Nota del autor: Anthropic ha actualizado su documentación oficial para advertir que Sonnet 4.6 podría no incorporar de forma fiable la marca de agua textual cuando se usan parámetros de muestreo distintos de los predeterminados. En este artículo explicamos las condiciones para que funcione y ofrecemos una lista de comprobación de la configuración de la API para desarrolladores.
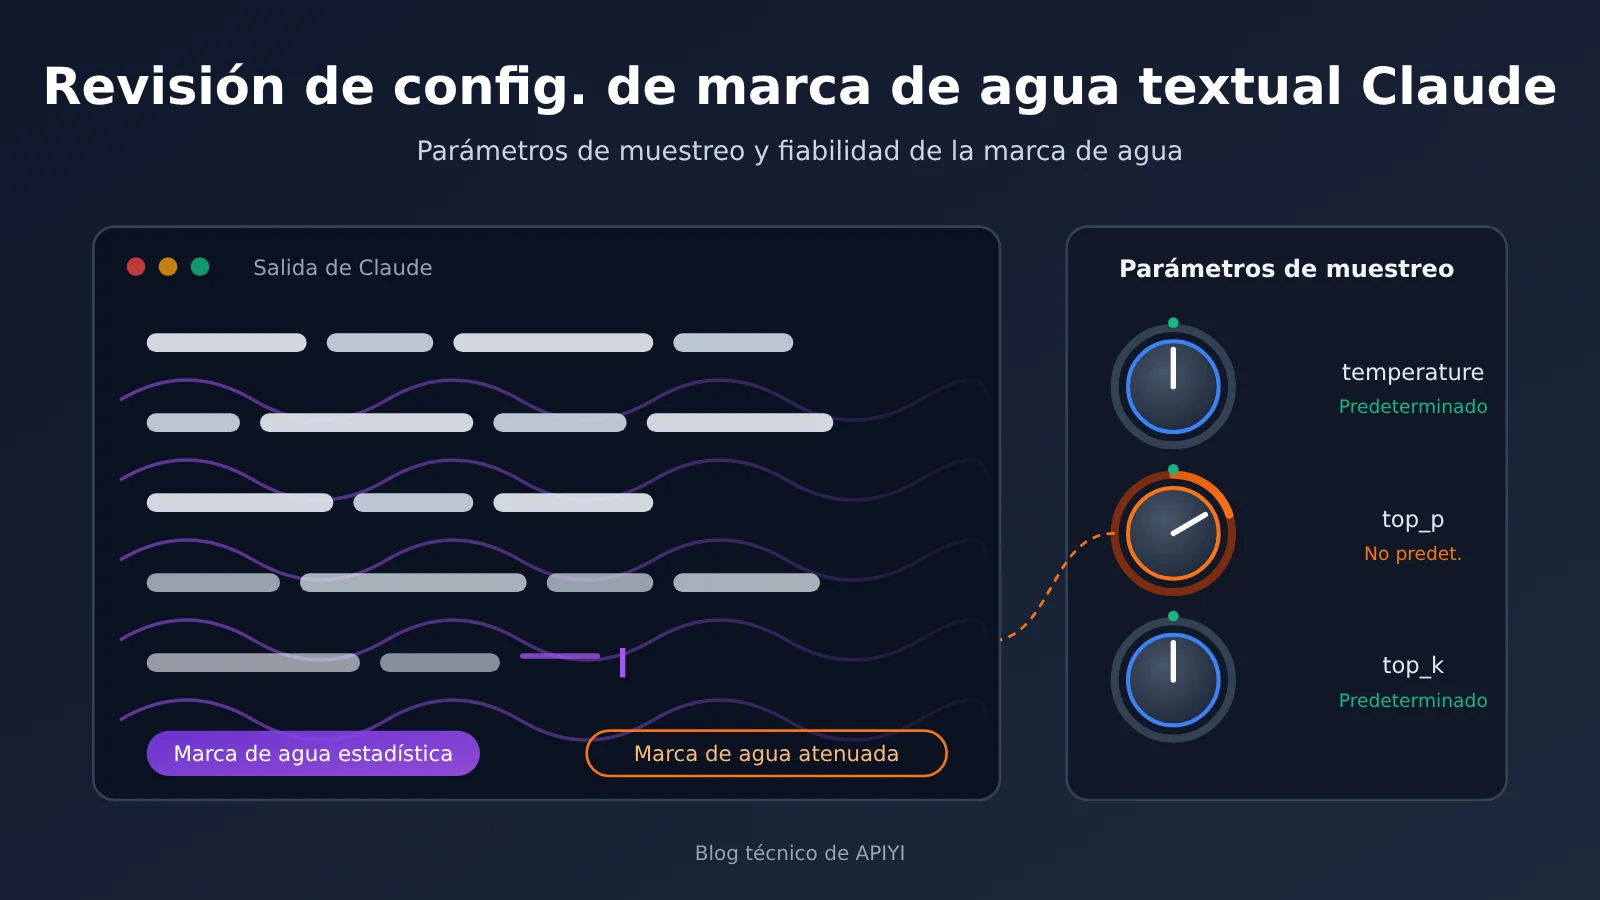
No todas las llamadas a Claude dan el mismo resultado: algunas respuestas llevan una marca de agua textual fiable y otras podrían no llevarla. En la documentación de la API actualizada el 3 de noviembre de 2026, Anthropic indica que si una solicitud a Claude Sonnet 4.6 establece temperature, top_p o top_k con valores distintos de los predeterminados, es posible que la respuesta no incorpore la marca de agua textual de forma fiable. Los equipos que dependen de esta marca de agua para el cumplimiento interno deben comprobar esta limitación por separado.
No es un rumor. Tanto la documentación oficial sobre marcas de agua textuales en la API como la tabla de compatibilidad de modelos del centro de ayuda mencionan esta limitación. La recomendación oficial es omitir directamente esos tres parámetros, en lugar de establecer un supuesto «valor seguro».
Lo esencial: descubre en 3 minutos en qué configuraciones puede fallar la marca de agua textual de Claude y qué debes comprobar en cada uno de estos tres canales: la API de Claude, las plataformas en la nube y los servicios de reenvío de terceros.
Datos clave sobre la marca de agua de texto de Claude
Empecemos por los datos principales de esta actualización. La información procede del centro de ayuda y la documentación de la API de Anthropic, y se verificó el 5 de noviembre de 2026. La compatibilidad podría cambiar más adelante.
| Dato | Detalle |
|---|---|
| Empresa | Anthropic |
| Actualización de la documentación | Desde el 3 de noviembre de 2026; el centro de ayuda volvió a actualizarse alrededor del 4 de noviembre |
| Limitación principal | En Sonnet 4.6, cuando temperature, top_p o top_k tienen valores distintos de los predeterminados, es posible que la salida no incorpore la marca de agua de forma fiable |
| Recomendación oficial | Si necesitas la marca de agua para cumplir requisitos normativos, omite estos tres parámetros en las solicitudes y elimina también los que añada automáticamente el framework |
| Modelos incluidos en esta ampliación | Mythos 5, Opus 4.7, Opus 4.6 y Sonnet 4.6, según un correo a clientes citado por la prensa |
| Avance en plataformas en la nube | Se prevé completar el despliegue de los modelos correspondientes en Amazon Bedrock antes del 10 de noviembre |
| Impacto en el precio | Según la documentación oficial, la marca de agua no añade tokens de salida ni genera cargos adicionales |
Contexto de la ampliación de la marca de agua de texto de Claude
Según informó el medio tecnológico The Decoder el 31 de octubre, Anthropic comunicó por correo a sus clientes de API que, a partir del 3 de noviembre, incorporaría gradualmente una marca de agua de texto invisible a cuatro modelos publicados con anterioridad. Modelos más recientes, como Opus 5.5, ya eran compatibles con esta función. Por tanto, esta actualización amplía la cobertura a más modelos, pero no introduce un nuevo producto de detección ni modifica las tarifas.
Al 5 de noviembre, el centro de ayuda oficial enumera 16 modelos de Claude: 12 aparecen como compatibles con la marca de agua de texto en canales propios y 4 tienen esa casilla vacía. La situación de los cuatro modelos incluidos en la ampliación es la siguiente:
| Modelo | Marca de agua de texto en canales propios | Marca de agua de texto en socios de nube | C2PA para archivos |
|---|---|---|---|
| Mythos 5 | Marcado como compatible | Marcado como compatible (despliegue en Bedrock en curso) | Compatible |
| Opus 4.7 | Marcado como compatible | Marcado como compatible (despliegue en Bedrock en curso) | Compatible |
| Opus 4.6 | Casilla vacía en la tabla oficial | Casilla vacía en la tabla oficial | Compatible |
| Sonnet 4.6 | Compatible con condiciones | Compatible con condiciones (despliegue en Bedrock en curso) | Compatible |
El caso de Opus 4.6 merece una explicación aparte. El correo a clientes lo incluye entre los modelos de la ampliación y las limitaciones de ese mismo documento oficial también mencionan los parámetros de muestreo no predeterminados de Opus 4.6. Sin embargo, su casilla de marca de agua de texto sigue vacía en la tabla de compatibilidad. La información pública presenta inconsistencias, por lo que de momento no es posible determinar en qué canales o configuraciones se ha completado su despliegue. Opus 4.5, Sonnet 4.5 y Haiku 4.5 tampoco aparecen marcados como compatibles con la marca de agua de texto en la tabla oficial.
Relación entre la marca de agua de texto de Claude y tres parámetros de muestreo
Estos tres parámetros no activan ni desactivan la marca de agua. Controlan cómo el modelo elige entre las palabras candidatas, y la marca de agua de texto de Claude aprovecha precisamente los patrones estadísticos de ese proceso. Por eso, ambos se influyen mutuamente.
Qué controla cada parámetro: temperature, top_p y top_k
| Parámetro | Función | Cómo entenderlo | Relación con la marca de agua |
|---|---|---|---|
| temperature | Controla el grado de aleatoriedad de la generación | Cuanto mayor es el valor, más diversos son los resultados; cuanto menor, más estables | Cambia la distribución de probabilidad de las palabras candidatas |
| top_p | Limita los tokens candidatos según un rango de probabilidad acumulada | Solo elige entre una parte de los tokens con mayor probabilidad | Reduce o modifica el espacio de opciones |
| top_k | Limita el número de tokens candidatos considerados en cada paso | Solo elige entre los K primeros candidatos | Recorta directamente el conjunto de candidatos |
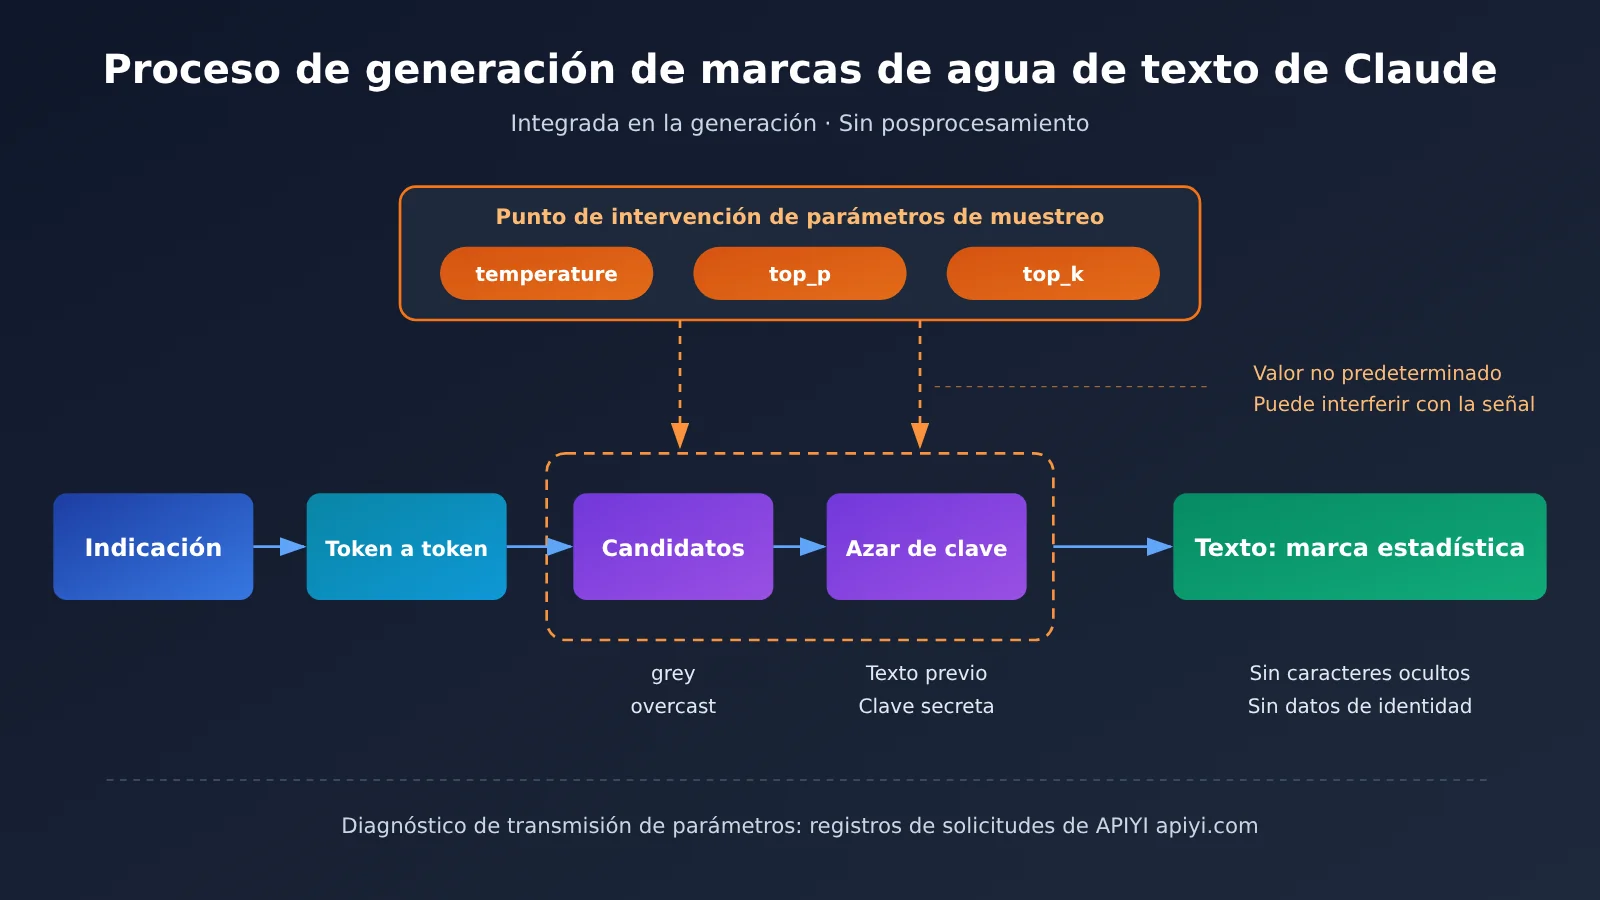
Los tres parámetros afectan a la elección del siguiente token. La señal de la marca de agua también se genera en ese paso, así que un cambio en la estrategia de muestreo puede interferir con los patrones estadísticos de los que depende. Sin embargo, Anthropic no ha afirmado que todas las combinaciones de valores no predeterminados hagan desaparecer la marca de agua por completo. Lo preciso es decir que «puede dejar de ser fiable», no que «fallará necesariamente».
La marca de agua de texto de Claude actúa durante la generación
Anthropic presentó este mecanismo el 14 de agosto de 2026. Se trata de una implementación del método SynthID-Text de Google DeepMind. Cuando Claude genera tokens uno a uno, normalmente hay varios candidatos semánticamente razonables para una misma posición. Por ejemplo, después de “The weather today was cold and …” tanto grey como overcast tienen sentido. Sin perjudicar la precisión ni la calidad, el sistema combina el texto previo con una clave secreta para determinar la aleatoriedad usada en esas elecciones. La secuencia de elecciones forma así un patrón estadístico detectable.
Por eso, la marca de agua no es un complemento de posprocesamiento. Los desarrolladores no tienen que hacer nada de lo siguiente:
- Añadir campos adicionales a la solicitud ni modificar el código que analiza la respuesta.
- Buscar caracteres Unicode ocultos, marcas visibles o códigos de identificación al final del texto: no los hay.
- Invocar una API por separado para aplicar la marca de agua.
- Gestionar información de identidad en la marca de agua, ya que no incluye ID de usuario, cuentas ni historiales de chat.
Precisamente porque la marca de agua se forma durante la generación, su comportamiento varía según el caso. Los textos largos ofrecen más posibilidades de elección de palabras y, por lo general, facilitan la acumulación de señal. El cuerpo del código tiene requisitos de sintaxis estrictos, por lo que la marca de agua es más escasa, aunque puede aparecer en comentarios y explicaciones. Reescribir el texto por completo, mezclarlo con otros contenidos o volver a traducirlo mediante otro proceso puede debilitar considerablemente la señal original. Anthropic no ha publicado un umbral de longitud para la detección, ni cifras de precisión o de falsos positivos; aquí tampoco especulamos con números concretos.
Cómo revisar la configuración de la API relacionada con las marcas de agua de texto de Claude
Para responder a «¿mi llamada cumple las condiciones para incluir una marca de agua?», no basta con mirar el nombre del modelo. También hay que revisar los parámetros de la solicitud enviada y el estado del despliegue del proveedor de origen. A continuación, lo vemos por canal.
| Canal de acceso | Qué revisar | Riesgo habitual |
|---|---|---|
| API de Claude de Anthropic | Si el ID del modelo está en la lista de modelos compatibles y si se han configurado los tres parámetros de muestreo | Ajustes de temperature heredados de código antiguo |
| Claude Code / Claude Cowork | El modelo que se invoca realmente y si es compatible | No volver a comprobarlo después de un cambio en el modelo predeterminado |
| Amazon Bedrock | La compatibilidad del modelo y si se ha completado su despliegue específico | Antes del 10 de noviembre, algunos modelos aún estaban en proceso de despliegue |
| Google Cloud / Microsoft Foundry | Si se trata de un modelo de Claude compatible y el estado del despliegue del producto | El avance puede variar entre plataformas de nube |
| Servicios de agregación o retransmisión de terceros (incluidos APIYI, apiyi.com, etc.) | La versión del modelo de origen, la asignación de alias, la transmisión o inyección de parámetros y si se modifica la salida | Determinar el estado de la marca de agua basándose solo en el nombre del modelo que aparece en la interfaz |
Los servicios de terceros merecen una explicación adicional. La marca de agua de Anthropic funciona a nivel de modelo: si un servicio de terceros invoca realmente el modelo original compatible con marcas de agua, no hay que dar por hecho que la salida deje de tenerla por cambiar de proveedor. Sin embargo, las estrategias de enrutamiento, las versiones de los modelos y los procesos varían según el proveedor. Que la marca de agua funcione a nivel de modelo no significa que cada cadena de salida de terceros se haya verificado de forma independiente. Para aplicaciones con requisitos estrictos de cumplimiento, la conclusión debe basarse en una comprobación real, no en las promesas verbales de ninguna plataforma.
Ejemplo mínimo: llamar a Claude sin parámetros de muestreo
La recomendación oficial es omitir estos tres parámetros. La forma más directa es no incluirlos en la solicitud y dejar que el modelo use la configuración de muestreo predeterminada:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz de APIYI compatible con OpenAI
)

# Nota: no se envían temperature / top_p / top_k
response = client.chat.completions.create(
    model="YOUR_CLAUDE_MODEL_ID",  # Usa el ID real de la lista de modelos de la plataforma
    messages=[{"role": "user", "content": "写一段产品介绍"}]
)
print(response.choices[0].message.content)
Ver el código completo: interceptar y auditar los parámetros de la solicitud enviada
import json
import logging
import httpx
import openai

logging.basicConfig(level=logging.INFO)
SAMPLING_KEYS = {"temperature", "top_p", "top_k"}

def audit_request(request: httpx.Request):
    """Comprueba el cuerpo antes de enviar la solicitud y alerta si hay parámetros de muestreo"""
    try:
        body = json.loads(request.content or b"{}")
    except Exception:
        return
    found = SAMPLING_KEYS & set(body.keys())
    # Comprueba también los campos extra_body que algunas plataformas transmiten sin modificar
    found |= SAMPLING_KEYS & set(body.get("extra_body", {}) or {})
    logging.info("model=%s sampling_params=%s",
                 body.get("model"), {k: body.get(k) for k in found})
    if found:
        logging.warning("检测到采样参数 %s,水印可能不可靠", found)

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",
    http_client=httpx.Client(event_hooks={"request": [audit_request]})
)

def call_claude(prompt: str, model: str, **kwargs) -> str:
    """Envoltura de la aplicación: elimina los parámetros de muestreo para evitar envíos accidentales"""
    clean_kwargs = {k: v for k, v in kwargs.items() if k not in SAMPLING_KEYS}
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        **clean_kwargs
    )
    # Registra el identificador del modelo devuelto para conservar la configuración de la invocación
    logging.info("response_model=%s", resp.model)
    return resp.choices[0].message.content

print(call_claude("总结一下文本水印的原理", model="YOUR_CLAUDE_MODEL_ID",
                  temperature=0.7))  # La función envolvente eliminará este parámetro
Este código tiene dos capas de protección. La envoltura de la aplicación elimina los parámetros que se hayan pasado por error; el hook de la capa HTTP audita el cuerpo de la solicitud que se envía finalmente y puede detectar parámetros que un SDK, framework o middleware haya añadido sin que lo sepas. La documentación oficial advierte que no configurar un parámetro de forma explícita no significa que esté ausente de la solicitud: algunas clases envolventes de frameworks pueden incluir un valor predeterminado de temperature. Por eso, hay que comprobar la solicitud real capturada.
🚀 Inicio rápido: si necesitas comparar la configuración de las solicitudes entre varias versiones de Claude, puedes probar distintos ID de modelo en APIYI apiyi.com con la misma clave API. Usa el hook de auditoría anterior para comprobar que no se envíen parámetros no deseados y, después, decide la configuración de producción.
Análisis del impacto de la marca de agua de texto de Claude para desarrolladores
Impacto para desarrolladores de API
- Hay que identificar el modelo exacto: «Claude» no implica un único comportamiento de marca de agua. Sonnet 4.6 la admite bajo ciertas condiciones, el estado de Opus 4.6 es incierto y la serie 4.5 aún no figura como compatible. Cada modelo debe tratarse por separado.
- Hay que auditar los parámetros de muestreo: parámetros como temperature suelen ajustarse por costumbre. Si el negocio depende de la marca de agua, deben incluirse entre las configuraciones que requieren aprobación.
- No busques un «valor seguro»: la recomendación oficial es omitir el parámetro, no asignarle un valor concreto. Los supuestos trucos que circulan en internet para eludir o conservar la marca de agua no cuentan con confirmación oficial y no deberían usarse.
- La marca de agua no afecta al costo: según la documentación oficial, no añade tokens ni cargos. Algunos modelos de Claude 4.7 y posteriores pueden generar más tokens para un mismo texto debido a diferencias de segmentación del nuevo tokenizador, no a la marca de agua.
Impacto para usuarios de plataformas y en materia de cumplimiento
Las obligaciones de transparencia del artículo 50 de la Ley de Inteligencia Artificial de la UE empezaron a aplicarse el 2 de agosto de 2026. Para los sistemas existentes que cumplan los requisitos de las disposiciones transitorias, el período de transición se extiende hasta el 2 de diciembre de 2026. Las empresas que dependen de marcas de agua incorporadas por el modelo deberían completar una revisión de sus configuraciones antes de esa fecha. Una marca legible por máquina incorporada por el modelo y la obligación del usuario de añadir una etiqueta visible al contenido son dos cosas distintas. Las obligaciones concretas deben evaluarse según el proveedor, el implementador y el tipo de contenido.
Los equipos que usan plataformas de agregación de API deberían gestionar los «cambios en las funciones del modelo de origen» como cambios en una dependencia: qué versión del proveedor corresponde al ID de modelo de la plataforma, si los parámetros se transmiten sin cambios y si la salida se traduce o reformula. Estos tres factores determinan si pueden cumplirse las condiciones de la marca de agua.
💡 Recomendación: si tu aplicación exige una marca de agua, prioriza los modelos que figuran oficialmente como compatibles, como Opus 4.7, Opus 5.5 y Sonnet 5.5, y conserva un registro de la configuración de las invocaciones. Al hacer pruebas en APIYI apiyi.com, puedes verificar primero los identificadores de versión en la lista de modelos y después integrar el servicio en producción.
Lista de verificación para desarrolladores: marca de agua de texto de Claude
Si tu negocio necesita conservar la marca de agua de texto de Claude, conviene comprobar lo siguiente:
- Si el modelo figura en la lista de modelos compatibles de Anthropic y en qué fecha se verificó;
- La plataforma de invocación y el estado de la implementación en la nube; si usas Bedrock, ten en cuenta que la fecha prevista de finalización es el 10 de noviembre;
- Si
temperatureaparece en el cuerpo de la solicitud; - Si
top_paparece en el cuerpo de la solicitud; - Si
top_kaparece en el cuerpo de la solicitud; - Si el SDK, el framework, la puerta de enlace o el middleware añaden automáticamente parámetros de muestreo;
- Si el resultado se traduce de nuevo, se reescribe de forma considerable o se concatena;
- Si se mantiene un registro de las versiones del modelo y las configuraciones de invocación para los procesos importantes.
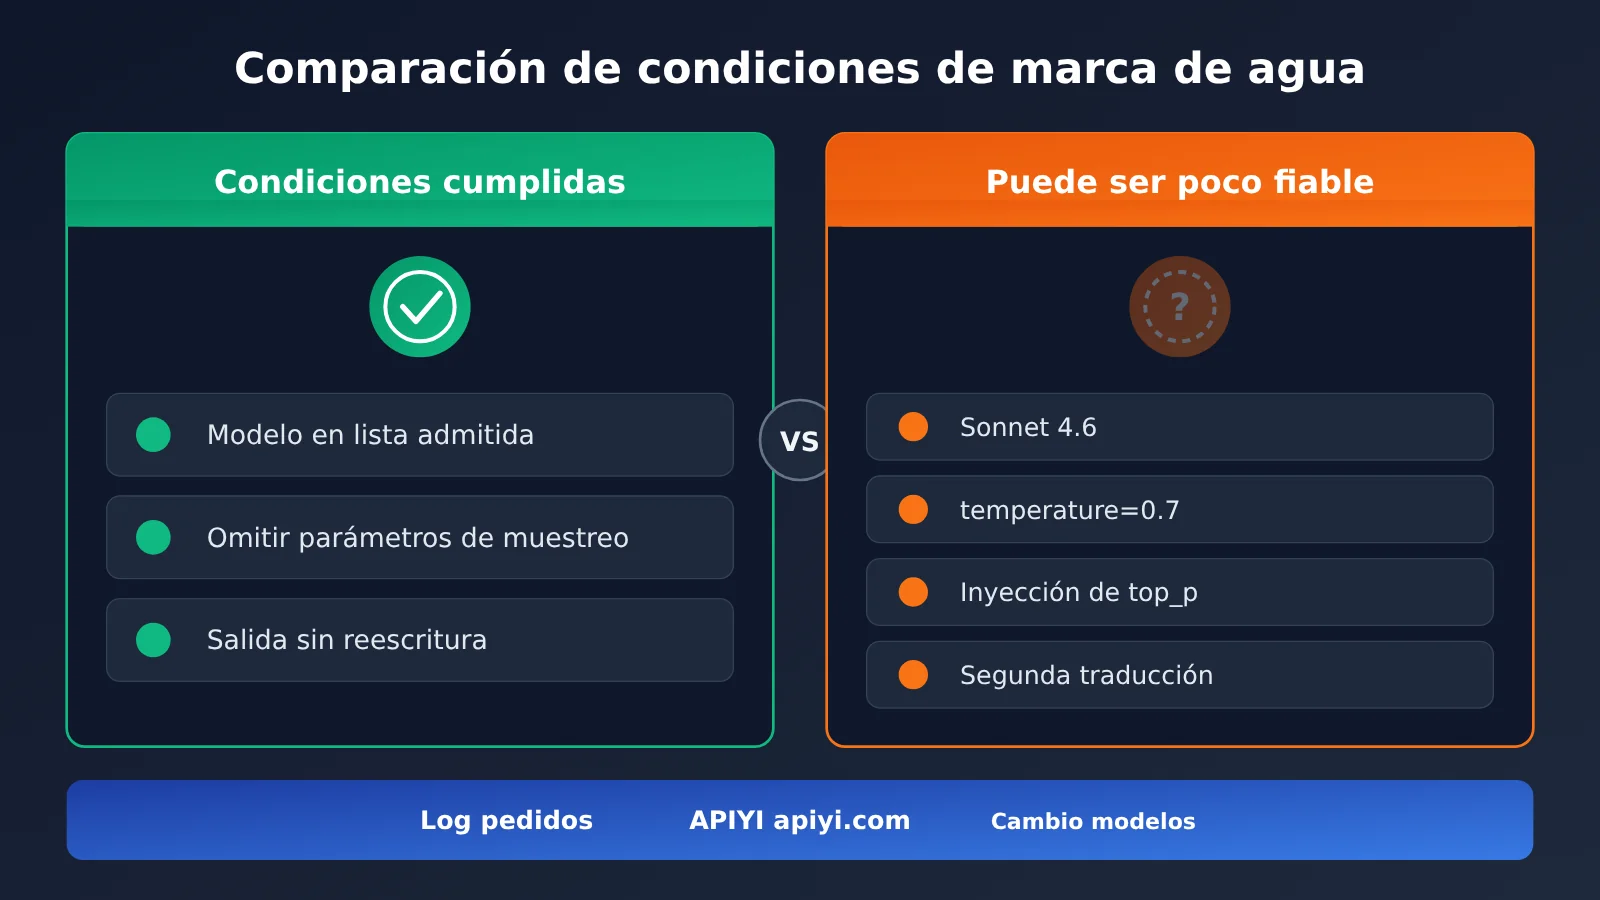
Por último, también conviene tener claros los límites de la detección. Al 5 de noviembre, la API de detección de marcas de agua de texto de Anthropic seguía en vista previa privada, dirigida principalmente a organismos reguladores, medios de comunicación, investigadores, instituciones educativas y empresas que necesitan verificar el cumplimiento normativo. Por ahora, los usuarios generales no tienen acceso a una herramienta pública de detección de autoservicio. Content Checker, la herramienta gratuita de Claude, verifica las credenciales de contenido C2PA de los archivos; no es el mismo mecanismo que la detección de marcas de agua de texto.
Preguntas frecuentes FAQ
Q1: ¿Qué es la marca de agua de texto de Claude?
Es una señal estadística invisible que Anthropic incorpora durante la generación del texto. Se basa en métodos similares a SynthID-Text y aprovecha patrones estadísticos en la selección de tokens para crear una señal detectable. No inserta caracteres ocultos, no añade marcas visibles ni contiene información sobre la identidad del usuario.
Q2: ¿Configurar temperature en 0 o 1 garantiza que la marca de agua funcione?
No. La recomendación oficial es omitir temperature, top_p y top_k de la solicitud; no se han indicado valores supuestamente seguros. Por otro lado, tampoco se ha afirmado que los valores distintos a los predeterminados hagan desaparecer la marca de agua, solo que podrían hacerla menos fiable.
Q3: ¿Todos los modelos de Claude tienen esta restricción sobre los parámetros de muestreo?
No se puede generalizar. La documentación oficial menciona explícitamente a Sonnet 4.6 y la descripción de la restricción también menciona a Opus 4.6, pero la casilla de Opus 4.6 sigue vacía en la tabla de compatibilidad. Para los demás modelos, consulta la tabla más reciente del centro de ayuda e indica la fecha de verificación.
Q4: Si invoco Claude a través de una plataforma de agregación de API, ¿sigue habiendo marca de agua?
Si el modelo original que se invoca admite marcas de agua, no se puede dar por hecho que desaparezcan al cambiar de proveedor, pero tampoco se puede asegurar que estén presentes sin verificarlo. Al hacer pruebas en plataformas como APIYI apiyi.com, conviene comprobar el identificador de versión del modelo, auditar la solicitud para confirmar que no se hayan añadido parámetros de muestreo y verificar que la salida no se haya reescrito después.
Q5: ¿Cómo puedo comprobar rápidamente si mi solicitud incluye parámetros de muestreo?
Añade un hook de solicitud en el cliente HTTP para imprimir el cuerpo de la solicitud que se envía finalmente. Puedes consultar el código completo de la sección anterior. Antes de pasar a producción, puedes hacer una prueba con el crédito disponible en APIYI apiyi.com y confirmar que ni el SDK ni el framework añadan parámetros automáticamente.
Q6: ¿Cuáles son las limitaciones conocidas de la marca de agua de texto de Claude?
La marca de agua es menos abundante en textos cortos, bloques de código y contenidos con poco margen para variar la redacción; una reescritura considerable o una traducción posterior pueden debilitar la señal. El resultado de la detección solo puede indicar que el contenido posiblemente haya sido generado o procesado por Claude; no demuestra la identidad del autor ni la veracidad del contenido. Que no se detecte una marca de agua tampoco significa necesariamente que el contenido haya sido creado por una persona.
Puntos clave sobre la marca de agua de texto de Claude
- Los tres parámetros no son interruptores: temperature, top_p y top_k afectan al proceso de muestreo, por lo que pueden interferir con la señal de la marca de agua.
- La recomendación oficial es omitirlos: no establezcas tus propios «valores seguros» y comprueba también que el framework no los añada automáticamente.
- Cada modelo tiene un estado distinto: Sonnet 4.6 ofrece compatibilidad condicional, el estado de Opus 4.6 no está claro y la serie 4.5 aún no figura como compatible.
- La marca de agua se forma durante la generación: no hace falta modificar los campos de la solicitud ni el código de análisis, y no tiene costo adicional.
- El estado varía según el proveedor: se espera que Bedrock complete el despliegue antes del 10 de noviembre; las conexiones a través de terceros deben verificarse por separado.
- Guarda la configuración: puedes probar versiones y parámetros de los modelos desde una interfaz unificada en APIYI apiyi.com y registrar la configuración de cada invocación.
Resumen
Hay tres puntos clave sobre la marca de agua de texto de Claude:
- Las limitaciones están definidas: en Sonnet 4.6, la marca de agua puede no ser fiable si se usan parámetros de muestreo distintos de los predeterminados. La recomendación oficial es omitirlos.
- El mecanismo es claro: la marca de agua se forma durante la generación mediante patrones estadísticos en la selección de tokens; no es un complemento de posprocesamiento.
- El estado sigue cambiando: la compatibilidad continúa ampliándose, por lo que conviene consultar periódicamente la documentación oficial sobre Opus 4.6 y el avance en cada plataforma en la nube.
Para quienes usan la API, no basta con confirmar el nombre del modelo: también hay que comprobar los parámetros que se envían y el estado del despliegue del proveedor. Una buena opción es probar las distintas versiones de Claude con una interfaz unificada en APIYI apiyi.com y llevar un registro de la configuración de las invocaciones, para adaptarse a futuros cambios en la compatibilidad oficial.
📚 Referencias
- Documentación para desarrolladores de Anthropic API sobre marcas de agua en texto: límites de los parámetros de muestreo y recomendaciones oficiales
- Enlace:
platform.claude.com/docs/en/build-with-claude/text-watermark -
Descripción: fuente primaria sobre los límites de parámetros de Sonnet 4.6
-
Centro de ayuda de Anthropic – How Claude marks AI-generated content: tabla de compatibilidad por modelo
- Enlace:
support.claude.com/en/articles/16266773-how-claude-marks-ai-generated-content -
Descripción: consulta el estado más reciente de las marcas de agua por modelo y canal
-
Anthropic – How Claude’s text watermark works: fundamentos técnicos de la marca de agua
- Enlace:
www.anthropic.com/news/claude-text-watermark -
Descripción: explica cómo funciona la marca de agua en la fase de generación
-
Reportaje de The Decoder: ampliación de las marcas de agua a cuatro modelos anteriores
- Enlace:
the-decoder.com/anthropics-watermark-rollout-leaves-a-loophole-on-two-older-Claude-models -
Descripción: fechas y modelos incluidos en la ampliación, según un correo enviado a clientes
-
Nature – Scalable watermarking for identifying LLM outputs: artículo científico sobre SynthID-Text
- Enlace:
www.nature.com/articles/s41586-024-08025-4 - Descripción: contexto académico del método de marcas de agua
Autor: equipo técnico de APIYI
Intercambio técnico: visita la página principal de APIYI en apiyi.com para contactarnos y conversar sobre la invocación de modelos Claude y la configuración de parámetros