Nota del autor: es previsible que el día del lanzamiento de un modelo nuevo se agoten las cuotas y aparezcan límites de tasa y tiempos de espera agotados. En este artículo encontrarás 5 claves de diseño: niveles de modelos, modelos alternativos, colas de prioridad, programación fuera de las horas pico, y monitoreo y presupuesto. También incluye una lista de verificación de capacidad para el día del lanzamiento.
La conclusión, de entrada: que un modelo nuevo alcance el límite de cuota nada más lanzarse no es una sorpresa, sino parte del ciclo de lanzamiento del producto. Las cuotas gratuitas atraen a muchos usuarios que quieren probarlo, el tráfico se concentra el día del lanzamiento y el proveedor necesita tiempo para ampliar su capacidad. Cuando todo esto coincide, la escasez de capacidad es casi inevitable. Del lado de la aplicación, lo importante es diseñar de antemano un sistema de cambio entre modelos y programación fuera de las horas pico, en lugar de esperar a que aparezca el error 429 para empezar a reintentar una y otra vez.
Este artículo no trata de «añadir unos cuantos reintentos más». Los reintentos pueden absorber fluctuaciones breves, pero no resuelven el agotamiento de la cuota ni la sobrecarga del proveedor. El día del lanzamiento, lo que marca la diferencia no es la cantidad de reintentos, sino cómo has organizado de antemano los niveles de modelos y las colas. Al terminar, tendrás un método práctico para diseñar la capacidad de ese día: niveles de modelos, modelos alternativos, colas de prioridad, programación fuera de las horas pico, monitoreo y presupuesto. También sabrás cuándo cambiar de modelo, cuándo poner una solicitud en cola y cuándo detenerte.
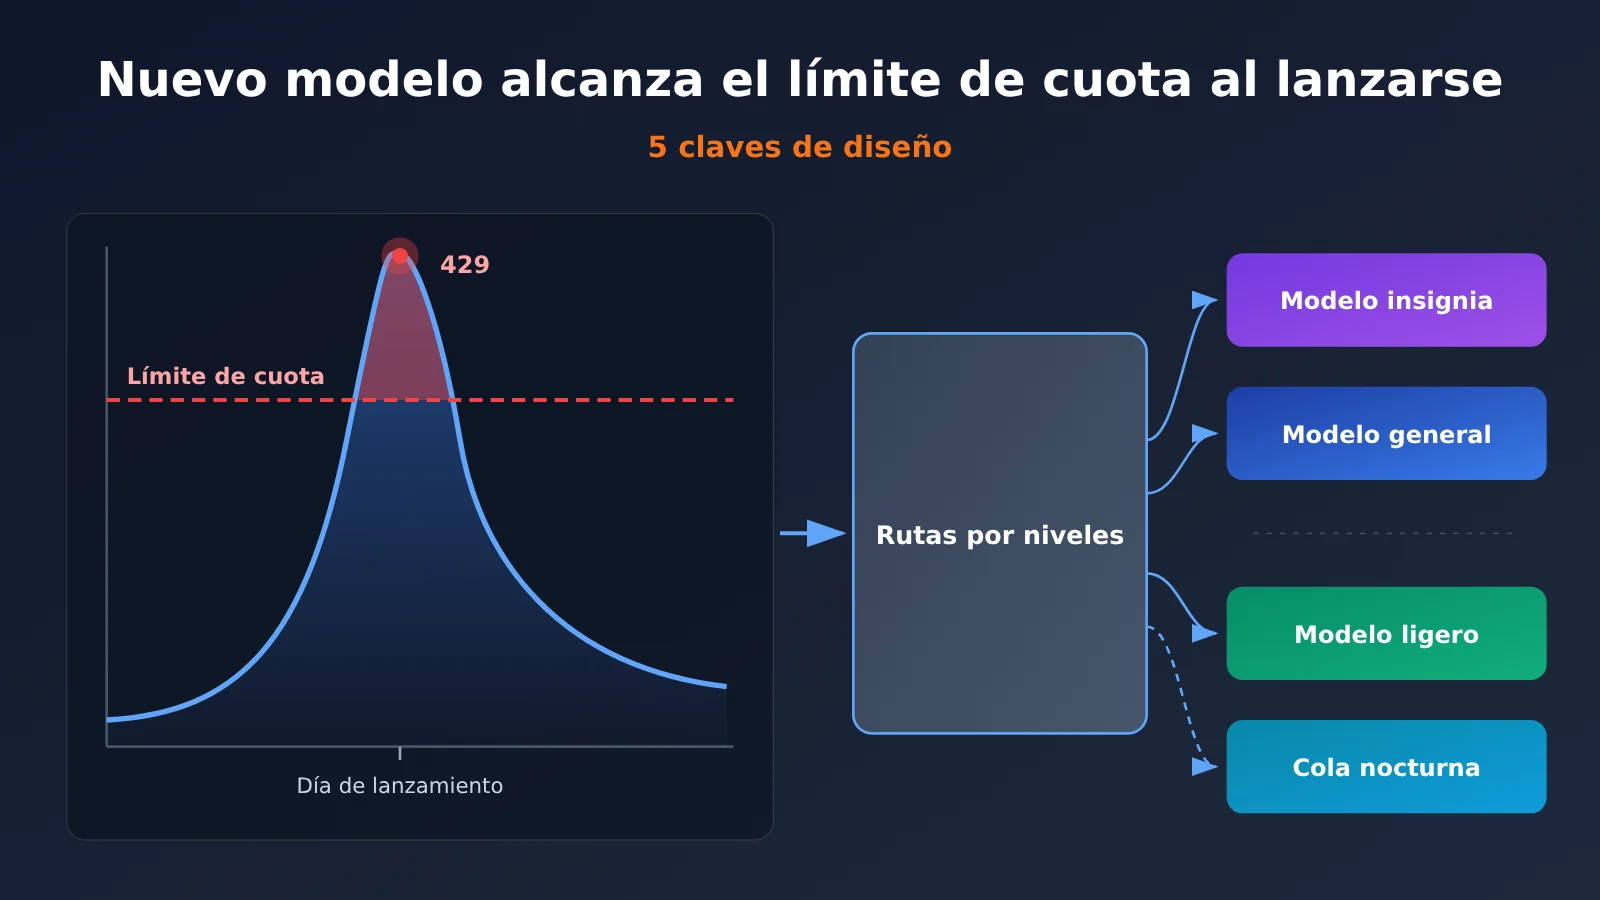
Por qué es fácil alcanzar los límites el día de lanzamiento de un modelo
En resumen: los límites se alcanzan cuando la demanda se dispara de golpe y la ampliación de la capacidad disponible no llega a tiempo. Las aplicaciones deben diseñarse para afrontarlo como un evento previsible.
Un ejemplo reciente es Hy4, de Tencent. Según la información pública de la compañía, Hy4 debutó en WorkBuddy el 4 de noviembre. El primer día, muchos usuarios alcanzaron su límite de uso; después, Tencent multiplicó por diez la capacidad del clúster de inferencia y aumentó la cuota gratuita. La compañía recomendó cambiar a Hy3 al alcanzar el límite o dejar las tareas no urgentes para la noche. También extendió la gratuidad limitada de Hy3 hasta el 15 de noviembre a las 23:59.
Es importante aclarar que este incidente ocurrió a nivel del producto WorkBuddy: se trataba de cuotas de uso para usuarios finales y no puede equipararse directamente a una limitación de tasa de la API. Las cuotas de producto suelen calcularse por cuenta o nivel de membresía, mientras que los límites de la API regulan la tasa y la concurrencia por clave, organización o modelo. Sus condiciones de activación y sus soluciones son distintas. Aun así, el patrón es general: cuando se lanza un modelo, la demanda se concentra en muy poco tiempo.
La escala de la demanda también crece rápidamente. Ese mismo 4 de noviembre, DeepSeek informó de que Harness tenía alrededor de 1,54 millones de usuarios activos diarios y consumía unos 92 billones de tokens al día. Son cifras comunicadas por la propia empresa, no auditadas por terceros: sirven para hacerse una idea de la magnitud, pero no como base precisa para planificar la capacidad. Aun así, muestran que el consumo de tokens de las aplicaciones basadas en agentes ya supera con creces al de un chat convencional.
Cuatro causas por las que un nuevo modelo alcanza los límites
| Causa | Cómo se manifiesta | Impacto en la aplicación |
|---|---|---|
| Cuotas gratuitas o de prueba | Los nuevos modelos suelen ofrecer cuotas de prueba que atraen a muchos usuarios al mismo tiempo | La cuota se agota rápidamente y aparecen errores 402 o 429 |
| Acceso concentrado | Se acumula el tráfico del día de lanzamiento, las promociones y las horas laborales | Los picos pueden alcanzar entre 3 y 10 veces el volumen habitual |
| Ocupación por tareas largas | Agentes con múltiples turnos, llamadas a herramientas y contextos largos | Cada solicitud consume muchos tokens y ocupa recursos de inferencia durante más tiempo |
| Demora en la ampliación de capacidad del proveedor | Ampliar el clúster de inferencia lleva tiempo | Errores 5xx, colas, tiempos de espera agotados e incluso fluctuaciones en la calidad de las respuestas |
De estas cuatro causas, la aplicación solo puede controlar directamente la forma y la programación de sus propias solicitudes. Así que, en lugar de confiar en que el proveedor «aguante», conviene preparar mecanismos propios para distribuir y amortiguar la carga.
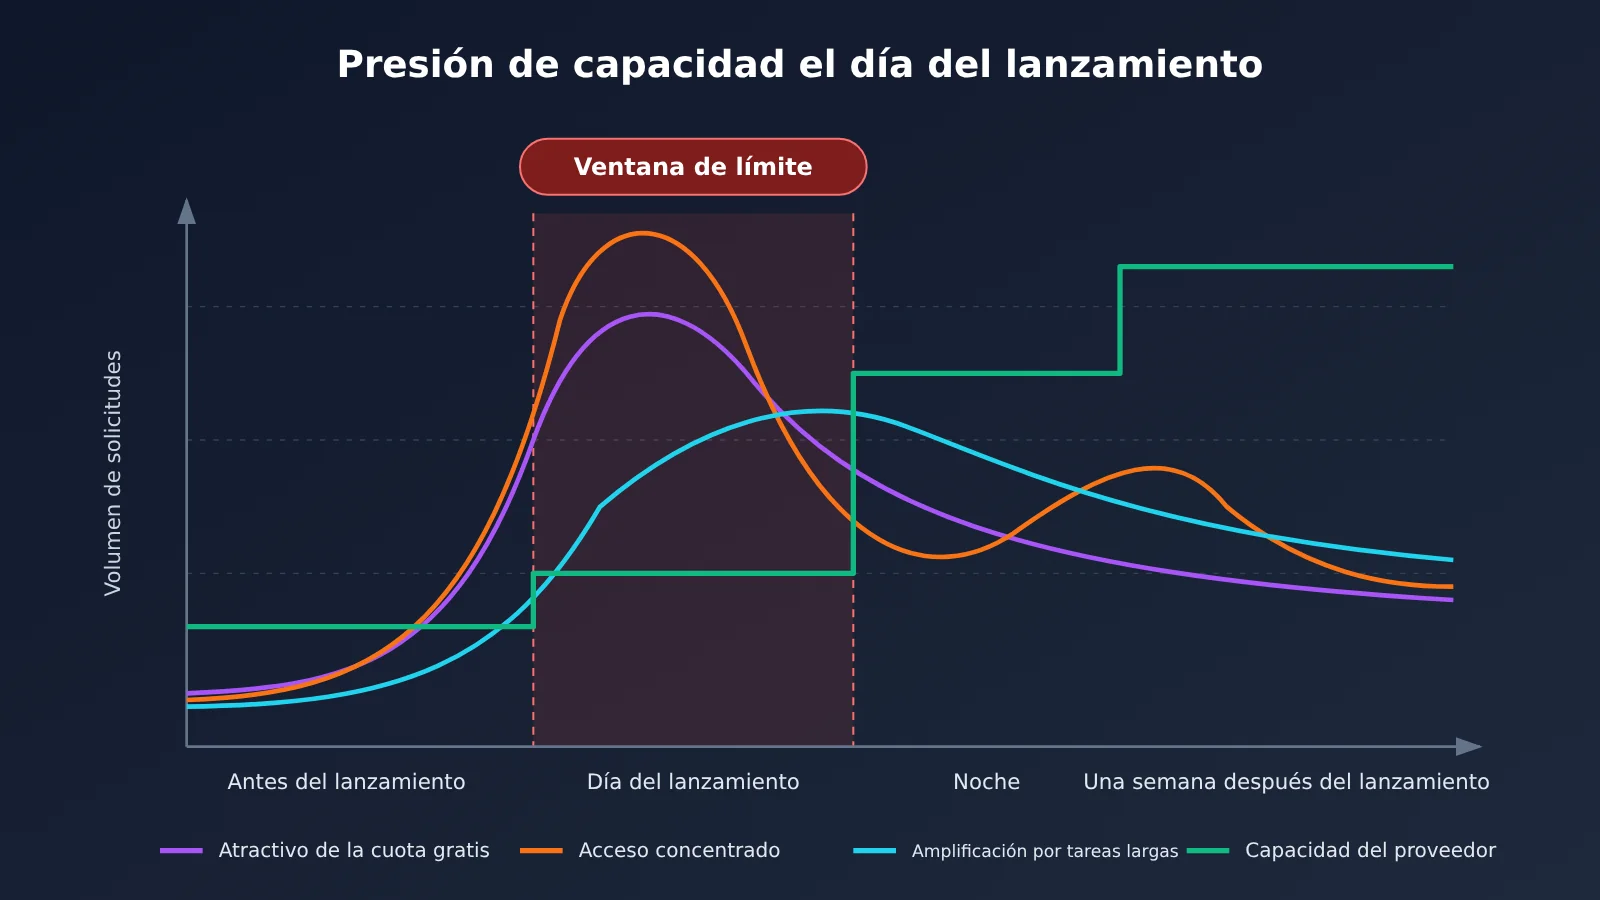
Cinco tipos de problemas de capacidad al alcanzar los límites de un modelo nuevo
La conclusión: alcanzar un límite no es un único error, sino cinco tipos distintos de problemas de capacidad. Cada uno requiere una respuesta diferente.
Muchos equipos aplican la misma lógica de reintentos a todos los fallos, y eso es precisamente lo que agrava los incidentes el día del lanzamiento. Cuando se agota la cuota, los reintentos seguirán fallando; si el servicio upstream está sobrecargado, los reintentos frecuentes incluso aumentarán la congestión. La siguiente tabla separa los cinco tipos de problemas para ayudarte a diseñar una respuesta para cada caso.
| Problema | Códigos de estado habituales | Causa | Tratamiento |
|---|---|---|---|
| Cuota agotada | 402, 429 |
Se agotó la cuota gratuita, la cuota de prueba o el saldo de la cuenta | Detener los reintentos, cambiar a un modelo de respaldo o pedir que se recargue el saldo |
| Límite de tasa o concurrencia | 429, a menudo con Retry-After |
Se superó el límite de RPM, TPM o concurrencia de una clave o un modelo | Esperar según Retry-After; si la espera supera el umbral, cambiar de modelo o poner la solicitud en cola |
| Capacidad insuficiente del upstream | 500, 502, 503, 529 |
Sobrecarga o fallo parcial del clúster de inferencia | Hacer unos pocos reintentos con espera exponencial y cambiar a un modelo de respaldo tras fallos consecutivos |
| Ocupación por tareas largas | Tiempo de espera agotado, conexión interrumpida | Varias rondas de un agente, invocaciones de herramientas o un contexto largo hacen que una solicitud consuma demasiados recursos | Dividir las tareas, limitar el contexto y asignar a las tareas largas un grupo de concurrencia independiente |
| Concentración en horas pico | Aparición combinada de 429 y 5xx |
Se acumula el tráfico diurno, del día de lanzamiento o de una campaña | Usar una cola de prioridades y programar tareas fuera de las horas pico; posponer las no urgentes |
Hay dos detalles de la tabla que conviene destacar. Primero, 429 es ambiguo: puede indicar tanto que se superó el límite de tasa como que se agotó la cuota. Para distinguirlos, hay que revisar el mensaje de error del cuerpo de la respuesta y Retry-After. Segundo, los códigos de sobrecarga como 529 indican que el upstream no puede atender solicitudes temporalmente. En ese caso, reducir la frecuencia de las solicitudes es más eficaz que acelerar los reintentos.
Una vez distinguidos los códigos de error, los cinco puntos de diseño que siguen tienen una base clara: cuándo cambiar de modelo, cuándo poner una solicitud en cola y cuándo detenerse directamente.
5 claves de diseño para alternar entre modelos y escalonar solicitudes
En resumen, estos cinco puntos responden a cinco preguntas: «¿qué modelo usar?, ¿por cuál sustituirlo?, ¿quién lo usa primero?, ¿cuándo usarlo? y ¿cuánto costó?». Si falta alguno, el problema saldrá a la luz el día del lanzamiento.
Clave de diseño 1: organización de modelos por niveles
Cómo hacerlo: divide los modelos en tres niveles según su capacidad y costo: avanzado, general y ligero. Después, asigna las tareas de negocio a cada nivel según su prioridad y dificultad. Usa el nivel avanzado para razonamiento complejo y generación de código crítico; el general para preguntas y respuestas cotidianas, resúmenes y reescritura; y el ligero para tareas sencillas como clasificación, extracción y reconocimiento de intenciones. Cuando se lanza un modelo nuevo, normalmente se le asigna solo una parte del tráfico del nivel avanzado, en lugar de sustituir por completo al modelo anterior.
Cuándo se aplica: la organización por niveles es una configuración permanente, no algo que se active solo ante una falla. Define de antemano el destino predeterminado de cada tipo de tarea; el día del lanzamiento solo se ajustan las proporciones.
Cómo comprobarlo: usa un conjunto fijo de pruebas para cada nivel y registra la tasa de éxito, la latencia P95 y el costo en tokens por tarea. Así podrás confirmar que la calidad no disminuye de forma notable cuando el nivel ligero se encarga de tareas sencillas.
En la práctica, el mayor obstáculo suele ser que cada proveedor añade otro SDK y otra clave que gestionar. Con una plataforma de agregación como APIYI apiyi.com, puedes invocar modelos de distintos proveedores, como OpenAI, Claude y Gemini, con una sola clave. La interfaz es compatible con el formato de OpenAI, así que para organizar los niveles solo tienes que cambiar el nombre del modelo, sin mantener una autenticación y un cliente independientes para cada uno.
Punto de diseño 2: asignación de modelos alternativos
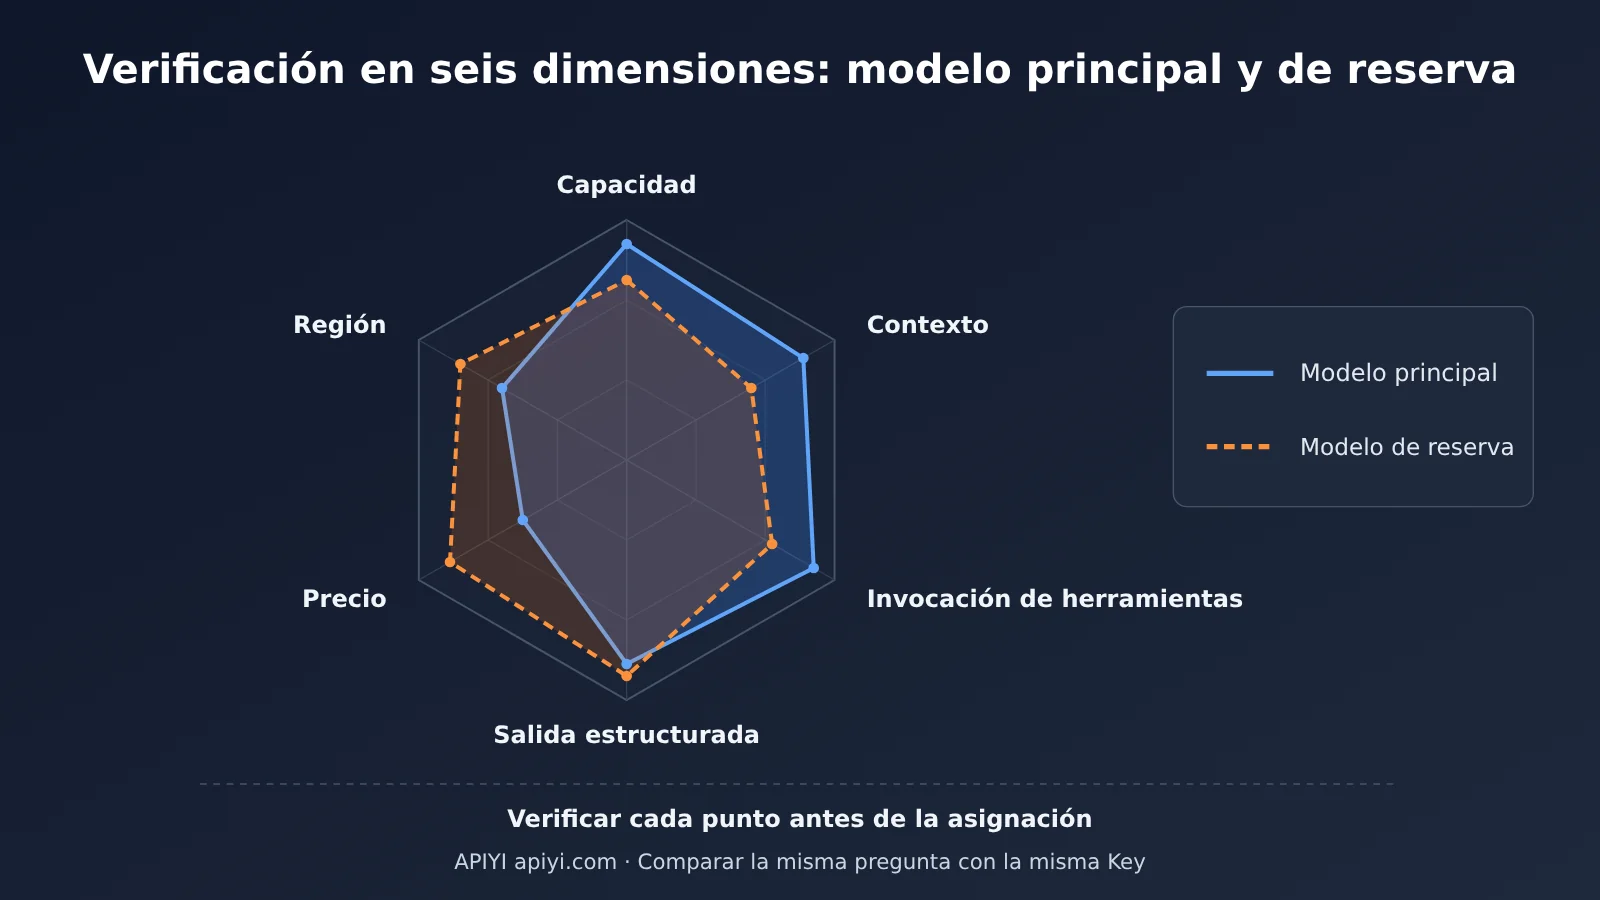
Cómo hacerlo: asigna al menos un modelo alternativo a cada modelo principal y comprueba seis dimensiones para cada asignación: nivel de capacidad, longitud del contexto, compatibilidad con llamadas a herramientas, capacidad de salida estructurada, precio y regiones disponibles. Es fácil pasar por alto las llamadas a herramientas y la salida estructurada: si el modelo alternativo no admite el mismo formato de llamada a funciones, el agente se interrumpirá en cuanto se produzca el cambio.
Cuándo activarlo: define condiciones concretas, como 2 errores 5xx consecutivos, un Retry-After de 429 que supere el tiempo de espera aceptable para la tarea, una latencia P95 que se mantenga por encima del doble de la referencia o una respuesta explícita que indique que se agotó la cuota. No configures el cambio para «cualquier fallo», porque hasta las fluctuaciones ocasionales provocarían numerosos cambios.
Cómo validarlo: ejecuta el mismo conjunto de pruebas con el modelo principal y el alternativo. Compara la tasa de éxito, la tasa de validación de las salidas estructuradas y la tasa de éxito de las llamadas a herramientas. Si las diferencias superan el margen de tolerancia del negocio, elige otro modelo alternativo.
| Nivel | Tareas adecuadas | Modelo principal | Modelo alternativo | Condición de cambio |
|---|---|---|---|---|
| Insignia | Razonamiento complejo, código crítico, planificación de agentes | Modelo insignia recién lanzado | Modelo insignia de la generación anterior o modelo equivalente de otro proveedor | 2 errores 5xx consecutivos; Retry-After de 429 superior a 30 segundos |
| General | Preguntas y respuestas, resúmenes, reformulación, generación de informes | Modelo general de uso principal | Modelo general equivalente de otro proveedor | Latencia P95 superior al doble de la referencia durante 5 minutos |
| Ligero | Clasificación, extracción, enrutamiento, reconocimiento de intenciones | Modelo ligero | Modelo ligero de otro proveedor | Tasa de errores 5xx superior al 5 %; cuota agotada |
| Procesamiento por lotes | Análisis sin conexión, etiquetado de datos, evaluación | Cualquier modelo económico disponible | Sin cambio; se pospone directamente | No se cambia de inmediato; se envía a la cola nocturna |
| Plataformas disponibles | Acceso unificado para todos los niveles anteriores | APIYI apiyi.com, API oficiales de cada proveedor | Igual que el principal | Consulta la consola y la documentación |
Los umbrales de la tabla son ejemplos: ajústalos según la referencia de tu negocio.
💡 Recomendación para la degradación: si no quieres mantener toda la lógica de cambio en la aplicación, puedes apoyarte también en las capacidades de la plataforma. Según su descripción oficial, APIYI apiyi.com utiliza despliegue multinodo, enrutamiento inteligente, degradación automática y balanceo de carga, lo que puede aliviar parte de la carga ante fallos parciales de los proveedores. Consulta la documentación oficial para conocer las condiciones de activación y las reglas de cambio concretas. Aun así, conviene mantener en la aplicación tus propias asignaciones de modelos alternativos como respaldo.
Punto de diseño 3: colas de prioridad
Cómo implementarlo: divide las solicitudes en tres niveles de prioridad: tareas de pago o urgentes, tareas internas y tareas por lotes. Las tareas urgentes van directamente al modelo principal; las internas pasan al modelo alternativo cuando el principal está ocupado; y las tareas por lotes esperan en una cola. Configura para cada cola un máximo de solicitudes concurrentes, un tiempo máximo de espera y una estrategia alternativa en caso de que se agote el tiempo, para evitar que una tarea larga acapare todo el conjunto de conexiones concurrentes.
Cuándo se activa: cuando la tasa de respuestas 429 del modelo principal o la longitud de la cola superan el umbral establecido, las colas entran en acción y las solicitudes de baja prioridad dejan de competir por la capacidad concurrente del modelo principal.
Cómo verificarlo: las colas deben ser observables; como mínimo, hay que poder consultar su longitud, el tiempo medio de espera y la tasa de abandono. Durante las pruebas de carga, provoca artificialmente una limitación de tasa en el modelo principal y confirma que la latencia de las tareas urgentes se mantiene estable y que las de baja prioridad esperan en cola en lugar de fallar.
Hay un principio innegociable: las solicitudes no idempotentes no deben reintentarse automáticamente. Si falla una operación como realizar un pedido, enviar un mensaje, escribir en una base de datos o llamar a una herramienta externa de pago, primero hay que consultar su estado y confirmar si el intento anterior ya se completó antes de decidir si se vuelve a enviar. Para estas solicitudes se puede generar una clave de idempotencia, que el servidor utilizará para evitar duplicados. Reintentar automáticamente ante cualquier error es una causa habitual de cobros y escrituras duplicados el día del lanzamiento.
Punto de diseño 4: programación fuera de las horas pico
Cómo hacerlo: identifica las tareas que toleran demoras, como informes offline, resúmenes por lotes, etiquetado de datos y evaluaciones de regresión, y ejecútalas por la noche o en horas de baja demanda. Una de las recomendaciones que Tencent dio a sus usuarios cuando Hy4 alcanzó su límite fue trasladar las tareas no urgentes a la noche. La misma idea se aplica a las llamadas a la API.
Cuándo activarlo: puedes combinar dos mecanismos. El primero se basa en una ventana horaria: ejecutar los trabajos por lotes durante las horas de menor demanda nocturna. El segundo se basa en la carga: si la tasa de 429 o la latencia P95 supera el umbral durante el día, se retrasa automáticamente la ejecución de la cola de procesamiento por lotes.
Cómo verificarlo: comprueba si disminuye el volumen de solicitudes durante las horas pico del día y si la tasa de finalización de las tareas nocturnas y la tasa de reintentos tras fallos se mantienen dentro de límites aceptables. Las tareas programadas fuera de las horas pico pueden reintentarse si fallan, pero también deben respetar el principio de idempotencia.
Punto de diseño 5: monitoreo y presupuesto
Cómo hacerlo: desglosa las estadísticas de uso por clave, modelo y tipo de tarea; no te fijes solo en el total. Aunque el volumen total se mantenga estable, el consumo de tokens de una tarea de agente podría haberse duplicado. Solo lo detectarás si revisas cada dimensión por separado. Establece también presupuestos y alertas temporales para el día del lanzamiento. Puedes flexibilizar un poco los umbrales de alerta, pero debes mantener el límite de presupuesto.
Cuándo activarlo: conviene que las reglas de alerta cubran cuatro señales: aumento repentino de la tasa de 429, aumento repentino de la tasa de 5xx, consumo de tokens por tarea por encima del valor de referencia y consumo del presupuesto diario superior a un determinado porcentaje.
Cómo verificarlo: antes del lanzamiento, haz una prueba con poco tráfico y confirma que el panel desglosa correctamente las dimensiones y que las alertas llegan en el plazo previsto.
| Métrica | Dimensiones de interés | Descripción |
|---|---|---|
Tasa de 429 |
Clave, modelo | Distinguir entre superar el límite de velocidad y agotar la cuota |
Tasa de 5xx |
Modelo | Determinar si el proveedor está sobrecargado y activar el cambio |
| Latencia P95 | Modelo, tipo de tarea | Medir las tareas largas por separado para evitar que eleven la referencia general |
| Longitud de la cola y tiempo de espera | Cola de prioridad | Observar si se acumulan las tareas de baja prioridad |
| Tokens/tarea, costo/tarea | Tipo de tarea | Las interacciones de varias rondas de los agentes y las llamadas a herramientas pueden multiplicarlos considerablemente |
| Número de cambios y tasa de éxito de la conmutación de respaldo | Correspondencia entre modelos principal y de respaldo | Determinar si el modelo de respaldo realmente absorbió el tráfico |
Para las estadísticas de costos puedes apoyarte en las funciones de la plataforma. La consola de APIYI apiyi.com permite consultar la lista de modelos, el uso, la facturación y los registros. Es útil para revisar el consumo real por clave y modelo el día del lanzamiento. Si además instrumentas tus propias métricas por tipo de tarea, podrás relacionar «cuánto se gastó» con «en qué se gastó».
Para estimar la capacidad, puedes calcular el QPS máximo a partir de los usuarios activos diarios, el volumen de solicitudes y el promedio de tokens, y luego multiplicarlo por el factor de amplificación de las interacciones de varias rondas de los agentes y las llamadas a herramientas. El pico del día del lanzamiento puede ser entre 3 y 10 veces el habitual. Conviene reservar entre un 30% y un 50% de capacidad adicional o tener listo un modelo de respaldo al que puedas cambiar en cualquier momento. Si estimas solo a partir de escenarios de chat, subestimarás considerablemente el consumo de los contextos largos y las llamadas a herramientas.
Inicio rápido con el cambio entre modelos: cómo validar la alternativa
Conclusión: una ruta alternativa que no se ha probado equivale a no tenerla. La validación debe completarse antes del despliegue.
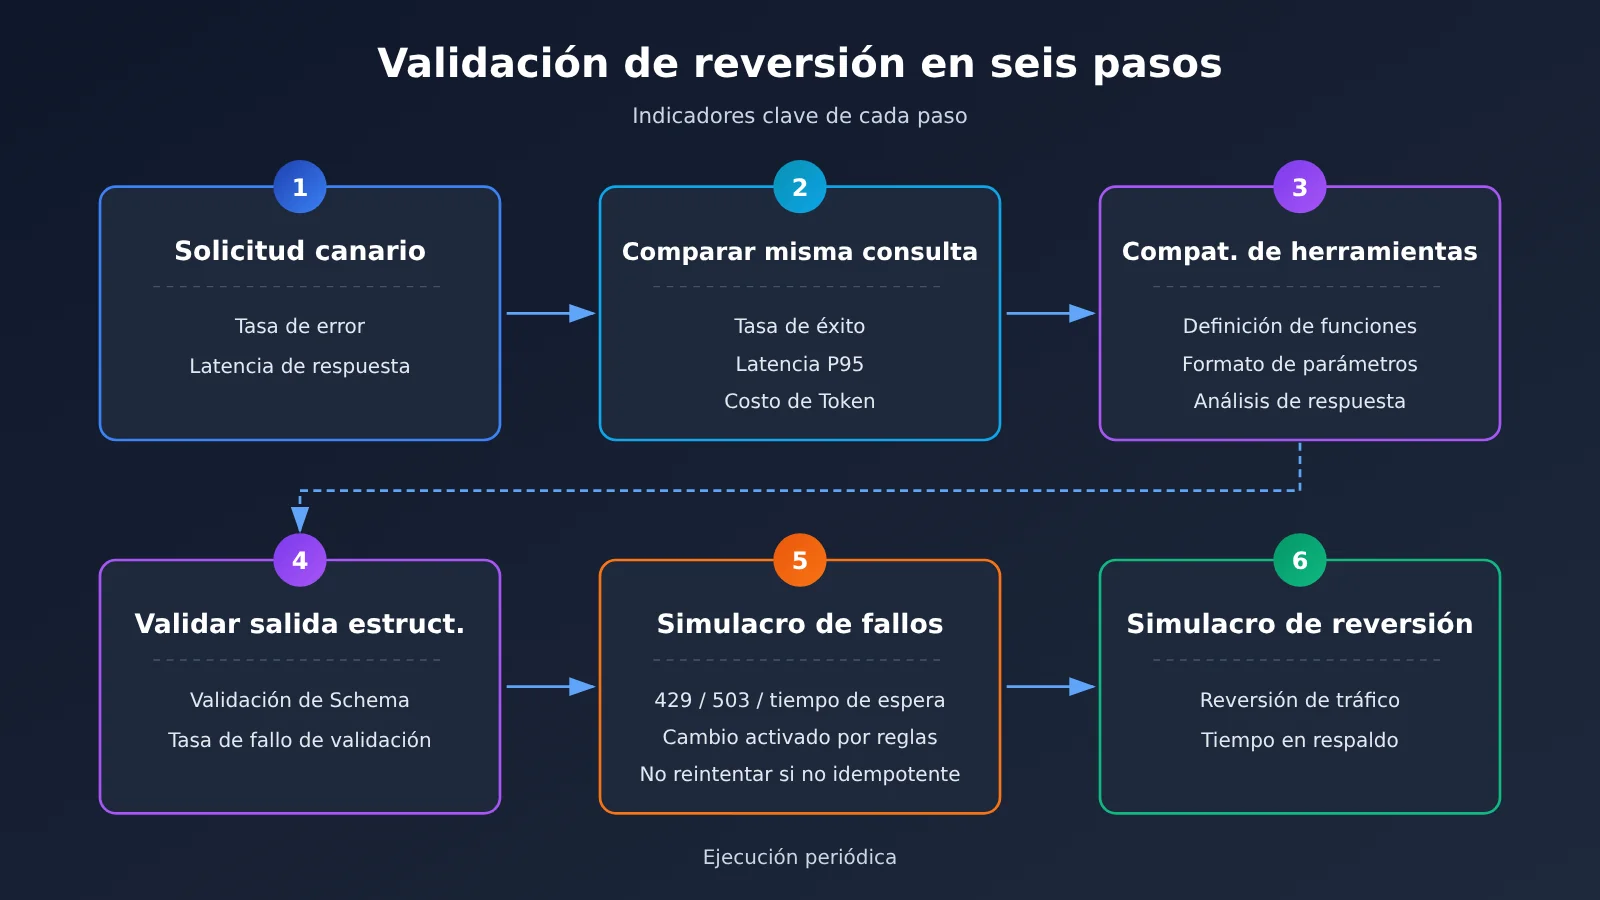
Los cambios en la integración no son complicados. Si ya usas un SDK compatible con OpenAI, solo tienes que establecer base_url como https://api.apiyi.com/v1 y sustituir api_key por la clave que proporciona la plataforma. Después podrás cambiar entre el modelo principal y el alternativo modificando el parámetro model, sin incorporar un cliente nuevo. Lo que sí requiere tiempo es la validación. Te recomendamos seguir este orden:
- Solicitudes canary: envía primero una pequeña parte del tráfico real al modelo alternativo y observa la tasa de errores y la latencia.
- Comparación con las mismas tareas: ejecuta un conjunto de evaluación fijo en ambos modelos y compara la tasa de éxito, la latencia P95 y el costo de los tokens.
- Compatibilidad de llamadas a herramientas: comprueba una por una las definiciones de funciones, el formato de los parámetros y el análisis de las respuestas en el modelo alternativo.
- Validación de salidas estructuradas: valida las salidas JSON contra un esquema y registra la tasa de fallos de validación.
- Pruebas de inyección de fallos: simula errores
429,503y tiempos de espera agotados para confirmar que el cambio se activa según las reglas y que las solicitudes no idempotentes no se reintentan automáticamente. - Prueba de reversión: una vez recuperado el modelo principal, confirma que el tráfico vuelve a él como se espera y no permanece demasiado tiempo en el modelo alternativo.
Lo ideal es realizar estas pruebas periódicamente, no solo una vez antes del despliegue. Los proveedores actualizan sus modelos y tus indicaciones y definiciones de herramientas también cambian, así que una configuración validada hace tres meses puede que ya no funcione hoy.
🚀 Inicio rápido: regístrate en APIYI apiyi.com y obtén crédito gratuito para pruebas. Usa la misma clave para comparar ambos modelos con las mismas tareas y después decide la configuración para el día del despliegue. Consulta los precios y la disponibilidad de los modelos en la consola y la documentación.
Preguntas frecuentes FAQ
En resumen: la mayoría de las dudas que surgen el día de lanzamiento de un modelo se reducen a identificar primero el tipo de error y luego decidir si conviene cambiar de modelo, esperar en cola o detenerse.
Q1: ¿Conviene limitar el tráfico en la aplicación antes del lanzamiento de un modelo?
Sí. Establecer de antemano un máximo de solicitudes simultáneas y una cola de prioridades en la aplicación ofrece más control que esperar a que el proveedor limite el tráfico con un `429`. Así puedes decidir qué usuarios y tareas tienen prioridad; el límite del proveedor no distinguirá las prioridades de tu negocio. Puedes calcular el umbral a partir del pico habitual y multiplicarlo por un factor estimado de aumento.
Q2: ¿Hay que cambiar de modelo inmediatamente al recibir un 429?
No necesariamente. Revisa primero `Retry-After`: si el tiempo de espera es aceptable para la tarea, espera y vuelve a intentarlo. Si supera el umbral o la respuesta indica claramente que la cuota se ha agotado, cambia al modelo alternativo. Al invocar modelos de distintos proveedores con una sola clave a través de APIYI apiyi.com, solo tienes que cambiar el nombre del modelo. Esto te permite ajustar los umbrales con más precisión, sin tener que cambiar todo el tráfico ante el primer `429`.
Q3: ¿Cómo se deben gestionar las colas de tareas no urgentes?
Asigna a las tareas no urgentes una cola y un grupo de concurrencia independientes, y establece un tiempo máximo de espera. Si se supera, no las descartes: aplázalas hasta la noche o un período de menor demanda. Monitorea la longitud de la cola, el tiempo de espera y la tasa de abandono. Las tareas fallidas pueden reintentarse, pero primero debes comprobar el estado de las que no sean idempotentes.
Q4: ¿El cambio automático a un modelo alternativo puede reducir la calidad de las respuestas?
Es posible. Por eso, antes de cambiar, compara las respuestas a las mismas preguntas y asegúrate de que la diferencia de calidad esté dentro de los límites aceptables para tu negocio. La descripción oficial de APIYI apiyi.com indica que admite el cambio automático a modelos alternativos y el balanceo de carga, pero las reglas de cambio se rigen por la documentación oficial. Debes verificar las diferencias de resultados con tu propio conjunto de evaluación. Para tareas sensibles a la calidad, es preferible esperar en cola por el modelo principal que cambiar directamente a otro.
Q5: ¿Cómo distinguir entre una cuota de producto agotada y un límite de tráfico de la API?
Fíjate en el origen y en cómo se aplica el límite. La cuota de producto aparece en la aplicación dirigida al usuario final, como la cuota de Hy4 en WorkBuddy; se calcula por cuenta y suele mostrarse mediante un aviso en la interfaz. El límite de tráfico de la API aparece en la respuesta de la interfaz como un `429`, que puede incluir `Retry-After`, y se calcula por clave, organización o modelo. En el primer caso, puedes cambiar de modelo dentro del producto o esperar a que se restablezca la cuota. En el segundo, puedes recurrir a la espera progresiva entre reintentos, las colas y la asignación de modelos alternativos.
Puntos clave sobre el cambio entre modelos y la programación fuera de horas pico
Conclusión: la estabilidad el día del lanzamiento depende de haber preparado de antemano los niveles de modelos, las colas y el presupuesto.
- La escasez de capacidad es previsible: alcanzar los límites de cuota el día que se lanza un modelo es parte del ciclo de producto; hay que planificarlo.
- Hay que clasificar los errores:
402,429,5xxy los tiempos de espera agotados requieren tratamientos distintos; no se pueden reintentar todos por igual. - Primero los niveles, luego el cambio: asigna las tareas a tres niveles —modelo insignia, general y ligero— y dirige solo una parte del tráfico al nuevo modelo al principio.
- Comprueba la correspondencia de respaldo: verifica una por una las capacidades, el contexto, la invocación de herramientas, la salida estructurada, el precio y las regiones.
- Detén las solicitudes no idempotentes: tras un fallo, comprueba primero el estado y decide después si vuelves a enviarlas.
- Reduce la carga en horas pico: programa las tareas que toleran retrasos durante la noche y reserva la concurrencia diurna para las urgentes.
- Desglosa la monitorización: consulta los registros de uso de APIYI apiyi.com para verificar el consumo real por Key y por modelo.
Resumen y lista de comprobación de capacidad para el día del lanzamiento
Conclusión: el día del lanzamiento, lo que marca la diferencia no es el número de reintentos, sino los niveles de modelos y las colas preparados de antemano.
Cuando un modelo nuevo alcanza su límite de cuota nada más lanzarse, suele deberse a una combinación de cuotas gratuitas, accesos concentrados, tareas largas y retrasos en la ampliación de capacidad del proveedor. Desde la aplicación, puedes asignar los destinos predeterminados según el nivel del modelo, preparar alternativas de respaldo, proteger las tareas críticas con colas de prioridad, suavizar los picos con programación fuera de horas punta y mantener visibles los riesgos y costos mediante la monitorización y los presupuestos. La siguiente lista divide las acciones entre antes y durante el día del lanzamiento y puede usarse directamente en la revisión previa a la puesta en producción.
| Fase | Comprobación | Criterio de cumplimiento |
|---|---|---|
| Antes del lanzamiento | Validar el modelo principal y el de respaldo | Ambos superan la comparación con las mismas tareas y las pruebas de invocación de herramientas y salida estructurada |
| Antes del lanzamiento | Distinguir los códigos de error | 402, 429, 500, 503, 529 y los tiempos de espera agotados tienen ramas de tratamiento independientes |
| Antes del lanzamiento | Detener las solicitudes no idempotentes | Los reintentos automáticos están desactivados para operaciones de escritura e invocaciones de herramientas de pago; tras un fallo se comprueba primero el estado |
| Antes del lanzamiento | Cola de prioridad | Hay tres niveles de prioridad, con concurrencia máxima, tiempo máximo en cola y degradación por tiempo de espera configurados |
| Antes del lanzamiento | Lista de tareas fuera de horas pico | Se enumeran las tareas por lotes que pueden aplazarse hasta la noche y se configuran reglas de activación según la carga |
| Antes del lanzamiento | Simulacro | Se completan y documentan las pruebas de inyección de fallos, cambio y reversión |
| Día del lanzamiento | Monitorización | Se consultan por Key, modelo y tarea la tasa de 429, la tasa de 5xx, la latencia P95 y la longitud de la cola |
| Día del lanzamiento | Presupuesto | Se establecen un presupuesto temporal y alertas, con umbrales más flexibles pero manteniendo un límite máximo |
| Día del lanzamiento | Seguimiento de los cambios | Se vigilan el número de cambios y la tasa de éxito de la reversión; cuando se recupera el modelo principal, se vuelve a él según lo previsto |
| Día del lanzamiento | Comunicación con las áreas de negocio | Se informa de antemano sobre los posibles retrasos y el alcance de la degradación |
Si estás preparando el próximo lanzamiento de un modelo, te recomendamos usar una sola Key a través de APIYI apiyi.com para probar tanto el modelo principal como el de respaldo. Después, usa los registros de consumo de la consola para establecer el presupuesto y completa cada punto de esta lista.
📚 Referencias
Conclusión: estas fuentes sirven para verificar cómo acceder a los modelos y qué funciones ofrece la plataforma. Para conocer los parámetros concretos, consulta la documentación oficial más reciente.
- Centro de documentación de APIYI: lista de modelos, descripción de interfaces, consulta de uso y facturación
- Enlace:
docs.apiyi.com -
Descripción: consulta los modelos disponibles, el uso de la interfaz compatible con OpenAI y la información sobre la conmutación automática a alternativas
-
Códigos de error de la API de OpenAI: significado de errores por límite de tasa como
429y recomendaciones para gestionarlos - Enlace:
platform.openai.com/docs/guides/error-codes -
Descripción: entiende la diferencia entre los límites de tasa y el agotamiento de la cuota
-
Errores de la API de Anthropic: incluye cómo gestionar errores de sobrecarga
- Enlace:
docs.anthropic.com/en/api/errors - Descripción: conoce el significado del error de sobrecarga
529
Autor: Equipo técnico de APIYI
Contacto técnico: Contáctanos desde la página de inicio de APIYI. Para consultar más información sobre la integración, visita el centro de documentación en docs.apiyi.com