Nota del autor: analizamos la arquitectura de dos capas Router + Worker de DeepSeek Super-agent, cómo separa la coordinación global de la ejecución independiente y cuándo conviene adoptar un diseño similar en tu propio sistema de agentes.
Si tienes abiertas cuatro o cinco ventanas de agentes de programación a la vez, te encontrarás con un problema muy práctico. Una ventana está corrigiendo un bug de inicio de sesión, otra está revisando una migración de base de datos y otra espera los resultados de CI. Tienes que recordar qué está haciendo cada una, cuál espera tu respuesta y qué tareas están relacionadas entre sí. Los modelos son cada vez más capaces de trabajar de forma independiente, pero la carga de gestionar esas sesiones sigue recayendo en las personas.
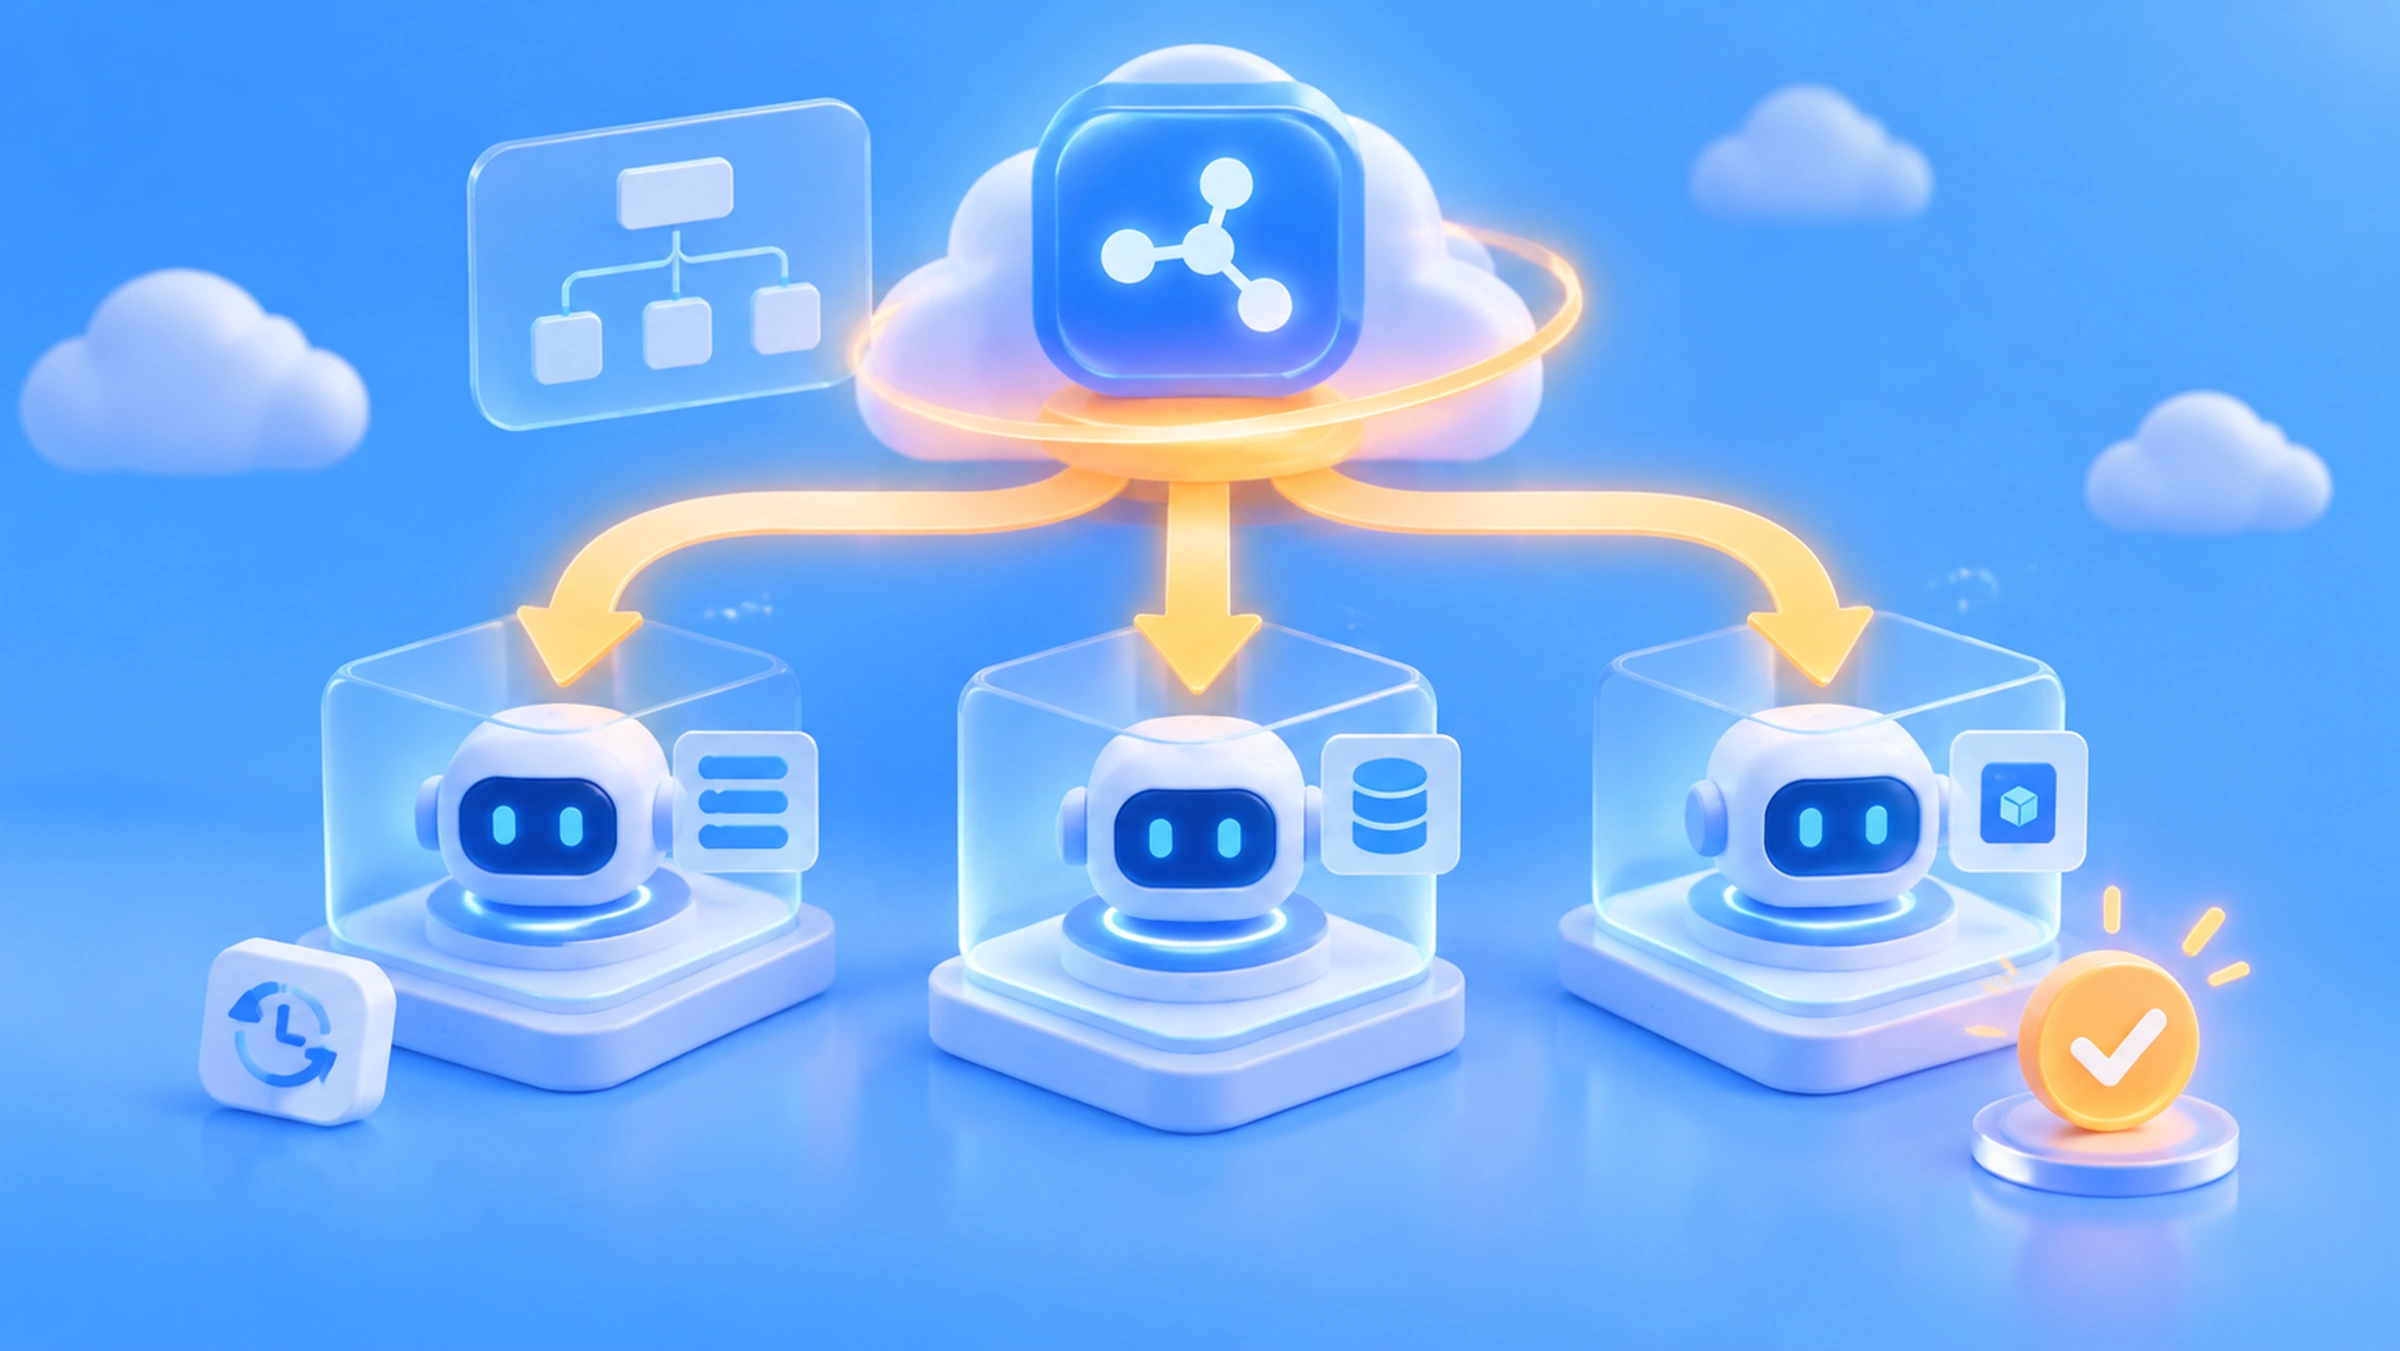
El 31 de octubre de 2026, el equipo de DeepSeek Harness publicó el artículo técnico «Exploración del diseño de Super-agent: hacia sistemas de agentes más autónomos» y liberó el prototipo de investigación dsh-superagent-prototype bajo licencia MIT. Su diseño central es la arquitectura de dos capas Router + Worker: un Router permanente se encarga de la coordinación global, mientras que varios Workers aislados ejecutan las tareas concretas.
Esto no es un truco para «hacer que una IA haga más cosas a la vez». La clave de Super-agent es separar la coordinación global de la ejecución independiente mediante la arquitectura del sistema, para reducir la carga de gestionar varias sesiones. En este artículo seguiremos el recorrido «problema, mecanismo, evidencia y valor para ingeniería» para explicar los motivos detrás del diseño, sus mecanismos principales, los datos de los experimentos oficiales y sus implicaciones para las llamadas a la API y la gestión de costos.
Qué te llevarás: al terminar, entenderás qué problema resuelve realmente la arquitectura de dos capas Router + Worker y podrás evaluar cuándo conviene adoptar un diseño similar en tu propio sistema de agentes.
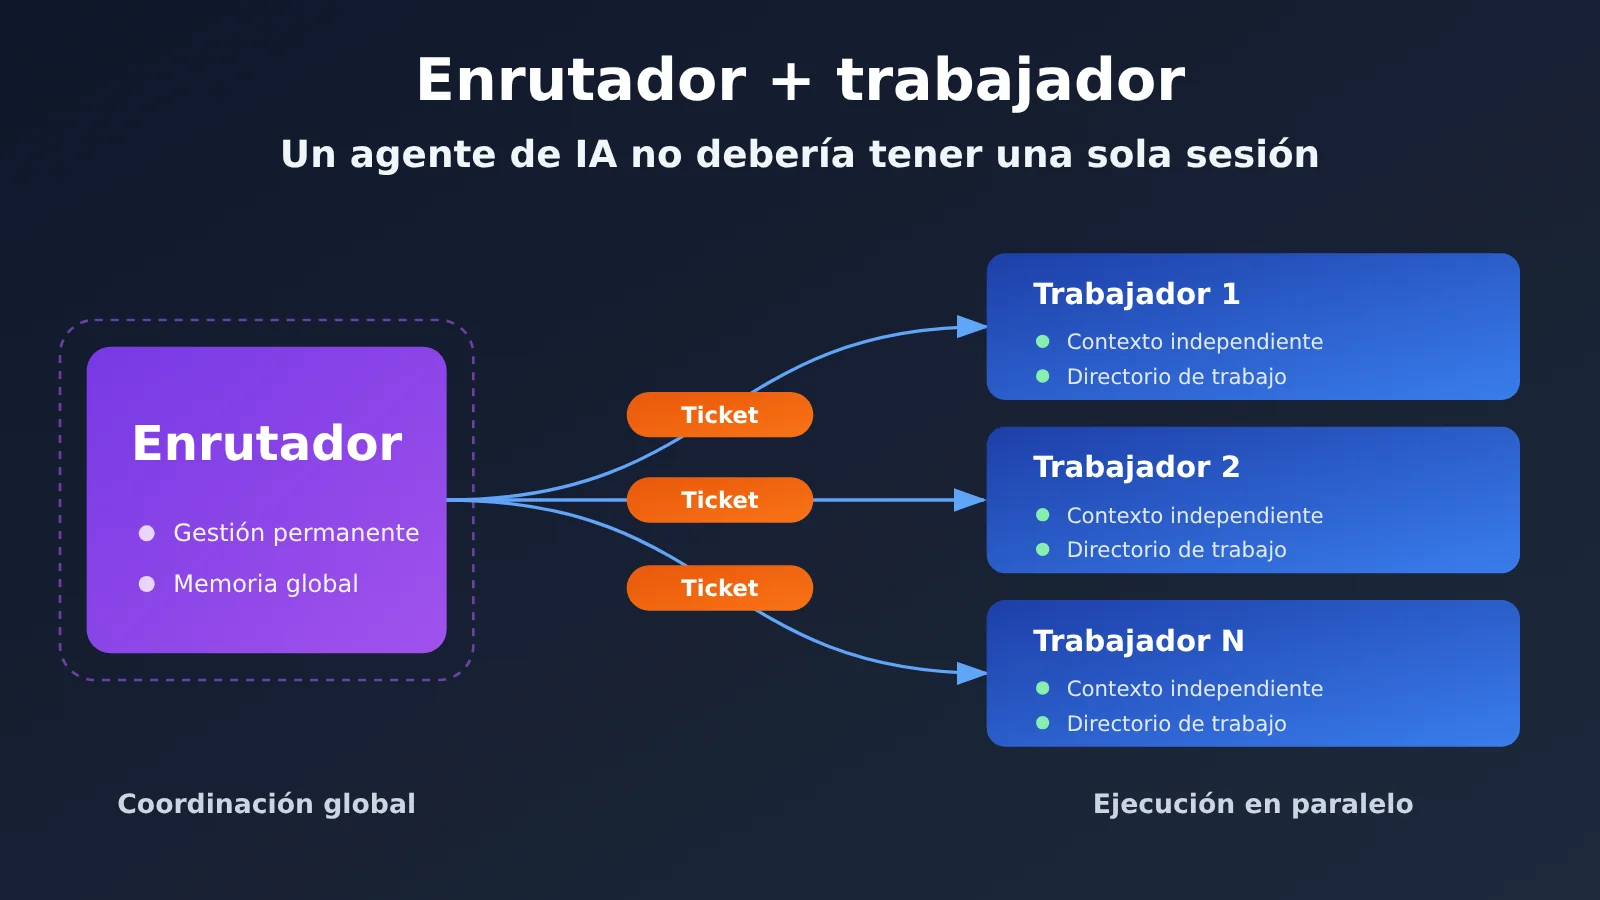
Router + Worker: datos clave de un vistazo
Antes de profundizar en la arquitectura, repasemos los datos básicos de este lanzamiento. Es importante aclarar que DeepSeek ha publicado como código abierto un prototipo de investigación, no un producto comercial oficial ni un nuevo modelo base.
| Información | Detalles |
|---|---|
| Fecha de lanzamiento | 31 de octubre de 2026 (el artículo técnico y el repositorio de GitHub se publicaron el mismo día) |
| Responsable | Equipo de DeepSeek Harness |
| Nombre del proyecto | dsh-superagent-prototype, desarrollado principalmente en TypeScript y con licencia MIT |
| Naturaleza del proyecto | Prototipo de investigación, no un producto comercial oficial; depende de DeepSeek Harness para funcionar |
| Arquitectura principal | Estructura de dos capas: Router para la coordinación global y Worker para la ejecución aislada |
| Funciones actuales | Monitorización de un único repositorio de GitHub, integración opcional con Feishu, gestión de tickets, sesiones independientes de Worker y generación de PR |
| Interés de la comunidad | Alrededor de 8900 estrellas y 898 forks al 2 de noviembre (las cifras cambian constantemente) |
DeepSeek ha definido cuatro características como objetivos para Super-agent: Continuous (continuidad del contexto entre canales), Productive (ejecución paralela de varias tareas), Proactive (respuesta proactiva a eventos dentro de los permisos concedidos) y Persistent (funcionamiento continuo y capacidad de recuperarse de algunos fallos). Son objetivos de diseño, no una garantía de que el prototipo de código abierto ya los cumpla todos.
Por qué un agente de IA no debería tener una sola sesión
El equipo de DeepSeek considera que el cuello de botella de las herramientas de programación con IA está pasando de la «capacidad del modelo» a la «atención humana». Según sus observaciones diarias, una persona suele poder seguir de forma efectiva entre 3 y 5 sesiones activas de agentes. Es una estimación basada en la experiencia del equipo, no una estadística pública de usuarios a gran escala, pero describe bien la sensación que tienen muchos desarrolladores.
El dilema entre una y varias sesiones
Las dos soluciones más habituales tienen limitaciones importantes. La arquitectura Router + Worker se propone precisamente para combinar la «continuidad del contexto global» con la «capacidad de procesamiento paralelo en segundo plano».
| Arquitectura | Ventajas | Problema principal |
|---|---|---|
| Una sola sesión para todo el trabajo | El contexto global se mantiene continuo de forma natural | La información de las tareas se mezcla; las llamadas a herramientas de larga duración bloquean las nuevas tareas; está limitada por un único bucle ReAct |
| Una sesión independiente por tarea | Permite la ejecución en paralelo y aísla los contextos | Falta memoria global; la persona debe recordar la relación entre tareas; las conversaciones y notificaciones se dispersan en varias ventanas |
| Arquitectura de dos capas Router + Worker | Estado global centralizado y contextos de ejecución aislados | Mayor consumo de recursos de inferencia; el Router puede convertirse en un cuello de botella |
El problema de una sola sesión es que se «atasca»; el de varias sesiones es que todo queda «disperso». En el primer caso, una ventana de contexto tiene que cargar con los pasos intermedios de todas las tareas; en el segundo, todo el costo de coordinación recae sobre la persona. La idea de DeepSeek es introducir, a nivel de sistema, un rol dedicado a «recordar el contexto global», para que los ejecutores puedan concentrarse en ejecutar.
Cómo funciona la arquitectura de dos capas Router + Worker
Router: la capa de coordinación y planificación global
El Router es una capa lógica que permanece activa. En la exploración actual de la arquitectura oficial, se implementa principalmente mediante una sesión de LLM persistente, aunque conceptualmente no tiene por qué equivaler a una única sesión del modelo. Su función es «gestionar», no «ejecutar»:
- Recibir de forma centralizada los mensajes del usuario y los eventos externos de GitHub, IM, CI y otras fuentes;
- Mantener la relación entre las tareas y decidir si es necesario crear una nueva;
- Comprobar los permisos, asignar tareas a los Workers y coordinar el trabajo entre tareas;
- Recopilar la información que debe entregarse a una persona y, cuando sea necesario, recuperar el contexto de tareas anteriores.
Un detalle importante es que, según el equipo oficial, el Router podría incluso prescindir de la herramienta Bash. Al no ejecutar directamente tareas complejas de programación, evita quedar bloqueado durante llamadas prolongadas a herramientas. Además, sus tareas no suelen requerir el modelo de razonamiento más potente: a veces basta con uno más ligero para gestionar las interacciones y asignaciones. Esto ofrece una base técnica para configurar distintos modelos según su función.
Worker: la capa de ejecución aislada de tareas
El Worker se encarga del trabajo concreto. En el prototipo público, cada Ticket corresponde a una sesión de Executor y cuenta con su propio directorio de trabajo. Dentro de los permisos concedidos, el Worker modifica código, ejecuta pruebas y atiende los comentarios posteriores. Al terminar, genera un Report; si hace falta una decisión humana, establece el estado Attention. Los resultados se entregan por el canal original, por ejemplo, mediante un PR de GitHub.
El contexto del modelo es independiente para cada Worker, lo que evita que los pasos intermedios de distintas tareas se mezclen en una misma ventana. Pero hay un matiz importante: una sesión y un directorio independientes no equivalen a un aislamiento de seguridad robusto. La documentación oficial de despliegue señala que, por defecto, los Workers ejecutan comandos con la cuenta de usuario del sistema operativo del operador.
Cómo recorre un GitHub Issue el flujo Router + Worker
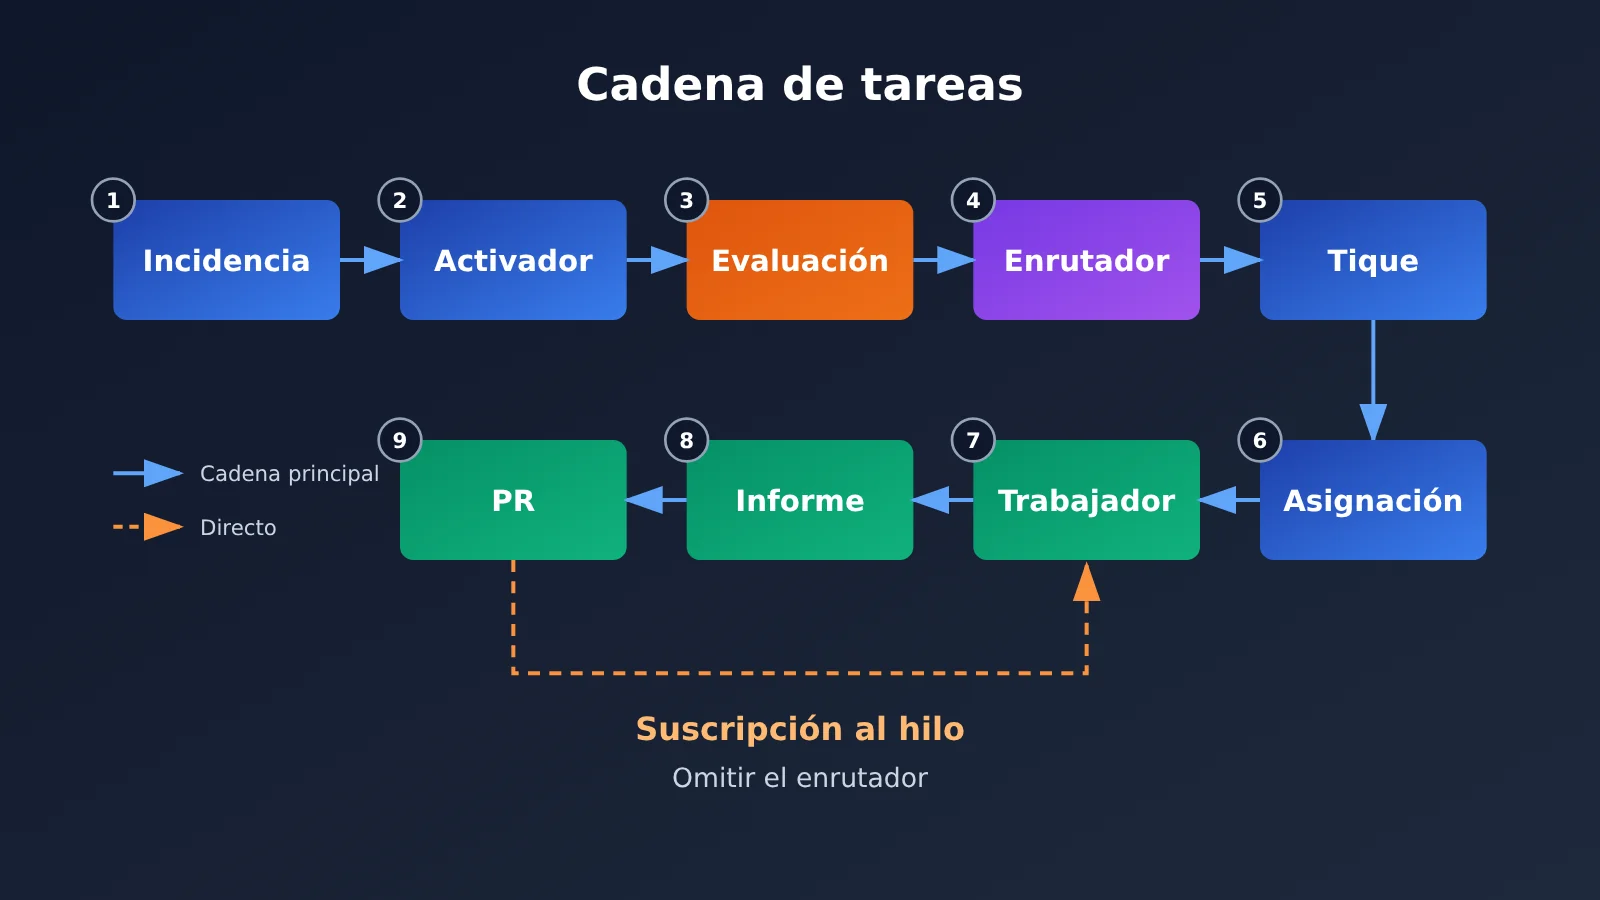
Según el Domain Model de la implementación de código abierto, el flujo de tareas se resume así: Source → Trigger → Eval → Decision → Ticket → Assignment → Executor → Report. Tomemos como ejemplo a un usuario autorizado que solicita corregir un bug en un Issue de GitHub:
- GitHub Source recibe un comentario en el Issue y genera un Trigger;
- El sistema filtra primero los permisos mediante reglas deterministas y después el modelo evalúa si la solicitud cumple los criterios para aceptarla;
- El Router acepta la tarea y crea un Ticket que registra su alcance y los permisos concedidos (Mandate);
- El sistema crea una Assignment para el Ticket y la asigna al Worker correspondiente;
- El Executor realiza la corrección en un directorio y una sesión independientes;
- El Worker informa del progreso o presenta el resultado y genera un PR;
- El sistema entrega el resultado al usuario a través del hilo del Issue o PR original.
Si después el usuario solicita cambios en ese PR, el nuevo mensaje puede vincularse automáticamente con la tarea original. Así, no tiene que buscar qué sesión de agente estaba trabajando en el asunto: un ejemplo concreto de cómo la arquitectura de dos capas reduce la carga de gestión para las personas.
4 diseños clave de Router + Worker
La arquitectura de dos capas es solo el esqueleto; lo que realmente la hace funcional son varios diseños de ingeniería específicos. Cada uno responde a un problema concreto:
| Diseño | Problema de ingeniería que resuelve | Mecanismo principal |
|---|---|---|
| Entrega directa mediante suscripción a Thread | Todos los mensajes posteriores pasan por el Router, lo que sobrecarga el nodo central | El Worker se suscribe al Thread del que es responsable y recibe directamente los eventos relacionados |
| Procesamiento por lotes del Router | Cuando llegan ráfagas de eventos, procesarlos uno a uno limita el rendimiento del Router | Los Trigger acumulados durante el razonamiento se combinan en un lote para analizarlos |
| Inline & Spill | La ventana de contexto es limitada e inyectar todo el contenido resulta costoso | La información reciente y necesaria se incluye en la ventana; del contenido extenso solo se conserva un resumen y un puntero de lectura |
| Recuperación en cadena | Es difícil recuperar información de tareas anteriores | Se sigue la relación entre Trigger, Thread, Ticket y Worker para buscar paso a paso |
Entrega directa mediante suscripción a Thread: menos reasignaciones del Router
Supongamos que el Worker A está a cargo de un PR. Los comentarios posteriores y los resultados de CI pueden entregarse directamente al Worker A según el Thread al que pertenecen, sin que el Router tenga que tomar una nueva decisión por cada mensaje relacionado. Es un ejemplo típico de cómo descargar del nodo central decisiones frecuentes que aportan poco valor.
Pero la entrega directa por suscripción tiene límites de autorización claros. La documentación oficial especifica que los mensajes de la suscripción pueden aportar contexto, pero no pueden ampliar el Mandate del Ticket original. Si un comentario posterior solicita trabajo nuevo fuera del alcance autorizado, el Worker debe devolverlo al sistema para que lo vuelva a evaluar. Esto es importante para protegerse de instrucciones no autorizadas en comentarios externos.
Procesamiento por lotes del Router: respuesta a ráfagas de eventos
Mientras el Router realiza una ronda de razonamiento, los nuevos Trigger se acumulan y se analizan juntos como un lote en la siguiente ronda. Esto equivale a pasar de «una invocación del modelo por mensaje» a «varios mensajes por ronda de razonamiento», lo que reduce considerablemente el costo de razonamiento por decisión cuando hay muchos eventos.
Inline & Spill y recuperación en cadena: el contexto como caché
DeepSeek trata la ventana de contexto como una especie de caché. Inline consiste en incluir directamente en la ventana la información reciente que probablemente se necesite, como los últimos comentarios de la tarea actual, las líneas de código relevantes y el código circundante necesario. Spill consiste en dejar fuera de la ventana el contenido poco frecuente o demasiado extenso, como una discusión histórica larga, y conservar solo un resumen, los ID asociados y un punto de acceso para leerlo. Los mensajes históricos que no son relevantes no tienen que inyectarse cada vez.
A partir de esta idea surge Chain of Recall (recuperación en cadena): el modelo puede seguir las relaciones entre los objetos Trigger → Thread → Ticket → Worker para recuperar información histórica paso a paso y según sea necesario. Esto ahorra más contexto que «introducir todo el historial cada vez» y se parece más a una consulta de base de datos mediante índices. Sin embargo, el equipo también reconoce que la memoria que abarca varios meses o períodos aún más largos sigue siendo un problema sin resolver.
Interpretación de los datos del experimento Router + Worker
DeepSeek realizó una serie de experimentos preliminares con cargas de trabajo sintéticas. Cada simulación incluía unas 300 interacciones: alrededor de 20 eran solicitudes de trabajo y el resto eran charlas, comentarios de seguimiento, cancelaciones y mensajes de CI. Cada configuración se ejecutó 5 veces. El trabajo de programación se sustituyó por herramientas simuladas que consumían tiempo, por lo que los datos miden el rendimiento del sistema de coordinación, no la calidad del código generado.
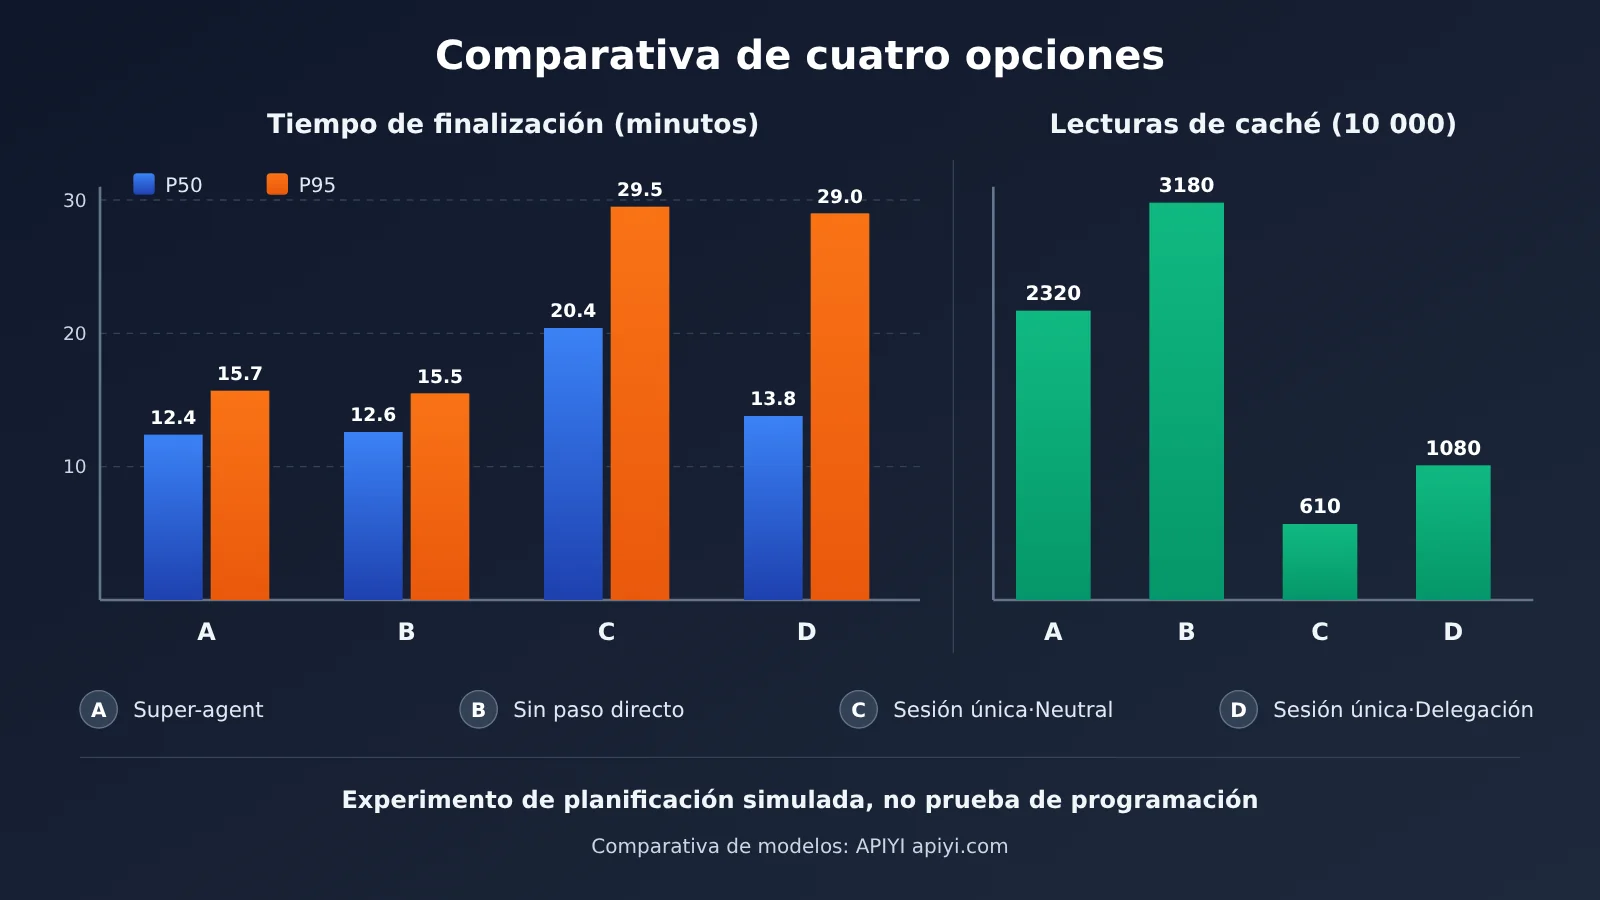
Comparación de la coordinación de extremo a extremo
| Configuración | Tiempo de finalización P50 | Tiempo de finalización P95 | Tokens de lectura de caché por experimento |
|---|---|---|---|
| Super-agent | 12,4 minutos | 15,7 minutos | Aproximadamente 23,2 millones |
| Super-agent, sin paso directo de suscripciones | 12,6 minutos | 15,5 minutos | Aproximadamente 31,8 millones |
| Sesión única + Subagent, indicación neutral | 20,4 minutos | 29,5 minutos | Aproximadamente 6,1 millones |
| Sesión única + Subagent, delegación prioritaria | 13,8 minutos | 29,0 minutos | Aproximadamente 10,8 millones |
Frente a la configuración de sesión única con indicación neutral, Super-agent redujo el tiempo de finalización P50 en aproximadamente un 39 % y el P95 en un 47 %. Frente a la configuración de sesión única con delegación prioritaria, la ventaja en P50 fue pequeña, pero la cola de tiempos más largos, reflejada en el P95, fue notablemente más corta. En otras palabras, el mayor beneficio de la arquitectura de dos capas es evitar que las tareas más lentas se prolonguen demasiado.
El costo también es claro: Super-agent leyó aproximadamente 3,8 veces más tokens de caché que la configuración de sesión única con indicación neutral. Utiliza más sesiones paralelas y recursos de inferencia para conseguir tiempos de finalización más cortos y estables. Pero eso no significa que el costo total aumente 3,8 veces: el gasto real también depende del precio de cada modelo, los aciertos de caché, los tokens de entrada y salida normales, los modelos elegidos para Router y Worker y las llamadas a herramientas. DeepSeek tampoco ha publicado todavía el gasto medio de API para solicitudes de trabajo reales.
El experimento de ablación del paso directo de suscripciones también merece atención. Al eliminarlo, el número de decisiones que debía procesar Router aumentó aproximadamente un 30 % y los tokens de lectura de caché, un 37 %, mientras que el tiempo de finalización apenas cambió. La conclusión es que, en esta prueba, el paso directo de suscripciones ahorra principalmente invocaciones del modelo y carga de contexto en Router, en lugar de acelerar directamente el proceso.
Prueba de estrés del procesamiento por lotes de Router
En estas pruebas, Router utilizó un modelo real y Worker, un modelo simulado:
| Métrica | Baja densidad de eventos | Alta densidad de eventos |
|---|---|---|
| Ritmo de llegada de eventos | Aproximadamente 1 por minuto | Aproximadamente 40 por minuto |
| Tamaño medio del lote | 1,0 | 2,8 |
| Duración de cada solicitud al modelo | 2,5 segundos | 3,9 segundos |
| Tiempo de inferencia por decisión | 6,4 segundos | 1,6 segundos |
Al aumentar la densidad de eventos, cada solicitud tardó más, pero el tiempo de inferencia por decisión disminuyó, lo que indica que el procesamiento por lotes mejoró el rendimiento efectivo. La conclusión oficial es prudente: con el tamaño actual del equipo, un solo Router basta por ahora, pero eso no significa que pueda procesar una cantidad ilimitada de mensajes.
Impacto de Router + Worker para desarrolladores
Niveles de modelos: un modelo ligero para el Router y uno según la tarea para el Worker
La conclusión de ingeniería más directa de esta arquitectura de dos niveles es que no todos los roles necesitan usar el mismo modelo. El Router se encarga principalmente de clasificar, asignar y resumir tareas, por lo que le conviene un modelo rápido y de bajo costo. Para el Worker, en cambio, se puede elegir un modelo con mayor capacidad de razonamiento según la complejidad de la tarea. El propio prototipo también permite especificar por separado el proveedor y el modelo para el Router y el Worker.
Este ejemplo mínimo usa una misma interfaz compatible con OpenAI para que el Router decida cómo asignar una tarea:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口,一个 Key 切换多家模型
)

ROUTER_MODEL = "your-fast-cheap-model"   # 替换为控制台中可用的轻量模型名

resp = client.chat.completions.create(
    model=ROUTER_MODEL,
    messages=[{"role": "user", "content": "判断这条 Issue 评论是否需要新建 Ticket:修复登录页 500 错误"}]
)
print(resp.choices[0].message.content)
Ver código de ejemplo de invocación por niveles con Router + Worker
import json
import openai
from typing import Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 角色与模型分层:模型名请替换为你实际可用的模型
ROLE_MODELS: Dict[str, str] = {
    "router": "your-fast-cheap-model",
    "worker_simple": "your-mid-tier-model",
    "worker_complex": "your-strong-reasoning-model",
}

usage_log = []  # 按 Ticket 记录 Token 消耗

def call(role: str, ticket_id: str, prompt: str) -> str:
    resp = client.chat.completions.create(
        model=ROLE_MODELS[role],
        messages=[{"role": "user", "content": prompt}],
    )
    u = resp.usage
    usage_log.append({
        "ticket": ticket_id, "role": role,
        "input": u.prompt_tokens, "output": u.completion_tokens,
    })
    return resp.choices[0].message.content

def router_dispatch(ticket_id: str, event: str) -> str:
    prompt = (
        "你是任务调度器,只做分类,不执行任务。"
        "输出 JSON:{\"accept\": bool, \"complexity\": \"simple\"|\"complex\"}\n"
        f"事件:{event}"
    )
    decision = json.loads(call("router", ticket_id, prompt))
    if not decision["accept"]:
        return "ignored"
    role = "worker_complex" if decision["complexity"] == "complex" else "worker_simple"
    return call(role, ticket_id, f"在授权范围内处理任务:{event}")

print(router_dispatch("T-001", "CI 失败:单元测试 test_login 超时"))
print(usage_log)
🎯 Consejo técnico: Al crear agentes por niveles, prueba primero con la misma clave API de APIYI en apiyi.com cómo se desempeñan los modelos ligeros y los de razonamiento avanzado en los roles de Router y Worker. Así podrás decidir la configuración final sin recurrir al modelo más caro para todos los roles.
Control de costes: registrar los gastos por ticket, no solo en el balance general
Los experimentos oficiales muestran que la arquitectura de dos capas consume más recursos de inferencia, por lo que exige un control de costes más detallado. Estas son algunas prácticas útiles:
- Registrar los tokens por ticket: separar el coste de las decisiones del Router del coste de ejecución de los Workers para identificar qué tipos de tareas son más caros;
- Distinguir los tipos de gastos: contabilizar por separado los costes de los modelos, las herramientas —como la búsqueda y la obtención de páginas web— y el entorno de ejecución;
- Vigilar los aciertos de caché: la mayor parte de los tokens de Super-agent corresponde a lecturas de caché, y el precio por unidad puede variar mucho entre un acierto y un fallo. Según los precios oficiales de DeepSeek, la diferencia puede ser de varias decenas de veces;
- Reducir las decisiones innecesarias: aplicar la idea de las suscripciones directas para que los eventos posteriores lleguen directamente al Worker responsable y evitar que el Router tenga que asignarlos de nuevo.
💰 Optimización de costes: ejecutar varios Workers en paralelo puede multiplicar el número de llamadas. Con APIYI apiyi.com puedes invocar modelos de distintos proveedores con pago por uso y comparar en una misma factura el gasto real de cada rol y modelo, lo que facilita la optimización por capas.
Cuándo conviene adoptar Router + Worker
Una arquitectura de dos capas no es mejor solo por ser más compleja. Estas pautas pueden ayudarte a decidir:
- Conviene adoptarla: cuando hay varios asuntos independientes en curso —por ejemplo, el ticket A corrige un bug, el ticket B revisa una migración y el ticket C se ocupa de CI—, los eventos llegan por varios canales y hay que responder de forma continua;
- Puede esperar: cuando hay pocas tareas, dependen mucho unas de otras o el trabajo consiste principalmente en repartir una sola tarea compleja. En esos casos, un solo agente o un Agent Team tradicional consume menos recursos;
- Primero hay que completar la infraestructura: si aún no están listos el aislamiento de permisos, la gestión de conflictos al modificar archivos o los registros de facturación por tarea, empezar a trabajar en paralelo puede aumentar los riesgos.
También conviene tener en cuenta que Router + Worker y un Agent Team convencional tienen enfoques distintos. Un Agent Team suele dividir una tarea compleja entre roles de investigación, programación y pruebas. En Super-agent, el Router se centra más en coordinar varios asuntos independientes, sin entrar en los detalles técnicos de cada tarea. La documentación oficial también señala que, si la sesión principal de un Agent Team convencional se limita a centralizar la interacción y distribuir el trabajo entre tareas, puede formar una estructura similar: la arquitectura de dos capas no es un concepto exclusivo de DeepSeek.
Limitaciones de la arquitectura Router + Worker y alcance del prototipo
Al analizar este tipo de arquitectura, es fácil confundir el diseño completo descrito en los documentos con las funciones que ya ofrece el prototipo de código abierto. Conviene distinguir lo que indican las fuentes:
- Ya disponible en el prototipo: seguimiento de un único repositorio de GitHub, integración opcional con Feishu, gestión de tickets, sesiones y directorios independientes para cada Worker, generación de PR, visualización en el panel de administración de las tareas que requieren intervención humana y continuación del trabajo a partir de mensajes posteriores;
- Diseñado, pero sin pruebas de una implementación completa: gestión automática de varios repositorios, ejecución continua en la nube a nivel de producción y entornos multidispositivo, y reparación autónoma completa mediante un Watchdog independiente. El bucle ReAct asíncrono ya está implementado en Harness, pero todavía no está activado por defecto;
- La proactividad tiene límites: el trabajo inferido usa por defecto el modo
observe, que solo registra y no ejecuta acciones; la fusión automática de PR está desactivada por defecto.
A nivel de arquitectura, aún hay varios retos reconocidos públicamente. El primero es la escalabilidad de un único Router: la documentación oficial solo afirma que basta para el tamaño actual del equipo, pero no responde a cómo distribuirlo en fragmentos a mayor escala. El segundo es la memoria a largo plazo: Inline & Spill y la recuperación encadenada resuelven el contexto a corto y medio plazo, pero la memoria que se extiende durante meses sigue sin resolverse. El tercero son los límites de permisos: Router y Worker se ejecutan por defecto en modo danger-full-access, con la identidad del usuario del sistema que los opera; la recomendación oficial es utilizar un usuario de sistema independiente. La inyección de indicaciones mediante comentarios externos y la gestión de credenciales también figuran entre los problemas pendientes. En la comunidad se publicó además un informe de auditoría de código de un tercero sobre un commit concreto, pero el ataque completo no se ha reproducido de forma independiente, así que solo puede considerarse un riesgo potencial.
Las pruebas de la comunidad también confirman que se trata de un prototipo: un usuario siguió SETUP.md y consiguió completar el flujo de extremo a extremo, desde un Issue hasta un PR, partiendo de un clon nuevo. Al mismo tiempo, informó de problemas con la identificación de procesos de Node.js 24, mensajes perdidos por retrasos en las notificaciones de GitHub y fallos en las aserciones de las pruebas cuando el idioma del sistema era chino.
Preguntas frecuentes (FAQ)
Q1: ¿Qué es la arquitectura de dos capas Router + Worker?
Es la estructura básica de DeepSeek Super-agent: el Router funciona como una capa permanente de coordinación global, encargada de recibir eventos, mantener las relaciones entre tareas y asignar el trabajo. El Worker es la capa de ejecución aislada: cada Ticket se resuelve en una Session y un directorio independientes. La clave está en separar la coordinación global de la ejecución independiente.
Q2: ¿En qué se diferencia Router + Worker de un equipo convencional de múltiples agentes?
Un equipo de agentes convencional suele dividir una tarea compleja entre roles como investigación, programación y pruebas. Router + Worker, en cambio, pone el énfasis en coordinar varios trabajos independientes entre sí, sin que el Router entre en los detalles de cada tarea. Si la sesión principal de un equipo convencional solo se encarga de la interacción unificada y de asignar trabajo entre tareas, también puede formar una estructura similar de dos capas.
Q3: ¿El experimento oficial demuestra que Super-agent mejora la eficiencia de programación en un 47 %?
No. El experimento utilizó herramientas de programación simuladas, ejecutó cada alternativa solo 5 veces y midió el tiempo de finalización de la planificación de tareas, no la calidad del código ni la capacidad de programación. La reducción de aproximadamente un 47 % en el P95 solo indica que, con esa carga sintética, los casos más lentos de la planificación tardaron menos. No se puede extrapolar a una mejora real de la eficiencia de programación ni utilizar para comparar la capacidad de programación con Claude Code o Codex.
Q4: ¿Router + Worker permite ahorrar dinero?
No necesariamente. En el experimento sintético oficial, Super-agent realizó aproximadamente 3,8 veces más lecturas de caché que la alternativa neutral de una sola sesión: utilizó más recursos a cambio de velocidad y estabilidad. La oportunidad de ahorro está en asignar modelos por capas: usar un modelo ligero para el Router y elegir el modelo del Worker según la complejidad. Con APIYI apiyi.com puedes probar el costo real de distintas combinaciones de modelos mediante una interfaz unificada y elegir la que más te convenga.
Q5: ¿Cómo puedo comprobar rápidamente en mi proyecto la asignación de modelos por capas de Router + Worker?
Te recomendamos seguir estos pasos:
1. Regístrate en APIYI apiyi.com para obtener una clave API y crédito gratuito de prueba;
2. Utiliza el código de este artículo y configura base_url como `https://api.apiyi.com/v1`;
3. Configura distintos modelos para el Router y el Worker, registra el consumo de tokens por Ticket y compara los resultados.
La compatibilidad con la interfaz de OpenAI significa que, para cambiar de modelo, solo tienes que modificar el parámetro model.
Q6: ¿Se puede usar directamente el prototipo de código abierto en un entorno de producción empresarial?
Por ahora no se recomienda usarlo directamente en producción. Es un prototipo de investigación: el Worker se ejecuta por defecto con la identidad y los altos privilegios del operador, no admite GitHub Enterprise Server y la comunidad también ha informado de fallos, como notificaciones que no llegan, y posibles problemas de seguridad. Lo más adecuado es utilizarlo en un entorno aislado para validar el diseño del flujo de trabajo.
Puntos clave de Router + Worker
- Enfoque principal: Super-agent es una arquitectura de sistema externa al modelo. Lo que se ha publicado como código abierto es un prototipo de investigación, no un producto comercial.
- El problema de fondo: el cuello de botella pasa de la capacidad del modelo a la atención humana. Una sola sesión se «atasca»; con varias, el trabajo se dispersa.
- Separación de responsabilidades: el Router se encarga únicamente de la coordinación global y puede incluso prescindir de Bash. Los Workers ejecutan tareas de forma independiente en sesiones aisladas.
- Mecanismos clave: la comunicación directa mediante suscripciones reduce las decisiones que debe tomar el Router; el procesamiento por lotes reparte el coste de inferencia, e Inline & Spill trata el contexto como una caché.
- Límites de los datos: los experimentos de planificación muestran tiempos de finalización más cortos para las tareas más lentas, pero un mayor consumo de tokens. Además, no son una medida de la capacidad de programación.
- Cómo empezar: puedes usar la interfaz unificada de APIYI apiyi.com para configurar distintos modelos según el rol y gestionar los costes por Ticket.
Resumen
DeepSeek ha utilizado Router + Worker para responder a la pregunta: «¿Por qué un AI Agent no debería tener una sola sesión?».
- Valor de la arquitectura: separa la coordinación global de la ejecución independiente, para que sea el sistema quien recuerde las relaciones entre tareas y no la persona.
- Diseño de ingeniería: la comunicación directa mediante suscripciones, el procesamiento por lotes, Inline & Spill y la recuperación encadenada abordan, respectivamente, la carga central, el rendimiento ante picos, la capacidad de contexto y la recuperación del historial.
- Una visión realista: los experimentos muestran el equilibrio entre la eficiencia de planificación y el consumo de recursos. La escalabilidad de un único Router, la memoria a largo plazo y el aislamiento de permisos siguen pendientes de resolver.
Si tu sistema ya necesita atender varios asuntos independientes al mismo tiempo, merece la pena tomar como referencia esta arquitectura de dos capas. Si las tareas son pocas y están concentradas, un solo Agent sigue siendo una opción más económica. Sea cual sea la estructura, asignar modelos por niveles y contabilizar el gasto por tarea es clave para controlar los costes.
Recomendamos usar APIYI apiyi.com para probar rápidamente cómo funcionan distintos modelos en los roles de Router y Worker. La plataforma ofrece una interfaz compatible con OpenAI, facturación por uso y crédito gratuito de prueba para nuevos usuarios.
📚 Referencias
- Artículo oficial de DeepSeek sobre la arquitectura: Exploración del diseño de Super-agent: hacia sistemas de agentes más autónomos
- Enlace:
x.com/DeepSeekHarness/article/2116857257245987236 -
Descripción: Fuente primaria sobre la arquitectura de dos capas, los cinco módulos, los datos experimentales y los problemas pendientes.
-
Repositorio oficial de DeepSeek en GitHub: dsh-superagent-prototype
- Enlace:
github.com/deepseek-ai/dsh-superagent-prototype -
Descripción: Estado del proyecto, código fuente, protocolos y alcance actual.
-
Documentación del modelo de dominio de código abierto: objetos de tarea y modelo de flujo
- Enlace:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/001-domain.md -
Descripción: Definiciones de conceptos clave como Source, Trigger, Ticket y Assignment.
-
Documentación de autorización y suscripciones: reglas de suscripción de Mandate y Thread
- Enlace:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/002-authorization.md -
Descripción: Explicación oficial de por qué los mensajes de suscripción no pueden ampliar el alcance de la autorización.
-
Documentación de despliegue: dependencias, cuentas y recomendaciones de seguridad
- Enlace:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/006-deployment.md -
Descripción: Modo de ejecución con privilegios elevados y recomendación de usar un usuario de sistema independiente.
-
Precios oficiales de DeepSeek API: precios de modelos y herramientas
- Enlace:
api-docs.deepseek.com/quick_start/pricing - Descripción: Diferencias de precio según si hay o no un acierto de caché; referencia para estimar costos.
Autor: Equipo técnico de APIYI
Intercambio técnico: Contáctanos desde la página principal de APIYI en apiyi.com para conversar sobre arquitectura de agentes y prácticas de invocación de múltiples modelos. Encontrarás más recursos en el centro de documentación docs.apiyi.com.