Nota del autor: las puntuaciones de las clasificaciones públicas pueden inflarse mediante optimizaciones específicas. Este artículo explica por qué ocurre el benchmaxing, propone 5 comprobaciones de credibilidad y presenta 4 pasos para crear una batería privada con tareas propias.
La conclusión, de entrada: las puntuaciones de las clasificaciones pueden servir como punto de partida para investigar, pero no deberían determinar directamente la elección de un modelo. En las clasificaciones generales, los modelos líderes suelen estar separados por apenas unos puntos, suficientes para cambiar quién ocupa el primer lugar. Con diferencias tan pequeñas, las optimizaciones dirigidas a las pruebas pueden influir fácilmente en la clasificación. Este fenómeno se conoce como benchmaxing.
Lo que realmente determina la elección es el rendimiento de los modelos candidatos en las tareas de tu negocio. Este artículo no clasifica modelos ni juzga quién hace «trampa». Se divide en tres partes: cómo detectar puntuaciones potencialmente infladas, cómo crear una pequeña batería privada a partir de casos reales y en qué situaciones las clasificaciones no cubren las métricas que te interesan.
Qué es el benchmaxing: 3 causas de las puntuaciones infladas en los rankings
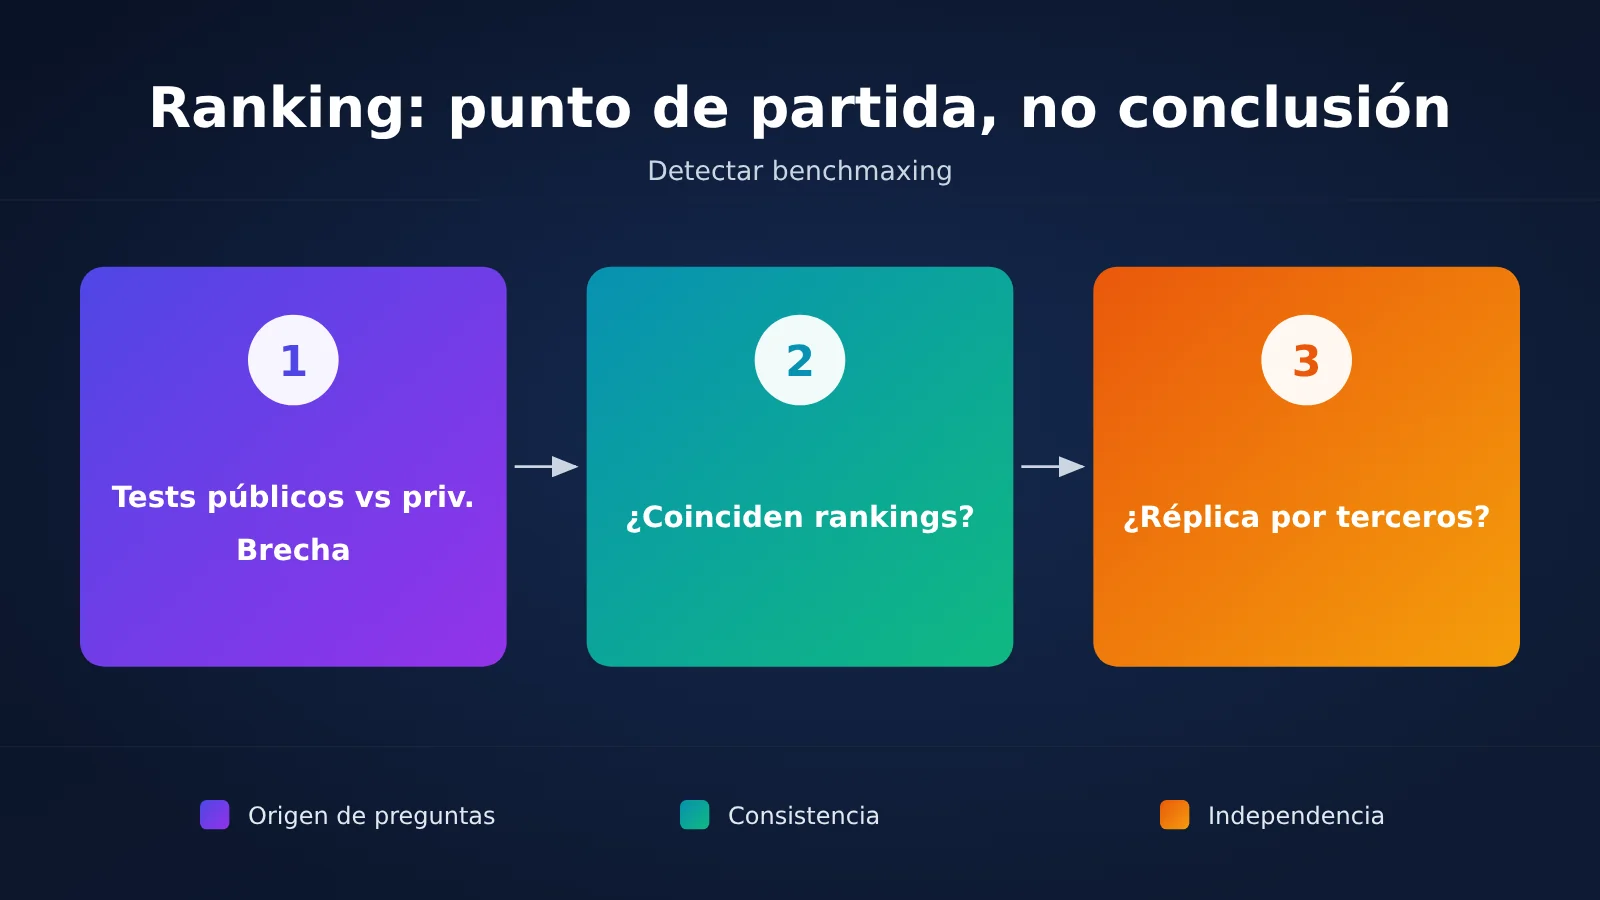
Según un artículo de MindStudio del 1 de noviembre de 2026, el benchmaxing consiste en entrenar o ajustar un modelo para obtener puntuaciones altas en pruebas de referencia conocidas, en lugar de mejorar sus capacidades generales. Su señal más característica es que el modelo destaca en los rankings, pero su rendimiento cae notablemente cuando se enfrenta a preguntas nuevas que evalúan la misma capacidad.
| Causa | Cómo ocurre | Pistas para identificarla |
|---|---|---|
| Las preguntas entraron en los datos de entrenamiento | Las preguntas de la prueba, o variantes muy similares, se incorporaron al corpus de entrenamiento de forma intencionada o accidental | La puntuación es alta con las preguntas originales, pero baja cuando se reformulan |
| Ajuste fino por tipo de pregunta | El modelo se optimiza específicamente para los formatos y patrones de razonamiento que favorece una prueba concreta | Solo destaca en un ranking y obtiene resultados mediocres en otros |
| Las preguntas públicas llevan mucho tiempo circulando | Las preguntas se comentan en foros y blogs, y terminan en los datos recopilados de la web | Cuanto más antigua es una prueba pública, más cerca están las puntuaciones de la saturación |
El benchmaxing no implica necesariamente mala intención
El artículo original señala que ninguna de estas tres situaciones requiere mala intención. Un laboratorio puede creer sinceramente que está mejorando la capacidad de razonamiento general, cuando en realidad ha sobreajustado el modelo a unos pocos tipos de preguntas conocidos. Cuanto más tiempo lleva una prueba disponible públicamente, menos se parece a una medición de capacidades y más a un examen de práctica que el modelo ya ha resuelto.
Por eso, conviene fijarse en las pruebas, no en las intenciones. Lo que importa es si esa puntuación se traduce en un buen rendimiento ante preguntas nuevas, no especular sobre quién pudo hacerlo a propósito.
Por qué aparece el benchmaxing: ritmo de lanzamientos y comparativas
Las puntuaciones son la forma más sencilla que tienen los laboratorios de demostrar avances a inversores, desarrolladores y al público, sin necesidad de someterse a una auditoría independiente completa. Una cifra como «59 puntos en un índice global» encaja fácilmente en un comunicado de prensa y se puede comparar con la de un competidor. Cuanto más simple es la cifra, mayor es la presión por optimizarla.
El segundo factor es el ritmo de lanzamientos. Según el mismo artículo de MindStudio, un modelo de la serie Google Gemini obtuvo 50 puntos en el Artificial Analysis Index y, aproximadamente un mes después, un modelo posterior de la misma compañía alcanzó los 59 puntos y llegó al primer puesto. Por ahora, estos datos solo tienen esa fuente y este artículo no los ha verificado de forma independiente. La idea del texto original es que las iteraciones se miden en semanas, la distancia entre los líderes se mide en unos pocos puntos y cualquier método para marcar la diferencia resulta atractivo.
Antes de mirar el ranking, clasifica los hechos
Cuando cites una puntuación, aclara primero a qué categoría pertenece. La siguiente tabla usa los casos de este artículo como ejemplo:
| Tipo de dato | Caso en este artículo | Cómo valorar su fiabilidad |
|---|---|---|
| Dato declarado por la empresa / predicción verbal | Musk afirma que Grok 5 podría obtener una puntuación «casi perfecta» en Humanity’s Last Exam y que Grok 4 alcanzó alrededor del 52 % en la parte de texto de esa prueba | Son una predicción y una afirmación propia, no resultados de pruebas independientes |
| Prueba independiente de terceros | El Artificial Analysis Index combina pruebas de razonamiento, programación, ciencias y matemáticas, entre otras | Puede servir como referencia, pero hay que indicar la fecha de la cita |
| Información de un solo medio | La puntuación de Grok 4.7 en el índice, su resultado en Terminal-Bench y el cambio de Gemini de 50 a 59 puntos | Solo procede de MindStudio y no se ha verificado de forma independiente |
| Desconocido | El momento exacto y el alcance del cambio de Artificial Analysis hacia preguntas privadas | Se debe consultar su explicación oficial; este artículo no hace suposiciones |
Según MindStudio, Grok 4.7 quedó por detrás de los modelos líderes tanto en el índice global independiente como en Terminal-Bench. El texto original presenta esa «brecha entre las expectativas públicas y las pruebas independientes» como una señal que merece atención, y aclara que esto no significa que xAI tenga más problemas que otros proveedores. Este artículo también se limita a usarla como señal, sin extraer ninguna conclusión.
5 señales para evaluar la fiabilidad de las puntuaciones de un ranking
La respuesta de los evaluadores independientes es directa: no publicar las preguntas. Si nunca se hacen públicas, nadie puede entrenar específicamente para ellas. Según MindStudio, organizaciones como Artificial Analysis ya han recurrido a preguntas privadas. Dentro de una misma categoría de capacidad, la diferencia entre los resultados en pruebas públicas y en preguntas privadas nuevas se considera una de las señales más reveladoras de benchmaxing.
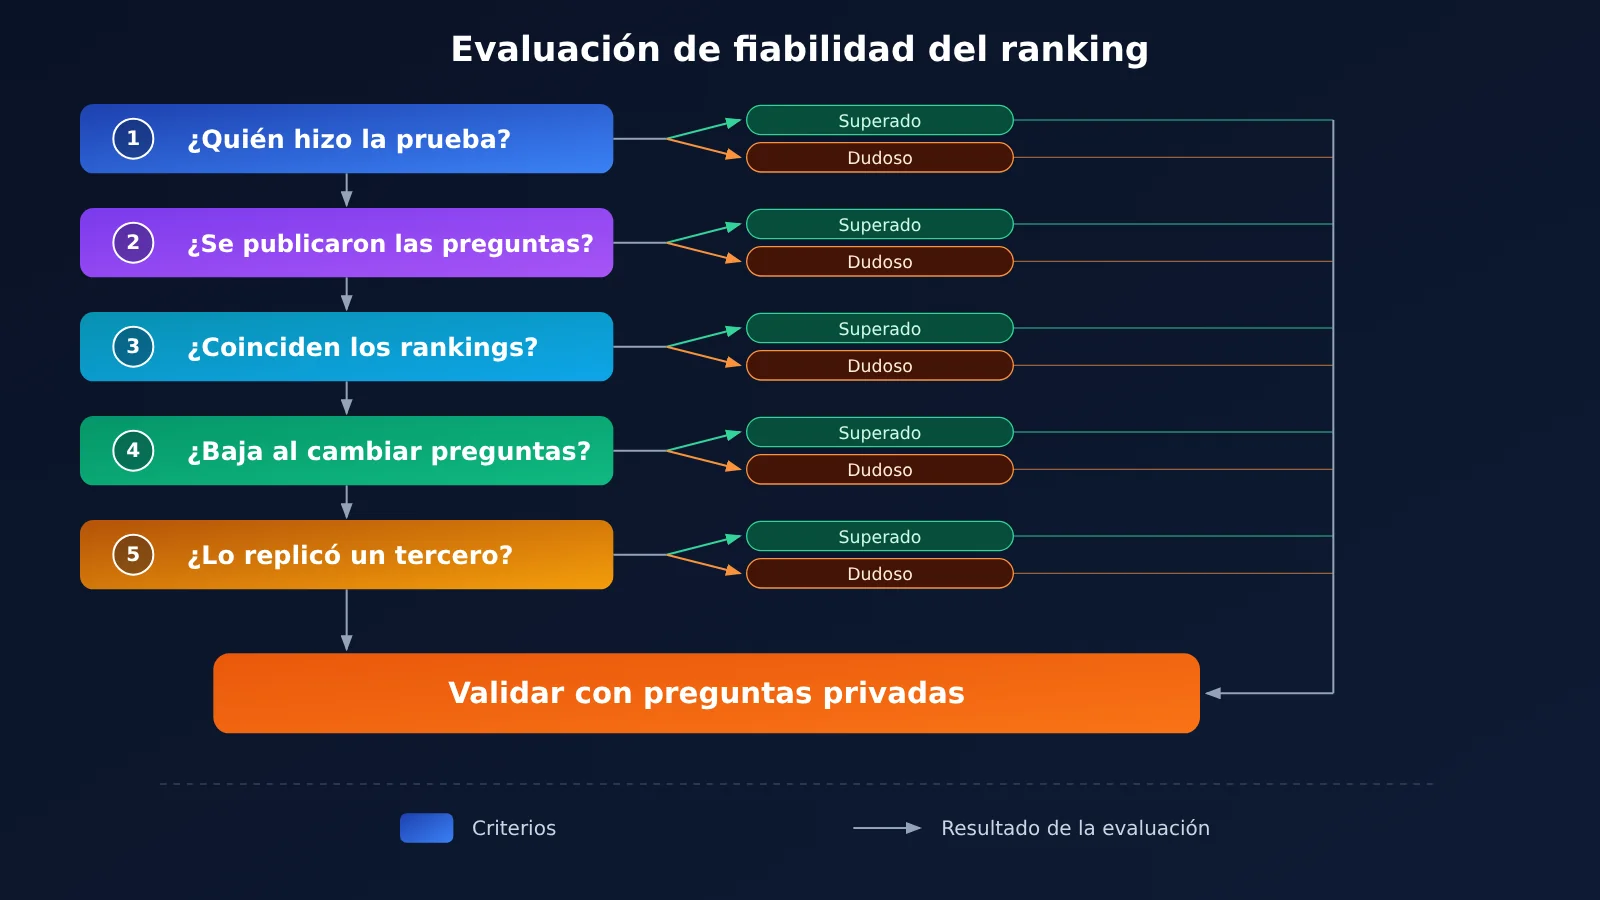
A partir de las recomendaciones del artículo original, podemos resumir el método en esta lista de 5 comprobaciones:
| N.º | Qué comprobar | Cómo hacerlo | Señal positiva | Señal de alerta |
|---|---|---|---|---|
| 1 | Quién hizo la evaluación | Comprueba si el resultado procede de un informe técnico del fabricante o de una página de evaluación independiente | Evaluación realizada de forma independiente por terceros | Solo hay resultados publicados por el fabricante |
| 2 | Si las preguntas se han publicado | Comprueba si el benchmark se publicó antes de la fecha de corte de los datos de entrenamiento del modelo | Preguntas privadas o publicadas después del entrenamiento | Preguntas antiguas que llevan años disponibles |
| 3 | Si los resultados son coherentes en varios rankings | Compara distintos benchmarks de razonamiento, programación y matemáticas | Posiciones similares en los distintos rankings | Destaca en un solo ranking |
| 4 | Si la puntuación baja al cambiar las preguntas sobre una misma capacidad | Compara los conjuntos públicos y privados, o las preguntas originales y sus versiones reformuladas | La diferencia es pequeña tras cambiar las preguntas | La puntuación cae de forma notable |
| 5 | Si terceros han reproducido los resultados | Busca informes de reproducción independientes y revisa la configuración de la evaluación | Varias partes reproducen los resultados y la configuración es transparente | No se pueden reproducir los resultados o la configuración no es pública |
Por qué es más difícil inflar un índice compuesto
El artículo original señala que el valor de Artificial Analysis Index está en combinar varios tipos de pruebas en una sola puntuación. Es posible sobreajustar un modelo a una prueba concreta, pero hacerlo a la vez para varias pruebas de razonamiento, programación, ciencia y matemáticas es mucho más difícil, sobre todo cuando algunas preguntas no se publican. Por eso conviene dar más peso al punto 3: la coherencia entre rankings.
Crea tu propio conjunto privado de pruebas en 4 pasos
Por muy limpio que sea un ranking, evalúa los modelos con pruebas de otros. Para elegir el modelo definitivo, necesitas tu propio conjunto privado de pruebas. Su ventaja es que ningún laboratorio las ha visto.
| Paso | Qué hacer | Cómo hacerlo | Resultado |
|---|---|---|---|
| ① Seleccionar casos | Extraer casos de la actividad real | Usa tickets reales, casos fallidos de los registros de producción y conversaciones con quejas de usuarios. Agrúpalos por tipo de tarea y empieza con 20–50 casos por categoría | Conjunto inicial de pruebas etiquetadas |
| ② Definir criterios de aceptación | Decidir de antemano qué resultado es «suficientemente bueno» | Prioriza resultados verificables, como campos JSON, etiquetas de clasificación o si se superan las pruebas unitarias. Para las respuestas abiertas, usa una rúbrica y revisa manualmente una proporción fija de los casos | Script de puntuación + rúbrica |
| ③ Probar varios modelos | Controlar las variables para compararlos | Usa la misma indicación, los mismos parámetros y el mismo evaluador o las mismas reglas de puntuación. Registra la puntuación, la latencia y el uso de tokens | Tabla comparativa de resultados |
| ④ Actualizar periódicamente | Evitar que el conjunto se convierta en otro examen de práctica | Añade cada mes nuevos casos fallidos y retira las pruebas en las que todos los modelos obtengan la puntuación máxima. Reserva una parte del conjunto sin usarla para ajustar parámetros | Conjunto de pruebas versionado |
Selección de casos y criterios de aceptación para una batería de pruebas privada
A la hora de seleccionar casos, los fallos son más valiosos que los éxitos. Las conversaciones en las que el usuario vuelve a preguntar, interviene un agente humano o se registra una valoración negativa son las que mejor muestran las diferencias entre modelos. Conviene definir los criterios de aceptación antes de ejecutar las pruebas; de lo contrario, es fácil ajustarlos a los resultados después de verlos.
La definición de «suficientemente bueno» debe poder expresarse con cifras. Por ejemplo: «la precisión de los campos extraídos de forma estructurada alcanza un umbral determinado» o «las respuestas de atención al cliente no contienen errores fácticos en una revisión manual por muestreo». La proporción de casos revisados depende del riesgo: en procesos de alto riesgo se puede revisar una muestra mayor, mientras que en tareas de bajo riesgo puede predominar la evaluación automática.
Cómo controlar las variables al comparar varios modelos
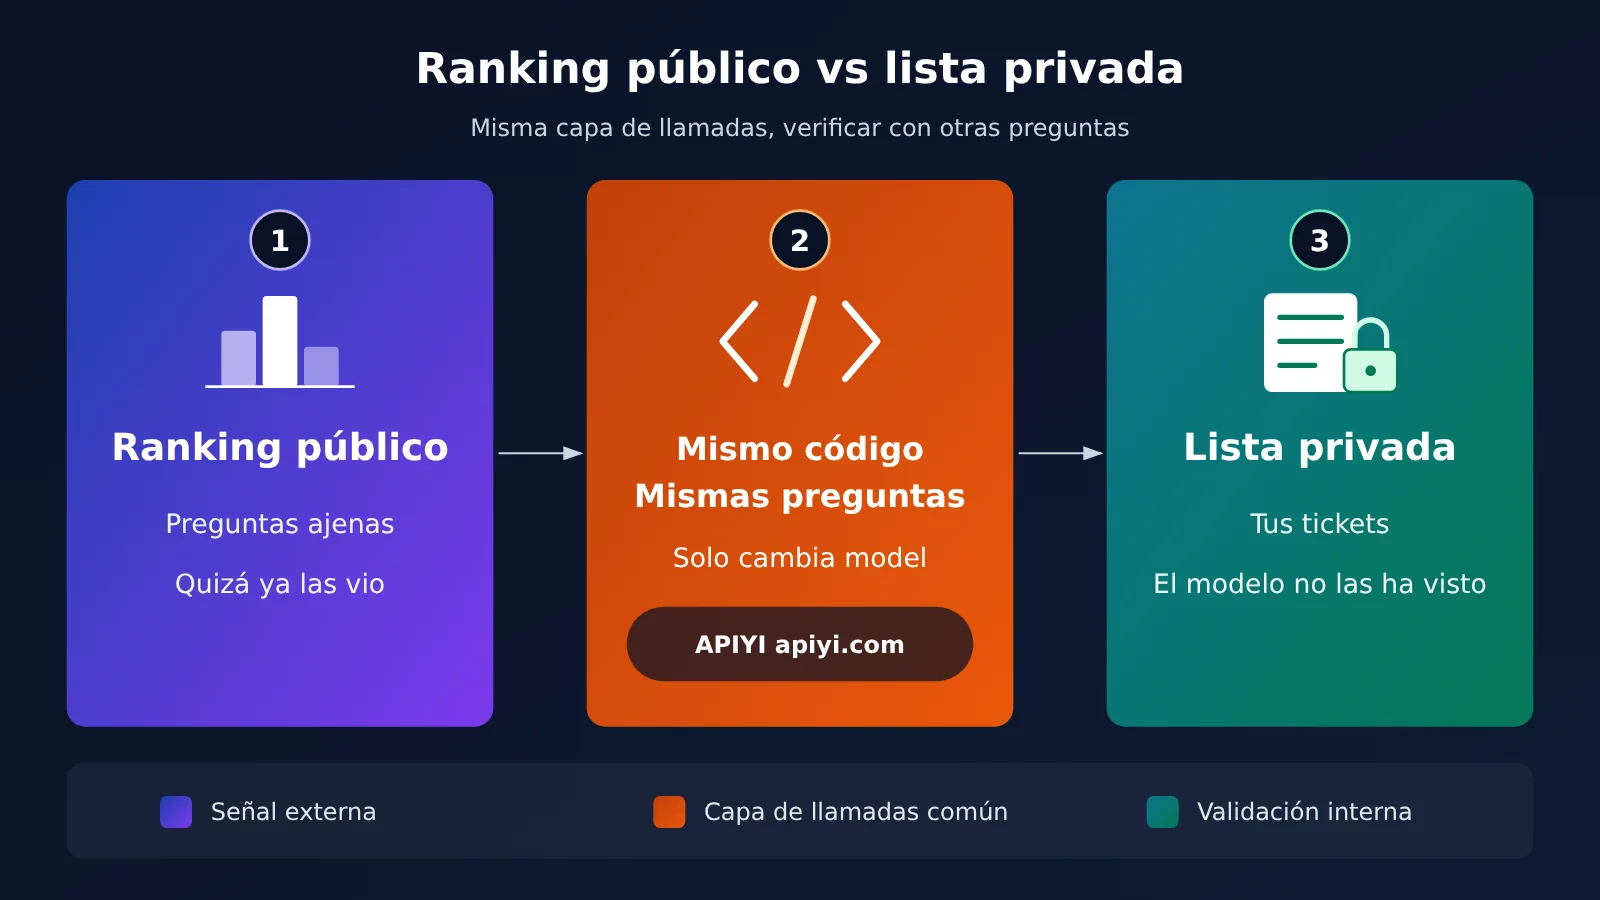
El problema más común en las comparaciones entre modelos es no controlar las variables: por ejemplo, usar una indicación cuidadosamente ajustada para el modelo A y una indicación predeterminada para el modelo B. Lo correcto es utilizar el mismo código y la misma batería de pruebas, y cambiar únicamente el nombre del modelo.
Si los modelos candidatos son de distintos proveedores, mantener varios SDK puede ser complicado. APIYI es compatible con el formato de OpenAI y permite invocar modelos de distintos proveedores con un solo token. Para cambiar de modelo, solo hay que modificar el parámetro model, lo que facilita ejecutar la misma batería de pruebas con un único script de evaluación. La configuración es la siguiente:
- SDK oficial de Python de OpenAI: al inicializar el cliente, establece
base_urlenhttps://api.apiyi.com/v1e introduce el token de la plataforma enapi_key. - Cambio de modelo en el bucle de evaluación: modifica solo el campo
model. Consulta los nombres en la lista de modelos de APIYI apiyi.com. - Parámetros de muestreo fijos: configura
temperature=0y el mismo valor demax_tokenspara todos los modelos, para reducir la influencia de la aleatoriedad. - Registro de uso: lee el campo
usagede la respuesta y suma los tokens que consume cada modelo en la batería de pruebas.
🚀 Para empezar rápidamente: elige como candidatos 3 o 4 modelos bien posicionados en las clasificaciones y que hayan superado las 5 comprobaciones anteriores. Invócalos uno tras otro con el mismo token a través de APIYI apiyi.com y podrás obtener una primera comparación con 50 solicitudes reales de soporte en una tarde.
Evita ajustar los parámetros a tu propia batería de pruebas
Tú también puedes caer en el benchmaxing con tu propia batería. Ajustar la indicación una y otra vez hasta que un modelo obtenga la puntuación perfecta en esos 50 casos no es muy distinto de que un proveedor optimice para escalar posiciones en una clasificación. Estas medidas pueden ayudarte a evitarlo:
- Separa un conjunto de validación: reserva alrededor del 30 % de los casos, ajusta los parámetros solo con el conjunto de desarrollo y toma la decisión final con el conjunto reservado.
- Congela las indicaciones: una vez iniciada la comparación formal, fija una versión de cada indicación y vuelve a evaluar todos los modelos ante cualquier cambio.
- Incorpora casos nuevos: cada vez que actualices la batería, añade casos de fallos recientes para que evolucione con las necesidades del negocio.
Cuándo no basta con mirar la puntuación de la clasificación
Aunque las puntuaciones de una clasificación sean totalmente fiables, puede que no midan lo que te importa. En los siguientes casos, la clasificación sirve, como mucho, de referencia general:
| Escenario | Por qué no lo cubre la clasificación | Qué evaluación añadir |
|---|---|---|
| Tareas especializadas poco frecuentes | La terminología sectorial, los formatos internos y las lenguas con menos recursos rara vez aparecen en las pruebas de referencia generales | Una batería privada con datos reales del negocio |
| Llamadas a herramientas y agentes | Las preguntas y respuestas de un solo turno no permiten medir la estabilidad de las llamadas de varios pasos ni la corrección del formato de los parámetros | Tasa de éxito de tareas de extremo a extremo y tasa de errores de formato en las llamadas a funciones |
| Costo y latencia | Las clasificaciones ordenan por capacidad, sin considerar el costo por solicitud ni la latencia hasta el primer token | Registrar también el consumo de tokens y el tiempo de respuesta en la batería de pruebas |
| Estabilidad | Una sola ejecución no refleja las fluctuaciones en producción | Ejecutar varias veces cada caso y comprobar la consistencia de los resultados |
Una regla práctica: una vez alcanzado el nivel de capacidad necesario, lo que importa comparar es la relación calidad-precio y la estabilidad. Es posible que tanto el primer modelo de la clasificación como el tercero cumplan tus requisitos en la batería de pruebas; en ese caso, suele convenir el que ofrezca menor latencia y costos más controlables. Al acceder a los modelos de forma unificada mediante APIYI apiyi.com, puedes comparar en una misma tabla su capacidad, tiempo de respuesta y consumo.
Preguntas frecuentes
P1: ¿El benchmaxing equivale a que un modelo haga trampa?
No. Las preguntas pueden llegar a los datos de entrenamiento de forma accidental, por ejemplo, a través de rastreadores web. Además, un equipo puede optimizar el modelo para ciertos tipos de preguntas porque cree que así mejora su capacidad de razonamiento. Para evaluarlo, fíjate en si mantiene la puntuación al cambiar las preguntas, sin sacar conclusiones sobre sus motivos.
P2: ¿Cuándo siguen siendo fiables las puntuaciones de las clasificaciones?
Las puntuaciones siguen siendo una señal útil si las preguntas son privadas o aparecieron después de la fecha de corte de los datos de entrenamiento, un tercero realiza las pruebas de forma independiente, las conclusiones coinciden en varias clasificaciones y alguien reproduce los resultados. Un índice que combina varios tipos de pruebas es más difícil de inflar que una sola prueba de referencia.
P3: ¿Cuántas preguntas necesita como mínimo un conjunto privado?
No hay una norma universal. Como punto de partida, entre 20 y 50 ejemplos reales por tipo de tarea suelen bastar para detectar diferencias evidentes. Si las diferencias no están claras, amplía el conjunto de preguntas y reserva también un conjunto de validación.
P4: ¿Cómo comparar modelos de varios proveedores con el mismo código?
Lo más sencillo es usar una interfaz compatible con OpenAI. Tras obtener un token en APIYI apiyi.com, configura `base_url` con la dirección de la plataforma y cambia solo el parámetro `model` dentro del bucle. Así podrás comparar los modelos con el mismo conjunto de preguntas. Consulta la lista de modelos de la plataforma para saber cuáles están disponibles.
P5: ¿Grok 5 está cerca de obtener una puntuación perfecta en Humanity’s Last Exam?
A la fecha de este artículo, se trata de una predicción pública de Musk, no de un resultado de pruebas. Si en el futuro se alcanza esa puntuación, conviene revisarla con la lista de comprobación de cinco puntos, especialmente el rendimiento de esa misma capacidad con preguntas nuevas y privadas. Después, usa tu propio conjunto de preguntas a través de APIYI apiyi.com para comprobar si el modelo se adapta a tu negocio.
Puntos clave sobre benchmaxing y evaluación con tareas propias
- Definición: el benchmaxing consiste en optimizar un modelo para pruebas conocidas, lo que hace que su puntuación en las clasificaciones supere su capacidad real.
- Causas: las preguntas llegan a los datos de entrenamiento, se ajusta el modelo para tipos de preguntas concretos o las pruebas públicas circulan durante mucho tiempo. Ninguna de estas situaciones requiere mala intención.
- Señal principal: que la puntuación baje al evaluar la misma capacidad con preguntas nuevas es la advertencia más directa.
- 5 comprobaciones: quién ejecutó la evaluación, si las preguntas eran públicas, si los resultados coinciden en varias clasificaciones, si la puntuación baja con preguntas nuevas y si un tercero ha reproducido los resultados.
- Lista de pruebas en 4 pasos: seleccionar muestras, definir criterios de aceptación, probar varios modelos y actualizar la lista periódicamente. Además, conviene reservar un conjunto de validación para evitar el sobreajuste a las propias pruebas.
- Invocación unificada: con la interfaz compatible con OpenAI de APIYI apiyi.com, basta con cambiar el parámetro
modelpara alternar entre modelos.
Conclusión: las clasificaciones son el punto de partida, no la respuesta
Hoy mismo puedes hacer tres cosas. Primero, revisa cada puntuación que te interese con la lista de 5 comprobaciones y anota el tipo de dato y la fecha de la referencia. Segundo, selecciona 50 casos fallidos de los registros del último mes y define los criterios de aceptación antes de ejecutar los modelos. Tercero, prueba entre 3 y 4 modelos candidatos con el mismo código y los mismos parámetros, y registra la puntuación, la latencia y el consumo.
Puedes usar APIYI apiyi.com para comparar varios modelos con un solo token y actualizar la lista de pruebas una vez al mes. La elección debe basarse en tus propias pruebas, no en los exámenes de otros.
📚 Referencias
- MindStudio: What Is Benchmaxing? Why AI Labs Are Hiding Test Questions (2026-11-01)
- Enlace:
mindstudio.ai/blog/ai-benchmark-maxing-private-tests -
Descripción: definición y causas del benchmaxing, tendencia hacia preguntas privadas y única fuente de los datos sobre Gemini y Grok citados en el artículo.
-
Sitio oficial de Artificial Analysis: evaluaciones independientes de modelos e índice general
- Enlace:
artificialanalysis.ai - Descripción: consulta su información oficial para conocer cuándo y en qué medida se pasó a utilizar preguntas privadas.
Autor: Equipo técnico de APIYI
Intercambio técnico: contáctanos desde la página de inicio de APIYI en apiyi.com. Para más recursos sobre integración, visita el centro de documentación en docs.apiyi.com.