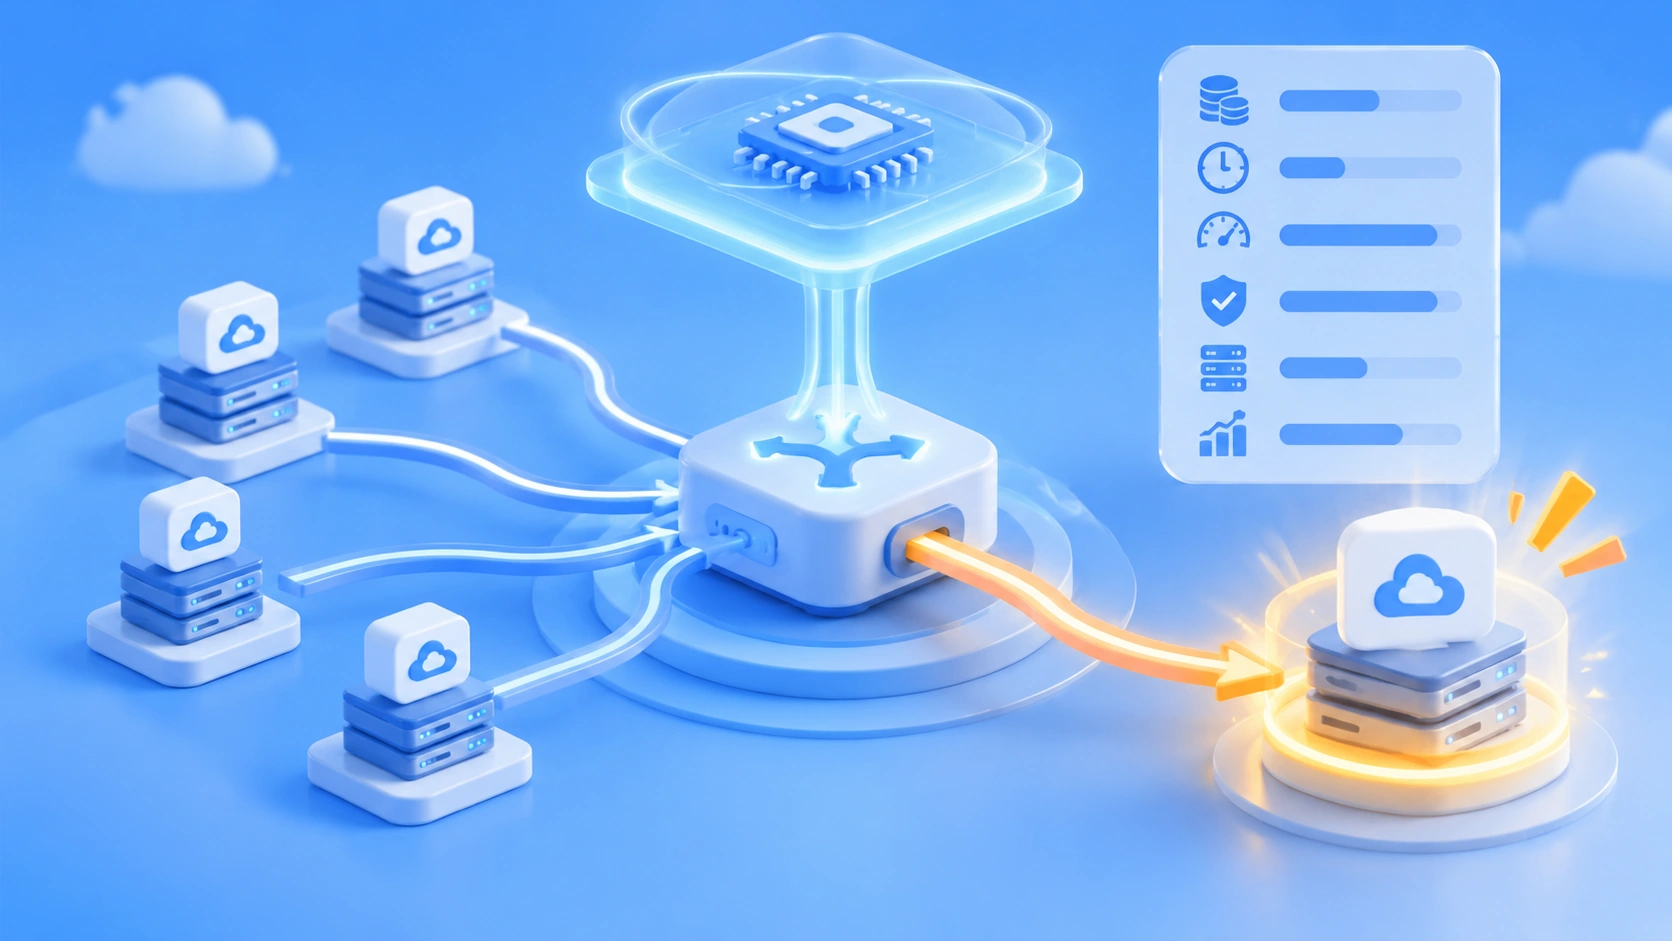
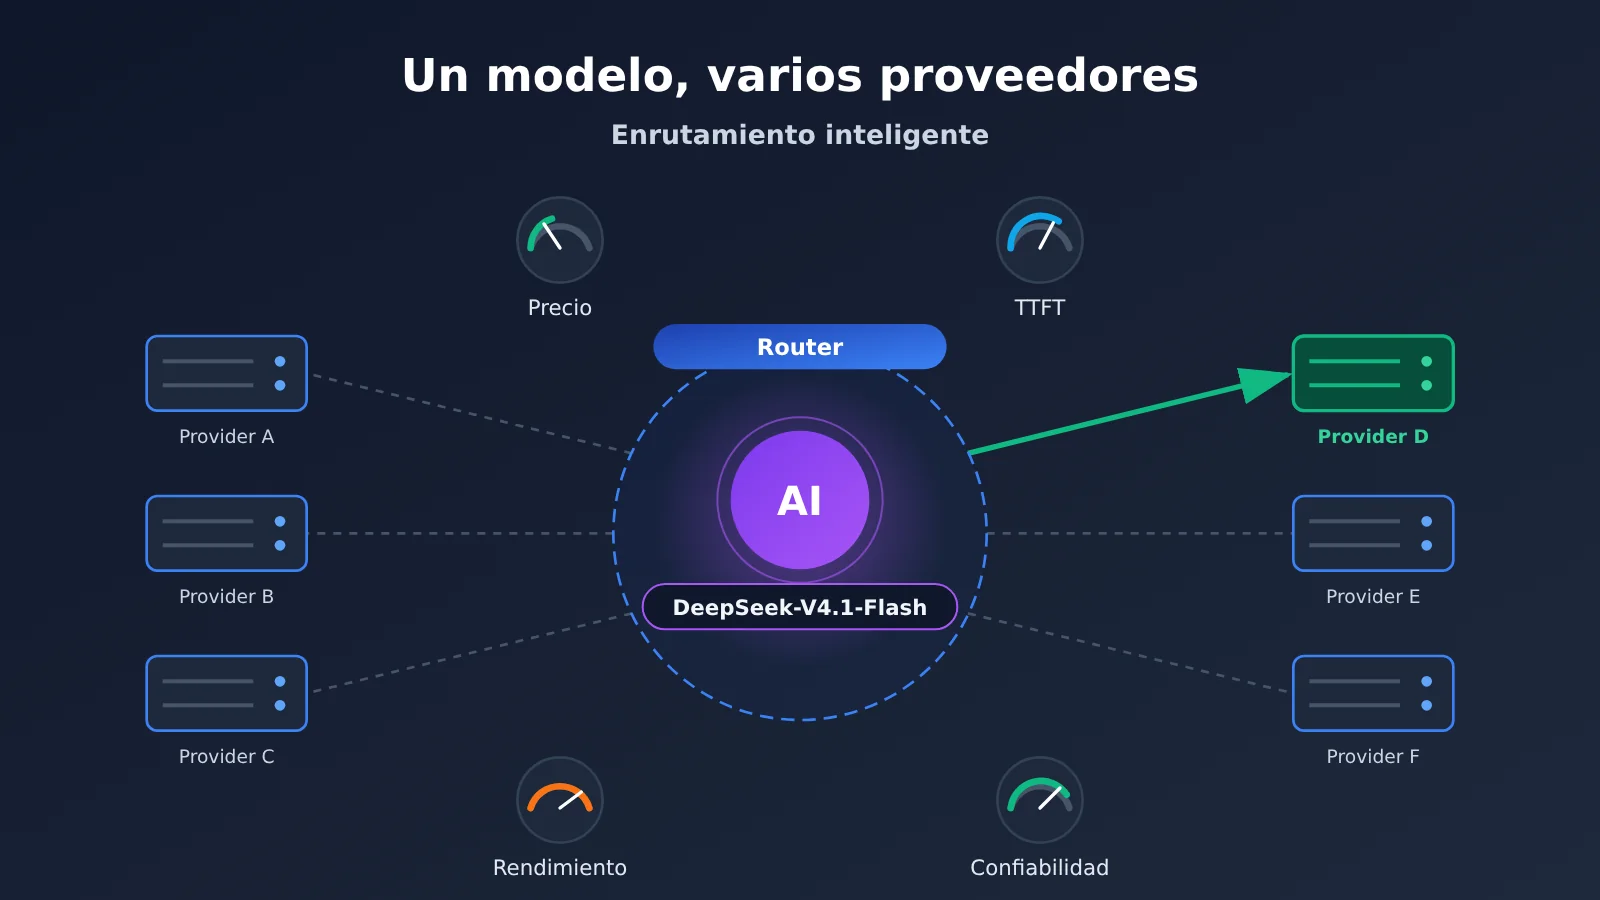
Respuesta directa: Un mismo modelo de pesos abiertos puede ser desplegado por muchos proveedores de inferencia distintos, y por eso aparecen decenas de proveedores de API. OpenRouter no se limita a mirar quién tiene el precio de lista más bajo: elige proveedores según el costo integral de una respuesta utilizable. Evalúa seis indicadores —precio efectivo real, latencia del primer token, rendimiento, límites de velocidad, fiabilidad y calidad de la respuesta— y luego entrega la solicitud al proveedor más adecuado en ese momento; si falla, prueba otro.
Esto muestra que la competencia en la agregación de API de IA ya pasó de “ofrecer una interfaz unificada” a “asignar proveedores dinámicamente”. El 16 de noviembre de 2026, Hugging Face anunció que transferiría a OpenRouter el enrutamiento de modelos de lenguaje de Inference Providers. Esta colaboración ofrece un caso concreto para ver cómo esos indicadores se convierten en un mecanismo automático de selección de proveedores.
¿Qué puede aprender al leer este artículo?
- Por qué un mismo modelo de IA puede tener varios proveedores de API, y cuál es la diferencia entre el desarrollador del modelo y el proveedor de inferencia
- Qué indicadores de decisión utiliza el enrutamiento de proveedores y qué problema resuelve cada uno
- Qué puede lograr la conmutación por error y cuáles son sus límites
- Cómo usar los metadatos de la API del catálogo de modelos de Hugging Face para comparar proveedores por su cuenta
Índice: La parte de hechos objetivos se desarrolla en este orden: primero se explica el origen de la existencia de varios proveedores de API; luego se desglosan el objeto de decisión del enrutamiento inteligente y sus 6 indicadores; después se describe el flujo y los límites de la conmutación por error; por último, se muestra cómo los desarrolladores pueden comparar proveedores por su cuenta usando la API del catálogo. A lo largo del texto se intercalan datos experimentales de enrutamiento publicados por OpenRouter y cambios en la facturación. La parte de análisis y opinión aborda hacia dónde competirán a continuación las plataformas de agregación de API, y cómo los desarrolladores deberían elegir y validar en sus aplicaciones.
Entender el concepto «To Know» de múltiples proveedores de API y el enrutamiento de Provider
| Concepto | Breve explicación |
|---|---|
| Provider | Proveedor que despliega el modelo y realmente ofrece el servicio de inferencia, por ejemplo Together AI o Novita |
| Router | Capa de enrutamiento que decide a dónde va la solicitud según las condiciones de la petición y el estado de los proveedores disponibles |
| Modelo de pesos abiertos | Modelo cuyos pesos post-entrenamiento se publican y que puede desplegarse por cuenta propia según su licencia |
| TTFT | Time to First Token, el tiempo de espera desde que se envía la solicitud hasta que regresa el primer token |
| Rendimiento | Cantidad de tokens generados por unidad de tiempo, normalmente medida en tok/s |
| Failover | Cambio automático a otro proveedor y reintento cuando falla el proveedor actual |
| Prompt Caching | El proveedor almacena en caché las entradas repetidas para reducir el costo computacional y el tiempo de respuesta |
| BYOK | Bring Your Own Key, llevar tu propia Key del proveedor y usar la cuota de la cuenta correspondiente |
| P50 / P95 | Percentiles estadísticos; P50 es la mediana y P95 refleja el 5% de solicitudes más lentas |
Vistazo rápido al impacto de los cambios en el enrutamiento entre múltiples proveedores de API
- Desarrolladores: En principio, el código y el Token del lado de Hugging Face no necesitan cambios, pero el proveedor real lo determina el enrutamiento: un mismo ID de modelo puede caer en distintos Provider en diferentes solicitudes. Las aplicaciones que dependen de llamadas a herramientas o de salidas estructuradas deben volver a pasar por pruebas de regresión. Para quienes configuraban su propia Key de Provider de modelos de lenguaje en Hugging Face, esa vía ya se cerró, así que deben volver a confirmar la Key y a quién se factura.
- Compras empresariales y equipos de plataforma: Hay que reevaluar la admisión de proveedores, las estrategias de recuperación ante desastres y las condiciones de tratamiento de datos. Las organizaciones pueden deshabilitar un Provider específico, pero eso no equivale a contar con una garantía completa de residencia de datos o de cumplimiento normativo; sigue siendo necesario revisar la política de datos de cada proveedor, uno por uno.
Un mismo modelo de IA en varios proveedores de API: hechos objetivos
Por qué un mismo modelo puede tener varios proveedores de API
El desarrollador del modelo y el proveedor de inferencia son dos roles distintos. El desarrollador se encarga de entrenar el modelo y publicar los pesos. En el caso de los modelos de pesos abiertos, cualquier organización con capacidad de cómputo y que cumpla las condiciones de la licencia puede desplegar los pesos en su propio clúster de GPU y ofrecer una API al público. Por eso, modelos como DeepSeek, Qwen o GLM suelen ejecutarse simultáneamente sobre varias infraestructuras de inferencia.
Tomemos deepseek-ai/DeepSeek-V4.1-Flash como ejemplo: el desarrollador solicita un mismo nombre de modelo, pero la inferencia real bien puede ejecutarse en Together AI, Novita u otro Provider compatible con ese modelo. Cada proveedor usa hardware distinto, distinta escala de clústeres, distintas formas de programación y distintas estrategias de precios, de modo que el precio, la velocidad y la capacidad del mismo modelo también varían. Algunos ofrecen precios bajos pero sufren limitación de tráfico fácilmente en horas pico; otros devuelven el primer Token rápidamente; otros admiten contextos más largos; otros dan un soporte más completo al formato de llamadas a herramientas.
Los datos de escala muestran cuán fragmentado está este mercado. OpenRouter reveló en un anuncio de colaboración que su plataforma completa admite más de 600 modelos, integra más de 80 Providers y procesa más de 800 billones de Tokens al mes, atendiendo a más de 10 millones de usuarios. Estos son datos de toda la plataforma de OpenRouter, no la escala aportada por esta colaboración en particular. La página de Providers de Hugging Face también lista a más de diez proveedores como Baseten, Cerebras, DeepInfra, Fireworks, Nebius, Novita o Together AI, pero los Providers disponibles varían según el modelo.
Un modelo corresponde a varios proveedores, y las condiciones de cada uno cambian en tiempo real; «¿a quién le envío esta solicitud?» se convierte en una decisión que hay que tomar continuamente, y de ahí surge el enrutamiento multi-Provider.
¿Qué decide realmente el enrutamiento inteligente?
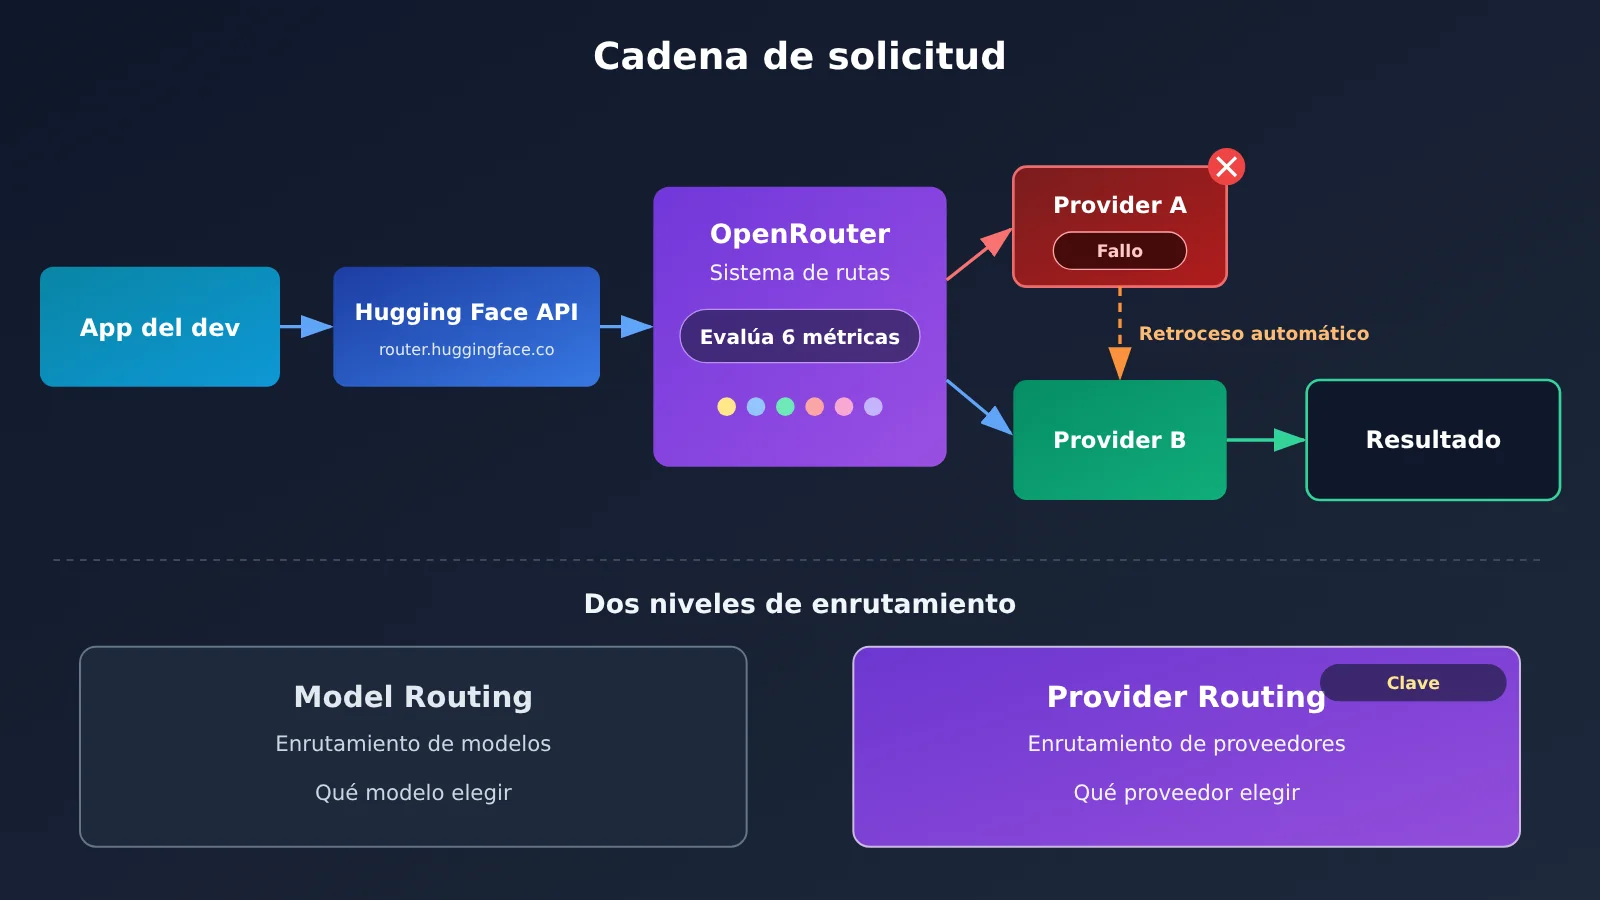
Primero, conviene distinguir dos conceptos que se confunden con facilidad. Model Routing (enrutamiento de modelos) decide qué modelo responde; por ejemplo, las preguntas simples van a un modelo pequeño y las complejas a un modelo grande. Provider Routing (enrutamiento de proveedores) parte de que el modelo ya está definido y decide qué proveedor ejecuta la inferencia. La colaboración entre OpenRouter y Hugging Face que se analiza en este artículo es del segundo tipo: el modelo lo especifica el desarrollador, la capa de enrutamiento solo elige al proveedor y no cambia el modelo por ti.
Después de la colaboración, el recorrido de una solicitud a un modelo de lenguaje es: aplicación del desarrollador o agente de programación (Coding Agent) → API de Hugging Face (router.huggingface.co) → sistema de enrutamiento de OpenRouter → inferencia en algún proveedor → devolución del resultado. OpenRouter se encarga aquí del enrutamiento de solicitudes y de la selección de proveedor, pero no ejecuta la inferencia de todos los modelos. El usuario sigue usando un Token de Hugging Face y la facturación se gestiona mediante la cuenta de Hugging Face del usuario o de su organización. Hugging Face indica que no aplica ningún recargo sobre el precio de inferencia del proveedor.
En cuanto al control, Hugging Face ofrece tres niveles:
- Enrutamiento automático predeterminado: el cliente oficial usa
provider="auto"y el sistema elige al proveedor combinando precio, velocidad y fiabilidad. - Proveedor específico: por ejemplo,
provider="together", o añadir el sufijo:novitadespués del ID del modelo para enviar la solicitud siempre a ese proveedor. - Enrutamiento por políticas: la interfaz compatible con OpenAI admite los sufijos
:cheapest(prioridad al precio) y:fastest(prioridad al rendimiento).
Cabe tener en cuenta que :fastest optimiza el rendimiento (throughput), no la “rapidez” en todos los sentidos. TTFT, velocidad de generación y tiempo total de la solicitud son tres métricas distintas. En respuestas cortas de una o dos frases, la latencia del primer token suele afectar más la percepción que el rendimiento.
| Elemento de comparación | Enrutamiento original de Hugging Face | Nuevo enrutamiento de OpenRouter |
|---|---|---|
| Sistema de enrutamiento | Enrutador propio de Hugging Face | OpenRouter |
| Selección de proveedor | Mecanismo de selección original | Evaluación integral en tiempo real |
| Base del precio | Estrategia de precios original | Precio efectivo real |
| Factores de velocidad | Mecanismo de rendimiento original | Incluye TTFT y rendimiento |
| Fallo en una solicitud | Puede devolver el error directamente | Puede reintentar con otro proveedor dentro de la misma solicitud |
| Caché de sesión | Estrategia original | Permite mantener el proveedor por sesión |
| Credenciales del usuario | Token de Hugging Face | Se sigue usando el Token de Hugging Face |
¿Qué métricas debe considerar un sistema de enrutamiento multiproveedor adecuado?
OpenRouter anunció el 28 de octubre de 2026 una nueva generación del algoritmo Provider Routing. El enrutamiento predeterminado anterior dependía bastante del precio de lista de los tokens de entrada, por lo que los proveedores de precios bajos tendían a recibir más tráfico. El nuevo algoritmo combina las siguientes seis categorías de señales en un costo de enrutamiento (Routing Cost) en tiempo real; el objetivo es optimizar el costo integral de «una respuesta válida que se obtiene con éxito al primer intento», en lugar de buscar únicamente el precio unitario más bajo.
① Effective Price (precio efectivo real) resuelve el problema de que «un precio de lista barato no equivale a una factura barata». Combina los tres tipos de precios unitarios —entrada no cacheada, entrada cacheada y salida— y luego los cruza con la proporción real de entrada/salida de la solicitud y la tasa de aciertos de caché de ese proveedor. El ejemplo que da OpenRouter es: 40,000 tokens de entrada no cacheados ($2/M) cuestan $0.080, 60,000 tokens de entrada cacheados ($0.50/M) cuestan $0.030 y 4,000 tokens de salida ($8/M) cuestan $0.032, para un total de $0.142. En escenarios con agentes, la proporción de entrada cacheada suele ser alta; comparar solo el precio de lista de entrada puede llevar a elegir mal el proveedor.
② TTFT (latencia del primer token) resuelve la pregunta de cuánto tiene que esperar el usuario para ver una respuesta. Las interfaces de chat y las llamadas multi-turno a herramientas de los agentes son las más sensibles a esta métrica, porque en cada turno hay que esperar primero el primer token.
③ Throughput (rendimiento) mide la velocidad una vez que empieza la generación. El nuevo algoritmo considera el rendimiento de generación durante todo el proceso de respuesta, no solo el pico instantáneo. Tareas con mucho volumen de salida, como la generación de textos largos o el autocompletado de código, se ven principalmente afectadas por esta métrica.
④ Rate Limits (límites de velocidad) se centra principalmente en los errores HTTP 429 y aborda el problema de «capacidad insuficiente del proveedor». Si un proveedor devuelve 429 con frecuencia, indica que sus recursos de cómputo están limitados, y el enrutamiento reducirá el tráfico que le asigna.
⑤ Reliability (fiabilidad) mide la frecuencia de solicitudes fallidas. Si la tasa de errores de un proveedor es claramente superior a la de otros proveedores del mismo modelo, el sistema reducirá la distribución de tráfico e, si es necesario, pausará temporalmente el tráfico hasta que se recupere.
⑥ Quality (calidad de la respuesta) aborda la inconsistencia de rendimiento de un mismo modelo entre distintas implementaciones. Según la documentación pública disponible, las señales de calidad se refieren principalmente a si las llamadas a herramientas devuelven correctamente y si la estructura cumple los requisitos. Los proveedores cuyas llamadas a herramientas tienen formatos anómalos o cuya precisión en benchmarks está claramente por detrás verán reducida su competitividad.
Además de estas seis métricas, la propia documentación de enrutamiento de OpenRouter incluye las políticas de datos como restricción. Por ejemplo, data_collection: "deny" permite excluir a los proveedores que no cumplen los requisitos de recopilación de datos, y zdr: true exige usar endpoints con retención cero de datos. La documentación de seguridad de Hugging Face indica que no utiliza los datos de las solicitudes de los usuarios para entrenar modelos, que durante el enrutamiento no guarda el cuerpo de la solicitud ni la respuesta, y que los registros de depuración se conservan durante un máximo de 30 días y no contienen datos de usuario ni tokens. Sin embargo, también advierte a los desarrolladores de que deben revisar las políticas de seguridad de datos del proveedor real. Las garantías de la plataforma no sustituyen los acuerdos de tratamiento de datos de cada proveedor.
Datos del experimento de enrutamiento de OpenRouter
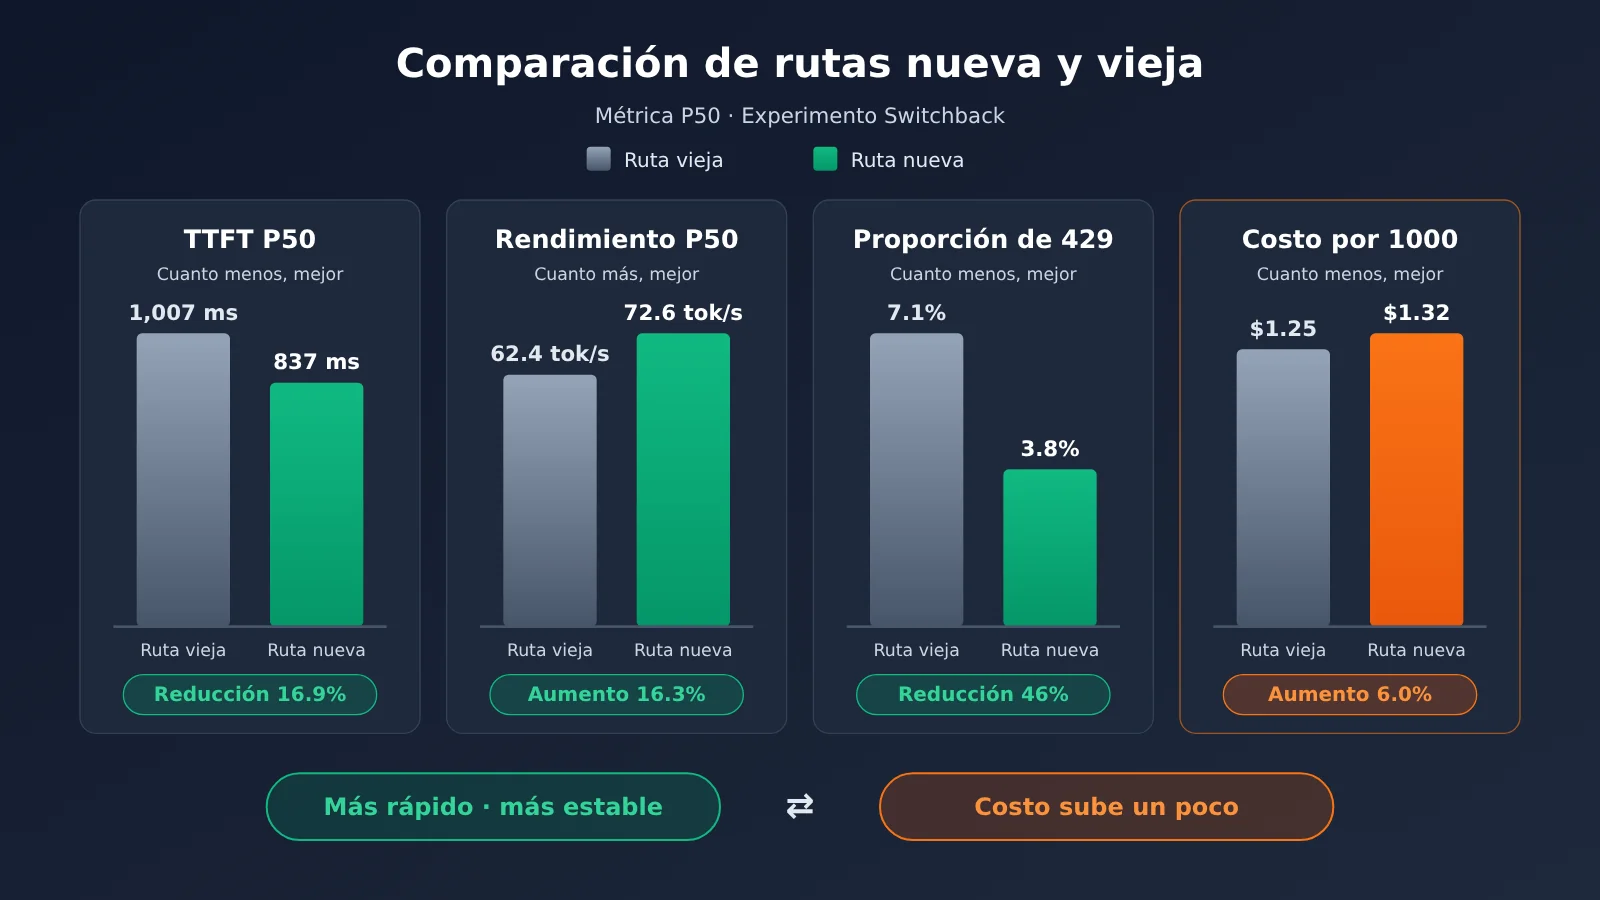
Antes de lanzar el nuevo algoritmo, OpenRouter llevó a cabo en octubre de 2026 un experimento switchback de una semana. Cada día se dividía en bloques de 3 horas; los bloques emparejados usaban respectivamente el algoritmo nuevo y el antiguo, y después de cada cambio se dejaba un periodo de calentamiento de 1 hora que no se contabilizaba. En total, más de 24 millones de solicitudes y 103.000 millones de tokens de entrada. Se eligió un experimento switchback en lugar de una asignación aleatoria de usuarios porque, al desviar el nuevo algoritmo el tráfico de los proveedores sobrecargados, el grupo con el algoritmo antiguo también se beneficia, lo cual distorsionaría la comparación.
| Métrica | Enrutamiento antiguo | Enrutamiento nuevo | Cambio |
|---|---|---|---|
| TTFT P50 | 1,007 ms | 837 ms | Reducción del 16.9% |
| TTFT P95 | 4,601 ms | 3,733 ms | Reducción del 18.9% |
| Throughput P50 | 62.4 tok/s | 72.6 tok/s | Aumento del 16.3% |
| Duración total de la solicitud P50 | 4.00 s | 3.24 s | Reducción del 19.0% |
| Solicitudes con al menos un 429 | 7.1% | 3.8% | Reducción del 46% |
| Solicitudes que requieren reintento | 10.4% | 6.9% | Reducción del 34% |
| Costo por mil solicitudes | $1.25 | $1.32 | Aumento del 6.0% |
| Costo por millón de tokens | $0.301 | $0.324 | Aumento del 7.3% |
Estos datos resumen el trade-off central del nuevo enrutamiento: un aumento de aproximadamente el 6% en el costo por mil solicitudes a cambio de menor latencia y menos errores de capacidad. Conviene señalar varias limitaciones: el experimento lo diseñó y publicó OpenRouter por cuenta propia, sin auditoría de terceros; la muestra es un conjunto de modelos abiertos representativos, no representa a todos los modelos ni proveedores; los resultados son estadísticas agregadas, no significan que cada solicitud vaya a mejorar un 16.9%. Además, estos datos provienen de un experimento de OpenRouter anterior a la colaboración, no de una medición independiente después del lanzamiento de Hugging Face.
💡 Consejo de pruebas: el experimento de enrutamiento ofrece estadísticas globales; el desempeño de tu propio negocio tienes que medirlo tú. Si necesitas comparar en un mismo código la calidad de salida y el costo de varios modelos principales, puedes usar APIYI apiyi.com para invocarlos de forma unificada con una sola clave API: primero define la elección a nivel de modelo y luego considera la optimización a nivel de proveedor.
Cómo conmuta el sistema cuando un Provider se avería
El flujo típico del failover automático es este: el enrutamiento selecciona el Provider A; si A funciona, devuelve la respuesta directamente; si A falla o tiene problemas de capacidad, el sistema prueba con el Provider B dentro de la misma solicitud; si B responde bien, devuelve el resultado. En el experimento, las «solicitudes que necesitan reintento» bajaron del 10.4% al 6.9%, y el tiempo dedicado a intentos fallidos por solicitud bajó de 349 ms a 242 ms. Esto demuestra que un buen enrutamiento no solo debe saber reintentar, sino también evitar desde el principio a los proveedores que están en mal estado.
El retroceso automático y el Provider especificado son dos opciones que se condicionan mutuamente. El enrutamiento predeterminado permite conmutar, lo que da mayor disponibilidad. En cambio, especificar un Provider fija la solicitud a uno solo, cumple con los requisitos de admisión de proveedores, pero pierde el margen de tolerancia a fallos. La propia API de OpenRouter ofrece la combinación de only (permitir solo el Provider indicado) junto con allow_fallbacks: false (no hacer retroceso automático), que permite que la solicitud falle directamente cuando no hay ningún proveedor conforme, en lugar de derivarla a otro proveedor. Cabe aclarar que estos son parámetros de la API completa de OpenRouter y no deben interpretarse como que la interfaz de Hugging Face ya los tiene todos disponibles. La capacidad equivalente del lado de Hugging Face consiste en indicar un Provider y deshabilitar Providers en la configuración.
Los reintentos también tienen coste, y no son infinitos:
- Coste de tiempo: cada intento fallido alarga el tiempo total, algo que se nota especialmente en la interacción en tiempo real.
- Salida en streaming: una respuesta en streaming que ya ha empezado a emitirse no se puede continuar sin cortes en otro proveedor.
- Efectos secundarios duplicados: si una llamada a herramienta ya disparó una acción externa en el primer intento, el reintento puede provocar que se ejecute dos veces, así que la aplicación tiene que encargarse de la idempotencia.
- Pérdida de caché: Prompt Caching normalmente está ligado a un proveedor concreto, y cambiar de proveedor puede hacer que se pierda el beneficio de la caché. Hugging Face ofrece para ello la cabecera
X-HF-Session-Id, que usa un UUID estable para que una misma sesión se quede, en lo posible, en el Provider que tiene la caché. - Sin proveedores disponibles: si un modelo solo tiene un Provider, o si los demás no admiten los parámetros actuales, no hay nada a lo que conmutar. Los problemas de cuota insuficiente, permisos de Token insuficientes, solicitud inválida o contexto excedido tampoco los resuelve el enrutamiento.
Cambios en la facturación de Hugging Face y las claves propias
Esta colaboración trae un cambio disruptivo: al invocar modelos de lenguaje a través de Hugging Face, ya no se puede usar tu propia clave API del proveedor. Todas las solicitudes relacionadas se enrutan vía OpenRouter, y los costos se cargan a la cuenta de Hugging Face o de la organización. Las claves propias para tareas de generación de imágenes y video siguen funcionando, según lo que indique la documentación oficial.
Si un desarrollador quiere seguir usando el saldo del proveedor que compró, puede llamar directamente a la API de ese proveedor o cambiar a su propia cuenta de OpenRouter. Según los términos actuales de la documentación BYOK de OpenRouter: la asignación gratuita de BYOK se mide por el costo equivalente del catálogo de inferencia; las cuentas Pay-as-you-go reciben 25.000 USD al mes, y Enterprise tiene una asignación personalizada; el excedente se factura al 5% del costo equivalente de inferencia y se descuenta de los Credits de la plataforma. Ese 25.000 es costo de inferencia medido en dólares, no número de solicitudes. Además, al recurrir a la capacidad compartida se pueden consumir los Credits de la plataforma. Conectarse directamente a OpenRouter implica otra relación de cuenta y facturación independiente; las claves existentes no se migran automáticamente.
En la documentación de precios actual de Hugging Face, los usuarios Free no tienen una asignación mensual fija; los usuarios PRO reciben 2 USD al mes, y Team y Enterprise reciben 2 USD por asiento al mes. Estas asignaciones son Compute Credits genéricos, que se pueden usar para cubrir servicios como Inference Providers, Inference Endpoints y Spaces. Vale la pena señalar otro punto: que el mecanismo de precios de los proveedores no cambie no significa que el costo por solicitud no cambie, porque el enrutamiento puede elegir un proveedor un poco más caro pero más rápido y estable.
Cómo los desarrolladores pueden comparar por su cuenta varios proveedores usando la API de catálogo
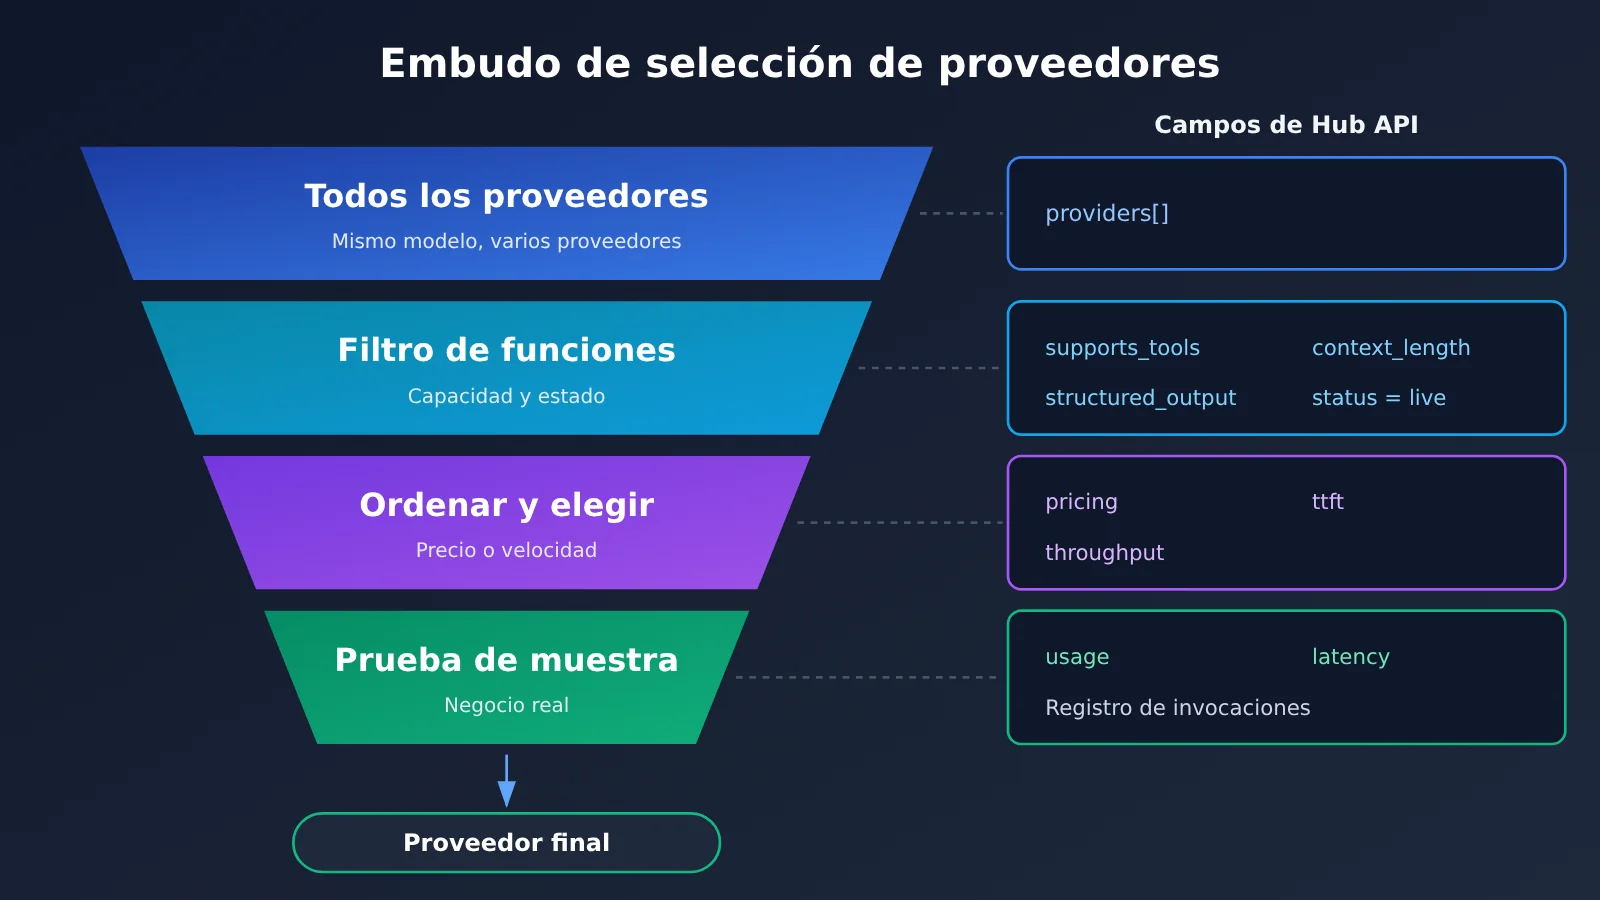
Hugging Face ofrece una interfaz consultable de catálogo de modelos, que es una ventana pública por la que el sistema de enrutamiento obtiene información para tomar decisiones:
- Todos los modelos:
GET https://router.huggingface.co/v1/models - Un modelo concreto:
GET https://router.huggingface.co/v1/models/deepseek-ai/DeepSeek-V4-Pro
| Campo | Significado | Papel en la selección del modelo |
|---|---|---|
| provider | Proveedor que realmente ofrece la inferencia | Determinar la lista de candidatos |
| status | Estado actual, por ejemplo live, error | Descartar proveedores no disponibles |
| context_length | Longitud de contexto que admite ese proveedor | Filtrar requisitos de contexto largo |
| pricing.input / pricing.output | Precio en USD por cada millón de tokens de entrada y salida | Ordenar por coste |
| supports_tools | Si admite llamadas a herramientas | Requisito indispensable para escenarios de Agent |
| supports_structured_output | Si admite salida estructurada | Requisito indispensable para salida JSON |
| first_token_latency_ms | Latencia del primer token de la última sonda de verificación | Ordenar para casos de uso interactivos |
| throughput | Velocidad de generación de la última sonda de verificación | Ordenar para casos de salidas largas |
| is_free / is_model_author | Promoción gratuita temporal / si es el autor del modelo | Referencia auxiliar |
Estos campos no están completos en todos los proveedores, y los datos de rendimiento proceden de la última sonda de verificación; no equivalen a tu propio rendimiento real de extremo a extremo. Lo razonable es «primero filtrar, luego ordenar»: descartar con los campos de funcionalidad a los proveedores incompatibles y después ordenar por coste o velocidad. El siguiente ejemplo muestra esta idea; consulta la documentación oficial de la Hub API para conocer la estructura exacta de la respuesta:
import os
import requests

HF_TOKEN = os.environ["HF_TOKEN"]
MODEL = "deepseek-ai/DeepSeek-V4.1-Flash"

resp = requests.get(
    f"https://router.huggingface.co/v1/models/{MODEL}",
    headers={"Authorization": f"Bearer {HF_TOKEN}"},
    timeout=30,
)
data = resp.json()
providers = data.get("providers", [])  # La estructura concreta se rige por la documentación oficial

# Paso 1: filtrado por funcionalidad (el Agent necesita llamadas a herramientas + salida estructurada + contexto de 64K)
candidates = [
    p for p in providers
    if p.get("status") == "live"
    and p.get("supports_tools")
    and p.get("supports_structured_output")
    and (p.get("context_length") or 0) >= 64_000
]

# Paso 2: ordenar por precio unitario de salida; los campos faltantes van al final
candidates.sort(key=lambda p: (p.get("pricing") or {}).get("output", float("inf")))

for p in candidates:
    print(p["provider"], p.get("pricing"), p.get("first_token_latency_ms"), p.get("throughput"))
Después de filtrar los candidatos, debes probarlos de nuevo con solicitudes reales de tu negocio. Los metadatos del catálogo indican «lo que el proveedor afirma admitir», pero no sustituyen la precisión, la tasa de éxito de las llamadas a herramientas y la tasa de finalización final en tus propias tareas.
Antes de ajustar a nivel de proveedor, normalmente también hay que decidir qué modelo usar. El siguiente fragmento de código muestra cómo comparar por lotes las respuestas de varios modelos usando la misma interfaz compatible con OpenAI. Sustituye los ID de modelo por los nombres reales de la lista de modelos de la plataforma:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI: interfaz unificada, una sola clave para invocar varios modelos
)

prompt = "用 JSON 返回:{\"city\": 城市名, \"reason\": 一句话理由},推荐一个适合冬季旅行的城市"

for model in ["model-id-a", "model-id-b", "model-id-c"]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, resp.usage.total_tokens, resp.choices[0].message.content)
🚀 Inicio rápido: Los nuevos usuarios pueden reclamar crédito de prueba gratuito en APIYI apiyi.com y usar el código de arriba para ejecutar un conjunto de muestras de su propio negocio. Los registros de invocación del backend guardan, en cada solicitud, el modelo utilizado, el consumo de tokens y el costo, lo que facilita calcular el costo real por tarea en lugar de fijarse solo en el precio de lista.
Cabe aclarar que el acceso unificado más los registros de invocación, por un lado, y los datos de rendimiento en tiempo real a nivel de proveedor que muestra Hugging Face, por otro, son funciones de niveles distintos: la primera resuelve «conectar y calcular con precisión», mientras que la segunda muestra además el estado dinámico de los proveedores subyacentes. Ambas pueden usarse en conjunto.
Múltiples proveedores de API y enrutamiento inteligente: análisis y criterio
¿Dónde está la próxima competencia de las plataformas de agregación de API?
Si descomponemos las capacidades de OpenRouter, podemos dividirlas en tres capas: la agregación de modelos resuelve «cómo acceder a diferentes modelos», la agregación de proveedores resuelve «quién infiere para un mismo modelo» y el enrutamiento dinámico resuelve «a quién debe entregarse esta solicitud». La interfaz unificada ya ha resuelto básicamente el problema del acceso; esta colaboración demuestra que la segunda y la tercera capa están convirtiéndose en nuevos puntos de competencia. La base de este juicio es: Hugging Face eligió abandonar su propio router y adoptar capacidades de enrutamiento externas; OpenRouter también publicó por separado su algoritmo de enrutamiento y demostró su valor mediante experimentos en producción.
Se puede prever que la optimización de costos, la estabilidad y la gobernanza de datos se convertirán en nuevas dimensiones de comparación para las plataformas de API. La siguiente es una predicción que aún está pendiente de verificación posterior: la transparencia del enrutamiento será cada vez más importante, y los desarrolladores querrán saber a qué proveedor de servicios llegó la solicitud, por qué se eligió y cuánto se pagó; las restricciones de las políticas de datos podrían pasar de ser una opción adicional a un requisito obligatorio para la adquisición empresarial.
Sin embargo, el enrutamiento no es una panacea. Los datos experimentales muestran que la velocidad y la estabilidad adicionales tienen como precio un mayor costo unitario. Los planes de seguimiento en el anuncio de colaboración (por ejemplo, conectar las cuentas de ambas partes y incluir más tareas en el enrutamiento de OpenRouter) también siguen siendo solo planes. El enrutamiento tampoco puede resolver los problemas de calidad, licencias y adaptación empresarial de los propios modelos.
Demanda de modelos de pesos abiertos y presión de costos en las empresas
Los datos del lado de la demanda respaldan la idea de que «la orquestación entre proveedores está cobrando importancia». Las estadísticas de OpenRouter muestran que, si se calcula sobre el volumen semanal de tokens de los 50 modelos principales, el 28 de septiembre de 2026 los modelos de pesos abiertos llegaron al 71.7%. Se trata de una métrica interna de la plataforma OpenRouter y no debe extrapolarse como cuota de mercado global. Cuanto mayor es el uso de modelos de pesos abiertos, más común resulta que varios proveedores ofrezcan el mismo modelo, y más evidente se vuelve el valor del enrutamiento.
Del lado de los costos, Capgemini encuestó en septiembre de 2026 a 500 directivos (CXO) de grandes empresas: el 59% señaló que el gasto en IA supera claramente lo previsto y, entre las empresas afectadas, el exceso promedio fue del 24%. Estos datos representan solo la muestra de esa encuesta, pero, al ponerlos junto a la conclusión del experimento de enrutamiento —«más velocidad implica más costo»—, sirven para recordar algo a las empresas: el enrutamiento automático busca por defecto una experiencia global equilibrada, no necesariamente la factura más baja. Para los casos de uso sensibles al costo, conviene elegir de forma proactiva una estrategia priorizada por precio o establecer un tope de precio, y verificar de forma continua con los registros de invocaciones.
Cómo decidir según el rol
- Desarrolladores individuales y equipos pequeños: el enrutamiento automático por defecto ya te ahorra el trabajo de montar tu propia tolerancia a fallos; la clave está en validar con muestras reales si la invocación de herramientas y la salida JSON son estables. Primero definir el modelo a través de una interfaz unificada como APIYI apiyi.com y luego optimizar a nivel de proveedor según haga falta: es un camino de baja inversión.
- Productos interactivos: céntrate en el TTFT P95 antes que en el throughput.
:fastestno necesariamente mejora la sensación percibida en respuestas cortas. - Tareas de salida larga y procesamiento por lotes: el throughput y el precio efectivo importan más; vale la pena considerar una estrategia priorizada por precio y aprovechar la afinidad de sesión para conservar los beneficios de la caché.
- Equipos empresariales y de plataforma: primero haz inventario de qué aplicaciones dependen de su propia Provider Key y qué procesos de negocio exigen un proveedor fijo; después decide si permitir fallback, limitar los proveedores o conectarte directamente a uno. Los acuerdos de procesamiento de datos deben revisarse uno por uno.
Sea cual sea la estrategia que elijas, al final todo se reduce a la misma acción: hacer una prueba con tus propias solicitudes y tus propias métricas. Usar la cuota gratuita de APIYI apiyi.com para una comparación a pequeña escala, o filtrar primero los proveedores candidatos con la API del catálogo de Hugging Face, son puntos de partida de muy bajo costo. El 16.9% del experimento oficial es un promedio general; cuánto puede ganar tu negocio, solo lo sabrás después de medirlo.
The proof of the pudding is in the eating. (Al final, la única forma de comprobar los resultados es ponerlo en práctica.)