Nota del autor: Todos llevan Flash en el nombre, pero sus modalidades de entrada, endpoints y multiplicadores de grupo son distintos. Este artículo explica cómo elegir un modelo Flash en este orden: primero revisar la página del modelo, luego comparar precios y, por último, seleccionar según la tarea.
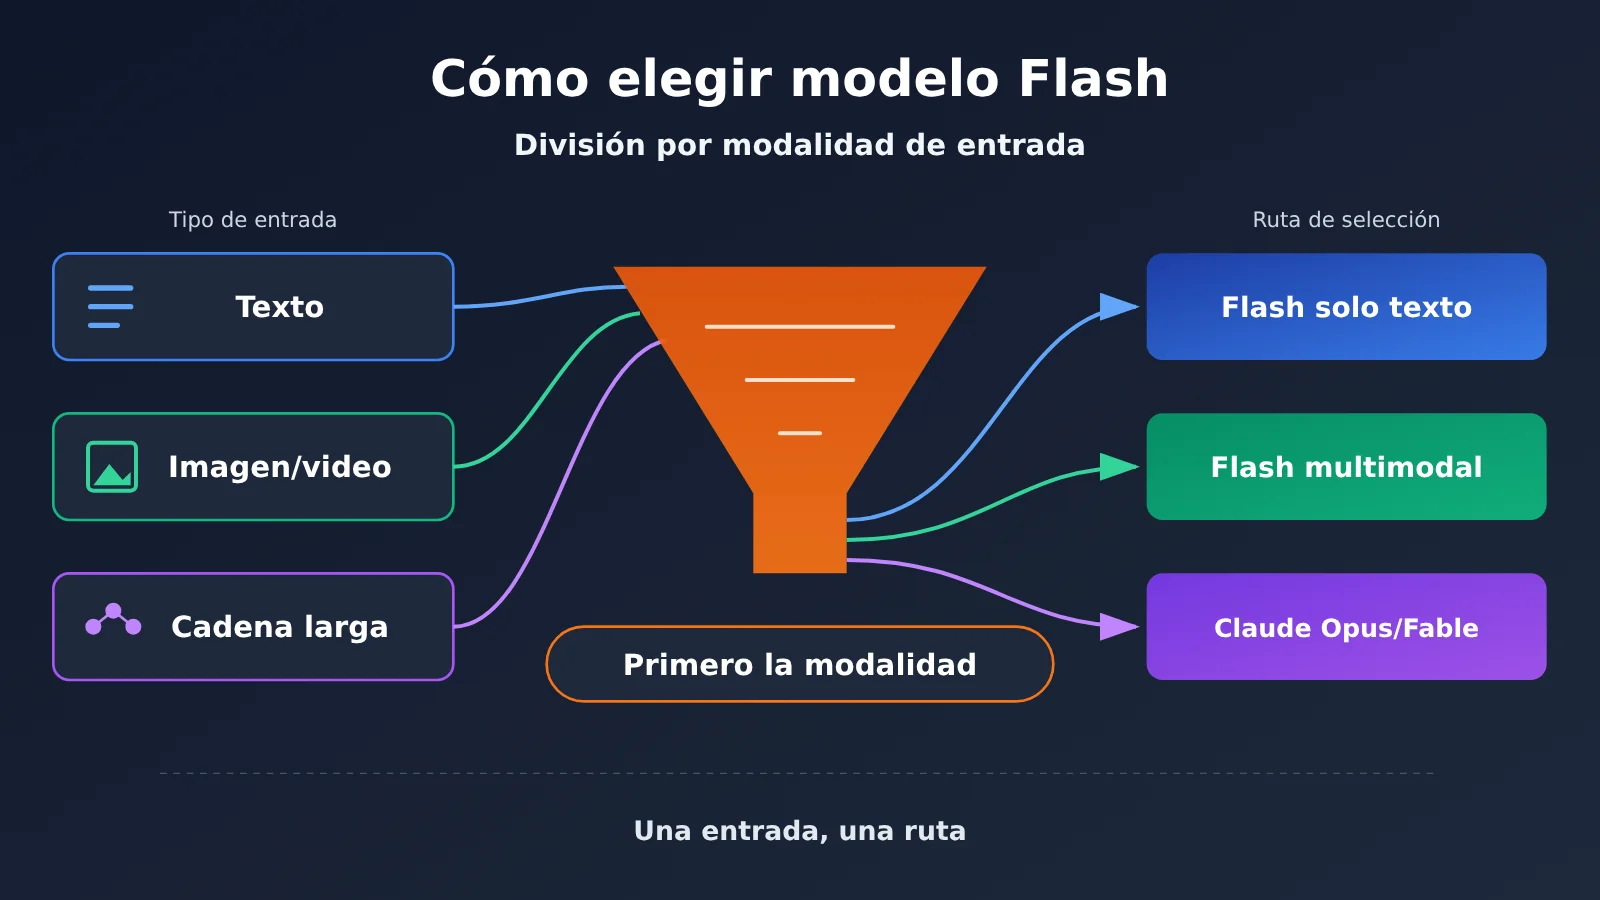
Mucha gente elige modelos de la gama Flash así: si el nombre incluye Flash, lo da por “rápido y barato” y le encarga lo mismo programar, analizar imágenes o resolver fórmulas. El problema de hacerlo así es que los modelos con Flash en el nombre no tienen la misma modalidad de entrada ni los mismos endpoints disponibles. Algunos solo aceptan texto; otros pueden leer imágenes y videos; y algunos ni siquiera funcionan con /v1/messages.
Este no es un ranking de “quién es el más fuerte”. Este artículo no declara qué modelo es mejor o más barato en todos los casos; solo ofrece una serie de pasos aplicables para elegir modelos Flash: primero revisar los tipos de entrada y el uso que indica la página del modelo, después comparar los precios de entrada, salida y lectura de caché y, por último, asignar cada tarea a un modelo concreto.
Valor principal: después de leer este artículo, podrás elegir un modelo Flash cuya modalidad encaje con tu tipo de entrada (texto puro, capturas de pantalla de gráficos o videos largos). También sabrás qué tareas de razonamiento pesado no conviene delegar a Flash por defecto.
Puntos clave para elegir un modelo Flash
| Punto clave | Descripción | Valor |
|---|---|---|
| Primero, revisa la modalidad de entrada | El tipo de entrada indicado en la página del modelo (texto/imagen/video/audio) determina si puede recibir tus datos | Evita enviar capturas de pantalla a un modelo que solo acepta texto |
| Luego, revisa los endpoints | Cada modelo tiene un soporte distinto para los endpoints chat, messages y gemini | Evita que la interfaz falle directamente al cambiar de modelo |
| Compara los tres precios | El precio de entrada, el precio de salida y la lectura de caché deben revisarse en conjunto, y luego multiplicar por el multiplicador de grupo | La estimación de la factura se acerca más a la real |
| Asigna según la tarea | Para leer gráficos o modificar código corto, usa un Flash cuya modalidad coincida | El costo de las tareas de alto volumen se mantiene controlable |
| Para razonamiento pesado, elige otro modelo | Para fórmulas, demostraciones y tareas técnicas de cadena larga, no uses Flash por defecto | Deja los problemas difíciles a modelos de posicionamiento superior |
Por qué no se puede aplicar un criterio único a los modelos Flash solo por su nombre
«Flash» es solo el nombre que el fabricante da a una categoría de modelos, y cada proveedor lo define de manera distinta. En la página de modelos de APIYI (docs.apiyi.com/models.md) se puede ver que, entre varios modelos que también se llaman Flash, las modalidades de entrada van desde «solo texto» hasta «texto, imagen, video y audio». Los endpoints también varían desde «chat y messages» hasta «solo chat».
Por eso, al elegir un modelo Flash, el nombre solo te ayuda a delimitar que se trata de una categoría orientada a alto volumen y baja latencia. Lo que realmente determina si puedes usarlo son las tres columnas de información de la página del modelo: tipo de entrada, endpoints compatibles y multiplicador de grupo. Todos los datos a continuación provienen de la página del modelo y de la tabla general de modelos. La fecha de verificación es 2026-11-17; los datos de la tabla general se actualizaron el 2026-11-16 09:39 (UTC+8). Los precios están en unidades de precio de lista predeterminado por millón de tokens.
Modalidades de entrada y endpoints de los modelos Flash
La siguiente tabla reúne las modalidades de entrada y los endpoints de varios modelos Flash. El primer paso para elegir un modelo es descartar aquí los que no coinciden en modalidad o en endpoint.
| ID del modelo | Modalidad de entrada | Salida | Endpoint | Otras notas de la página del modelo |
|---|---|---|---|---|
deepseek-v4-flash |
Solo texto | Texto | chat, messages | No admite salida estructurada; admite llamadas a herramientas, razonamiento profundo opcional y caché de indicaciones |
deepseek-v4.1-flash |
Sin página de modelo individual | — | chat, messages | Solo una fila en la tabla general; las capacidades quedan sujetas a la descripción oficial posterior |
gemini-3.8-flash |
Texto, imagen, video, audio | Texto | chat, gemini (sin messages) | Razonamiento profundo activado por defecto, niveles de razonamiento low/medium/high; especificaciones oficiales aún no publicadas |
qwen3.8-flash |
Texto, imagen, video | Texto | Solo chat | Ventana de contexto 1,000,000, salida máxima 131,072 |
glm-5.3-flash |
Texto, imagen, video | Texto | Solo chat | Ventana de contexto 1,000,000, salida máxima 128,000; razonamiento profundo activado por defecto |
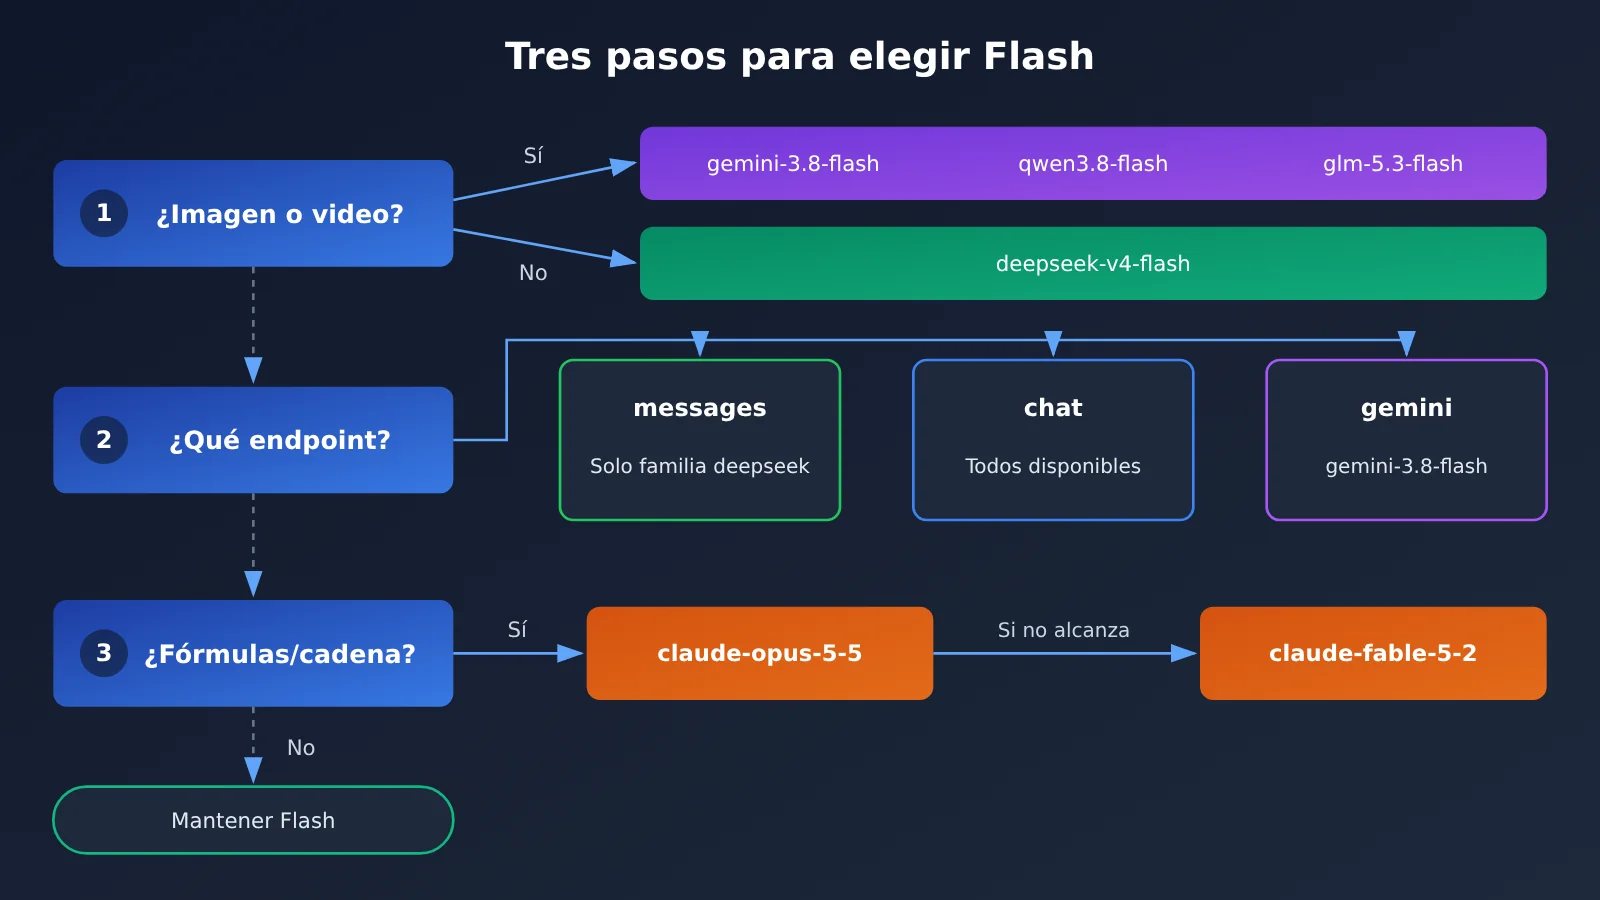
Hay dos puntos que conviene tener muy en cuenta. Primero, el «solo texto», la ventana de contexto de 1,048,576 y la salida máxima de 393,216 de deepseek-v4-flash son datos de la página del modelo v4, y no se pueden trasladar a deepseek-v4.1-flash. De v4.1, por ahora, solo hay una fila en la tabla general; si las capacidades no están claras, mejor no asumirlas. Segundo, si tu proyecto usa la interfaz /v1/messages al estilo de Anthropic, ninguno de los Flash multimodales servirá; tendrás que cambiar al endpoint chat.
Cómo comparar precios y grupos de los modelos Flash
Una vez validadas las modalidades y el endpoint, toca comparar los precios. Cambiar de modelo altera directamente la factura, y el precio de lista no equivale al cargo real, porque los grupos de tokens de APIYI en apiyi.com llevan multiplicadores. La tabla siguiente recoge el precio de lista predeterminado y los grupos indicados en la página de cada modelo.
| ID del modelo | Precio de entrada | Precio de salida | Lectura de caché | Grupos y multiplicador |
|---|---|---|---|---|
deepseek-v4-flash |
$0.44 | $1.32 | $0.01408 | ClaudeCode 0.95×; CodexResponses, Default, SVIP 1× |
deepseek-v4.1-flash |
$0.3 | $1.2 | $0.006 | ClaudeCode, CodexResponses, Default, SVIP |
gemini-3.8-flash |
$0.75 | $3.75 | $0.075 | Gemini_Reverse 0.5×; Default, SVIP 1× |
qwen3.8-flash |
$0.114 | $0.3876 | $0.01425 | Default, SVIP 1× |
glm-5.3-flash |
$0.15 | $0.5 | $0.03 | CodexResponses, Default, SVIP |
claude-opus-5-5 |
$4 | $20 | $0.2 | Ver tabla general de modelos |
claude-fable-5-2 |
$8 | $40 | $0.2 | Sin grupo Claude_Reverse |
Tres puntos para conciliar la factura de los modelos Flash
Este artículo no decide por ti quién es más barato, porque el costo real depende de tu proporción de entrada/salida y de la tasa de aciertos de caché. Te sugiero revisar tu factura con estos tres pasos:
- Fíjate en la proporción de entrada y salida: en tareas como ver imágenes o leer documentos, la entrada es grande y la salida pequeña, así que el precio de entrada pesa más; en tareas como generar código o informes largos, el precio de salida pesa más.
- Fíjate en la lectura de caché: en escenarios donde la indicación del sistema es fija y las llamadas se repiten, el precio de lectura de caché afecta de forma notable a la factura total.
- Multiplica por el multiplicador del grupo: el mismo
gemini-3.8-flash, si pasa por el grupo Gemini_Reverse se liquida a 0.5×, y si pasa por Default a 1×; la factura no da el mismo número.
💰 Consejo de costos: el grupo al que se vincula el token cambia directamente el resultado del cargo. Antes de cambiar de modelo, entra en la consola de APIYI en apiyi.com y confirma el grupo del token actual; después estima multiplicando el precio de lista de la tabla anterior por el multiplicador. Así evitas descubrir el cambio en la factura solo después de lanzar.
Elegir un modelo Flash según la tarea
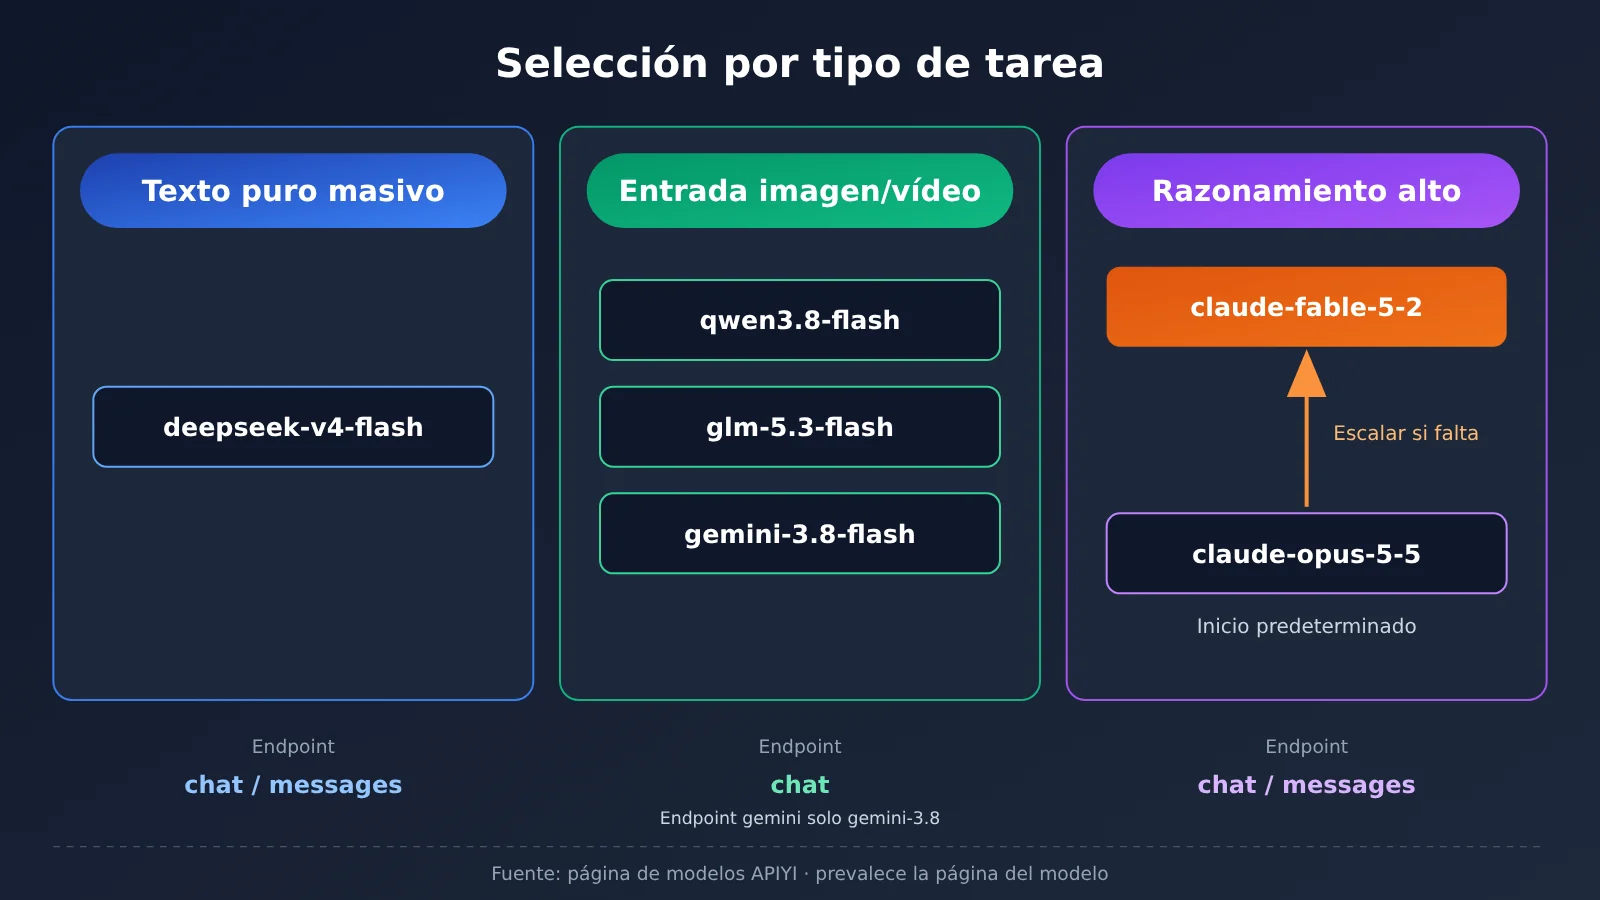
Una vez revisadas las modalidades, los endpoints y los precios, ya podemos concretar según la tarea. La siguiente tabla ofrece una guía de selección por tarea. La asignación se basa en la información de las páginas de cada modelo; las capacidades concretas deben consultarse en dichas páginas.
| Tipo de tarea | Características de entrada | Modelos candidatos | Criterio de selección |
|---|---|---|---|
| Modificar código corto, procesamiento de texto de alta concurrencia | Solo texto | deepseek-v4-flash |
La página del modelo indica textualmente que está orientado a alta concurrencia y baja latencia; admite el endpoint messages |
| Ver capturas de pantalla y modificar código, leer gráficos | Texto + imagen | qwen3.8-flash, glm-5.3-flash, gemini-3.8-flash |
La modalidad de entrada incluye imagen; admite comprensión visual |
| Análisis de documentos y vídeos largos | Texto + vídeo | qwen3.8-flash, glm-5.3-flash, gemini-3.8-flash |
La modalidad de entrada incluye vídeo; la página del modelo qwen menciona textualmente este tipo de escenarios de alto volumen |
| Entradas con audio | Texto + audio | gemini-3.8-flash |
De todos ellos, solo la página de este modelo menciona entrada de audio |
| Fórmulas, demostraciones, trabajo técnico de varios pasos | Derivación intensiva | claude-opus-5-5 → claude-fable-5-2 |
Ninguna de las cuatro páginas de modelos Flash presenta el cálculo científico como una especialidad |
Selección del modelo Flash para tareas de programación
Si la entrada solo trae código e instrucciones en texto, el modelo cuya modalidad encaja es deepseek-v4-flash. En su página de modelo pone, textualmente, «MoE de 284B de parámetros totales y 13B activos, pensado para alta concurrencia y baja latencia»; eso es texto de la página del modelo, no datos medidos en este artículo. Admite tanto el endpoint chat como el de messages, así que es el que exige menos cambios si lo conectas a un cliente de estilo Anthropic. Ojo: en la casilla de salida estructurada figura como no compatible, así que si dependes de JSON Schema para restringir la salida, tendrás que resolverlo por otra vía.
Si la tarea de programación incluye capturas de pantalla —por ejemplo, «cambia el frontend siguiendo este diseño»— hay que pasar a un Flash multimodal. En la página de qwen3.8-flash pone, textualmente, que «viene bien para escenarios de alto volumen como codificación visual, documentos y análisis de videos largos». La página de glm-5.3-flash indica 320B de parámetros totales, 18B activos, y una puntuación de 84.3 en Terminal-Bench 2.1. Ambas cifras salen de la página del modelo, no son mediciones de este artículo, y tampoco significan que supere en todo a los otros modelos.
Selección del modelo Flash para imágenes y videos largos
Para leer gráficos, interpretar capturas de PDF y analizar videos largos, la modalidad de los tres Flash multimodales encaja. La diferencia está sobre todo en el endpoint y en la sección de funciones: gemini-3.8-flash admite además entrada de audio y ejecución de código, y puede usar el endpoint gemini; qwen3.8-flash y glm-5.3-flash solo tienen el endpoint chat. En gemini-3.8-flash y glm-5.3-flash el razonamiento profundo viene activado por defecto, algo que conviene tener en cuenta en tareas de alto volumen sensibles a la latencia.
No usar Flash por defecto para tareas de derivación pesada
Aquí conviene dejar claro el límite: Flash no es que no sepa calcular en absoluto, sino que ninguna de las cuatro páginas de modelos presenta el cálculo científico, las demostraciones o la física como una especialidad, así que no deberíamos confiarle este tipo de tareas por defecto. En su anuncio del 2026-11-09, Anthropic posicionó Claude Fable 5.2 para los trabajos técnicos más difíciles y recomendó partir de Opus 5.5 para la mayoría de tareas de programación y conocimiento, y subir a Fable solo cuando no sea suficiente.
Ambos modelos ya están disponibles en APIYI, con ID de modelo claude-opus-5-5 y claude-fable-5-2. Sus precios de lista son claramente más altos que el nivel Flash, por lo que lo más razonable es dividir el trabajo: las tareas de alto volumen van a Flash; solo se sube de nivel para derivación de fórmulas, demostraciones y análisis técnico de cadenas largas.
Inicio rápido con el modelo Flash
Una vez definido el modelo, los pasos de integración son muy sencillos. APIYI ofrece una interfaz compatible con OpenAI, y con una sola API Key puedes invocar todos los modelos anteriores. A continuación repasamos los puntos clave de configuración, tal como se describen en la documentación de ayuda.
Paso 1: configurar el base_url y los endpoints del modelo Flash
- En el cliente, establece el
base_urlcomohttps://api.apiyi.com/v1y coloca en API Key el token que creaste en la consola. - Elige la ruta según el modelo: todos pueden usar
/v1/chat/completions; solodeepseek-v4-flash(ydeepseek-v4.1-flash, como se indica en la tabla general) pueden usar/v1/messages;gemini-3.8-flashtambién puede usar el endpoint de Gemini. - En el campo
modeldel cuerpo de la petición, escribe el ID del modelo, por ejemploqwen3.8-flash.
Paso 2: organizar las peticiones del modelo Flash según la modalidad de entrada
- Solo texto: basta con incluir
roley elcontentde texto dentro demessages; aplica adeepseek-v4-flash. - Con imágenes: en el formato chat, escribe
contentcomo un array, usandotypeigual atextpara el elemento de texto ytypeigual aimage_urlpara el elemento de imagen. Envíalo únicamente a modelos que admiten entrada de imágenes. - Activar streaming: establece
streamentrue; útil en escenarios de alta concurrencia donde necesitas que el primer token se devuelva rápido.
Paso 3: lista de verificación antes de cambiar de modelo Flash
- ¿El nuevo modelo admite el endpoint que estás usando actualmente? Si vienes de messages y cambias a un Flash multimodal, tienes que pasar a chat.
- ¿El nuevo modelo admite las funciones de las que dependes? Por ejemplo, la salida estructurada está marcada como no compatible en
deepseek-v4-flash. - ¿Cuál es el multiplicador del nuevo modelo dentro del grupo de tokens actual?
🚀 Inicio rápido: te recomiendo empezar con el crédito de prueba gratuito para nuevos usuarios en APIYI apiyi.com, enviar el mismo lote de entradas reales a dos o tres modelos Flash candidatos, comparar la calidad de salida y el consumo de tokens, y después decidir el cambio definitivo. Solo necesitas modificar el campo
modelpara cambiar entre un modelo y otro.
Preguntas frecuentes (FAQ)
Q1: ¿Qué significa realmente «modelo Flash»?
Flash es un nombre que los fabricantes dan a una clase de modelos orientados al volumen y a la baja latencia; no es un estándar unificado. Los Flash de cada fabricante difieren bastante en modalidades de entrada, endpoints y funciones compatibles. Para elegir hay que mirar la página del modelo, no solo el nombre.
Q2: ¿Se pueden intercambiar deepseek-v4-flash y deepseek-v4.1-flash?
No conviene darlo por hecho. Por ahora v4.1 solo tiene una fila en la tabla general: entrada $0.3, salida $1.2, lectura de caché $0.006, endpoints chat y messages. El número de parámetros, la ventana de contexto y la característica «solo texto» de v4 no se pueden trasladar a v4.1; antes de reemplazar, guíate por la tabla general y por las notas posteriores del modelo.
Q3: ¿Por qué mi cliente estilo Claude no puede llamar a gemini-3.8-flash?
Porque los endpoints de `gemini-3.8-flash` son chat y gemini, no incluye messages. `qwen3.8-flash` y `glm-5.3-flash` también solo tienen chat. Si necesitas el endpoint messages, los únicos candidatos que quedan son los Flash de la familia deepseek.
Q4: ¿Por qué el mismo modelo cobra distinto según el token?
Porque el multiplicador del grupo es diferente. Por ejemplo, `gemini-3.8-flash` en el grupo Gemini_Reverse es 0.5×, y en Default es 1×. Para la relación entre tokens y grupos puedes consultar la documentación de APIYI en docs.apiyi.com/faq/token-and-groups.md.
Q5: ¿Cómo llamar rápidamente a estos modelos Flash mediante la API?
Regístrate en APIYI apiyi.com y crea un token, configura base_url como `https://api.apiyi.com/v1`, elige la ruta chat o messages según el modelo y pon el ID correspondiente en `model`. Los usuarios nuevos tienen crédito de prueba gratuito, así que puedes validar primero con un lote pequeño.
Q6: ¿Los modelos Flash pueden hacer derivaciones matemáticas o cálculo científico?
Pueden manejar cálculos generales, pero ninguna de las páginas de modelo presenta el cálculo científico, las demostraciones o la física como especialidad. Para fórmulas, demostraciones y tareas técnicas de cadena larga, se recomienda empezar con `claude-opus-5-5` y, si no alcanza, subir a `claude-fable-5-2`.
Q7: ¿Se puede usar directamente la puntuación de Terminal-Bench de la página del modelo como base para elegir?
La página del modelo `glm-5.3-flash` dice textualmente que la puntuación en Terminal-Bench 2.1 es 84.3; eso es lo que aparece en la página del modelo, no una medición de este artículo. Puede servir como señal de referencia, pero no significa que ese modelo sea más fuerte en todas las tareas; al final, se recomienda validar con tus propios datos reales.
Puntos clave para elegir un modelo Flash
- El nombre no equivale a la capacidad: los modelos que llevan Flash en el nombre no coinciden ni en modalidades de entrada ni en endpoints.
- Primero, revisa la modalidad: para texto puro, elige
deepseek-v4-flash; si incluye imagen y video, elige un Flash multimodal. - Segundo, revisa el endpoint:
messagessolo está disponible en la familia deepseek; la mayoría de los Flash multimodales solo funcionan conchat. - Tercero, revisa la factura: considera en conjunto el precio de entrada, el de salida y el de lectura de caché, y luego multiplica por el factor de grupo de tokens.
- Cita la fuente de las cifras de la página del modelo: el número de parámetros, Terminal-Bench y «apto para codificación visual» son texto original de la página del modelo.
- Para razonamiento pesado, no uses Flash por defecto: para demostrar fórmulas, empieza por
claude-opus-5-5; si no basta, pasa aclaude-fable-5-2. - Valida con lotes pequeños antes de cambiar: en APIYI, usa la cuota gratuita con entradas reales y luego decide si haces el cambio definitivo.
Resumen
La clave para elegir un modelo Flash se resume en una frase: elige según la modalidad de entrada, no lo decidas solo por el nombre.
- Primero, revisa la página del modelo: confirma los tipos de entrada, los endpoints y las funciones compatibles, y descarta los modelos que no encajan.
- Después, compara precios: revisa el precio de entrada, el de salida y el de lectura de caché según tu proporción de invocaciones, y multiplica por el factor de grupo de tokens.
- Asigna según la tarea: las tareas de gran volumen, como interpretar gráficos y editar código breve, dale a un Flash cuya modalidad encaje; las tareas de razonamiento pesado, a Claude Opus 5.5 o Fable 5.2.
Los precios y las capacidades se actualizan; al elegir, toma como referencia la página del modelo del día. Te recomiendo que en APIYI apiyi.com compares varios modelos candidatos con la misma clave API en lotes pequeños, y luego decidas según tu factura y la calidad de los resultados.
📚 Referencias
-
Anuncio de Anthropic – Claude Fable y Mythos 5.2: posicionamiento de Fable 5.2 y recomendaciones para empezar a usarlo con Opus 5.5
- Enlace:
anthropic.com/claude-fable-and-mythos-5-2 - Descripción: entender la base para repartir modelos en tareas de re-derivación
- Enlace:
-
Resumen de modelos Claude: lista oficial de modelos de Anthropic y explicación de uso
- Enlace:
platform.claude.com/docs/en/about-claude/models/overview - Descripción: recomendaciones de uso de Opus y Fable, coherentes con el anuncio
- Enlace:
-
Tabla general de modelos y páginas de modelos de APIYI: precios, grupos, endpoints y modalidades de entrada
- Enlace: centro de documentación models.md y las páginas de cada modelo (deepseek-v4-flash, gemini-3-8-flash, qwen3-8-flash, glm-5-3-flash)
- Descripción: aquí está la fuente de todos los datos de precios y capacidades de este artículo; antes de elegir, consulta siempre la versión más reciente
Autor: Equipo técnico de APIYI
Intercambio técnico: puedes contactarnos desde la página principal del sitio de APIYI; para más información sobre modelos y grupos, visita el centro de documentación docs.apiyi.com