Autorhinweis: Zwei Tarife, auf denen beide „10 Millionen Token“ steht, können sich in der Menge der tatsächlich erledigbaren Aufgaben um ein Vielfaches unterscheiden. Dieser Artikel bietet eine praktische Umrechnungsmethode, mit der du entscheiden kannst, ob für dich ein Abonnement oder nutzungsbasierte Abrechnung besser passt.
Beim Vergleich von Token-Kontingenten schauen viele Entwickler zuerst auf „wie viele Token pro Monat, wie viel Geld pro Monat“ und rechnen dann direkt den Preis pro Token aus. Diese Rechnung wirkt plausibel, ignoriert aber Unterschiede bei Caching, Ausgabe, Modellmultiplikatoren und Zeitfenstern. Dieser Artikel stellt die Umrechnungsmethode „Äquivalente Kosten pro Aufgabe“ vor, mit der du verschiedene Tarife auf eine gemeinsame Skala bringst.
Dies ist kein allgemeiner Beitrag nach dem Motto „Abonnement ist günstiger“ oder „nutzungsbasierte Abrechnung ist flexibler“, sondern eine Methode, mit der du anhand deiner eigenen Nutzungsdaten zu einem Ergebnis kommst. Der Artikel nennt keine ungeprüften Preise. Bei den Modellpreisen und der Abrechnungslogik von APIYI gelten die tatsächlichen Angaben auf der Preisseite https://docs.apiyi.com/models.
Der Kernnutzen: Nach der Lektüre kannst du Token-Nutzungsfelder auslesen, Abrechnungsregeln aufschlüsseln, den Break-even-Punkt berechnen und eine zu dir passende Entscheidung treffen.
Kernpunkte zum Kontingent von Token-Paketen
Token ist nur eine Maßeinheit, keine einheitliche Werteinheit. Die Stückpreise für Token bei Eingabe, Ausgabe und Cache-Lesezugriffen unterscheiden sich oft, und bei manchen Paketen kommen modellabhängige Multiplikatoren hinzu. Ein nominal gleich hohes Kontingent bedeutet daher nicht, dass es auch den gleichen tatsächlichen Wert hat.
| Aspekt | Erläuterung | Auswirkung auf die Auswahl |
|---|---|---|
| Abrechnungsgrundlage | Ob Cache-Lesezugriffe, Cache-Schreibvorgänge und Reasoning-Token auf das Kontingent angerechnet werden | Entscheidet, wie viel Kontingent eine Aufgabe verbraucht |
| Modellgewichtung | Verschiedene Modelle können das Kontingent mit unterschiedlichen Faktoren belasten | Entscheidet, wie lange High-End-Modelle tatsächlich nutzbar bleiben |
| Zeitfenster | Es kann stündliche, wöchentliche oder monatliche Limits geben | Entscheidet, ob das Kontingent auch in Spitzenzeiten verfügbar ist |
| Form des Kontingents | Kann in Token, Anfragen, Punkten oder Nachrichten gemessen werden | Entscheidet, ob ein direkter Vergleich mit anderen Angeboten möglich ist |
| Aufgabenstruktur | Kontextlänge, Gesprächsrunden und Cache-Trefferquote unterscheiden sich | Entscheidet über die endgültigen Kosten pro Aufgabe |
Warum die Zahlen beim Kontingent von Token-Paketen verzerrt werden
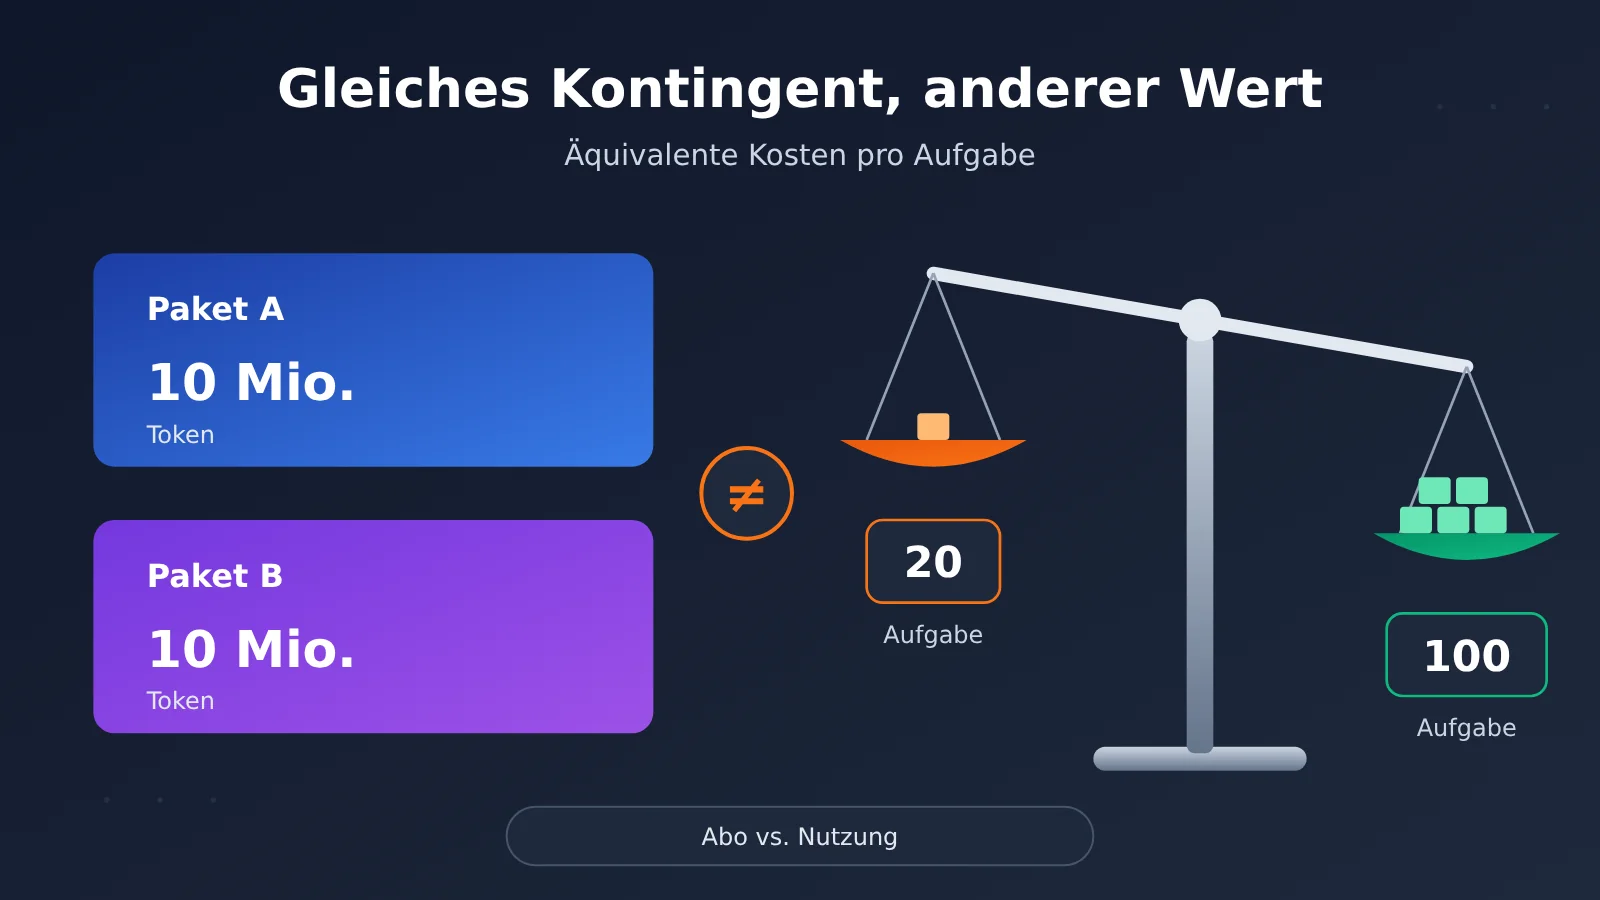
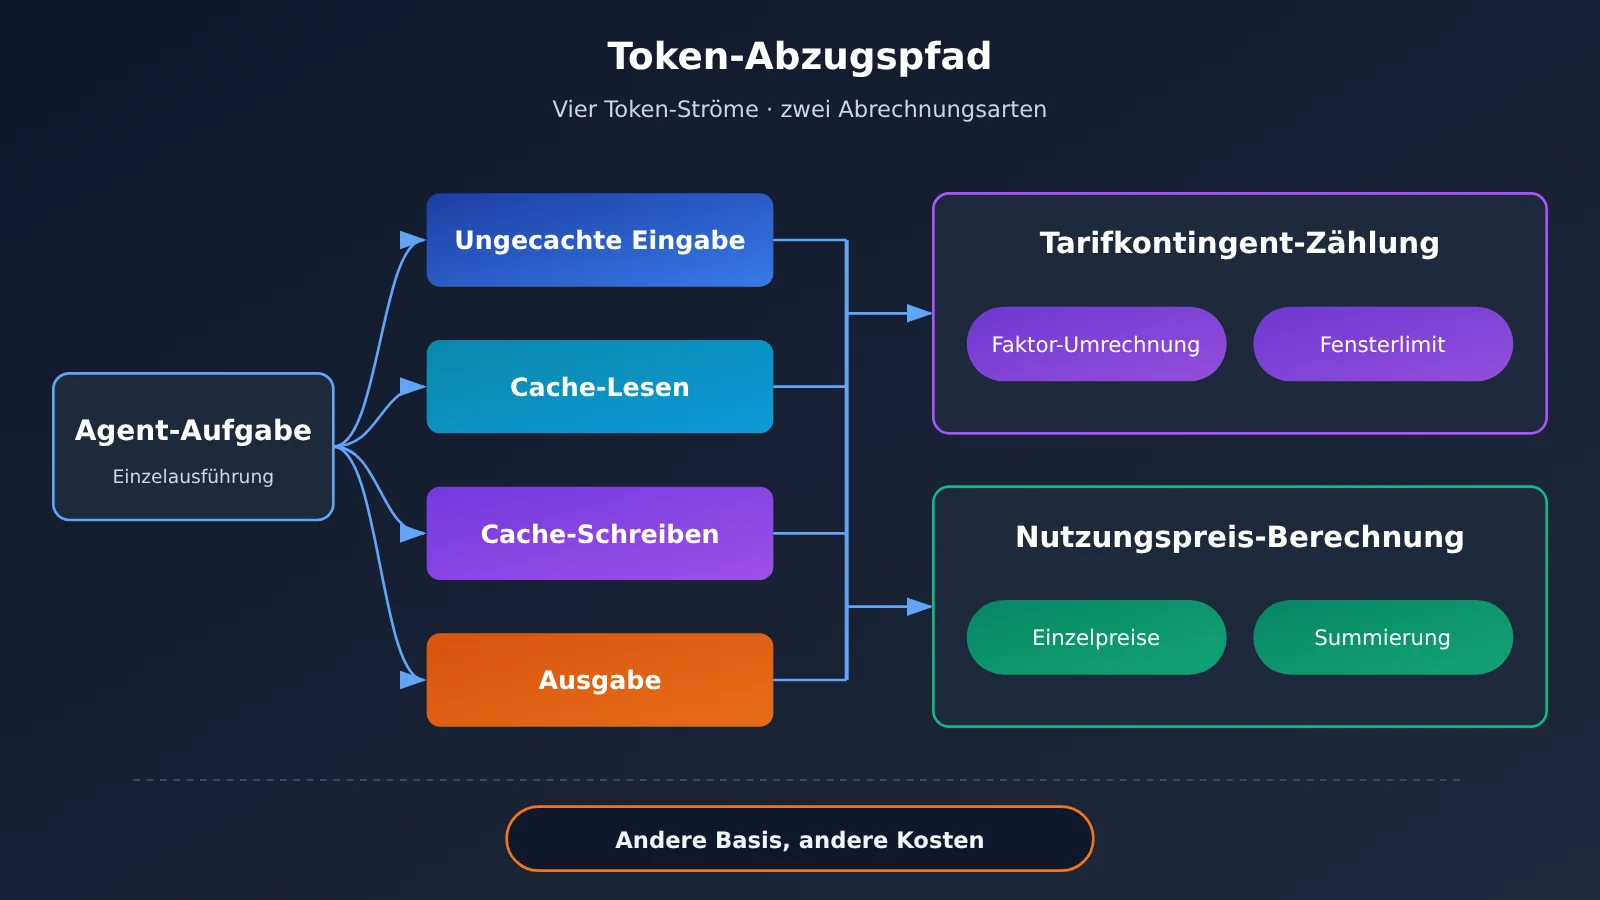
Dieselbe Aufgabe für einen Programmier-Agenten kann durch wiederholtes Senden des Kontexts eine große Menge an Token für Cache-Lesezugriffe erzeugen. Angenommen, eine Aufgabe erzeugt insgesamt 500.000 Token, davon 400.000 Token für Cache-Lesezugriffe, 60.000 Token nicht gecachte Eingabe und 40.000 Token Ausgabe. Die folgenden Zahlen sind nur Beispiele zur Veranschaulichung der Methode und stehen für kein reales Paket.
Wenn Paket A alle Token auf das Kontingent anrechnet, reicht ein Kontingent von 10 Millionen für etwa 20 solcher Aufgaben. Wenn Paket B Cache-Lesezugriffe nicht anrechnet, verbraucht dieselbe Aufgabe nur 100.000 Kontingenteinheiten, und ein Kontingent von 10 Millionen reicht für etwa 100. Beide haben nominal dasselbe Kontingent, die tatsächlich erledigbare Aufgabenmenge unterscheidet sich aber um den Faktor 5.
Übliche Abrechnungsgrundlagen bei Token-Paketkontingenten
Die folgende Tabelle zeigt die Abrechnungsgrundlagen, die beim Vergleich am leichtesten übersehen werden. Die Definitionen der Anbieter sind nicht vollständig identisch; prüfen Sie vor dem Kauf Punkt für Punkt die offiziellen Angaben und leiten Sie nichts aus dem Namen ab.
| Abrechnungsposten | Bedeutung | Häufige Fallstricke | So prüfen Sie |
|---|---|---|---|
| Nicht gecachte Eingabe | Prompt-Inhalte, die erstmals gesendet werden und den Cache nicht treffen | Lange Kontexte werden mehrfach gezählt | Nutzungsdetails prüfen |
| Cache-Lesevorgänge | Eingaben, die den Prompt-Cache treffen | Kann den Großteil der Gesamtmenge ausmachen; die Anrechnungsregeln unterscheiden sich stark | Paketregeln und Preisseite prüfen |
| Cache-Schreibvorgänge | Nutzung, die beim Schreiben von Inhalten in den Cache entsteht | Der Stückpreis kann von normaler Eingabe abweichen | Modellpreisangaben prüfen |
| Ausgabe | Vom Modell generierte Inhalte | Der Stückpreis ist meist höher als bei der Eingabe; lange Ausgaben wirken sich deutlich aus | Modellpreisangaben prüfen |
| Reasoning-Token | Nutzung, die durch den Denkprozess von Reasoning-Modellen entsteht | Nutzer sehen den eigentlichen Text nicht, er kann aber als Ausgabe abgerechnet werden | Nutzungsfelder in der Antwort prüfen |
Für die nutzungsbasierte Abrechnung von APIYI gelten einheitlich die tatsächlichen Angaben auf der Preisseite https://docs.apiyi.com/models. Stückpreise und Cache-Regeln können sich je nach Modell unterscheiden; prüfen Sie sie am besten einzeln für die Modelle, die Sie tatsächlich verwenden.
Token-Paketkontingent schnell erfassen: In 5 Schritten Abonnement und nutzungsbasierte Zahlung durchrechnen
Für die folgende Methode brauchen Sie keine komplexen Tools – eine Tabellenkalkulation reicht. Entscheidend ist, mit Daten aus echten Aufgaben zu arbeiten, statt den Monatsverbrauch nach Gefühl zu schätzen.
Schritt 1: Den Token-Verbrauch echter Aufgaben erfassen
Wählen Sie 3 bis 5 der häufigsten Aufgabentypen aus, zum Beispiel das Beheben eines Bugs, das Erstellen eines Wochenberichts oder die Bearbeitung einer Charge von Kundenservice-Tickets. Erfassen Sie pro Aufgabentyp mindestens 5 bis 10 Durchläufe, um den Einfluss zufälliger Schwankungen zu verringern. Der Verbrauch komplexer und einfacher Aufgaben kann stark abweichen; es ist nicht ratsam, nur ein einzelnes Ergebnis als repräsentativ für alle Fälle zu verwenden.
Wenn Sie das Modell bereits über die API aufrufen, können Sie den Verbrauch aus dem usage-Objekt der Antwort auslesen. Die Feldbedeutungen der beiden gängigen Schnittstellenformate unterscheiden sich; achten Sie bei der Aggregation besonders darauf:
| Nutzungsposten | Feld im OpenAI-Format | Feld im Anthropic-Format | Hinweis zur Aggregation |
|---|---|---|---|
| Eingabe | prompt_tokens |
input_tokens |
Der erstere Wert enthält üblicherweise bereits die Cache-Treffer, der letztere enthält üblicherweise nicht die Cache-Lese-/Schreibteile |
| Cache-Lesen | prompt_tokens_details.cached_tokens |
cache_read_input_tokens |
Beim OpenAI-Format sollte man ihn von der Eingabe abziehen, bevor man den nicht gecachten Teil berechnet |
| Cache-Schreiben | Hängt vom Modell und davon ab, was die Schnittstelle zurückgibt | cache_creation_input_tokens |
Separat erfassen und mit dem jeweiligen Stückpreis berechnen |
| Ausgabe | completion_tokens |
output_tokens |
Den Anteil der Aufgaben mit langen Ausgaben im Blick behalten |
| Reasoning | completion_tokens_details.reasoning_tokens |
Hängt vom Modell und davon ab, was die Schnittstelle zurückgibt | Nicht zusätzlich zur Ausgabe addieren |
Schritt 2: Die äquivalenten Kosten pro Aufgabe bei nutzungsbasierter Abrechnung ermitteln
Bilden Sie zunächst den Durchschnitt der erfassten Nutzung und schlagen Sie dann den Stückpreis des Zielmodells nach. Die Berechnungsformel lautet:
Nutzungskosten pro Aufgabe = ungecachte Eingabe × Eingabepreis + Cache-Lesevorgang × Cache-Lesepreis + Cache-Schreibvorgang × Cache-Schreibpreis + Ausgabe × Ausgabepreis
Alle Preise in der Formel sollten von der aktuellen Preisseite stammen – verlassen Sie sich nicht auf alte Screenshots oder Zahlen aus Drittanbieter-Quellen. Wenn die Preise pro Million Token angegeben sind, denken Sie daran, die Einheiten vor der Berechnung zu vereinheitlichen. Bei der Nutzung von APIYI orientieren Sie sich bitte an den Modellpreisen und Abrechnungsmodalitäten, die unter https://docs.apiyi.com/models angegeben sind.
Schritt 3: Das Abonnementkontingent in die Zahl der möglichen Aufgaben umrechnen
Die entscheidende Kennzahl eines Abonnementplans ist nicht die Gesamtzahl der Token, sondern „wie viele Aufgaben sich innerhalb des Limits erledigen lassen“. Prüfen Sie zuerst die Abzugsregeln des Pakets und schätzen Sie dann mit folgender Formel:
Monatlich erledigbare Aufgaben = monatlich verfügbares Kontingent ÷ (abgerechnete Token pro Aufgabe × Modellmultiplikator)
Wird das Paket nach Anfragen oder Guthabenpunkten abgerechnet, ersetzen Sie den Nenner durch die durchschnittliche Anzahl an Anfragen bzw. den durchschnittlichen Punkteverbrauch pro Aufgabe. Wenn die Regeln nicht öffentlich einsehbar sind, können Sie während der Testphase einige Standardaufgaben ausführen, die Veränderung des Kontingents beobachten und daraus rückrechnen. Das Ergebnis ist lediglich eine Schätzung und sollte in der Tabelle entsprechend gekennzeichnet werden.
Schritt 4: Token-Paketkontingent mithilfe von Zeitfenstern korrigieren
Ein ausreichendes Monatsvolumen bedeutet nicht, dass es auch in Spitzenzeiten reicht. Wenn das Paket stunden- oder wochenbasierte Fenster hat, muss zusätzlich mit der Spitzennutzung geprüft werden:
Tatsächlich nutzbare Aufgabenanzahl = min (monatlich erreichbare Aufgabenanzahl, kumulierte erreichbare Aufgabenanzahl in den einzelnen Zeitfenstern)
Ein Entwickler kann beispielsweise den Großteil seiner Nutzung in einer Sprint-Woche konzentrieren, sodass das Wochenlimit vorzeitig ausgeschöpft wird. Die zusätzliche Wartezeit ist dann ebenfalls ein Kostenfaktor – besonders wenn Aufgaben nicht unterbrochen werden dürfen. Deshalb sollte dieser Schritt nicht übersprungen werden.
Schritt 5: Break-even-Punkt zwischen Abonnement und Pay-as-you-go berechnen
Zum Schluss vergleicht man zwei Zahlen: die Break-even-Aufgabenmenge und die Aufgabenmenge, die du monatlich tatsächlich erledigen musst:
Break-even-Aufgabenmenge = monatliche Abonnementgebühr ÷ Pay-as-you-go-Kosten pro Aufgabe
Die Entscheidungsregel lässt sich auf drei Punkte vereinfachen:
- Die monatliche Aufgabenmenge liegt deutlich über dem Break-even-Punkt und die tatsächlich nutzbare Aufgabenanzahl deckt den Bedarf: Das Abonnement hat Vorrang.
- Die monatliche Aufgabenmenge liegt unter dem Break-even-Punkt oder die Nutzung schwankt stark: Pay-as-you-go hat Vorrang.
- Die monatliche Aufgabenmenge liegt nahe am Break-even-Punkt: Wähle die flexiblere Variante und rechne im nächsten Abrechnungszyklus erneut nach.
Tipp für den schnellen Einstieg: Um die reale Nutzung zu erfassen, kannst du über APIYI apiyi.com denselben Satz Eingabeaufforderungen mit verschiedenen Modellen testen und die
usage-Daten anschließend in die Tabelle eintragen. So musst du nicht jede Schnittstelle einzeln anpassen und kannst die Ergebnisse einheitlich vergleichen.
Token-Verbrauch über APIYI erfassen: So bindest du die API an
APIYI stellt die in diesem Artikel besprochenen Modell-APIs bereit – kompatibel mit den Schnittstellenformaten von OpenAI und Anthropic. Bestehende Projekte müssen in der Regel nur die Verbindungskonfiguration anpassen, um mit der Erfassung der Nutzungsdaten zu beginnen. Ob ein bestimmtes Modell verfügbar ist, entnimmst du der Preisseite.
- Registriere ein Konto bei APIYI auf apiyi.com und lege im Konsolen-Dashboard einen API-Schlüssel an.
- Für das OpenAI-kompatible Format setzt du
base_urlaufhttps://api.apiyi.com/v1; Adresse und Request-Header für das Anthropic-Format konfigurierst du wie in der Dokumentation beschrieben. - Setze
modelauf den Modellnamen, der auf der Preisseite aufgeführt ist, sende eine Standardaufgabe und protokolliere dasusage-Objekt aus der Antwort. - Prüfe den Stückpreis des Modells unter
https://docs.apiyi.com/modelsund setze ihn in die Formel aus Schritt 2 ein.
Die vollständige Integrationsanleitung findest du in der APIYI-Dokumentation: https://docs.apiyi.com.
Token-Pakete im Vergleich: Abo, Pay-as-you-go und Hybrid
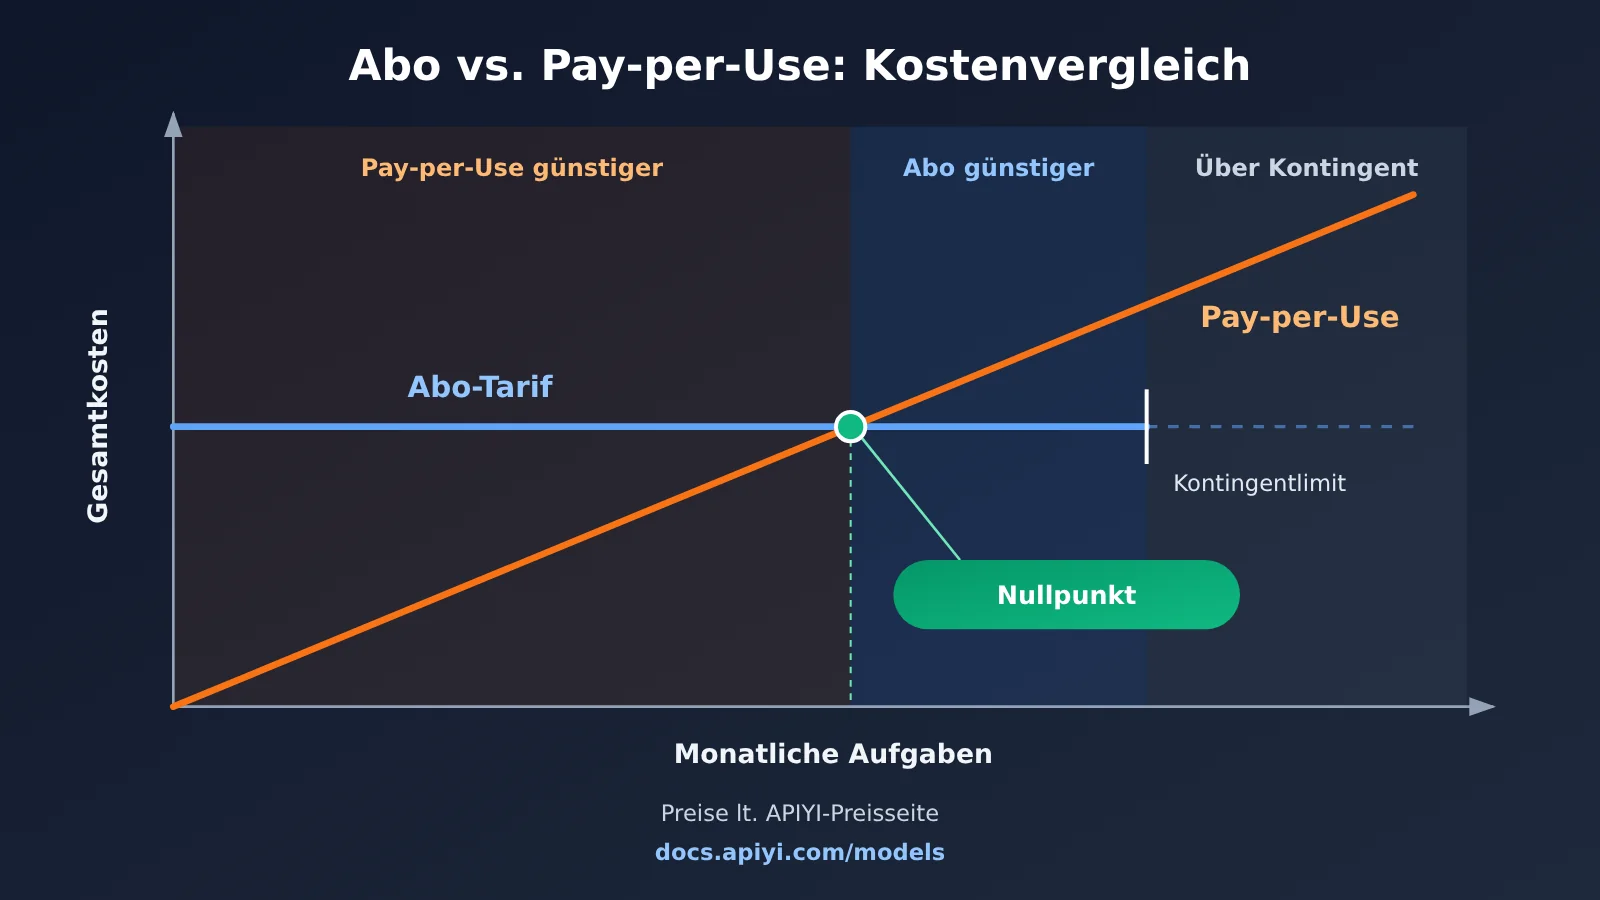
Wo der Schnittpunkt in der Grafik liegt, ist von Fall zu Fall verschieden – er hängt von deiner Aufgabenstruktur und den gewählten Modellen ab. Die folgende Tabelle vergleicht die drei Varianten anhand von Entscheidungskriterien, ohne konkrete Preise zu nennen.
| Vergleichsdimension | Abo-Modell | Pay-as-you-go | Hybrid-Modell |
|---|---|---|---|
| Kostenprofil | Monatsgebühr relativ fix | variiert mit der Nutzung | Fixkosten plus flexible Kosten |
| Hauptrisiko | Kontingent bleibt ungenutzt oder ist vorzeitig erschöpft | Nutzungsspitzen treiben die Rechnung nach oben | zwei Rechnungen, mehr Verwaltungsaufwand |
| Passt besser zu | häufige und stabile tägliche Entwicklung | seltene, schwankende oder programmatische Aufrufe | stabiler Grundbedarf mit Spitzen |
| Modellwechsel | eingeschränkt durch den Umfang des Pakets | meist flexibler | Hauptmodell fix, weitere nach Bedarf |
| Preisgrundlage | laut offizieller Paketseite | bei Nutzung von APIYI laut https://docs.apiyi.com/models |
jeweils nach der zugehörigen Seite kalkuliert |
Wann passt das Abo, wann Pay-as-you-go?
Einzelentwickler mit hoher Frequenz: Wenn du täglich vor allem in festen Tools arbeitest und deine Nutzung halbwegs stabil ist, solltest du zuerst das Abo durchrechnen. Prüfe dabei vor allem, ob das Kontingent in Spitzenzeiten reicht und ob Cache-Lesevorgänge ins Kontingent einfließen.
Produkte und Backend-Dienste: Für nutzerseitige Online-Funktionen ist Pay-as-you-go meist die bessere Wahl, weil sich das Aufrufvolumen kaum vorhersagen lässt und du eine klare Kostenzuordnung brauchst. Achte zugleich auf die Bedingungen von Abo-Diensten: Manche Abos erlauben keine Nutzung für Produktivdienste oder Weiterverkauf.
Kleine Teams: Erfasse zuerst den tatsächlichen Verbrauch jeder Person einzeln und gehe nicht davon aus, dass alle dieselbe Abo-Stufe brauchen. Wer viel nutzt, kann ein Abo nehmen; wer wenig nutzt, und alle Automatisierungsskripte laufen über Pay-as-you-go. So passt die Gesamtlösung meist besser zum echten Bedarf.
Modellbewertungsphase: In dieser Phase gibt es noch kein stabiles Nutzungsmuster, Pay-as-you-go erleichtert die kleine Validierung. Über APIYI kannst du mehrere Modelle mit einer einheitlichen Schnittstelle aufrufen und erst nach den Tests über die langfristige Lösung entscheiden.
Häufig gestellte Fragen (FAQ)
F1: Was ist ein Token-Paketkontingent?
Ein Token-Paketkontingent ist die Nutzungsobergrenze, die ein Anbieter innerhalb eines bestimmten Zeitraums bereitstellt. Sie kann direkt in Tokens berechnet werden oder sich in Gutschriften, Anfragezahlen oder Nachrichtenzahlen umrechnen lassen. Beim Vergleich muss man zuerst die Abzugsregeln klären und darf nicht nur auf die nominale Zahl schauen.
F2: Worin unterscheidet sich ein Token-Paketkontingent von der nutzungsbasierten Abrechnung?
Bei einem Paket zahlt man in der Regel im Voraus eine feste Gebühr und nutzt innerhalb des Limits; bei der nutzungsbasierten Abrechnung wird nach tatsächlichem Verbrauch und Stückpreis des Modells abgerechnet. Ersteres erleichtert die Budgetkontrolle, kann aber ungenutzt bleiben oder an die Obergrenze stoßen; Letzteres ist flexibler, erfordert aber eine gute Überwachung des Verbrauchs.
F3: Wie oft sollten die Regeln zum Token-Paketkontingent überprüft werden?
Empfohlen ist eine Überprüfung pro Verlängerungszyklus, und bei Modell-Upgrades, Änderungen der Aufgabenstruktur oder Anpassungen des Pakets sollte sofort neu gerechnet werden. Modellpreise, Multiplikatoren und Limits können sich ändern, sodass frühere Schlussfolgerungen nicht unbedingt weiterhin gelten. Preisinformationen sollten sich nach dem aktuellen Inhalt der offiziellen Seite richten.
F4: Ist ein Abonnement bei hoher Cache-Trefferquote immer besser geeignet?
Nicht unbedingt. Der Stückpreis für Cache-Lesevorgänge unterscheidet sich meist vom normalen Input, sodass die nutzungsbasierten Kosten deutlich sinken können; wenn das Paket jedoch auch Cache-Lesevorgänge auf das Kontingent anrechnet, wird das Kontingent umso schneller verbraucht. Man sollte beide Varianten getrennt in die Formel einsetzen und durchrechnen.
F5: Wie lässt sich der Token-Aufwand schnell über die API verifizieren?
Man kann 3 bis 5 Arten von Standardaufgaben vorbereiten, über APIYI apiyi.com die Kandidatenmodelle aufrufen und das Feld `usage` protokollieren. Die Plattform ist mit den Schnittstellenformaten von OpenAI und Anthropic kompatibel, sodass vorhandener Code einfach wiederverwendet werden kann. Die Anbindung ist unter `https://docs.apiyi.com` beschrieben.
F6: Wo lassen sich die Modellpreise von APIYI abfragen?
Bitte besuchen Sie `https://docs.apiyi.com/models`. Die Input-, Output- und Cache-Preise sowie die Abrechnungsgrundlage der Modelle richten sich nach den tatsächlichen Daten auf dieser Seite. Es empfiehlt sich, vor der Berechnung den Modellnamen und die Preiseinheit zu prüfen und keine Zahlen aus weiterverbreiteten Inhalten zu verwenden.
F7: Welche Grenzen hat diese Umrechnungsmethode für Token-Paketkontingente?
Sie hängt von der Repräsentativität der Stichprobe ab; bei zu wenigen Stichproben wird die Abweichung größer. Bei manchen Paketen sind Multiplikatoren und Limits nicht vollständig offengelegt und lassen sich nur durch Tests zurückrechnen. Zudem quantifiziert die Formel weder Modellqualität noch Nacharbeitskosten direkt; wenn ein Modell wiederholte Versuche erfordert, sollten die Kosten für diese Wiederholungen mit eingerechnet werden.
F8: Können Abonnement und nutzungsbasierte Zahlung gleichzeitig verwendet werden?
Ja, das ist auch eine gängige Vorgehensweise, wenn der Verbrauch deutliche Spitzen aufweist. Stabile Alltagsaufgaben werden vom Abonnement getragen, Automatisierungsskripte und Aufgaben oberhalb des Limits laufen über die nutzungsbasierte API-Abrechnung. Bei der Umsetzung sollten beide Ausgabenposten getrennt erfasst und geprüft werden, ob die Nutzungsweise den jeweiligen Nutzungsbedingungen entspricht.
Token-Paket-Kontingente: Die wichtigsten Punkte
- Nominales Kontingent ist nicht gleich tatsächlicher Wert: Dieselbe Token-Anzahl kann sehr unterschiedliche Arbeitsmengen abdecken.
- Zuerst die Abrechnungsgrundlage vereinheitlichen: Cache-Lese- und -Schreibvorgänge, Ausgabe-, Reasoning-Token und Modellmultiplikatoren Punkt für Punkt prüfen.
- Aufgaben als Vergleichseinheit verwenden: Die Zahl der erledigbaren Aufgaben zu vergleichen ist verlässlicher als der Preis pro Million Token.
- Das Zeitfenster gehört in die Rechnung: Selbst wenn die Monatsmenge reicht, kann das Limit in Spitzenzeiten vorzeitig erreicht werden.
- Den Break-even-Punkt als Entscheidungshilfe nutzen: Die Monatsgebühr des Abos durch die nutzungsbasierten Kosten pro Aufgabe teilen und mit dem echten Bedarf vergleichen.
- Mit echten Daten verifizieren: Über APIYI lassen sich Modelle einheitlich aufrufen; die Kosten rechnest du anhand der Preisseite nach.
Fazit
Token-Paket-Kontingente lassen sich nicht direkt vergleichen, weil hinter derselben Zahl unterschiedliche Abrechnungsgrundlagen, Modellgewichtungen und Nutzungslimits stecken können. Wer zwischen Abo und nutzungsbasierter Zahlung wählen will, geht am besten in dieser Reihenfolge vor:
- Nutzung erfassen: Eingabe-, Cache-, Ausgabe- und Reasoning-Token echter Aufgaben protokollieren.
- Kosten berechnen: Anhand der aktuellen Preisseite die nutzungsbasierten Kosten pro Aufgabe ermitteln.
- Kontingent umrechnen: Das Abo-Kontingent in die Zahl erledigbarer Aufgaben umrechnen – inklusive Multiplikatoren und Zeitfenstern.
- Bedarf vergleichen: Die Break-even-Aufgabenmenge dem tatsächlichen Monatsbedarf gegenüberstellen und dann Abo, nutzungsbasierte Zahlung oder eine Mischlösung wählen.
Am besten machst du die erste Kalkulation mit einer Woche echter Aufgaben und aktualisierst die Daten in jedem Verlängerungszyklus. Wenn du modellübergreifend testen möchtest, kannst du über APIYI apiyi.com eine einheitliche Schnittstelle nutzen; maßgeblich sind die Preise unter https://docs.apiyi.com/models.
📚 Referenzen
- APIYI Modell- und Preisseite: Modellpreise und Abrechnungsmodalitäten nachschlagen
- Link:
docs.apiyi.com/models -
Beschreibung: Alle Angaben zu APIYI-Preisen und Abrechnungsmodalitäten in diesem Artikel richten sich nach den tatsächlichen Daten auf dieser Seite.
-
APIYI Dokumentationszentrum: Hinweise zur API-Anbindung
- Link:
docs.apiyi.com -
Beschreibung: Enthält Konfigurations- und Nutzungshinweise – ideal zur Einsicht vor dem Testen.
-
Offizielle OpenAI-Dokumentation: Erläuterung der API- und Nutzungsfelder
- Link:
platform.openai.com/docs -
Beschreibung: Kann zur Überprüfung der Bedeutung des
usage-Felds in Antworten im OpenAI-Format herangezogen werden. -
Offizielle Anthropic-Dokumentation: Messages API und Prompt-Caching
- Link:
docs.anthropic.com - Beschreibung: Kann zur Überprüfung der Felder für Cache-Lese- und -Schreibnutzung im Anthropic-Format herangezogen werden.
Autor: APIYI Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI unter apiyi.com – weitere Materialien finden Sie im Dokumentationszentrum unter docs.apiyi.com