Anmerkung des Autors: Nach einem Modell-Upgrade lassen sich Eingabeaufforderungen und Patch-Code nicht nach Bauchgefühl löschen. Dieser Artikel hilft dir mit einer Einteilung in 4 Kategorien und einem 5-stufigen Regressionsablauf zu entscheiden, was gelöscht, geändert oder behalten werden sollte.
Im November 2026 hat ein Bericht von 36Kr über den Weggang einer Schlüsselfigur von Claude Code bei Anthropic wieder viele Entwickler über KI-Programmierwerkzeuge sprechen lassen. Jenseits der Personalgeschichten stellt sich für viele Teams eine viel praktischere Frage: Nach jedem Modell-Upgrade werden Eingabeaufforderungen und Patch-Code mehr – sind sie überhaupt noch nötig? Dieser Artikel stellt eine Aufräum-Methode vor – erst klassifizieren, dann abgleichen, dann schrittweise ausrollen –, mit der du Ballast abbaust, ohne Stabilität zu opfern.
Das ist kein Artikel, der dir rät, einfach mutig alles zu löschen. In Eingabeaufforderungen können Geschäftsregeln stecken, in Patch-Code können Sicherheitsleitplanken stecken – ein versehentliches Löschen kostet oft mehr als ein paar zusätzliche Token. Dieser Artikel liefert auch keine allgemeinen Benchmarks, denn der Aufräumeffekt hängt von deinen eigenen Geschäftssamples ab. Du musst deine Schlüsse aus deinen eigenen Daten ziehen.
Kernnutzen: Nach dem Lesen dieses Artikels kannst du beurteilen, welche Eingabeauforderungen und welcher Patch-Code nach einem Modell-Upgrade gelöscht werden können, und du kannst das Aufräumen mit einem rückrollbaren Ablauf durchführen.
Zentrale Punkte für die Bereinigung von Eingabeaufforderungen und Patch-Code nach einem Modell-Upgrade
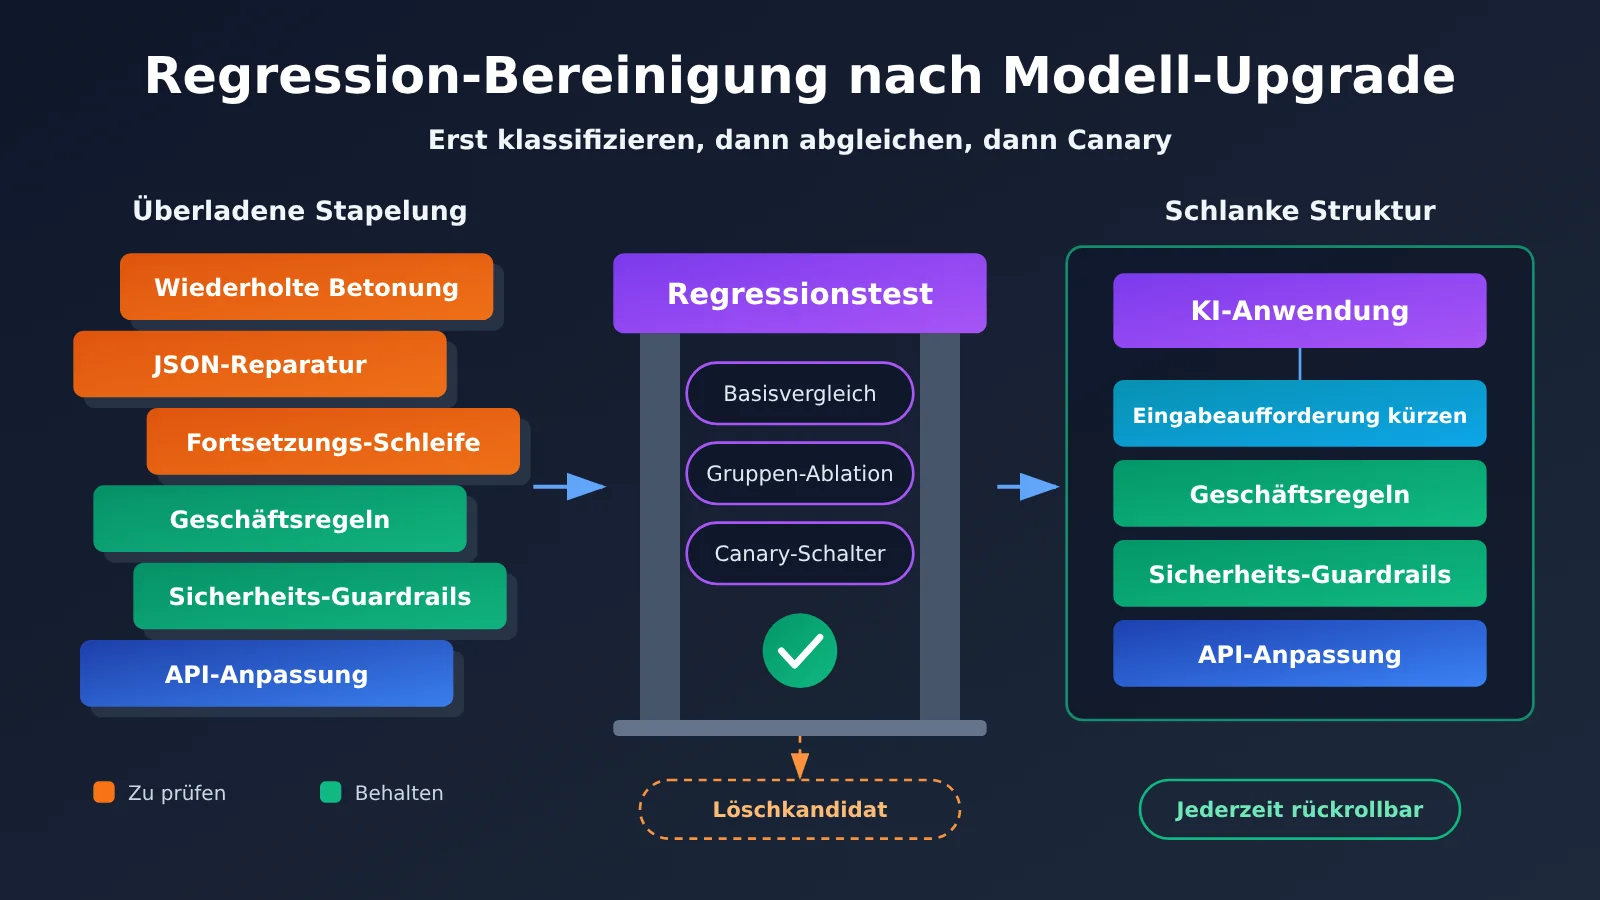
Merken Sie sich zuerst eine Grundregel: Ein Abschnitt einer Eingabeaufforderung oder ein Patch, der dazu dient, Schwächen des alten Modells auszugleichen, sollte überprüft werden. Dient er dazu, Geschäftsregeln auszudrücken oder Risiken zu kontrollieren, darf er wegen eines Modell-Upgrades nicht einfach entfernt werden. Die folgende Tabelle fasst den später beschriebenen Ablauf zusammen.
| Punkt | Erläuterung | Nutzen |
|---|---|---|
| Erst klassifizieren, dann anfassen | In 4 Kategorien einteilen: Modellkompensation, Geschäftsregeln, Sicherheitsleitplanken, Schnittstellenanpassung | Verhindert, dass wichtige Logik versehentlich gelöscht wird |
| Nur das Modell wechseln, um eine Baseline zu erhalten | In der ersten Runde Eingabeaufforderungen und Code unverändert lassen | Trennt Modelländerungen von Bereinigungsänderungen |
| Gruppenweise Ablationstests | Jeweils nur eine Gruppe entfernen und die Ergebnisse vergleichen | Zeigt genau, welche Wirkung jeder Bestandteil hat |
| Canary-Rollout mit Feature-Schaltern | Bereinigungsergebnisse über die Konfiguration steuern und jederzeit zurückrollen können | Senkt das Risiko von Produktionsstörungen |
| Abrechnung separat prüfen | Kürzere Eingabeaufforderungen bedeuten nicht automatisch niedrigere Gesamtkosten | Verhindert Fehlurteile, wenn man nur die Token-Anzahl betrachtet |
Warum Eingabeaufforderungen und Patch-Code nach einem Modell-Upgrade veralten
In den meisten KI-Anwendungen sind Eingabeaufforderungen durch Produktionsprobleme „großgefüttert“ worden. Wenn das Modell ein Format verfehlte, wurde eine betonte Anweisung ergänzt. Wenn die Ausgabe abgeschnitten wurde, kam eine Fortsetzungsschleife hinzu. Wenn das Modell gelegentlich ungültiges JSON schrieb, wurde zusätzlich eine Reparaturfunktion eingebaut. Diese Vorgehensweisen waren damals alle sinnvoll, aber sie sind an das Verhalten des alten Modells gebunden – und diese Bindung wird selten dokumentiert.
Nach einem Modell-Upgrade kann es für diese Inhalte drei Fälle geben: Das Problem ist verschwunden, und der Patch wird zu totem Code; das Problem besteht weiter, und der Patch bleibt nützlich; das Modellverhalten hat sich geändert, und die alte Schreibweise erzeugt nun Nebenwirkungen. Wenn zum Beispiel früher wiederholte Betonungen eingesetzt wurden, um die Aufmerksamkeit des Modells zu erregen, kann ein neues Modell, das auf Anweisungen anders reagiert, dadurch eine Regel übermäßig befolgen. Deshalb lautet das Ziel der Überprüfung nach dem Upgrade nicht „so kurz wie möglich“, sondern: Jeder Abschnitt soll einen klaren Grund für seine Existenz haben.
Wie man Eingabeaufforderungen und Patch-Code in 4 Kategorien einteilt
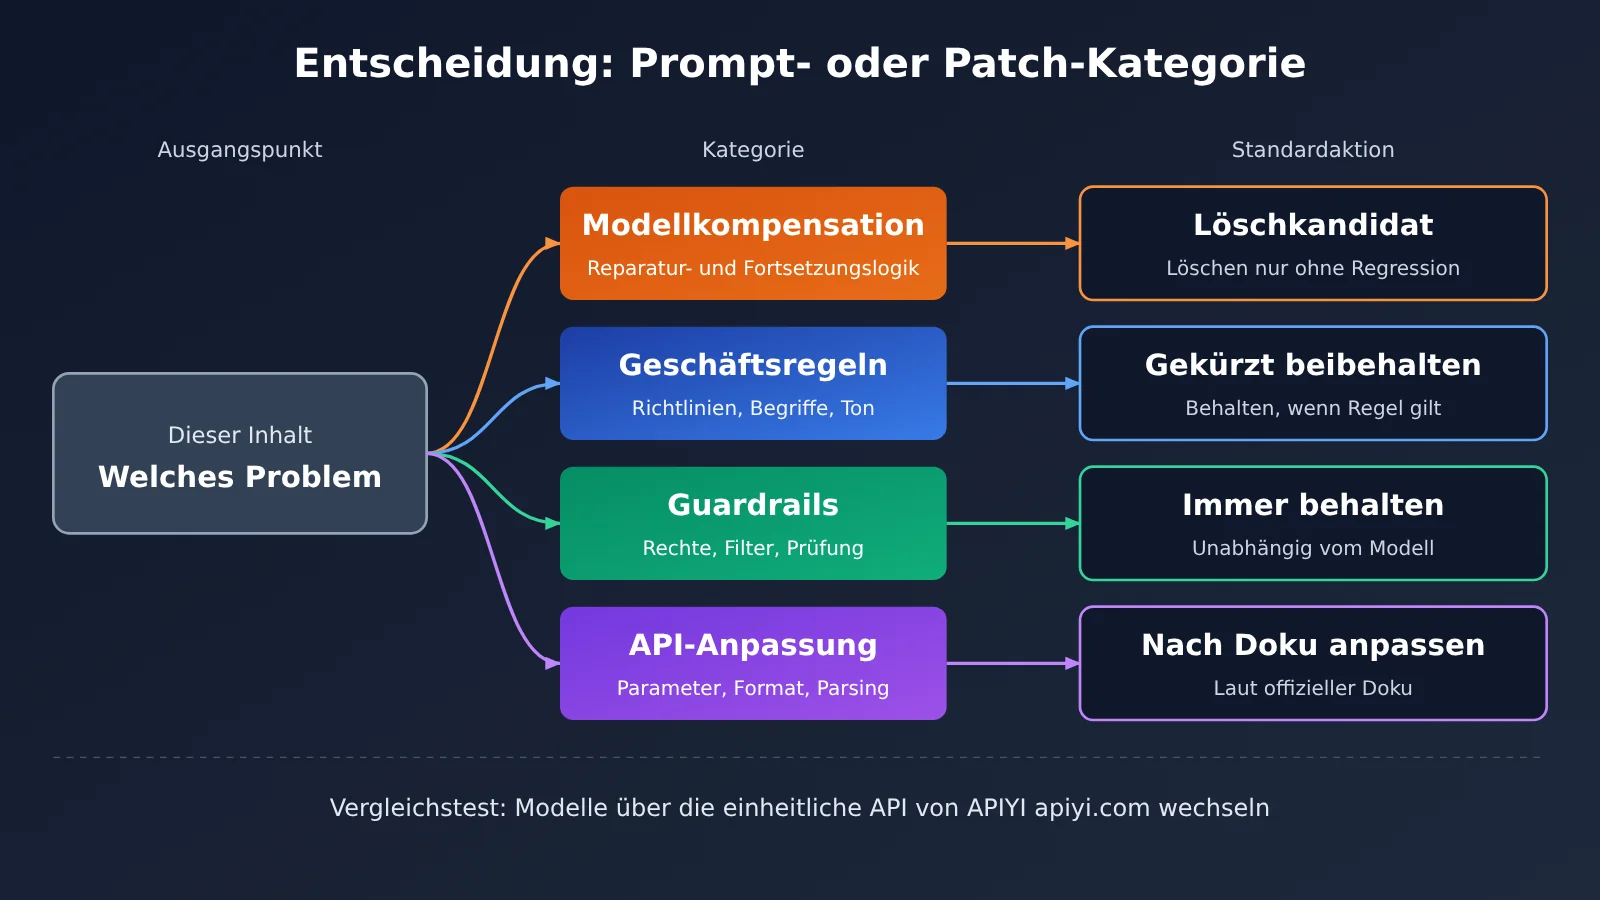
Vor dem Aufräumen zerlegt man die System-Eingabeaufforderung zunächst abschnittsweise und listet auch die Verarbeitungslogik vor und nach dem Modellaufruf Punkt für Punkt auf. Anschließend ordnet man alles gemäß der folgenden Tabelle ein – so hat man für jede spätere Löschentscheidung eine nachvollziehbare Grundlage.
| Kategorie | Typische Beispiele | Standardaktion | Entscheidungskriterium |
|---|---|---|---|
| Modellkompensation | wiederholte Betonung von „nicht weglassen“, JSON-Reparaturfunktionen, Fortsetzungsschleifen bei Abbruch | als Löschkandidat markieren | erst löschen, wenn Regressionstests keine Verschlechterung zeigen |
| Geschäftsregeln | Rückerstattungsrichtlinien, Glossar, Markenton, Domänenbeschränkungen | behalten und präziser formulieren | behalten, solange die Regel gilt |
| Sicherheitsleitplanken | Berechtigungsprüfung, Filterung sensibler Informationen, Ausgabeprüfung, Schutz vor Injection | immer behalten | nicht von den Fähigkeiten des Modells abhängig |
| Schnittstellenanpassung | Parameter-Mapping, Formatkonvertierung bei Tool-Aufrufen, Antwort-Parsing | an das neue Modell anpassen | offizielle API-Dokumentation ist maßgeblich |
Ein Detail verdient eine eigene Erwähnung: Reparaturlogik kann man durchaus entfernen, Validierungslogik darf man nicht entfernen. Wenn die strukturierten Ausgaben des neuen Modells stabiler sind, lässt sich der Code, der JSON per Regex repariert, unter Umständen abschalten – die Schema-Validierung sollte aber bestehen bleiben. Ebenso kann man die Fortsetzungsschleife für abgeschnittene Ausgaben noch einmal prüfen, während Wiederholungsversuche bei Netzwerkfehlern und Rate-Limits nichts mit den Modellfähigkeiten zu tun haben und deshalb gar nicht erst in den Aufräumumfang gehören.
Schnellstart: Eingabeaufforderungen und Patch-Code nach einem Modell-Upgrade aufräumen
Der folgende 5-Schritte-Ablauf braucht keine komplexe Plattform – er lässt sich mit dem vorhandenen Test-Framework und einer Tabelle erledigen. Entscheidend ist, immer nur eine Variable gleichzeitig zu ändern und jede Entscheidung festzuhalten.
Schritt 1: Herkunft der Eingabeaufforderungen und des Patch-Codes erfassen
Mit git log und git blame verfolgen Sie zurück, wann welcher Abschnitt eingeführt wurde und mit welchem Problem er zusammenhängt. In der Liste halten Sie vier Angaben fest: Position des Inhalts, Kategorie, adressiertes Problem, Art der Verifikation. Wenn niemand mehr sagen kann, woher eine Eingabeaufforderung stammt, markieren Sie sie als „zu prüfen“ und erklären Sie sie nicht vorschnell für nutzlos.
Schritt 2: Eine Regressions-Stichprobe für das Modell-Upgrade aufbauen
Das Regressionsset sollte aus drei Teilen bestehen: echten, gewöhnlichen Anfragen aus dem Produktivbetrieb, Fehlerbeispielen, die früher bereits Vorfälle ausgelöst haben, sowie geschäftlichen Grenzszenarien. Der Umfang lässt sich je nach Risiko festlegen – für kleine Teams ist es durchaus sinnvoll, mit einigen Dutzend besonders wertvoller Beispiele zu starten. Da Modellausgaben mit Unsicherheit behaftet sind, sollten Schlüsselproben mehrfach ausgeführt werden, damit ein zufälliges Bestehen nicht als stabiles Bestehen gewertet wird.
Schritt 3: Nur das Modell tauschen und eine Vergleichsbasis schaffen
Im ersten Durchlauf wird ausschließlich der Modellname geändert; Eingabeaufforderung und Code bleiben unverändert, und steuerbare Parameter wie die Temperatur werden fest eingestellt. So erhält man die Unterschiede zwischen „altes Modell + alte Konfiguration“ und „neues Modell + alte Konfiguration“ und kann zudem frühzeitig Veränderungen an Schnittstellenparametern oder der Antwortstruktur erkennen. Wenn die Plattform feste Modellversionen unterstützt, ist diesen der Vorzug zu geben, damit sich das Modell während des Tests nicht ändert und die Ergebnisse verfälscht.
Die folgende Tabelle listet die Konfigurationspunkte auf, die beim Anschluss eines Vergleichsexperiments bestätigt werden müssen.
| Konfigurationspunkt | Wie ausfüllen | Hinweis |
|---|---|---|
base_url |
Die in der APIYI-Dokumentation angegebene passende Schnittstellenadresse verwenden | Adressen und Pfade im OpenAI- und Anthropic-Format richten sich nach der Dokumentation |
api_key |
Einen in der Konsole erstellten Schlüssel verwenden | Über Umgebungsvariablen verwalten, nicht ins Repository schreiben |
model |
Den Modellnamen aus der Preisseite oder der Dokumentation eintragen | Alte und neue Versuchsgruppe abgesehen vom Modellnamen identisch halten |
temperature |
In allen Versuchsgruppen denselben Wert verwenden | Bei manchen Modellen kann der Parameterbereich abweichen; Dokumentation prüfen |
max_tokens |
Für altes und neues Modell ausreichend Platz einstellen | Damit eine Kürzung nicht fälschlich als Qualitätsproblem des Modells gewertet wird |
🚀 Tipp zum schnellen Einstieg: Bei Vergleichsexperimenten kostet die Anpassung an mehrere Schnittstellen meist die meiste Zeit. APIYI bietet API-Aufrufe für die in diesem Artikel behandelten Modelle wie Claude und GPT und ist mit den Schnittstellenformaten von OpenAI und Anthropic kompatibel. In der Regel müssen nur
base_url,api_keyundmodelangepasst werden, um mit dem Test zu beginnen. Hinweise zur Anbindung finden Sie in der APIYI-Dokumentation: https://docs.apiyi.com
Schritt 4: Gruppenweise Ablation von Eingabeaufforderungen und Patch-Code
Sobald die Baseline stabil ist, beginnen Sie mit der Kategorie der Modellkompensation und entfernen Sie die Gruppen nacheinander. Jede Gruppe enthält nur Inhalte, die dasselbe Problem lösen. Entfernen Sie beispielsweise zuerst die Eingabeaufforderungen zur Formatbetonung und die zugehörige Reparaturfunktion und führen Sie danach den Regressionstest aus, bevor Sie mit der nächsten Gruppe weitermachen. Wenn Sie zu viel auf einmal löschen, lässt sich bei einer Verschlechterung der Ergebnisse die Ursache nur schwer eingrenzen – am Ende bleibt oft nur ein vollständiges Zurückrollen.
| Metrik | Beobachtung | Entscheidungsgrundlage |
|---|---|---|
| Passrate kritischer Stichproben | Ob historische Vorfälle und Hochrisikoszenarien bestanden werden | Bei Verschlechterung diese Gruppe wiederherstellen |
| Passrate über alle Aufgaben | Qualitätsveränderung bei normalen Anfragen | Anhand vorab vom Team festgelegter Schwellenwerte entscheiden |
| Patch-Auslöserate | Tatsächliche Auslösehäufigkeit der Reparatur- oder Fortschreibungslogik | Wenn sie langfristig nahe null liegt, kann das als Grundlage für eine Löschung dienen |
| Token und Latenz | Eingabe- und Ausgabemenge sowie Antwortzeit | Zur Bewertung des tatsächlichen Nutzens der Bereinigung |
| Rate manueller Eingriffe | Anteil der Übergaben an Menschen oder der Nacharbeit durch Nutzer | Nach dem Go-live kontinuierlich beobachten, um blinde Flecken der Offline-Stichproben auszugleichen |
Die Bewertungskriterien sollten vor dem Testlauf festgeschrieben werden, sonst passt das Team die Maßstäbe leicht nachträglich an die Ergebnisse an. Beim Patch-Code können Sie zunächst auch nur protokollieren, ohne einzugreifen: Lassen Sie ihn weiterlaufen und melden Sie gleichzeitig, „was passieren würde, wenn er nicht vorhanden wäre“. Entscheiden Sie erst einige Tage später anhand der Auslösedaten, ob er entfernt wird. Das ist besonders für Hochrisikobereiche nützlich.
Schritt 5: Canary-Rollout und Rollback-Fähigkeit beibehalten
Die bereinigte Version sollte über einen Konfigurationsschalter ausgerollt werden: Zuerst nur einen kleinen Teil des Traffics abdecken und erst, wenn die Kennzahlen stabil sind, den Umfang erweitern. Bei Löschungen muss die Begründung klar dokumentiert werden, zum Beispiel „Die Modell-Regression für eine Version wurde bestanden, die Patch-Auslöserate bleibt dauerhaft nahe null“. So lässt sich die Einschätzung beim nächsten Upgrade direkt wiederverwenden.
Zusätzlich sollte besonders die Fallback-Kette des Modells geprüft werden. Wenn bei Nichtverfügbarkeit des Hauptmodells auf ein älteres Modell zurückgefallen wird, können Patches, die für das alte Modell geschrieben wurden, weiterhin erforderlich sein. Robuster ist es, die Eingabeaufforderungen in zwei Ebenen aufzuteilen: Geschäftsregeln und Sicherheitsanforderungen liegen in der Basisebene, modellbezogene Inhalte in der Adapterschicht, die über die Routing-Konfiguration je nach Modell geladen wird.
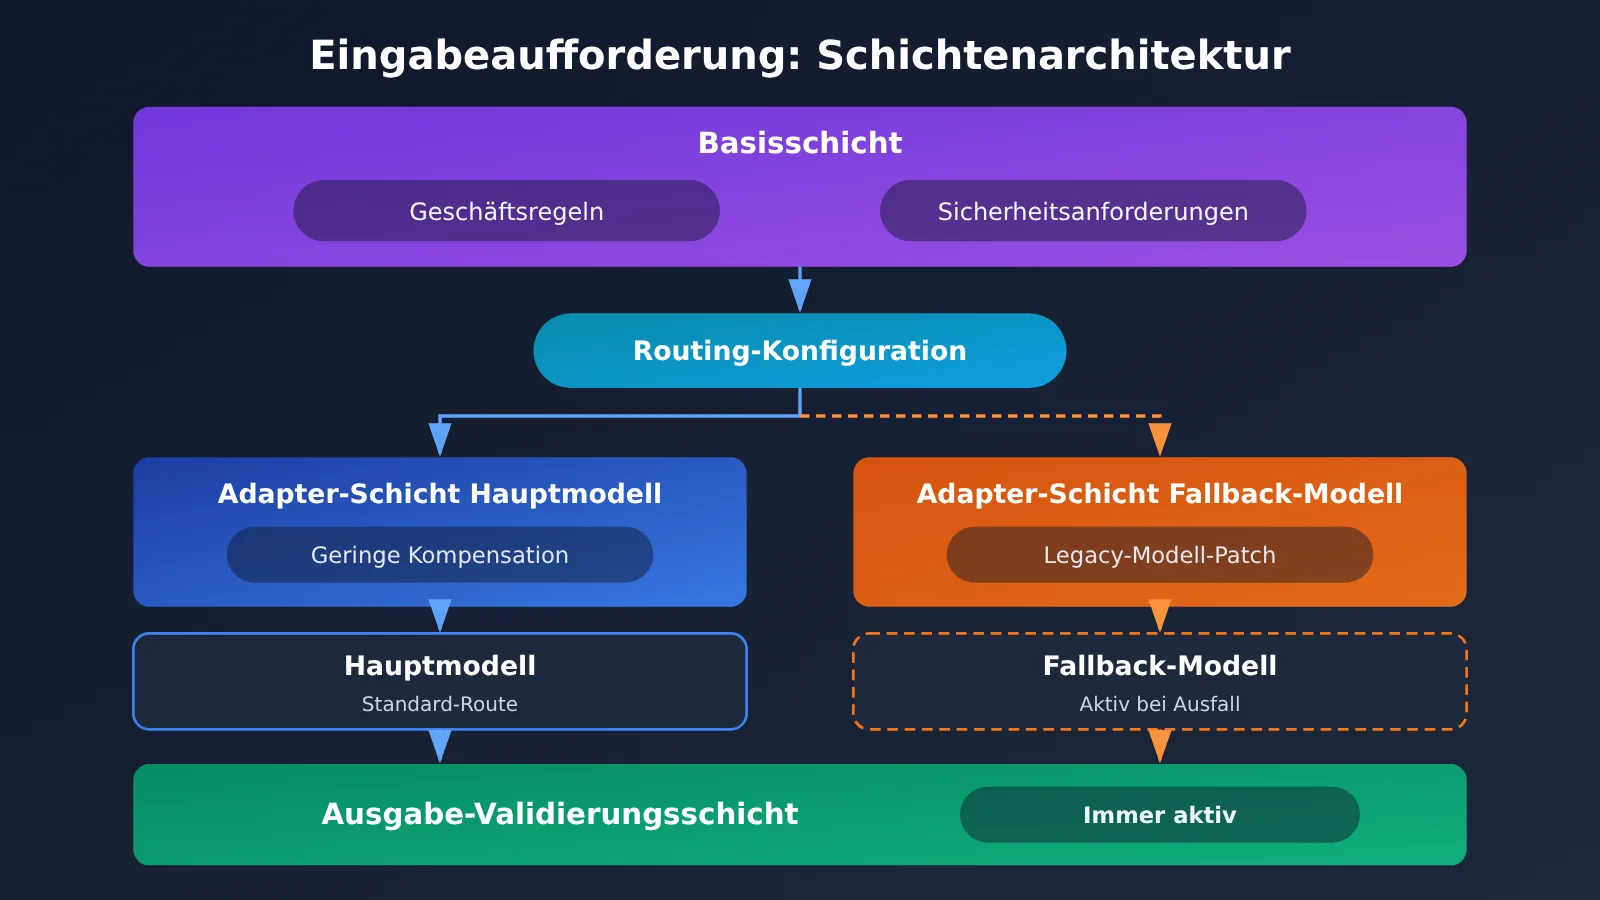
Vergleich von drei Strategien für den Umgang mit Eingabeaufforderungen und Patch-Code nach einem Modell-Upgrade
Aufräumen kennt nicht nur zwei Extreme: „alles löschen“ und „nichts anfassen“. Die folgende Tabelle vergleicht drei gängige Vorgehensweisen – je nach Geschäftsrisiko und Teamaufwand können Sie die passende auswählen.
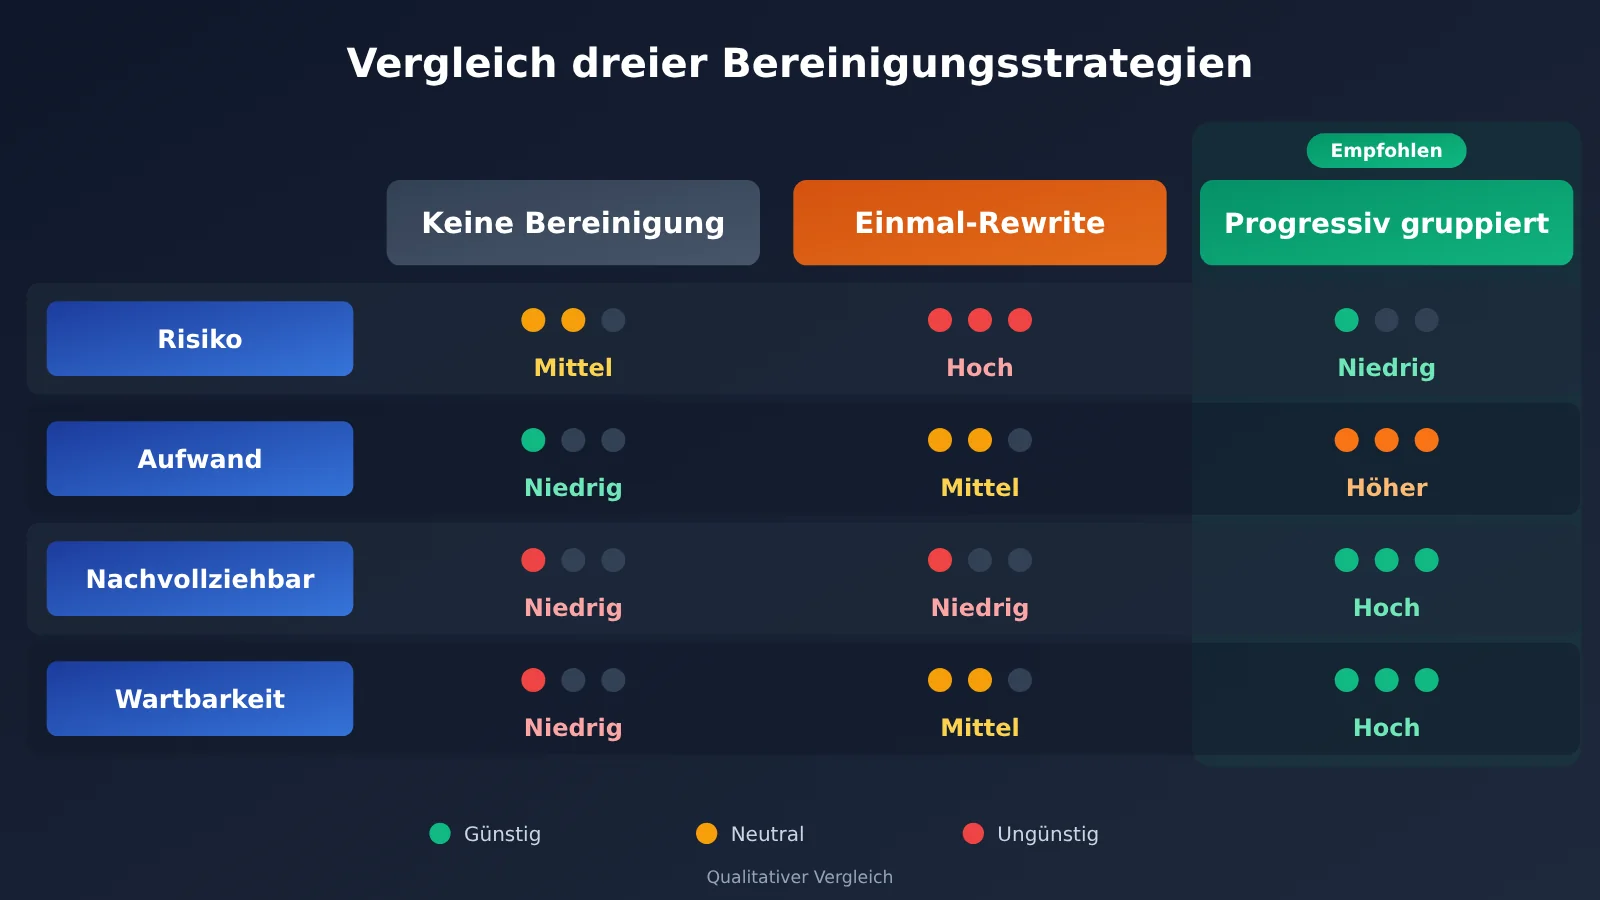
| Strategie | Vorgehen | Hauptrisiko | Geeignete Szenarien |
|---|---|---|---|
| Unverändert beibehalten | Nur den Modellnamen wechseln, alles andere bleibt unangetastet | Ungültige Inhalte sammeln sich weiter an, die Fähigkeiten des neuen Modells lassen sich kaum ausschöpfen | Temporäres Upgrade oder kurzfristig fehlende Testressourcen |
| Einmaliges Umschreiben | Von Grund auf neu nach dem Prompt-Leitfaden des neuen Modells verfassen | Implizite Geschäftsregeln können verloren gehen | Kleiner Prompt-Umfang oder laufende Restrukturierung |
| Gruppenweise schrittweise Bereinigung | Nach Kategorien gruppieren, Gruppe für Gruppe per Ablation reduzieren und als Canary-Release ausrollen | Zeitaufwand für den Aufbau eines Regression-Sets | Produktionsumgebungen und die meisten langfristig gepflegten Anwendungen |
Vergleichsanalyse zu „Unverändert beibehalten“: Diese Strategie bleibt bei der Markteinführungsgeschwindigkeit führend, doch die Nebenwirkungen alter Prompts und der Wartungsaufwand verschwinden nicht von selbst. Die gruppenweise schrittweise Bereinigung eignet sich dagegen besser für Produktionssysteme, die langfristig iteriert werden.
Vergleichsanalyse zu „Einmaliges Umschreiben“: Diese Strategie glänzt bei der Sauberkeit der Prompt-Struktur, aber Geschäftswissen, das in historischen Patches steckt, geht leicht verloren. Wenn Sie sich tatsächlich für ein Umschreiben entscheiden, sollten Sie es dennoch mit demselben Regression-Set verifizieren und die Geschäftsregeln der alten Version Punkt für Punkt abgleichen.
Kostenkalkulation für die Bereinigung von Eingabeaufforderungen und Patch-Code nach einem Modell-Upgrade
Kürzere Prompts bedeuten nicht automatisch niedrigere Gesamtkosten. Die Kosten eines Aufrufs lassen sich mit „Eingabe-Tokens × Eingabepreis + Ausgabe-Tokens × Ausgabepreis“ schätzen. Bei Nutzung von Caching müssen zusätzlich Lese- und Schreibzugriffe getrennt abgerechnet und die durch Wiederholungen und Degradation entstehenden Zusatzaufrufe eingerechnet werden. Die Ausgabe des neuen Modells kann länger ausfallen, außerdem können Änderungen am Prompt-Präfix die Cache-Trefferquote beeinflussen – prüfen Sie die Kalkulation daher stets anhand des tatsächlichen Verbrauchs aus Ihren Experimenten nach.
💰 Hinweis zur Preisangabe: Dieser Artikel nennt keine konkreten Einzelpreise. Für Modellpreise, Abrechnungsmodalitäten, Ein- und Ausgabepreise sowie Cache-Preise gelten die aktuellen Daten auf der Preisseite von APIYI https://docs.apiyi.com/models; notieren Sie bei der Kalkulation das Datum der Abfrage.
Häufige Fragen (FAQ)
F1: Was bedeutet „Modellkompensation“ in Eingabeaufforderungen und Patch-Code?
Modellkompensation bezeichnet Inhalte, die hinzugefügt werden, um Schwächen eines bestimmten Modells zu umgehen – zum Beispiel das wiederholte Betonen eines Ausgabeformats, das Reparieren von beschädigtem JSON oder das Zusammensetzen abgeschnittener Ergebnisse. Der Unterschied zu Geschäftsregeln besteht darin, dass sie nach dem Wechsel zu einem leistungsfähigeren Modell möglicherweise nicht mehr benötigt werden.
F2: Sollten Eingabeaufforderungen und Patch-Code nach einem Modell-Upgrade komplett gelöscht und neu geschrieben werden?
In der Regel nicht empfehlenswert. Ein kompletter Neuschrieb ist zwar sauber, führt aber leicht zum Verlust impliziter Geschäftsregeln und gesammelter Erfahrungen aus Störfällen. Für Produktivsysteme eignet sich eine gruppenweise, schrittweise Bereinigung besser; wenn die Eingabeaufforderungen sehr klein sind oder das Geschäft gerade umgebaut wird, kann ein Neuschrieb erwogen werden – allerdings muss auch dieser über ein Regressionsset validiert werden.
F3: Wann ist der richtige Zeitpunkt, um Eingabeaufforderungen und Patch-Code zu bereinigen?
Der beste Zeitpunkt ist die Evaluierungsphase beim Modellwechsel, weil dann ohnehin Regressionstests laufen. Außerdem sollte eine gezielte Bereinigung angesetzt werden, wenn die Patch-Auslöserate über längere Zeit nahe null liegt oder die Eingabeaufforderungen so zahlreich geworden sind, dass niemand sie mehr anzupassen wagt. Vor großen Verkaufsaktionen oder Geschäftsspitzen sollten Sie nicht konzentriert bereinigen.
F4: Welche Eingabeaufforderungen und welcher Patch-Code dürfen auf keinen Fall wegen eines Modell-Upgrades gelöscht werden?
Berechtigungsprüfungen, Filterung sensibler Informationen, Validierung des Ausgabe-Schemas, Schutz vor Prompt-Injection und Audit-Logs sollten immer erhalten bleiben. Sie kontrollieren Systemrisiken und sollten sich nicht darauf verlassen, dass das Modell „mit hoher Wahrscheinlichkeit gut abschneidet“. Auch die Retry-Logik für Netzwerkfehler und Rate-Limits gehört zur Infrastruktur und darf nicht in die Bereinigung einbezogen werden.
F5: Wie lassen sich alte und neue Modelle schnell über die API vergleichen?
Nachdem das Regressionsset vorbereitet ist, lassen Sie die alte und die neue Versuchsgruppe dieselben Eingabeaufforderungen und Parameter verwenden und ändern nur den Modellnamen. Über APIYI können Sie verschiedene Modelle über ein Interface-Format aufrufen, das zu OpenAI oder Anthropic kompatibel ist – praktisch, um innerhalb desselben Testskripts zu wechseln. Details zur Konfiguration finden Sie in der Dokumentation: https://docs.apiyi.com
F6: Wie lässt sich feststellen, ob die Bereinigung wirklich Kosten spart?
Erfassen Sie getrennt die Input-Tokens, Output-Tokens, Cache-Treffer und Retry-Anzahl vor und nach der Bereinigung und multiplizieren Sie diese mit dem aktuellen Stückpreis. Stückpreise und Cache-Abrechnung finden Sie auf der Preisseite von APIYI: https://docs.apiyi.com/models . Vergleichen Sie neben den Kosten pro Aufruf auch die Kosten pro erfolgreich abgeschlossener Aufgabe – Letztere kommen den tatsächlichen Geschäftskosten näher.
F7: Welche Grenzen hat dieser Bereinigungsprozess?
Ein Regressionsset deckt nur bekannte Probleme ab; bestandene Tests bedeuten nicht, dass online keine neuen Situationen auftreten – Canary-Releases und Monitoring sind daher unverzichtbar. Der Prozess erfordert außerdem Personalaufwand; bei selten genutzten oder risikoarmen internen Tools muss er nicht vollständig übernommen werden. Bei wenigen Stichproben können die Kennzahlen stark schwanken, weshalb darauf keine zu feinen Schlussfolgerungen gestützt werden sollten.
Die wichtigsten Erkenntnisse: Aufräumen von Eingabeaufforderungen und Patch-Code nach einem Modell-Upgrade
- Beurteilungskriterium: Prüfen Sie, ob ein Inhalt das alte Modell kompensiert oder ob er Geschäftsregeln ausdrückt und Risiken kontrolliert.
- Vier Kategorien: Modellkompensation, Geschäftsregeln, Sicherheitsleitplanken und Schnittstellenanpassung – jede Kategorie erfordert andere Maßnahmen.
- Baseline zuerst: Im ersten Durchlauf wird nur das Modell getauscht, Eingabeaufforderungen und Patch-Code bleiben unverändert.
- Schrittweise Ablation: Entfernen Sie jeweils nur eine Gruppe zusammengehöriger Inhalte – nur so lässt sich bei einer Verschlechterung die Ursache genau lokalisieren.
- Validierungen behalten: Die JSON-Reparaturlogik können Sie überprüfen, Schema-Validierung und Berechtigungsprüfungen sollten bleiben.
- Fallback prüfen: Bevor Sie einen Patch löschen, stellen Sie sicher, ob das alte Modell in der Fallback-Kette noch davon abhängt.
- Vergleichswerkzeug: Über die kompatible Schnittstelle von APIYI können Sie mit demselben Skript zwischen Modellen wechseln und Regressionstests fahren.
Fazit
Ob Eingabeaufforderungen und Patch-Code nach einem Modell-Upgrade gelöscht werden sollten, hängt nicht von der Werbung für das neue Modell ab, sondern von Ihren Regressionsdaten. Die Bereinigung lässt sich in drei Punkten zusammenfassen:
- Erst die Herkunft klären: Machen Sie deutlich, welches Problem jedes Stück Inhalt löst, und ordnen Sie es anschließend einer der vier Kategorien zu.
- Experimentell entscheiden: Baseline aufbauen, gruppenweise Ablation durchführen und anhand vorab definierter Kennzahlen über Behalten oder Löschen entscheiden.
- Änderungen rückrollbar machen: Über Feature-Schalter im Canary-Verfahren ausrollen und modellbezogene Inhalte getrennt von Geschäftsregeln verwalten.
Beginnen Sie mit einem Szenario, das ein moderates Aufrufvolumen und überschaubares Risiko hat, führen Sie den kompletten Ablauf einmal durch und weiten Sie ihn dann auf das Kerngeschäft aus. Wenn Sie mehrere Modelle vergleichen möchten, können Sie die in diesem Artikel behandelten Modelle über APIYI aufrufen; die Anbindung ist unter https://docs.apiyi.com beschrieben. Bei den Kosten gelten die tatsächlichen Angaben auf der Preisseite https://docs.apiyi.com/models.
📚 Referenzen
- 36氪 – Princeton-CS-Absolventin verlässt überraschend Anthropic und machte Claude Code groß: Quelle für den aktuellen Hintergrund am Anfang dieses Artikels
- Link:
36kr.com/p/4055331476526214 -
Hinweis: Veröffentlicht am 4. November 2026. Die in diesem Artikel beschriebenen Bereinigungsmethoden sind eine Zusammenfassung allgemeiner Engineering-Praktiken und keine Wiedergabe des Inhalts dieses Berichts.
-
APIYI-Dokumentation: Erläuterung des Schnittstellenformats und der Integrationskonfiguration
- Link:
docs.apiyi.com -
Hinweis: Dient zur Bestätigung von
base_url, Schnittstellenpfaden und Aufrufmethoden. -
APIYI-Modell- und Preisseite: Modellliste und Abrechnungsinformationen
- Link:
docs.apiyi.com/models -
Hinweis: Die in diesem Artikel genannten Modellpreise, Abrechnungsgrundlagen und Cache-Preise richten sich nach den tatsächlichen Daten dieser Seite.
-
Offizielle Anthropic-Dokumentation: Leitfaden zu Claude-Modellen und Eingabeaufforderungen
- Link:
docs.anthropic.com -
Hinweis: Beim Upgrade auf Claude-Modelle können Sie dort Änderungen an der Schnittstelle und Empfehlungen zu Eingabeaufforderungen nachlesen.
-
Offizielle OpenAI-Dokumentation: Leitfaden zu GPT-Modellen und API
- Link:
platform.openai.com/docs - Hinweis: Beim Upgrade auf GPT-Modelle können Sie dort Parameteränderungen und Migrationshinweise nachlesen.
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website; weitere Materialien finden Sie im Dokumentationszentrum unter docs.apiyi.com