Anmerkung des Autors: Ein Leitfaden für Entwickler zur Fehlersuche bei Modell-API-Aufrufen im Live-Betrieb. Anhand von Fehlercodes, Logs und einer minimalen Reproduktion mit curl lässt sich feststellen, ob der Fehler beim eigenen Aufruf, auf der Gateway-Plattform oder beim Upstream-Modell liegt. Dazu gibt es eine Checkliste für Fehlermeldungen.
Mitten in der Nacht meldet ein Alarm eine steigende Fehlerrate bei der Modell-API. Die meiste Zeit kostet dabei oft nicht die Reparatur, sondern die Frage, wer zuständig ist: Hat eine Änderung am eigenen Code den Fehler verursacht? Gibt es ein Problem auf der Gateway-Plattform? Oder ist der Upstream-Modelldienst instabil? Dieser Artikel stellt eine Methode zur Ursachenanalyse auf drei Ebenen vor: eigener Aufruf → Gateway-Plattform → Upstream-Modell. Damit lässt sich die Fehlersuche bei Modell-API-Aufrufen schnell eingrenzen.
Dies ist keine bloße Fehlercode-Übersicht. Auch Betreiber von Modell-Aggregationsplattformen nutzen diese Einteilung, um fehlerhafte Aufrufe zu untersuchen: Sie reproduzieren das Problem anhand von Anfrageparametern, Logs, Fehlercodes und der Aufrufkette und prüfen dann, ob die Ursache beim Aufruf des Nutzers, bei der Plattform oder beim Upstream-Modelldienst liegt. Dieser Artikel übersetzt den Ansatz in eine Reihenfolge, die Sie als API-Nutzer direkt anwenden können. Ob Sie einen Anbieter direkt oder über ein Aggregations-Gateway wie APIYI anbinden: Die Reihenfolge der Fehlersuche bleibt gleich.
Das nehmen Sie mit: eine Fehlersuche in 6 Schritten, typische Hinweise auf verschiedene Fehlerkategorien, eine minimale Reproduktion mit curl und eine Checkliste, die Sie für eine Fehlermeldung direkt ausfüllen können.
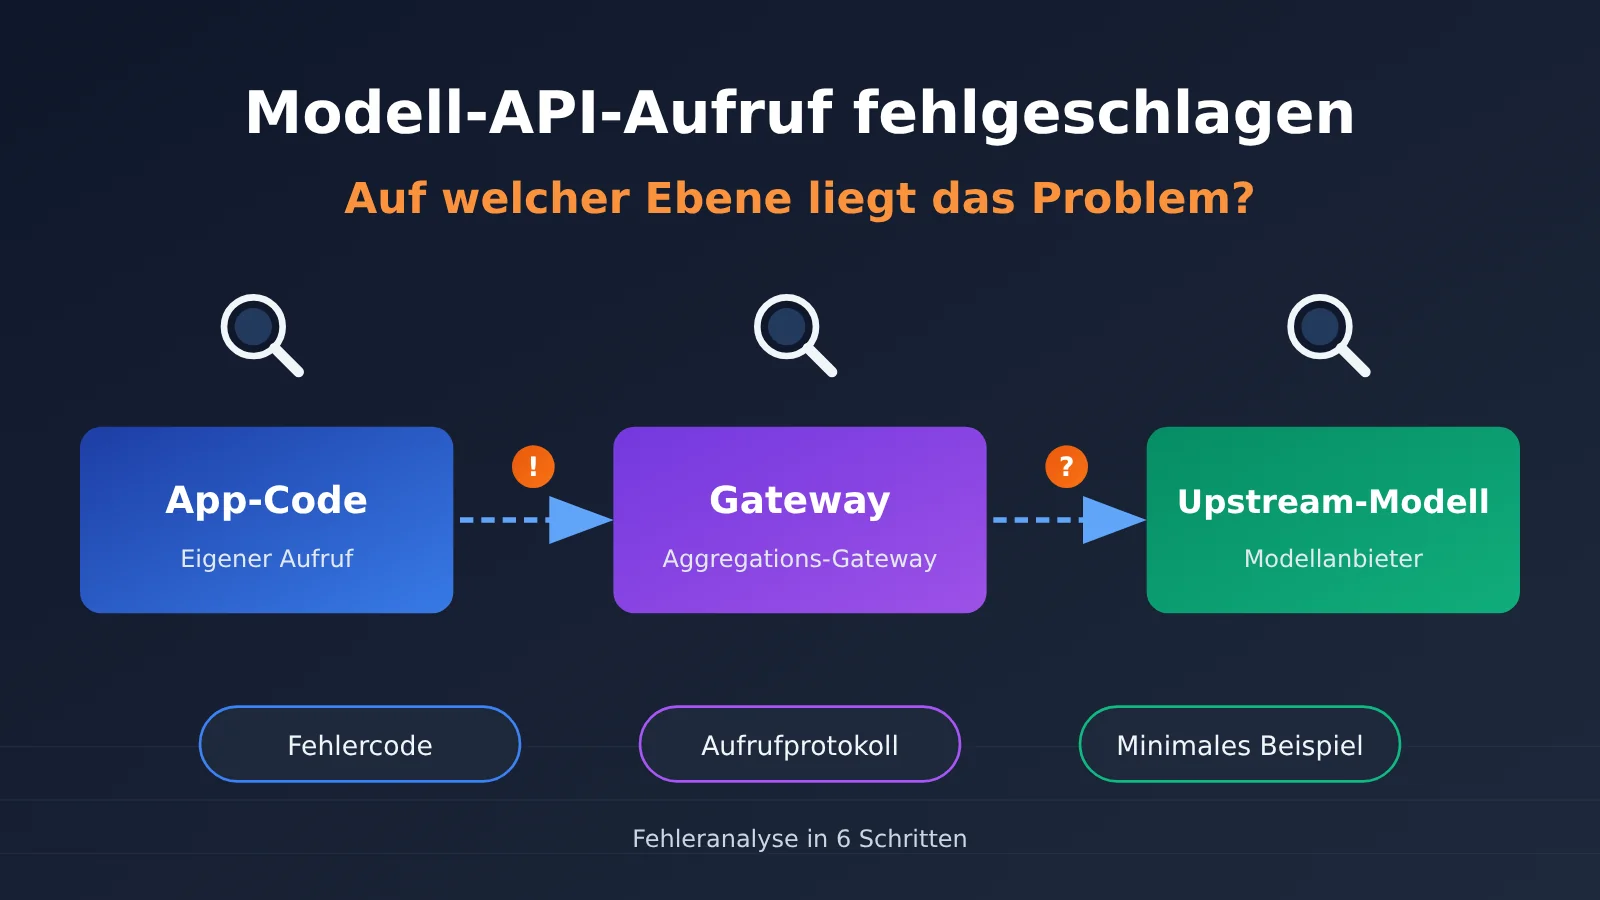
Die drei Ebenen zur Ursachenanalyse bei Modell-API-Fehlern
Ein Modell-API-Aufruf durchläuft mindestens drei Ebenen: deine Anwendung und Netzwerkumgebung, ein zwischengeschaltetes Gateway oder eine Aggregationsplattform und schliesslich den Modellanbieter, der die Inferenz bereitstellt. Bei einer direkten Verbindung zum Anbieter ist die mittlere Ebene schlank, aber Lastverteilung und Zugangsschicht gibt es trotzdem. Ziel der Analyse ist es, den Fehler einer dieser Ebenen zuzuordnen.
| Ebene | Typische Probleme | Häufige Hinweise | Zuständig |
|---|---|---|---|
| Eigener Aufruf | Falscher API-Schlüssel, ungültige Parameter, Kontextfenster überschritten, zu kurz gesetztes lokales Timeout, Proxy- oder DNS-Probleme | 4xx-Fehler lässt sich zuverlässig reproduzieren; in einer anderen Umgebung funktioniert es; nur bestimmte Codepfade sind betroffen | Du selbst |
| Gateway-Plattform | Fehler bei Authentifizierung oder Abrechnung, fehlerhafte Parameterzuordnung, Routing oder Fallback, Ratenbegrenzung durch die Plattform, Verbindungsabbruch unterwegs | Direkter Aufruf funktioniert, über das Gateway schlägt er fehl; das Format der Fehlermeldung weicht vom Anbieter ab; mehrere Modelle sind gleichzeitig betroffen | Plattformbetreiber |
| Modellanbieter | Überlastung, Änderung der Modellversion, verändertes Modellverhalten, Ratenbegrenzung durch den Anbieter | Mehrere Zugangskanäle schlagen gleichzeitig fehl; es gibt eine Meldung auf der Statusseite des Anbieters; nur ein bestimmtes Modell ist betroffen | Modellanbieter (meist über die Plattform informiert) |
Warum die Ursachenanalyse bei Modell-APIs mit drei Ebenen beginnt
Wenn ein Modell-API-Aufruf fehlschlägt, reagieren viele Teams zunächst mit mehr Wiederholungsversuchen oder wechseln direkt das Modell. Das kann kurzfristig helfen, behebt aber nicht die Ursache. Das Problem kann nach ein paar Tagen wieder auftreten – und ein Konfigurationsfehler bleibt möglicherweise unentdeckt. Wer zuerst die Ursache eingrenzt und dann handelt, vermeidet Zeitverlust durch Massnahmen an der falschen Stelle.
Die Einordnung in drei Ebenen hilft auch bei der Frage, an wen du dich als Nächstes wenden solltest. Liegt das Problem beim eigenen Aufruf, lässt es sich durch eine Codeänderung beheben. Ist die Gateway-Plattform betroffen, solltest du den Plattformbetreiber mit der Request-ID kontaktieren. Liegt die Ursache beim Modellanbieter, bleibt meist nur, auf die Wiederherstellung zu warten, das Modell zu wechseln oder einen Fallback zu aktivieren. Die Massnahmen unterscheiden sich also deutlich. Eine falsche Zuordnung verlängert die Zeit bis zur Behebung.
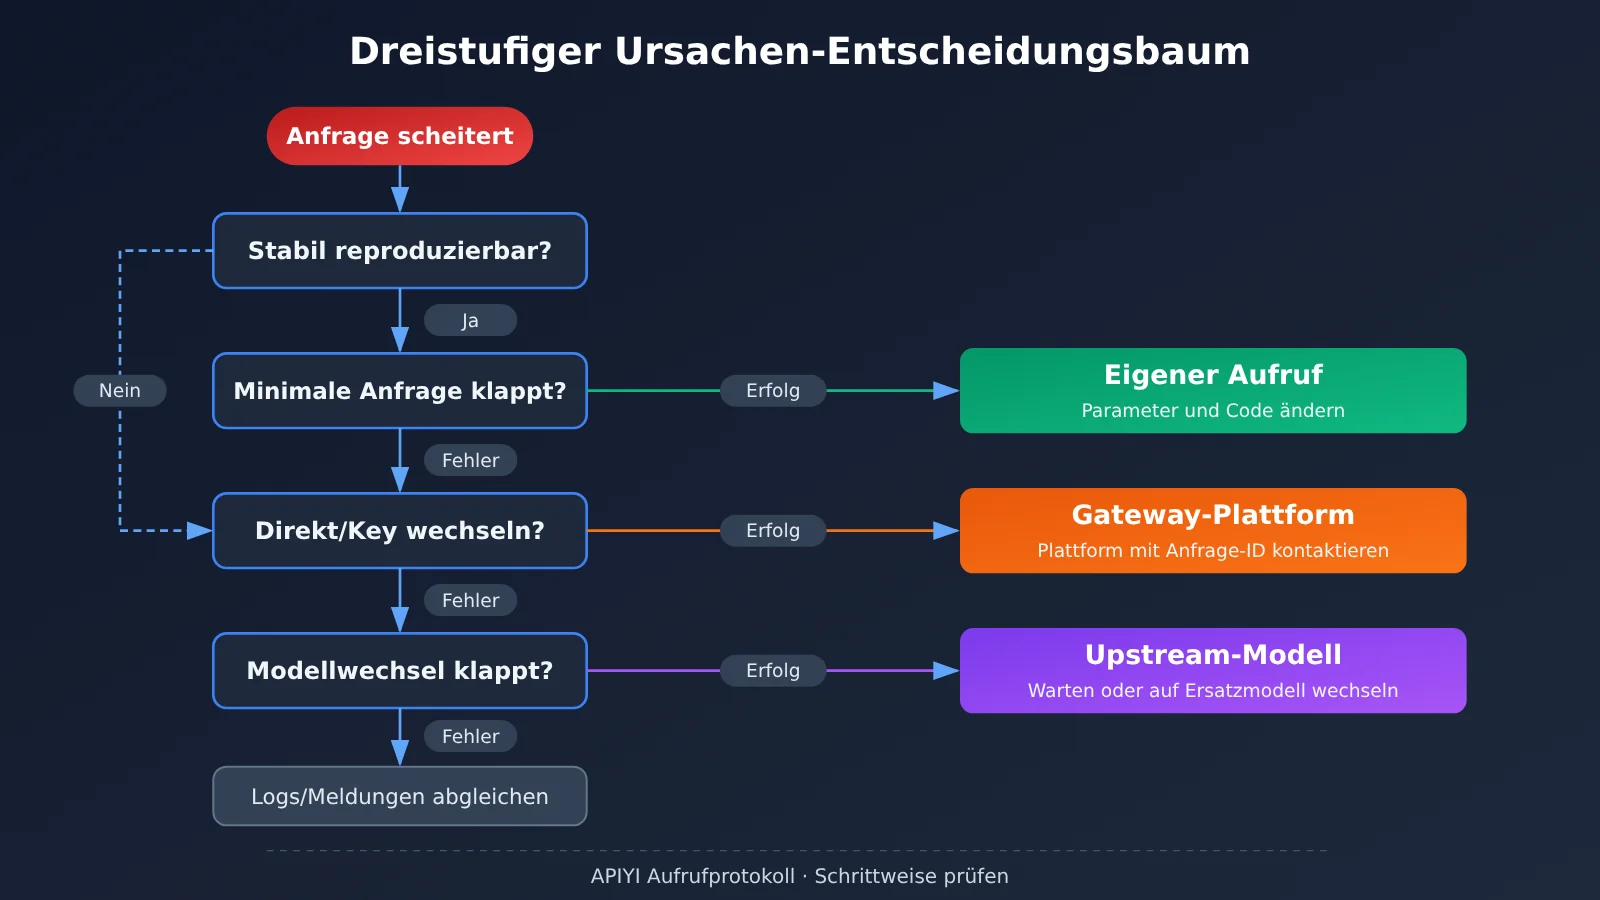
Fehler bei Modell-API-Aufrufen in 6 Schritten eingrenzen
Die Reihenfolge folgt dem Prinzip: erst die einfachen Prüfungen, dann die aufwendigeren; erst das Problem eingrenzen, dann tiefer suchen. Jeder Schritt schließt möglichst eine Fehlerquelle aus, statt alle Komponenten gleichzeitig zu verdächtigen.
- Auswirkungen eingrenzen: Schlagen alle oder nur einzelne Anfragen fehl? Ist ein Modell betroffen oder sind es mehrere? Seit wann tritt der Fehler auf? Je größer die Auswirkungen, desto wahrscheinlicher liegt die Ursache bei der Plattform oder einem vorgelagerten Anbieter. Ist nur eine Funktion betroffen, liegt es meist am eigenen Code.
- Originalfehler dokumentieren: Speichere den HTTP-Statuscode, den unveränderten Response-Body, die Anfrage-ID aus dem Response-Header (falls vorhanden), den Zeitpunkt und die Dauer. Verlass dich nicht allein auf die vom SDK aufbereitete Fehlermeldung – dabei gehen oft wichtige Details verloren.
- Minimalbeispiel erstellen: Sende unabhängig vom Anwendungscode mit curl eine möglichst einfache Anfrage, zum Beispiel einen kurzen Text ohne Streaming und Tool-Aufrufe. Ist diese Anfrage erfolgreich, liegt das Problem wahrscheinlich an deiner Parameterkombination oder Anwendungslogik.
- Parameter schrittweise ergänzen: Füge ausgehend von der minimalen Anfrage nacheinander die System-Eingabeaufforderung, einen langen Kontext sowie Parameter wie
stream,toolsundresponse_formathinzu. So findest du heraus, welcher davon den Fehler auslöst. - Vergleiche durchführen: Teste ein anderes Modell über dasselbe Gateway oder stelle, sofern die Netzwerkumgebung es erlaubt, eine direkte Verbindung zum Anbieter her. Funktioniert ein anderes Modell, deutet das meist auf den vorgelagerten Anbieter hin. Funktioniert der direkte Zugriff, liegt die Ursache meist beim Gateway.
- Logs und Statusmeldungen prüfen: Sieh dir die Aufruf-Logs der Plattform und die Statusseite des Anbieters an. Prüfe, ob die Anfrage die Plattform erreicht hat, ob sie weitergeleitet wurde und was der vorgelagerte Anbieter zurückgegeben hat.
Häufige Fehlerarten bei Modell-APIs und ihre Erkennungsmerkmale
Fehlercodes sind der direkteste Anhaltspunkt bei der Fehlersuche. Allerdings ordnen Plattformen sie nicht immer einheitlich zu. Die folgende Tabelle orientiert sich an der allgemeinen HTTP-Semantik. Die genaue Bedeutung findest du in der Dokumentation deiner Plattform.
| Fehlerart | Typisches Erscheinungsbild | Erkennungsmerkmale | Wahrscheinlichste Ursache |
|---|---|---|---|
| Authentifizierung fehlgeschlagen | 401 / 403 | Mit einem anderen API-Schlüssel funktioniert es wieder; der Schlüssel enthält überflüssige Leerzeichen oder wurde für die falsche Umgebung verwendet | Meist der eigene Aufruf, gelegentlich der Kontostatus auf der Plattform |
| Parameterfehler | 400 / 422 | Eine minimale Anfrage funktioniert, schlägt aber nach dem Hinzufügen eines bestimmten Parameters fehl; die Fehlermeldung nennt den Feldnamen | Eigener Aufruf oder fehlerhafte Parameterzuordnung der Plattform |
| Modell nicht vorhanden | 404 oder Hinweis auf ein ungültiges Modell | Der Modellname ist falsch geschrieben oder das Modell wurde abgeschaltet oder umbenannt | Eigener Aufruf oder Änderung der Modellversion |
| Ratenbegrenzung / Kontingent | 429 | Nach Verringerung der gleichzeitigen Anfragen funktioniert es wieder; der Response-Header enthält eine Wartezeit bis zum nächsten Versuch | Je nach Ursprung der Begrenzung auf Plattform- oder Upstream-Seite |
| Serverfehler | 500 / 502 / 503 | Dieselbe Anfrage funktioniert mal und mal nicht; mehrere Nutzer melden gleichzeitig Probleme | Gateway-Plattform oder Upstream-Modell |
| Timeout | 504 oder clientseitiger Timeout | Tritt häufiger bei Anfragen mit langer Ausgabe auf; verschwindet nach dem Wechsel zu Streaming | Lokale Timeout-Einstellung, Gateway-Timeout oder zu langsame Upstream-Inferenz |
| Streaming-Unterbrechung | SSE-Verbindung bricht vorzeitig ab, ohne Endmarkierung | Anfragen ohne Streaming funktionieren; tritt nur bei langen Antworten auf | Zwischengeschalteter Proxy, Einstellungen zum Offenhalten der Gateway-Verbindung oder Upstream |
Besonderheiten bei Streaming-Unterbrechungen, Versionswechseln und automatischem Fallback
Streaming-Unterbrechungen gehören zu den Problemen, deren Ursache sich am schwersten ermitteln lässt. Der Client sieht lediglich, dass die Verbindung abgebrochen wurde; der HTTP-Statuscode kann trotzdem 200 sein. Prüfen Sie zunächst, ob Ihr Proxy, Load Balancer oder Nginx für langlebige Verbindungen ein kurzes Leerlauf-Timeout festlegt. Beobachten Sie dann mit curl und dem Parameter -N direkt die rohe SSE-Ausgabe, um zu prüfen, ob eine Endmarkierung angekommen ist.
Versionswechsel führen nicht unbedingt zu einer Fehlermeldung, können aber die Ausgabe verändern: Beispielsweise ist das JSON-Format nicht mehr stabil oder bei Tool-Aufrufen fehlen Parameter. Wenn der Modellname auf einen Alias verweist, der laufend aktualisiert wird, kann sich das Verhalten nach einem Update des Upstream-Anbieters unbemerkt ändern. Verwenden Sie in Produktionsumgebungen möglichst feste Modellnamen mit Datum oder Versionsnummer und führen Sie regelmäßig Regressionstests durch.
Automatisches Fallback und dynamisches Routing können dazu führen, dass die Ergebnisse bei der Fehlersuche nicht konsistent sind. Manche Gateways wechseln bei einem Fehler des Upstream-Anbieters automatisch auf einen alternativen Kanal oder ein anderes Modell. Das erhöht die Verfügbarkeit, kann aber auch bedeuten, dass dieselbe Anfrage einmal funktioniert und beim nächsten Mal fehlschlägt – oder sich der Ausgabestil plötzlich ändert. Prüfen Sie, ob das Feld model in der Antwort mit der Anfrage übereinstimmt. Falls die Plattformprotokolle den tatsächlich verwendeten Kanal oder das Modell erfassen, sollten Sie auch diese Angaben abgleichen. Ob der Aufrufer das Fallback erkennen kann, hängt von der Implementierung der Plattform ab. Klären Sie das am besten im Voraus mit dem Plattformanbieter.
Fehler beim Modellaufruf per API: Minimalbeispiel mit curl
Ein Minimalbeispiel hilft dabei, Einflüsse des Anwendungscodes auszuschließen. curl benötigt kein SDK und zeigt den unverarbeiteten HTTP-Austausch – ideal als Grundlage für die Fehlersuche. Das folgende Beispiel bezieht sich auf eine OpenAI-kompatible Schnittstelle. Ersetzen Sie die Adresse durch die base_url aus der Dokumentation Ihrer Plattform.
5 curl-Tipps für ein Minimalbeispiel
- Nur Statuscode und Dauer anzeigen: Mit
-sS -o /dev/null -w "%{http_code} %{time_total}"sehen Sie innerhalb weniger Sekunden, ob die Anfrage ankommt und wie lange sie dauert. - Vollständige Anfrage- und Antwort-Header anzeigen: Mit dem Parameter
-vsehen Sie den TLS-Handshake sowie die Anfrage- und Antwort-Header. Viele Plattformen legen die Anfrage-ID und Informationen zur Ratenbegrenzung in den Antwort-Headern ab. - Dauer einzelner Verbindungsphasen unterscheiden: Ergänzen Sie in
-wdie Werte%{time_namelookup},%{time_connect}und%{time_starttransfer}. Dauert die DNS-Auflösung oder der Verbindungsaufbau lange, liegt das Problem meist im lokalen Netzwerk. Eine lange Zeit bis zum ersten Byte deutet eher auf ein langsames Gateway oder eine langsame Inferenz beim vorgelagerten Anbieter hin. - Streaming-Ausgabe beobachten: Deaktivieren Sie mit
-Ndie Pufferung und setzen Sie im Anfrage-Body"stream": true. So können Sie die SSE-Daten Zeile für Zeile verfolgen und erkennen, wo die Verbindung abbricht. - Anfrage-Body minimieren: Behalten Sie nur
modelund einen Eintrag inmessagesmit einem kurzen Text. Lassen Sie optionale Parameter wietools,response_formatundmax_tokensweg.
🚀 Tipp zur Fehlersuche: Auf Aggregationsplattformen wie APIYI können Sie mit demselben API-Schlüssel Modelle verschiedener Anbieter aufrufen. Für einen Vergleich müssen Sie im Minimalbeispiel nur das Feld
modeländern. So lässt sich schnell ein anderes Modell testen, ohne für jeden Anbieter ein eigenes Konto und einen eigenen API-Schlüssel einzurichten.
Vergleichsmatrix: Die Fehlerquelle eingrenzen
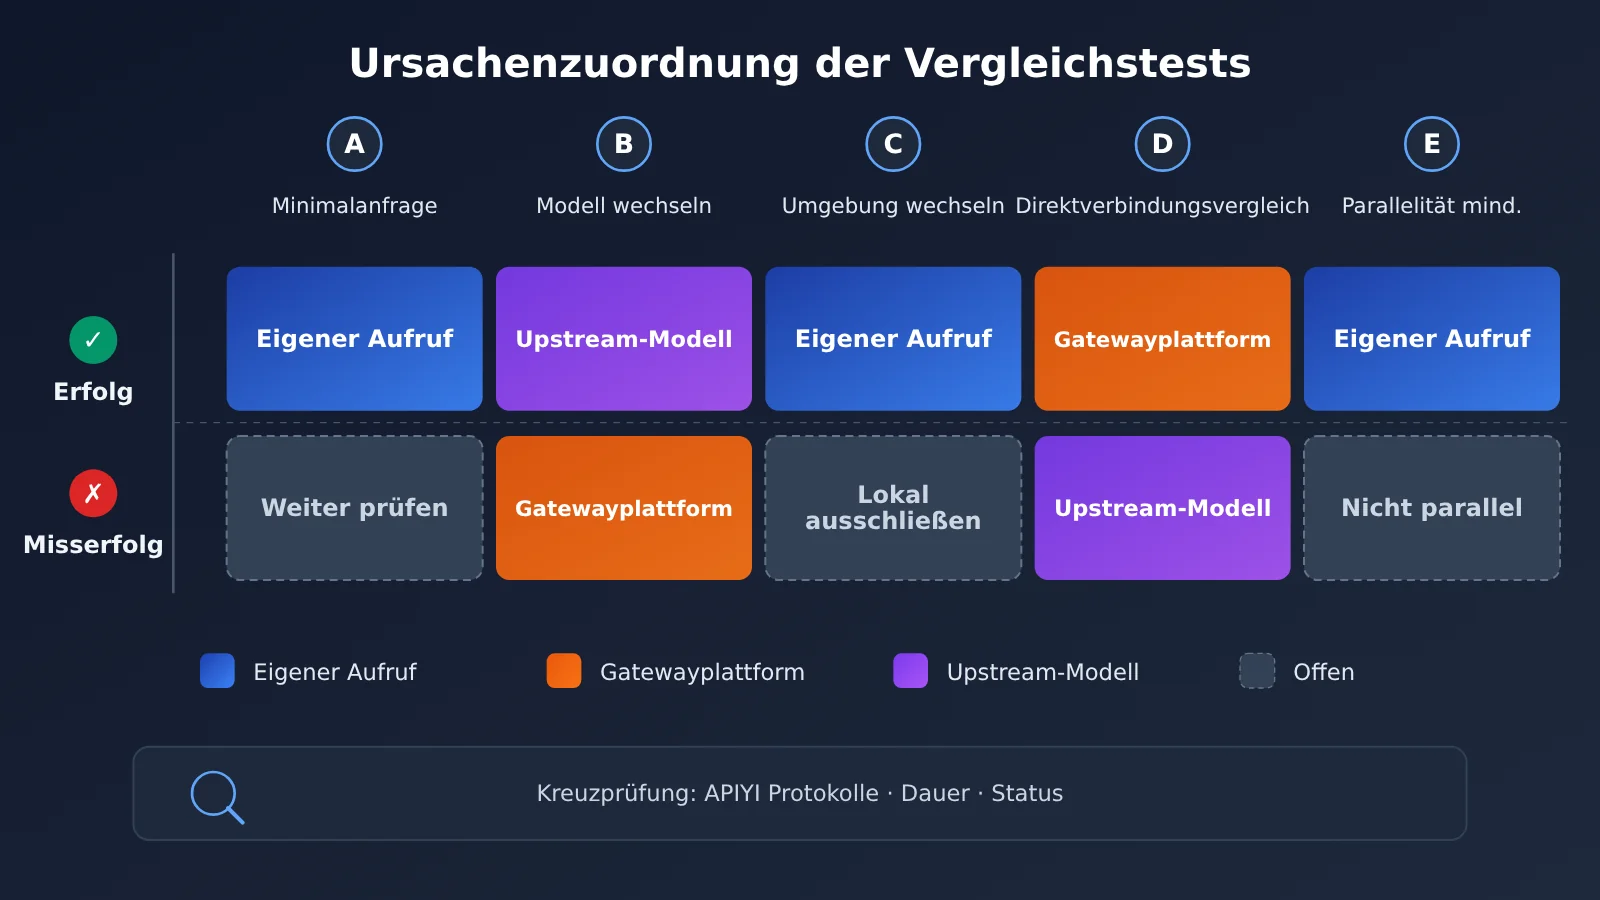
Mit gezielten Vergleichstests lässt sich die Ursache deutlich zuverlässiger eingrenzen. Führen Sie möglichst mindestens die ersten drei Tests in der Tabelle durch.
| Testgruppe | Vorgehen | Was bedeutet Erfolg? | Was bedeutet ein Fehler? |
|---|---|---|---|
| A: Minimale Anfrage | Derselbe API-Schlüssel und dasselbe Modell, minimaler Anfrage-Body | Das Problem liegt an den Anwendungsparametern oder der Codelogik | Mit den Tests B und C fortfahren |
| B: Anderes Modell | Dasselbe Gateway und derselbe API-Schlüssel, Modell eines anderen Anbieters verwenden | Beim Anbieter des ursprünglichen Modells könnte ein Problem vorliegen | Gateway, API-Schlüssel oder lokales Netzwerk sind eher verdächtig |
| C: Andere Umgebung | Dieselbe Anfrage von einem anderen Rechner oder Netzwerk senden | Problem im lokalen Netzwerk, Proxy oder DNS | Lokale Netzwerkfaktoren ausschließen |
| D: Direkter Vergleich | Wenn möglich, die offizielle Schnittstelle des Anbieters direkt aufrufen | Das Gateway ist eher verdächtig; der Fehler kann an die Plattform gemeldet werden | Das vorgelagerte Modell selbst funktioniert nicht ordnungsgemäß |
| E: Parallelität reduzieren | Die Anzahl paralleler Anfragen auf 1 senken und erneut versuchen | Problem mit Ratenbegrenzung oder Kontingent | Das Problem hängt nicht mit der Parallelität zusammen |
Aufrufprotokolle zur Ursachenanalyse von Modell-API-Fehlern nutzen
curl zeigt, ob ein Aufruf jetzt fehlschlägt. Aufrufprotokolle zeigen, was zum fraglichen Zeitpunkt passiert ist. Probleme im laufenden Betrieb lassen sich oft nicht zuverlässig reproduzieren – dann sind Logs die einzige verfügbare Informationsquelle. Gleichen Sie bei der Fehlersuche die Logs Ihrer Anwendung und der Plattform anhand von Zeitstempel und Anfrage-ID ab und betrachten Sie sie gemeinsam.
Auf Anwendungsseite sollten Sie mindestens Folgendes protokollieren: Anfragezeitpunkt, Modellname, Parameterübersicht ohne sensible Inhalte, HTTP-Statuscode, ursprüngliche Fehlerantwort, Gesamtdauer, Zeit bis zum ersten Byte und die von der Plattform zurückgegebene Anfrage-ID. Plattformseitige Logs können ergänzen, was Sie selbst nicht sehen – etwa ob die Anfrage die Plattform erreicht hat, wie viele Token abgerechnet wurden und welches Modell tatsächlich aufgerufen wurde.
💡 Tipp zur Log-Nutzung: Wenn Sie APIYI verwenden, können Sie die Aufrufprotokolle in der Konsole nach Zeitraum einsehen und einzeln mit Ihren Anwendungslogs abgleichen. Welche Felder die Plattformlogs enthalten und ob ursprüngliche Fehlermeldungen vorgelagerter Anbieter durchgereicht werden, entnehmen Sie bitte den Angaben in der Konsole und Dokumentation. Im Zweifel ist eine Nachfrage beim technischen Support schneller als eigenes Rätselraten.
Checkliste für eine Fehlermeldung an den Anbieter
Je vollständiger Ihre Fehlermeldung, desto schneller lässt sich das Problem lösen. Bei einer Beschreibung wie „Die Schnittstelle funktioniert nicht mehr“ sind fast immer mehrere Rückfragen nötig. Stellen Sie die Informationen aus der folgenden Tabelle am besten zusammen und übermitteln Sie sie gebündelt.
| Information | Beispiel | Zweck |
|---|---|---|
| Zeitraum | Sekundengenau und mit Zeitzone | Erleichtert der Plattform die Log-Suche |
| Anfrage-ID | Eindeutige Kennung im Response-Header oder Response-Body | Ermöglicht die direkte Zuordnung einer einzelnen Anfrage |
| Modellname und Endpunkt | Vollständiger Modellname und Schnittstellenpfad | Hilft zu prüfen, ob ein bestimmter vorgelagerter Anbieter betroffen ist |
| Ursprüngliche Fehlermeldung | Statuscode und vollständiger Response-Body | Unterscheidet Plattformfehler von durchgereichten Fehlern vorgelagerter Anbieter |
| Minimale Reproduktionsschritte | Beschreibung der bereinigten curl-Parameter | Ermöglicht eine zuverlässige Reproduktion |
| Auswirkungen | Anteil fehlgeschlagener Anfragen, betroffene Modelle oder Funktionen | Hilft, den Schweregrad einzuschätzen |
| Bereits durchgeführte Vergleiche | Ergebnisse der Versuchsgruppen A bis E | Vermeidet doppelte Fehlersuche |
Entfernen Sie vor der Fehlermeldung sensible Angaben wie API-Schlüssel und private Nutzerdaten. Lassen Sie vom Schlüssel nur die ersten und letzten Zeichen zur Identifikation stehen. Bietet Ihre Plattform rund um die Uhr technischen Support, können Sie bei dringenden Störungen zunächst kurz die Auswirkungen melden und die Details anschließend nachreichen.
Häufige Fragen (FAQ)
F1: Was sollte ich als Erstes tun, wenn ein Modellaufruf per API fehlschlägt?
Dokumentieren Sie zunächst den ursprünglichen Fehler: Statuscode, unveränderten Response-Body, Request-ID und Zeitpunkt. Prüfen Sie anschließend, wie groß die Auswirkung ist. Starten Sie den Dienst nicht vorschnell neu und ändern Sie nicht sofort den Code. Gehen die ursprünglichen Informationen verloren, wird die Ursachenanalyse deutlich schwieriger.
F2: Wie erkenne ich, ob das Problem am Gateway oder am vorgelagerten Modell liegt?
Am besten hilft ein Vergleichstest: Wechseln Sie am selben Gateway zu einem anderen Modell. Funktioniert es dann wieder, liegt die Ursache wahrscheinlich beim Anbieter des ursprünglichen Modells. Falls eine direkte Verbindung zum Anbieter möglich ist und funktioniert, ist eher die Gateway-Ebene verdächtig. Auch das Format der Fehlerantwort kann Hinweise liefern: Durchgereichte Fehler des Anbieters haben oft eine anbieterspezifische Struktur.
F3: Liegt ein 429-Rate-Limit an mir?
Nicht unbedingt. Ein 429-Fehler kann durch das Kontingent Ihres Kontos, eine plattformseitige Begrenzung gleichzeitiger Anfragen pro Schlüssel oder eine Überlastung beim vorgelagerten Anbieter entstehen. Reduzieren Sie zunächst die Zahl gleichzeitiger Anfragen auf 1 und versuchen Sie es erneut. Prüfen Sie dann die Hinweise zum Rate-Limit in den Response-Headern und fragen Sie bei der Plattform nach, auf welcher Ebene die Begrenzung greift.
F4: Wie gehe ich vor, wenn dieselbe Anfrage mal funktioniert und mal fehlschlägt?
Prüfen Sie zunächst, ob ein automatischer Fallback oder dynamisches Routing aktiv ist: Vergleichen Sie das Feld `model` in der Antwort mit dem tatsächlich aufgerufenen Kanal in den Plattform-Logs. Untersuchen Sie anschließend die Laufzeiten der fehlgeschlagenen Anfragen. Häufen sie sich um einen bestimmten Wert, wurde möglicherweise auf einer Ebene ein Timeout ausgelöst.
F5: Wie lassen sich Modelle mit wenig Aufwand und geringen Kosten vergleichen?
Ein Aggregator mit einer einheitlichen Schnittstelle für mehrere Modelle macht den Vergleich einfacher. Bei APIYI reicht es, mit demselben API-Schlüssel das Feld `model` zu ändern, um den Anbieter zu wechseln. So lassen sich ein minimales Reproduktionsbeispiel und ein direkter Vergleich innerhalb weniger Minuten durchführen, ohne bei jedem Anbieter ein eigenes Konto zu beantragen.
F6: Ist ein plötzlicher Qualitätsverlust der Modellausgabe auch ein Aufruffehler?
Dabei wird zwar keine Fehlermeldung ausgegeben, trotzdem sollte die Ursache geklärt werden. Prüfen Sie zunächst, ob der Modellname auf einen Alias verweist, der regelmäßig aktualisiert wird. Vergleichen Sie dann feste Testfälle mit früheren Ergebnissen. Wenn sich das Modellverhalten tatsächlich geändert hat, melden Sie es der Plattform und liefern Sie Vergleichsbeispiele mit.
F7: Muss ich bei einer Störungsmeldung über ein Aggregator-Gateway Informationen zum vorgelagerten Anbieter liefern?
Sie müssen den Anbieter nicht selbst kontaktieren. Geben Sie aber die Request-ID, den Modellnamen und die ursprüngliche Fehlermeldung an. Damit kann die Plattform die Weiterleitungsprotokolle durchsuchen und feststellen, ob der Fehler vom vorgelagerten Anbieter stammt. Wenn Sie etwa den technischen Support von APIYI mit Request-ID und Zeitfenster kontaktieren, lassen sich viele Rückfragen vermeiden.
Die wichtigsten Punkte zur Fehlersuche bei Modell-API-Aufrufen
- Zuerst die Ebene bestimmen: Liegt das Problem beim eigenen Aufruf, auf der Gateway-Plattform oder beim vorgelagerten Modell? Davon hängt die Lösung ab.
- Originaldaten sichern: Statuscode, vollständige Antwort und Anfrage-ID sind die wichtigsten Hinweise auf die Fehlerursache.
- Minimalbeispiel erstellen: Mit curl den Aufruf ohne Anwendungscode reproduzieren und Parameter einzeln wieder hinzufügen, bis der Auslöser gefunden ist.
- Vergleichstests durchführen: Ein anderes Modell, eine andere Umgebung und ein direkter Aufruf helfen, die Fehlerquelle einzugrenzen.
- Auf automatisches Fallback achten: Bei unterschiedlichen Ergebnissen das tatsächlich verwendete Modell und die Routing-Protokolle prüfen.
- Logs auf beiden Seiten abgleichen: Anwendungslogs und Aufrufprotokolle von Plattformen wie APIYI anhand von Zeitstempel und Anfrage-ID vergleichen.
- Fehler strukturiert melden: Zeitpunkt, Anfrage-ID, vollständige Fehlermeldung und Ergebnisse der Vergleichstests gesammelt übermitteln.
Fazit
Wenn ein Modell-API-Aufruf fehlschlägt, ist nicht die sofortige Lösung das Wichtigste. Entscheidend ist zunächst, die betroffene Ebene zu bestimmen:
- Eigener Aufruf: Mit einem Minimalbeispiel und dem schrittweisen Hinzufügen von Parametern prüfen. Meist lässt sich das Problem durch Änderungen am Code oder an der Konfiguration beheben.
- Gateway-Plattform: Durch einen Vergleich mit einem direkten Aufruf und anhand der Plattform-Logs prüfen. Anschließend den Plattformbetreiber mit der Anfrage-ID kontaktieren.
- Vorgelagertes Modell: Durch einen Vergleich mit anderen Modellen und anhand von Herstellerhinweisen prüfen. Ein Modellwechsel oder eine Fallback-Strategie kann das Problem vorübergehend abfangen.
Am besten nehmen Sie die sechs Schritte zur Fehlersuche und die Checkliste für Fehlermeldungen in das On-Call-Handbuch Ihres Teams auf. So können Sie beim nächsten Alarm direkt danach vorgehen. Wenn Sie eine Lösung für den Zugriff auf mehrere Modelle aufbauen, können Sie über APIYI (apiyi.com) mit derselben Schnittstelle modellübergreifende Vergleichstests durchführen und mithilfe der Aufrufprotokolle der Plattform einen eigenen Prozess zur Fehlersuche einrichten.
📚 Referenzen
- MDN HTTP-Antwortstatuscodes: Allgemeine Bedeutung der HTTP-Statuscodes
- Link:
developer.mozilla.org/zh-CN/docs/Web/HTTP/Status -
Hinweis: Hilft dabei, die standardmässige Bedeutung von 4xx- und 5xx-Fehlern zu verstehen
-
Offizielles curl-Handbuch: Vollständige Beschreibung der curl-Parameter
- Link:
curl.se/docs/manpage.html -
Hinweis: Enthält Erklärungen zu häufig verwendeten Parametern für die Fehlersuche, etwa den Zeitvariablen von
-w,-Nund-v -
MDN Server-Sent Events: Beschreibung des SSE-Streaming-Protokolls
- Link:
developer.mozilla.org/zh-CN/docs/Web/API/Server-sent_events - Hinweis: Hilft dabei, das Format der Streaming-Ausgabe und das Verhalten bei Unterbrechungen zu verstehen
Autor: Das technische Team von APIYI
Technischer Austausch: Kontaktieren Sie uns über die Startseite von APIYI. Weitere Informationen zur Anbindung und Fehlerbehebung finden Sie im Dokumentationszentrum unter docs.apiyi.com.