Der Tool Search der drei Anbieter löst dasselbe Problem, aber die Implementierungswege unterscheiden sich deutlich. Alle drei lassen das Modell zu Beginn nur kurze Hinweise auf die Tools sehen und laden das vollständige Parameterschema erst nach, wenn ein Tool aufgerufen werden soll. Die Unterschiede liegen vor allem an drei Stellen: Gemini bietet zwei Suchmodi – serverseitig und clientseitig; die clientseitige Suche kann neue Tools einbringen. Claude stellt zwei serverseitige Suchverfahren bereit, Regex und BM25, und nutzt tool_reference, um innerhalb der bereits deklarierten Tool-Menge zu suchen. GPT gruppiert Tools mit namespace; im Client-Modus lassen sich über tool_search_output dynamisch neue Tools einspeisen. Bei der Auswahl kommt es darauf an, ob die Tool-Bibliothek feststeht oder sich häufig ändert – und auf die vorhandene API-Architektur des Teams.
Was Sie nach dem Lesen dieses Artikels wissen
- Zu welcher API der Tool Search der drei Anbieter jeweils gehört und mit welchem Feld er aktiviert wird.
- Worin sich die Inhalte unterscheiden, die im initialen Kontext des Modells verbleiben, und welche Rolle
short_description,tool_referenceundnamespacejeweils spielen. - Wie sich die Ereigniskette aus Tool-Suche und tatsächlichem Funktionsaufruf zusammensetzt und wo bei der Anpassung leicht Fehler passieren.
- Welcher Anbieter neue Tools in eine Unterhaltung einbringen kann, die im ursprünglichen Request nicht enthalten waren.
- Wie man bei Unternehmens-Agenten für Bestellungen und Lagerbestand anhand der Struktur der Tool-Bibliothek die richtige Wahl trifft.
Überblick:Der Hauptteil beginnt mit den Veröffentlichungsterminen und der gemeinsamen Idee der drei Anbieter, zerlegt danach die Suchmechanismen und nativen Felder von Gemini, Claude und GPT, vergleicht sie anschließend in einer Übersichtstabelle über acht Dimensionen und zeigt dieselben drei technischen Wege anhand eines Agenten für Bestellungen und Lagerbestand. Der abschließende Analyseteil liefert Auswahlkriterien und erläutert, worauf bei der Protokollanpassung in einem modellübergreifenden Gateway zu achten ist.
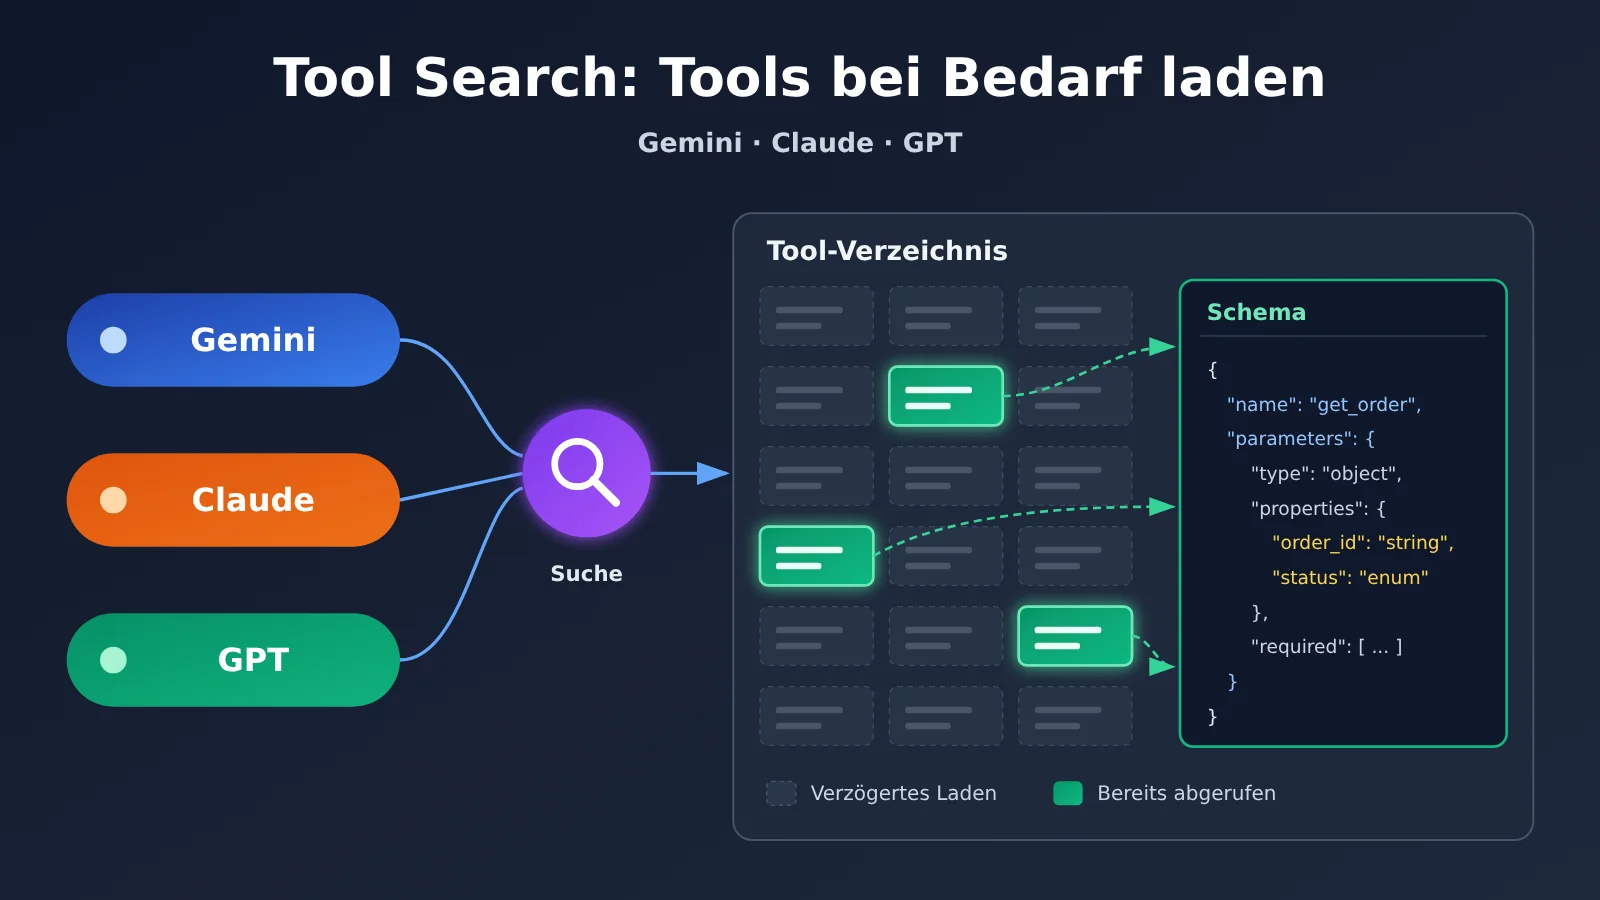
Wichtige Konzepte zu Tool Search
| Konzept | Kurze Erklärung |
|---|---|
| Werkzeugkatalog | Eine Sammlung von Geschäftswerkzeugen für die Suche, einschließlich Name, Beschreibung, Parameterdefinitionen und Berechtigungsinformationen |
| Tool Search | Die Fähigkeit, die für eine aktuelle Aufgabe benötigten Werkzeuge zu suchen und ihre vollständigen Definitionen bei Bedarf zu laden |
defer_loading |
Ein Feld, das alle drei Anbieter verwenden und das kennzeichnet, dass die vollständige Werkzeugdefinition erst verzögert geladen wird |
| Regex | Gleicht Hinweise auf Werkzeugnamen, Beschreibungen oder Parameter mit regulären Ausdrücken ab |
| BM25 | Klassischer Algorithmus, der Suchergebnisse nach der Relevanz der Suchbegriffe im Verhältnis zum Text sortiert |
tool_reference |
Ein Inhaltsblock, mit dem Claude ein bereits deklariertes Werkzeug referenziert; anschließend erweitert die API ihn zur vollständigen Definition |
namespace |
Eine Deklaration in der OpenAI Responses API, die verwandte Funktionen nach Geschäftsfähigkeiten gruppiert |
| Dynamische Werkzeuginjektion | Die Anwendung übergibt dem Modell Werkzeugdefinitionen, die im ursprünglichen Request nicht deklariert waren, zur weiteren Verwendung |
tool_search_output |
Ein Antwortelement, das der OpenAI-Client bei der Suche zurückgibt und das die passenden Werkzeugdeklarationen enthält |
| Remote-MCP | Ein entfernter Dienst, der über das Model Context Protocol auffindbare und ausführbare Werkzeuge bereitstellt |
| Cache-Präfix | Der zwischen mehreren Modellaufrufen gleichbleibende Anfangsteil der Eingabe, der sich für die Wiederverwendung aus dem Cache eignet |
Tool Search: Auswirkungen im Überblick
- Agent-Entwickler: Bei vielen Werkzeugen muss man nicht mehr alle Schemata auf einmal in den Kontext packen, aber Request-Bodies und Rückgabeereignisse unterscheiden sich bei den drei Anbietern – ein Agent, der mehrere Modelle abdeckt, muss die Auswertung jeweils separat implementieren.
- Unternehmensplattformen und Betreuer von Werkzeugkatalogen: Werkzeugbenennung, Kurzbeschreibung und Gruppierung wirken sich nun direkt auf die Suchqualität aus. Der Werkzeugkatalog selbst wird zu einem Asset, das gestaltet werden muss.
- Verantwortliche für Kosten und Betrieb: Tool Search spart nicht unbedingt Geld. Googles offizielles Rechenbeispiel zeigt sowohl Fälle mit weniger als auch mit mehr Tokens – ob es sich lohnt, entscheidet die tatsächliche Abrechnung im Test.
Objektive Fakten: Veröffentlichungschronik und Mechanismen von Tool Search bei drei Anbietern
Warum Gemini, Claude und GPT alle Tool Search anbieten
Wenn ein Agent gleichzeitig CRM-, Bestell-, Lager-, Logistik- und Ticketsysteme sowie mehrere MCP-Server anbindet, beanspruchen allein die Tool-Deklarationen einen großen Teil des Kontextfensters. Die Google-Dokumentation merkt an, dass schon ein paar Dutzend Funktionsdeklarationen mehrere Zehntausend Token belegen können. Anthropic führt ein Beispiel an: Fünf MCP-Server – GitHub, Slack, Sentry, Grafana und Splunk – kommen zusammen auf 58 Tools; allein die Tool-Definitionen machen etwa 55,000 Token aus.
Die zeitliche Abfolge der Veröffentlichungen bei den drei Anbietern sieht so aus: Anthropic führte am 24. November 2025 das Tool Search Tool ein; OpenAI brachte am 5. März 2026 zusammen mit GPT-5.4 die API Tool Search heraus; Google stellte am 19. November 2026 die Tool Retrieval der Gemini API als Vorschauversion vor. Der Grundgedanke ist bei allen drei gleich: Das Modell weiß zunächst, welche Fähigkeiten verfügbar sind, und liest die vollständigen Parameterdefinitionen erst dann, wenn es sie tatsächlich braucht.
Alle drei haben eigene Leistungsdaten veröffentlicht, doch die Testbedingungen unterscheiden sich völlig; für ein Ranking taugen sie nicht. Im Beispiel von Anthropic sank der anfängliche Kontext von etwa 77,000 Token auf etwa 8,700 Token; in einer internen MCP-Evaluierung stieg die Trefferquote bei der Tool-Auswahl von Claude Opus 4 von 49% auf 74%. OpenAI maß auf MCP Atlas mit 250 Aufgaben und 36 MCP-Servern eine Reduktion der Gesamt-Token um 47%, bei unveränderter Genauigkeit. Google nennt bislang nur hypothetische Rechenbeispiele: Bei 200 Tools ergibt sich eine Reduktion von etwa 85.6%, bei 10 Tools mit langem Kontext dagegen ein Anstieg von etwa 36.5%.
Gemini Tool Search: Zwei Abrufmodi – serverseitig und clientseitig
Geminis Tool Retrieval basiert auf der Interactions API und erfordert v1beta; das ältere generateContent wird nicht unterstützt. Der serverseitige Modus lässt sich aktivieren, indem man {"type": "tool_search"} in tools aufnimmt und für selten genutzte function oder mcp_server defer_loading: true setzt. Das Modell sieht zunächst nur den Namen und die short_description der verzögert geladenen Tools. Erste Tests von Google zeigten, dass jeder Tool-Eintrag im Durchschnitt etwa 26 Tokens kostet. Ist keine kurze Beschreibung hinterlegt, wird stattdessen der erste Satz der vollständigen description verwendet.
Ein Punkt sorgt leicht für Missverständnisse: Im serverseitigen Modus müssen Entwickler weiterhin die vollständigen Tool-Definitionen übermitteln. Selbst bei Verwendung von previous_interaction_id muss das komplette tools-Array bei jeder Anfrage erneut gesendet werden. Das verzögerte Laden verhindert lediglich, dass das vollständige Schema vorzeitig in den Modellkontext gelangt. Außerdem lassen sich bereits geladene Schemas während der aktuellen Sitzung nicht mehr entladen; pro Anfrage darf höchstens ein tool_search deklariert werden; serverseitiger und clientseitiger Abruf dürfen nicht in derselben Anfrage gemischt werden.
| Dimension | Serverseitiger Abruf | Clientseitiger Abruf |
|---|---|---|
execution |
server (Standard) |
client |
| Retriever | Wird von der Gemini API übernommen | Vom Entwickler selbst gebaut |
| Tool-Bibliothek muss im Voraus deklariert werden | Erforderlich | Nicht erforderlich |
defer_loading |
Anwendbar | Nicht anwendbar |
| Zusätzliche Roundtrips | Keine zusätzlichen Client-Roundtrips | Ein zusätzlicher Roundtrip pro Suche |
| Typische Szenarien | Große, relativ feste Tool-Sammlungen | Private Tool Registry, Multi-Tenant, dynamische Tools |
Im clientseitigen Modus ruft das Modell die vom Entwickler definierte Suchfunktion auf (z. B. search_tool_registry), und die Anwendung gibt in function_result.result die vollständigen Tool-Deklarationsobjekte der Treffer zurück. Auf diese Weise lassen sich im Verlauf des Dialogs Tools einbringen, die in der ursprünglichen Anfrage nicht deklariert wurden – etwa wenn ein Nutzer während der Sitzung vorübergehend einen neuen SaaS-Dienst anbindet.
Claude Tool Search: Regex, BM25 und tool_reference
Claudes Tool Search Tool gehört zur Messages API. Serverseitig stehen zwei Typen von Suchwerkzeugen bereit: tool_search_tool_regex_20251119 – hier erzeugt das Modell reguläre Ausdrücke, ideal für Toolbibliotheken mit starken Namensmustern – und tool_search_tool_bm25_20251119, bei dem das Modell natürlichsprachliche Abfragen generiert, was sich gut eignet, um Tools anhand ihrer Fähigkeitsbeschreibungen zu entdecken. Beide Varianten durchsuchen Toolnamen, Beschreibungen, Parameternamen und Parameterbeschreibungen. Bei Claude heißt das Parameterfeld input_schema – anders als parameters bei den beiden anderen Anbietern.
Der Ereignisablauf einer typischen Suche sieht so aus: Claude startet zunächst einen server_tool_use-Aufruf des integrierten Suchwerkzeugs, die API gibt ein tool_search_tool_result zurück, das Ergebnis enthält ein tool_reference. Dieses wird anschließend von der API zur vollständigen Definition entfaltet, und schließlich erzeugt das Modell einen tool_use auf Geschäftsebene. Anthropic weist ausdrücklich darauf hin, dass die Kennung srvtoolu_... des integrierten Suchwerkzeugs kein tool_result vom Entwickler erfordert; die Anwendung muss lediglich den eigentlichen geschäftlichen tool_use ausführen.
| Claude Tool Search Regel | Offizielle Vorgabe |
|---|---|
| Maximale Anzahl verzögert geladener Tools pro Anfrage | 10.000 |
| Standardmäßig zurückgegebene Treffer pro Suche | Bis zu 5, anpassbar über limit |
| Länge der Regex-Abfrage | Maximal 200 Zeichen |
| Länge der BM25-Abfrage | Maximal 500 Zeichen |
| Nicht unterstützte Modelle | Claude Opus 4.1 und frühere Modelle |
| Cache-Einschränkung | Tools mit defer_loading: true dürfen kein cache_control setzen |
Entwickler können die Suche auch mit eigenen Algorithmen wie Embeddings implementieren, doch zurückgegeben wird trotzdem ein tool_reference – und das referenzierte Tool muss bereits in der obersten Ebene tools deklariert sein. Claudes Design ähnelt daher eher dem Muster „aus einer im Voraus deklarierten Toolbibliothek die benötigten Tools herauszusuchen“. Bei MCP konfiguriert Claude die Verzögerungsstrategie über das mcp_toolset des MCP Connector. Sie lässt sich einheitlich in default_config oder pro Tool einzeln in configs festlegen.
GPT Tool Search: Namespace und dynamische Tool-Injektion
OpenAIs Tool Search ist Teil der Responses API, wird von GPT-5.4 und neueren kompatiblen Modellen unterstützt und ebenfalls über tool_search und defer_loading aktiviert. Das Besondere daran ist der namespace: Entwickler können zusammengehörige Funktionen nach Geschäftsdomänen wie crm oder billing gruppieren. Das Modell entscheidet dann anhand von Name und Beschreibung des Namespace, welche Art von Fähigkeit relevant ist, und klappt bei Bedarf die verzögerten Funktionen innerhalb der Gruppe auf. So wird die Gruppierung von Tools zu einer Struktur auf API-Ebene – und bleibt nicht bloß eine Namenskonvention.
Im Servermodus verläuft die Ereigniskette so: tool_search_call → tool_search_output → function_call → die Anwendung gibt function_call_output zurück. Im Clientmodus fragt die Anwendung nach Eingang von tool_search_call selbst den Tool-Katalog ab und gibt mit derselben call_id ein tool_search_output zurück, dessen Feld tools die vollständigen Deklarationen der passenden Tools enthält. Erst in der nächsten Runde ruft das Modell diese Funktionen auf. Die offizielle Dokumentation erlaubt es an dieser Stelle, Tools zurückzugeben, die in der ursprünglichen Anfrage nicht deklariert wurden, verlangt aber gleichzeitig, dass Entwickler dynamische Schemas strikt validieren und nur vertrauenswürdige Tool-Definitionen bereitstellen.
Beim Caching hängt OpenAI neu entdeckte Tool-Definitionen hinten an den Kontext an, um den Einfluss auf den bereits gecachten Prefix gering zu halten. Bei MCP ist Folgendes zu beachten: Tool Search in der Responses API unterstützt das bedarfsweise Auffinden von MCP-Tools, während die Agents API die Tool-Erkennung automatisch durch die Laufzeit einbindet, sofern Modell und Anbieter das unterstützen. Die offizielle Doku weist ausdrücklich darauf hin, dass sich die beiden Konfigurationen nicht direkt aufeinander übertragen lassen.
Hier ein illustrativer Request an die Responses API, der die Grundstruktur des verzögerten Ladens zeigt. Maßgeblich für die Felder ist die offizielle OpenAI-Dokumentation:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatibler Endpunkt von APIYI
)

tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "inventory_get_stock",
        "description": "Inventory: check stock level by SKU.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {"sku": {"type": "string"}},
            "required": ["sku"]
        }
    }
]

resp = client.responses.create(
    model="gpt-5.4",
    input="订单 A-1042 还没发货,帮我查一下 SKU-88 的库存。",
    tools=tools
)
for item in resp.output:
    print(item.type)  # erwartete Ereignisse: tool_search_call / function_call usw.
Beispielcode für clientseitige Suche und dynamische Injektion anzeigen
import requests

BASE_URL = "https://api.apiyi.com/v1"  # Responses-API-Anfragen laufen über APIYI
HEADERS = {"Authorization": "Bearer YOUR_API_KEY"}

def search_registry(query: str) -> list:
    """Durchsucht den unternehmensinternen Tool-Katalog und filtert nach Benutzerberechtigungen (illustrativ)"""
    return [{
        "type": "function",
        "name": "warehouse_schedule_shipment",
        "description": "Warehouse: schedule a new shipment date.",
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {"type": "string"},
                "date": {"type": "string"}
            },
            "required": ["order_id", "date"]
        }
    }]

def handle(output_items: list) -> list:
    follow_ups = []
    for item in output_items:
        if item["type"] == "tool_search_call":
            query = item.get("arguments", {}).get("query", "")
            follow_ups.append({
                "type": "tool_search_output",
                "call_id": item["call_id"],      # dieselbe call_id wie beim Suchaufruf
                "tools": search_registry(query)  # darf Tools enthalten, die in der ursprünglichen Anfrage nicht deklariert waren
            })
    return follow_ups
# Hinweis: Dynamisch zurückgegebene Schemas unbedingt vorher validieren und nur vertrauenswürdige Tools ausliefern
🚀 Schnellvalidierung empfohlen: Bevor du die echte Produktionsumgebung anbindest, kannst du mit dem einheitlichen Key von APIYI apiyi.com testweise GPT, Claude und Gemini aufrufen und dasselbe Tool-Verzeichnis bei allen drei Anbietern durchlaufen lassen. So kannst du prüfen, ob deine Parsing-Schicht die Ereignisstrukturen korrekt erkennt, und dich anschließend für die Hauptlösung entscheiden.
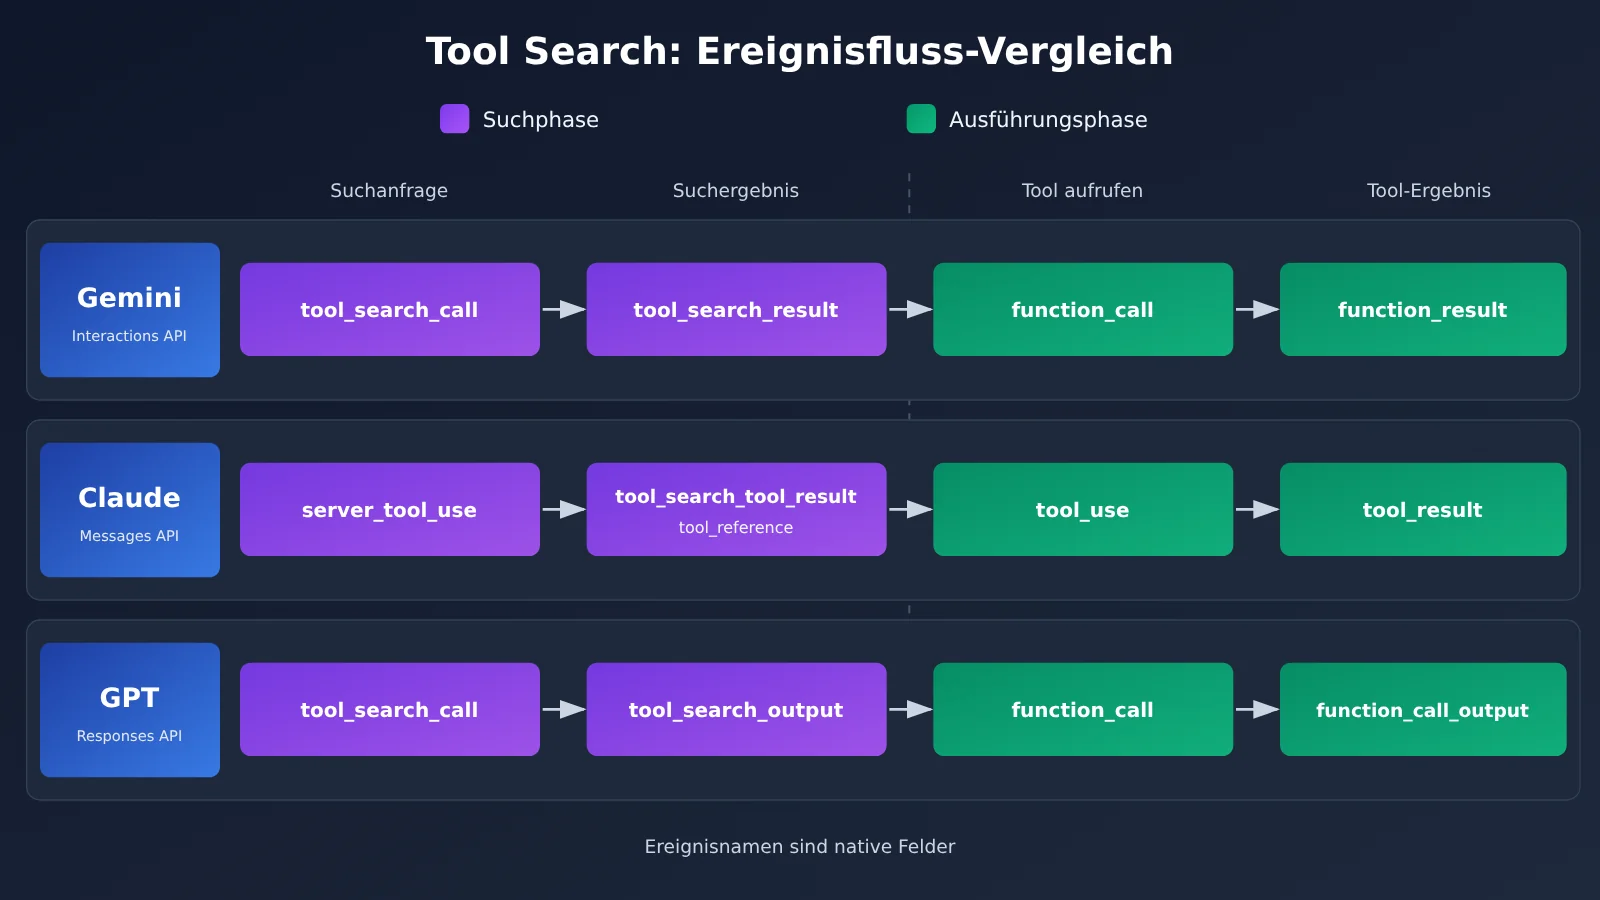
Die Ereignisnamen in der obigen Grafik sind jeweils die nativen Feldbezeichnungen der Anbieter. Wer den Ereignisfluss bei jedem Anbieter selbst testen möchte, kann über APIYI apiyi.com mit demselben Testskript zwischen den Modellen wechseln und die Ergebnisse vergleichen.
Zentrierter Vergleich der Tool-Search-Mechanismen der drei Anbieter
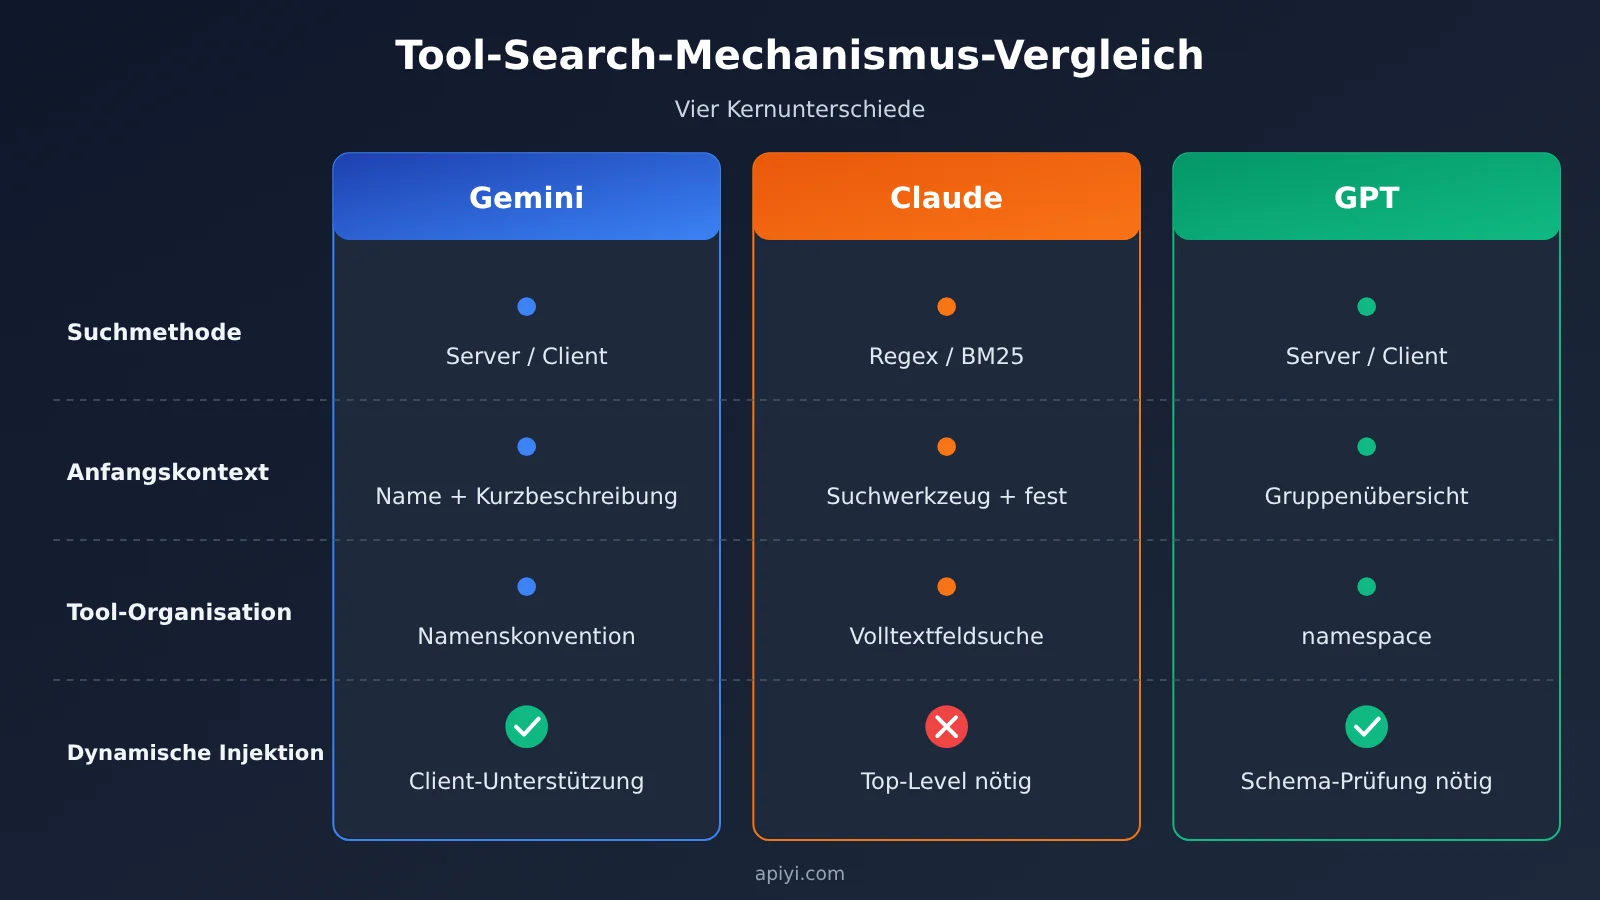
| Dimension | Gemini | Claude | GPT |
|---|---|---|---|
| Zugehörige API | Interactions API (v1beta) |
Messages API | Responses API |
| Retrieval-Methode | Serverseitig (Algorithmus nicht offengelegt) / clientseitig | Regex / BM25 / benutzerdefinierte Suche | Serverseitig / clientseitig |
| Erhalt des initialen Kontexts | Name + short_description |
Suchtool + nicht verzögerte Tools | Verzögerte Tools oder namespace-Zusammenfassung |
| Tool-Organisation | Namenskonvention + kurze Beschreibung | Name, Beschreibung und Parameter sind alle durchsuchbar | Gruppierung über namespace |
| Parameterfeld | parameters |
input_schema |
parameters |
| Clientseitiges Retrieval | Unterstützt | Benutzerdefinierte Suche liefert tool_reference |
Unterstützt (tool_search_output) |
| Dynamisches Hinzufügen neuer Tools | Im Client-Modus unterstützt | Referenzierte Tools müssen bereits auf oberster Ebene deklariert sein | Im Client-Modus unterstützt, Schema-Validierung erforderlich |
| MCP-Integration | mcp_server + defer_loading |
default_config / configs von mcp_toolset |
Unterschiedliche Regeln für Responses und Agents |
| Caching und Abrechnung | Keine separate Funktionsgebühr; auf total_tool_use_tokens achten |
Wird nicht separat berechnet; für verzögerte Tools kann kein cache_control gesetzt werden |
Neue Tools werden hinten angehängt, um den Cache-Präfix zu schützen |
💡 Auswahlempfehlung: Die obige Tabelle vergleicht nur überprüfbare Schnittstellenregeln. Die tatsächliche Wirkung hängt von deiner Tool-Bibliothek und der Gesprächslänge ab. Es empfiehlt sich, über den einheitlichen Multi-Modell-Zugang von APIYI apiyi.com kleine A/B-Tests mit einer Stichprobe durchzuführen und die Kosten anschließend anhand der Abrechnungsfelder der jeweiligen Anbieter zu kalkulieren.
Analyse und Einschätzung: Eignungsbedingungen für die Tool-Search-Auswahl
Drei technische Routen am Beispiel eines Bestell- und Bestands-Agenten
Stellen Sie sich folgende Geschäftsanforderung vor: Ein Nutzer fragt den Bestellstatus ab, stellt fest, dass die Ware noch nicht versandt wurde, fragt anschließend den Bestand ab und entscheidet dann, ob ein neues Versanddatum angesetzt werden kann. Im System gibt es neun Tool-Kategorien – CRM, Bestellungen, Bestand, Lagerdisposition, Logistik, Rückerstattungen, Abrechnung, Benachrichtigungen und Genehmigungen –, jede mit mehreren Funktionen.
- Gemini-Route: Häufig verwendete Bestellabfragen werden direkt geladen; Long-Tail-Tools wie Bestand und Lagerdisposition werden auf verzögertes Laden gesetzt, und
short_descriptionwird sauber gepflegt. Die serverseitige Suche wählt dann das Schema vonget_inventoryaus. Werden Lagerdispositions-Tools je nach Mandant dynamisch freigeschaltet, wechselt man auf die clientseitige Suche und gibt die Ergebnisse aus einer privaten Registry zurück. - Claude-Route: Folgen die Tool-Namen einem klaren Muster (z. B.
inventory_*,warehouse_*), kommt Regex präzise zum Zug. Formuliert der Nutzer eher umgangssprachlich wie „Können wir noch nachbestellen?“, ist BM25 besser geeignet. Am Ende wirdtool_referencezu einem aufrufbarentool_useexpandiert. - GPT-Route: Für
crm,inventoryundlogisticswerdennamespace-Bereiche angelegt. Das Modell erkennt zunächst, dass die beiden Domänen Bestand und Logistik betroffen sind, und klappt dann die Funktionen innerhalb der Gruppe auf. Ein temporär angebundener neuer Logistikdienstleister kann über das clientseitigetool_search_outputinjiziert werden.
Dieses Szenario dient nur der Veranschaulichung der Mechanismen und sagt nichts über die tatsächlich gemessenen Erfolgsquoten oder Latenzen der drei Anbieter aus.
Vier Auswahlprinzipien für Entwickler
- Große, feste Tool-Bibliothek: Achten Sie zuerst auf die serverseitigen Suchfunktionen. Alle drei Anbieter decken das ab, aber beachten Sie: Gemini sendet bei jeder Anfrage das vollständige Tool-Array erneut; bei Claude liegt das Limit für Deferred Tools pro Anfrage bei 10.000.
- Explizite Kontrolle der Suchstrategie erforderlich: Claudes offengelegte Regex- und BM25-Ansätze sind die einzigen Lösungen, bei denen der Algorithmus klar dokumentiert ist. Sie eignen sich für Teams, die nach Namensregeln präzise Treffer erzielen wollen. Die serverseitigen Algorithmen von Gemini und GPT sind nicht offengelegt; man sollte nicht annehmen, dass sie mit denen von Claude identisch sind.
- Tool-Bibliothek ändert sich häufig oder muss nach Benutzerberechtigungen gefiltert werden: Achten Sie besonders auf die dynamische clientseitige Injektion. Die Client-Modi von Gemini und GPT können neue Tools einbringen; Claudes benutzerdefinierte Suche kann nur auf bereits deklarierte Tools verweisen, daher muss die Kandidatenmenge vor dem Senden der Anfrage zusammengestellt werden.
- Kleiner Tool-Umfang: Googles Rechenbeispiel zeigt, dass bei 10 Tools und einem langen Kontext von 30.000 Tokens der Token-Verbrauch tatsächlich um etwa 36,5 % steigt. Google empfiehlt, bei weniger als etwa 20 stabilen Tools weiterhin statisch zu laden. Das ist auch für die beiden anderen Anbieter relevant, doch jeder muss es selbst testen.
Protokolladaption bei modellübergreifenden Gateways
Der Fehler, in den Teams, die modellübergreifende Agents bauen, am häufigsten stolpern, ist die Gleichsetzung von „dieses Modell lässt sich aufrufen“ mit „die Tool Search dieses Modells funktioniert“. Man kann die Fähigkeiten in vier Ebenen aufteilen: Modellzugriff, Protokoll-Endpunkte (Interactions / Messages / Responses), Tool-Deklarationsfelder (tool_search, defer_loading, namespace, MCP-Konfiguration) sowie Ausführung und Statusverwaltung (Retrieval-Events, Funktionsergebnisse, signature, Sitzungsverlauf). Eine erfolgreiche Modellanbindung belegt nur, dass die erste Ebene in Ordnung ist.
Besonders beachten sollte man eine Regel von Gemini: In zustandslosen Sitzungen mit store=false dürfen tool_search_call, tool_search_result und deren signature weder verändert noch gelöscht werden, sonst wird HTTP 400 zurückgegeben. Das bedeutet, ein Gateway darf Verlaufsnachrichten nicht nach Belieben komprimieren oder umschreiben. Um die drei Anbieter auf eine einheitliche Tool-Search-Schnittstelle zu abstrahieren, muss man auf Ebene des Agent-Frameworks eine Event-Mapping-Tabelle pflegen; man kann nicht erwarten, dass derselbe Request-Body allein durch eine geänderte Base-URL universell funktioniert.
🎯 Technische Empfehlung: Wenn Sie über Aggregationsplattformen wie APIYI apiyi.com mehrere Modelle anbinden, sollten Sie zunächst mit geringem Traffic prüfen, ob der Zielendpunkt und Felder wie
tool_search,defer_loading,namespacevollständig durchgereicht werden, und erst dann Tool Search in die Produktionskette aufnehmen.
Variablen, die es weiterhin zu beobachten gilt
Gemini Tool Retrieval ist noch eine Preview-Version, und bis zur offiziellen Veröffentlichung kann sich die Schnittstelle noch ändern. Wie hoch die durchschnittliche Einsparung, die Latenz und die Trefferquote in echten Produktionsumgebungen tatsächlich ausfallen, dazu gibt es Stand 20. November 2026 noch keine unabhängig überprüfbaren Tests. Eine Richtung lässt sich jedoch absehen: Alle drei Anbieter verlagern die „Governance des Tool-Katalogs“ an die Entwickler – Benennung, kurze Beschreibungen, Gruppierung und Berechtigungen werden zunehmend zu einer Index-Engineering-Aufgabe, ähnlich wie bei einem Retrieval-System. Vor dem Rollout empfiehlt es sich, ein Kontrollexperiment mit den Kennzahlen initiale Input-Token, Tool-Nutzungs-Token, Rate der korrekten Tool-Auswahl, Rate erfolgloser Suchen ohne Treffer und durchschnittliche Suchanzahl aufzusetzen und in einer Multi-Modell-Umgebung wie APIYI apiyi.com auf demselben Aufgabensatz quer zu validieren, damit man sich nicht von den Werbezahlen eines einzelnen Anbieters in die Irre führen lässt.
Mehr Tools bedeuten nicht automatisch einen klügeren Agenten; ob er bei Bedarf das passende Tool präzise findet, bestimmt die Obergrenze dessen, was ein Agent leisten kann. Wie es im „Lunyu · Weiling Gong“ heißt: „Will man seine Arbeit gut verrichten, muss man zuerst sein Werkzeug schärfen.“
Referenzen
- Google Tool Retrieval – technische Dokumentation: serverseitige und clientseitige Suche, Limits, Abrechnung und Rechenbeispiele
- Link:
aistudio.google.com/docs/tool-retrieval
- Link:
- Offizielle Google-Ankündigung: Introducing Tool Retrieval in the Gemini API
- Link:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval
- Link:
- Anthropic Tool Search Tool – Dokumentation: Regex, BM25, tool_reference und Limits
- Link:
platform.claude.com/docs/en/agents-and-tools/tool-use/tool-search-tool
- Link:
- Anthropic Advanced Tool Use – Ankündigung: Tool Search Release und interne Evaluierung
- Link:
anthropic.com/research/advanced-tool-use
- Link:
- OpenAI Tool Search – Dokumentation: namespace, clientseitige Suche und dynamische Injektion
- Link:
developers.openai.com/api/docs/guides/tools-tool-search
- Link:
- OpenAI GPT-5.4 – Ankündigung: Tool Search Release und MCP-Atlas-Tests
- Link:
openai.com/index/introducing-gpt-5-4
- Link:
Autor: APIYI-Team
Technischer Austausch: Wenn Sie die Anpassung von Tool-Aufrufen für Multi-Modell-Agenten weiter diskutieren möchten, besuchen Sie APIYI apiyi.com und kontaktieren Sie uns. Weitere Integrationsunterlagen finden Sie im Dokumentationszentrum docs.apiyi.com.