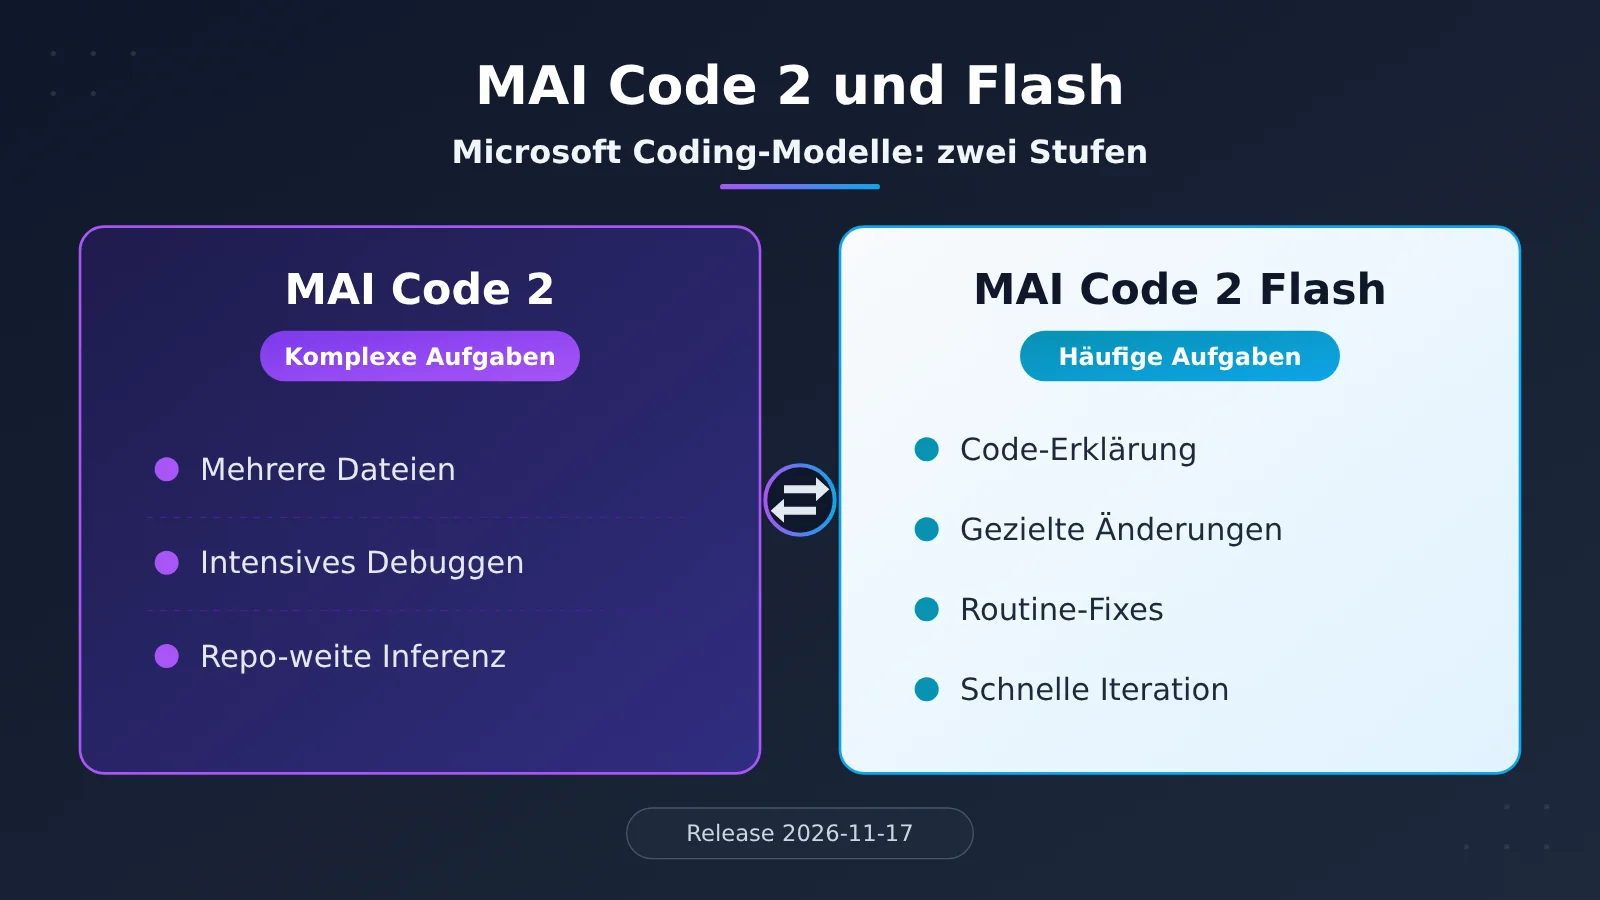
Kurzantwort: Microsoft teilt die MAI Code 2-Serie in eine „Stufe für komplexe Aufgaben“ und eine „Stufe für häufige, einfache Aufgaben“ auf. Am 17. November 2026 veröffentlichte Microsoft MAI Code 2 und MAI Code 2 Flash. MAI Code 2 richtet sich an Änderungen über mehrere Dateien hinweg, tiefgehendes Debugging und repositoryweites Reasoning; MAI Code 2 Flash an Codeerklärungen, gezielte Änderungen, routinemäßige Fehlerbehebungen und hochfrequente Iterationen. Für die meisten Entwickler und kleinen Teams lautet unsere Empfehlung: standardmäßig zuerst Flash für alltägliche kleine Aufgaben einsetzen und erst dann auf Code 2 wechseln, wenn dateiübergreifende Abhängigkeiten oder schwer eingrenzbare Bugs auftreten.
Das erfahren Sie in diesem Artikel:
- Wie die beiden Modellstufen offiziell positioniert sind und welche Art von Programmieraufgaben jeweils zu ihnen passt.
- Welche Ein-/Ausgabemodalitäten und Kontextspezifikationen in der Model Card offengelegt sind und wie diese Zahlen einzuordnen sind.
- Über welche Zugänge die Modelle derzeit nutzbar sind, welche Kanäle lediglich „demnächst verfügbar“ sind und wann der Copilot-Aktionspreis ausläuft.
- Eine praktische Entscheidungsmethode: mit Flash beginnen und anhand von Signalen auf Code 2 hochstufen.
Index: Werfen Sie zuerst einen Blick auf die To-Know-Konzepttabelle und die Kurzübersicht zu den Auswirkungen, um schnell die für Sie relevanten Teile zu erfassen. Der erste Teil, „Objektive Fakten“, ist in Veröffentlichungsinformationen, die Positionierung der beiden Stufen, Model-Card-Spezifikationen, verfügbare Zugänge sowie die Art der Evaluierung und die Aktionspreise gegliedert; hier stehen ausschließlich belegte Inhalte. Teil zwei, „Analyse und Einschätzung“, enthält die redaktionelle Meinung: die Bedeutung der Stufung, Empfehlungen zur Auswahl, die tatsächlichen Grenzen des langen Kontexts und Punkte, die vor der API-Anbindung geprüft werden sollten.
MAI Code 2 und Flash: Begriffe, die man vorab kennen sollte (To Know)
| Begriff | Kurze Erklärung |
|---|---|
| Repository-weites Reasoning | Das Modell muss die Struktur des gesamten Code-Repositorys und dateiübergreifende Abhängigkeiten verstehen, nicht nur die aktuelle Datei oder einen Ausschnitt |
| Gezielte Änderungen | Kleine Änderungen an einer bekannten Stelle, zum Beispiel eine Funktion anpassen oder einen Fehler an einer Stelle beheben |
| Kontextfenster | Maximale Tokenmenge, die das Modell in einem Durchgang verarbeiten kann, einschließlich Eingabe und Ausgabe |
| Model Card | Vom Anbieter veröffentlichtes Dokument zum Modell, das Fähigkeiten, Spezifikationen, Bewertungen und Einschränkungen beschreibt |
| Microsoft Foundry | Microsofts Plattform für Unternehmen zum Erstellen von KI-Modellen und -Anwendungen, früher Azure AI Foundry |
| Limited-Access-Preview | Vorschau mit eingeschränktem Zugriff: Eine Nutzung erfordert eine Bewerbung oder das Erfüllen bestimmter Voraussetzungen; sie ist nicht allgemein verfügbar |
| Herstellereigene Benchmarks | Vom Modellanbieter selbst veröffentlichte Testergebnisse; sie sind nicht dasselbe wie unabhängige Tests durch Dritte oder Nutzer |
Auswirkungen der Veröffentlichung von MAI Code 2 und Flash auf einen Blick
| Zielgruppe | Wichtigste Auswirkungen |
|---|---|
| GitHub Copilot-Nutzer | Beide Modelle sind in Copilot verfügbar, aber in unterschiedlichen Tarifen; prüfen Sie Tarif, Organisationsrichtlinien und aktuelle Kontingente |
| Einzelentwickler und kleine Teams | Es gibt eine weitere Option, Modelle nach Aufgabenschwierigkeit auszuwählen; alltägliche kleine Änderungen müssen nicht immer an ein schweres Modell gehen |
| Unternehmenskunden von Azure / Foundry | Flash befindet sich in einer Limited-Access-Preview und muss beantragt werden; der offizielle Starttermin ist den offiziellen Angaben zu entnehmen |
| Entwickler, die über Drittanbieterplattformen zugreifen | OpenRouter, Vercel und andere Kanäle sind in der Ankündigung als „demnächst verfügbar“ gekennzeichnet; derzeit kann nicht davon ausgegangen werden, dass sie bereits nutzbar sind |
1. Objektive Fakten: Was MAI Code 2 und Flash veröffentlicht haben
1.1 Veröffentlichungsdatum von MAI Code 2 und Informationsquellen
Microsoft hat am 17. November 2026 über die offizielle News-Seite von microsoft.ai MAI Code 2 und MAI Code 2 Flash veröffentlicht. Im selben Zeitraum erläuterte Microsoft im Tech-Community-Blog von Azure AI Foundry, wie die Modelle auf der Foundry-Seite bereitgestellt werden, und veröffentlichte ein gemeinsames Modellkarten-PDF für beide Modelle. Dieser Artikel gleicht zusätzlich das offizielle GitHub-Changelog und die Abrechnungsdokumentation ab, Stichtag ist der 18. November 2026.
1.2 Die zwei Ausrichtungen von MAI Code 2 und Flash
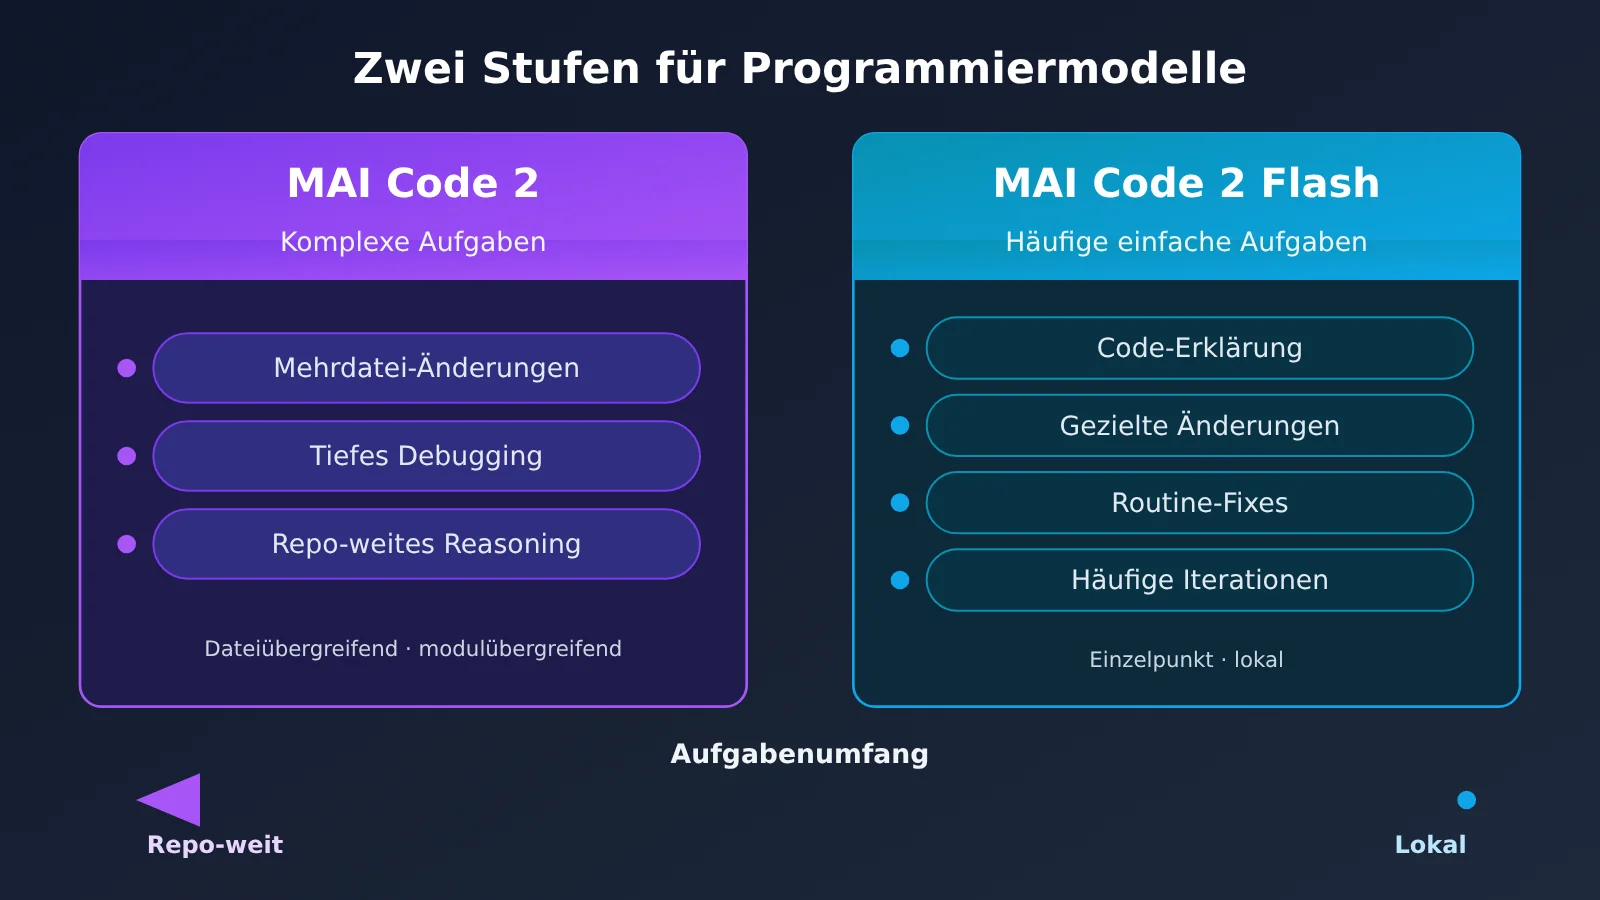
Die offizielle Beschreibung der Aufgabenteilung zwischen den beiden Modellen ist eindeutig: Das eine übernimmt komplexe Aufgaben, die ein ganzheitliches Verständnis erfordern, das andere übernimmt häufige Aufgaben mit kleinem Umfang.
| Dimension | MAI Code 2 | MAI Code 2 Flash |
|---|---|---|
| Offizielle Positionierung | Komplexe Programmieraufgaben | Häufige, routinemäßige Programmieraufgaben |
| Typische Aufgaben | Änderungen über mehrere Dateien, tiefgehendes Debugging, Reasoning auf Repository-Ebene | Code-Erklärung, punktuelle Änderungen, routinemäßige Fehlerbehebungen, hochfrequente Iterationen |
| Aufgabenumfang | Dateiübergreifend, modulübergreifend | Einzelpunkt, lokal begrenzt |
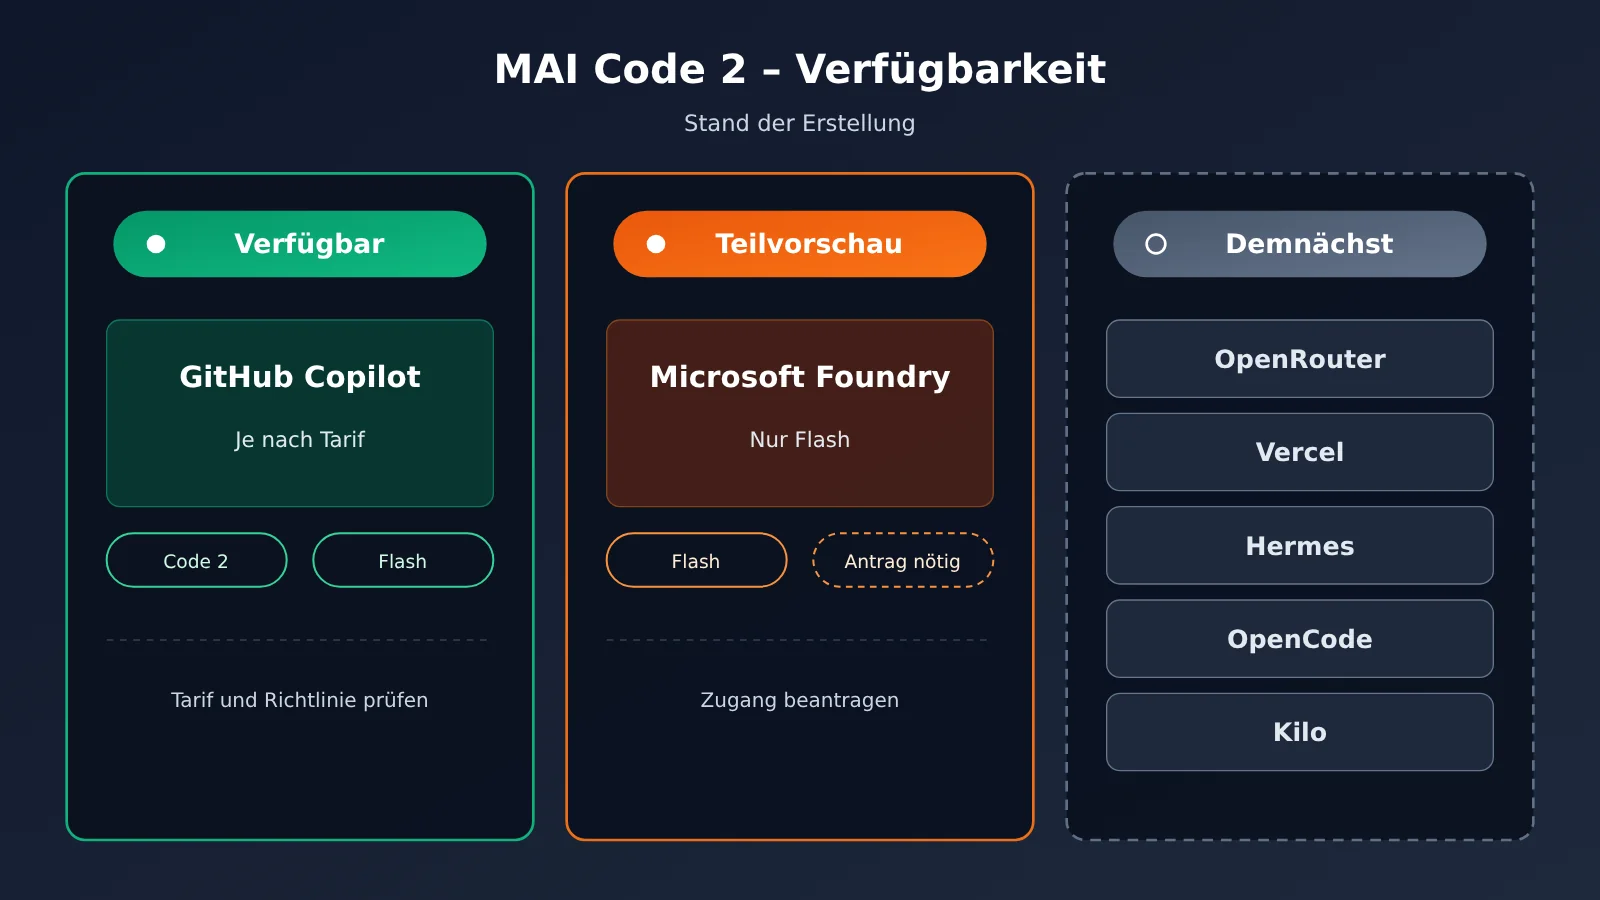
| GitHub Copilot | Bereits verfügbar | Bereits verfügbar |
| Foundry | In den Referenzmaterialien nicht angegeben | Eingeschränkter Zugriff als Preview |
1.3 Öffentlich zugängliche Spezifikationen aus der Modellkarte von MAI Code 2
Die Modellkarte enthält Zahlen zu Modalitäten und Kontext. Wichtig ist, dass die Modellkarte auch darauf hinweist, dass die tatsächlichen Beschränkungen im Produkt von diesen Zahlen abweichen können.
| Punkt | Daten aus der Modellkarte |
|---|---|
| Eingabemodalität | Text, Bilder |
| Ausgabemodalität | Text |
| Modellkontext | 1,05 Mio. Tokens |
| Maximale Eingabe | 922k Tokens |
| Maximale Ausgabe | 128k Tokens |
Zur Gesamtzahl der Parameter gibt es in den verfügbaren Materialien unterschiedliche Versionsangaben. Dieser Artikel nennt daher keine konkreten Zahlen; maßgeblich sind künftige offizielle Aktualisierungen.
1.4 Verfügbare Zugänge für MAI Code 2 und Flash
Im offiziellen GitHub-Changelog steht: Code 2 richtet sich an Copilot Pro, Pro+, Max, Business und Enterprise; Flash ist zusätzlich für Free und Student verfügbar. Auch berechtigte Jahresabonnements können die Modelle nutzen. Unternehmen oder Organisationsadministratoren können den Zugriff über Modellrichtlinien steuern. Man darf „bereits live“ daher nicht so verstehen, dass jedes Konto ohne Bedingungen Zugriff hat. Auf der Foundry-Seite bestätigt die Release-Ankündigung lediglich, dass Code 2 Flash eine Vorschau mit eingeschränktem Zugriff (limited-access preview) ist; eine vollständige Freigabe von Code 2 in Foundry wird nicht verkündet.
Die Release-Ankündigung nennt außerdem Kanäle wie OpenRouter, Vercel, Hermes, OpenCode und Kilo, allerdings mit dem Status „soon“ (demnächst). Mit anderen Worten: Zum Zeitpunkt dieses Artikels kann man diese Kanäle nicht als bereits umfassend verfügbar betrachten.
1.5 Zur Art der Evaluierungsdaten von MAI Code 2
Dieser Artikel stützt sich nicht auf unabhängige eigene Messungen. Die von Microsoft zusammengefassten Vergleiche mischen interne Evaluierungen mit externen Daten: DeepSWE 1.1, TerminalBench 2.1 und SWE Atlas liefen auf Microsoft MSBench über die Copilot CLI und ohne Subagenten; die Werte und Kosten für FrontierCode 1.1 stammen von Artificial Analysis. Die betreffenden Modelle wurden jeweils auf die maximale Reasoning-Stufe (max) eingestellt; bei den MAI-Kosten wurde der 50-%-Aktionspreis zugrunde gelegt. Ergebnisse, die unter diesen spezifischen Aufgaben-, Konfigurations- und Preisbedingungen erzielt wurden, sind keine allgemeingültige Aussage für alle Codebasen. Microsoft stellt zudem ausdrücklich klar, dass die beiden Modelle nicht für Grundlagenforschung und agentische Aufgaben mit sehr langen Abläufen optimiert sind.
1.6 Copilot-Aktionspreis: Tarif und Gültigkeitsdatum gemeinsam prüfen
Die in der GitHub-Abrechnungsdokumentation aufgeführten aktuellen Aktionspreise sehen wie folgt aus, angegeben in US-Dollar pro Million Token; diese gelten als Copilot-Abrechnungsgrundlage und dürfen nicht direkt als Preisangabe für Foundry oder Drittanbieter-APIs verwendet werden.
| Modell | Eingabe | Zwischengespeicherte Eingabe | Ausgabe | Eingabe/Zwischengespeicherte Eingabe/Ausgabe ab 17. Mai 2027 |
|---|---|---|---|---|
| MAI Code 2 | $0.50 | $0.025 | $2.50 | $1.00/$0.05/$5.00 |
| MAI Code 2 Flash | $0.05 | $0.005 | $0.25 | $0.10/$0.01/$0.50 |
In der offiziellen Fußnote heißt es, dass die Aktion bis zum 17. Mai 2027 läuft und ab diesem Tag die Preise in der rechten Spalte gelten; maßgeblich sind danach die jeweils aktuellen Dokumente. Die tägliche Abrechnung wird in GitHub AI Credits umgerechnet; das im Tarif enthaltene Kontingent, das Budget für zusätzliche Nutzung sowie die alten Abrechnungsregelungen für Jahresabonnements müssen jeweils separat geprüft werden. Dies ist keine unbegrenzte kostenlose Nutzung, und das Kostenverhältnis während der Aktionsphase darf nicht als dauerhafter Rabatt dargestellt werden. Offizielle GitHub-Abrechnungsdokumentation
2. Analyse und Einschätzung: Was die zwei Stufen von MAI Code 2 und Flash für Entwickler bedeuten
Die folgende Einschätzung stammt von der Redaktion. Sie leitet sich aus den Fakten in Teil 1 ab und gibt nicht die offizielle Position von Microsoft wieder. Aussagen zur künftigen Entwicklung sind Prognosen.
2.1 Warum MAI Code 2 zwei Stufen hat
Beim Programmieren sind die meisten Anfragen tatsächlich recht „klein“: einen Codeabschnitt erklären, einen Parameter ändern, einen offensichtlichen Fehler beheben. Solche Aufgaben verlangen vom Modell kein besonders tiefes全局 Verständnis. Wichtiger sind eine schnelle Antwort und die Möglichkeit, das Modell häufig aufzurufen. Anders sieht es bei Aufgaben wie modulübergreifendem Refactoring oder der Suche nach tiefer liegenden Bugs aus: Sie fallen seltener an, sind aber pro Fall deutlich schwieriger und erfordern, dass das Modell die Gesamtstruktur des Repositorys versteht.
Die beiden Anforderungstypen auf zwei Modelle aufzuteilen, bedeutet für Nutzer: Sie zahlen entsprechend der Schwierigkeit ihrer Aufgabe. GitHub positioniert Flash offiziell als leichtgewichtiges, kostengünstiges Modell für den täglichen Entwicklungsalltag; die aktuelle Abrechnungsdokumentation nennt zudem unterschiedliche Token-Preise für die beiden Modelle (siehe 1.6). Ein Unterschied beim Stückpreis ist jedoch nicht gleichbedeutend mit einem Unterschied bei den Kosten pro Aufgabe. Antwortgeschwindigkeit, Token-Verbrauch und Anzahl der Nacharbeitsrunden sollte man daher weiterhin an den eigenen Aufgaben prüfen.
2.2 Bearbeitungsempfehlung: Mit Flash starten, bei Signalen auf MAI Code 2 upgraden
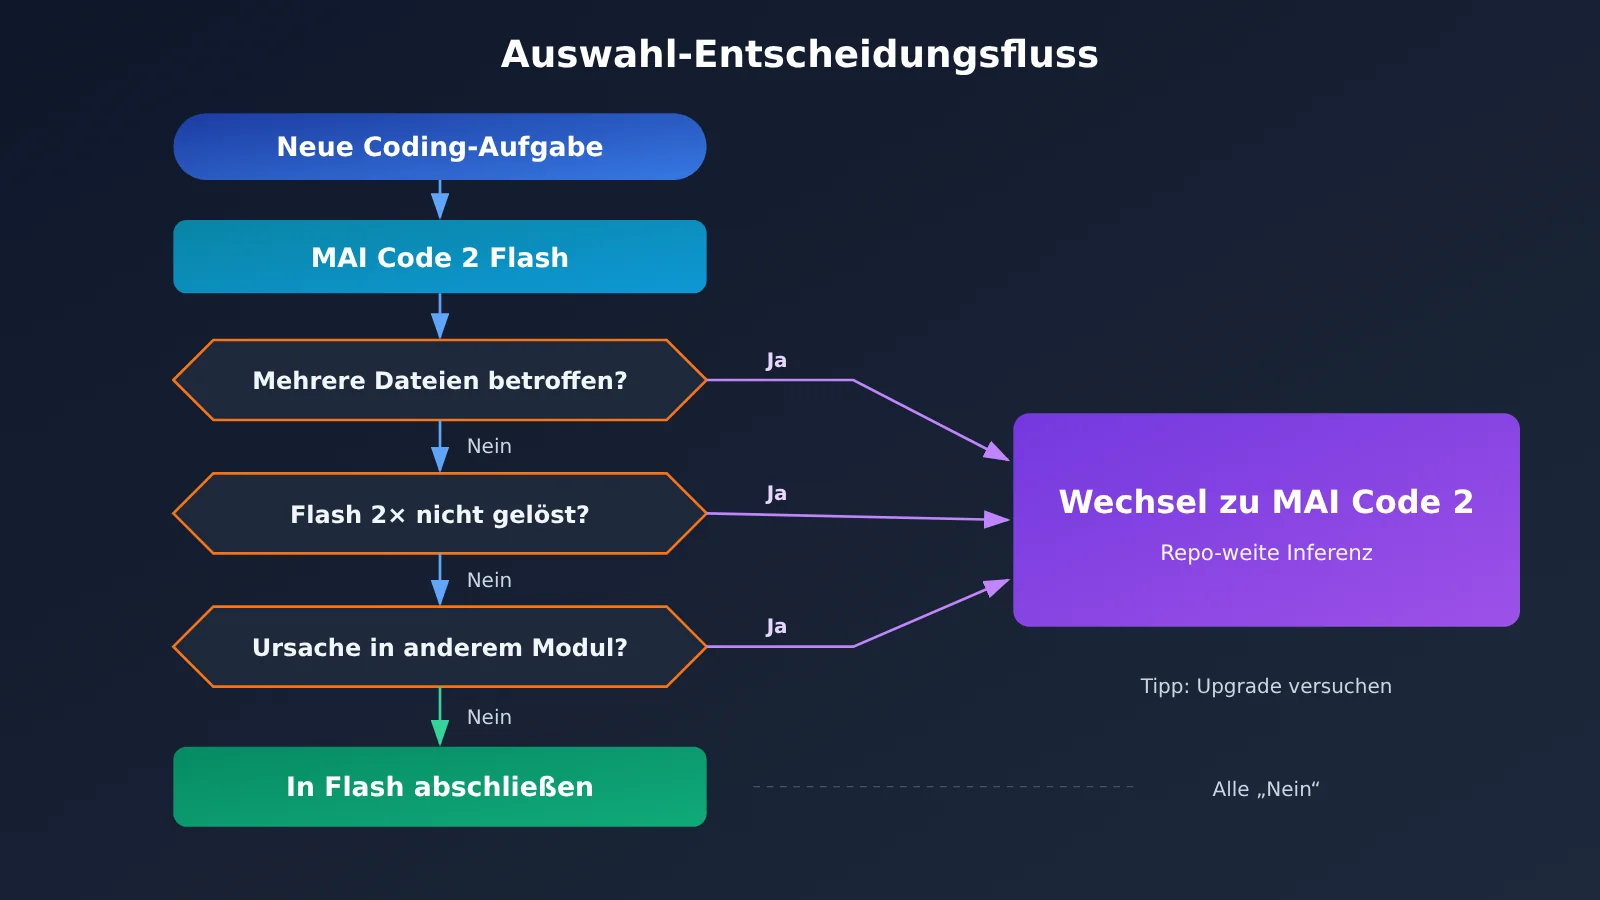
Für Entwickler und kleine Teams empfehlen wir, Flash als Standardstufe zu verwenden und nur bei klaren Signalen auf Code 2 umzusteigen. Dies ist eine noch zu verifizierende Routing-Strategie: Es ist nicht garantiert, dass Flash schneller ist oder dass Code 2 Probleme zwangsläufig behebt. Gleichzeitig sollten die Erfolgsquote der Aufgaben, die Zeit für die manuelle Überprüfung und die tatsächlichen Kosten erfasst werden.
Die folgenden Schwellenwerte sind lediglich Bearbeitungsempfehlungen und dienen als praktische Ausgangspunkte für erste Versuche – sie sind weder offizielle Grenzen noch bereits verifizierte optimale Regeln:
- Die Änderung betrifft mindestens 3 Dateien, oder Schnittstellendefinitionen und Aufrufer müssen synchron angepasst werden.
- Flash hat zweimal hintereinander einen Fix geliefert, der das Problem nicht gelöst hat – das deutet darauf hin, dass das Problem nicht lokal begrenzt ist.
- Die Grundursache des Bugs liegt in einem anderen Modul, zum Beispiel in der Konfiguration, in der Abhängigkeitsversion oder stromaufwärts der Datenflusskette.
- Die Gesamtarchitektur des Projekts muss verstanden werden, etwa um Modulbeziehungen zu ordnen oder einen Refactoring-Plan zu entwerfen.
- Du selbst kannst nicht genau sagen, wo das Problem liegt und brauchst das Modell für eine globale Fehlersuche.
Umgekehrt können bei Aufgaben wie Code-Erklärungen, dem Schreiben von Unit-Test-Beispielen, dem Umbenennen, dem Ergänzen von Kommentaren oder dem Beheben von Kompilierungsfehlern zunächst Flash ausprobiert und dann anhand der Testergebnisse und der manuellen Überprüfung entschieden werden, ob es beibehalten wird.
2.3 1,05 Mio. Kontext bedeutet nicht, dass man ihn im Tool voll ausschöpfen kann
Die Model Card gibt den Kontext mit 1,05 Mio. an, die maximale Eingabe mit 922k und die maximale Ausgabe mit 128k – weist aber gleichzeitig darauf hin, dass die tatsächlichen Grenzen im Produkt abweichen können. Unsere Einschätzung: In Produkten wie GitHub Copilot können die effektiv verfügbare Kontextlänge und das Ausgabelimit pro Anfrage durch die Produktstrategie beeinflusst werden.
Erwarten Sie also nicht, dass „das ganze Repository hineinpacken“ das Problem löst. Der verlässlichere Weg bleibt: Zuerst lässt man das Modell die relevanten Verzeichnisse und Schlüsseldateien sehen und erweitert dann den Umfang schrittweise. Genau darin liegt der Wert, den Code 2 mit seinem Fokus auf „Inferenz auf Repository-Ebene“ bietet: Es muss in einer großen Menge Code die entscheidenden Zusammenhänge finden können – nicht nur mehr Text aufnehmen können.
2.4 MAI Code 2 über die API aufrufen: erst prüfen, dann testen
Derzeit sind GitHub Copilot und Foundry (Flash in eingeschränkter Vorschau) die bestätigten Zugangswege für die MAI Code 2-Reihe; Drittanbieter-Aggregatoren sind noch nicht flächendeckend verfügbar. Wenn du eine API-Integration planst, besteht der erste Schritt nicht darin, Business-Code zu schreiben, sondern zu klären, ob die Zielplattform diese beiden Modelle wirklich anbietet und wie die Modell-IDs lauten.
Der folgende Code zeigt nur den Integrationsansatz. Er wurde für diesen Artikel nicht ausgeführt, und es wurde auch nicht geprüft, ob APIYI diese beiden Modelle bereits bereitstellt. Ein Name, der „mai“ enthält, ist lediglich ein Kandidat und ersetzt nicht die Prüfung des offiziellen Modellnamens, der Schnittstellenfunktionen und der Berechtigungen. Das Beispiel listet zuerst die Modelle auf und filtert dann die möglicherweise relevanten Einträge:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible Schnittstelle von APIYI; Modellverfügbarkeit laut aktueller Liste
)

# Aktuell verfügbare Modelle auflisten und Einträge filtern, die mit MAI Code 2 zusammenhängen könnten
models = client.models.list()
mai_models = [m.id for m in models.data if "mai" in m.id.lower()]
print(mai_models or "当前列表中未找到 MAI 相关模型")
Wenn in der Liste tatsächlich ein passendes Modell auftaucht, kannst du nach dem Ansatz aus Abschnitt 2.2 ein einfaches Routing nach Stufen schreiben. Die Modell-ID richtet sich nach der Plattformliste; unten stehen dafür Platzhalter:
Beispielcode für den gestuften Aufruf nach Aufgabenkomplexität ansehen
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # einheitliche Schnittstelle von APIYI verwenden
)

# Platzhalter: bitte durch die echte ID ersetzen, die in der Modellliste bestätigt wurde
FLASH_MODEL = "YOUR_FLASH_MODEL_ID"
CODE2_MODEL = "YOUR_CODE2_MODEL_ID"

def pick_model(files_touched: int, failed_attempts: int, cross_module: bool) -> str:
    """Wählt das Modell anhand der Signale aus Abschnitt 2.2: standardmäßig Flash, bei Erfüllung einer der Bedingungen Upgrade auf Code 2"""
    if files_touched >= 3 or failed_attempts >= 2 or cross_module:
        return CODE2_MODEL
    return FLASH_MODEL

def ask(prompt: str, files_touched=1, failed_attempts=0, cross_module=False) -> str:
    model = pick_model(files_touched, failed_attempts, cross_module)
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "你是资深工程师,先说明改动范围,再给出代码。"},
            {"role": "user", "content": prompt},
        ],
    )
    return f"[{model}]\n" + resp.choices[0].message.content

print(ask("解释这个函数的作用:def add(a, b): return a + b"))
🎯 Integrationshinweis: Die Drittanbieter-Kanäle für die MAI Code 2-Reihe gehen nach und nach online. Prüfe am besten zuerst in der Modellliste oder der Dokumentation von APIYI apiyi.com, was tatsächlich unterstützt wird und wie die Modell-IDs lauten, und entscheide dann über die Integration. Falls die Modelle noch nicht angeboten werden, kannst du mit demselben OpenAI-kompatiblen Code schon einmal das Stufen-Routing auf einem bereits unterstützten Programmiermodell aufbauen. Später musst du zusätzlich Schnittstellenparameter, Tool-Calling-Unterstützung, Kosten und Regressionstests prüfen – es ist nicht garantiert, dass der bloße Austausch der Modell-ID ausreicht.
2.5 Was sich bei MAI Code 2 noch ändern könnte
Die folgenden Einschätzungen sind Prognosen und müssen sich erst noch durch Fakten bestätigen lassen:
- Startzeitpunkt der Drittanbieter-Kanäle: Wann Kanäle wie OpenRouter oder Vercel, die derzeit mit „bald verfügbar“ gekennzeichnet sind, tatsächlich öffnen, entscheidet direkt darüber, wie hoch die Einstiegshürde für Nutzer ohne Copilot ist.
- Umfang des Foundry-Zugangs: Ob Flash von der eingeschränkten Vorschau in die allgemeine Verfügbarkeit übergeht und ob Code 2 in Foundry Einzug hält.
- Unabhängige Praxistests: Wie Community und Dritte auf echten Repositories abschneiden, sagt mehr über den tatsächlichen Unterschied der beiden Stufen aus als die Hersteller-Benchmarks.
- Reale Limits im Produkt: Die tatsächlichen Obergrenzen für Kontext und Ausgabe in Produkten wie Copilot bestimmen, wie weit „Repository-weites Reasoning“ in der Praxis reichen kann.
Wer verschiedene Programmiermodelle im selben Codebasis vergleichen möchte, ist mit einer Aggregationsplattform besser bedient. APIYI apiyi.com bietet eine einheitliche, OpenAI-kompatible Schnittstelle: Mit einem einzigen Key lassen sich OpenAI-, Claude-, Gemini- und weitere Modelle umschalten – ideal, um den Vergleichsprozess schon vor dem Launch neuer Modelle vorzubereiten.
Dass es nun zwei Stufen gibt, ist im Grunde das Eingeständnis einer einfachen Wahrheit: Kein Modell passt für alle Programmieraufgaben. Werkzeuge nach der Schwere der Aufgabe zuzuweisen ist die wirtschaftlichere Nutzung. Wie es in den „Chuci · Buju“ heißt:
„Die Elle hat ihre Schwächen, der Zoll seine Stärken.“
📚 Referenzen
- Offizielle GitHub-Ankündigung: Tarife und Administratorrichtlinien.
-
Offizielle GitHub-Preise und Aktions-Fußnoten: Preise, Aktionsende-Daten und Abrechnungsregeln.
-
Offizielle Microsoft-Ankündigung: Introducing MAI Code 2 and MAI Code 2 Flash: Ankündigung und Positionierung
- Link:
microsoft.ai/news/introducing-mai-code-2-and-mai-code-2-flash/ - Beschreibung: Aufgabenausrichtung der beiden Modelle, Verfügbarkeit in GitHub Copilot sowie die Information, dass Drittanbieter-Kanäle „demnächst verfügbar“ sind
- Link:
-
Azure AI Foundry Tech-Community-Blog: From model choice to your durable advantage
- Link:
techcommunity.microsoft.com/blog/azure-ai-foundry-blog/from-model-choice-to-your-durable-advantage-build-ai-that-keeps-improving/4573609 - Beschreibung: Bereitstellung über Foundry, Hinweise zum eingeschränkten Zugriff (Preview) von MAI Code 2 Flash
- Link:
-
Modellkarten zu MAI Code 2 und MAI Code 2 Flash (PDF): Modellspezifikationen und Evaluierungsdetails
- Link:
microsoft.ai/pdf/MAI-Code-2-And-MAI-Code-2-Flash-Model-Card.pdf - Beschreibung: Eingabe- und Ausgabemodalitäten, Kontextlänge, maximale Eingabe und Ausgabe sowie der Hinweis, dass Produktlimits abweichen können
- Link:
Autor: APIYI Technikteam
Technischer Austausch: Wenn Sie Fragen zur Modellintegration und zum Support haben, kontaktieren Sie uns gerne über die Startseite von APIYI apiyi.com. Weitere Integrationsdokumentationen finden Sie im Dokumentationszentrum docs.apiyi.com