2026 年 11 月 9 日,Google Cloud 发布第八代 TPU 的两套新系统配置:TPU 8tx 与 TPU 8i Max。TPU 8i Max 把两颗 TPU 8i 集成在同一封装中,计算能力、片上 SRAM 和 HBM 带宽同步翻倍,目标场景是长上下文、高并发和多 Agent 协作推理。
这不是一次单纯堆算力的发布。Google 官方公告、AMD 同步合作公告以及多家媒体的简报报道都已确认相关信息。本文不罗列芯片参数,而是用 KV Cache 的实际计算说明一件事:Agent 推理的瓶颈正在从“算得多快”转向“数据能不能及时送到计算单元”。
核心价值:读完本文,你能自己估算一个长上下文请求要占多少显存,理解内存墙的成因,并判断 TPU 8i Max 这类系统设计对你的 Agent 服务意味着什么。
TPU 8i Max 与 Agent 长上下文核心信息速览
| 信息项 | 详情 |
|---|---|
| 发布时间 | 2026 年 11 月 9 日 |
| 发布方 | Google Cloud |
| 产品性质 | 第八代 TPU 的系统配置,不是全新设计的独立芯片 |
| 封装方式 | 两颗 TPU 8i 集成在同一封装中 |
| 官方确认的提升 | 计算能力、SRAM、HBM 带宽均为 TPU 8i 的 2 倍 |
| 媒体简报披露参数 | 384 GB HBM、17.2 TB/s HBM 带宽、768 MB SRAM |
| 目标场景 | 长上下文、高并发推理、多 Agent 协作、长视频分析等 |
| 可用状态 | 官方产品页标注 Coming soon,尚未公布价格与 GA 日期 |
需要强调的是,Google 在公告中刻意区分了 chip 与 system。芯片设计周期以年计,而系统配置可以通过调整封装、内存、网络和安全组件,更快地匹配新的工作负载。TPU 8i Max 正是这种思路的产物:硅片沿用 TPU 8i,变化发生在封装与系统层。
为什么 Agent 长上下文比普通聊天更消耗内存
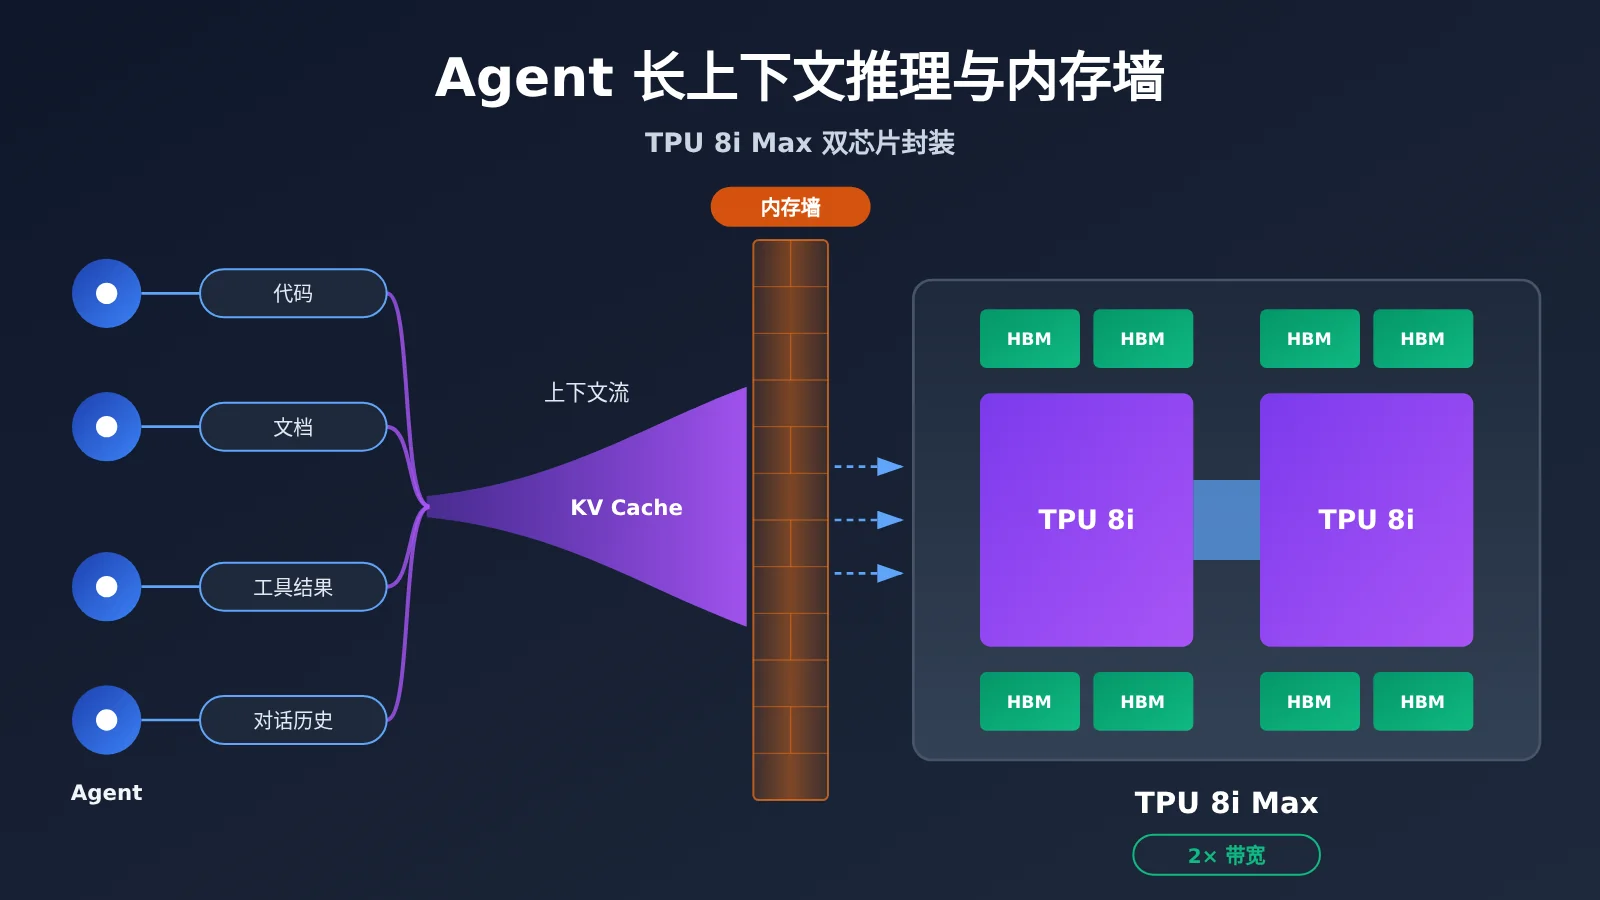
普通聊天通常是“一问一答”,上下文增长缓慢,会话结束后状态即可丢弃。Agent 则不同,它会把一个目标拆解成多个子任务,持续读取外部资料、调用工具、根据反馈继续推理,并在等待结果时保存状态。每一步的产出都会被追加回上下文,于是上下文只增不减。
以一个软件开发 Agent 为例,它在一次任务中可能同时背负以下内容:
- 代码库:数百个源代码文件及其依赖关系
- 项目文档:架构说明、接口约定、编码规范
- 历史对话:用户需求的多轮澄清与修改意见
- 工具结果:编译日志、测试输出、报错堆栈
- 子 Agent 产出:负责测试、审查、重构的子 Agent 各自返回的结果
更关键的是并发。一个主 Agent 派生出 4 个子 Agent 时,系统中就同时存在 5 份独立上下文。每份上下文都要在推理时常驻内存,这就是 Google 把“多 Agent 协作开发大型软件项目”列为 TPU 8i Max 典型场景的原因。需要说明的是,Google 提到的“百万 Token 级上下文”是目标应用场景的描述,并不是一个已公布的固定最大上下文规格。
KV Cache 如何随 Agent 长上下文线性增长
KV Cache 的作用
Transformer 在生成每个新 Token 时,需要用当前 Token 的 Query 去和所有历史 Token 的 Key 做注意力打分,再用得到的权重对历史 Token 的 Value 加权求和。如果每生成一个 Token 都把全部历史重新算一遍 Key 和 Value,计算量会随长度急剧膨胀。KV Cache 的做法是把历史 Token 已经算好的 Key、Value 存起来复用,用内存换计算。
代价是这份缓存会随着上下文长度和并发数持续增长。下面这个估算公式与 vLLM 的 KV Cache 内存布局相对应:
M_KV = 2 × L × H_KV × D × B × T × N
| 参数 | 含义 | Llama 3.1 70B 取值 |
|---|---|---|
| 2 | Key 与 Value 两份缓存 | 2 |
| L | Transformer 层数 | 80 |
| H_KV | Key/Value 注意力头数量 | 8(GQA) |
| D | 每个 KV Head 的维度 | 128 |
| B | 每个元素字节数 | 2(BF16) |
| T | 每个请求的 Token 数 | 按场景变化 |
| N | 并发请求数 | 按场景变化 |
Llama 3.1 70B 的 KV Cache 计算案例
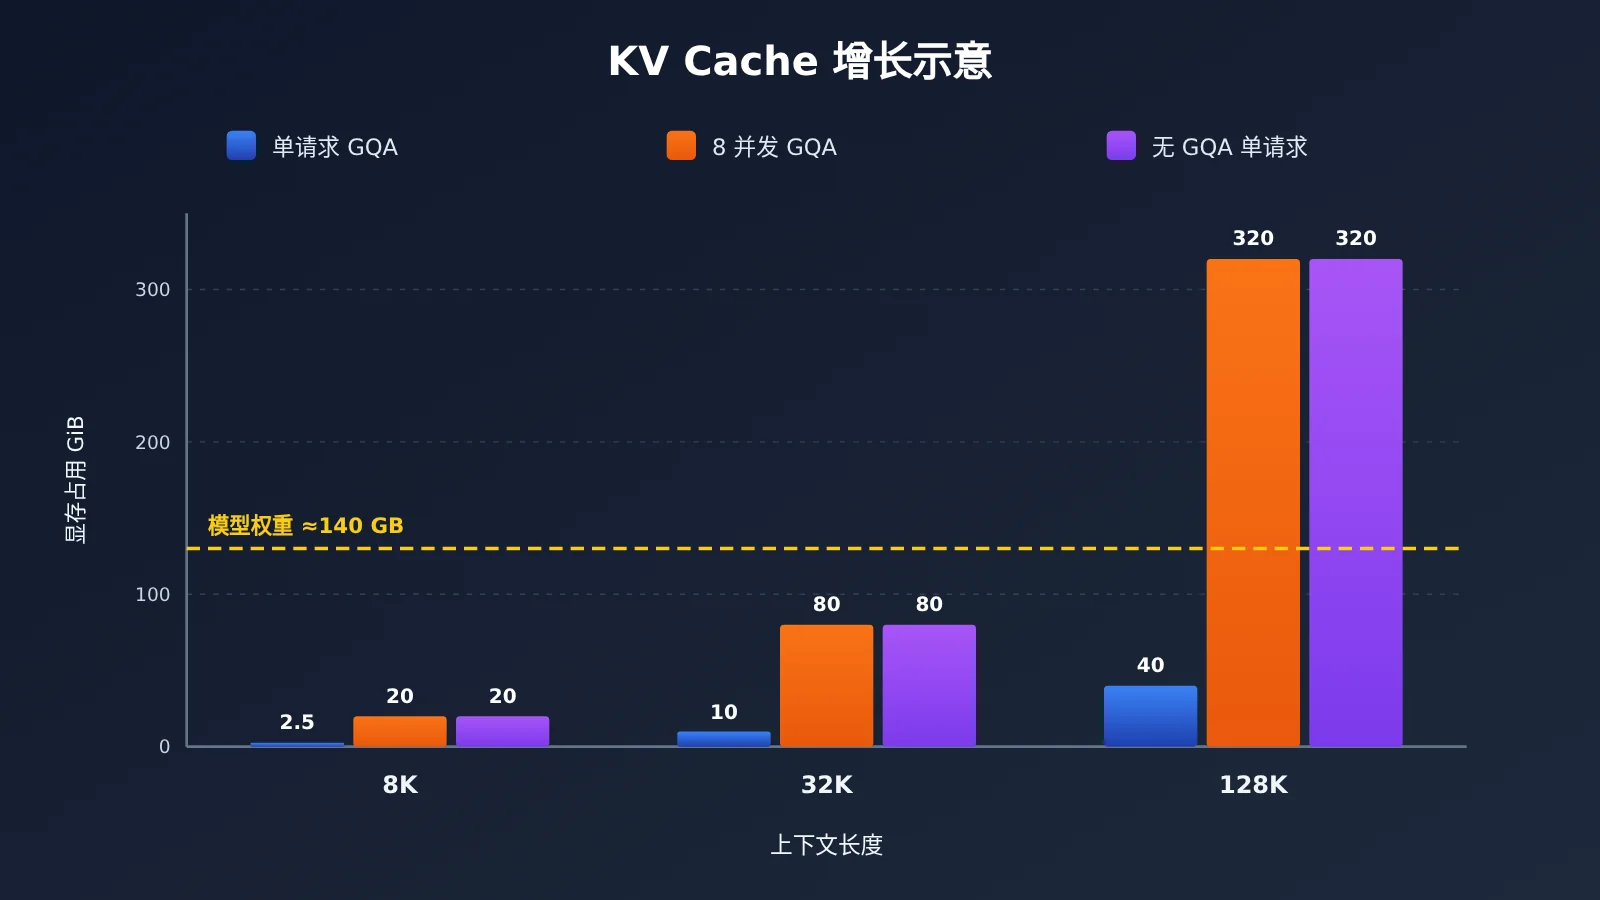
先算单个 Token:2 × 80 × 8 × 128 × 2 = 327,680 字节,也就是每个 Token 约 320 KiB。这个数字看起来不大,但乘上上下文长度后会迅速放大。
| 场景 | 上下文长度 | 并发数 | 理论 KV Cache |
|---|---|---|---|
| 短任务 | 8K | 1 | 2.5 GiB |
| 中等代码任务 | 32K | 1 | 10 GiB |
| 长上下文 Agent | 128K | 1 | 40 GiB |
| 多 Agent 并行 | 128K | 8 | 320 GiB |
以上只计算 KV Cache,不包含模型权重、运行时工作区和碎片开销。作为对照,70B 参数的模型以 BF16 存储时,权重本身大约就要 140 GB。也就是说,8 个 128K 的并发会话所需的 KV Cache,已经超过了模型权重的两倍。
GQA 对 KV Cache 内存占用的影响
Llama 3.1 70B 有 64 个 Attention Head,但只有 8 个 KV Head,这就是 GQA(Grouped-Query Attention):每 8 个 Query 头共享一组 Key/Value。计算时必须用 8 而不是 64,否则结果会偏大 8 倍。
做个反事实推演就能看出 GQA 的价值。如果该模型使用标准多头注意力、64 个头都保留独立 KV,单个 128K 请求的 KV Cache 会从 40 GiB 变成 320 GiB,一个请求就吃掉 8 并发 GQA 场景的全部用量。MQA 把 KV Head 进一步压到 1 个,内存更省,但对模型质量的影响也需要权衡。在此基础上,KV Cache 量化(例如从 BF16 降到 8 位)可以再把占用减半,代价是需要评估精度损失。
下面这段脚本可以直接复用上面的公式,帮你快速估算自己的模型在不同上下文和并发下的 KV Cache 规模:
def kv_cache_gib(layers, kv_heads, head_dim, bytes_per_elem, tokens, concurrency=1):
    """按 M_KV = 2 × L × H_KV × D × B × T × N 估算 KV Cache,单位 GiB"""
    total = 2 * layers * kv_heads * head_dim * bytes_per_elem * tokens * concurrency
    return total / (1024 ** 3)

# Llama 3.1 70B:80 层、8 个 KV Head、维度 128、BF16
for ctx in (8_192, 32_768, 131_072):
    print(f"{ctx:>7} tokens -> {kv_cache_gib(80, 8, 128, 2, ctx):.1f} GiB")

print("8 并发 x 128K ->", kv_cache_gib(80, 8, 128, 2, 131_072, 8), "GiB")
print("FP8 KV 量化 128K ->", kv_cache_gib(80, 8, 128, 1, 131_072), "GiB")
Agent 长上下文推理的内存墙究竟是什么
容量、带宽与 SRAM 是三个独立维度
讨论内存墙时最常见的误区,是把“内存大”和“内存快”混为一谈。实际上,AI 加速器的内存体系至少涉及三个相互独立的指标:
| 指标 | 决定什么 | 对 Agent 的意义 |
|---|---|---|
| HBM 容量 | 能装下多少数据 | 能同时保留多少模型权重和 KV Cache,即能撑多少并发上下文 |
| HBM 带宽 | 单位时间能搬运多少数据 | 每生成一个 Token 时,能否快速把权重和 KV Cache 送到计算核心 |
| 片上 SRAM | 离计算核心最近的高速存储 | 能否把高频数据留在片上,减少反复访问 HBM 的等待 |
HBM 本质是通过多层堆叠和先进封装实现高并行访问的 DRAM;SRAM 更快、更贴近计算单元,但单位容量成本高、物理面积有限。这就是现代加速器普遍采用多级内存层次,而不是单一追求某种内存容量的原因。
Prefill 与 Decode 的数据需求截然不同
LLM 推理分为两个阶段。Prefill 阶段一次性处理全部输入上下文并建立 KV Cache,大量 Token 可以并行计算,属于典型的计算密集型任务。Decode 阶段逐个生成输出 Token,每一步只处理一个新 Token,却要读取全部权重和整段 KV Cache,计算量很小、数据搬运量很大,属于带宽密集型任务。
可以用理想化的估算感受一下 Decode 的压力。单个 128K 请求的 KV Cache 约 40 GiB(约 43 GB),每生成一个 Token 都要完整读一遍。按 TPU 8i 单芯片约 8.6 TB/s 的 HBM 带宽,仅读取 KV Cache 就需要约 5 毫秒;按 TPU 8i Max 的 17.2 TB/s,下限约为 2.5 毫秒。这只是忽略权重读取、计算重叠和并行切分的理论下限,但足以说明:上下文越长,Decode 的时间越被数据搬运而不是计算所主导。
计算单元为什么会“等数据”
当计算核心每秒能完成的运算量远高于内存每秒能供给的数据量时,计算单元就会空转等待,这就是内存墙。对 Agent 而言,长上下文让每步 Decode 的读取量变大,高并发让需要常驻的 KV Cache 变多,多轮推理又要求缓存被反复读取和更新。三者叠加,单纯提升峰值算力的边际收益会越来越低。
🎯 技术建议:在评估自己的 Agent 应用前,建议先用不同上下文长度实测首 Token 延迟(TTFT)和输出速度,看延迟随上下文增长的趋势。通过 API易 apiyi.com 可以用同一个 API Key 在 Claude、Gemini、GPT 等模型间切换测试,便于比较不同模型的长上下文表现。
TPU 8i Max 双芯片封装如何扩展内存带宽
两颗 TPU 8i 如何组合
TPU 8i Max 是第八代 TPU 的第四套系统配置。Google 发现,多个 Agent 同时处理大型代码库、长视频或复杂文档时,瓶颈往往不是算力,而是芯片读取和交换数据的速度。它的解法是把两颗低延迟的 TPU 8i 整合进同一个封装,并在同等机架占地内放入 2 倍的硅片。
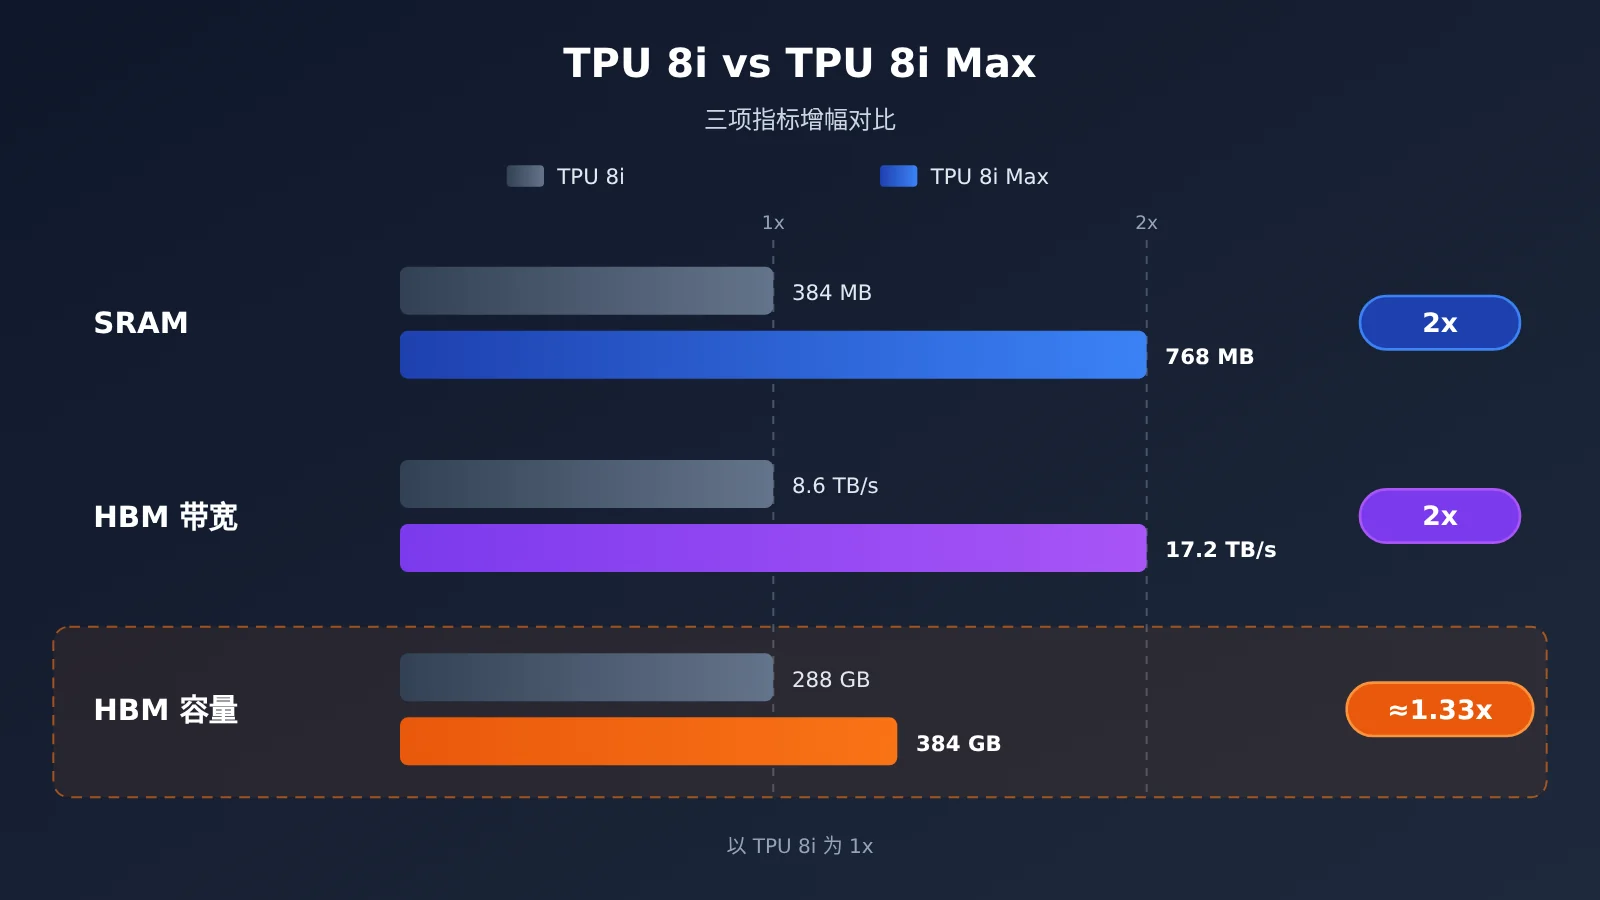
| 指标 | TPU 8i | TPU 8i Max | 变化幅度 |
|---|---|---|---|
| 芯片封装 | 单芯片 | 双芯片 | — |
| 计算能力 | 基准 | 2 倍 | 翻倍 |
| 片上 SRAM | 384 MB | 768 MB | 翻倍 |
| HBM 带宽 | 8,601 GB/s | 17,200 GB/s | 约翻倍 |
| HBM 容量 | 288 GB | 384 GB | 约增加 33% |
注:TPU 8i 数据来自 Google 2026 年 4 月的架构技术文章;TPU 8i Max 的绝对数值来自 11 月 9 日媒体简报报道,官方发布文章正文明确确认的是计算、SRAM、HBM 带宽翻倍。
为什么同步扩展比单独堆算力更有意义
如果只增加计算能力,Decode 阶段会更严重地卡在带宽上;如果只增加带宽,计算单元又可能吃不饱。TPU 8i Max 让计算、SRAM、HBM 带宽三者按相近比例扩展,使“数据供给速度 / 计算速度”的比值大致保持在原有设计平衡点上。翻倍的 SRAM 则让更多高频数据留在片上,进一步减少对 HBM 的往返访问。
HBM 容量只增加约 33%,不是翻倍
这是最容易写错的细节。HBM 带宽从约 8.6 TB/s 到 17.2 TB/s 是翻倍,但 HBM 容量从 288 GB 到 384 GB 只多了约 33%。结合前面的计算可以理解这意味着什么:TPU 8i Max 每 GB 内存对应的带宽更高,读取同样大小的 KV Cache 更快;但它能同时“装下”的上下文总量,增长幅度远小于带宽。
换句话说,TPU 8i Max 的核心价值不是让单个模型的上下文上限翻倍,而是让系统更高效地承载和处理大量并发上下文。容量不够时,仍需要借助 KV Cache 卸载、量化和多芯片切分等软件手段。
GPU 与 TPU 8i Max 的内存架构对照
为了理解 TPU 8i Max 的定位,可以用 NVIDIA 最新的 Rubin 架构作为 GPU 参照。
| 维度 | NVIDIA Rubin GPU | Google TPU 8i Max |
|---|---|---|
| 计量单位 | 单颗 GPU | 双 TPU 芯片封装 |
| HBM 容量 | 288 GB HBM4 | 384 GB HBM(媒体披露) |
| HBM 带宽 | 22 TB/s | 17.2 TB/s(媒体披露) |
| 片上存储 | 依具体架构配置 | 768 MB SRAM(媒体披露) |
| 芯片间互连 | NVLink 6 | Boardfly 低延迟网络(TPU 8i 体系) |
| 软件生态 | CUDA 及主流推理引擎 | JAX、TorchTPU、vLLM / SGLang TPU 后端 |
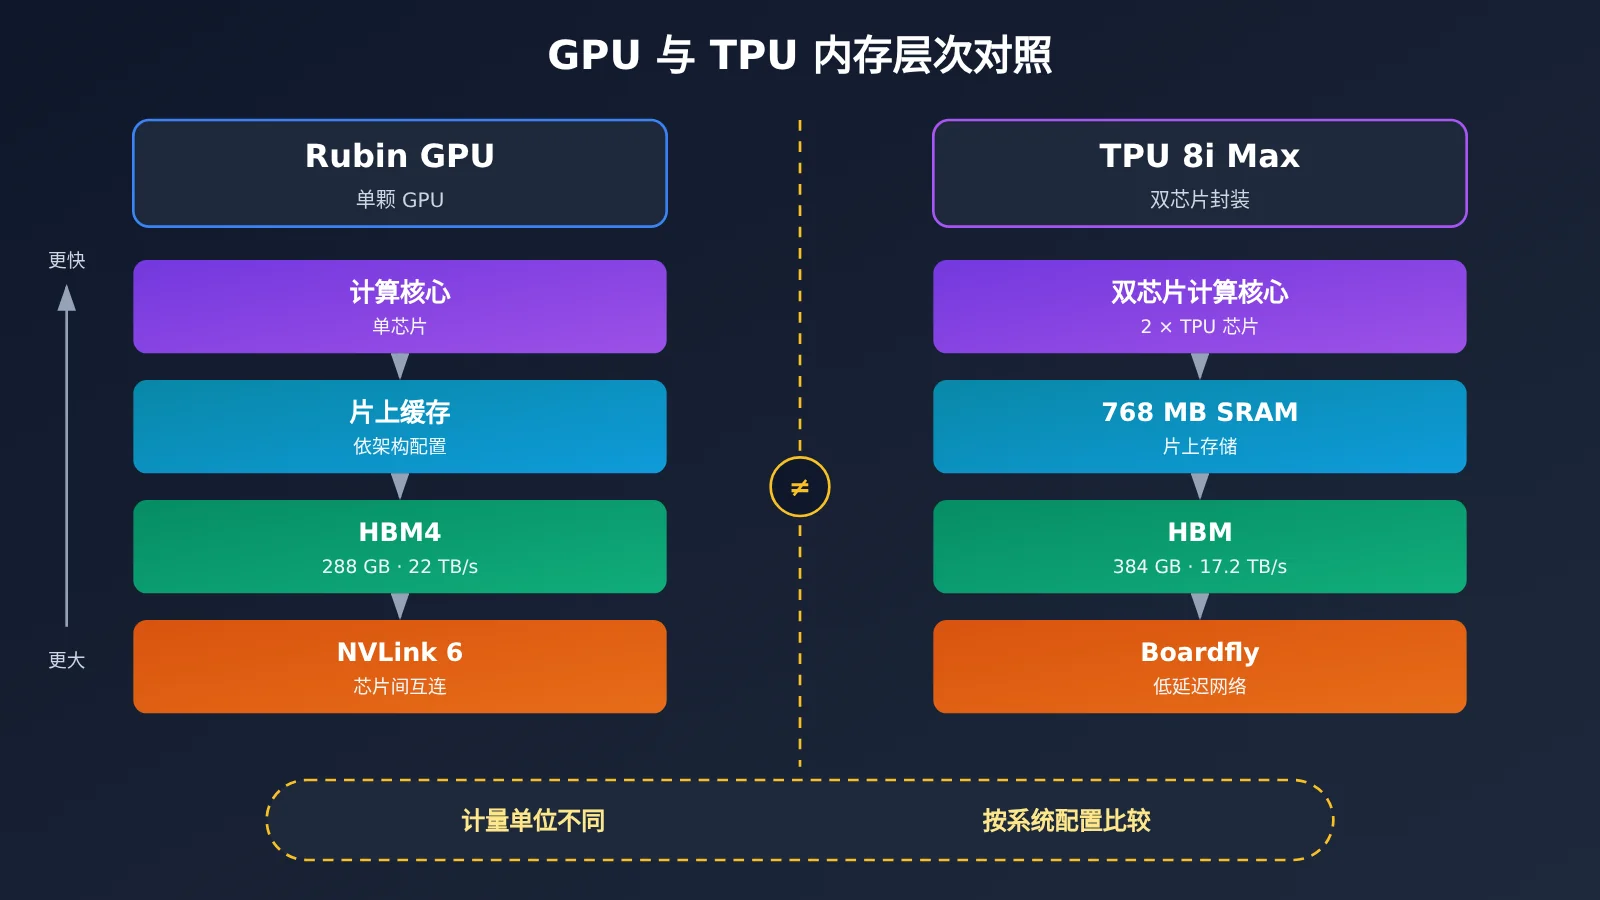
这张表不能用来简单排名。384 GB 与 288 GB 的比较对象一个是双芯片封装、一个是单颗 GPU;两者的 HBM 代际、互连方式、计算架构和整机配置都不同。仅看带宽,单颗 Rubin 更高;仅看容量,TPU 8i Max 更大,但这些都不能脱离系统规模独立讨论。
真正值得比较的是:在相同功耗、机架空间和成本下,整个系统能稳定支撑多少有效并发上下文,以及维持这些上下文时的吞吐量、延迟与能效。截至 2026 年 11 月 10 日,TPU 8i Max 尚无可公开复核的独立实测,这类系统级对比还需要等待正式商用后的数据。
💡 选择建议:对于大多数通过 API 构建 Agent 的团队来说,底层跑在 GPU 还是 TPU 上并不需要自己决策,更实际的是比较各家模型在长上下文下的延迟和单价。可以通过 API易 apiyi.com 的统一接口并行测试多个模型,用真实业务 Prompt 做对比。
TPU 8i Max 对 Agent 开发者的影响分析
区分上下文窗口、实际并发与推理延迟
模型标称的上下文窗口只说明“理论上能放多少”,并不等于服务端能在这个长度下支撑多少并发,更不代表延迟可以接受。前面的计算已经说明,同样 128K 上下文,1 个会话和 8 个会话的 KV Cache 相差 8 倍。对开发者而言,三个指标需要分开看:
- 上下文窗口:模型能处理的最大范围,决定单次能塞进多少资料
- 实际并发能力:在给定硬件下能同时维持多少个长会话,受 HBM 容量约束
- 推理延迟:TTFT 受 Prefill 计算量影响,逐 Token 速度受带宽和 KV Cache 大小影响
正在普及的三类缓解技术
硬件只是内存墙解法的一半,另一半在软件层。Google 同期开源的 TPU Sync,以及 TPU 版 vLLM、SGLang,都围绕下面这些技术展开:
| 技术 | 解决的问题 | 代价或注意点 |
|---|---|---|
| KV Cache Offloading | 把暂时不用的缓存从 HBM 转移到主机 DRAM、SSD 或共享存储,突破容量上限 | 恢复时需要传输时间,依赖高效的 DMA 与异步传输 |
| KV Cache 量化 | 降低每个元素的字节数,直接减少容量和带宽占用 | 需要评估精度影响 |
| Prefill / Decode 分离 | 把计算密集的 Prefill 和带宽密集的 Decode 部署到不同节点 | 节点间需要快速传输 KV Cache |
| Prefix Caching | 复用相同的系统提示词和历史前缀,避免重复 Prefill | 依赖请求前缀的重复度 |
Google 公布的 TPU Sync 数据显示,KV Cache 传输延迟可降低超过 90%,64K 上下文前缀缓存场景 TTFT 最多降低 90%。但这组测试基于第七代 Ironwood TPU,并且 GitHub README 当前列出的主动验证硬件是 v7x 和 v6e,不能直接当成 TPU 8i Max 的成绩。
落到实际性能与资源成本
对 API 调用方来说,这些底层优化最终体现为两点:长上下文请求的延迟是否稳定,以及按 Token 计费的成本是否下降。在应用侧,你同样可以借鉴“少占内存”的思路:精简系统提示词并保持前缀稳定以命中缓存,对工具输出做摘要后再回填上下文,给子 Agent 只传它需要的片段而不是全部历史。
下面的示例用流式输出测量不同上下文长度下的首 Token 延迟,便于观察上下文增长对 Prefill 的影响:
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

def measure_ttft(context: str, model: str = "gpt-4o-mini") -> float:
    start = time.perf_counter()
    stream = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": context + "\n请用一句话总结上文。"}],
        stream=True,
    )
    for chunk in stream:
        if chunk.choices and chunk.choices[0].delta.content:
            return time.perf_counter() - start
    return -1.0

print(f"TTFT: {measure_ttft('示例代码片段 ' * 2000):.2f}s")
查看多模型、多长度批量测试代码
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 一个 Key 切换多家模型
)

MODELS = ["gpt-4o-mini", "claude-sonnet-4", "gemini-2.5-flash"]
LENGTHS = [1_000, 5_000, 20_000]  # 重复片段次数,近似放大上下文

def run_once(model: str, repeat: int) -> dict:
    context = "def handler(event):\n    return process(event)\n" * repeat
    start = time.perf_counter()
    first, tokens = None, 0
    try:
        stream = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": context + "\n指出上面代码的潜在问题。"}],
            stream=True,
            max_tokens=200,
        )
        for chunk in stream:
            if chunk.choices and chunk.choices[0].delta.content:
                tokens += 1
                if first is None:
                    first = time.perf_counter() - start
        total = time.perf_counter() - start
        return {"model": model, "repeat": repeat, "ttft": first, "total": total, "chunks": tokens}
    except Exception as e:
        return {"model": model, "repeat": repeat, "error": str(e)}

for m in MODELS:
    for n in LENGTHS:
        print(run_once(m, n))
🚀 快速开始:通过 API易 apiyi.com 注册即可获取免费测试额度,把上面脚本的 base_url 保持为
https://api.apiyi.com/v1,几分钟内就能拿到多个模型在不同上下文长度下的 TTFT 曲线。
对行业的影响
- 系统级定制加速:Google 用“同一硅片、不同系统”的方式快速推出面向细分负载的配置,说明加速器竞争正从单芯片参数转向系统设计
- 软硬协同成为标配:TPU 8i Max 与 TPU Sync、Agent Compute Engine、TPU 版推理引擎一起发布,内存墙的解法同时依赖硬件带宽和软件调度
- 商业化仍在早期:TPU 8i Max 与 8t、8i、8tx 一样标注 Coming soon,尚无公开价格和正式可用日期,实际性价比有待验证
常见问题 FAQ
Q1:什么是 TPU 8i Max?
TPU 8i Max 是 Google 于 2026 年 11 月 9 日发布的第八代 TPU 系统配置,将两颗 TPU 8i 集成在同一封装中,计算能力、片上 SRAM 和 HBM 带宽均为 TPU 8i 的 2 倍,主要面向长上下文、高并发和多 Agent 协作推理。它不是一颗全新设计的芯片。
Q2:TPU 8i Max 的 HBM 容量翻倍了吗?
没有。根据媒体简报披露,HBM 容量从 288 GB 增加到 384 GB,约增加 33%;翻倍的是 HBM 带宽(约 8.6 TB/s 到 17.2 TB/s)和 SRAM(384 MB 到 768 MB)。容量和带宽是两个独立指标,不能混为一谈。
Q3:TPU 8i Max 现在可以使用吗?价格是多少?
截至 2026 年 11 月 10 日,Google Cloud 官方产品页将 TPU 8i Max 标注为 Coming soon,尚未公布公开价格和正式 GA 日期,也没有可公开复核的独立性能测试。目前能参考的只有 Google 的官方声明和媒体简报参数。
Q4:TPU 8i Max 能让单个模型支持百万 Token 上下文吗?
Google 将百万 Token 级上下文列为目标应用场景,但这并不是已公布的固定最大上下文规格。模型能处理多长上下文首先取决于模型本身;硬件决定的是在这个长度下能维持多少并发、延迟能否接受。
Q5:应用开发者如何验证长上下文对延迟的影响?
最直接的方法是用不同长度的真实业务上下文测量 TTFT 和输出速度:
1. 访问 API易 apiyi.com 注册账号,获取 API Key 和免费测试额度
2. 使用本文的测试脚本,base_url 设为 `https://api.apiyi.com/v1`
3. 在同一组上下文下切换多个模型,对比延迟随长度增长的斜率
Q6:KV Cache 量化和卸载有什么局限?
量化能直接减少内存和带宽占用,但可能带来精度损失,需要在目标任务上评估。卸载能突破 HBM 容量限制,但恢复时需要传输时间,如果数据层级之间的传输不够快,反而会拉高延迟。两者都需要结合并发规模和延迟目标来调参。
Agent 长上下文与 TPU 8i Max 核心要点 Key Takeaways
- 瓶颈转移:Agent 推理正从拼算力转向计算与内存数据供给的平衡
- KV Cache 线性增长:Llama 3.1 70B 每 Token 约 320 KiB,128K 单请求约 40 GiB
- GQA 很关键:8 个 KV Head 让缓存占用只有标准多头注意力的八分之一
- Decode 吃带宽:每生成一个 Token 都要完整读取 KV Cache,长上下文下带宽主导延迟
- 同步扩展:TPU 8i Max 的算力、SRAM、HBM 带宽同步翻倍,HBM 容量只增约 33%
- 软件同样重要:卸载、量化、Prefill/Decode 分离和前缀缓存是缓解内存墙的主要手段
- 上手验证:可借助 API易 apiyi.com 统一接口实测多模型的长上下文延迟
总结
Agent 长上下文推理的内存墙核心要点:
- 压力来源:代码库、工具结果、子 Agent 产出持续累积,叠加多 Agent 并发,KV Cache 会成倍放大
- 硬件思路:TPU 8i Max 不是单纯堆算力,而是让计算、SRAM、HBM 带宽同步扩展,保持数据供给与计算的平衡
- 适用边界:HBM 容量增幅有限、产品尚未商用,实际价值要等系统级实测数据验证
对多数开发者而言,现阶段更务实的做法是理解 KV Cache 的成本结构,在应用层控制上下文膨胀,并持续关注模型服务的长上下文延迟与价格变化。推荐通过 API易 apiyi.com 用真实业务数据对比多个模型的长上下文表现,平台提供 OpenAI 兼容接口和新用户免费额度。
📚 参考资料
- Google Cloud Blog – Introducing TPU 8tx and TPU 8i Max:本次发布的官方技术公告
- 链接:
cloud.google.com/blog/topics/ai-infrastructure/tpu-8tx-and-tpu-8i-max -
说明: 确认双芯片封装及计算、SRAM、HBM 带宽翻倍
-
Google Cloud – Inside the eighth-generation TPU:第八代 TPU 架构深度解析
- 链接:
cloud.google.com/blog/products/compute/tpu-8t-and-tpu-8i-technical-deep-dive -
说明: TPU 8i 原始规格与 Boardfly 网络架构
-
Google Cloud – Introducing TPU Sync:KV Cache 与权重传输库
- 链接:
cloud.google.com/blog/topics/ai-infrastructure/introducing-tpu-sync-fast-kv-cache-and-weight-transfer-on-tpu -
说明: 多级内存体系与 KV Cache Offloading 测试数据(基于 Ironwood)
-
Network World – Google targets AI’s next infrastructure bottlenecks:媒体简报报道
- 链接:
networkworld.com/article/4245897 -
说明: TPU 8i Max 的 HBM 容量、带宽与 SRAM 绝对参数
-
Google TPU Sync GitHub:开源仓库
- 链接:
github.com/google/tpu-sync - 说明: 兼容硬件与开发状态说明
作者: APIYI 技术团队
技术交流: 欢迎在 API易 官网首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心