作者注:按错误码给模型 API 报错分诊,讲清楚何时重试、何时切换备用模型、何时停下来修配置,并附错误码分诊表、备用模型核对表和上线检查清单。
模型 API 报错后,先看是哪一类错误,再决定怎么处理。4xx 多数是请求或配置的问题,重试不会让它变好;5xx、529 和超时才值得做有限重试,重试仍失败再切换备用模型;没有幂等保证的请求,不要自动重试。重试不是默认动作,切换也解决不了所有问题。很多线上事故并不是模型挂了,而是错误处理逻辑把一次小故障放大成了重复扣费、重复写库和整条链路被限流。
这篇不是错误码字典的翻译。它面向已经把模型 API 接进生产或半生产环境的开发者,重点是出错时怎样避免把局面弄得更糟。读完你会拿到一张错误码分诊表、一套重试与回退策略、一张备用模型能力核对表,以及一份可以照着执行的上线前检查清单。全文可以浓缩成一句判断:4xx 先修,5xx 才谈重试,非幂等请求先停手。
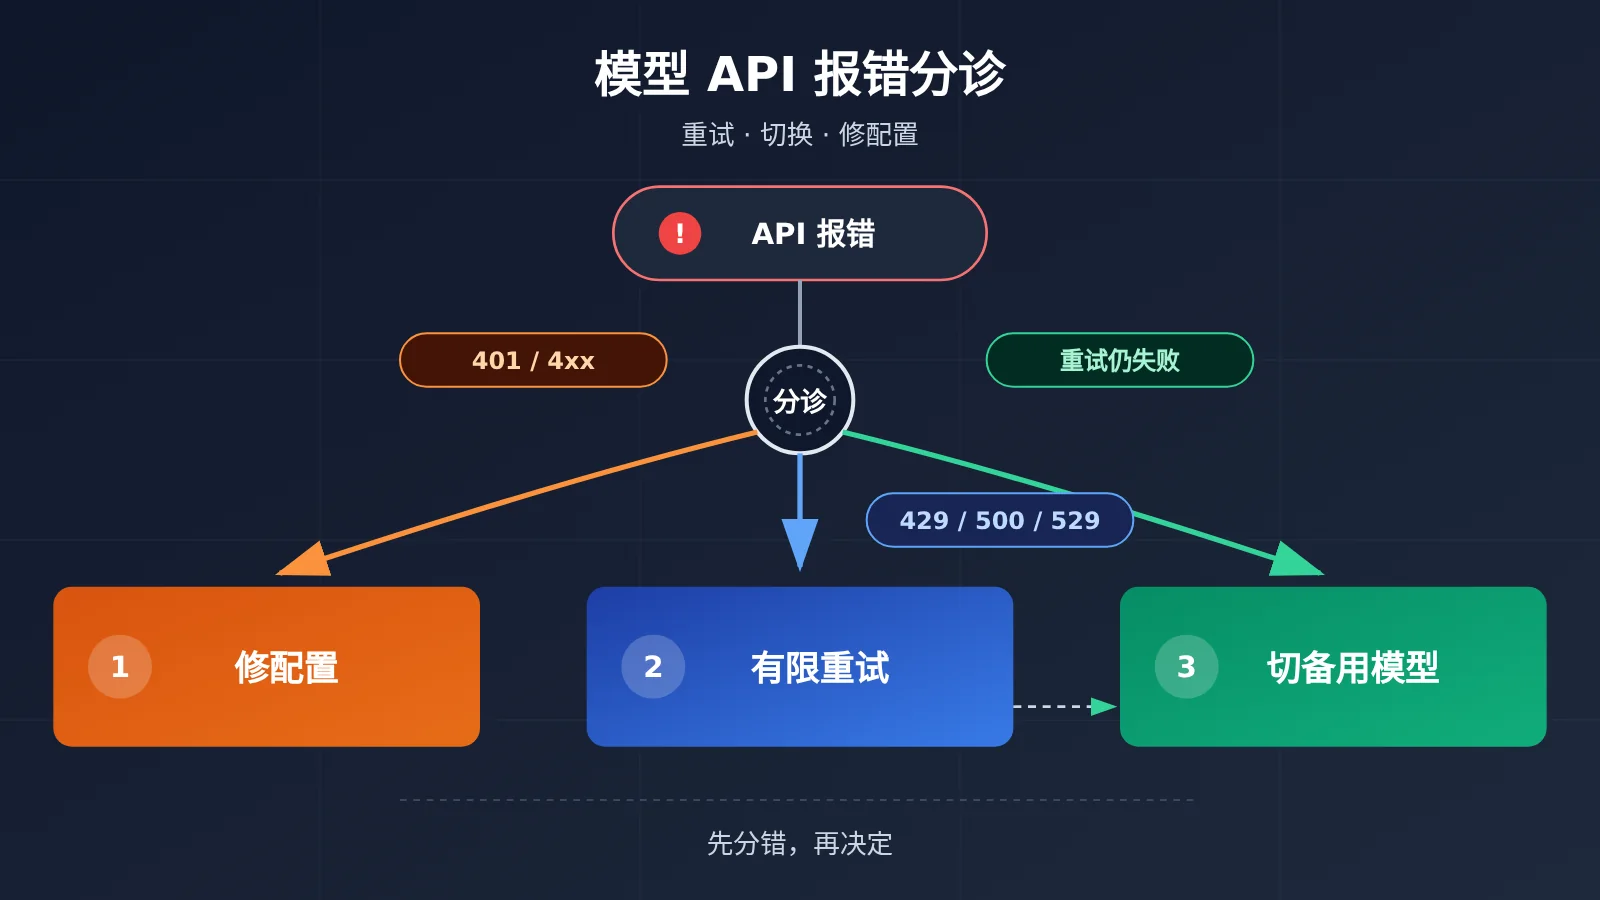
模型 API 报错的 5 类分诊:先分错,再决定重试或切换
结论先说:模型 API 报错只分五类,每一类的处理方向基本固定。把错误码先归到类别里,后面的重试和切换逻辑就不会乱。
| 错误类别 | 典型状态码 | 根因位置 | 默认动作 |
|---|---|---|---|
| 请求错 | 400、404、409、422 |
你的请求体、参数、模型 ID、端点 | 不重试,修请求 |
| 鉴权错 | 401、403 |
Key、请求头、权限、地区或策略 | 不重试,查 Key 和权限 |
| 额度或限流 | 402、429 |
余额、并发、速率、模型额度 | 402 停手;429 看错误体再退避或切换 |
| 上游故障 | 500、502、503、529 |
网关、上游服务、过载 | 有限重试,失败后切换 |
| 超时或流中断 | 408、504、网络超时、流断开 |
链路、长输出、上游响应慢 | 先确认是否已执行或已计费,幂等才重试 |
5 类错误分诊的关键:区分“重试”和“切换”
重试指用同一个模型、同一条线路再发一次请求,适合解决瞬时抖动;切换指换模型或换线路,适合解决某个上游持续不可用。两者的代价不一样:重试的代价是延迟和可能的重复计费,切换的代价是输出质量、工具调用兼容性和成本都可能发生变化。
所以分诊的顺序固定为三步:先确认错误类别,再判断请求是否幂等,最后选择重试、切换或停手。跳过第二步最危险,因为一个已经执行过的工具调用再执行一次,带来的就不只是“多花点钱”了。
为什么“全部重试”会让模型 API 报错更严重
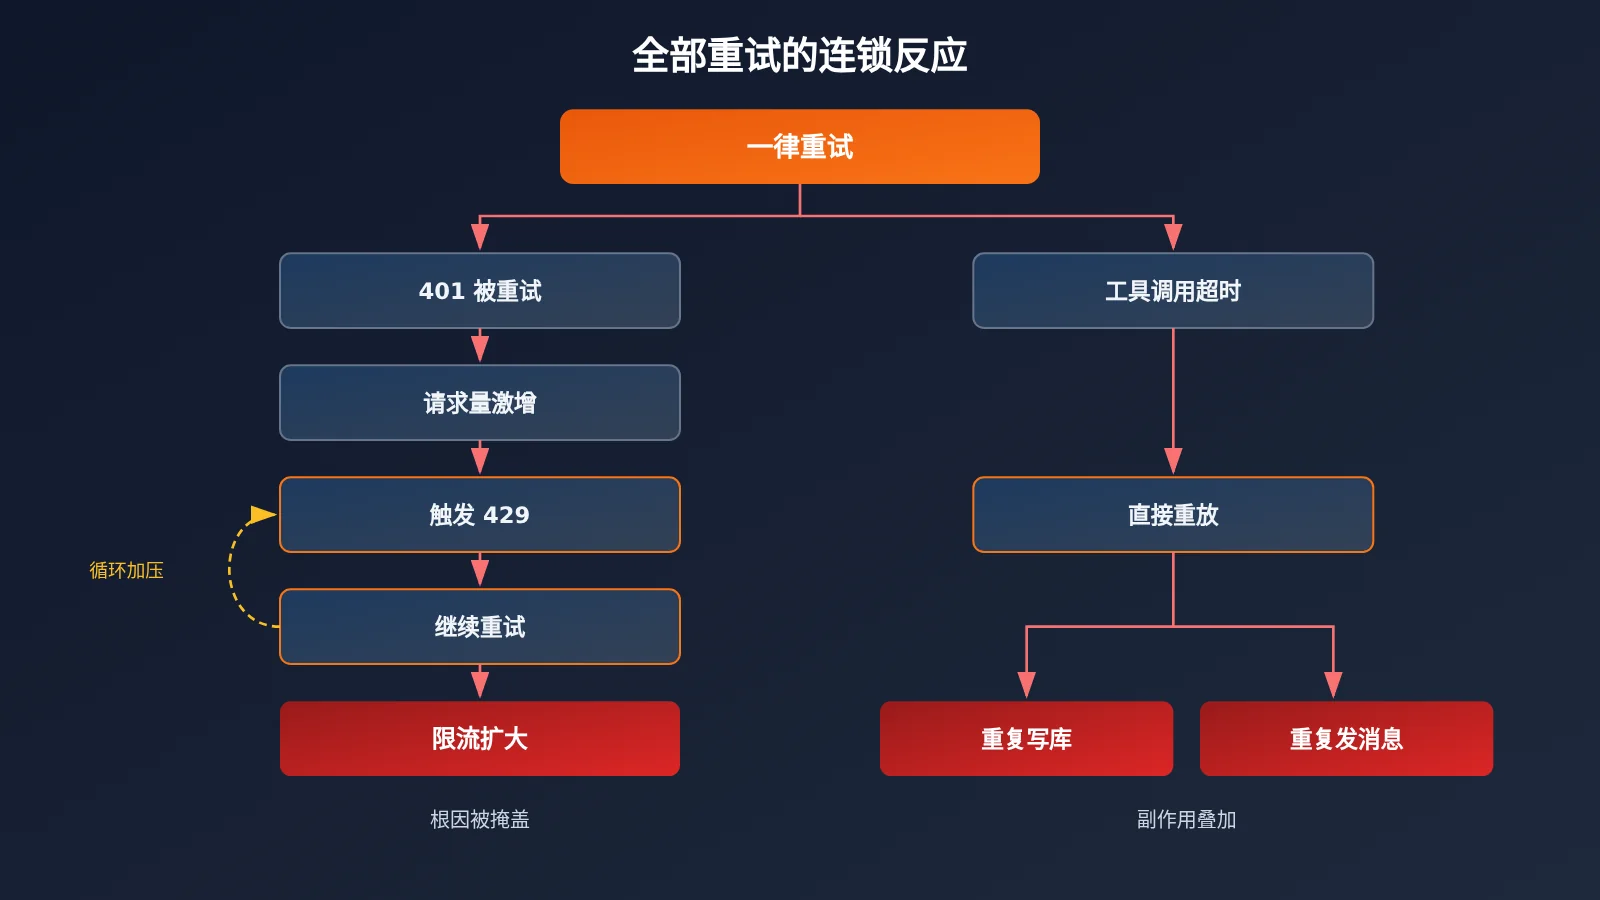
结论:对所有错误一律重试,看起来稳妥,实际上会同时放大成本、副作用和限流。生产环境里,这类逻辑造成的事故往往比原始错误更难排查。
第一个问题是重复扣费。流式响应中断不一定说明请求失败,上游可能已经生成了一部分 token,这部分费用可能已经产生。盲目重放等于同一个任务付两次钱,长输出任务尤其明显。
第二个问题是重复执行。Agent 场景里,一次模型请求可能触发写库、发消息、创建任务甚至支付。如果工具调用阶段超时,你并不知道工具是否已经执行;这时直接重放整个请求,很可能出现两条订单、两封邮件。
第三个问题是限流雪上加霜。429 本身就是上游在说“慢一点”,这时客户端立刻并发重试,相当于主动加压。更常见的反例是对所有 4xx 都重试:401 本来是 Key 写错,重试几轮后请求量被打满,最后日志里看到的是一堆 429,真正的根因反而被掩盖了。
401、429、500、529 错误码分诊表:哪些重试,哪些切换
结论:下表覆盖生产中最常见的 14 个状态码,其中只有少数值得重试,切换的前提是重试已经确认无效。表中的“是否切换”指换备用模型或线路,具体含义以实际错误体和各家文档为准。
| 状态码 | 常见含义 | 是否重试 | 是否切换 | 处理动作 |
|---|---|---|---|---|
400 |
请求格式或参数错误 | 否 | 否 | 修请求体,检查字段和类型 |
401 |
Key 无效或鉴权失败 | 否 | 否 | 查 Key、Authorization 请求头、Base URL |
402 |
余额不足或额度用完 | 否 | 视情况换线路 | 充值或切到有额度的线路,并告警 |
403 |
权限、地区或策略拒绝 | 否 | 否 | 查账号权限、模型授权、地区限制 |
404 |
模型或端点不存在 | 否 | 否 | 核对模型 ID 和端点路径 |
408 |
请求超时 | 幂等时有限重试 | 可选 | 确认未执行后重试 1 次 |
409 |
冲突或状态不一致 | 否 | 否 | 查业务状态,避免并发写 |
422 |
参数校验失败 | 否 | 否 | 修参数,常见于结构化输出 schema |
429 |
限流、并发或额度 | 退避后重试 | 重试失败可切换 | 先读错误体和 Retry-After |
500 |
上游内部错误 | 有限重试 | 连续失败则切换 | 记录 request id 和错误体 |
502 |
网关错误 | 有限重试 | 可切换 | 区分网关问题和上游问题 |
503 |
服务不可用 | 有限重试 | 可切换 | 尊重 Retry-After,必要时降级 |
504 |
网关超时 | 幂等时才重试 | 可切换 | 先查任务是否已执行 |
529 |
上游过载 | 有限重试 | 可切换 | 退避加抖动,持续过载就切换 |
429 不一定是限流:读错误体再决定
429 最容易被误判。它可能表示速率限流,也可能是并发超限、模型额度耗尽,个别情况下还和余额有关。速率限流通常退避几秒就能恢复;额度耗尽时,重试多少次都没用,直接切到最贵的模型更是只让成本翻倍,问题依旧。
处理 429 的步骤如下:
- 读取响应头里的
Retry-After,有就按它等待。 - 读取错误体里的错误类型字段,区分 rate limit、concurrency 和 quota。
- 速率或并发问题:退避重试 1 到 2 次,并降低本地并发。
- 额度问题:停止重试,告警并切换到有额度的线路。
500 的思路类似。它不一定说明模型本身坏了,可能是网关,也可能是上游。先记下 request id 和错误体摘要,排查和对账都要用到。
模型 API 报错重试策略:次数、退避、Retry-After 与幂等
结论:重试只针对瞬时错误,次数控制在 1 到 2 次,必须带指数退避和随机抖动,并且只对幂等请求自动执行。不满足这四个条件,就不要自动重试。
| 参数 | 建议值 | 说明 |
|---|---|---|
| 可重试错误 | 429、500、502、503、504、529、网络超时 |
4xx 中只有 408、429 例外 |
| 最大重试次数 | 1-2 次 | 超过后进入切换或告警,不再原地打转 |
| 退避间隔 | 1s、2s、4s 指数递增 | 每次叠加随机抖动,避免多实例同时重试 |
| Retry-After | 有就优先遵守 | 优先级高于本地退避算法 |
| 幂等前提 | 必须满足 | 写操作、工具调用、发消息、支付默认不自动重试 |
重试策略落地步骤
- 建立错误分类函数。输入状态码和错误体,输出五类之一,其他逻辑都基于这个分类结果,不要在业务代码里到处判断数字。
- 给请求打幂等标签。纯文本生成、摘要、翻译通常可以视为幂等;只要请求会触发工具或产生外部写操作,就标记为非幂等。
- 非幂等请求先查状态。工具调用超时后,先查询任务或数据库状态,确认没有执行过再重试,必要时使用业务侧的幂等键去重。
- 设置总时长上限。每个请求的重试总耗时要有上限,否则用户侧请求早就超时了,后台还在重试。
- 记录每一次尝试。至少记录 request id、模型 ID、状态码、错误类、延迟、token 用量和重试次数。
最后一步经常被省略,但对账和排错都离不开它。如果通过 API易 apiyi.com 接入,控制台里可以按 Key 查看用量和调用日志,把本地记录的 request id 和平台侧的错误信息对上,就能判断一次失败究竟发生在网关、上游,还是你自己的请求体。
流中断单独处理。流式请求断开时,先看已经收到多少 token、内容是否已经可用,再决定是续写、丢弃还是重放。长输出任务重放前要想清楚:前一次的生成可能已经计费。
🎯 排错建议:遇到
500、529这类不好判断归属的错误,先保存错误体原文和 request id,再到 API易 apiyi.com 控制台核对同一时段的用量与日志。不要只凭状态码就下结论。
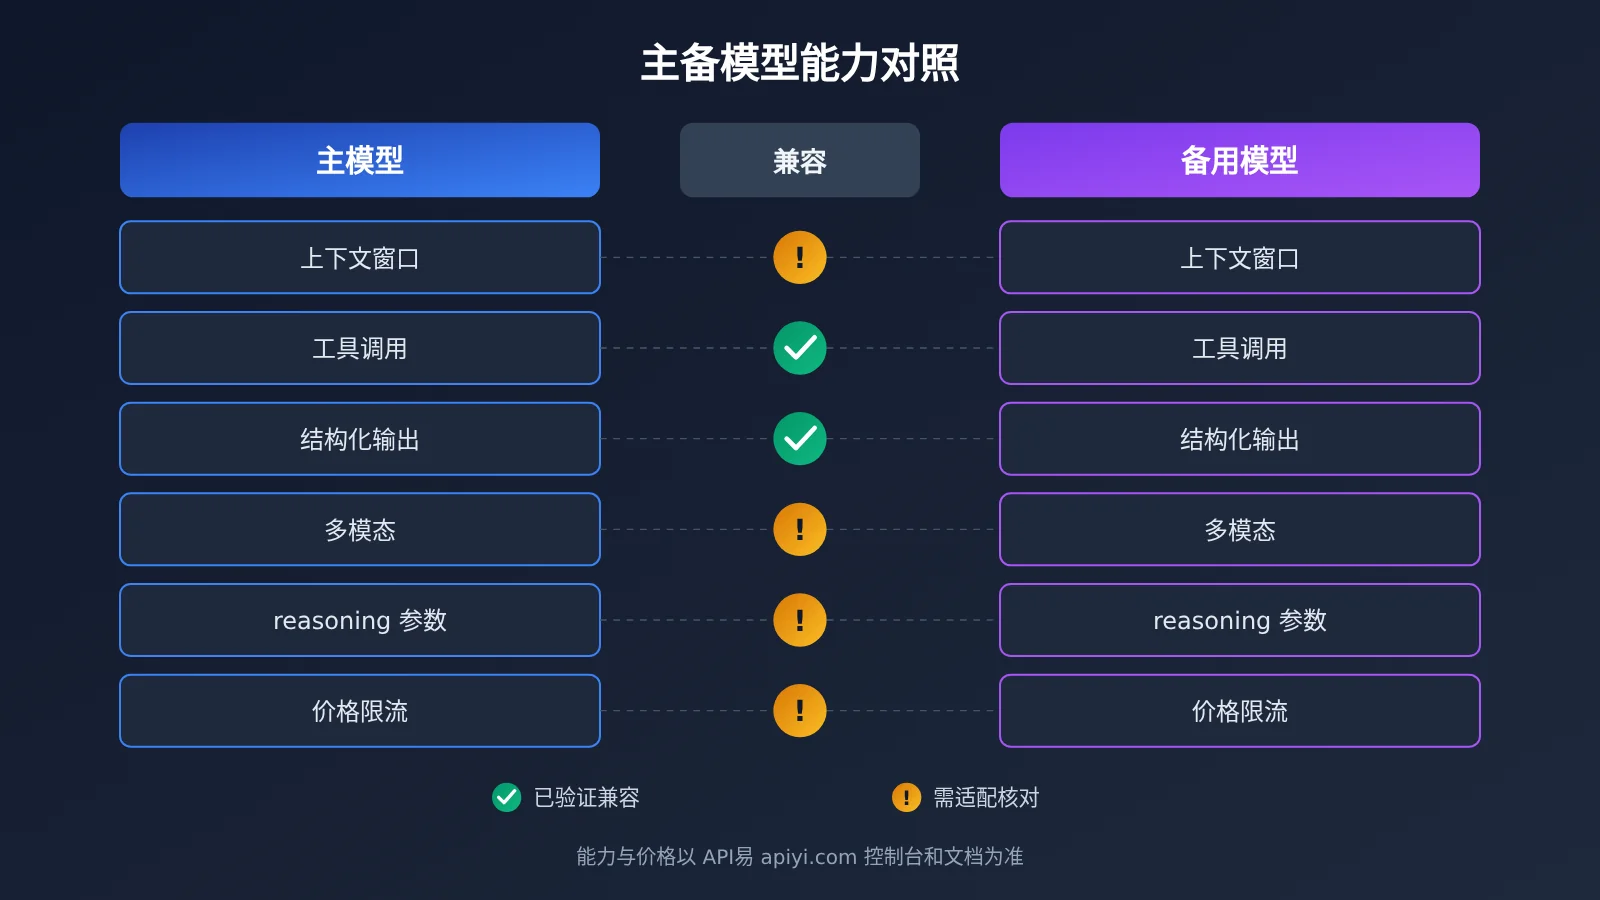
切换备用模型策略:能力分层、模型映射与兼容核对
结论:切换的前提是备用模型已经提前确认能接住同样的任务。如果故障发生时才第一次走回退路径,大概率会出现第二次故障。
先给模型分层:旗舰、通用、轻量。每类任务映射到一个主模型和一个同层或相邻层的备用模型。不要所有请求都回退到最贵的模型,那样一次上游抖动就可能让账单失控,而且不少简单任务换到旗舰模型上也没有收益。
| 能力项 | 主模型 | 备用模型 | 是否兼容 | 切换前要做什么 |
|---|---|---|---|---|
| 上下文窗口 | 填写实际上限 | 填写实际上限 | 待核对 | 确认最长真实输入能装下,否则先做截断策略 |
| 工具调用 | 工具 schema、并行调用 | 同上 | 待核对 | 验证调用 ID 回传格式和参数结构 |
| 结构化输出 | JSON schema 或严格 JSON | 同上 | 待核对 | 用同一 schema 跑通过率,防止 422 |
| 多模态输入 | 图片、音频、视频 | 同上 | 待核对 | 确认输入格式和大小限制 |
| reasoning 参数 | 推理档位或思考字段 | 同上 | 待核对 | 不支持的参数要在切换时剔除或映射 |
| 价格与限流 | 以控制台为准 | 以控制台为准 | 待核对 | 估算切换后的成本,确认限额够用 |
| 地区与合规 | 允许范围 | 允许范围 | 待核对 | 确认备用线路在业务允许的地区和合规范围内 |
这张表建议每个任务类型填一份,“是否兼容”一列只填验证过的结果,不要凭印象填写。reasoning 参数最容易出问题:主模型支持的推理档位字段,换到备用模型上可能直接返回 400 或 422。切换逻辑里要有一层参数适配,而不是原样转发。
模型映射:模型 ID 以控制台为准
切换时最常见的低级错误是模型 ID 写错,结果拿到 404。建议维护一张“逻辑模型名到实际模型 ID”的映射表,业务代码只引用逻辑名。通过 API易 apiyi.com 调用时,各模型的准确 ID、可用状态和价格都以控制台和文档为准,接入方式统一使用 https://api.apiyi.com/v1 作为 base_url。映射表变更后,跑一次金丝雀请求再发布。
备用模型验证与多模型网关:金丝雀、日志和自动降级
结论:备用模型上线前要用真实任务验证;回退之后要验收输出,不能只看状态码是不是 200。多模型网关可以降低切换成本,但不能替你做质量验收。
备用模型验证三步走
- 金丝雀请求。选一组真实业务任务,同一提示、同一工具、同一输入,分别发给主模型和备用模型。
- 同题对比。比较通过率、延迟、首 token 时间、token 成本和失败率。工具调用类任务还要逐项核对调用 ID、参数结构和返回结构是否兼容。
- 回退后验收。真实切换发生后,对输出做自动校验,例如 JSON 能否解析、必填字段是否齐全、工具参数是否合法,并记录切换原因和验收结果。
回退路径要定期演练。可以每周人为把一小部分流量切到备用模型,确认链路仍然可用,避免依赖、参数或模型 ID 在不知不觉中失效。
日志字段建议至少包括:
- 请求 ID、模型 ID、端点、状态码、错误类、错误体摘要
- 延迟、首 token 时间、总耗时、重试次数、切换目标
- 输入 token、输出 token、缓存命中、估算费用
- 工具调用名称、调用 ID、是否执行成功
- 切换原因、切换后是否通过验收
多模型网关在容灾里的作用
自己对接多家厂商做容灾,至少要维护多套 Key、多套 SDK 和多套错误格式。用 API易 apiyi.com 这类聚合网关,一个 Key 就能调用 OpenAI、Claude、Gemini、DeepSeek、Qwen 等主流模型,接口兼容 OpenAI 标准,也支持 Claude、Gemini 原生格式。主备模型可以放在同一套接入代码里,切换时改的是模型 ID,而不是整条集成链路。
平台侧还提供多节点部署、智能路由、自动降级和负载均衡,可以吸收一部分上游抖动。不过网关层的自动降级不能替代业务层的判断:幂等检查、工具调用去重、输出验收,仍然要在你自己的代码里完成。比较稳妥的分工是:网关负责线路和节点层面的可用性,应用负责任务层面的正确性。
💡 容灾建议:设计主备模型时,可以先在 API易 apiyi.com 用同一个 Key 对主模型和备用模型跑同一组金丝雀任务,再把验证通过的组合写进模型映射表。新用户可以先用免费测试额度做验证。
模型 API 报错常见问题 FAQ
结论:下面五个问题覆盖了生产中争议最多的场景,回答都遵循同一个原则:先判断,再动作。
Q1:401 要不要重试?
不要。`401` 表示鉴权失败,重试只会增加请求量,甚至把问题变成 `429`。检查 Key 是否有效、`Authorization` 请求头格式是否正确、Base URL 是否和 Key 属于同一平台。使用 API易 apiyi.com 时,可以到控制台确认 Key 状态。
Q2:429 要不要马上换模型?
不建议马上换。先读错误体和 `Retry-After`:速率或并发限流,退避后重试 1 到 2 次通常就能恢复;额度耗尽时才切换线路。切换时选同层级的备用模型,不要一律切到最贵的模型。
Q3:流式输出中断,要不要重放?
先别急着重放。流中断不等于请求失败,可能已经生成内容并产生费用。先看已收到的 token 数量和内容是否可用:可用就保留或续写;不可用且请求幂等,再重放 1 次。实际计费以控制台用量为准。
Q4:工具调用出现重复执行怎么办?
根本做法是在工具层做幂等,用业务侧的幂等键或任务 ID 去重,同一 ID 只执行一次。工具调用超时后,先查任务状态,确认没有执行再重试。已经出现重复的,按调用 ID 回溯日志,补偿或撤销多出来的操作。
Q5:切换备用模型后返回 200,但结果不对怎么办?
200 只说明请求成功,不代表任务成功。对输出做自动校验,例如 JSON 结构、必填字段、工具参数合法性。校验失败要计入失败率,并触发告警或人工复核。如果某个备用组合频繁验收失败,就从映射表里撤下,重新跑金丝雀验证。
上线前检查清单与总结:什么时候重试、切换、停手
结论:上线前逐项核对下面这张清单,比故障发生后临时补逻辑可靠得多。记住那句判断:4xx 先修,5xx 才谈重试,非幂等请求先停手。
| 序号 | 检查项 | 通过标准 |
|---|---|---|
| 1 | 先判断错误类型 | 所有状态码都能归入五类之一,未知错误默认不重试 |
| 2 | 4xx 不自动重试 | 400、401、402、403、404、409、422 直接告警或修复 |
| 3 | 再决定重试或切换 | 只对瞬时错误重试,最多 1 到 2 次,带退避和抖动 |
| 4 | 尊重 Retry-After | 响应头存在时优先按它等待 |
| 5 | 幂等检查 | 工具调用、写操作、发消息、支付默认停手,查状态后再决定 |
| 6 | 流中断处理 | 先看已收 token 和费用,不盲目重放 |
| 7 | 备用模型核对 | 能力核对表已按任务类型填写并验证 |
| 8 | 模型映射 | 逻辑名到模型 ID 的映射与控制台一致 |
| 9 | 最后验收输出 | 切换后做结构和字段校验,不只看 200 |
| 10 | 日志与演练 | 关键字段齐全,回退路径定期演练 |
模型 API 报错处理 Key Takeaways
- 什么时候重试:
429、500、502、503、529和幂等的超时请求,有限次数并退避。 - 什么时候切换:重试仍失败、上游持续不可用或额度耗尽,且备用模型已验证。
- 什么时候停手:
401等 4xx 配置错误,以及状态不明的非幂等请求。 - 切换不等于成功:备用模型返回 200 后仍要验收输出。
- 网关和应用分工:线路可用性交给网关,任务正确性留在业务代码。
错误处理做得好不好,看的不是重试写得多积极,而是能否在每次报错时做对判断。建议先把错误分类、幂等标签和日志字段补齐,再逐步引入备用模型。备用线路可以考虑 API易 apiyi.com:一个 Key 覆盖多家主流模型,便于用同一套代码完成主备验证与切换,价格和可用性以控制台和文档为准。
📚 参考资料
- API易 文档中心:接入方式、模型列表与计费说明
- 链接:
docs.apiyi.com -
说明:模型 ID、价格和可用性以文档与控制台为准
-
HTTP 状态码语义说明:
Retry-After等标准响应头的含义 - 链接:
developer.mozilla.org/docs/Web/HTTP/Status - 说明:用于理解 4xx、5xx 的通用语义,具体含义以各模型平台错误体为准
作者:APIYI 技术团队
技术交流:欢迎在 API易 官网 apiyi.com 首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心