2026 年 10 月 27 日,Google DeepMind 发布了新一代世界模型 Genie 4。这次变化最大的地方,是生成出来的世界会自己发出声音,里面的人会开口说话,你还能一边看一边打字改场景。官方 X 首发帖到 10 月 28 日上午约有 170 万浏览、1.53 万赞。不过它现在还进不去,官方只开放给了一小批受信任测试者。
核心价值:用 3 分钟弄清 Genie 4 新在哪、现在能不能用,以及你下一步可以做什么。
Genie 4 一变:世界自己会说话了
一句话结论:Genie 4 生成的不再是一个只能看的哑场景,而是一个会出声、会回应、能随手改的现场。
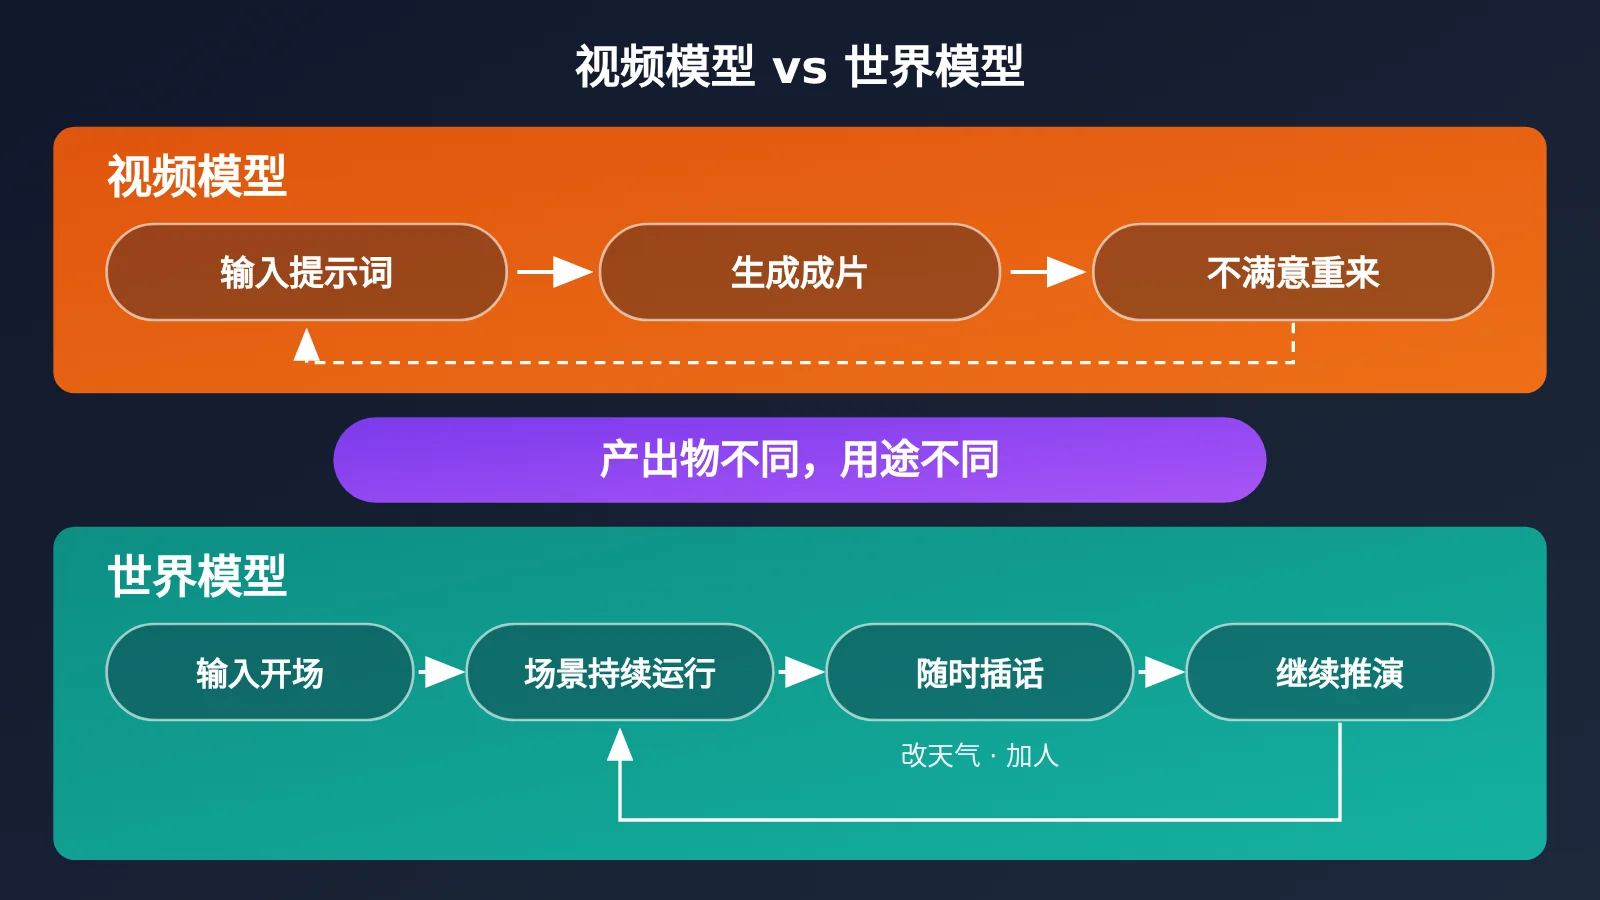
先解释一下“世界模型”。视频模型像给你一个门牌号,你拿到的是一段拍好的成片。世界模型更像一场现场演出,演员一直在台上,你喊一句“下雨”,台上就开始下雨,接下来的剧情也跟着变。官方博客把 Genie 4 的进步归成四项能力,下面逐条说明。
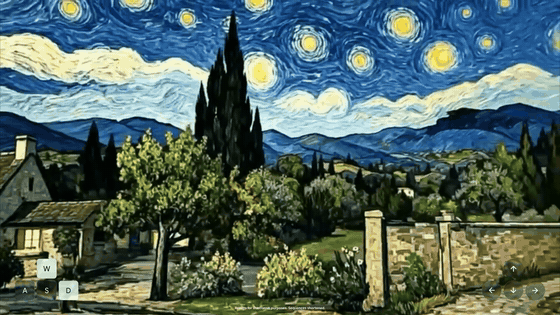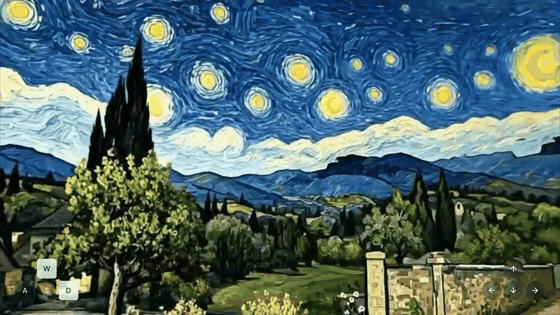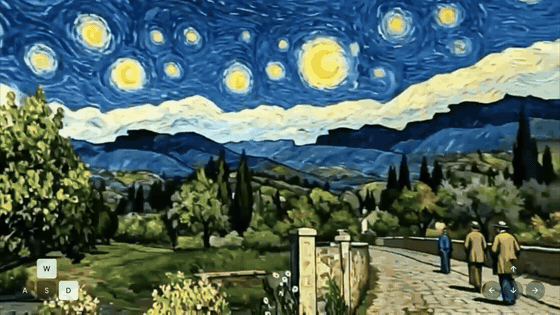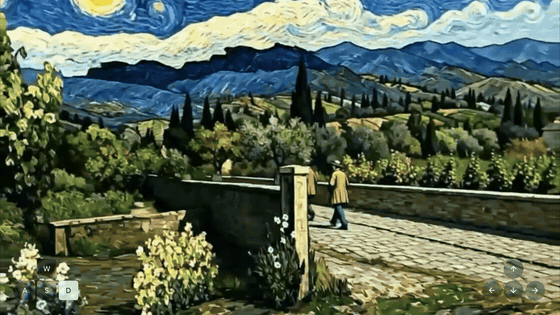
图注:官方发布片里,人物走进梵高《星夜》画出来的世界。来源:Google DeepMind 官方发布帖(2026-10-27),官方演示片段。
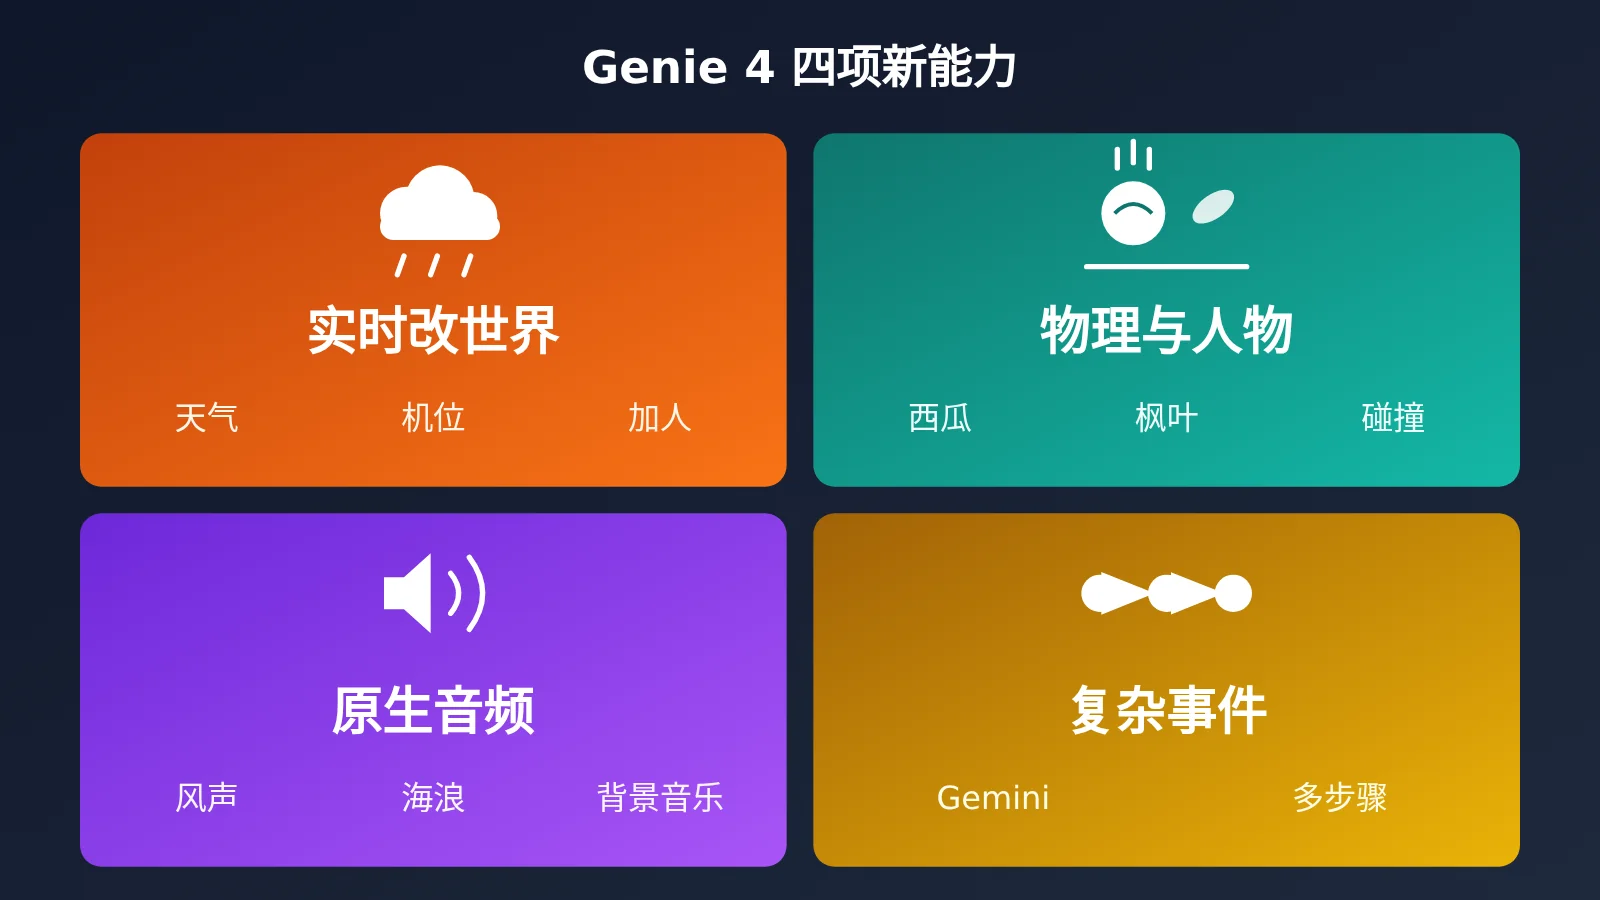
Genie 4 能力一:实时改变世界
官方博客说,你可以用自然语言实时修改正在运行的模拟,比如改天气、移动机位、加入新的人或物体。官方演示里,画面正在播放时输入一句指令,天气就会变化,镜头就会挪动,场景里也会多出一个人。
比较关键的细节是,官方称 Gemini 会结合周围场景,把你的提示词改写成更贴合当前画面的指令。在你两次输入之间,Gemini 也会持续观察并引导场景,让世界不会因为停止输入就“卡住”。
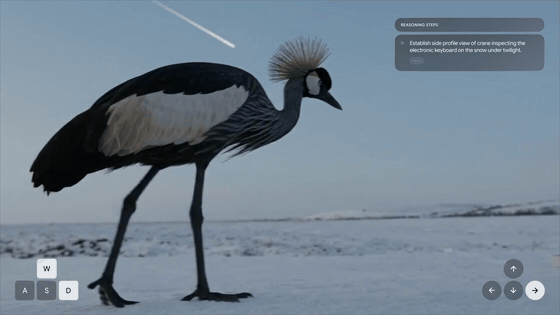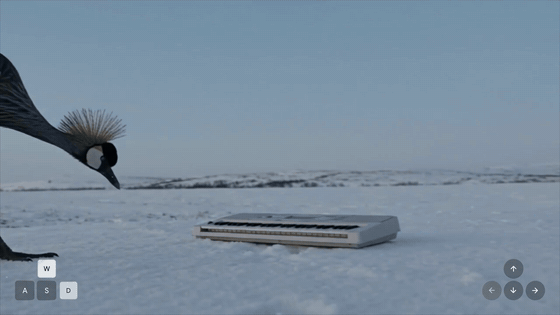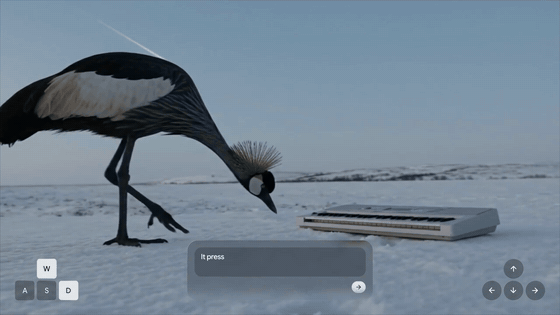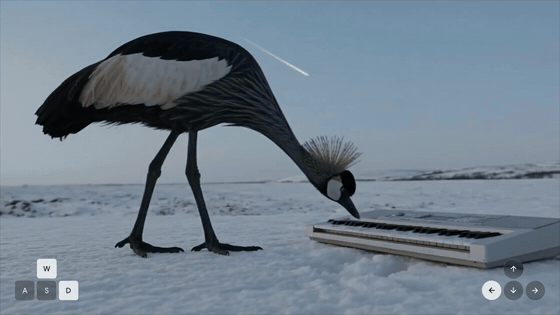
图注:画面还在跑的时候输入提示词,雪地里就多出一架钢琴,鹤走过去落在琴键上。来源:同上。
Genie 4 能力二:物理和人物更真实
官方博客说,Genie 4 能模拟空气动力学、碰撞这类真实物理。演示里有西瓜落地、枫叶飘落和互相碰撞的片段,需要注意这些都是 Google 自己放出来的演示。
官方认为最大的提升在“人”这一块:角色动作更自然,能对环境做出反应,也能被你实时操控。上一代 Genie 3 的人物相对僵硬,这次官方把它列为主要改进方向。
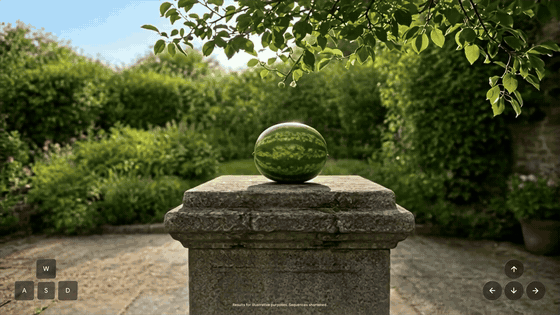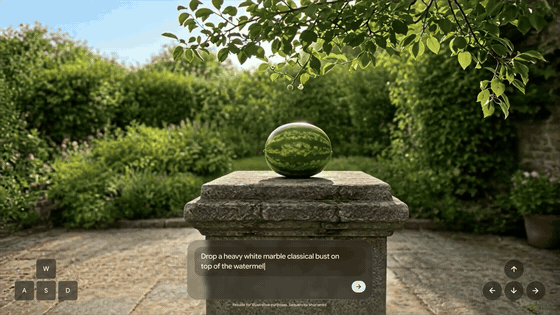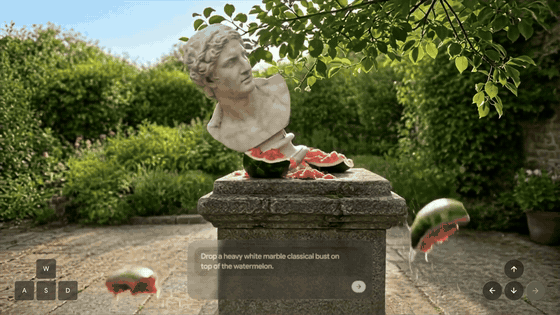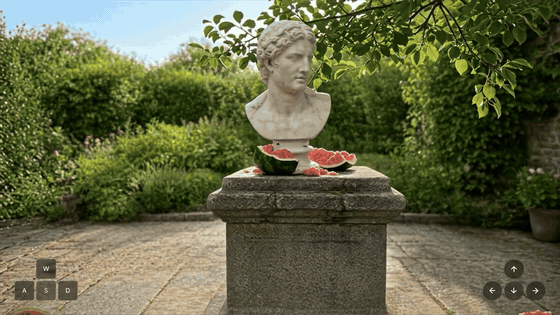
图注:只写一句“把大理石头像砸到西瓜上”,场景里就真的生成出头像,西瓜被砸碎、果肉飞溅。来源:同上。
Genie 4 能力三:原生生成声音
官方原话是,Genie 4 是他们“第一款原生生成音频的实时世界模型”。每个世界都会带上自己的环境音,从树林里的风声到海浪声,也可以有背景音乐。这些声音和画面同步生成,不是事后另外配上去的。
更进一步的是对话。官方博客说,角色会对你的输入或世界里发生的事情做出反应,并实时开口交谈。早期体验者 @venturetwins 在 X 上称这是“一大步”,特别提到“还带原生音频”。这只是个人观感,不代表效果已经得到验证。
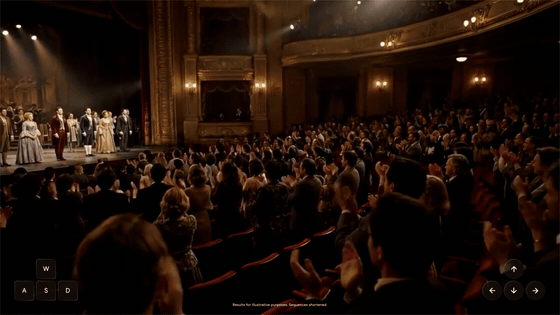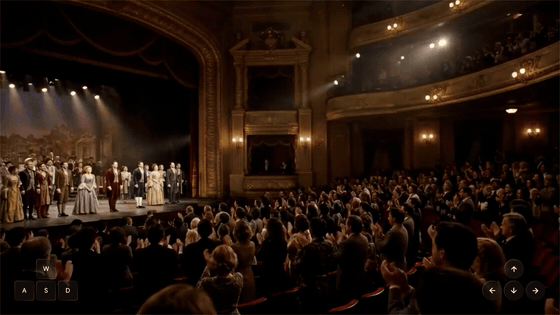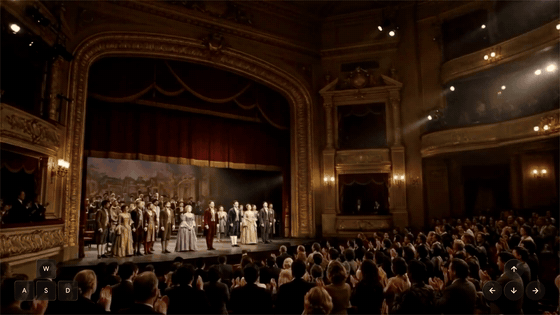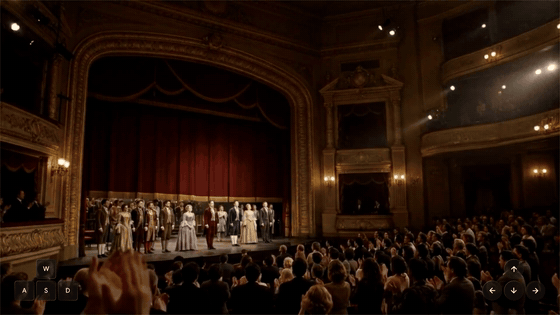
图注:歌剧院世界里镜头自己往上摇,看清穹顶。原片带环境音和角色对话,GIF 保留不了声音。来源:同上。
Genie 4 能力四:用 Gemini 模拟复杂事件
官方博客说,Genie 4 与 Gemini 结合后可以模拟多步骤事件。这样一来,AI 系统在进入真实世界之前,可以先在模拟环境里检验应对方式。这项能力主要面向机器人等研究场景,普通用户短期内接触不到。
Genie 4 二变:背后其实是三拨模型在配合
一句话结论:Genie 4 负责把像素画出来,几款 Gemini 模型分别负责外观、调度和拆解任务。
官方博客写明,Gemini Omni 负责把模拟锚定在真实世界的外观和行为上,也就是让画面里的东西看起来像真的。想了解 Omni 此前的背景,可以看《Gemini Omni 视频模型情报汇总:8 大信号锁定 I/O 2026 发布》。
被官方点名的第二个模型是 Gemini 3.8 Flash,官方称它是“在循环中的引导代理”。它不负责画画,更像片场的导演兼场记:持续观察画面,把目标拆成一步步动作,再回看生成的画面,判断每一步有没有完成。如果世界发生变化,或者用户中途插话,它会当场调整计划。
第三个是 Gemini 4 Argon,出现在 Gemini Robotics 相关实验里。官方举的例子是:Argon 把“下跳棋”这个任务拆成步骤,以文字字幕的形式实时交给 Genie 4,Genie 4 渲染出 Apptronik 的 Apollo 人形机器人下棋的画面。
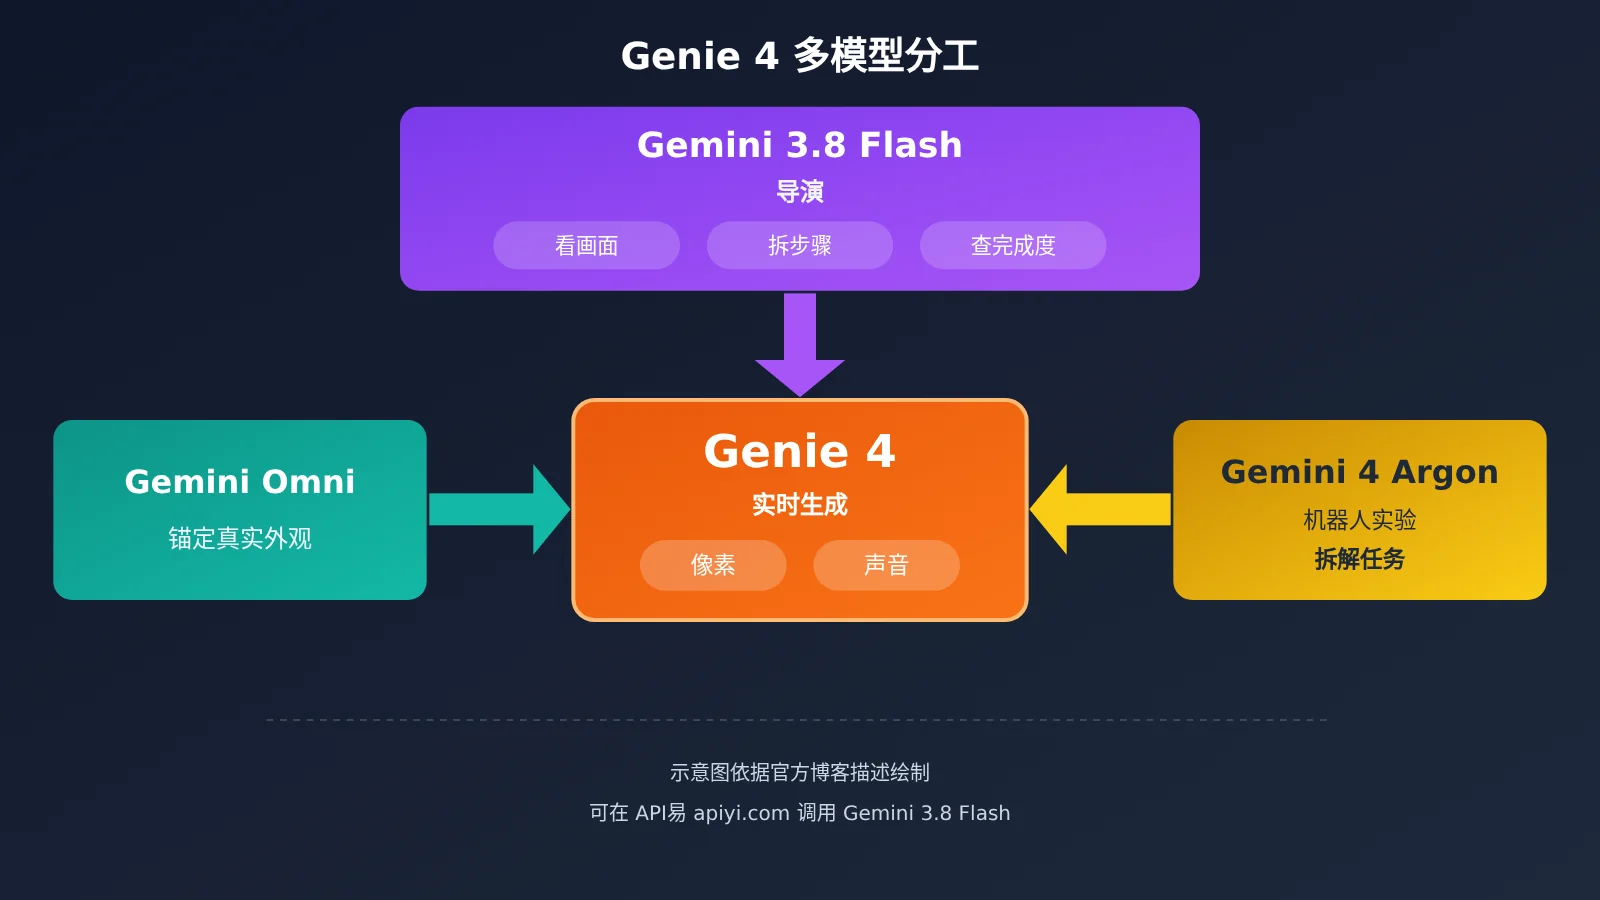
TechCrunch 引述的简报内容中,Google 研究总监 Tejas Kulkarni 提到未来会出现“混合世界模型”:由 Gemini 写代码和文本,Genie 实时接收这些内容并模拟现实。官方博客也提出了同样的方向,即 Gemini 负责结构和叙事时间线,Genie 负责像素级的物理表现。
Genie 4 三变:它和 Veo 这类视频模型不是一回事
一句话结论:视频模型交付的是一段成片,世界模型交付的是一个持续运行、可以随时介入的现场。
两者解决的问题不同,不存在谁替代谁。Veo 这类视频模型适合产出可直接剪进作品的固定片段。Genie 4 更适合构思、预演和交互原型,官方并没有把它定位成成片工具,也没有说它能取代游戏引擎。
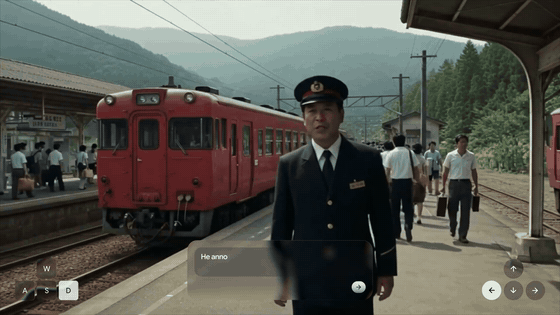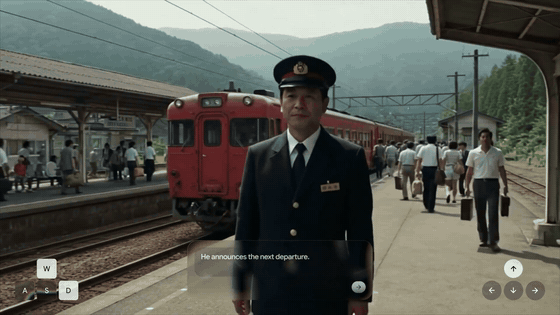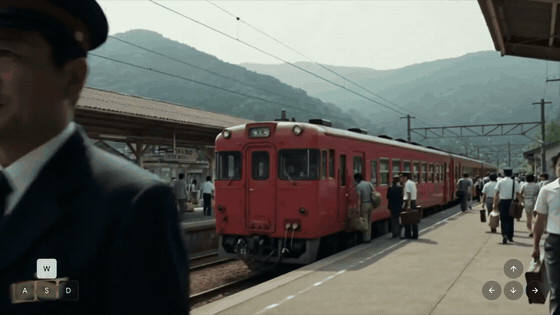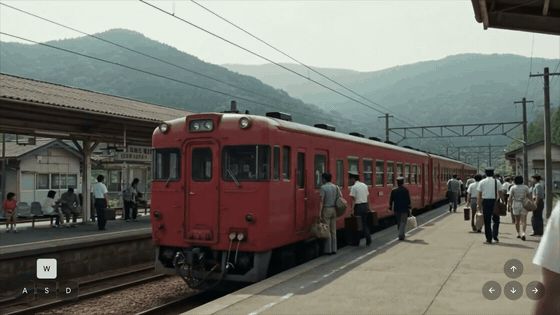
图注:1980 年代日本乡间车站,第一人称视角一路走过站台,人群自己在动。这正是视频模型给不了的部分。来源:同上。
| 对比项 | 视频模型(如 Veo) | 世界模型(Genie 4) |
|---|---|---|
| 产出物 | 一段固定的视频片段 | 一个持续运行、可交互的场景 |
| 能不能中途改 | 生成过程中不能改 | 可以随时用文字或操作改 |
| 想改结果要不要重生成 | 需要重新生成 | 不需要,场景会接着往下演 |
| 适合做什么 | 成片素材、广告、短视频 | 预演、分镜构思、交互原型、仿真研究 |
Genie 4 什么时候能用上
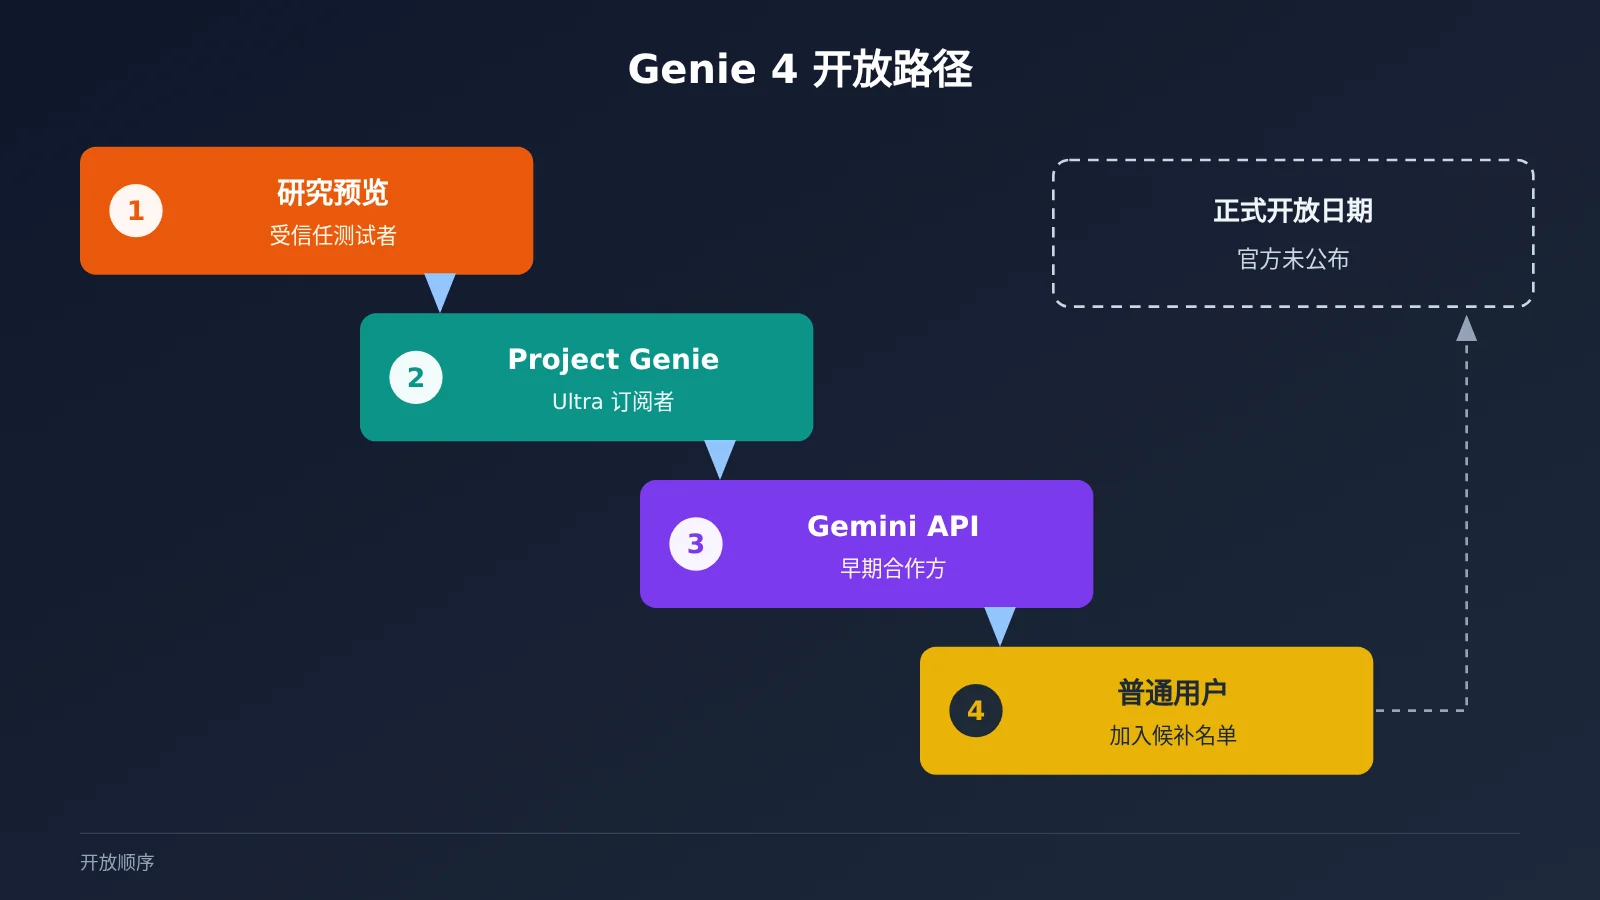
一句话结论:目前只有受信任测试者能用,普通用户只能先加入 waitlist 排队。
官方博客原话是:Genie 4 已作为研究预览开放给受信任测试者,收集反馈后,会先在 Google AI Ultra 订阅的 Project Genie 中开放,同时开放给 Gemini API 与 Google AI Studio 的 early access partners。
这里有两个概念需要说明。Project Genie 是 Google Labs 的实验网页应用,相当于世界模型的“体验展厅”,今年 1 月起挂在 Google AI Ultra 订阅里。early access partners 指提前拿到入场券的合作方,通常是企业或开发团队,并不是公开注册就能拿到的资格。
如果想排队,官方页面顶部有一个 Join the Genie 4 waitlist 入口,链接指向一张 Google 表单:forms.gle/WQnSNEM3omF7Uruu7,按表单要求填写即可。还要提醒一点:截至 10 月 28 日,Gemini 订阅页上 Project Genie 那一行写的仍然是 Genie 3,Genie 4 还没有出现在订阅权益里。正式开放日期官方没有公布。
Genie 4 现在还做不到的六件事
一句话结论:官方自己承认 Genie 4 仍是早期研究,短时间内表现较好,时间一长就容易出问题。
- 画面会漂移(官方博客):短时段内能保持连贯,但跑得久了、改词改多了,或者在场景里四处走动后,细节和物体的持续性会发生偏移,长期一致性仍在研究中。
- 复杂物理交互(官方博客):仍被列为研究中的方向。
- 实时音频的准确性(官方博客):声音能生成出来,但准确度还在改进。
- 清晰可读的文字(官方博客):画面里的招牌、文字可能渲染不清楚。
- 空间精度(官方博客):位置和距离关系还不够精确。
- 单次能跑多久:官方博客没有写。TechCrunch 根据简报报道称,Genie 4 最长可维持约两分钟的一致场景,是上一代的两倍。官方对照数据是 Project Genie 里 Genie 3 的单次生成上限为 60 秒,两者能对得上,但“两分钟”目前仍是媒体口径。
此外,分辨率、帧率、价格、调用额度、参数规模、API 上线时间,官方都没有公布。
社区里也有不同声音。X 用户 @dummerspast39 认为 Genie 4“不算新模型”,本质是 Omni 实时版加上 3.8 Flash 当助手。这只是单个用户的判断,没有给出证据,官方也没有回应。官方博客的说法是 Genie 4 “整合并建立在 Gemini 家族能力之上”。
国内读者现在能做什么
一句话结论:世界模型还要排队,但“做一段今天就能用的视频”现在就能做。
如果只是好奇,可以先加入 waitlist,同时关注官方博客和 SynthID 相关说明。SynthID 是 Google 的隐形水印技术,人眼看不出来,但可以被检测到。官方说 Genie 4 生成的视频和音频都会嵌入 SynthID,以后看到疑似 Genie 生成的内容,可以用这个思路去核实。
如果想马上动手,可以从 Genie 4 体系里能拿到的部分入手。官方点名担任“导演”的 gemini-3.8-flash,目前在 API易 apiyi.com 上可以调用。你可以让它把一段场景描述拆成镜头、动作和台词,先把分镜想清楚。视频方向,平台上已经有 Seedance 2.5 这类可用型号,可以把分镜直接做成片段。具体型号与价格以平台型号列表为准,可在 apiyi.com 查看。
这样做还有一个好处:一个 Key 就能调用多个模型,不需要为每个模型单独注册。接口兼容 OpenAI 格式,把 base_url 设为 https://api.apiyi.com/v1 即可接入现有代码。等 Genie 4 真正开放时,你手里已经有了一套“导演模型加视频模型”的工作流经验。
Genie 4 常见问题 FAQ
Q1:Genie 4 是什么?
Google DeepMind 在 2026 年 10 月 27 日发布的世界模型。它能实时生成可交互的环境,并且原生带声音和角色对话。
Q2:Genie 4 和 Genie 3 差在哪?
官方博客列出的新增内容包括原生音频、角色对话、更真实的人物动作,以及由 Gemini 实时引导。时长方面只有 TechCrunch 的“两分钟”口径,对照 Genie 3 在 Project Genie 里的 60 秒上限。
Q3:现在能用 Genie 4 吗?
普通用户暂时不能用。官方只处在研究预览阶段,只开放给受信任测试者,后续会面向 AI Ultra 的 Project Genie 用户和 API 早期合作方开放,具体日期没有公布。
Q4:Genie 4 有公开 API 和价格吗?
没有。官方没有公开 API、模型名和计费方式,它目前也不是可以购买的产品。想先体验周边能力,可以在 API易 apiyi.com 调用 Gemini 3.8 Flash 等已上线型号。
Q5:Genie 4 能替代视频生成工具吗?
不能这样理解。两者产出物不同,视频模型交付成片,Genie 4 适合预演和原型。需要成片素材时,仍然要用视频模型,可通过 API易 apiyi.com 一个 Key 调用多个视频型号。
Q6:官方演示的效果可信吗?
演示是 Google 自己放出的,早期体验者的评价也只是个人观感。官方承认画面会漂移、文字和空间精度仍有不足,最好等更多公开测试结果再下结论。
总结
Genie 4 最大的变化,是世界模型第一次同时具备了声音、对话和实时可控的能力,背后由 Gemini Omni、Gemini 3.8 Flash 等模型分工配合。不过它目前仍是研究预览,开放日期、价格和时长都没有官方数字,“两分钟”也只是媒体口径。
一句话带走:Genie 4 值得关注,但现在还用不上;想做内容,可以先用现有模型把分镜和视频做出来。 需要的话,可以在 API易 apiyi.com 用一个 Key 试试 Gemini 3.8 Flash 和视频型号。
参考资料
- Google DeepMind 官方博客:Genie 4: A new generation of world simulation
- 链接:
deepmind.google/blog/genie-4-a-new-generation-of-world-simulation - Google 官方博客:Introducing Genie 4
- 链接:
blog.google/innovation-and-ai/models-and-research/google-deepmind/introducing-genie-4 - TechCrunch 报道:Google’s Genie 4 world model adds audio, more realistic worlds, and real-time steering
- 链接:
techcrunch.com
作者:APIYI 技术团队
技术交流:欢迎在 API易 apiyi.com 首页联系我们,更多资料可访问 docs.apiyi.com 文档中心