摘要:本文依据公开的第三方测试报告,分析 Qwen4-Max-Preview 完成抓娃娃机、Python 服务修复和 1,600 条工单检索等任务的表现,并说明它在耗时和科研判断上的边界。
结论先行:Qwen4-Max-Preview 编程能力的核心判断
公开测试报告显示,Qwen4-Max-Preview 能够推进多步骤开发,补充测试,并交付可复验的项目。最有力的证据来自一次代码修复任务:模型先复现缺陷,再新增测试、发送真实 HTTP 请求并校验数据完整性,最终 57 项测试全部通过。它的短板同样明确:复杂任务耗时较长,抓娃娃机任务用了约 75 分钟;在科研任务中,模型对计算结果的解释超出了证据范围。因此,复杂交付物和科学结论都需要开发者审核。
下文先从抓娃娃机任务切入,再梳理一份覆盖 12 项任务的报告,重点分析代码修复与工单检索两组可核验证据。随后用非负矩阵分解案例说明模型的推理边界,再结合同一抓娃娃机挑战的跨工具对照讨论效率问题,最后给出适合交给它的任务类型。本文为公开报告的测评分析,我们没有重新运行作者的项目,所有数字均标注来源和测试条件。
To Know:理解 Qwen4-Max-Preview 测评的 9 个术语
| 术语 | 解释 |
|---|---|
| Agent | 模型自行规划步骤、调用工具并逐步推进任务的工作方式。 |
| 状态机 | 用一组状态和状态之间的转换规则来控制程序行为,例如抓娃娃机的“移动—下抓—上提—结算”。 |
| 回归测试 | 修改代码后重新验证已有功能,确认旧行为没有被改坏。 |
| HTTP 请求 | 客户端向服务端发送的请求,用来检验接口在真实运行时返回什么结果。 |
| 哈希校验 | 计算文件内容的摘要值,前后对比即可判断原始数据或测试文件是否被改动。 |
| Token 吞吐 | 单位时间内处理或生成的 Token 数量,数值受工具、网络和运行环境影响。 |
| 上下文检索 | 在一次请求携带的大量资料中定位并关联目标信息。 |
| 非负矩阵分解 | 把一个非负数据矩阵近似拆成两个非负因子矩阵相乘的算法。 |
| 局部最优解 | 在邻近范围内无法继续改进的解;判断一个解是否为局部最优,需要额外的数学条件或分析。 |
1 75 分钟完成抓娃娃机:Qwen4-Max-Preview 的一项复杂编程任务
1.1 抓娃娃机任务考察什么
2026 年 11 月 12 日,人人都是产品经理刊发了一篇基于 Qoder 的 Qwen4-Max-Preview 实测报告,其中最复杂的一项是抓娃娃机交互系统。这项任务把多种编程难点集中在一个项目里:机械交互与力反馈、绳索悬垂摆动、娃娃之间的碰撞、控制流程的状态机,以及最终的计分逻辑。
这类任务很难靠一次性生成完成。物理效果、状态切换和计分规则彼此依赖,模型需要反复编写、运行、观察和修正,因此它考察的是 Agent 式的多步骤推进能力。
1.2 作者记录的耗时、速度和消耗
| 指标 | 作者记录 | 测试条件与说明 |
|---|---|---|
| 总耗时 | 约 75 分钟 | Qoder 环境,单次任务 |
| 输出速度 | 约 33 Tokens/s | 该次任务中观测到的速度 |
| Credits 消耗 | 约 65 | 作者估算,Token Plan 计量 |
| 交付质量 | 较扎实 | 作者主观评价,认为整体可与 Kimi K3.1 打平 |
这组数字只属于该次任务。Credits 是 Token Plan 的订阅计量单位,实际消耗受输入、缓存命中、输出、思考 Token 和工具调用共同影响,65 Credits 只能说明这次任务的花费量级。33 Tokens/s 同样是特定环境下的观测值。
同一份报告还记录了另外几项任务。在只使用 NumPy 和 PIL 的水墨画任务中,模型生成了超过 1,000 行代码,绘制约 4,019 个笔触,并用像素明度统计和 ASCII 轮廓扫描自检,发现燕子与窗洞黑块重叠后主动调整了坐标。作者认为它的代码组织和自检能力较强,审美表现仍有提升空间。
2 Qwen4-Max-Preview 的十二项真实任务覆盖了什么
2.1 一份更全面的测试报告
11 月 16 日,人人都是产品经理刊发了一份 Z Finance 测试报告,作者称完成了 12 项任务,并对关键结果做了抽查和复验。下表按报告覆盖的任务整理:
| 类别 | 测试任务 | 主要考察能力 |
|---|---|---|
| 视觉生成 | 鹈鹕骑自行车 SVG | 视觉理解、代码生成 |
| 财务分析 | 三份财报联合分析 | 长文档理解、财务口径 |
| 图表识别 | Apple 产品收入柱状图 | 图表读取、数值估计 |
| 办公协作 | 会议纪要三轮修改 | 上下文保持、修改一致性 |
| 数据处理 | 44 行销售数据清洗 | 去重、单位转换、公式 |
| 演示文稿 | 平头哥上市 PPT | 实时检索、文件生成 |
| 长文本检索 | 1,600 条客服工单 | 跨记录关联、条件筛选 |
| 代码维护 | Python 工单服务修复 | 缺陷定位、测试与回归 |
| 科研复现 | 非负矩阵分解算法 | 算法实现、数值验证 |
| 网页开发 | 招股书资料展示页面 | HTML、离线交付、交互 |
| 仿真系统 | 雨水花园模拟 | 交互设计、数值计算 |
| 游戏开发 | 四季主题 3D 小游戏 | 3D 场景、状态管理、交互 |
2.2 五个值得关注的案例
这 12 项任务中,以下五项最能说明模型交付“可用成果”的能力:
- 财报分析:输入 Apple、Costco 的 FY2026 年报和 Anthropic 第二版招股书,约 8 分钟完成。抽查的 6 个关键数字全部正确,模型区分了经营亏损与净亏损,指出了可转债公允价值变动对净亏损的影响,对未披露的未来指引没有自行编造。
- Excel 清洗:44 行销售明细中混入了重复记录、仅有空格差异的重复数据、元与万元两种单位、三种日期格式和 5 笔缺失订单。清洗后剩 35 行,四个区域合计 215,700 元,5 个汇总单元格均使用真实公式,修改明细后汇总值能自动更新。
- PPT 生成:模型通过实时检索识别出分拆公告信息,生成可编辑的 PPT,并区分了估值预测与发行定价;第二轮调整受众后,原有 20 个关键数字、日期和名称都保持不变。作者也指出存在产品线遗漏。
- 工单检索与 Python 修复:这两项证据最具体,分别在第 4 节和第 3 节展开。
这些任务的共同点是交付物可以被检查:公式能不能联动,数字和原文是否一致,测试能否通过。这类证据比“生成了一段看起来正确的代码”更有说服力。
3 57 项测试通过:Qwen4-Max-Preview 最有说服力的工程证据
3.1 修复过程完整还原
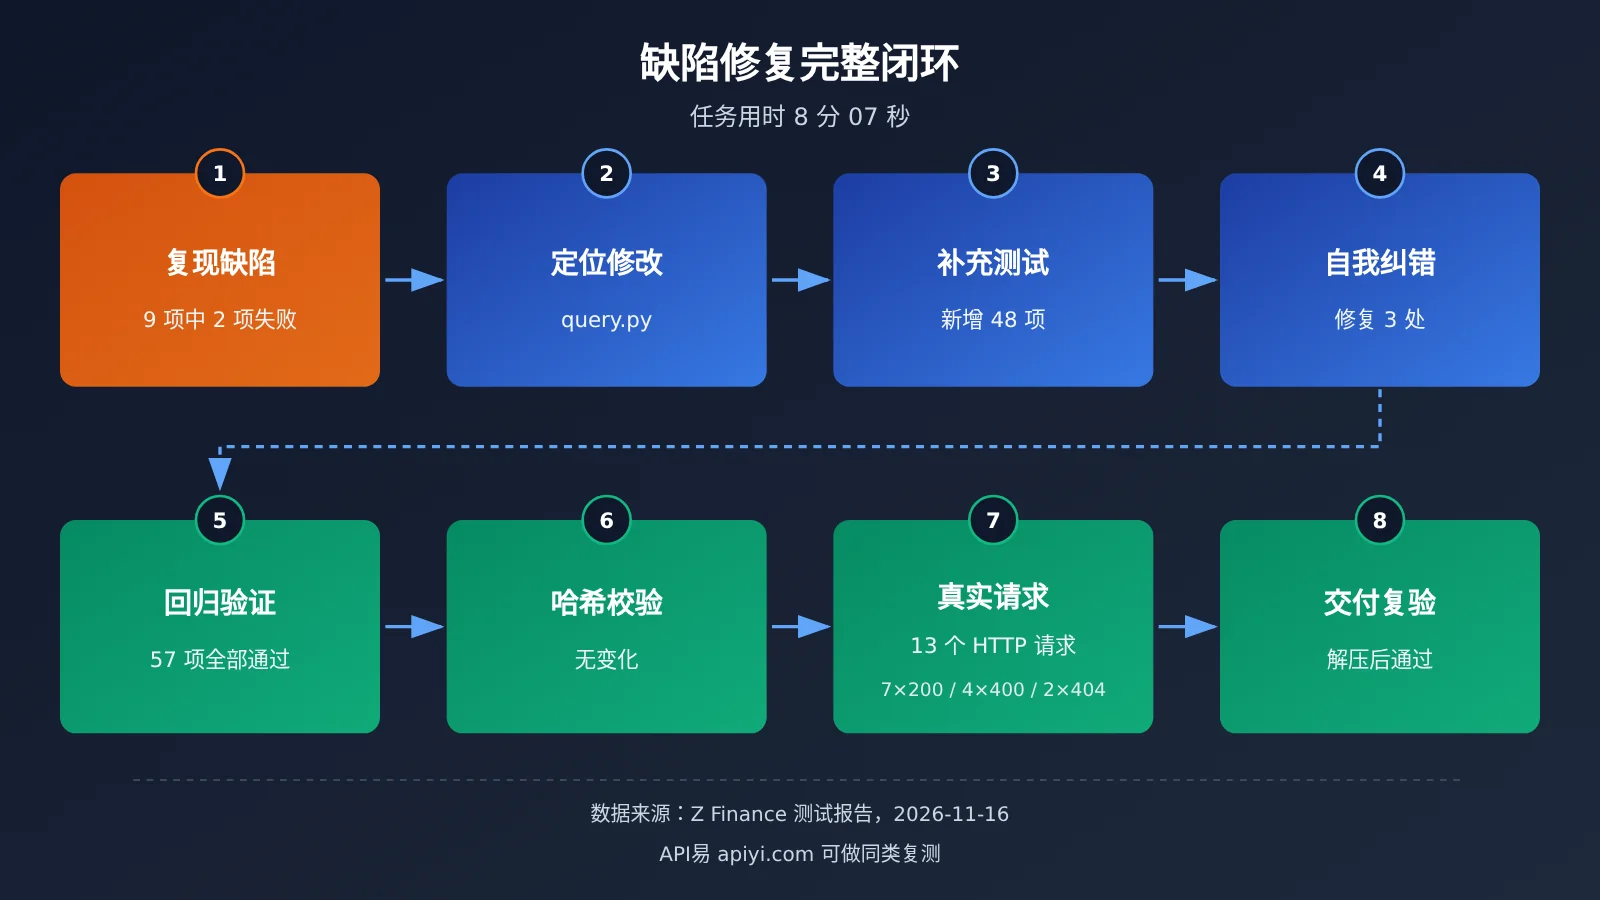
被测对象是一个用 Python 标准库编写的工单查询服务,缺陷涉及组合筛选、排序、分页和参数校验。任务要求修复缺陷,同时保留接口、原始数据和原有测试。报告记录该次任务用时 8 分 07 秒,过程如下:
| 步骤 | 模型的动作 | 工程意义 |
|---|---|---|
| 复现缺陷 | 先运行原有 9 项测试,复现其中 2 项失败 | 先确认问题存在,再动手修改 |
| 定位修改 | 主要修改集中在 query.py | 改动范围收敛,降低副作用 |
| 补充测试 | 新增 48 项测试 | 覆盖原测试未覆盖的边界情况 |
| 自我纠错 | 修复自编测试中的 3 处问题 | 发现测试本身写错并及时纠正 |
| 回归验证 | 最终 57 项测试全部通过 | 9 项原有测试加 48 项新增测试 |
| 完整性检查 | 对原始数据和原有测试做哈希校验,哈希无变化 | 证明没有靠篡改数据或测试来“通过” |
| 真实请求 | 启动本地服务发送 13 个 HTTP 请求,得到 7 个 200、4 个 400、2 个 404 | 验证接口运行时的正常响应与错误处理 |
| 交付复验 | 解压最终交付包后再次运行,测试通过 | 确认交付物本身可以独立运行 |
3.2 为什么这比生成代码更能说明问题
AI 编程中常见的失败方式有两种:一是改动测试或数据让测试“变绿”,二是代码在测试里通过,在真实运行时出错。该次任务的哈希校验针对第一种风险,真实 HTTP 请求和交付包复验针对第二种风险。4 个 400 和 2 个 404 响应说明模型也验证了错误路径,参数校验和不存在资源的处理都经过实际检验。
这一流程与成熟工程师修 Bug 的习惯一致:复现、修复、补测、回归、交付。它证明 Qwen4-Max-Preview 在一个规则明确、规模可控的服务中具备完整的维护闭环。这仍是一次任务的记录,无法换算成通用的代码修复成功率。
4 百万上下文的实际价值:在 1,600 条工单中找到相隔 741 行的线索
4.1 测试设计与结果
官方公布的 Qwen4-Max-Preview 上下文窗口为 1,000,000 Tokens。窗口大小只是容量上限,决定实用价值的是模型能否在大量材料中建立正确关联。Z Finance 报告中的工单测试回答了这个问题。
测试数据为 1,600 条客服工单,体量约 50 万字节,关键线索分布在相隔 741 行的两条记录中,共提出 5 个问题。报告记录 5 个问题全部答对,具体表现包括:
- 把两条分散的工单关联起来,找到 1,386 元退款金额及经手人。
- 依据审批日期,判断补偿券新政策是否适用于该案例。
- 统计出 62 条符合指定条件的工单,与脚本统计结果一致。
- 找出两组重复订单号,并区分哪组属于正常流转、哪组属于客户信息冲突。
4.2 字节和 Token 是两种单位
约 50 万字节是文件大小,Token 数量取决于分词方式和中英文比例,两者需要分开计算。这项测试证明的是“中等规模资料中的跨记录关联与条件筛选”,它的规模远小于 100 万 Token 的窗口上限,因此不能当作极限容量的压力测试。
第 3 项结果的价值在于可核对:62 条与脚本统计一致,说明模型的计数可以用确定性程序复核。实际使用时也建议采用同样的做法,用脚本核对模型给出的统计结果,再把模型用于关联和解释这类脚本难以完成的部分。
5 不能忽视的短板:Qwen4-Max-Preview 在科研推理中的过度结论
5.1 计算做对了,解释超出了证据
科研复现任务要求依据指定论文实现非负矩阵分解的乘法更新算法。输入矩阵为 48×36,使用三组不同初值,每组迭代 500 次。报告记录模型用时 10 分 06 秒,交付了代码、数值结果、图表和日志;三组结果各提供 52 个检查点,A 组关键检查点与公开参考结果吻合,另有 63 项自查记录。
问题出在结论环节。模型仅凭目标函数持续下降,就把结果解释为收敛到局部最优解。作者指出这属于过度推断。
5.2 三个需要分开判断的概念
这个案例涉及三个层次的判断,后者都需要比前者更强的证据:
- 目标函数下降:乘法更新规则的设计特性,日志和图表可以直接观察到。
- 数值迭代收敛:需要检查迭代量的变化是否趋于稳定,并设定明确的停止标准。
- 收敛到局部最优解:需要验证最优性条件,例如 KKT 条件,单看函数值下降无法得出。
这说明模型的执行能力和论证严谨性需要分别评估。数值计算可以靠检查点验证,科学结论则需要具备相关背景的人审核。在研究、论文复现或技术报告场景中,模型输出的“结论段”应作为草稿处理。
6 Qwen4-Max-Preview 与其他编程工具的同任务对照
6.1 抓娃娃机挑战的对照数据
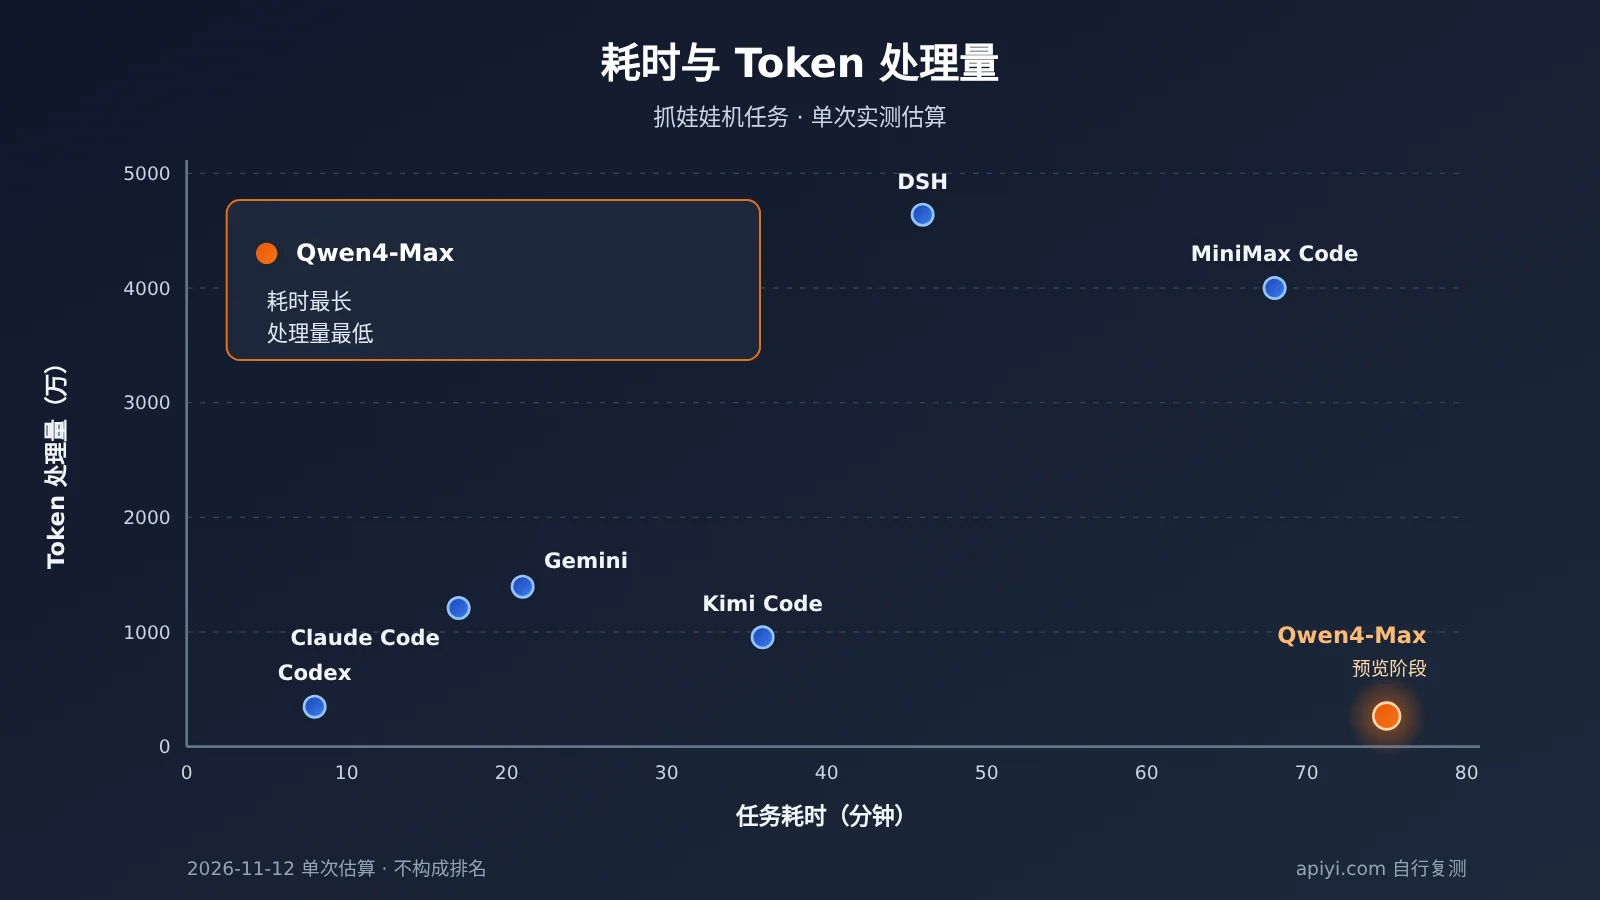
11 月 12 日的报告还给出了同一抓娃娃机挑战在不同工具中的记录。原表中的 Qwen 一行标注为 Qwen4-Max,测试时间为 11 月 12 日,早于正式版 11 月 16 日上线,对应的是预览阶段的模型。
| 工具/模型 | 耗时 | Token 总处理量(估算) | 输出 Token | 复测入口 |
|---|---|---|---|---|
| Codex | 8 分钟 | 350 万 | 2.8 万 | 对应官方工具 |
| Claude Code | 17 分钟 | 1,215 万 | 13 万 | 官方工具;Claude 模型可经 API易 apiyi.com 调用 |
| Gemini | 21 分钟 | 1,394 万 | 8.1 万 | 官方工具;Gemini 模型可经 API易 调用 |
| Kimi Code | 36 分钟 | 950 万 | 5.9 万 | 对应官方工具 |
| DSH | 46 分钟 | 4,644 万 | 28.1 万 | 对应官方工具 |
| MiniMax Code | 68 分钟 | 4,000 万 | 19.8 万 | 对应官方工具 |
| Qwen4-Max(预览阶段) | 75 分钟 | 269 万 | 5.5 万 | Token Plan(Qoder) |
6.2 如何读这组数据
数据呈现出一个明显的反差:Qwen4-Max-Preview 在该任务中的 Token 总处理量最低,约 269 万,耗时却最长,约 75 分钟。结合约 33 Tokens/s 的观测速度可以看出,该次任务的瓶颈在生成速度,消耗的 Token 规模本身并不大。
这组数据不适合做排名,原因有三点:Token 总量是作者估算的;各工具的上下文缓存占比、调用策略和执行方式不同;表中各模型的具体版本也没有统一说明。Token 处理量低可能来自更少的重复读取,也可能来自工具层的缓存策略差异,现有材料无法区分。它能支持的判断是:在这个工具环境里,Qwen4-Max-Preview 适合对等待时间不敏感、更在意交付完整性的任务。
7 哪些开发者值得尝试 Qwen4-Max-Preview
7.1 适合与谨慎使用的场景
综合两份报告,Qwen4-Max-Preview 在以下任务中表现较稳定:
- 规则明确的代码维护:有现成测试、问题边界清楚的修复和补测任务。
- 长文档检索与关联:工单、日志、合同、财报中的跨记录查找,配合脚本复核统计结果。
- 办公自动化:数据清洗、带公式的 Excel、可编辑 PPT 和多轮修改。
- 交互原型开发:单文件网页、模拟系统和小游戏原型,例如报告中约 46KB、无外部依赖的离线展示页。
需要谨慎的是三类任务:对响应时间敏感的交互开发(单次任务可能持续一小时以上)、需要严格数学或科学论证的结论输出,以及高可靠性要求的生产变更。报告作者的总结也包括“范围较宽的任务中部分信息会遗漏”和“仍需要人工核验最终交付物”。
使用前还要注意官方限制:Preview 只能通过阿里云 Token Plan 在 Claude Code、Cursor、Qoder 等工具中交互式使用,不支持按量付费,预览期至 2026 年 11 月 25 日 24:00(北京时间)结束后下线。正式版 Qwen4-Max 已于 11 月 16 日上线,官方建议迁移到正式版。两者参数不同:正式版思考模式最大输出为 262,144 Tokens,Preview 为 393,216 Tokens,迁移时需要重新设置输出预算。
7.2 用自己的任务做一次同类复测
二手报告最多只能说明“这个模型做得到”。决定它是否适合你的团队,最直接的方法是拿自己的真实代码和测试做一次对照。下面的示例通过 OpenAI 兼容接口发送一项代码修复任务,并记录耗时和 Token 用量。模型名称请以平台模型列表中的实际名称为准。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 统一接口,OpenAI 兼容
)

resp = client.chat.completions.create(
    model="qwen4-max",  # 以 API易 模型列表中的实际名称为准
    messages=[{"role": "user", "content": "阅读以下代码与失败的测试,给出最小修复补丁:..."}]
)
print(resp.choices[0].message.content)
查看多模型对照复测脚本
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 一个 Key 调用多家模型
)

# 替换为平台模型列表中的实际名称
MODELS = ["qwen4-max", "claude-sonnet-model-name", "gpt-model-name"]

TASK = """你将收到一个 Python 服务的源码和测试结果。
要求:1) 先说明复现到的失败原因;2) 只修改必要文件;
3) 补充覆盖边界条件的测试;4) 不得修改原始数据和已有测试。
--- 源码与测试输出 ---
{payload}
"""

def run_case(model: str, payload: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": TASK.format(payload=payload)}],
        max_tokens=32000,  # 思考模型的思考 Token 也占用输出预算,需预留空间
    )
    usage = resp.usage
    return {
        "model": model,
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,
        "answer": resp.choices[0].message.content,
    }

if __name__ == "__main__":
    payload = open("bug_context.txt", encoding="utf-8").read()
    for m in MODELS:
        r = run_case(m, payload)
        print(f"{r['model']}: {r['seconds']}s, "
              f"in={r['prompt_tokens']}, out={r['completion_tokens']}")
        # 将补丁应用到隔离目录,运行测试并对原始数据做哈希校验后再评分
脚本只负责收集方案和用量,评分环节要照搬报告中的做法:在隔离目录里应用补丁,运行原有测试和新增测试,用哈希值确认数据和旧测试没有被改动。这样得出的结论才对你的代码库有效。
🚀 快速开始:如果要在同一组任务上对比多个模型,可以通过 API易 apiyi.com 获取免费测试额度。平台提供 OpenAI 兼容接口,一个 API Key 即可切换 OpenAI、Claude、Gemini 等主流模型,便于把复测脚本跑在同一套评测流程里。
8 Qwen4-Max-Preview 测评常见问题
Q1:75 分钟完成抓娃娃机,说明它速度慢吗?
在该次 Qoder 任务中,它的耗时是对照表里最长的,观测输出速度约 33 Tokens/s。这只是单一环境下的记录,工具调度和网络条件都会影响结果。如果你的场景对等待时间敏感,建议用自己的任务实测。
Q2:57 项测试通过能代表它的代码修复成功率吗?
它代表一次完整、可核验的修复过程,无法换算成成功率。想评估在自己项目中的表现,可以通过 API易 apiyi.com 用同一组缺陷样本对比多个模型,按测试通过情况和哈希校验结果打分。
Q3:工单测试是否验证了 100 万 Token 上下文?
没有。该测试约 50 万字节,Token 数量取决于分词方式,规模远小于窗口上限。它验证的是跨记录关联和条件筛选能力。
Q4:Preview 结束后应该怎么办?
官方已上线正式版 Qwen4-Max,并建议使用正式版。正式版支持按量付费 API,思考模式最大输出为 262,144 Tokens,迁移时需要调整输出预算。第三方平台的上架情况和价格变化较快,可以在 API易 apiyi.com 的模型列表中确认当前可用的模型名称后再接入。
Q5:能把 Token Plan 的 Key 放进自己的应用后端吗?
不能。官方规定 Token Plan 仅限在允许的编程工具和智能体工具中交互式使用,自动化脚本批量调用和自建应用后端都不在允许范围内,违规可能导致订阅暂停或 Key 被封禁。自建应用应选择符合使用范围的 API 产品。
9 Qwen4-Max-Preview 测评 Key Takeaways
- 交付闭环:代码修复任务覆盖复现、修复、补测、哈希校验、真实请求和交付复验,57 项测试通过。
- 长文本关联:1,600 条工单中跨 741 行关联线索,5 问全对,62 条统计与脚本一致。
- 办公交付:Excel 公式可联动,PPT 多轮修改后 20 个关键事实保持不变。
- 速度短板:抓娃娃机任务约 75 分钟,Token 处理量低、耗时长。
- 推理边界:科研复现的计算与参考结果吻合,结论存在过度推断,需要人工审核。
- 证据性质:以上均为单一作者的任务实测,不构成标准化排名。
- 上手方式:用自己的代码与测试做对照复测,可借助 API易 apiyi.com 在一个接口内切换多个模型。
10 总结:开发者应该把 Qwen4-Max-Preview 用在哪里
公开报告给出的画像比较清晰。Qwen4-Max-Preview 擅长有明确规则和可检验结果的工作:带测试的代码维护、长资料中的跨记录检索、带公式的数据处理和可编辑办公文件,以及交互原型开发。它在这些任务中能自己补测试、自己查错,并交付可以复验的成果。
它的限制同样具体:复杂任务耗时较长,适合放在后台运行;科学结论容易超出证据范围,需要专业审核;Preview 只能通过 Token Plan 在指定工具中交互使用,并将于 11 月 25 日下线,长期使用应转向正式版。
最务实的做法是把它当作一名能独立完成维护闭环的工程助手,由开发者负责结论把关和最终合并。上线前,建议用自己的真实任务做一次多模型对照,通过 API易 apiyi.com 统一接口即可在同一流程里完成测试与比较。
📚 参考资料
-
人人都是产品经理:Qwen4-Max 预览版来了!实测,谈谈感受:Qoder 抓娃娃机实测与跨工具对照,2026-11-12
- 链接:
woshipm.com/ai/6492544.html - 说明: 75 分钟耗时、33 Tokens/s、65 Credits 及对照表来源
- 链接:
-
人人都是产品经理:实测 Qwen4-Max-Preview(Z Finance 测试报告):12 项任务综合测试,2026-11-16
- 链接:
woshipm.com/evaluating/6494229.html - 说明: 代码修复、工单检索、科研复现、办公任务数据来源
- 链接:
-
阿里云 Model Studio:Qwen4-Max-Preview 文档:官方规格与使用说明
- 链接:
help.aliyun.com/zh/model-studio/qwen4-max-preview - 说明: 上下文窗口、最大输出、预览时间与接入方式
- 链接:
-
阿里云 Model Studio:Qwen4-Max 文档:正式版参数与计费
- 链接:
help.aliyun.com/zh/model-studio/qwen4-max - 说明: 正式版输出预算与按量付费信息
- 链接:
-
阿里云:Token Plan 权限与使用规范:使用范围限制
- 链接:
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - 说明: 交互式使用要求与禁止场景
- 链接:
作者:API易 技术团队
技术交流:欢迎在 API易 apiyi.com 网站首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心