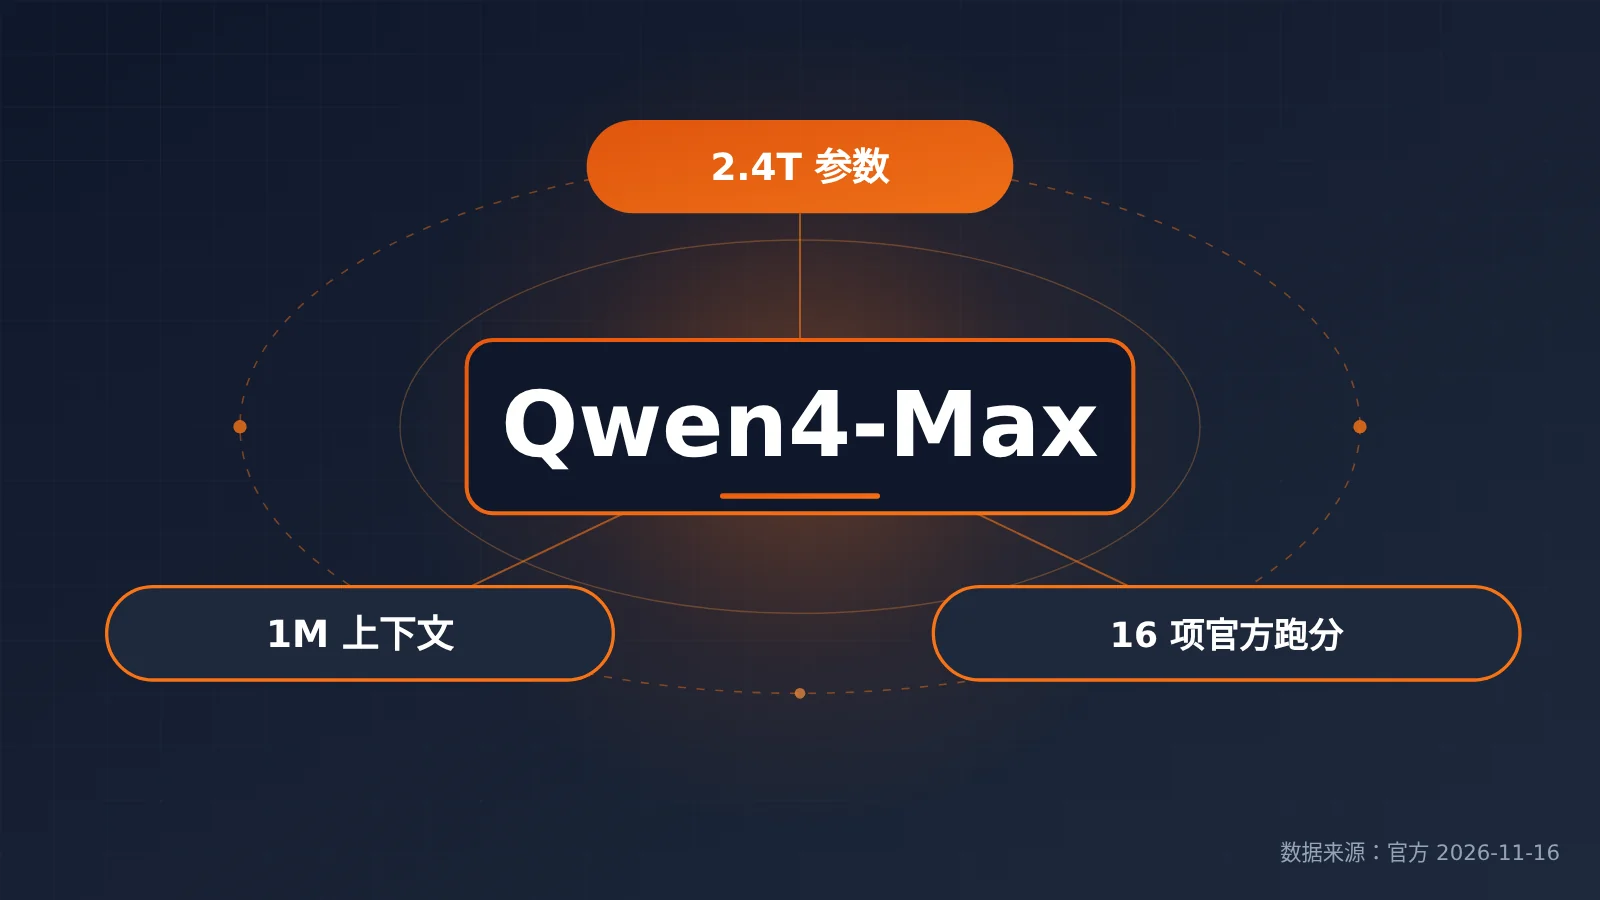
阿里通义团队于 2026-11-16 上午发布了 Qwen4-Max。主干参数 2.4T,上下文 1M,同时给出了一张包含 16 项跑分的对比图。
先说结论:Qwen4-Max 真正领先的是 token 效率和长程交付,并不是每一项都排第一。 在 16 项官方自报跑分里,它拿到 4 个第一、4 个第二;终端操作、程序构建、图表理解和视频理解这几项,仍明显落后于同图里的头部对手。
本文的信息来源只有三类:2026-11-16 的官方发布材料、arena.ai Code Arena WebDev 公开榜的终榜快照(2026-11-14),以及 QwenCloud 和千问AI平台的两处挂牌价。未公布的参数细节和第三方复现结果不在本文范围内。如果你手上正在跑 Qwen3.8-Max 或其他旗舰模型,读完可以按三类任务分别判断要不要换,并用输入价、输出价和缓存价自己算一笔账。
Qwen4-Max 发布信息速览
| 信息项 | 详情 |
|---|---|
| 发布时间 | 2026-11-16 10:01(UTC+8) |
| 发布方 | 阿里巴巴通义千问(Qwen)团队 |
| 参数规模 | 2.4T 主干参数,每 token 激活 71B,另有 328B N-gram Embedding 参数 |
| 上下文 | 1M,原生视觉 |
| 官方渠道 | QwenCloud API、Qwen Studio、QwenWork、Qoder、千问 App |
| 开源计划 | 官方表示更小尺寸的 Qwen4 会开源权重,Max 本身未提开源 |
从发布节奏看,这次不只是一个 API 型号的更新。Qwen4-Max 同时进入了 QwenWork(办公)和 Qoder(编程)两款自有产品,官方材料也把重点放在 agent 长任务和行业交付上,没有把纯问答能力作为主打。
Qwen4-Max 架构的三处改动
官方博客列出了三项结构改动,下面逐条说明它们解决什么问题:
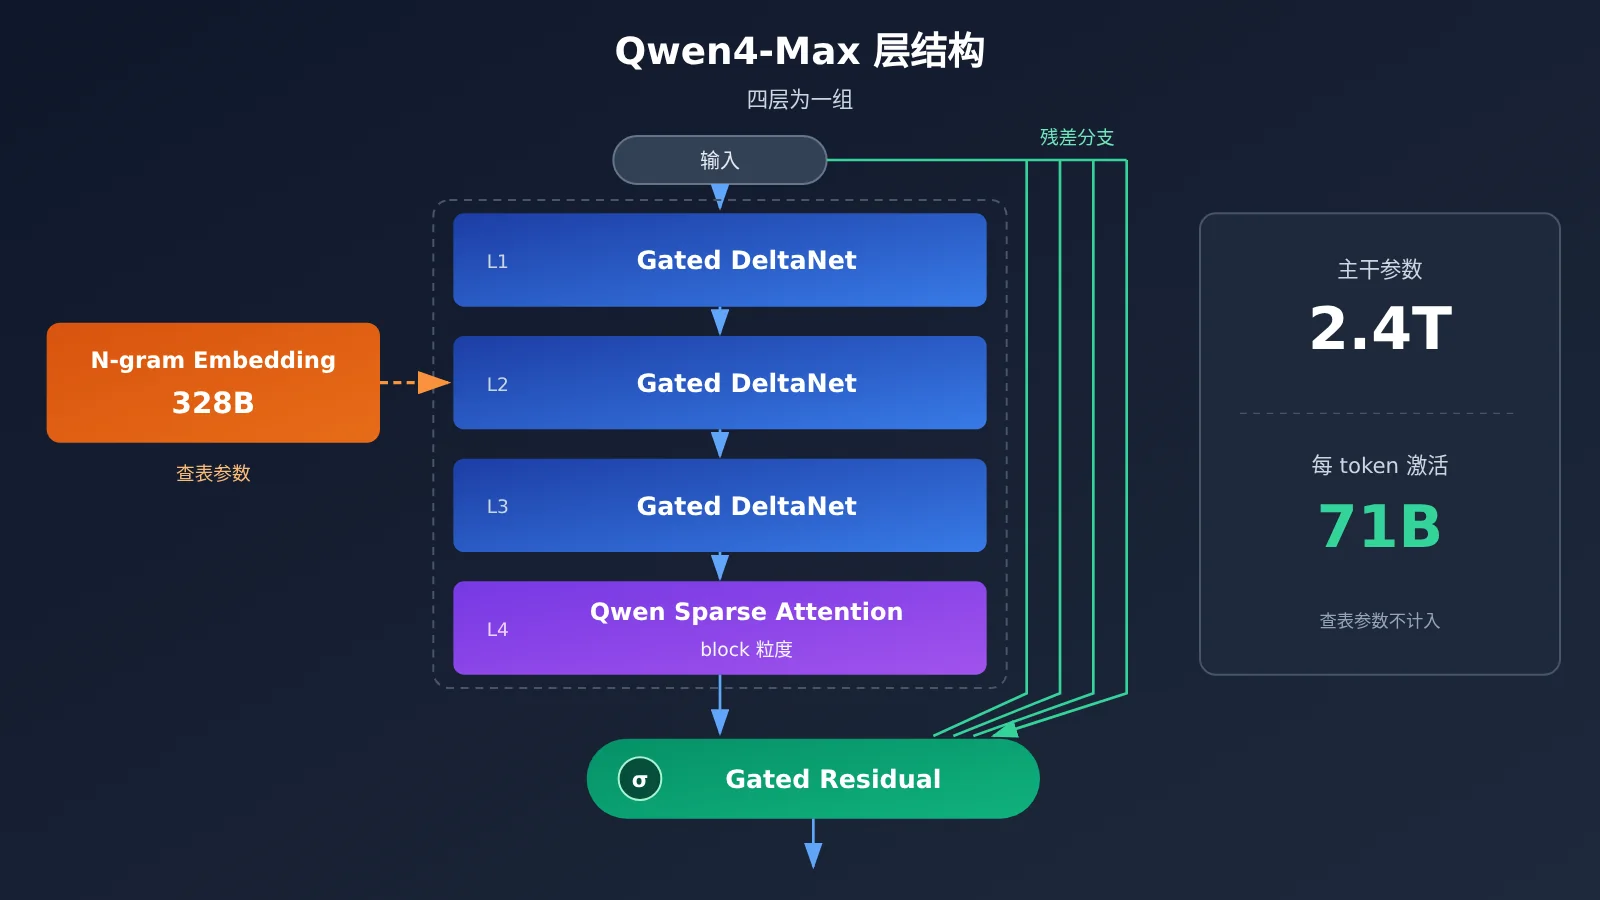
- GDN + QSA 混合注意力:每四层中有三层使用 Gated DeltaNet,另一层使用 Qwen Sparse Attention,并以 block 为粒度选择上下文。这样安排的主要目的是降低 1M 长上下文下的计算开销。
- Gated Residual:残差路径拆成四条并行分支,再通过门控合并,用于提升深层网络的表达能力。
- N-gram Embedding:在第二层查表,补充局部 token 模式。328B 的额外参数就来自这里,它们属于查表参数,不参与每个 token 的激活计算。
需要注意,2.4T 是主干参数总量,每个 token 实际激活的是 71B。拿它和其他模型比”参数大小”时,要先确认双方用的是同一个口径。
Qwen4-Max 规格与协议
| 规格项 | Qwen4-Max |
|---|---|
| 上下文窗口 | 1M |
| 最大输入 | 991K(思考模式下为 983K) |
| 最大输出 | 393K |
| 最大思维链 | 262K |
| TPM | 500 万 |
| 兼容协议 | OpenAI Chat Completions、Responses、Anthropic Messages、DashScope |
默认 reasoning_effort |
high(Qwen3.8-Max 默认为 xhigh) |
最后一行很容易被忽略。Qwen4-Max 默认的推理档位是 high,比上一代默认的 xhigh 低一档。如果你直接用默认参数对比新旧两代,看到的 token 节省有一部分来自档位差异,而不完全来自模型本身。做 A/B 测试时,建议把 reasoning_effort 显式设成相同的值。
Qwen4-Max 16 项官方跑分:领先与落后
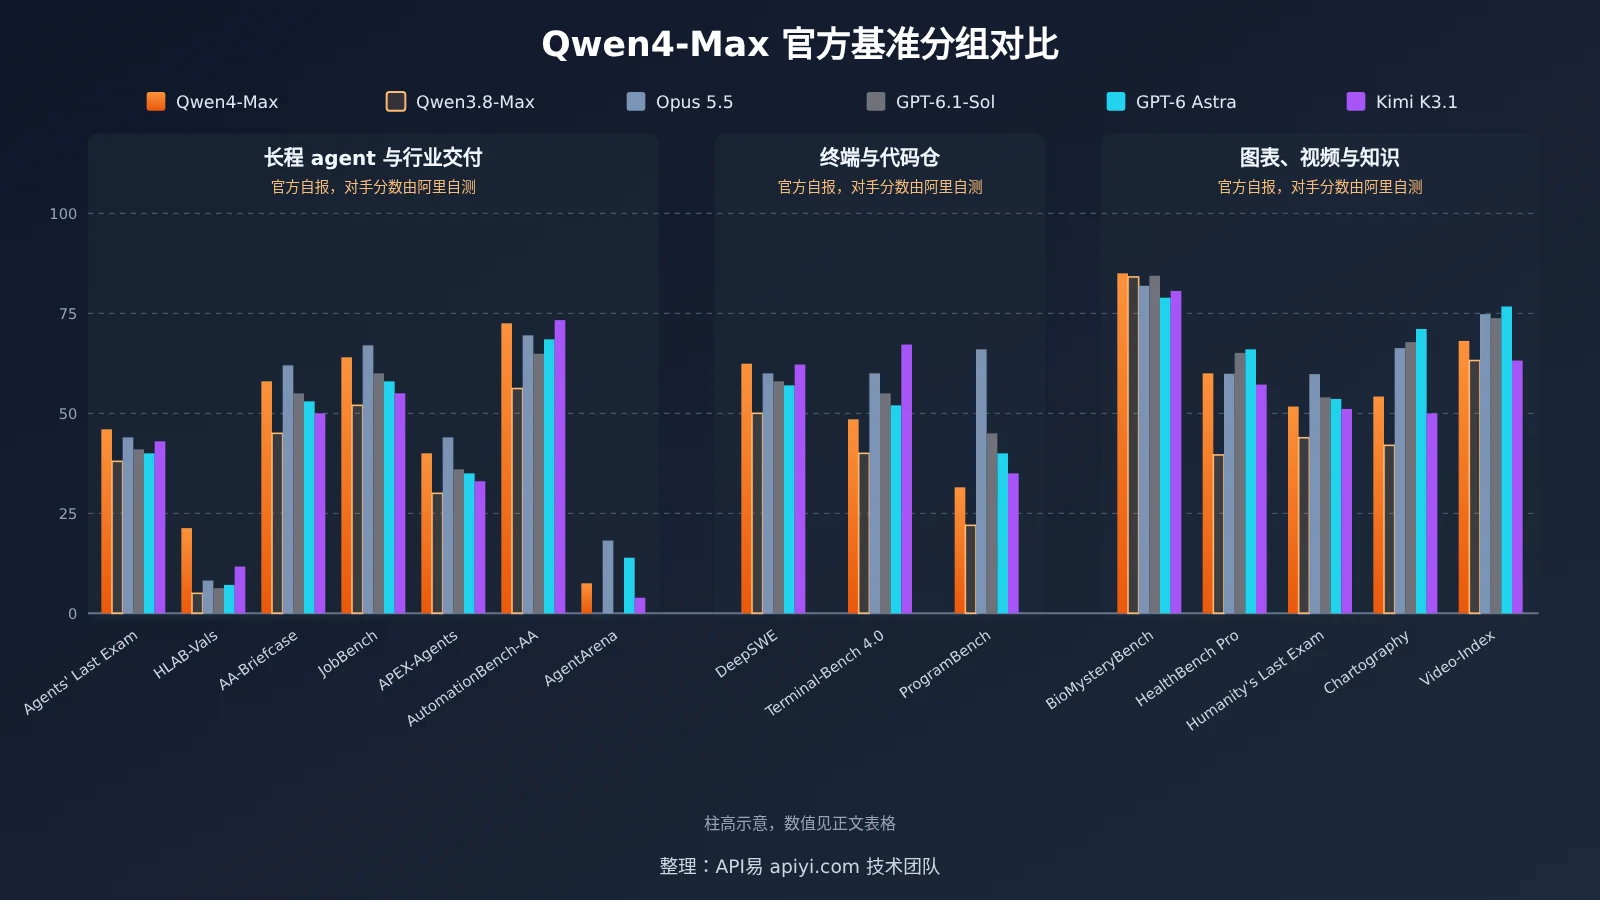
下表的全部分数都来自官方发布的同一张图,属于官方自报。图中对手的分数也是阿里自己测出来的,不能当作 Anthropic、OpenAI 或月之暗面公布的官方成绩。其中 CodeArena 与 AgentArena 引自 LM Arena,AA-Briefcase 与 AutomationBench-AA 引自 Artificial Analysis,APEX-Agents 引自 Mercor 榜,JobBench 由阿里用更新后的数据集和评测代码自行测试。
| 基准 | Qwen4-Max | Qwen3.8-Max-0902 | Opus 5.5 | GPT-6.1-Sol | GPT-6 Astra | Kimi K3.1 |
|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 75.7 | 69.3 | 74.2 | 75.2 | 74.1 | 75.5 |
| CodeArena WebDev(Elo) | 1750 | 1676 | 1816 | 1742 | 1763 | 1686 |
| Terminal-Bench 4.0 | 48.5 | 38.9 | 59.6 | 56.1 | 59.1 | 67.2 |
| ProgramBench | 31.5 | 28.0 | 65.0 | 52.5 | 55.0 | 25.0 |
| AA-Briefcase v1.1(Elo) | 1686 | 1605 | 1801 | 1555 | 1569 | 1674 |
| Agents’ Last Exam v1.1 | 46.7 | 27.9 | 43.4 | 42.6 | 43.4 | 未标 |
| JobBench | 68.5 | 65.3 | 75.4 | 66.2 | 66.1 | 61.2 |
| APEX-Agents v1.1 | 72.1 | 63.3 | 73.5 | 60.0 | 64.7 | 65.5 |
| HLAB-Vals-1.1 | 21.3 | 15.4 | 9.2 | 6.3 | 7.1 | 11.7 |
| AutomationBench-AA | 72.5 | 56.2 | 69.5 | 64.9 | 68.5 | 73.3 |
| AgentArena(Net Improvement) | 7.5 | — | 18.2 | — | 13.9 | 3.9 |
| BioMysteryBench | 85.0 | 84.1 | 81.9 | 84.4 | 78.9 | 80.6 |
| HealthBench Professional | 60.0 | 39.6 | 59.9 | 65.1 | 66.0 | 57.2 |
| Humanity’s Last Exam | 51.7 | 43.9 | 59.8 | 54.0 | 53.6 | 51.1 |
| Chartography | 54.2 | 42.0 | 66.3 | 67.8 | 71.1 | 50.0 |
| Video-Index | 68.1 | 63.2 | 74.8 | 73.8 | 76.7 | 63.2 |
Qwen4-Max 领先的项目
Qwen4-Max 排第一的有四项:DeepSWE、Agents’ Last Exam、HLAB-Vals 和 BioMysteryBench。其中 HLAB-Vals 的差距最大,21.3 分约为第二名 Kimi K3.1 的两倍。DeepSWE 只比 Kimi 高 0.2 分,这个差距基本可以视为持平。
另外四项排第二:AA-Briefcase、JobBench、APEX-Agents 和 AutomationBench-AA。前三项的第一名都是 Opus 5.5,最后一项的第一名是 Kimi K3.1。这些基准都偏向长程 agent 和白领工作交付,也正是官方这次主打的方向。
Qwen4-Max 落后的项目
终端与程序构建是这次最明显的短板。Terminal-Bench 4.0 的 48.5 分在六个模型中排第五,比第一名 Kimi 少 18.7 分。ProgramBench 的 31.5 分不到 Opus 5.5 的一半。如果你的 agent 主要在 shell 里跑构建、调试和部署,这两项比 DeepSWE 更有参考价值。
图表和视频理解同样落后。Chartography 和 Video-Index 都排在第四,距离第一名 GPT-6 Astra 分别差 16.9 分和 8.6 分。Humanity’s Last Exam 也排第四。所以”原生视觉”指的是能力具备,不代表这方面领先。
Qwen4-Max 在 Code Arena 公开榜的位置
arena.ai Code Arena WebDev 的公开榜终榜快照(2026-11-14)共有 1,007,405 票、159 个模型。Qwen4-Max(xHigh)以 1750 分排第 6,标记为 Preliminary,只有 1,814 票,页面显示的单任务成本 P50 为 $4.18。排在它前面的依次是 Claude Fable 5.2、Claude Opus 5.5、Claude Sonnet 5.5、Gemini 4 Carbon(Preliminary)和 GPT-6 Astra。
上一代 Qwen3.8-Max(0902)在同一榜单上是 1676 分、第 16 名,因此这一代提升了 74 分、10 个名次。不过 Qwen4-Max 的票数还比较少,后续排名可能还会变化。
Qwen4-Max 的 token 效率与”成本降六成”从何而来
官方的效率数字来自其自建的 Work360 场景基准。这套基准有 26 个一级领域、182 个二级领域和 721 个三级领域,Qwen4-Max 得分 52.69,Qwen3.8-Max 为 47.74。在 token 消耗上,Work360 的 Xhigh 档约少 24%,High 档约少 35%;在 Terminal-Bench 4.0 上,两档分别约少 48% 和 49%。
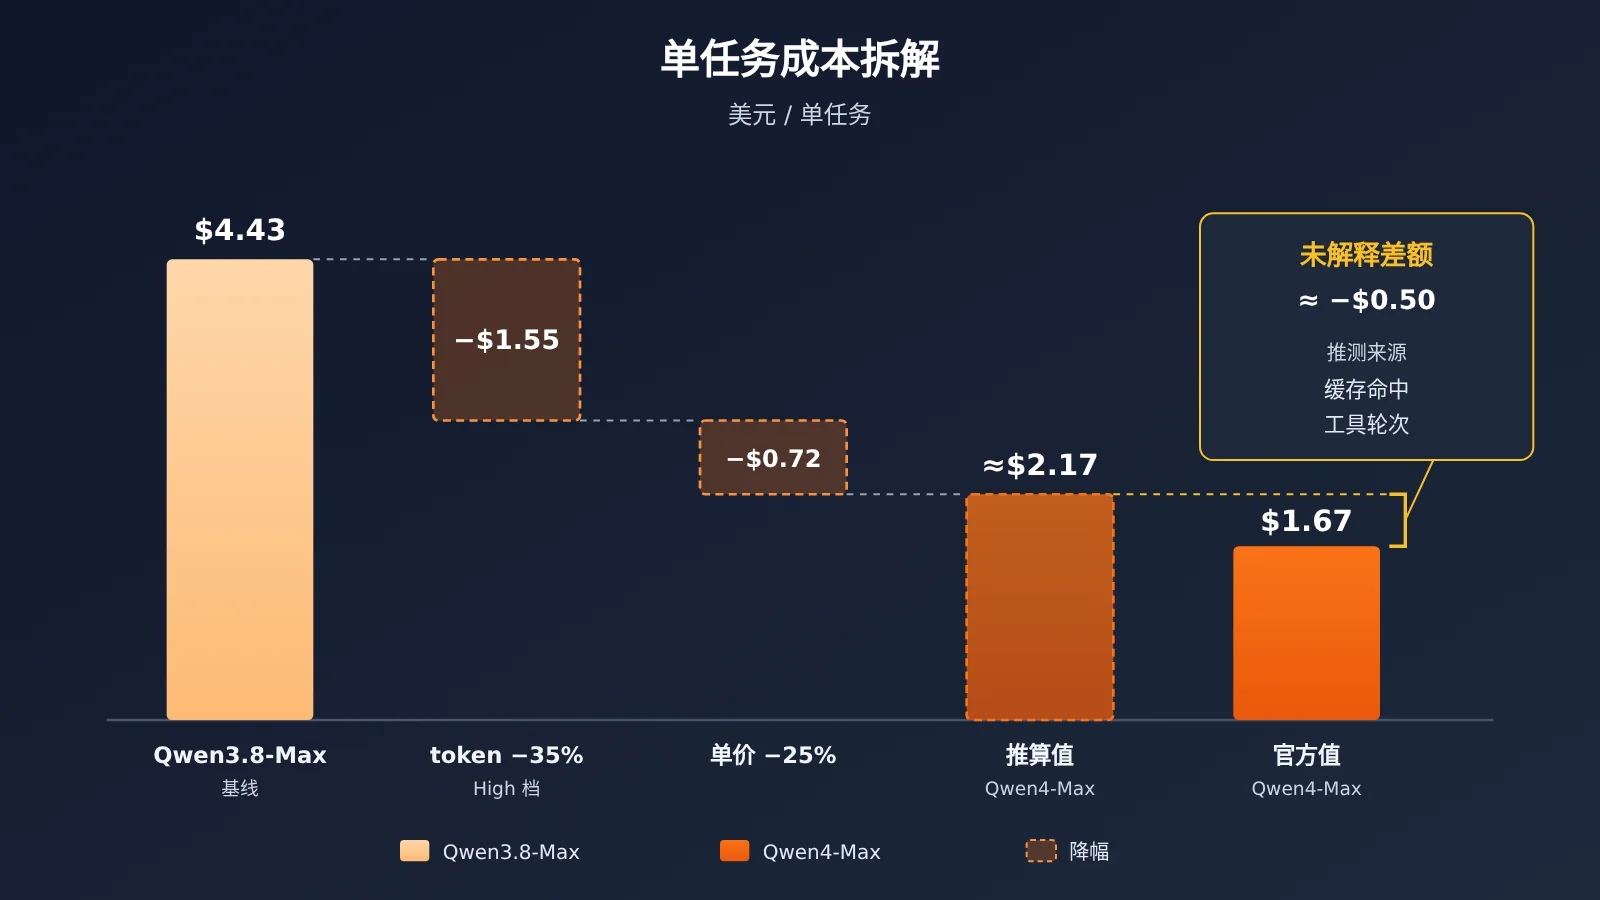
单任务平均成本方面,官方给出的数字是从 $4.43 降到 $1.67,中文博客口径为 ¥26.58 降到 ¥11.16,降幅 58%。按美元数字计算的降幅约为 62%。但如果只用”token 少 35% × 单价降 25%”来推,结果约为 0.65 × 0.75 ≈ 0.49,也就是降 51% 左右。中间这部分差额官方没有解释,比较可能的来源是缓存命中率提高、工具调用轮次变少,但这只是推测,不能当作已经确认的原因。
安全方面,Last Secure Code Bench 函数级的”功能与漏洞双通过率”从 22.0% 提升到 31.8%。函数、文件、仓库三个粒度都生成安全代码的比例,从 8% 提升到 14.7%。绝对值仍然不高,生成的代码依然需要人工审查。
Qwen4-Max 价格怎么算
下面列出 Qwen4-Max 的官方价格,以及上一代模型的官方价和 API易 现价,单位都是 美元 / 1M tokens,取数日期为 2026-11-16。
| 计费项 | Qwen4-Max(QwenCloud 官方) | Qwen3.8-Max(官方) | qwen3.8-max(API易 apiyi.com 现价) |
|---|---|---|---|
| 输入 | $1.5 | $2 | $1.65 |
| 输出 | $4.5 | $6 | $4.95 |
| 缓存读 / 命中 | $0.075 | $0.25 | $0.20625 |
| 5 分钟显式缓存创建 | $1.875 | — | — |
| 1 小时显式缓存创建 | $3 | — | — |
人民币价格以千问AI平台为准,单位为 人民币 / 1M tokens,取数日期 2026-11-16:
- 输入 ¥10,输出 ¥30,缓存命中 ¥0.5
- 5 分钟显式缓存创建 ¥12.5,1 小时显式缓存创建 ¥20
与上一代官方价相比,Qwen4-Max 的输入价和输出价各低 25%,缓存读价低 70%。缓存读价降幅最大,这对长程 agent 影响明显,因为多轮任务里大量重复的系统提示和历史上下文都会按缓存价计费。
自己估算成本时,可以按这个公式拆开算:未命中输入 × 输入价 + 缓存命中 × 缓存价 + 显式缓存创建量 × 创建价 + 输出(含思维链)× 输出价。举个假设的例子:一个任务有 1M 输入,其中 60 万命中缓存,输出 10 万。用 Qwen4-Max 官方价计算约为 $0.6 + $0.045 + $0.45 ≈ $1.10;在相同 token 量下,用 Qwen3.8-Max 官方价计算约为 $1.55。实际差距还要再叠加 token 消耗的变化,所以最可靠的做法是拿自己的真实日志重新跑一遍。
💰 算账提示:API易 目前还没有上架 qwen4-max,我们会尽快上架这个模型,具体型号名和价格以 apiyi.com 平台的型号列表为准。上架之前,可以先用平台上的
qwen3.8-max建立成本基线,等新型号上线后直接对比两份账单。
如何按场景判断要不要换 Qwen4-Max
| 场景 | Qwen4-Max 的表现(官方自报) | 建议 |
|---|---|---|
| 长程 agent 与行业交付(办公自动化、研究、交付文档) | HLAB-Vals、Agents’ Last Exam 第一;APEX、JobBench、AA-Briefcase 第二;token 明显更省 | 优先评估,从 Qwen3.8-Max 升级的收益最清楚 |
| 终端与代码仓(shell agent、构建、跨仓修改) | DeepSWE 第一但领先很小;Terminal-Bench 第五,ProgramBench 第四 | 以终端操作为主的任务,先和 Kimi K3.1、Opus 5.5 做对比再决定 |
| 前端 WebDev | Code Arena 公开榜第 6,1750 分(Preliminary) | 可以作为性价比选项,但不是榜首 |
| 图表与视频理解、多模态长文档 | Chartography、Video-Index 均第四 | 读图、读视频较多的流程,暂不建议只用它 |
| 生物与医疗问答 | BioMysteryBench 第一;HealthBench Professional 第三 | 可以纳入测试,但需要领域专家复核 |
一个比较稳妥的做法是分流:长程 agent 和文档交付这类任务交给 Qwen4-Max,终端重度任务和图表视频任务继续留给当前在这些方面表现更好的模型。这样不用把所有流量一次性迁移,也能先拿到 token 节省带来的收益。
🎯 选型建议:分流的前提是能用同一套代码切换模型。API易 apiyi.com 提供 OpenAI 兼容接口,用一个 API Key 就能调用多家旗舰模型,把
model字段换掉即可做 A/B 测试。
Qwen4-Max 快速上手
官方渠道是 QwenCloud API,支持 OpenAI Chat Completions、Responses、Anthropic Messages 和 DashScope 四种协议,已有的 OpenAI SDK 或 Anthropic SDK 都可以直接接入。接入时注意下面几点:
- 确认型号:官方型号 ID 写作
qwen4-max,以型号页为准。默认reasoning_effort为high,对比测试时显式指定同一档位,例如xhigh。 - 预留输出空间:最大输出 393K,最大思维链 262K。长任务要把
max_tokens或对应参数设得足够大,否则思维链会占满输出额度。 - 启用缓存:隐式缓存命中价为 $0.075。如果系统提示较长且会重复使用,可以评估是否值得使用 5 分钟或 1 小时的显式缓存;创建缓存需要单独付费,复用次数太少时反而不划算。
- 准备对照组:在 API易 注册后获取 API Key,将
base_url设为https://api.apiyi.com/v1,model填qwen3.8-max,用同一批任务跑出旧模型的 token 消耗和分数作为基线。 - 新型号上架后切换:qwen4-max 上架 API易 后,只需修改
model字段,其余代码保持不变,就能直接拿到新旧两代的对比数据。
🚀 快速开始:新用户在 API易 apiyi.com 注册即可获得免费测试额度,足够先把
qwen3.8-max的基线跑出来,后续切换模型不需要重新接入。
Qwen4-Max 常见问题 FAQ
Q1:Qwen4-Max 是什么?
Qwen4-Max 是通义千问在 2026-11-16 发布的旗舰模型。它采用 2.4T 主干参数,每 token 激活 71B,原生支持视觉输入,上下文为 1M,主要面向长程 agent 和行业交付任务。
Q2:Qwen4-Max 和 Qwen3.8-Max 差别在哪?
在官方自报的 16 项跑分中,Qwen4-Max 每一项都高于 Qwen3.8-Max-0902。Code Arena 公开榜上高出 74 分。官方价格方面,输入和输出各低 25%,缓存读低 70%。另外两者默认推理档位不同,分别是 `high` 和 `xhigh`。
Q3:16 项跑分可信吗?
这些分数都是官方自报的,对手分数也是阿里自己测的,目前没有第三方复现。可以参考的外部信号是 Code Arena WebDev 公开榜:在 2026-11-14 的终榜快照中,Qwen4-Max 排第 6,但仍是 Preliminary 状态,票数较少。
Q4:「成本降六成」能直接套用到我的业务吗?
不能直接套用。这个数字来自官方的 Work360 场景,降幅高于单纯按 token 和单价推算的结果,中间的差额官方没有解释。你的实际降幅取决于缓存命中率、工具调用轮次和推理档位,需要用自己的任务日志测算。
Q5:可以通过 API易 调用 Qwen4-Max 吗?
截至 2026-11-16 11:00,API易 的型号列表里还没有 qwen4-max,我们会尽快上架。目前在售的 Qwen 旗舰是 `qwen3.8-max`,价格为输入 $1.65、输出 $4.95、缓存读 $0.20625(单位:1M tokens)。上架进度和价格以 apiyi.com 的型号列表为准。
Q6:Qwen4-Max 有哪些短板?
终端操作(Terminal-Bench 第五)、程序构建(ProgramBench 第四)、图表与视频理解(均为第四)以及 HLE(第四)都落后于同图中的头部对手。安全代码的双通过率虽然有提升,也只有 31.8%。另外,Max 尺寸目前没有开源权重的计划。
总结:Qwen4-Max 值不值得换
- 定位:2.4T 主干、每 token 激活 71B、1M 上下文的旗舰模型,主打长程 agent 和行业交付。
- 领先的项目:16 项官方自报跑分中拿到 4 个第一、4 个第二,主要集中在 agent 和白领工作交付类基准。
- 落后的项目:终端操作、程序构建、图表、视频和 HLE 都排在第四或第五,不能用一个模型覆盖所有任务。
- 公开榜位置:Code Arena WebDev 终榜快照(2026-11-14)第 6,1750 分,仍为 Preliminary。
- 成本:官方单价下降 25%,缓存读下降 70%,token 消耗也明显减少;”降六成”需要用自己的数据验证。
如果你的主要负载是长程 agent 和文档交付,Qwen4-Max 值得优先评估;如果是终端重度任务或图表视频理解,建议继续分流到当前更强的模型。在 qwen4-max 上架之前,可以先通过 API易 apiyi.com 的 OpenAI 兼容接口,用 qwen3.8-max 建立成本和效果基线,新型号上线后修改一个字段就能完成对比。
📚 参考资料
- Qwen 官方 X 发布帖:Qwen4-Max 发布公告
- 链接:
x.com/Alibaba_Qwen/status/2122148127520289151 -
说明:发布时间与官方可用渠道
-
Qwen 官方博客(中文):架构、规格、16 项跑分与效率数字
- 链接:
qwen.ai/blog?id=qwen4-max -
说明:本文架构、规格与跑分数据均来自此文
-
QwenCloud 型号页:美元挂牌价
- 链接:
qwencloud.com/models/qwen4-max -
说明:美元 / 1M tokens 的输入、输出与缓存价格
-
千问AI平台型号页:人民币挂牌价
- 链接:
qianwenai.com/models/qwen4-max -
说明:人民币 / 1M tokens 的价格
-
arena.ai Code Arena WebDev:公开榜
- 链接:
arena.ai - 说明:本文引用的是 2026-11-14 的终榜快照
作者:APIYI 技术团队
技术交流:如需了解型号上架进度和接入方式,可在 API易 网站首页联系我们,文档见 docs.apiyi.com