作者注:手把手接入 K-Dense-AI 的 177 個科研 Agent Skills,從環境自檢、挑選、安裝、補依賴到觸發驗收,並單獨講清排錯和風險。
K-Dense-AI 開源的 Scientific Agent Skills 是一套給 Claude Code、Cursor 等編碼 Agent 用的科研技能包,共 177 個技能。它把單細胞分析、化學信息、文獻綜述、數據庫檢索這些流程寫成 Agent 能讀懂的操作手冊,你就不用每次都從頭寫 QC 流程、翻 API 文檔、覈對 DOI。不過它不適合一口氣全裝:技能能讓 Agent 執行代碼、裝包、聯網,而且裝技能文件不會順帶裝好 Python 依賴。
這不是“裝完就無敵”的安利文,而是一份按 5 個步驟走、每一步都能覈對結果的接入指南。
核心價值:讀完本文,你能挑出自己方向需要的 5-10 個科研 Skills,裝進正確目錄並補齊依賴,再讓 Agent 真正調用起來,產物和數字都能逐項覈對。
177 個科研 Skills 裏到底有什麼
倉庫地址是 K-Dense-AI/scientific-agent-skills,許可爲 MIT。截至 2026-10-28,它有 54,959 個 star、4,846 個 fork,當前版本 2.72.0,skills/ 目錄下共 177 個子目錄。README 自稱“250,000+ 科學家在用”“#1 Agent Skills library for science”,這些都是官方自報口徑,並不是第三方統計。配套論文爲 arXiv:2609.00065。
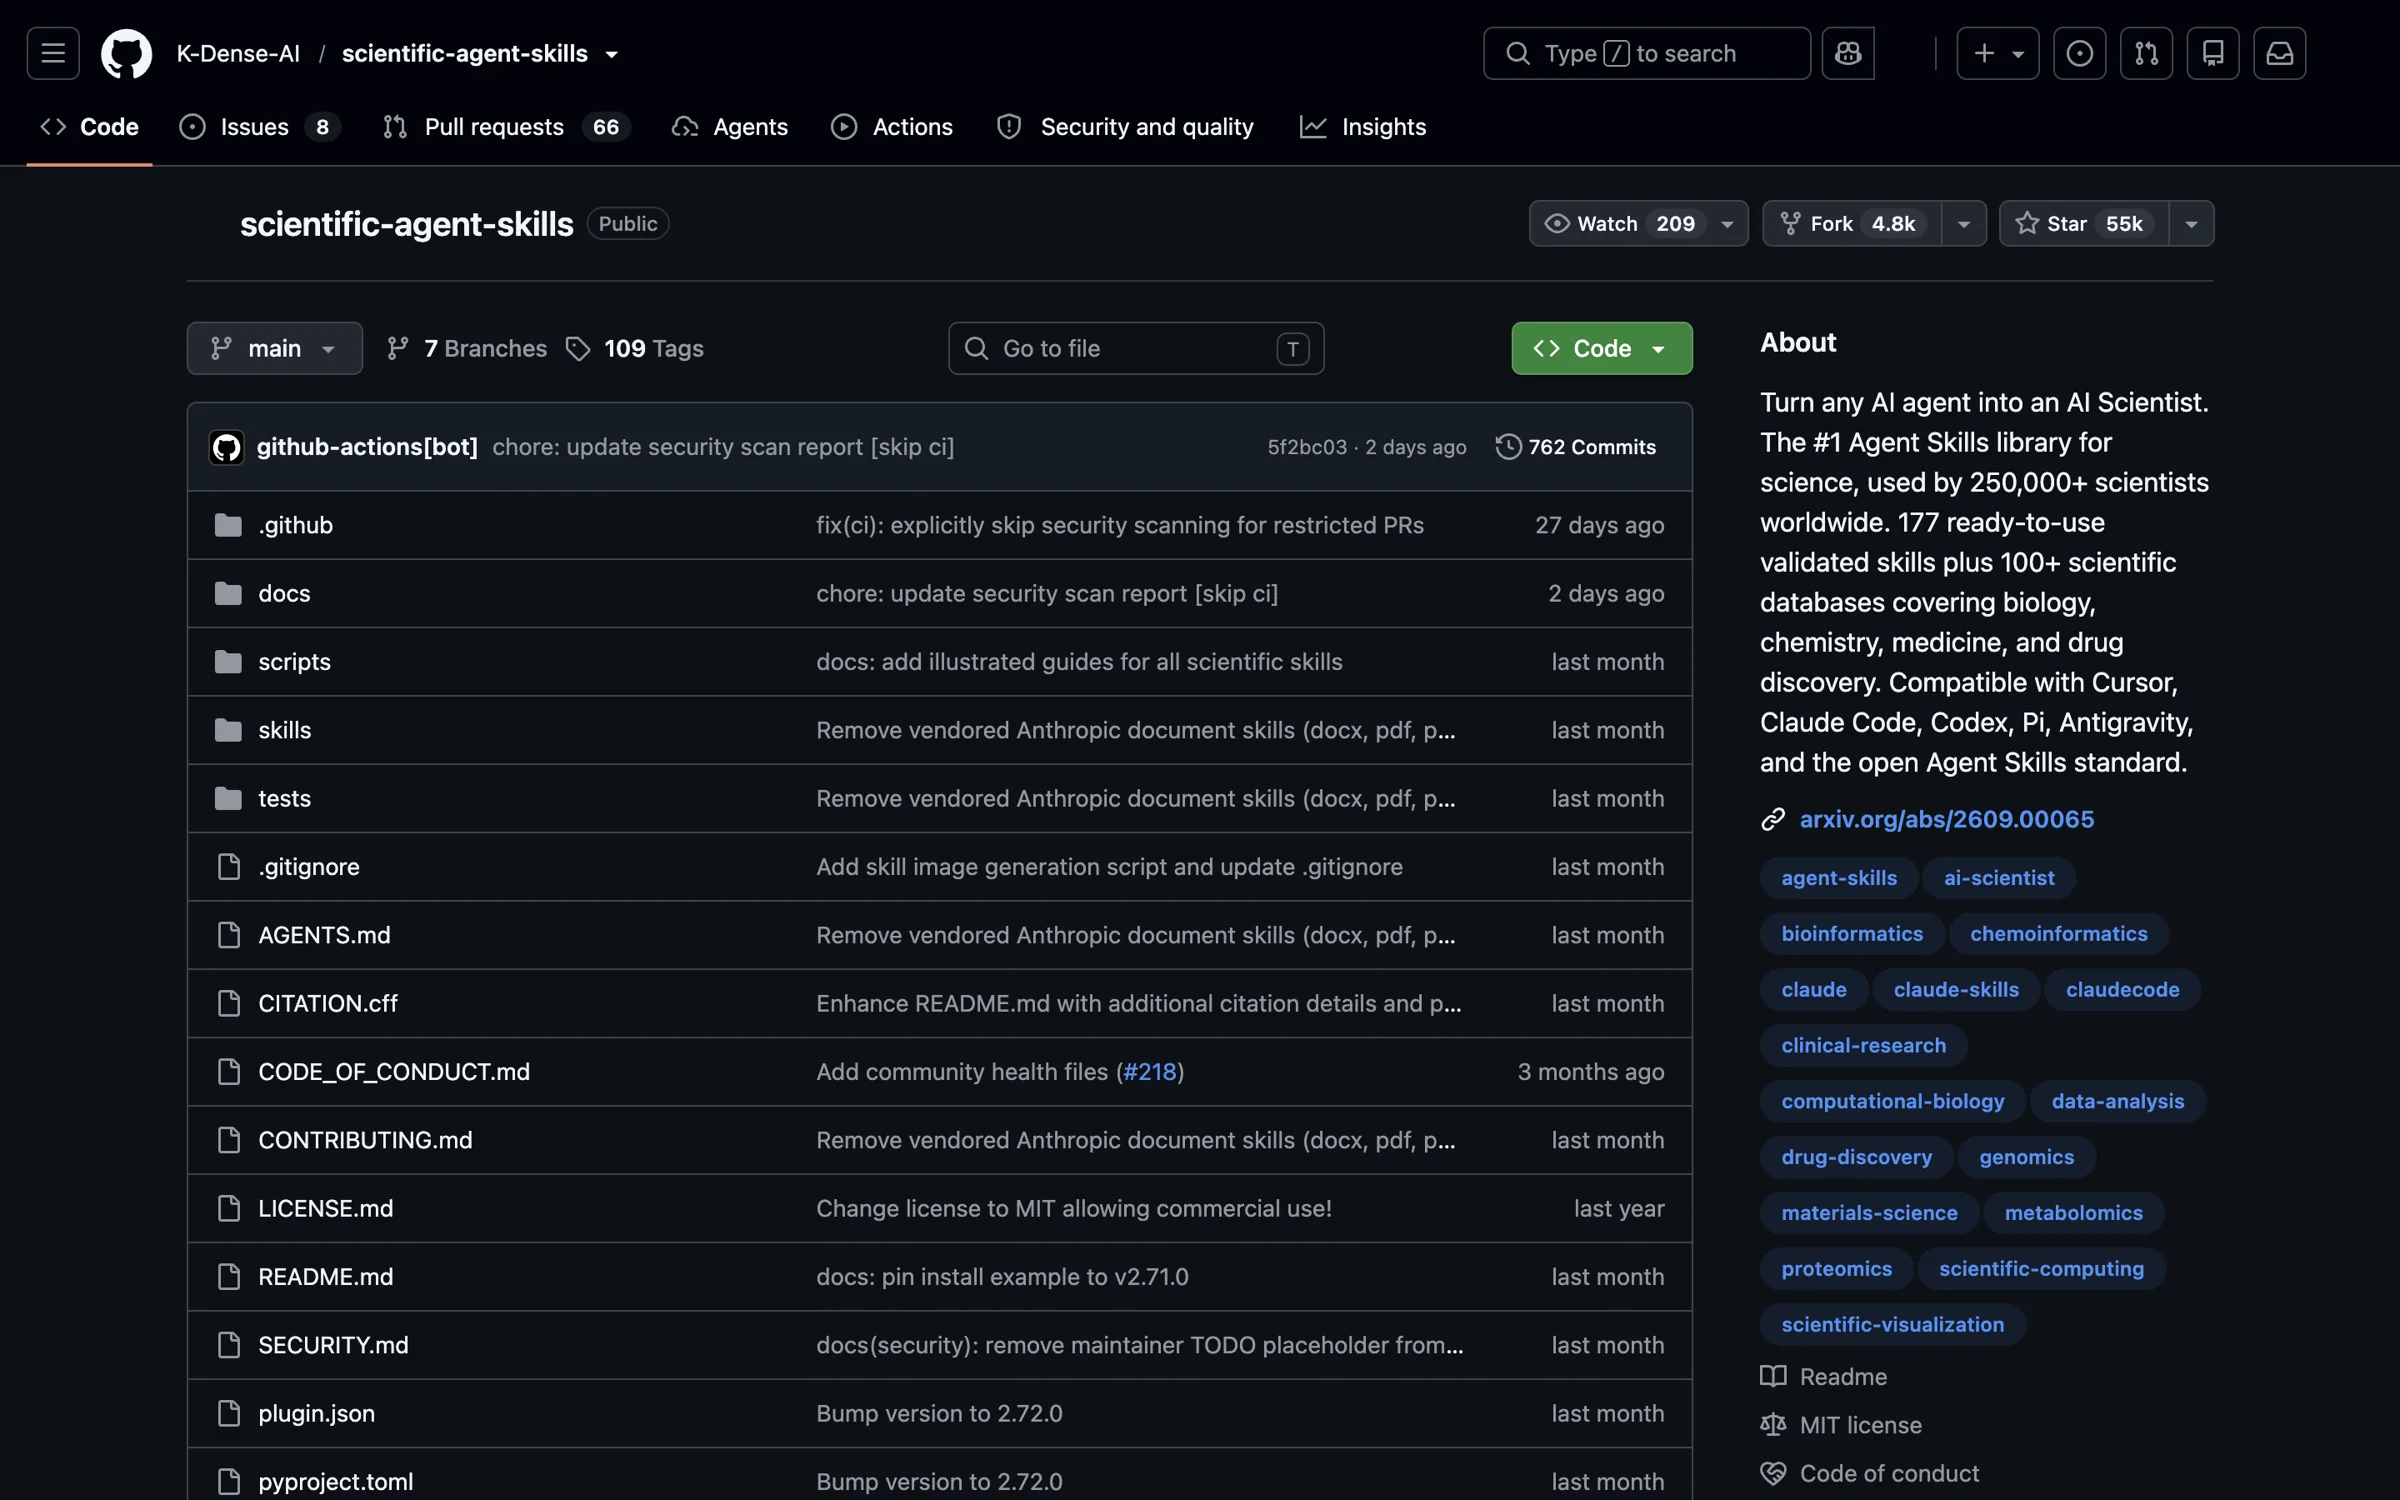
圖 1:倉庫首頁(2026-10-28 截圖),Star 55k、Fork 4.8k,About 一欄直接寫明 177 個技能與 100+ 數據庫
數量爲什麼是 177?2.71.0 時共有 181 個技能。從 2.72.0 開始,docx、pdf、pptx、xlsx 四個文檔技能不再隨倉庫分發,需要的話要去 Anthropic 的倉庫單獨安裝。
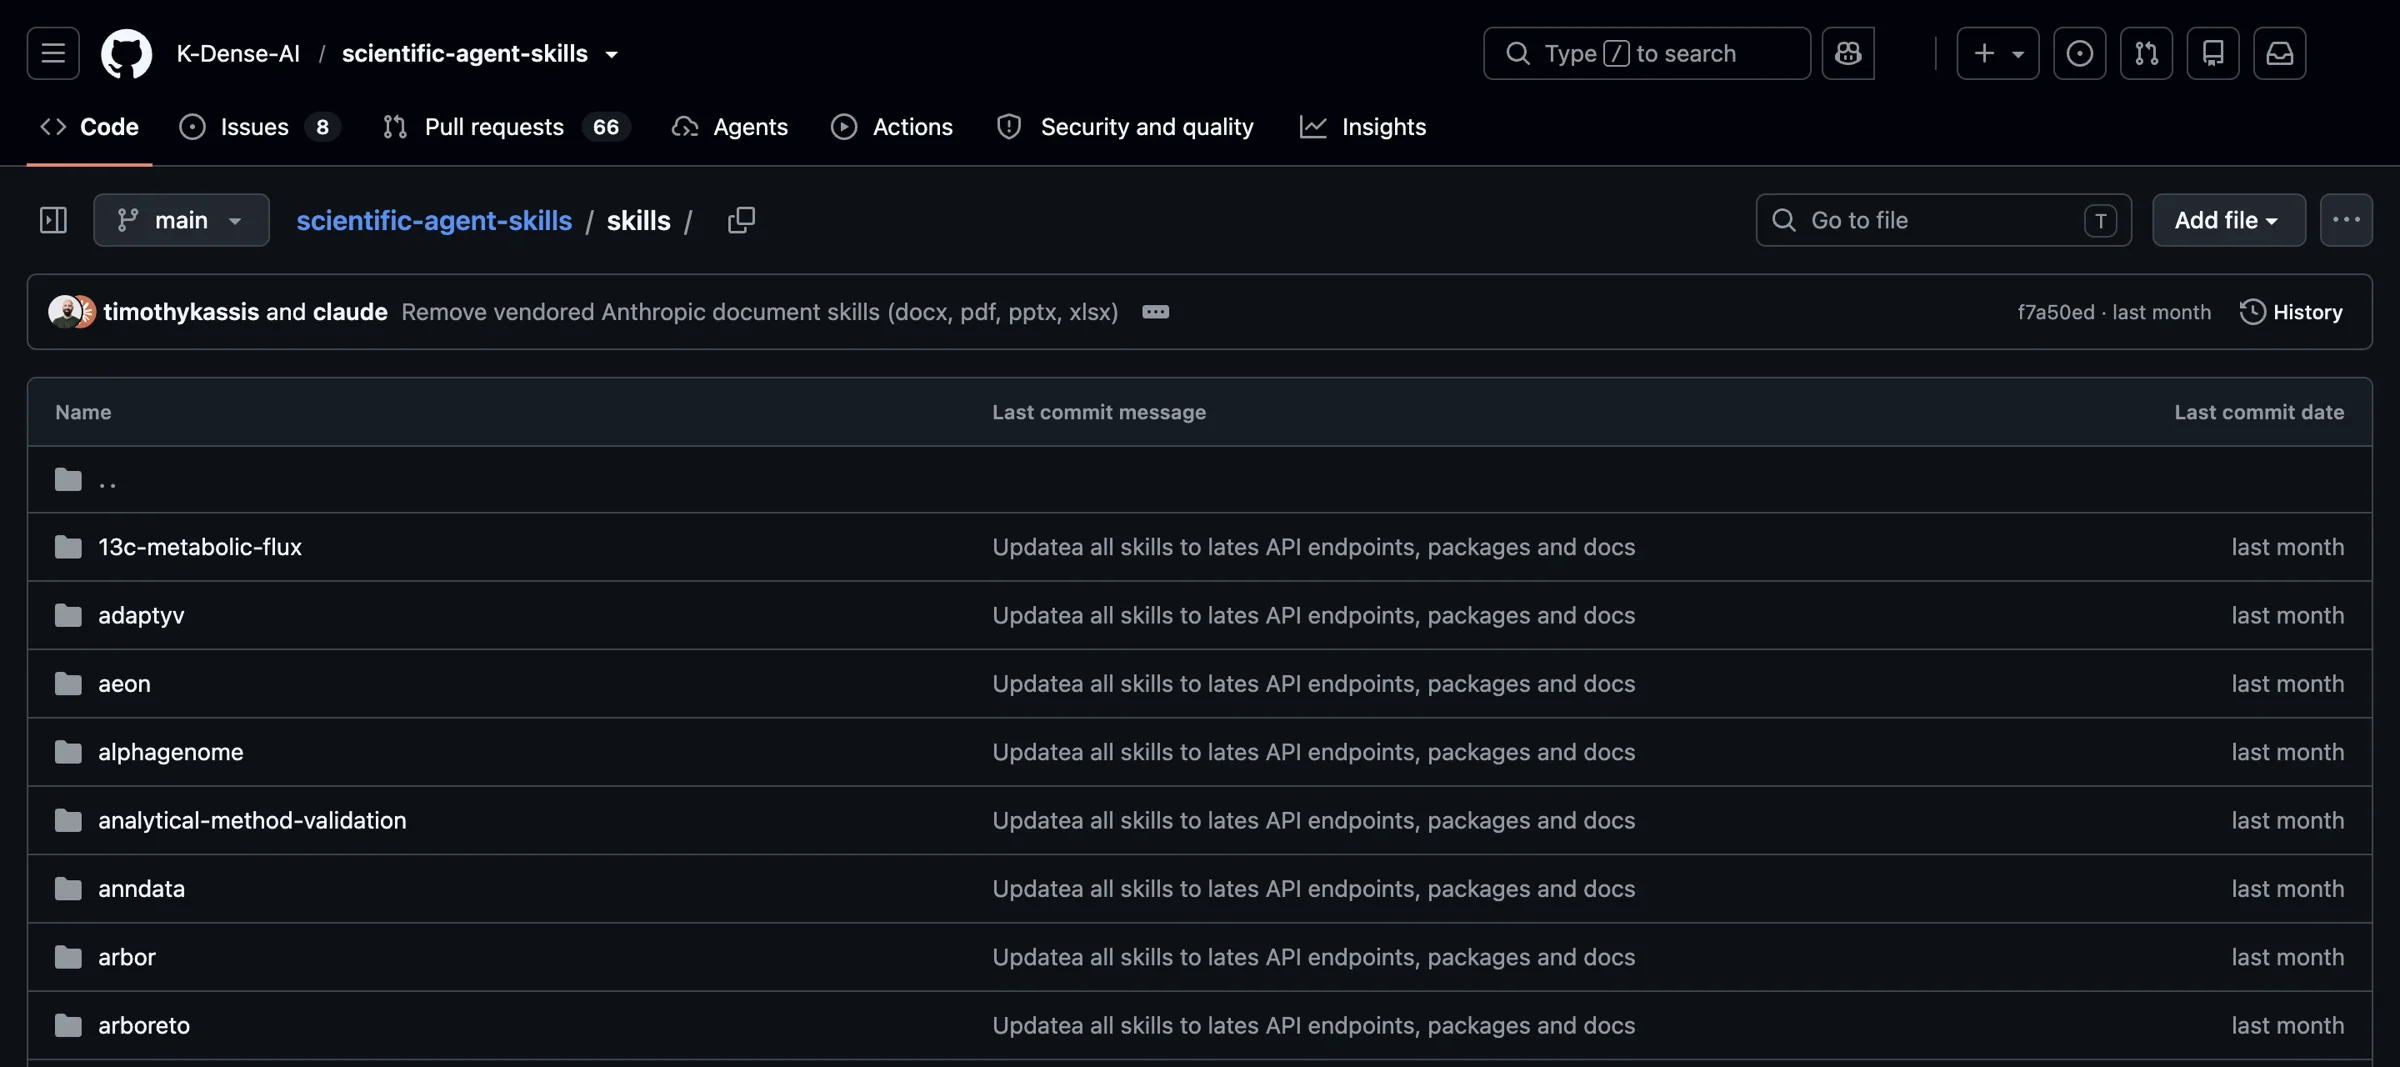
圖 2:skills/ 目錄裏一屏就是幾十個技能文件夾;最近一次提交的說明寫着 Remove vendored Anthropic document skills,這就是數量從 181 變成 177 的那次改動
README 把全部技能分成 22 個大類。下表按方向合併成幾組,只列有代表性的技能和包,不逐個羅列:
| 方向(README 大類) | 代表技能 / 包 | 典型用途 |
|---|---|---|
| 生物信息、多組學、蛋白組與質譜 | scanpy、pydeseq2、pyopenms、nextflow,包技能如 scVelo |
單細胞 QC 與聚類、差異表達、質譜處理、流程編排 |
| 化學信息與藥物發現、材料科學 | rdkit、pymatgen |
分子過濾與描述符、晶體結構與材料計算 |
| 物理與天文、工程與仿真 | qiskit,包技能如 QuTiP |
量子線路、量子系統仿真 |
| 臨牀研究、醫療 AI、法規與標準 | clinical-reports,包技能如 pydicom |
臨牀報告草稿、醫學影像讀取 |
| 數據分析與可視化、機器學習、地理空間 | scientific-visualization、timesfm-forecasting,包技能如 scikit-learn、PyTorch Lightning、GeoPandas |
出版級圖表、時間序列預測、建模、空間數據分析 |
| 科學傳播、研究方法論 | literature-review、scientific-writing、paper-lookup、paperzilla、scientific-slides、research-grants、peer-review、generate-image |
系統綜述、論文寫作、組會幻燈片、基金申請、審稿意見 |
| 數據庫檢索 | database-lookup,專項技能如 DepMap、Imaging Data Commons、PrimeKG、NCATS ARAX、AlphaGenome |
統一查詢公開、註冊和授權類數據源 |
其中 database-lookup 一個技能就整理了 80 個數據源,再加上專項技能和多庫包,README 對外的口徑是 100+ 數據庫。Python 包類技能有 70+ 個,RDKit、Scanpy、scikit-learn、PyTorch Lightning、pydicom、QuTiP、GeoPandas、pymatgen、Qiskit、scVelo、TimesFM 都在其中,每個技能會寫明適用的包版本和用法。
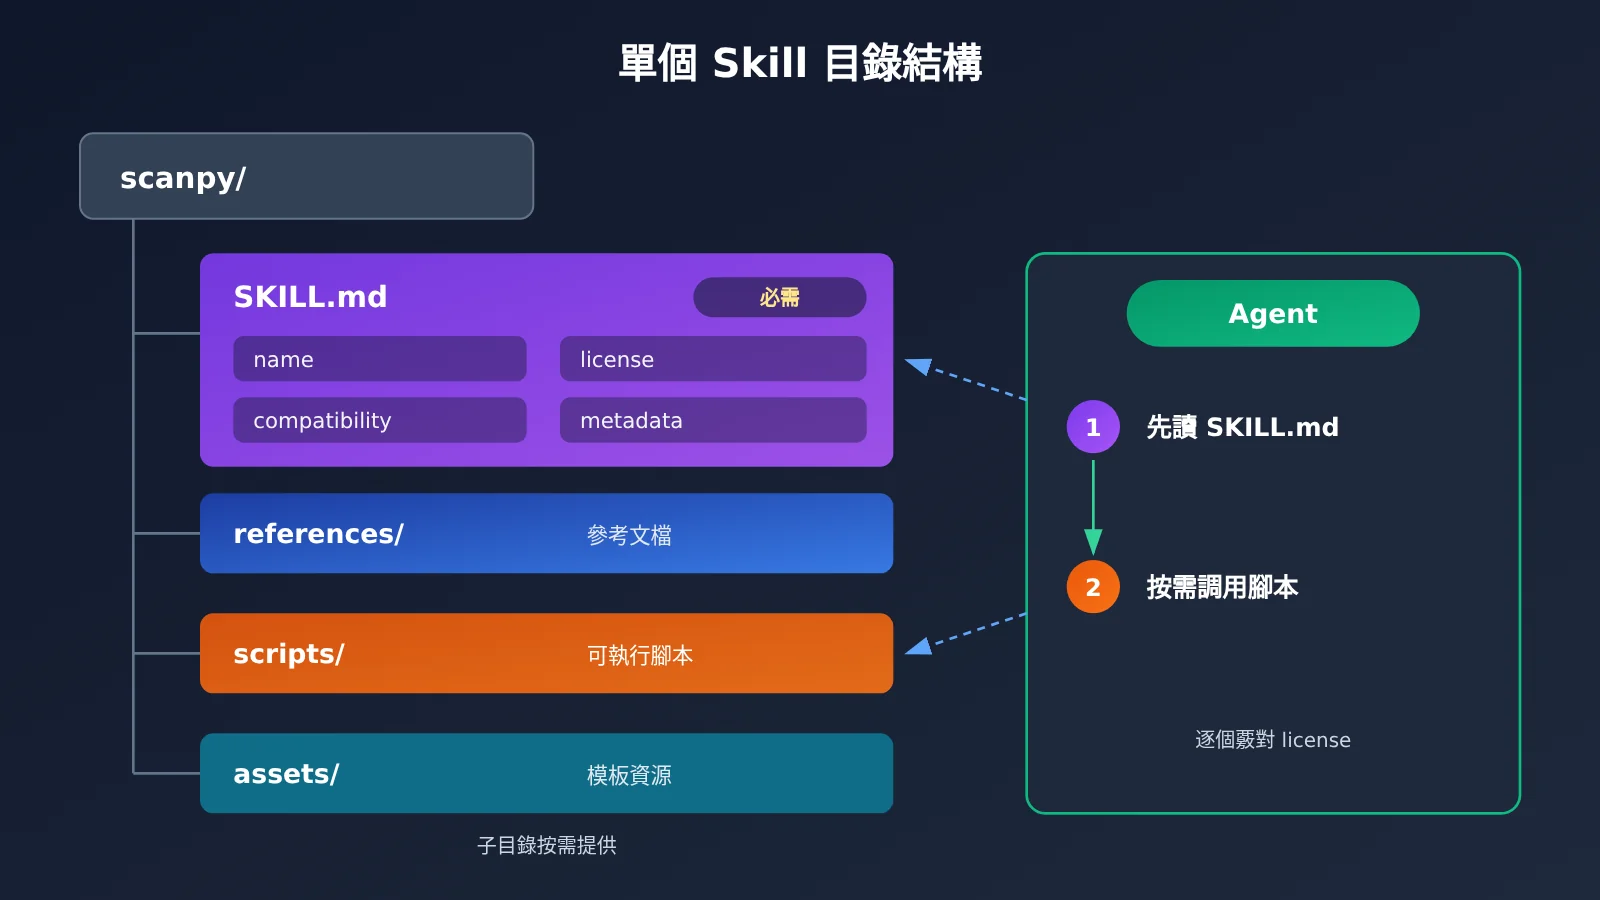
科研 Skills 單個技能的目錄結構
每個技能都是一個文件夾,SKILL.md 必須有,references/、scripts/、assets/ 按需提供。以 scanpy 爲例,它的 frontmatter 寫着 license 爲 BSD-3-Clause、Python 3.12+、metadata.version 1.8、last-reviewed 2026-10-01。
這裏有個容易忽略的地方:倉庫整體是 MIT,但每個技能在 SKILL.md 的 license 字段裏寫的是自己的許可,可能和倉庫不一致。如果要商用或二次分發,請逐個覈對。
科研 Skills 5 步接入流程
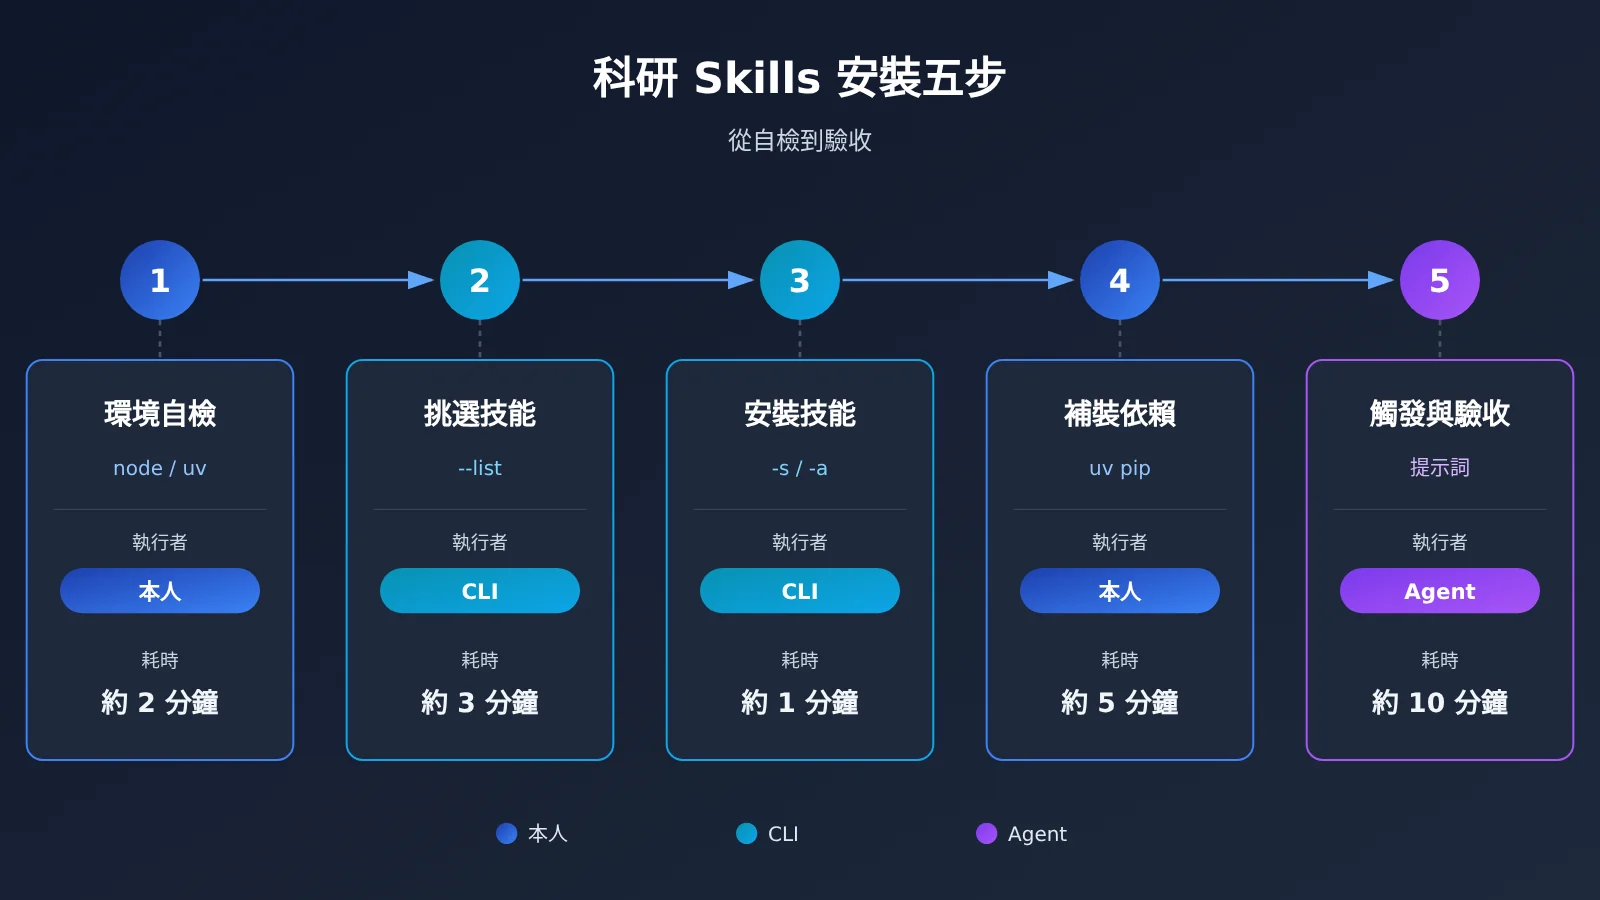
整個接入過程分五步:環境自檢 → 看清單挑技能 → 只裝需要的 → 補依賴和憑據 → 觸發並驗收。每一步都會註明是你本人在敲命令、命令行工具在執行,還是 Agent 在執行。
第 1 步:認清科研 Skills 的安裝形態和前置條件
耗時:約 5 分鐘 前置條件:能打開終端 難度:低(環境都齊的話可以跳過)
要做什麼:由你本人逐條運行下面的自檢命令,確認自己屬於“直接能裝”“缺工具要先補”“宿主不支持”中的哪一種。
node -v:安裝器npx skills要求 Node.js 22.20 或更高python3 --version:倉庫自帶的工具鏈要求 Python 3.13+(單個技能的依賴範圍以各自的 compatibility 爲準)uv --version:uv 用來安裝技能依賴gh --version:只有打算用 GitHub CLI 安裝時才需要,版本需在 2.90.0 以上- 系統:macOS、Linux,或者 Windows + WSL2
會看到什麼:每條命令輸出一個版本號。如果提示 command not found,說明還沒裝這個工具。
驗收標準:Node 版本不低於 v22.20,Python 不低於 3.13,uv 能正常輸出版本號,並且你正在用的宿主支持 Agent Skills 標準。安裝器 skills(npm 包,vercel-labs/skills,MIT,最新版本 1.7.4)官方支持 70+ 個宿主,常見的有 Claude Code、Cursor、Codex、Gemini CLI、Antigravity、OpenClaw。技能本身不綁定模型:宿主用什麼模型由你決定,第 5 步會說到把模型接到 API易 的具體做法。
第 2 步:先列科研 Skills 清單,再決定裝哪些
耗時:約 10 分鐘 前置條件:第 1 步通過 難度:低(不建議跳過)
要做什麼:由你本人運行“只列不裝”的命令。命令行工具會把倉庫拉下來,讀取全部技能的名稱和描述,但不會往本機寫入任何技能。
npx skills add K-Dense-AI/scientific-agent-skills --list
會看到什麼:終端裏列出 177 個技能,每個都帶有名稱和簡介。
實測提醒:這一步會先把整個倉庫 clone 到本地,倉庫體積四百多 MB。網絡慢的時候終端會長時間停在 Cloning repository…,超過 300 秒會直接報 Clone timed out。要放寬就用 SKILLS_CLONE_TIMEOUT_MS=600000(10 分鐘)再跑一次;或者先自己 git clone 到本地,再對本地目錄執行 skills add。
驗收標準:你手上有一份 5-10 個技能的候選清單。README 原話就是“Do not install everything at once”,官方也不建議一次全裝。技能裝得越多,Agent 選技能時干擾越大,需要你審查的代碼也越多。
可以按方向這樣挑:
- 生信:
scanpy、pydeseq2、database-lookup,做質譜再加pyopenms - 化學信息:
rdkit、database-lookup,做材料方向加pymatgen - 文獻與寫作:
literature-review、paper-lookup、scientific-writing、peer-review - 數據可視化:
scientific-visualization,涉及時間序列再加timesfm-forecasting - 實驗室自動化:這個大類裏的具體技能名以
--list的輸出爲準,流程編排可以先看nextflow
第 3 步:只裝需要的科研 Skills
耗時:約 5 分鐘 前置條件:已有候選清單 難度:中
要做什麼:由你本人運行安裝命令,命令行工具負責把技能寫進宿主的技能目錄。標題裏說的“一條命令”指的就是 npx skills add K-Dense-AI/scientific-agent-skills。直接執行它會進入交互模式,讓你勾選技能和宿主;如果在交互裏選了全部,就等於全裝,不推薦這樣做。
參數含義:
-s/--skill:指定技能名,'*'表示全部-a/--agent:指定宿主,例如claude-code、codex-g:裝到用戶目錄(全局);不加則裝到當前項目--copy:複製文件;默認是軟鏈(Symlink),本機只保留一份副本,更新起來更省事-y:跳過確認,適合腳本或 CI
可以直接複製的非交互命令(以 Claude Code、項目級安裝爲例,每行裝一個技能):
npx skills add K-Dense-AI/scientific-agent-skills -s scanpy -a claude-code -ynpx skills add K-Dense-AI/scientific-agent-skills -s database-lookup -a claude-code -ynpx skills add K-Dense-AI/scientific-agent-skills -s pydeseq2 -a claude-code -y
如果要全局安裝,在命令末尾加 -g;想用複製代替軟鏈,就加 --copy。一次裝多個技能的寫法請以 npx skills add --help 的說明爲準。
| 宿主 | 項目級目錄 | 全局目錄 |
|---|---|---|
| Claude Code | .claude/skills/ |
~/.claude/skills/ |
| Cursor | .agents/skills/ |
~/.cursor/skills/ |
| Codex | .agents/skills/ |
~/.agents/skills/ |
| Gemini CLI | .agents/skills/ |
~/.gemini/skills/ |
| Antigravity | .agents/skills/ |
~/.gemini/antigravity/skills/ |
| OpenClaw | skills/ |
~/.openclaw/skills/ |
項目級和全局怎麼選:只跟某個課題相關的技能(比如某個分析項目專用的 pydeseq2)放項目級,方便連同項目一起分享給組裏的人;文獻、寫作這類每天都用的技能放全局。
會看到什麼:安裝器逐個提示安裝成功,並顯示目標路徑。
驗收標準:由你本人運行 npx skills list,或者直接 ls .claude/skills/,確認剛裝的技能目錄都在,並且每個目錄下都有 SKILL.md。
還有兩種備選裝法:
gh skill install K-Dense-AI/scientific-agent-skills --agent claude-code --pin v2.71.0:用--pin固定到某個版本或 commit SHA,適合需要復現結果的課題git clone到~/.agents/skills/scientific-agent-skills(用戶級)或.agents/skills/scientific-agent-skills(項目級)
第 4 步:補齊科研 Skills 的 Python 依賴與憑據
耗時:10-30 分鐘(取決於包的大小) 前置條件:技能已裝好 難度:中(不能跳過)
要做什麼:這一步最容易出問題,所以再強調一遍:裝技能文件 ≠ 裝依賴。由你本人打開每個技能的 SKILL.md,查看 compatibility 字段,再用 uv 安裝依賴。注意,uv sync 只會裝倉庫自己的開發和校驗工具,不會裝全部科學計算包。
cat .claude/skills/scanpy/SKILL.md:查看 compatibility,scanpy 技能寫的是“測試於 Python 3.13 + Scanpy 1.12.4 + AnnData 0.13.4”uv venv .venv-scrna --python 3.13:一個工作流單獨建一個環境,避免單細胞和化學信息的包互相沖突source .venv-scrna/bin/activateuv pip install "scanpy[leiden]"
個別技能需要你自己的 Key。比如 generate-image 走的是 OpenRouter 的圖片接口,需要設置 export OPENROUTER_API_KEY=你的Key,而且按次計費。列模型或者加 --dry-run 不收費,建議先用這兩種方式試。literature-review 需要聯網做 DOI 校驗,導出 PDF 還要另裝 Pandoc 和 XeLaTeX。
已經在用 API易 的話,生圖這塊不用另開 OpenRouter 賬號:API易 文檔裏收錄了社區貢獻的兩個 Skills,apiyi-gpt-image-2-gen(官轉 gpt-image-2,按 token 計費、支持 4K 和自定義尺寸)和 apiyi-gpt-image-2-all-gen(官逆,按次 $0.025,對話式改圖)。裝進 Cursor、Codex CLI、Gemini CLI、OpenCode、GitHub Copilot 或 Amp 之後,直接說一句“用 apiyi-gpt-image-2-gen 生成一張 3840×2160 的圖”就行,Key 統一走環境變量 APIYI_API_KEY。
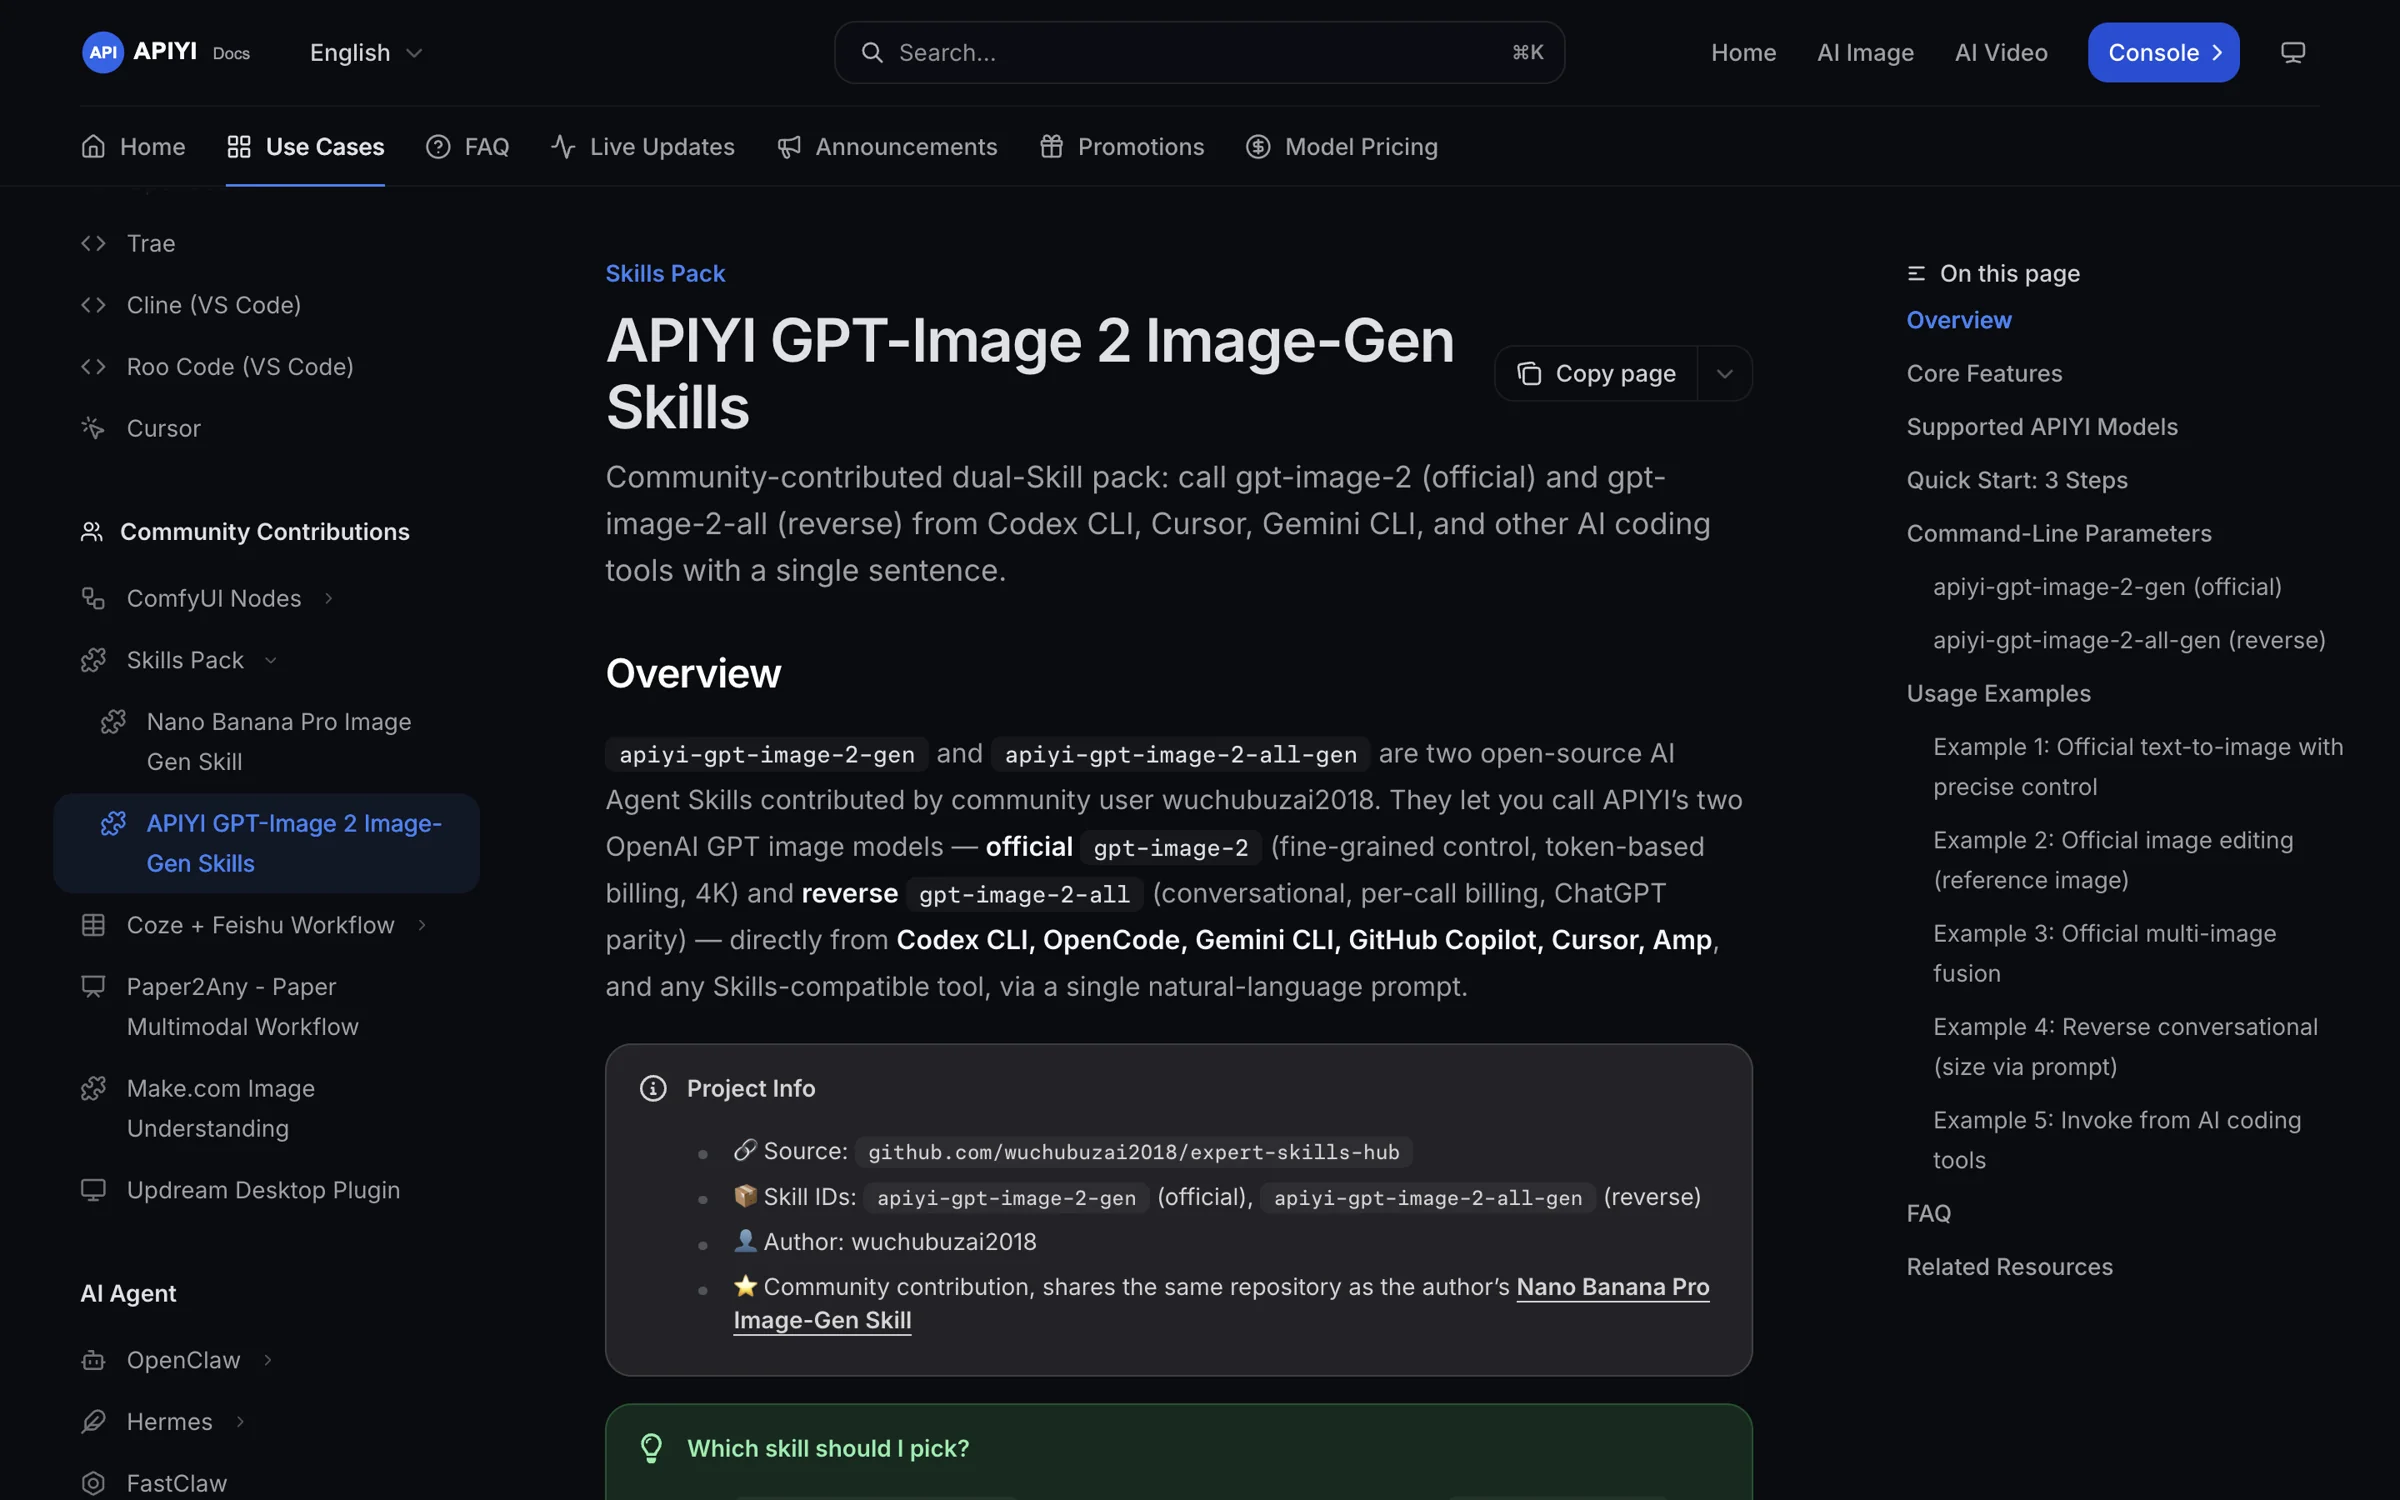
圖 3:API易 文檔裏的 Skills 合集頁面,兩個生圖技能都寫明瞭模型標識、計費方式和安裝報錯怎麼查
會看到什麼:uv 打印出解析和安裝的包列表。
驗收標準:由你本人運行 python -c "import scanpy, anndata; print(scanpy.__version__, anndata.__version__)",輸出的版本號能和 compatibility 字段對上。需要 Key 的技能,用 echo $OPENROUTER_API_KEY | head -c 6 確認環境變量已經生效。
第 5 步:觸發科研 Skills 並驗收結果
耗時:約 10 分鐘 前置條件:依賴已裝好 難度:低
要做什麼:重啓宿主,讓它重新掃描技能目錄。然後由你本人在對話框裏輸入提示詞,後面的工作由 Agent 完成:讀取 SKILL.md、執行腳本、生成產物。推薦的提示詞寫法是“通用開頭句 + 點名技能”:
- 開頭加一句
Use available skills you have access to whenever possible. - 再點名技能,例如“用 literature-review 技能做一次系統綜述”
會看到什麼:Agent 的回覆裏會說明它讀取了哪個技能,並給出要執行的命令。
驗收標準(三條都要能覈對):
- Agent 是否明確說明用了哪個技能。如果沒說,就追問一句“你用了哪個 skill”
- 產物落在哪個目錄,文件是否真實存在,用
ls自己看一下 - 結果裏的數字能否對上來源:DOI 能不能打開,數據庫條目的 ID 能不能查到
日常維護命令(由你本人運行):npx skills check 檢查更新,npx skills update 執行更新,npx skills remove 卸載。安裝器默認會收集匿名使用數據,加上 DISABLE_TELEMETRY=1 或 DO_NOT_TRACK=1 可以關閉。
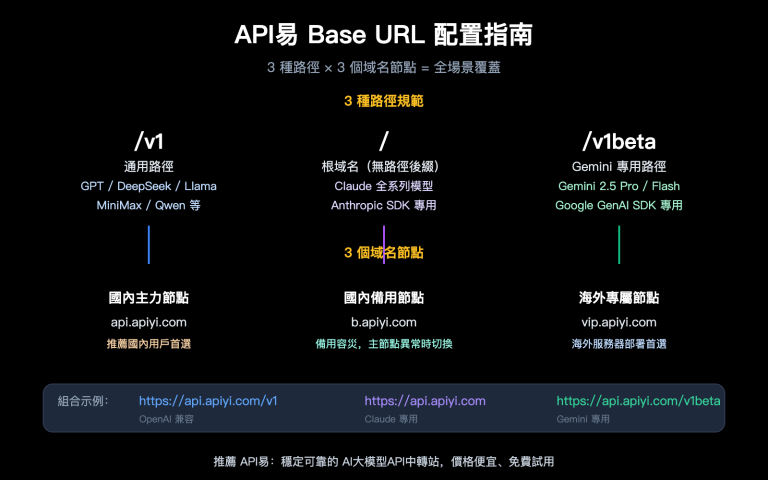
🎯 跑通之後再算賬:技能本身是免費開源的,真正花錢的是執行技能時的模型調用。一次單細胞全流程往往要多輪讀文檔、寫代碼、改錯,token 消耗不小。如果你的宿主支持自定義 OpenAI 兼容端點,可以把 base_url 設爲
https://api.apiyi.com/v1,通過 API易 apiyi.com 用一個 Key 切換 Claude、GPT、Gemini 等模型,對比不同模型跑同一個技能的效果和成本。以 Claude Code 爲例,接入就是兩行環境變量:ANTHROPIC_BASE_URL指向https://api.apiyi.com,ANTHROPIC_AUTH_TOKEN填你的 Key,配完這些技能照樣在 Claude Code 裏用。
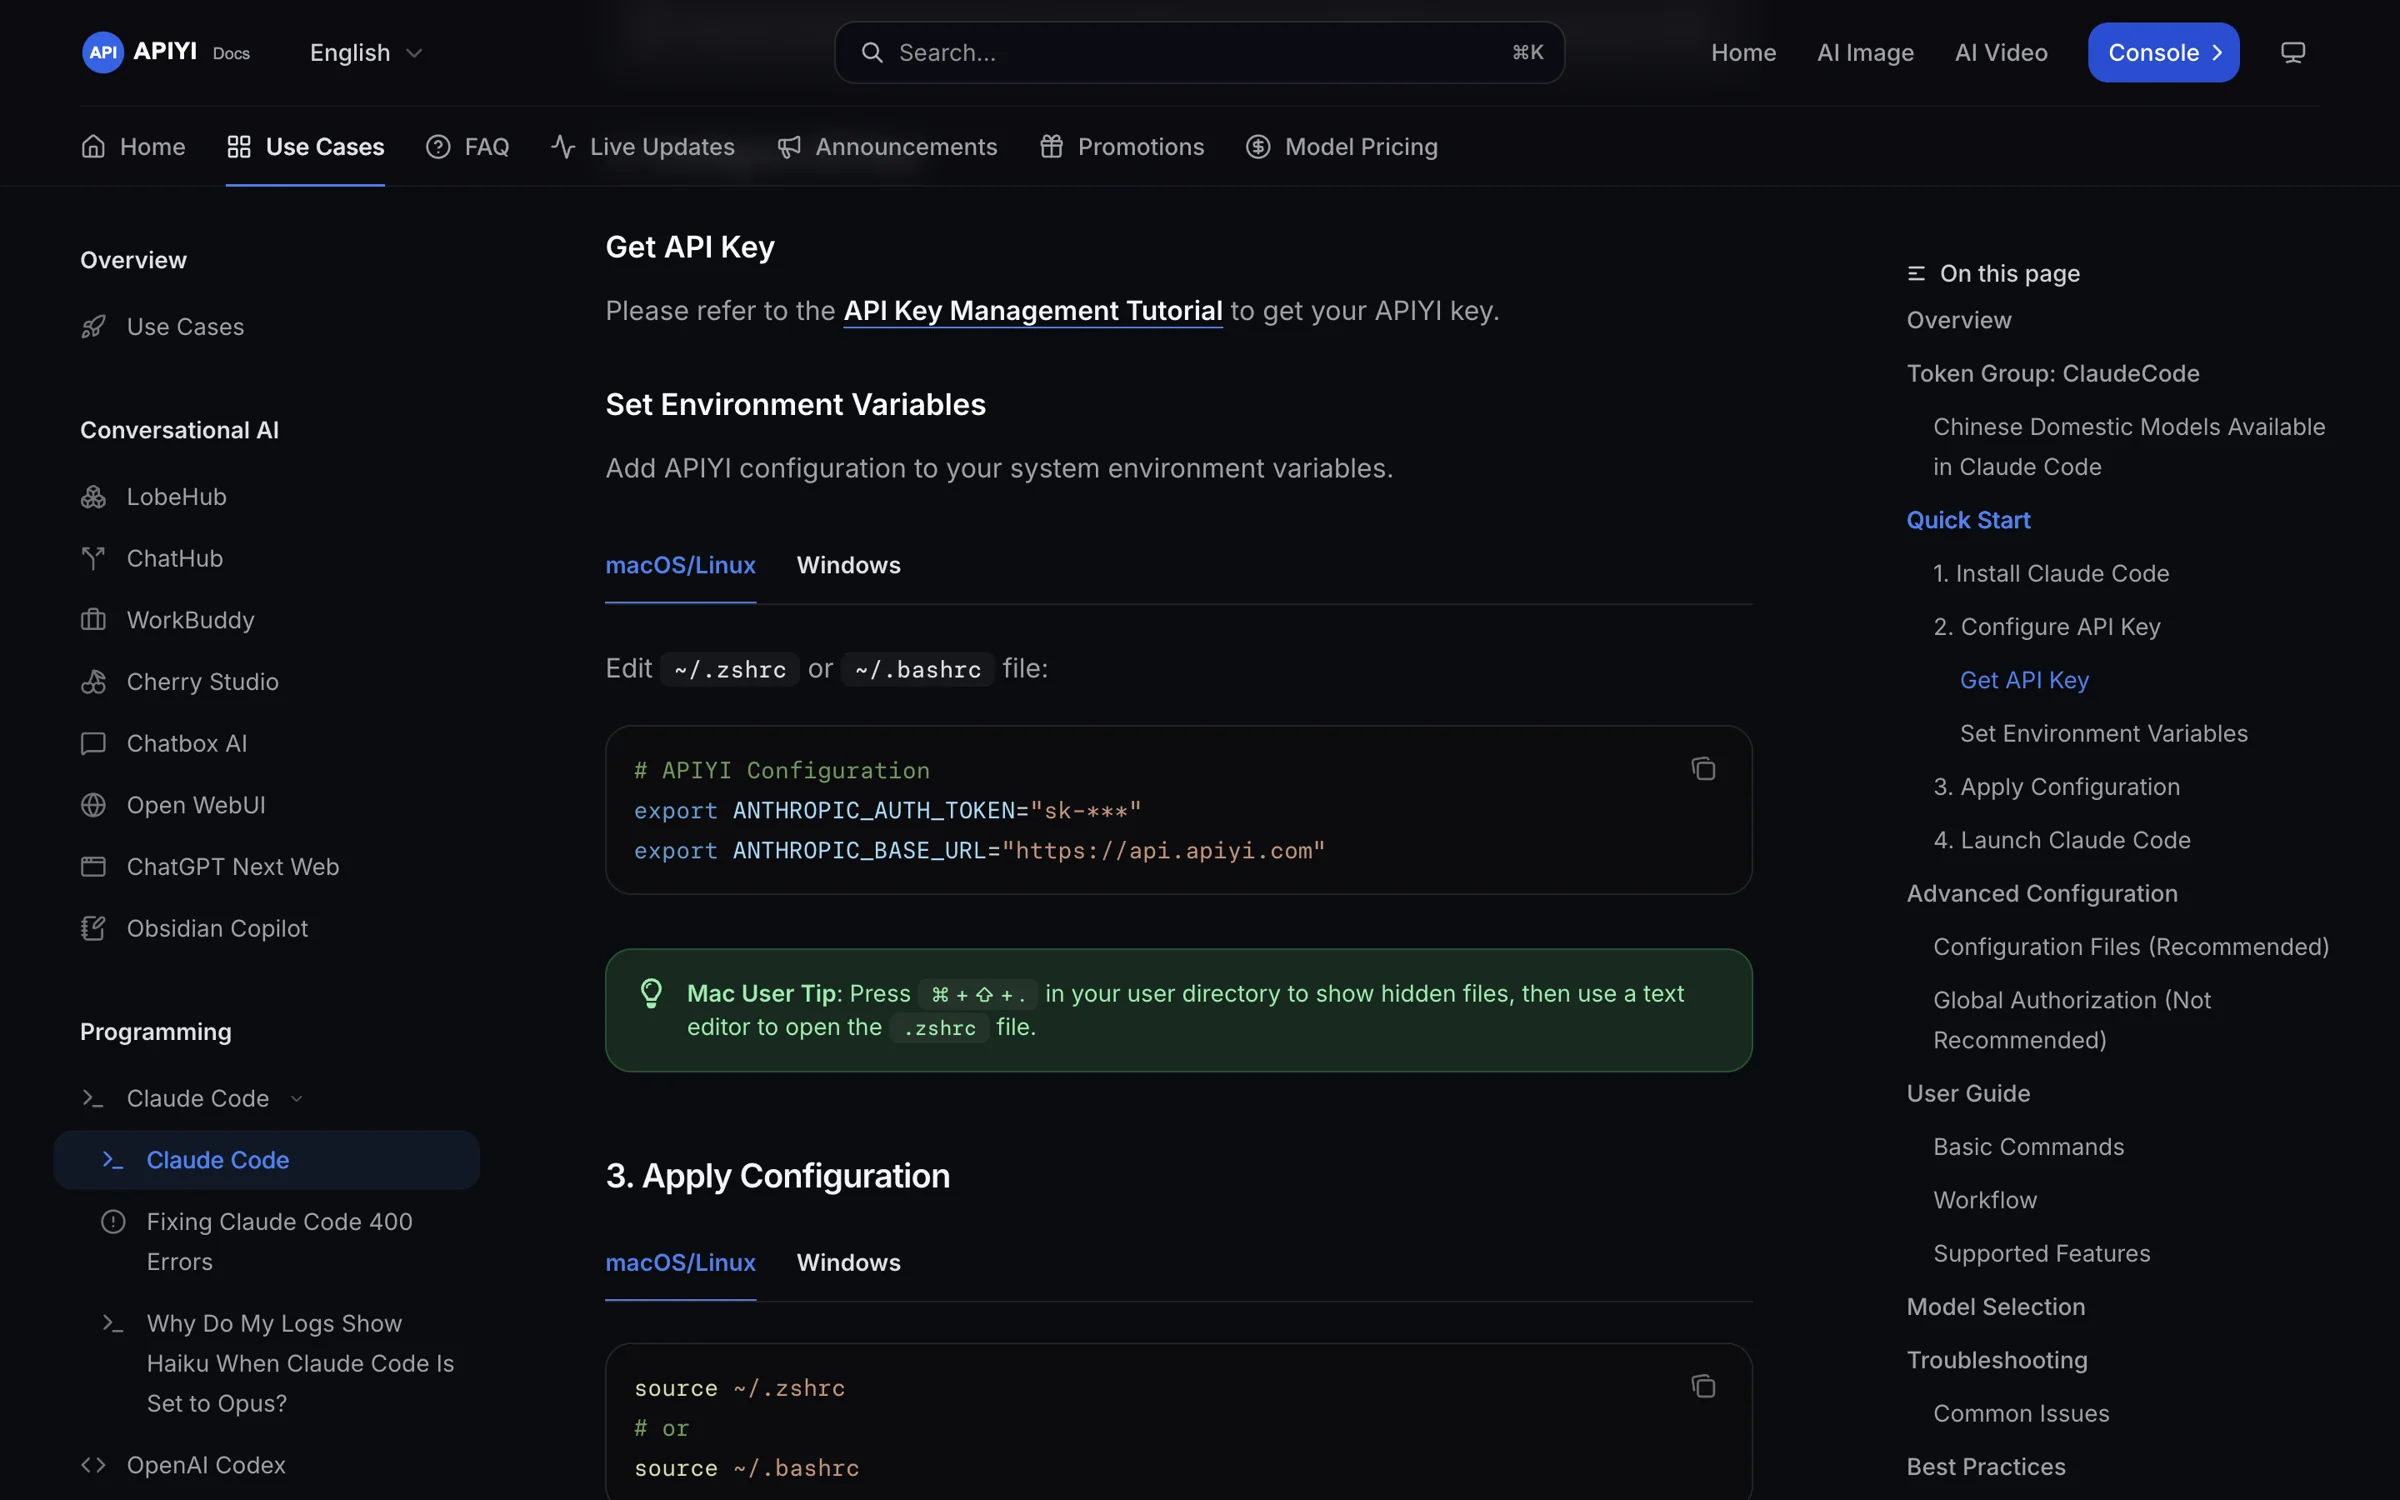
圖 4:API易 文檔裏 Claude Code 的配置,只需要兩行環境變量(截圖中的 Key 已打碼)
| 型號 | 輸入 | 輸出 | 緩存讀 | 可用平臺 |
|---|---|---|---|---|
| claude-opus-5-5 | $4 / 百萬 tokens | $20 / 百萬 tokens | $0.2 / 百萬 tokens | API易 apiyi.com |
型號與價格以平臺型號列表爲準。科研技能的提示詞裏會反覆帶上同一份 SKILL.md,緩存讀的單價只有輸入的二十分之一,長會話裏能省下不少費用。
三個科研 Skills 第一次跑通的真實場景
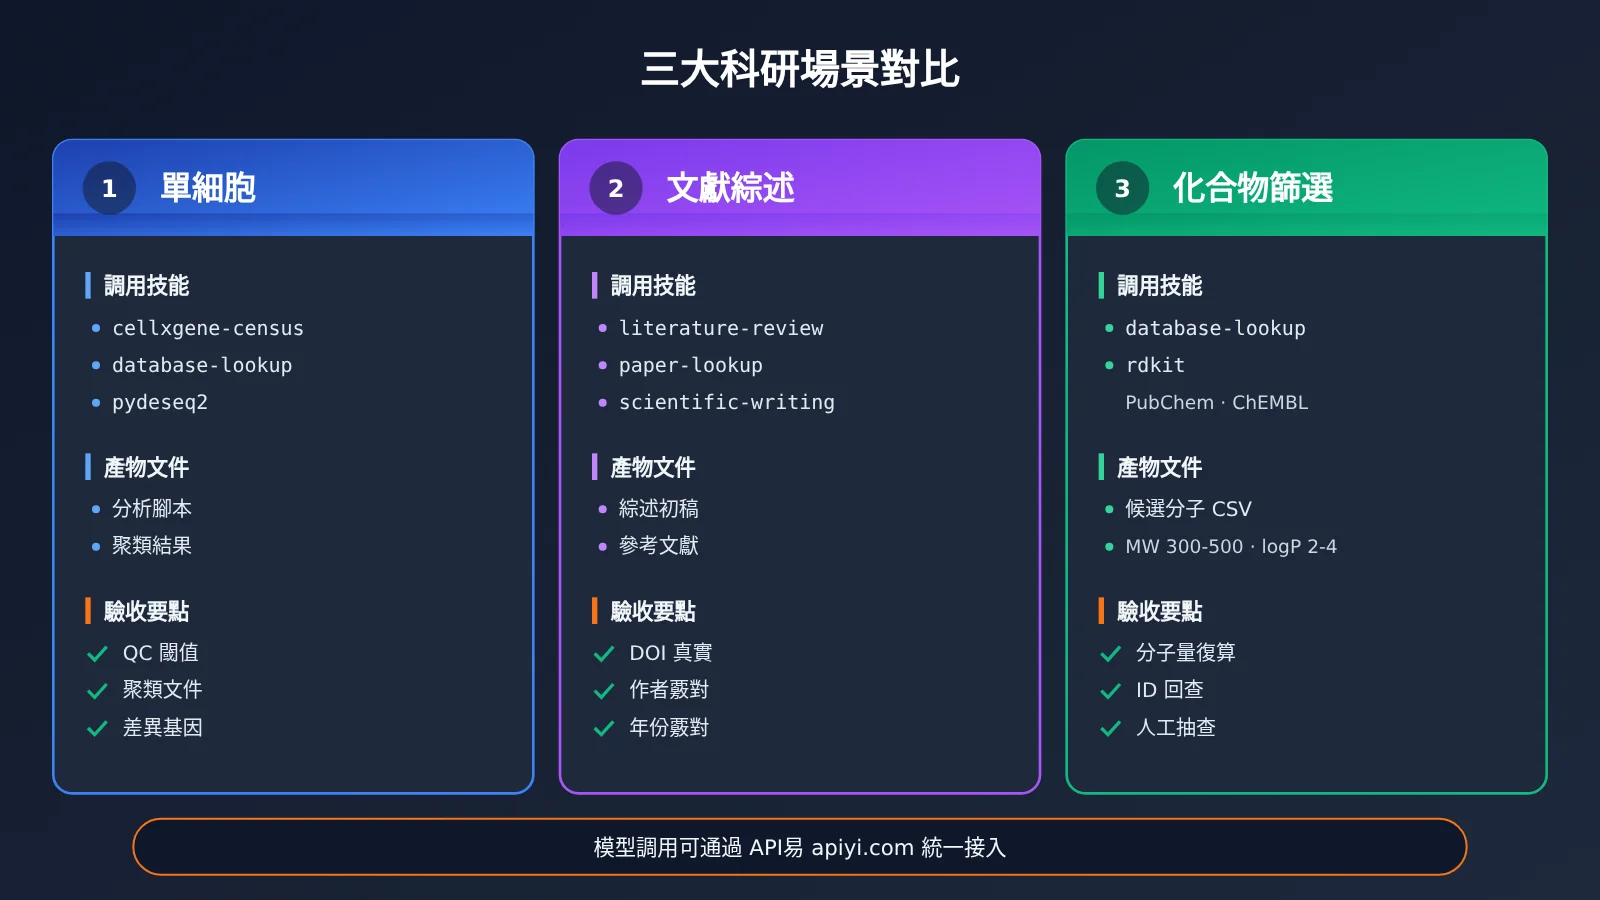
場景一:單細胞分析
提示詞:Use available skills you have access to whenever possible. 然後接着寫“用 scanpy 做 QC、標準化、降維和聚類,用 cellxgene-census 做細胞類型參考,用 database-lookup 查標記基因,用 pydeseq2 做差異表達”。Agent 會依次讀取這幾個技能,生成並執行分析腳本。
驗收時重點看三處:QC 閾值是否寫明,聚類結果文件是否存在,差異基因能否在 database-lookup 返回的數據源裏查到。
場景二:文獻綜述
提示詞:“用 literature-review 技能,針對某一具體主題做系統綜述,用 paper-lookup 補全文獻,最後用 scientific-writing 整理成初稿。”這個技能會聯網校驗 DOI,所以要逐條打開 DOI,確認文獻真實存在、作者和年份沒寫錯。
場景三:化合物篩選
提示詞:“用 database-lookup 從 PubChem 和 ChEMBL 拉一批候選分子,用 rdkit 按分子量 300-500、logP 2-4 過濾,並輸出 CSV。”驗收時由你本人抽查幾條:用 RDKit 重新計算分子量,看是否和 CSV 裏的一致;再拿化合物 ID 回 PubChem 查一下,確認能對上。
科研 Skills 排錯表
| 現象 | 常見原因 | 處理辦法 |
|---|---|---|
| 技能不加載 | 目錄放錯,或技能目錄裏缺 SKILL.md |
對照第 3 步的目錄表檢查;改完後重啓 IDE;Cursor 在 Settings → Rules 裏查看是否被識別 |
| 缺 Python 依賴 | 只裝了技能文件,沒裝依賴 | 按 SKILL.md 的 compatibility 用 uv pip install 安裝,並確認當前激活的是對應環境 |
| 數據庫限流 | 批量請求過快,或超出免費額度 | 查看該數據庫的文檔,加緩存、分批請求,降低併發 |
| 認證報錯 | Key 未設置、過期或權限不足 | 用 echo 檢查環境變量,到對應服務後臺覈對權限 |
舊路徑 scientific-skills/ 返回 404 |
v2.43.0 起技能路徑改爲 skills/ |
更新本地腳本和書籤裏的路徑,或者重新安裝 |
| 想卸載重裝 | 版本混亂,或軟鏈失效 | npx skills remove 後重新 npx skills add,需要固定版本時用 gh skill install --pin |
卡在 Cloning repository… 後報 Clone timed out |
倉庫體積四百多 MB,300 秒不夠 | 用 SKILLS_CLONE_TIMEOUT_MS=600000 再跑,或先 git clone 到本地再用本地路徑安裝 |
科研 Skills 風險與免責
這一節請認真讀完。Scientific Agent Skills 是社區開源項目,不是任何平臺的官方 API。我們只做推薦,不爲它背書。
技能具備執行能力。技能可以指揮 Agent 執行任意代碼、安裝包、發起網絡請求、修改本機文件。惡意或寫得不好的技能,都可能把 Agent 帶偏。建議的做法如下:
- 裝之前先讀
SKILL.md,看清它用了哪些包、連了哪些外部服務 - 查看貢獻歷史:K-Dense-AI 署名的技能經過了內部評審,社區貢獻的只能做到“盡力評審”
- 自己再掃描一遍:先運行
uv pip install cisco-ai-skill-scanner,再運行skill-scanner scan <path> --use-behavioral,其中<path>換成技能目錄。官方每週做增量掃描,至少每 30 天全量重掃一次,結果公開在docs/security-report.md
第三方服務約束。部分技能需要註冊第三方數據庫,或使用你自己的 Key,這時要遵守這些服務的條款和額度限制。批量抓取可能被限流,甚至被封號,建議先用小號或在隔離環境裏測試。
臨牀與法規邊界。臨牀、醫療、法規類技能只能用於研究和起草,不能替代診斷、放行或認證決定。
責任歸屬。使用這些技能產生的一切後果,由使用者自行判斷並承擔,與本平臺和本文作者無關。
常見問題 FAQ
Q1:Scientific Agent Skills 到底是什麼?
它是 K-Dense-AI 維護的科研技能庫,共 177 個遵循 Agent Skills 標準的技能文件夾,用來告訴 Agent 某個科研流程該怎麼做、要調哪些包、連哪些數據庫。它不是模型,也不是 API 服務。
Q2:爲什麼不建議一條命令把 177 個科研 Skills 全裝上?
一是官方 README 明確寫了不要一次全裝;二是技能裝得越多,Agent 越難選準該用哪個;三是每個技能都能執行代碼,裝得越多,需要審查的內容也越多。按方向挑 5-10 個就夠用了。
Q3:爲什麼現在是 177 個,而不是 181 個?
從 2.72.0 開始,docx、pdf、pptx、xlsx 四個文檔技能不再隨倉庫分發。需要的話,去 Anthropic 的 skills 倉庫另裝。
Q4:技能是免費的,那費用主要花在哪裏?
主要花在執行技能時的模型調用上,有些技能還會產生第三方服務的費用,比如 `generate-image` 走 OpenRouter 按次計費。模型這部分可以通過 API易 apiyi.com 按量計費調用,沒有固定月費,適合先拿一個小流程測一下 token 消耗,再決定長期用哪個型號。
Q5:我在 Cursor 裏裝好了,但 Agent 不調用技能怎麼辦?
先在 Settings → Rules 裏確認技能已被識別,再在提示詞開頭加上 `Use available skills you have access to whenever possible.`,並直接點名技能。如果還是不調用,可以換一個模型對比試試。通過 API易 apiyi.com 一個 Key 就能切換多種模型,排查起來比較省事。
Q6:怎麼保證科研結果可復現?
用 `gh skill install –pin` 把技能固定到某個版本或 commit;Python 依賴寫死在獨立的 uv 環境裏;同時記下 `SKILL.md` 裏的 metadata.version 和 last-reviewed 日期。
Q7:這些技能的許可都是 MIT 嗎?
不一定。倉庫整體是 MIT,但每個技能有自己的 license 字段,例如 `scanpy` 是 BSD-3-Clause。商用前請逐個覈對。
科研 Skills 核心要點 Key Takeaways
- 是什麼:177 個開源科研技能,覆蓋 README 列出的 22 個大類
- 怎麼裝:先用
--list查看清單,再用-s和-a只裝需要的 - 前置條件:Node.js 22.20+、Python 3.13+、uv,以及支持 Agent Skills 標準的宿主
- 最常踩的坑:裝技能文件不等於裝依賴,每個工作流單獨建一個 uv 環境
- 怎麼驗收:確認用了哪個技能、產物在哪個目錄、數字能否對上來源
- 安全:裝前讀
SKILL.md,並用 Cisco 掃描器掃一遍 - 成本:技能免費,模型調用可通過 API易 apiyi.com 統一接入並對比
總結
這 177 個科研 Skills 很好用,但要按順序來,不要貪多:
- 先自檢再安裝:先確認環境版本和宿主支持,再用
--list挑出 5-10 個技能 - 裝技能和裝依賴分開做:技能文件用
npx skills add安裝,Python 依賴用 uv 安裝,兩步都要做 - 結果要能覈對:每次運行都檢查用了哪個技能、產物在哪裏、數字從哪裏來
建議先拿一個最熟悉的小流程(比如對一份小數據集做 scanpy 聚類)完整走一遍,再逐步加技能。模型側推薦通過 API易 apiyi.com 按量計費先跑通,再根據 token 消耗決定長期用哪個型號。
📚 參考資料
- Scientific Agent Skills 倉庫:技能源碼、README 與安全報告
- 鏈接:
github.com/K-Dense-AI/scientific-agent-skills -
說明:包含 177 個技能、安裝方式、排錯說明和
docs/security-report.md -
skills 安裝器:npx skills 的命令與參數說明
- 鏈接:
github.com/vercel-labs/skills -
說明:查看 add / list / check / update / remove 等命令,以及 70+ 宿主的目錄對照
-
Anthropic Skills 倉庫:docx、pdf、pptx、xlsx 文檔技能
- 鏈接:
github.com/anthropics/skills -
說明:2.72.0 之後需要單獨到這裏安裝這四個文檔技能
-
配套論文:Scientific Agent Skills: A Library of Procedural Knowledge for Research Agents
- 鏈接:
arxiv.org/abs/2609.00065 -
說明:瞭解技能庫的設計思路
-
API易 文檔 · Claude Code 接入:環境變量、分組與故障排除
- 鏈接:
docs.apiyi.com/scenarios/programming/claude-code -
說明:用兩個環境變量把 Claude Code 接到 API易,技能裝好之後就在這裏把模型跑起來
-
API易 文檔 · GPT-Image 2 生圖 Skills:社區貢獻的兩個生圖技能
- 鏈接:
docs.apiyi.com/scenarios/ecosystem/apiyi-gpt-image-skills -
說明:
apiyi-gpt-image-2-gen與apiyi-gpt-image-2-all-gen的參數、計費與常見報錯 -
API易 模型價格總表:型號、類型、計費方式與單價
- 鏈接:
docs.apiyi.com/models - 說明:本文引用的 claude-opus-5-5 單價以這張表爲準,價格會變,用前請再覈對
作者:API易 技術團隊
技術交流:歡迎在 API易 網站首頁聯繫我們,更多模型接入資料可訪問 docs.apiyi.com 文檔中心