
直接回答: 同一個開放權重模型可以由許多家推理服務商分別部署,所以會出現幾十家 API 服務商。OpenRouter 不只看誰的標價最低,而是按一次可用響應的綜合成本來選服務商。它同時評估實際有效價格、首 Token 延遲、吞吐量、速率限制、可靠性和響應質量 6 項指標,然後把請求交給當前最合適的 Provider,失敗時再換另一家重試。
這說明 AI API 聚合的競爭已經從“提供統一接口”延伸到“動態調度服務商”。2026 年 11 月 16 日,Hugging Face 宣佈把 Inference Providers 的語言模型路由交給 OpenRouter。這次合作提供了一個具體樣本,可以看清這些指標如何變成一套自動選擇服務商的機制。
您讀完此文能瞭解到什麼?
- 同一個 AI 模型爲什麼會有多家 API 服務商,模型研發方和推理服務商有什麼區別
- Provider 路由靠哪些決策指標,每項指標分別解決什麼問題
- 故障回退能做到什麼,又有哪些邊界
- 如何用 Hugging Face 模型目錄 API 的元數據,自己比較不同服務商
索引: 客觀事實部分按以下順序展開:先說明多家 API 服務商的由來,再拆解智能路由的決策對象和 6 項指標,接着講故障切換的流程與限制,最後演示開發者如何用目錄接口自行比較 Provider,其中會穿插 OpenRouter 公佈的路由實驗數據和計費變化。分析判斷部分討論 API 聚合平臺下一步的競爭方向,以及開發者在應用中應如何取捨、驗證。
理解多家 API 服務商與 Provider 路由的 To Know 概念
| 概念 | 簡要解釋 |
|---|---|
| Provider | 部署模型並實際提供推理服務的供應商,例如 Together AI、Novita |
| Router | 根據請求條件和可用服務商狀態決定請求去向的路由層 |
| 開放權重模型 | 公開訓練後權重、可按其許可證自行部署的模型 |
| TTFT | Time to First Token,指請求發出到首個 Token 返回的等待時間 |
| 吞吐量 | 單位時間內生成的 Token 數量,通常以 tok/s 計 |
| Failover | 當前服務商失敗後自動切換到其他服務商重試 |
| Prompt Caching | 服務商緩存重複輸入,以降低計算開銷和響應時間 |
| BYOK | Bring Your Own Key,自帶服務商 Key 並使用對應賬戶額度 |
| P50 / P95 | 統計分位數,P50 是中位數,P95 反映較慢的那 5% 請求 |
多家 API 服務商路由變化的影響速覽
- 開發者: Hugging Face 側代碼和 Token 原則上不用改,但實際服務商會由路由決定,同一模型 ID 在不同請求中可能落到不同 Provider。依賴工具調用、結構化輸出的應用需要重新迴歸測試。原本在 Hugging Face 配置自有語言模型 Provider Key 的開發者,這條路徑已經停止,需要重新確認 Key 和計費歸屬。
- 企業採購與平臺團隊: 供應商准入、容災策略和數據處理條件需要重新評估。組織可以禁用指定 Provider,但這不等於獲得了完整的數據駐留或合規保證,仍要逐家覈對服務商的數據政策。
同一個 AI 模型多家 API 服務商:客觀事實
同一個模型爲什麼會有多家 API 服務商
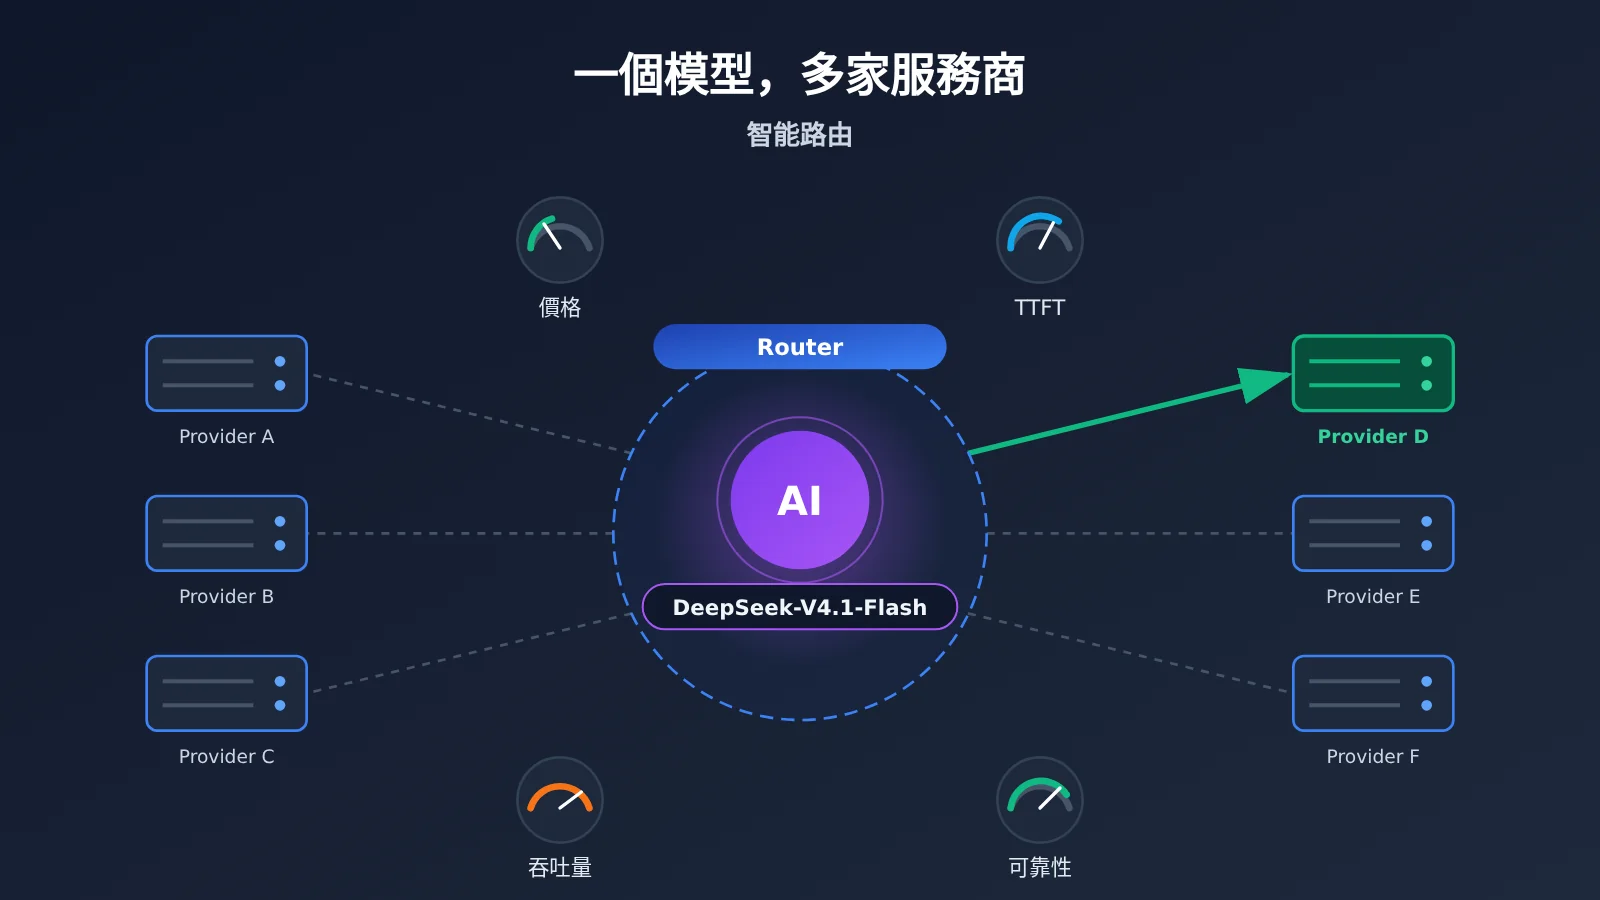
模型研發方和推理服務商是兩個角色。研發方負責訓練模型併發布權重。對於開放權重模型,任何具備算力、符合許可證條件的機構都可以把權重部署到自己的 GPU 集羣上,對外提供 API。所以 DeepSeek、Qwen、GLM 這類模型,往往同時跑在多家推理基礎設施上。
以 deepseek-ai/DeepSeek-V4.1-Flash 爲例,開發者請求的是同一個模型名稱,實際執行推理的可能是 Together AI、Novita 或其他支持該模型的 Provider。各家使用的硬件、集羣規模、調度方式和定價策略都不一樣,同一模型的價格、速度和可承載容量也就有差異。有的報價低但高峯期容易限流,有的首 Token 返回快,有的支持更長上下文,有的對工具調用格式支持更完整。
規模數據可以說明這個市場有多分散。OpenRouter 在合作公告中披露,其整體平臺支持 600 多個模型,接入 80 多個 Provider,每月處理超過 800 萬億 Token,服務超過 1,000 萬用戶。這些是 OpenRouter 全平臺數據,不是這次合作單獨帶來的規模。Hugging Face 的 Provider 頁面也列出了 Baseten、Cerebras、DeepInfra、Fireworks、Nebius、Novita、Together AI 等十多家服務商,但不同模型可用的 Provider 各不相同。
一個模型對應多家服務商,各家條件又在實時變化,”這次請求交給誰”就成了需要持續決策的問題,多 Provider 路由由此而來。
智能路由到底在決定什麼
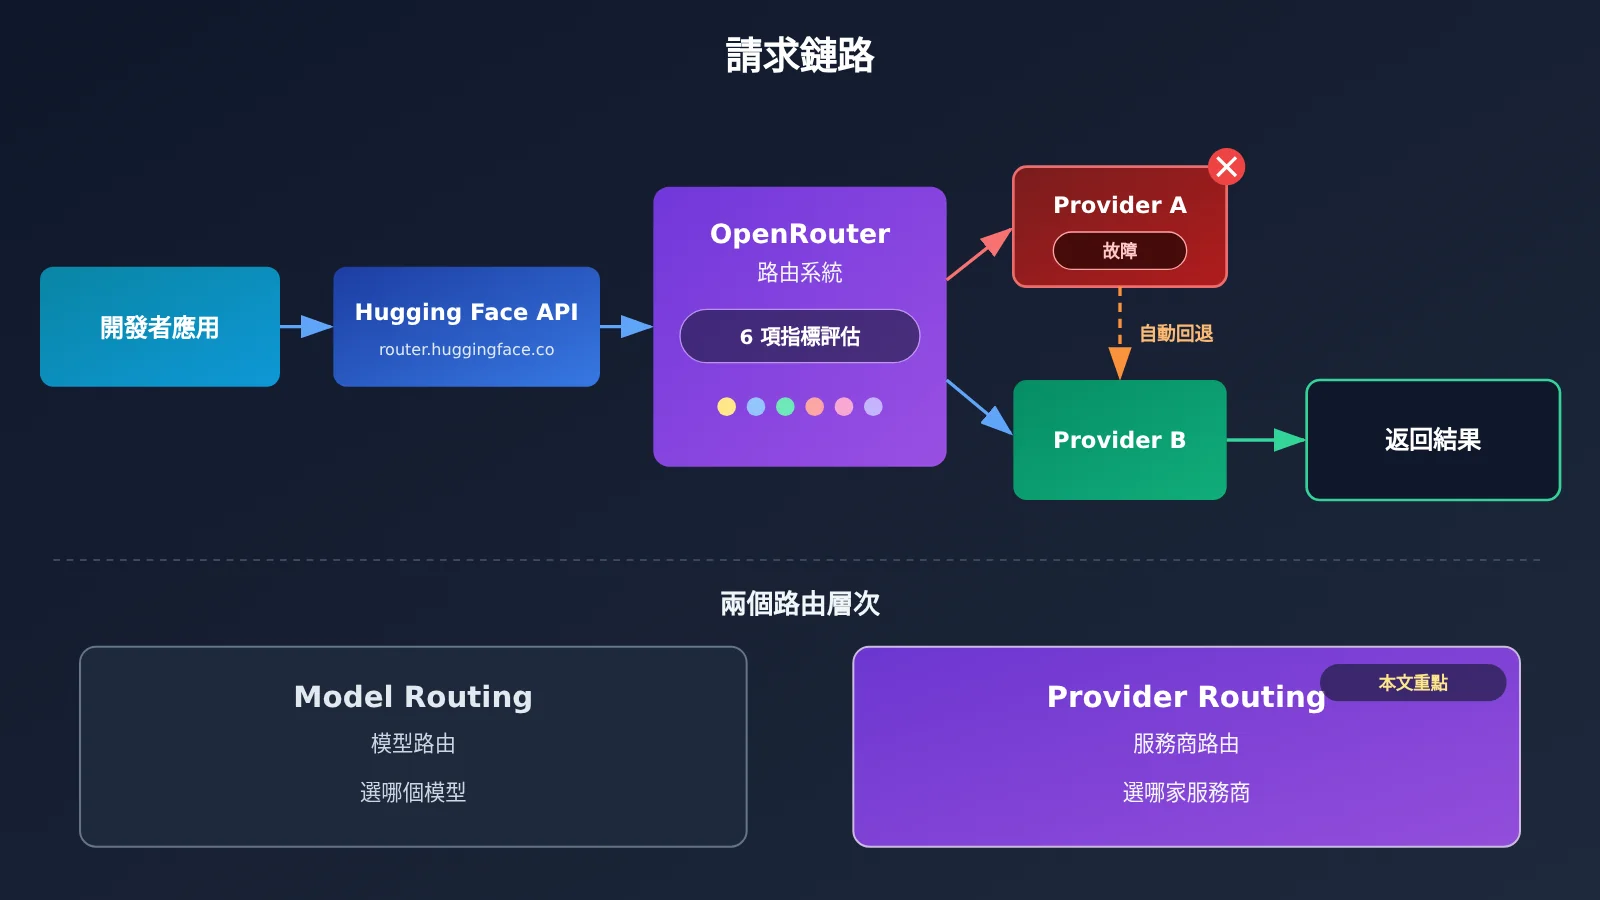
首先要區分兩個容易混淆的概念。Model Routing(模型路由) 決定用哪個模型回答,比如簡單問題交給小模型、複雜問題交給大模型。Provider Routing(服務商路由) 是在模型已經確定的前提下,決定由哪家服務商來執行推理。本文討論的 OpenRouter 與 Hugging Face 合作屬於後者:模型由開發者指定,路由層只挑選服務商,不會替你換模型。
合作之後,一次語言模型請求的鏈路是:開發者應用或 Coding Agent → Hugging Face API(router.huggingface.co)→ OpenRouter 路由系統 → 某個 Provider 推理 → 返回結果。OpenRouter 在這裏負責請求路由和服務商選擇,並不執行所有模型的推理。用戶仍使用 Hugging Face Token,通過 Hugging Face 賬戶或組織賬戶結算。Hugging Face 表示不在 Provider 推理價格上額外加價。
在控制方式上,Hugging Face 提供三個層次:
- 默認自動路由: 官方客戶端使用
provider="auto",系統綜合價格、速度和可靠性選擇服務商。 - 指定 Provider: 例如
provider="together",或在模型 ID 後加後綴:novita,請求固定交給該服務商。 - 策略路由: OpenAI 兼容接口支持
:cheapest(價格優先)和:fastest(吞吐量優先)後綴。
需要注意的是,:fastest 優化的是吞吐量,不是所有意義上的“快”。TTFT、生成速度和完整請求時間是三個不同指標。對於只輸出一兩句話的短回覆,首 Token 延遲往往比吞吐量更影響體感。
| 對比項 | 原 Hugging Face 路由 | 新 OpenRouter 路由 |
|---|---|---|
| 路由系統 | Hugging Face 自建路由器 | OpenRouter |
| Provider 選擇 | 原有選擇機制 | 實時綜合評估 |
| 價格依據 | 原有定價策略 | 實際有效價格 |
| 速度因素 | 原有性能機制 | 納入 TTFT 與吞吐量 |
| 單次失敗 | 可能直接返回錯誤 | 可在同一次請求中重試其他 Provider |
| 會話緩存 | 原有策略 | 支持按會話保持 Provider |
| 用戶憑證 | Hugging Face Token | 繼續使用 Hugging Face Token |
合格的多服務商路由系統需要看哪些指標
OpenRouter 於 2026 年 10 月 28 日公佈了新一代 Provider Routing 算法。舊的默認路由比較依賴輸入 Token 標價,低價服務商容易拿到更多流量。新算法把以下 6 類信號合成一個實時路由成本(Routing Cost),目標是優化“一次成功、可用的響應”的綜合成本,而不是單純追求最低單價。
① Effective Price(實際有效價格) 解決的是“標價便宜不等於賬單便宜”的問題。它會綜合未緩存輸入、緩存輸入、輸出三類單價,再結合實際請求的輸入輸出比例和該服務商的緩存命中率來計算。OpenRouter 給出的例子是:40,000 個未緩存輸入 Token($2/M)爲 $0.080,60,000 個緩存輸入 Token($0.50/M)爲 $0.030,4,000 個輸出 Token($8/M)爲 $0.032,合計 $0.142。在 Agent 場景中,緩存輸入佔比往往很高,只比較輸入標價可能選錯服務商。
② TTFT(首 Token 延遲) 解決的是“用戶要等多久纔看到回應”的問題。聊天界面和 Agent 多輪工具調用對它最敏感,因爲每一輪都要先等首 Token。
③ Throughput(吞吐量) 衡量的是開始生成之後的速度。新算法看的是完整響應過程中的生成吞吐量,而不只是瞬時峯值。長文本生成、代碼補全這類輸出量大的任務,主要受它影響。
④ Rate Limits(速率限制) 主要關注 HTTP 429 錯誤,解決的是“服務商容量不足”的問題。某家 Provider 頻繁返回 429,說明算力喫緊,路由會降低分配給它的流量。
⑤ Reliability(可靠性) 衡量請求失敗頻率。如果某服務商的錯誤率明顯高於同模型的其他服務商,系統會減少分流,必要時暫停流量直至恢復。
⑥ Quality(響應質量) 解決的是“同一個模型,不同部署表現不一致”的問題。按目前的公開說明,質量信號主要涉及工具調用能否正確返回、結構是否符合要求。工具調用格式異常或基準準確率明顯落後的服務商,競爭力會被下調。
除了這 6 項指標,OpenRouter 自身的路由文檔還把數據政策納入約束條件。例如 data_collection: "deny" 可以排除不符合數據收集要求的 Provider,zdr: true 要求使用零數據留存端點。Hugging Face 安全文檔說明,它不使用用戶請求數據訓練模型,路由時不保存請求正文和響應,調試日誌最長保留 30 天且不含用戶數據或 Token。但它同時提示開發者,仍需查看實際 Provider 的數據安全政策。平臺承諾不能替代每家服務商的數據處理協議。
OpenRouter 路由實驗數據與取捨
新算法上線前,OpenRouter 在 2026 年 10 月做了一次爲期一週的 Switchback 交替實驗。每天劃分爲 3 小時區塊,匹配的區塊分別使用新舊算法,每次切換後留 1 小時預熱期不計入測量,總計超過 2,400 萬次請求、1,030 億個輸入 Token。採用交替實驗而不是用戶隨機分組,是因爲新算法把流量從過載 Provider 移走後,舊算法組也會受益,這會干擾對比。
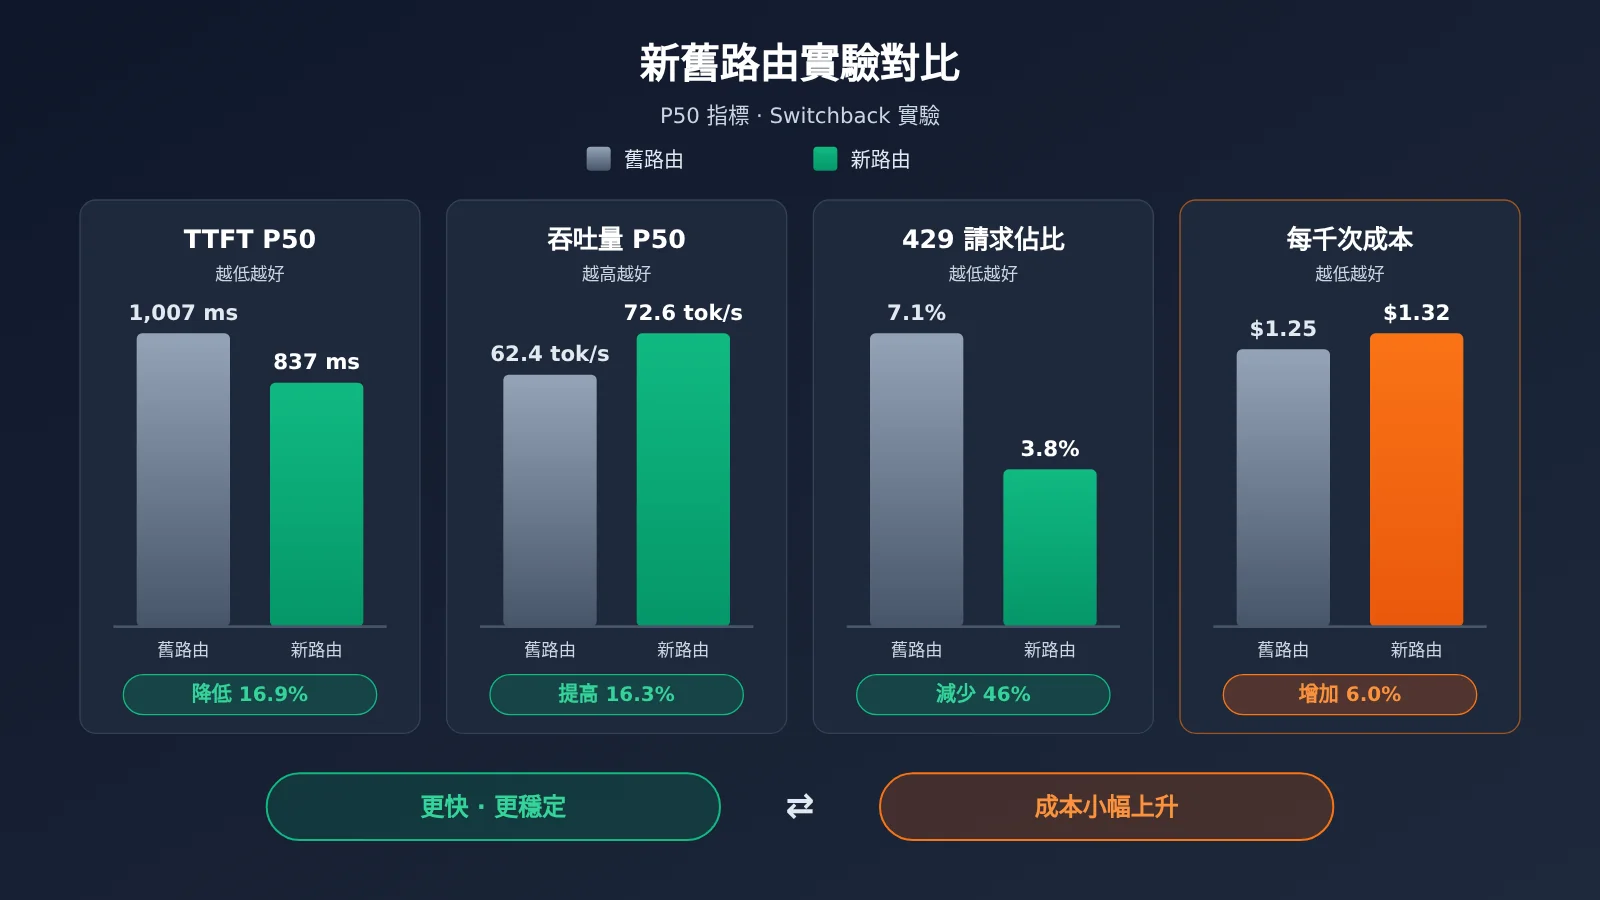
| 指標 | 舊路由 | 新路由 | 變化 |
|---|---|---|---|
| TTFT P50 | 1,007 ms | 837 ms | 降低 16.9% |
| TTFT P95 | 4,601 ms | 3,733 ms | 降低 18.9% |
| 吞吐量 P50 | 62.4 tok/s | 72.6 tok/s | 提高 16.3% |
| 完整請求耗時 P50 | 4.00 s | 3.24 s | 降低 19.0% |
| 至少一次 429 的請求 | 7.1% | 3.8% | 減少 46% |
| 需要重試的請求 | 10.4% | 6.9% | 減少 34% |
| 每千次請求成本 | $1.25 | $1.32 | 增加 6.0% |
| 每百萬 Token 成本 | $0.301 | $0.324 | 增加 7.3% |
這組數據體現了新路由的核心取捨:用約 6% 的每千次請求成本增長,換取更低的延遲和更少的容量錯誤。需要說明幾點限制:實驗由 OpenRouter 自行設計並公佈,未經第三方審計;樣本是一組代表性開放模型,不代表所有模型和服務商;結果是總體統計,不意味着每個請求都能獲得 16.9% 的改善。這些數據也來自合作之前的 OpenRouter 實驗,不是 Hugging Face 上線後的獨立實測。
💡 測試建議: 路由實驗給出的是整體統計,自己的業務表現還要自己測。如果需要在同一套代碼裏橫向對比多個主流模型的輸出質量和成本,可以通過 API易 apiyi.com 用一個 Key 統一調用,先把模型層面的選擇確定下來,再考慮服務商層面的優化。
Provider 出現故障時系統如何切換
自動 Failover 的典型流程是:路由選中 Provider A;A 正常則直接返回;A 報錯或遇到容量問題,系統在同一次請求中嘗試 Provider B;B 成功後返回結果。實驗中“需要重試的請求”從 10.4% 降到 6.9%,每次請求耗費在失敗嘗試上的時間從 349 ms 降到 242 ms。這說明好的路由不僅要會重試,還要儘量在一開始就避開狀態不佳的服務商。
自動回退和指定 Provider 是一對互相制約的選擇。默認路由允許切換,可用性更高。指定 Provider 則把請求固定在一家,滿足供應商准入要求,但失去了容災餘地。OpenRouter 自身 API 提供 only(只允許指定 Provider)配合 allow_fallbacks: false(不自動回退)的組合,可以讓請求在沒有合規服務商時直接失敗,而不是轉給其他供應商。需要區分的是,這些是 OpenRouter 完整 API 的參數,不能理解爲 Hugging Face 接口已全部開放。Hugging Face 側對應的能力,是指定 Provider 和在設置中禁用 Provider。
重試也有成本,並不是無限的:
- 時間成本: 每一次失敗嘗試都會拉長總耗時,對實時交互影響明顯。
- 流式輸出: 已經開始輸出的流式響應,不能無縫續接到另一家服務商。
- 重複副作用: 工具調用如果在第一次嘗試中已經觸發外部動作,重試可能導致重複執行,應用需要自己做冪等處理。
- 緩存損失: Prompt Caching 通常與具體服務商綁定,切換服務商可能丟掉緩存收益。Hugging Face 爲此提供
X-HF-Session-Id請求頭,用穩定的 UUID 讓同一會話儘量留在持有緩存的 Provider 上。 - 無可用服務商: 如果某模型只有一家 Provider,或其他 Provider 不支持當前參數,就沒有可切換的對象。額度不足、Token 權限不足、請求無效、上下文超限等問題,路由同樣解決不了。
Hugging Face 計費與自有 Key 的變化
這次合作帶來一項破壞性變更:通過 Hugging Face 調用語言模型時,不能再使用自己配置的 Provider API Key。所有相關請求都經 OpenRouter 路由,費用記到 Hugging Face 賬戶或組織賬戶。圖像、視頻生成任務的自有 Key 仍然可用,具體以官方說明爲準。
如果開發者想繼續使用自己購買的服務商額度,可以直接調用該服務商 API,或者改用 OpenRouter 自己的賬戶。按 OpenRouter 當前 BYOK 文檔的口徑:BYOK 的免費額度按等價推理目錄成本計量,Pay-as-you-go 賬戶爲每月 25,000 美元,Enterprise 爲自定義額度;超出部分按等價推理費用的 5% 計費,從平臺 Credits 中扣除。這裏的 25,000 是美元計量的推理成本,不是請求次數。另外,回退到共享容量時可能消耗平臺 Credits。直接接入 OpenRouter 是另一套獨立的賬戶和計費關係,原有 Key 不會自動遷移過去。
Hugging Face 當前定價文檔中,Free 用戶沒有固定月度贈送額度,PRO 用戶每月 $2,Team 和 Enterprise 每席位每月 $2。這些額度是通用 Compute Credits,可抵扣 Inference Providers、Inference Endpoints、Spaces 等服務。還有一點值得注意:Provider 定價機制不變,不等於每次請求成本不變,因爲路由可能選擇價格略高但更快、更穩定的服務商。
開發者如何用目錄 API 自己比較多家服務商
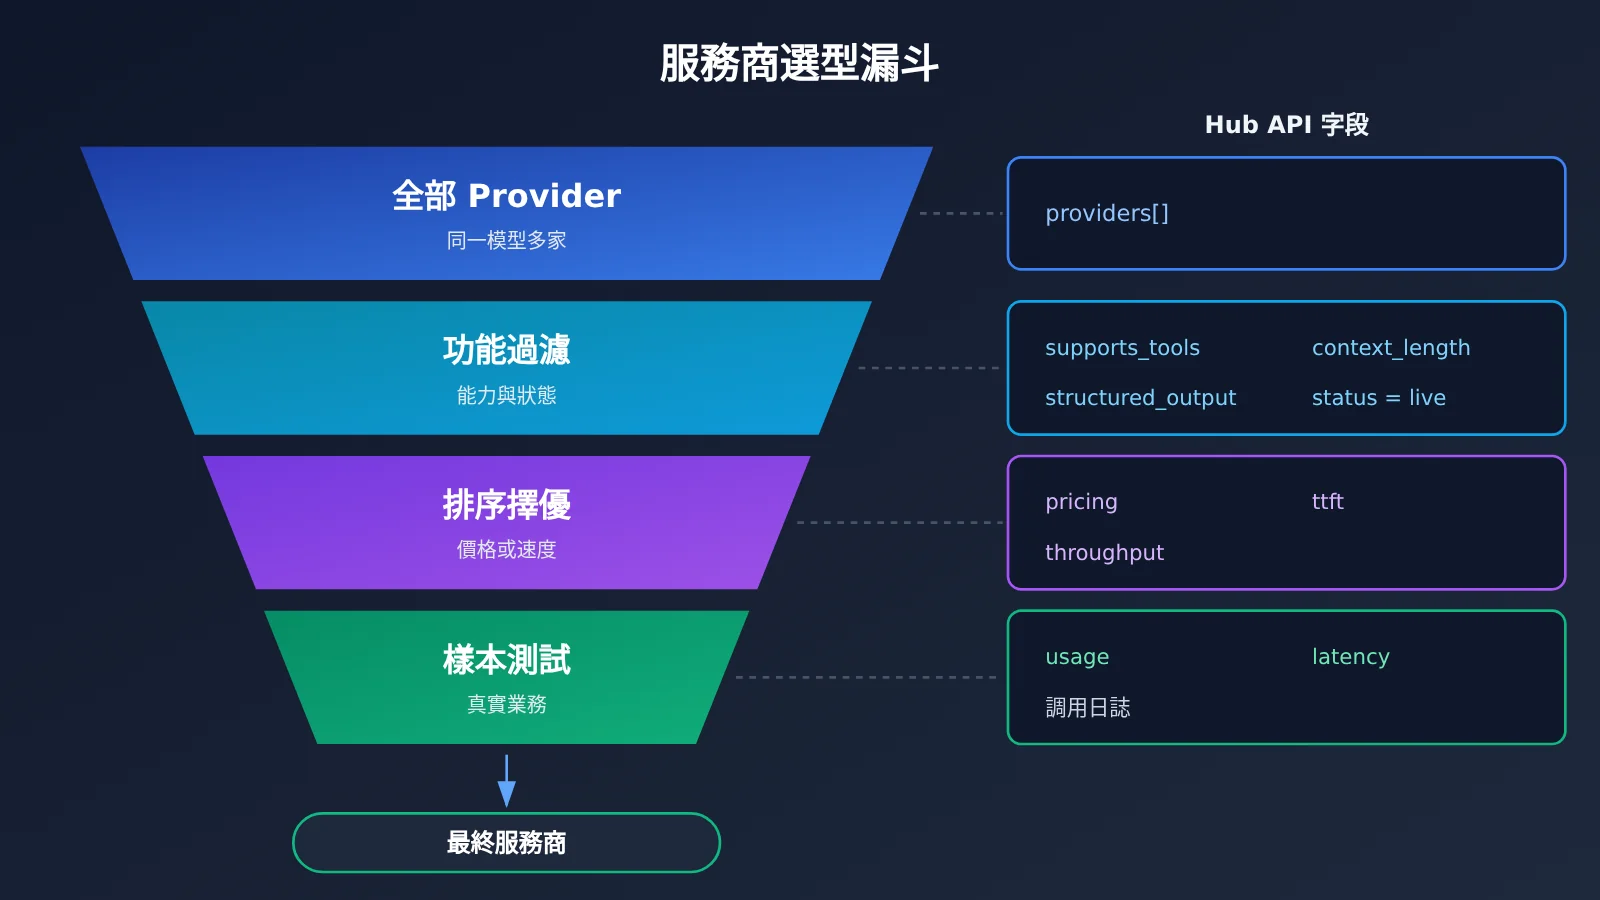
Hugging Face 提供了可查詢的模型目錄接口,這是路由系統獲得決策依據的一個公開窗口:
- 全部模型:
GET https://router.huggingface.co/v1/models - 單個模型:
GET https://router.huggingface.co/v1/models/deepseek-ai/DeepSeek-V4-Pro
| 字段 | 含義 | 在選型中的作用 |
|---|---|---|
| provider | 實際提供推理的服務商 | 確定候選名單 |
| status | 當前狀態,如 live、error | 排除不可用的服務商 |
| context_length | 該服務商支持的上下文長度 | 過濾長上下文需求 |
| pricing.input / pricing.output | 每百萬輸入、輸出 Token 美元價 | 成本排序 |
| supports_tools | 是否支持工具調用 | Agent 場景硬性條件 |
| supports_structured_output | 是否支持結構化輸出 | JSON 輸出硬性條件 |
| first_token_latency_ms | 最近一次驗證探測的首 Token 延遲 | 交互類排序 |
| throughput | 最近一次驗證探測的生成速度 | 長輸出類排序 |
| is_free / is_model_author | 臨時免費活動 / 是否爲模型發佈者 | 輔助參考 |
這些字段並非每個 Provider 都完整提供,性能數據也來自最近一次驗證探測,不等於你自己的端到端實時表現。合理的做法是“先過濾、再排序”:先用功能字段篩掉不兼容的服務商,再按成本或速度排序。下面的示例演示了這個思路,返回結構請以官方 Hub API 文檔爲準:
import os
import requests

HF_TOKEN = os.environ["HF_TOKEN"]
MODEL = "deepseek-ai/DeepSeek-V4.1-Flash"

resp = requests.get(
    f"https://router.huggingface.co/v1/models/{MODEL}",
    headers={"Authorization": f"Bearer {HF_TOKEN}"},
    timeout=30,
)
data = resp.json()
providers = data.get("providers", [])  # 具體結構以官方文檔爲準

# 第一步:功能過濾(Agent 需要工具調用 + 結構化輸出 + 64K 上下文)
candidates = [
    p for p in providers
    if p.get("status") == "live"
    and p.get("supports_tools")
    and p.get("supports_structured_output")
    and (p.get("context_length") or 0) >= 64_000
]

# 第二步:按輸出單價排序,缺失字段排到最後
candidates.sort(key=lambda p: (p.get("pricing") or {}).get("output", float("inf")))

for p in candidates:
    print(p["provider"], p.get("pricing"), p.get("first_token_latency_ms"), p.get("throughput"))
篩出候選之後,必須再用真實業務請求測一遍。目錄元數據說明的是服務商“聲稱支持什麼”,不能替代你自己任務上的準確率、工具調用成功率和最終完成率。
在服務商層面細調之前,通常還要先確定用哪個模型。下面這段代碼演示了用同一個 OpenAI 兼容接口批量對比多個模型的回答,模型 ID 請替換爲平臺模型列表中的實際名稱:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 統一接口,一個 Key 調用多家模型
)

prompt = "用 JSON 返回:{\"city\": 城市名, \"reason\": 一句話理由},推薦一個適合冬季旅行的城市"

for model in ["model-id-a", "model-id-b", "model-id-c"]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, resp.usage.total_tokens, resp.choices[0].message.content)
🚀 快速上手: 新用戶可以在 API易 apiyi.com 領取免費測試額度,用上面這段代碼跑一組自己的業務樣本。後臺調用日誌會記錄每次請求的模型、Token 消耗和費用,方便算出真實的單任務成本,而不是隻看標價。
需要說明的是,統一接入加調用日誌,和 Hugging Face 展示的 Provider 級實時性能數據,屬於不同層次的功能:前者解決“接得上、算得清”,後者進一步展示底層服務商的動態狀態。兩者可以搭配使用。
多家 API 服務商與智能路由:分析判斷
API 聚合平臺的下一步競爭在哪裏
把 OpenRouter 的能力拆開看,可以分爲三層:模型聚合解決“如何訪問不同模型”,Provider 聚合解決“同一模型由誰推理”,動態路由解決“這一次請求該交給誰”。統一接口已經基本解決了接入問題,這次合作說明,第二、三層正在變成新的競爭點。這一判斷的依據是:Hugging Face 選擇放棄自建路由器、改用外部路由能力;OpenRouter 也把路由算法單獨公開,並用生產實驗論證它的價值。
可以預見,成本優化、穩定性和數據治理會成爲 API 平臺新的比較維度。以下是預測,尚待後續驗證:路由透明度會越來越重要,開發者會希望知道請求落在了哪家服務商、爲什麼選它、付了多少錢;數據政策約束可能從附加選項變成企業採購的門檻條件。
不過,路由不是萬能藥。實驗數據顯示,更快、更穩的代價是更高的單位成本。合作公告中的後續計劃(例如連通兩邊賬戶、把更多任務納入 OpenRouter 路由)也還只是計劃。路由也無法解決模型本身的質量、許可證和業務適配問題。
開放權重模型需求與企業成本壓力
需求側的數據支持“服務商調度變得重要”這一判斷。OpenRouter 統計顯示,按前 50 個模型的每週 Token 量計算,2026 年 9 月 28 日開放權重模型佔比達到 71.7%。這是 OpenRouter 平臺內的統計口徑,不能推廣爲全球市場份額。開放權重模型用量越大,同一模型多家服務商並存的情況就越普遍,路由的價值也越明顯。
成本側,Capgemini 在 2026 年 9 月調查了 500 名大型企業 CXO,59% 表示 AI 支出明顯超出預期;在受影響企業中,平均超支幅度爲 24%。這組數據只代表該調查樣本,但它與路由實驗中“速度提升伴隨成本上升”的結論放在一起,提醒企業:自動路由默認追求的是綜合體驗,不一定是最低賬單。對成本敏感的業務,應主動選擇價格優先策略或設置價格上限,並用調用日誌持續覈對。
不同角色應如何取捨
- 個人開發者與小團隊: 默認自動路由已經能省掉自建容災的工作,重點是用真實樣本驗證工具調用和 JSON 輸出是否穩定。先通過 API易 apiyi.com 這樣的統一接口確定模型,再按需在服務商層面優化,是一條投入較低的路徑。
- 交互類產品: 優先關注 TTFT P95,而不是吞吐量。
:fastest未必能改善短回覆的體感。 - 長輸出與批處理任務: 吞吐量和有效價格更關鍵,可以考慮價格優先策略,並利用會話粘性保住緩存收益。
- 企業與平臺團隊: 先盤點哪些應用依賴自有 Provider Key、哪些業務必須固定服務商,再決定是允許回退、限定服務商,還是直連服務商。數據處理協議要逐家覈對。
無論選哪種策略,最終都要落到同一個動作上:拿自己的請求、自己的指標去跑一輪。在 API易 apiyi.com 用免費額度做小規模對比,或者用 Hugging Face 目錄 API 先篩出候選服務商,都是成本很低的起點。官方實驗的 16.9% 是整體平均值,你的業務能得到多少,只有測過才知道。
The proof of the pudding is in the eating.(布丁好不好,喫了才知道;實際效果要靠實踐檢驗。)


