Команда Alibaba Tongyi утром 2026-11-16 выпустила Qwen4-Max. Основные параметры — 2.4T, контекстное окно — 1M, и в придачу приложена сравнительная диаграмма с 16 бенчмарками.
Сразу к выводу: Qwen4-Max действительно лидирует по эффективности токенов и выполнению длительных задач, но не по всем пунктам сразу. Из 16 официально заявленных бенчмарков он взял 4 первых места и 4 вторых; в терминальных операциях, сборке программ, понимании диаграмм и понимании видео он всё ещё заметно отстаёт от ведущих конкурентов на той же диаграмме.
Источников информации в этой статье всего три: официальные материалы релиза от 2026-11-16, финальный снимок публичного рейтинга arena.ai Code Arena WebDev (2026-11-14) и две опубликованные цены — на QwenCloud и на платформе Qwen AI. Неопубликованные детали параметров и результаты сторонних воспроизведений в эту статью не входят. Если у вас сейчас работает Qwen3.8-Max или другая флагманская модель, после прочтения вы сможете по трём типам задач отдельно решить, стоит ли переходить, и самостоятельно посчитать по цене входа, цене выхода и цене кеша.
Краткая сводка о релизе Qwen4-Max
| Пункт | Детали |
|---|---|
| Дата выпуска | 2026-11-16 10:01 (UTC+8) |
| Разработчик | Команда Tongyi Qianwen (Qwen), Alibaba |
| Объём параметров | 2.4T основных параметров, 71B активируется на каждый токен, плюс 328B параметров N-gram Embedding |
| Контекст | 1M, нативная поддержка зрения |
| Официальные каналы | QwenCloud API, Qwen Studio, QwenWork, Qoder, приложение Qianwen |
| Планы по открытому коду | Официально заявлено, что веса Qwen4 меньших размеров будут открыты; про открытие самого Max речи не было |
Судя по темпу релизов, это не просто обновление очередной модели в API. Qwen4-Max одновременно появился в двух собственных продуктах — QwenWork (офис) и Qoder (программирование), а в официальных материалах акцент сделан на длительных агентных задачах и отраслевых внедрениях, а не на способности отвечать на вопросы как таковой.
Три изменения в архитектуре Qwen4-Max
В официальном блоге перечислены три структурных изменения — разберём, какую задачу решает каждое:
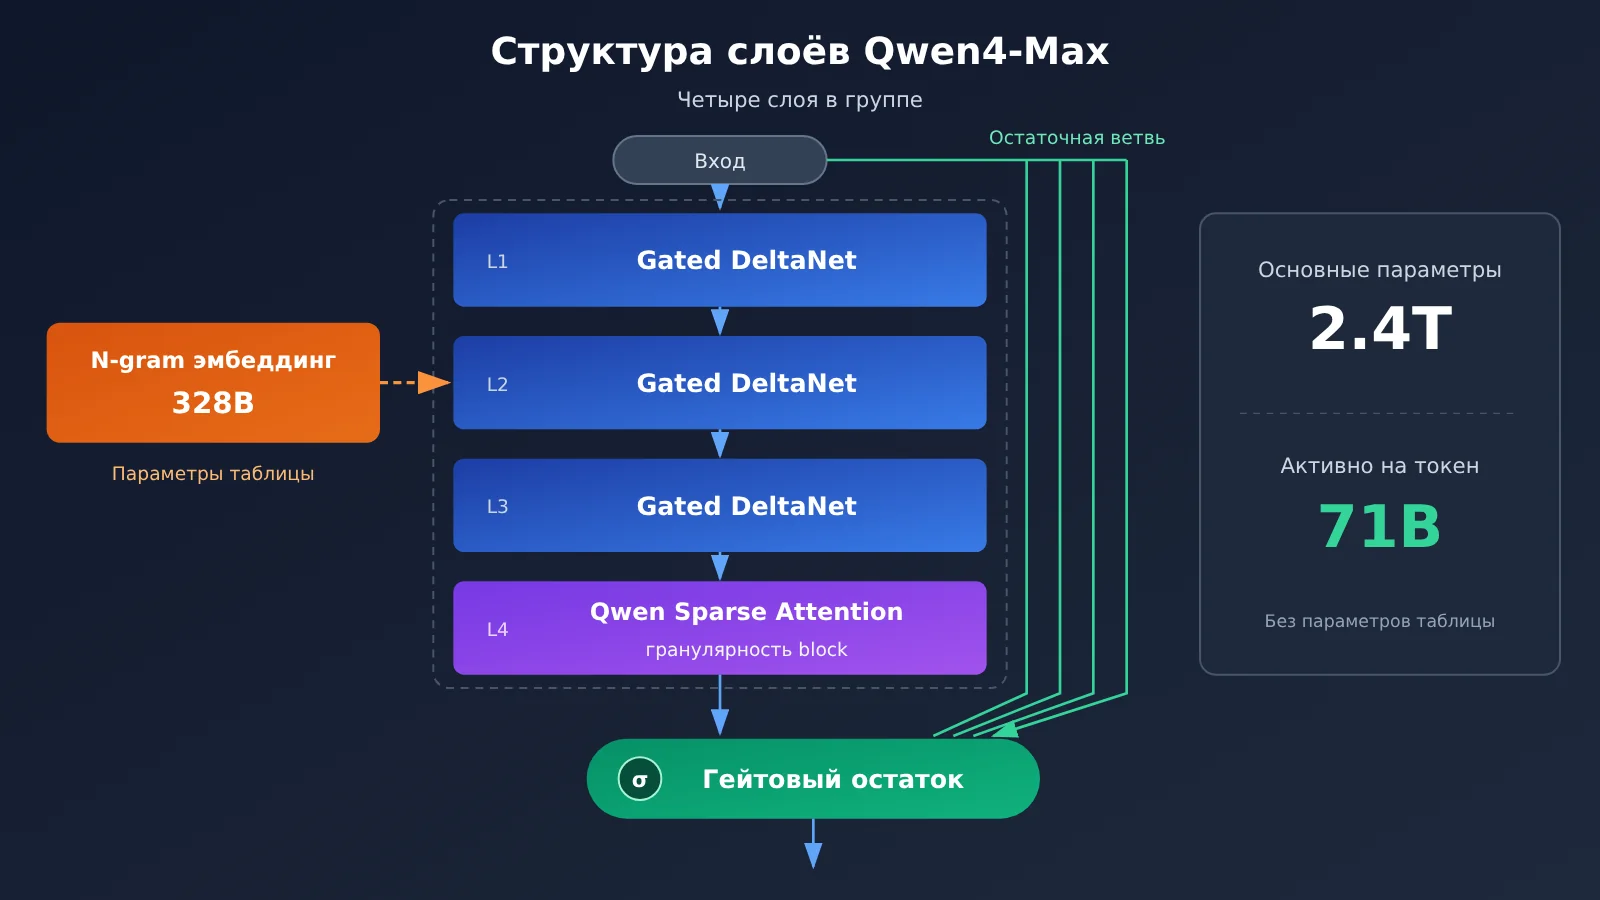
- Гибридное внимание GDN + QSA: из каждых четырёх слоёв три используют Gated DeltaNet, а четвёртый — Qwen Sparse Attention, причём контекст выбирается на уровне блоков. Главная цель такой схемы — снизить вычислительные затраты при длинном контексте в 1M.
- Gated Residual: путь остаточной связи разделён на четыре параллельные ветви, которые затем объединяются через гейтирование — это повышает выразительность глубокой сети.
- N-gram Embedding: на втором слое выполняется поиск по таблице, дополняющий локальные паттерны токенов. Отсюда и берутся дополнительные 328B параметров: это параметры таблицы поиска, они не участвуют в расчёте активации на каждый токен.
Важно: 2.4T — это суммарное число параметров основы, а на каждый токен реально активируется 71B. Сравнивая «размер параметров» с другими моделями, сначала убедитесь, что обе стороны считают по одной и той же методике.
Спецификации и протоколы Qwen4-Max
| Параметр | Qwen4-Max |
|---|---|
| Контекстное окно | 1M |
| Максимальный вход | 991K (в режиме размышления — 983K) |
| Максимальный выход | 393K |
| Максимальная цепочка рассуждений | 262K |
| TPM | 5 млн |
| Совместимые протоколы | OpenAI Chat Completions, Responses, Anthropic Messages, DashScope |
reasoning_effort по умолчанию |
high (у Qwen3.8-Max по умолчанию xhigh) |
Последнюю строку легко пропустить. У Qwen4-Max уровень рассуждений по умолчанию — high, на одну ступень ниже, чем xhigh у предыдущего поколения. Если сравнивать новое и старое поколение на параметрах по умолчанию, часть экономии токенов объясняется разницей в уровне, а не самой моделью. Для A/B-тестов лучше явно задавать одинаковое значение reasoning_effort.
Qwen4-Max: 16 официальных бенчмарков — где впереди, где позади
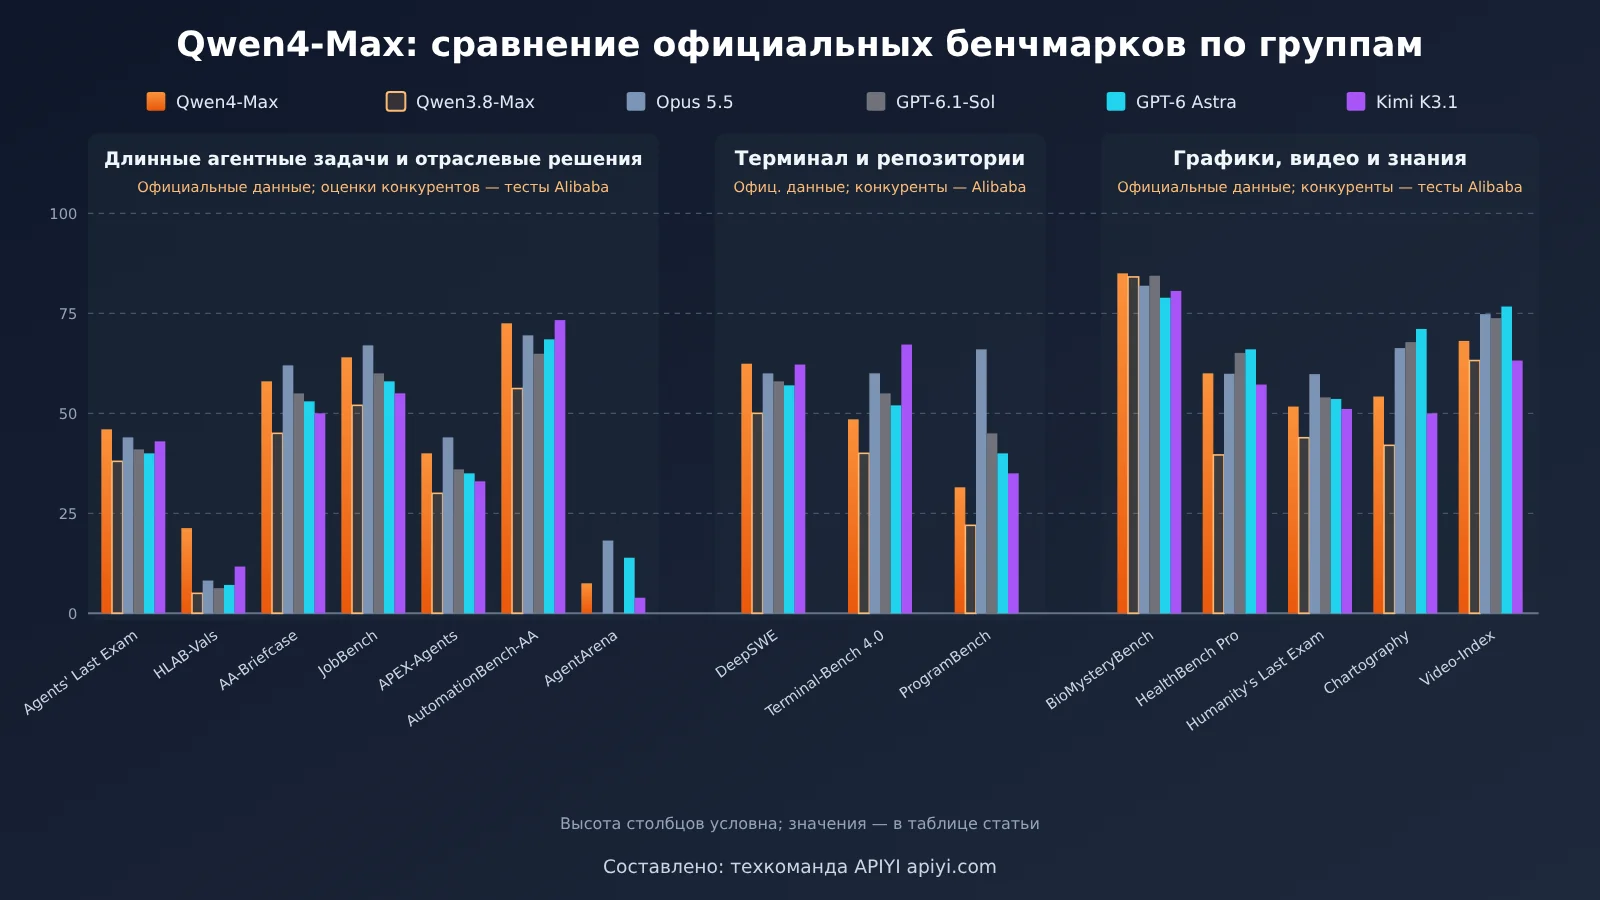
Все результаты в таблице ниже взяты из одного официально опубликованного графика и представляют собой данные самой компании. Оценки конкурентов на этом графике тоже получены Alibaba в ходе собственных замеров — их нельзя воспринимать как официальные результаты, объявленные Anthropic, OpenAI или Moonshot. При этом CodeArena и AgentArena взяты из LM Arena, AA-Briefcase и AutomationBench-AA — из Artificial Analysis, APEX-Agents — из рейтинга Mercor, а JobBench Alibaba тестировала самостоятельно на обновлённом наборе данных и с обновлённым кодом оценки.
| Бенчмарк | Qwen4-Max | Qwen3.8-Max-0902 | Opus 5.5 | GPT-6.1-Sol | GPT-6 Astra | Kimi K3.1 |
|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 75.7 | 69.3 | 74.2 | 75.2 | 74.1 | 75.5 |
| CodeArena WebDev (Elo) | 1750 | 1676 | 1816 | 1742 | 1763 | 1686 |
| Terminal-Bench 4.0 | 48.5 | 38.9 | 59.6 | 56.1 | 59.1 | 67.2 |
| ProgramBench | 31.5 | 28.0 | 65.0 | 52.5 | 55.0 | 25.0 |
| AA-Briefcase v1.1 (Elo) | 1686 | 1605 | 1801 | 1555 | 1569 | 1674 |
| Agents’ Last Exam v1.1 | 46.7 | 27.9 | 43.4 | 42.6 | 43.4 | не указано |
| JobBench | 68.5 | 65.3 | 75.4 | 66.2 | 66.1 | 61.2 |
| APEX-Agents v1.1 | 72.1 | 63.3 | 73.5 | 60.0 | 64.7 | 65.5 |
| HLAB-Vals-1.1 | 21.3 | 15.4 | 9.2 | 6.3 | 7.1 | 11.7 |
| AutomationBench-AA | 72.5 | 56.2 | 69.5 | 64.9 | 68.5 | 73.3 |
| AgentArena (Net Improvement) | 7.5 | — | 18.2 | — | 13.9 | 3.9 |
| BioMysteryBench | 85.0 | 84.1 | 81.9 | 84.4 | 78.9 | 80.6 |
| HealthBench Professional | 60.0 | 39.6 | 59.9 | 65.1 | 66.0 | 57.2 |
| Humanity’s Last Exam | 51.7 | 43.9 | 59.8 | 54.0 | 53.6 | 51.1 |
| Chartography | 54.2 | 42.0 | 66.3 | 67.8 | 71.1 | 50.0 |
| Video-Index | 68.1 | 63.2 | 74.8 | 73.8 | 76.7 | 63.2 |
Проекты, где Qwen4-Max впереди
Qwen4-Max занимает первое место в четырёх бенчмарках: DeepSWE, Agents’ Last Exam, HLAB-Vals и BioMysteryBench. Самый большой отрыв — в HLAB-Vals: 21,3 балла, что примерно вдвое больше результата занявшего второе место Kimi K3.1. В DeepSWE модель обходит Kimi всего на 0,2 балла, и такой разрыв можно смело считать ничьей.
Ещё в четырёх бенчмарках она вторая: AA-Briefcase, JobBench, APEX-Agents и AutomationBench-AA. В первых трёх первое место держит Opus 5.5, в последнем — Kimi K3.1. Все эти бенчмарки заточены под длительные agent-задачи и под то, что называют работой «белых воротничков», — именно это и продвигают в этом релизе.
Где Qwen4-Max отстаёт
Работа в терминале и сборка программ — самое заметное слабое место в этот раз. 48,5 балла в Terminal-Bench 4.0 — пятое место среди шести моделей, на 18,7 балла меньше, чем у лидера Kimi. 31,5 балла в ProgramBench — меньше половины результата Opus 5.5. Если ваш агент в основном собирает, отлаживает и разворачивает проекты в shell, эти два бенчмарка дают больше информации, чем DeepSWE.
С пониманием графиков и видео тоже не всё гладко. Chartography и Video-Index — оба на четвёртом месте, отставание от лидера GPT-6 Astra составляет 16,9 и 8,6 балла соответственно. Humanity’s Last Exam тоже на четвёртом месте. Так что «нативное зрение» здесь означает, что возможность есть, а не что модель лидирует в этой области.
Место Qwen4-Max в публичном рейтинге Code Arena
Финальный снимок публичного рейтинга arena.ai Code Arena WebDev (2026-11-14) насчитывает 1 007 405 голосов и 159 моделей. Qwen4-Max (xHigh) с 1750 баллами занимает 6-е место, имеет пометку Preliminary и всего 1 814 голосов; на странице указана стоимость одной задачи по P50 — $4,18. Перед ней идут Claude Fable 5.2, Claude Opus 5.5, Claude Sonnet 5.5, Gemini 4 Carbon (Preliminary) и GPT-6 Astra.
Предыдущее поколение Qwen3.8-Max (0902) в том же рейтинге занимало 16-е место с 1676 баллами, так что нынешнее поколение прибавило 74 балла и поднялось на 10 позиций. Правда, у Qwen4-Max пока относительно мало голосов, поэтому рейтинг ещё может измениться.
Откуда у Qwen4-Max такая token-эффективность и «снижение стоимости на 60%»
Официальные цифры по эффективности взяты из собственного сценарного бенчмарка Work360. В нём 26 доменов первого уровня, 182 — второго и 721 — третьего; Qwen4-Max набирает 52,69 балла, Qwen3.8-Max — 47,74. По расходу токенов Work360 в режиме Xhigh экономит около 24%, в режиме High — около 35%; на Terminal-Bench 4.0 эти два режима дают примерно 48% и 49% экономии соответственно.
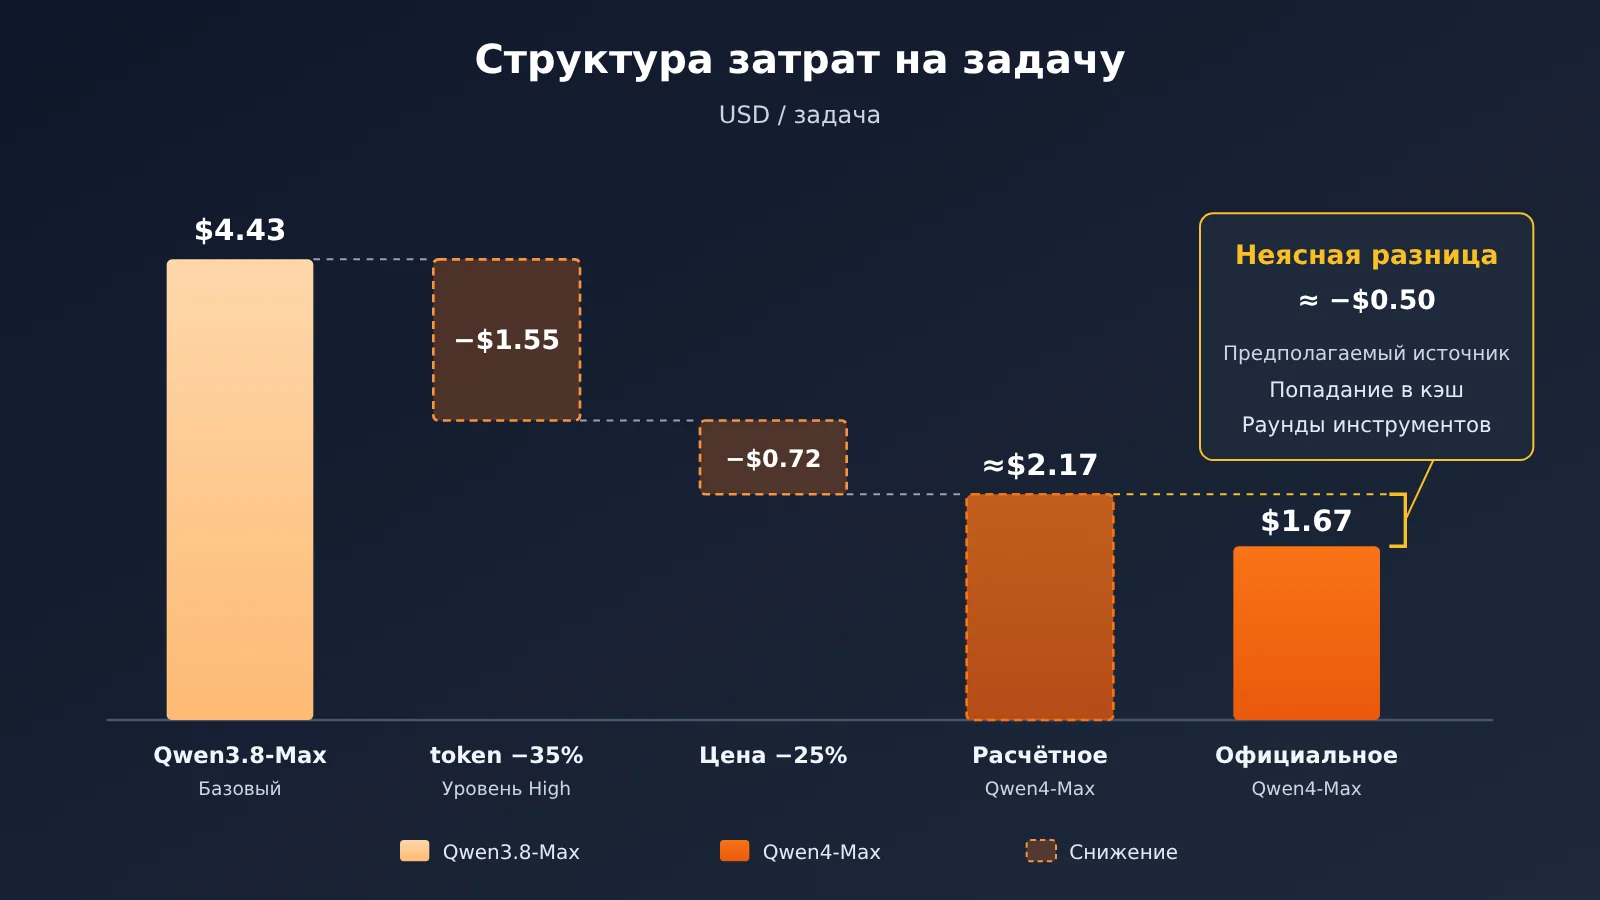
Что касается средней стоимости одной задачи, официальные цифры — с $4.43 до $1.67, а в китайском блоге — с ¥26.58 до ¥11.16, то есть падение на 58%. В долларах снижение получается около 62%. Но если считать только по формуле «токенов на 35% меньше × цена за токен ниже на 25%», выходит примерно 0,65 × 0,75 ≈ 0,49, то есть снижение около 51%. Оставшуюся разницу официально никак не объясняют; наиболее вероятные источники — рост доли попаданий в кэш и меньшее число раундов вызова инструментов, но это лишь догадки, а не подтверждённые причины.
По безопасности: на уровне функций в Last Secure Code Bench показатель «двойного прохождения» — и по функциональности, и по отсутствию уязвимостей — вырос с 22,0% до 31,8%. Доля случаев, когда безопасный код генерируется на всех трёх уровнях — функция, файл, репозиторий, — выросла с 8% до 14,7%. Абсолютные значения по-прежнему невысоки, и сгенерированный код всё ещё требует проверки человеком.
Как рассчитывается цена Qwen4-Max
Ниже — официальные цены Qwen4-Max, а также официальные цены предыдущего поколения и текущие цены APIYI. Все значения указаны в долларах США за 1 млн токенов, дата сбора данных — 2026-11-16.
| Статья расходов | Qwen4-Max (официально QwenCloud) | Qwen3.8-Max (официально) | qwen3.8-max (текущая цена APIYI на apiyi.com) |
|---|---|---|---|
| Вход | $1.5 | $2 | $1.65 |
| Выход | $4.5 | $6 | $4.95 |
| Чтение кеша / попадание в кеш | $0.075 | $0.25 | $0.20625 |
| Создание явного кеша на 5 минут | $1.875 | — | — |
| Создание явного кеша на 1 час | $3 | — | — |
Цены в юанях приведены по данным платформы Qwen AI, единица — юани / 1 млн токенов, дата сбора данных — 2026-11-16:
- Вход — ¥10, выход — ¥30, попадание в кеш — ¥0.5
- Создание явного кеша на 5 минут — ¥12.5, создание явного кеша на 1 час — ¥20
По сравнению с официальными ценами предыдущего поколения у Qwen4-Max цена входа и цена выхода ниже на 25%, а цена чтения кеша — на 70%. Сильнее всего подешевело чтение кеша, и для долгосрочных агентов это заметно: в многораундовых задачах много повторяющихся системных промптов и исторического контекста тарифицируется по цене кеша.
Если хотите оценить стоимость самостоятельно, разложите её по формуле: входные токены без попадания в кеш × цена входа + попадания в кеш × цена кеша + объём создания явного кеша × цена создания + выходные токены (включая цепочку рассуждений) × цена выхода. Вот гипотетический пример: в задаче 1 млн входных токенов, из них 600 000 попадают в кеш, а выход — 100 000 токенов. По официальным ценам Qwen4-Max получается примерно $0.6 + $0.045 + $0.45 ≈ $1.10. При том же объёме токенов по официальным ценам Qwen3.8-Max выходит около $1.55. К реальной разнице ещё добавится изменение расхода токенов, поэтому надёжнее всего заново прогнать расчёт на собственных реальных логах.
💰 Подсказка по расчётам: APIYI пока не добавил qwen4-max в каталог, но мы скоро это сделаем. Точное название модели и цена будут указаны в списке моделей на платформе apiyi.com. До появления новой модели можно взять
qwen3.8-maxна платформе и построить базовую стоимость, а когда модель выйдет, просто сравнить два счёта.
Как по сценарию решить, стоит ли переходить на Qwen4-Max
| Сценарий | Показатели Qwen4-Max (по официальным заявлениям) | Рекомендация |
|---|---|---|
| Длинные agent-задачи и отраслевые поставки (автоматизация офиса, исследования, сдача документации) | Первое место в HLAB-Vals и Agents’ Last Exam; второе место в APEX, JobBench, AA-Briefcase; заметная экономия токенов | Оценивать в первую очередь: выгода от перехода с Qwen3.8-Max здесь наиболее очевидна |
| Терминал и репозитории кода (shell agent, сборка, изменения в нескольких репозиториях) | Первое место в DeepSWE, но с небольшим отрывом; пятое место в Terminal-Bench, четвёртое в ProgramBench | Для задач с преобладанием терминальных операций сначала сравните с Kimi K3.1 и Opus 5.5, а потом решайте |
| Фронтенд WebDev | 6-е место в публичном рейтинге Code Arena, 1750 баллов (Preliminary) | Можно рассматривать как вариант с хорошим соотношением цена/качество, но это не лидер |
| Понимание графиков и видео, мультимодальные длинные документы | Четвёртое место и в Chartography, и в Video-Index | Для процессов, где много работы с изображениями и видео, пока не рекомендуется использовать только её |
| Биологические и медицинские вопросы-ответы | Первое место в BioMysteryBench; третье место в HealthBench Professional | Можно включить в тестирование, но нужна проверка профильными экспертами |
Достаточно надёжный подход — разделить потоки: задачи вроде длинных agent-сессий и сдачи документации передать Qwen4-Max, а терминалоёмкие задачи и задачи с графиками и видео оставить моделям, которые сейчас лучше справляются с этим. Так не нужно переносить весь трафик разом, и при этом можно сразу получить выгоду от экономии токенов.
🎯 Совет по выбору: чтобы разделить потоки, нужна возможность переключать модели в рамках одного и того же кода. APIYI apiyi.com предоставляет OpenAI-совместимый интерфейс: с одним API-ключом можно вызывать флагманские модели разных производителей — достаточно поменять поле
model, чтобы провести A/B-тестирование.
Qwen4-Max: быстрый старт
Официальный канал — QwenCloud API, он поддерживает четыре протокола: OpenAI Chat Completions, Responses, Anthropic Messages и DashScope. Уже имеющиеся OpenAI SDK или Anthropic SDK можно подключать напрямую. При подключении обратите внимание на следующие моменты:
- Уточните модель: официальный ID модели записывается как
qwen4-max, ориентируйтесь на страницу модели. По умолчаниюreasoning_effortравенhigh; при сравнительном тестировании явно указывайте один и тот же уровень, напримерxhigh. - Резервируйте место для вывода: максимальный вывод — 393K, максимальная цепочка рассуждений — 262K. Для длинных задач задавайте
max_tokensили соответствующий параметр достаточно большим, иначе цепочка рассуждений займёт всю выходную квоту. - Включите кэширование: цена при попадании в неявный кэш — $0.075. Если системный промпт длинный и будет повторно использоваться, оцените, стоит ли использовать явное кэширование на 5 минут или 1 час; создание кэша оплачивается отдельно, и при слишком малом числе повторных использований это может оказаться невыгодно.
- Подготовьте контрольную группу: после регистрации в APIYI получите API-ключ, установите
base_urlвhttps://api.apiyi.com/v1, вmodelукажитеqwen3.8-maxи прогоните тот же набор задач, чтобы получить расход токенов и оценку старой модели в качестве базовой линии. - Переключитесь после появления новой модели: когда qwen4-max появится в APIYI, достаточно изменить поле
model, остальной код остаётся без изменений — и вы сразу получите данные для сравнения старого и нового поколений.
🚀 Быстрый старт: новые пользователи могут зарегистрироваться в APIYI apiyi.com и получить бесплатную тестовую квоту — её хватит, чтобы сначала прогнать базовую линию
qwen3.8-max; для последующего переключения модели не нужно заново подключаться.
Qwen4-Max: часто задаваемые вопросы (FAQ)
Вопрос 1: Что такое Qwen4-Max?
Qwen4-Max — флагманская модель Tongyi Qianwen, выпущенная 16 ноября 2026 года. У неё 2,4 трлн параметров в основной части, 71 млрд активируются на каждый токен, есть нативная поддержка визуального ввода, контекстное окно 1M. Ориентирована прежде всего на длительные задачи агентов и отраслевые проекты под заказ.
Вопрос 2: Чем Qwen4-Max отличается от Qwen3.8-Max?
В 16 бенчмарках, которые разработчик публикует сам, Qwen4-Max по каждому пункту выше Qwen3.8-Max-0902. На публичном лидерборде Code Arena — на 74 балла больше. По официальным ценам: ввод и вывод дешевле на 25% каждый, чтение кэша — на 70%. Кроме того, у моделей разные уровни рассуждений по умолчанию: `high` и `xhigh`.
Вопрос 3: Можно ли верить этим 16 бенчмаркам?
Все эти результаты заявлены самим разработчиком, а оценки конкурентов Alibaba тоже измеряла сама — независимого воспроизведения пока нет. Из внешних сигналов можно опереться на публичный лидерборд Code Arena WebDev: в срезе финального рейтинга от 14 ноября 2026 года Qwen4-Max занимает 6-е место, но статус всё ещё Preliminary, и голосов мало.
Вопрос 4: Можно ли просто перенести «снижение стоимости на 60%» на свой бизнес?
Напрямую — нет. Эта цифра взята из официального сценария Work360, и снижение там больше, чем даёт простой расчёт по токенам и цене за токен. Чем объясняется эта разница, разработчик не уточняет. Ваш реальный процент экономии зависит от доли попаданий в кэш, числа раундов вызова инструментов и уровня рассуждений — считать нужно по логам собственных задач.
Вопрос 5: Можно ли вызывать Qwen4-Max через APIYI?
По состоянию на 11:00 16 ноября 2026 года модели qwen4-max в списке APIYI ещё нет, но мы добавим её как можно скорее. Сейчас из флагманов Qwen доступна `qwen3.8-max` по цене: ввод $1.65, вывод $4.95, чтение кэша $0.20625 (за 1M токенов). Актуальный статус добавления и цены смотрите в списке моделей на apiyi.com.
Вопрос 6: Какие у Qwen4-Max слабые места?
Работа в терминале (Terminal-Bench — пятое место), сборка программ (ProgramBench — четвёртое), понимание графиков и видео (оба — четвёртые), а также HLE (четвёртое) — везде модель уступает лидерам с той же диаграммы. Доля двойных прохождений для безопасного кода хоть и выросла, но составляет всего 31,8%. Кроме того, открытых весов для размера Max пока не планируется.
Итоги: стоит ли переходить на Qwen4-Max
- Позиционирование: флагманская модель с магистралью 2.4T, активацией 71B на токен и контекстом 1M; ставка сделана на длительные агентские задачи и отраслевые поставки.
- Где лидирует: из 16 официально заявленных бенчмарков — 4 первых места и 4 вторых, в основном в агентских задачах и бенчмарках на «офисную» работу и сдачу результатов.
- Где отстаёт: терминальные операции, сборка программ, диаграммы, видео и HLE — четвёртое или пятое место; одной моделью все задачи не закрыть.
- Место в публичном рейтинге: снимок финального лидерборда Code Arena WebDev (2026-11-14) — 6-е место, 1750 баллов, статус по-прежнему Preliminary.
- Стоимость: официальная цена за единицу снижена на 25%, чтение кэша — на 70%, расход токенов тоже заметно меньше; «минус шестьдесят процентов» нужно проверять на своих данных.
Если основная нагрузка — длительные агентские задачи и работа с документами, Qwen4-Max стоит оценить в первую очередь; если это терминалоёмкие задачи или понимание диаграмм и видео, лучше продолжать разводить их по текущим более сильным моделям. Пока qwen4-max не вышел, можно через OpenAI-совместимый интерфейс APIYI apiyi.com построить базовую линию по стоимости и качеству на qwen3.8-max; когда новая модель появится, достаточно изменить одно поле — и сравнение готово.
📚 Источники
- Официальный пост Qwen в X: анонс релиза Qwen4-Max
- Ссылка:
x.com/Alibaba_Qwen/status/2122148127520289151 -
Что здесь: дата релиза и официальные каналы доступности
-
Официальный блог Qwen (на китайском): архитектура, характеристики, 16 бенчмарков и цифры по эффективности
- Ссылка:
qwen.ai/blog?id=qwen4-max -
Что здесь: архитектура, характеристики и данные бенчмарков в этой статье взяты именно отсюда
-
Страница модели на QwenCloud: цены в долларах
- Ссылка:
qwencloud.com/models/qwen4-max -
Что здесь: цены за вход, выход и кеширование в долларах за 1M tokens
-
Страница модели на платформе QianwenAI: цены в юанях
- Ссылка:
qianwenai.com/models/qwen4-max -
Что здесь: цены в юанях за 1M tokens
-
arena.ai Code Arena WebDev: публичный лидерборд
- Ссылка:
arena.ai - Что здесь: в статье используется снимок финального рейтинга от 2026-11-14
Автор: техническая команда APIYI
Связь по техническим вопросам: если хотите узнать о сроках появления модели и способах подключения — свяжитесь с нами на главной странице сайта APIYI, документация доступна на docs.apiyi.com