Nota do autor: o MiniMax H3 e o H3-Image tiveram os pesos do modelo abertos, mas os componentes do sistema, os serviços em nuvem e as licenças da comunidade definem os limites para desenvolvimento e uso comercial. Neste artigo, destrinchamos tudo módulo por módulo e licença por licença.
Em 10 de novembro de 2026, a MiniMax abriu os pesos do H3-Image. Antes disso, em 3 de agosto de 2026, o modelo de geração de vídeo omnimodal MiniMax H3 já tinha sido aberto (open source). Os dois lançamentos têm mais de três meses de diferença, mas costumam ser discutidos como se fossem a mesma coisa. Na verdade, são dois modelos com duas licenças diferentes.
Este não é um artigo para criticar um suposto “falso open source”. O comunicado oficial, o model card no Hugging Face e o texto original das licenças deixam tudo bem claro: o que a MiniMax abriu foram os pesos e os materiais de inferência centrados no modelo gerador principal, e não o sistema completo na nuvem. O que vamos fazer aqui é separar, item por item, o que foi aberto, o que não foi e como você pode usar cada parte.
Valor central: ao terminar a leitura, você vai saber diferenciar o status de abertura de cada um dos três módulos do MiniMax H3, entender quais componentes do H3-Image dá para rodar localmente e conhecer as diferenças concretas entre as duas Community Licenses, tanto no limite de receita quanto nos serviços hospedados.
MiniMax H3: resumo das informações essenciais sobre o código aberto
Primeiro, a linha do tempo e os fatos básicos numa tabela só. Todas as conclusões abaixo se baseiam nos comunicados oficiais, nos model cards e no texto original das licenças, com verificação até 11 de novembro de 2026.
| Item | MiniMax H3 (vídeo) | MiniMax H3-Image (imagem) |
|---|---|---|
| Data de abertura | 3 de agosto de 2026 | 10 de novembro de 2026 |
| Posicionamento | Geração de vídeo omnimodal, com saída de vídeo e áudio estéreo nativo | Geração e edição de imagens em alta resolução, derivada do H3 |
| Escala principal | 33B de parâmetros | DiT com 33,1B de parâmetros |
| Conteúdo liberado | Pesos do H3-Base e materiais de inferência (dois checkpoints: FL2VA e Ref2VA) | DiT, Image VAE, Tokenizer/Processor, modelo PE etc. |
| Ainda depende da nuvem | Context-IR, Regenerate-2K | H3-Image-Context-IR |
| Licença | H3 Community License | H3-Image Community License |
Antes de ler: 6 termos essenciais sobre o MiniMax H3
- Pesos abertos (open weights): você pode baixar os parâmetros do modelo já treinado, mas o que é permitido fazer com eles depende da licença. Isso não significa que os dados de treinamento e todo o pipeline sejam públicos.
- Community License: um acordo de licença criado pelo próprio provedor do modelo. Não é uma licença aberta genérica como MIT ou Apache 2.0.
- Checkpoint: o arquivo de parâmetros usado para carregar o modelo. Um mesmo modelo pode ter vários checkpoints para tarefas diferentes.
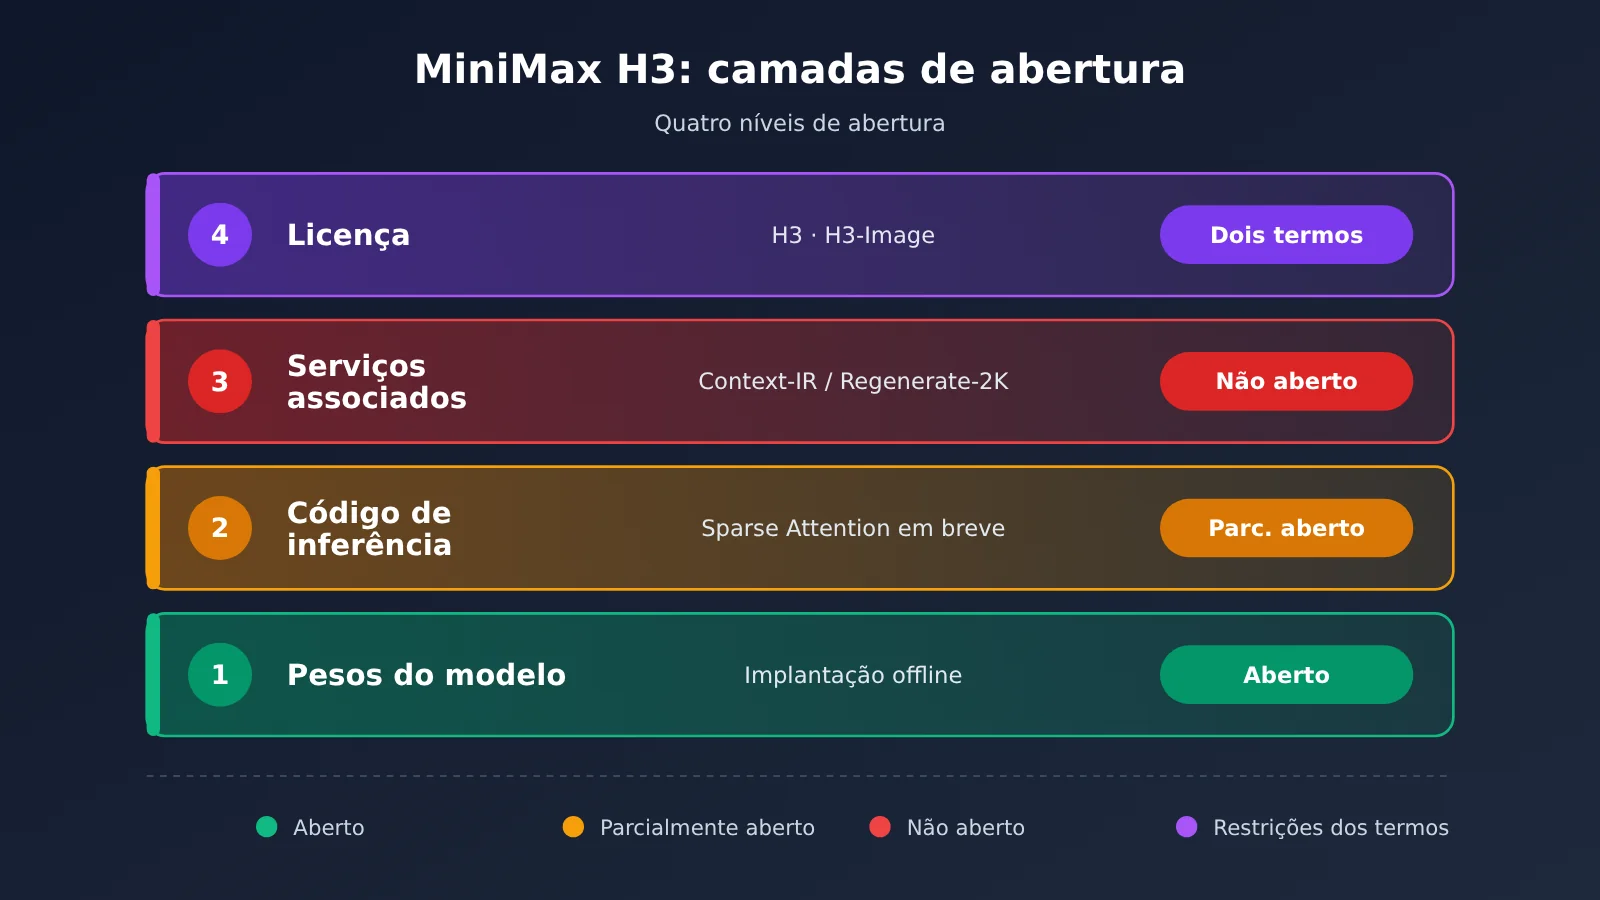
- Context-IR: serviço oficial que entende entradas multimodais, interpreta instruções e organiza o contexto. Hoje, ele só está disponível via API.
- Serviço hospedado (hosting): oferecer as funções do modelo a terceiros pela rede, por exemplo expondo uma API pública. É o cenário que as restrições da licença mais miram.
- Atenção esparsa (sparse attention): técnica que calcula só parte das relações de atenção para reduzir o custo computacional em sequências longas.
Modelo de vídeo MiniMax H3: de 3 módulos, só 1 foi aberto
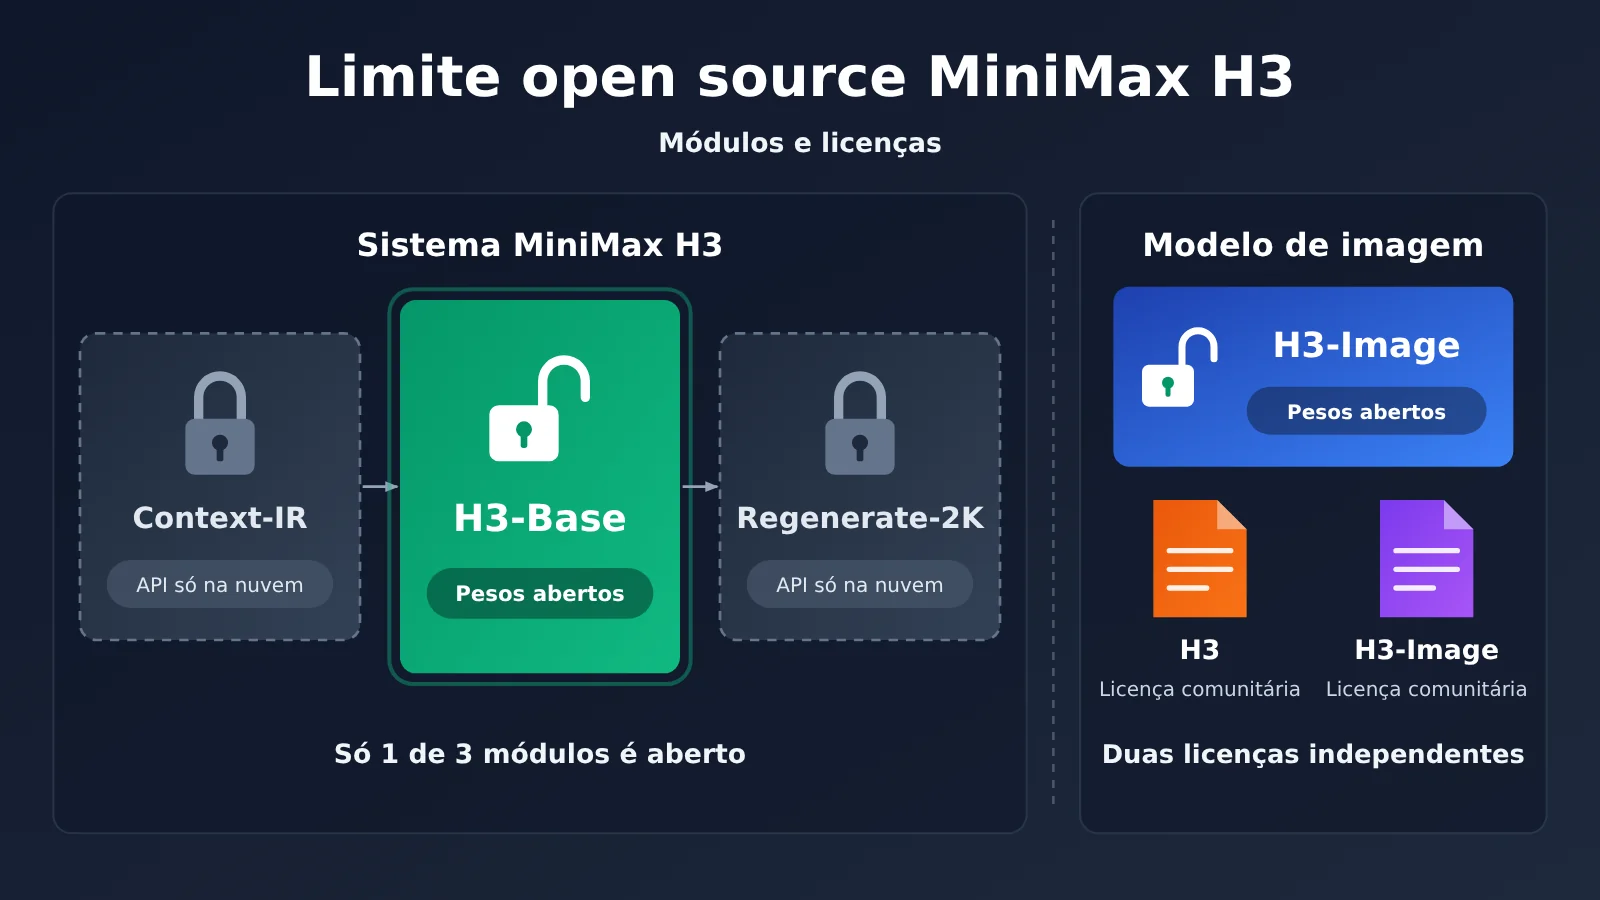
O anúncio oficial divide o sistema MiniMax H3 completo em três módulos. Entender essa divisão é a chave para entender o “é open source, mas nem tanto”.
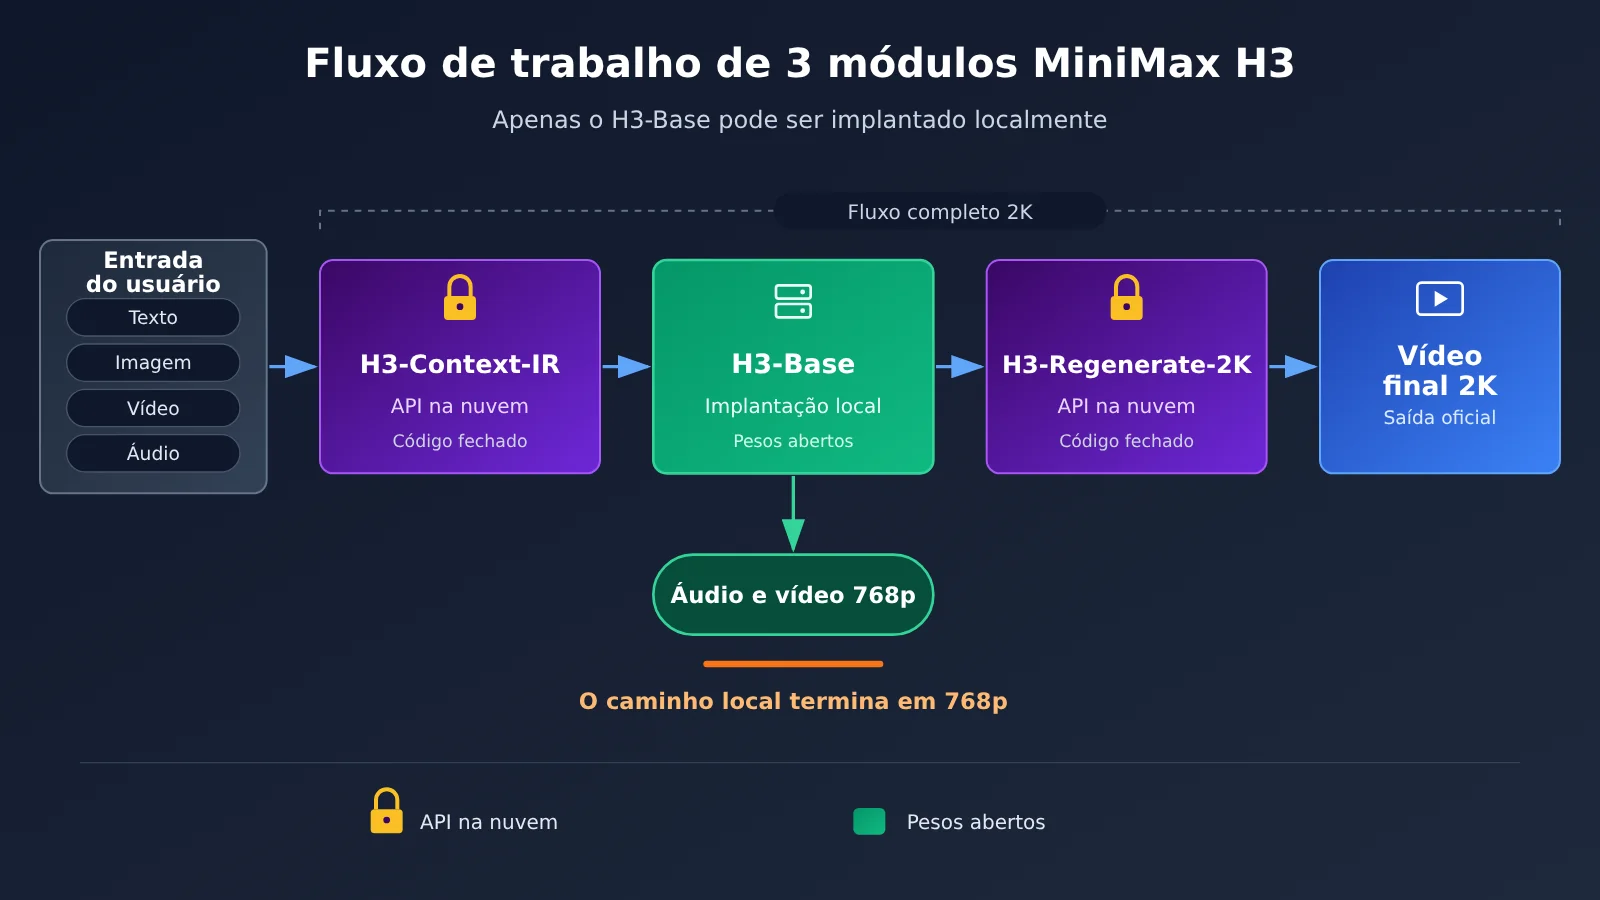
| Módulo | Função | Situação de abertura | Uso local |
|---|---|---|---|
| H3-Context-IR | Compreensão de entradas multimodais, interpretação de instruções, estruturação de contexto | Código fechado, disponível via API oficial | Não |
| H3-Base | Modelo central de geração de vídeo e áudio | Pesos e materiais de inferência abertos | Sim |
| H3-Regenerate-2K | Usa o contexto original para regenerar o resultado de baixa resolução em 2K | Código fechado, disponível via API oficial | Não |
Os dois checkpoints do MiniMax H3-Base
O H3-Base não é um único arquivo de pesos: vem com dois checkpoints específicos por tarefa. O FL2VA cobre texto para vídeo, vídeo a partir do primeiro quadro, vídeo a partir do último quadro e vídeo a partir do primeiro e do último quadro. Já o Ref2VA aceita imagem, vídeo e áudio como referência ao mesmo tempo, e dá conta de tarefas de geração e edição mais complexas, como manter a aparência dos personagens e o cenário do vídeo original e alterar só os movimentos, a articulação labial e os diálogos.
Os dois checkpoints incluem componentes como processor, tokenizer, text encoder, transformer, visual VAE e audio VAE. Em outras palavras, o que foi aberto é um repositório de modelo que realmente roda inferência, e não pesos “crus” que você precisa completar por conta própria com o restante da infraestrutura. Isso é bem mais completo do que muitos lançamentos que só liberam os pesos.
Diferença entre o 768p local e o fluxo completo em 2K
Pela especificação oficial, o H3 gera por padrão vídeos com lado menor de 768px, duração de 4 a 15 segundos, 24 FPS e áudio estéreo de 32kHz. Implantando apenas o H3-Base, que é open source, dá para gerar áudio e vídeo em 768p localmente. Para reproduzir a saída em 2K da versão oficial, ainda é preciso chamar as duas APIs: Context-IR e Regenerate-2K.
Portanto, o jeito mais correto de dizer é: o H3-Base roda de forma independente, mas o sistema H3 completo não consegue se desvincular totalmente dos serviços da MiniMax. Na solução local, a etapa de compreensão das entradas e organização das instruções precisa ser desenhada por você mesmo, e não dá para supor que exista uma versão local do Context-IR.
O Sparse Attention, fácil de passar batido
No primeiro lançamento open source, a equipe deixou claro que o próprio modelo H3 oferece suporte nativo a treinamento e inferência com atenção esparsa, o que reduz o custo computacional de sequências longas multimodais. Só que o código de inferência liberado inicialmente inclui apenas Full Attention. A implementação do Sparse Attention será publicada separadamente em atualizações futuras.
Isso significa que ter os pesos abertos não quer dizer que todas as otimizações internas de inferência também foram abertas. Se você rodar inferência de vídeos longos com o código público atual, o custo computacional pode ficar acima do desempenho real da versão oficial na nuvem, e essa é uma variável a considerar na hora de avaliar a performance.
Quais componentes o MiniMax H3-Image libera?
A forma de abertura do H3-Image é parecida com a do H3: o modelo principal pode ser baixado, mas o processamento de contexto ainda depende da nuvem. A tabela abaixo foi organizada a partir do repositório do modelo no Hugging Face.
| Componente | Aberto? | Descrição |
|---|---|---|
| Modelo de geração de imagens DiT de 33.1B | Sim | Diffusion Transformer de fluxo único, com cerca de 68,65 GB |
| Image VAE | Sim | Codificação e decodificação da representação latente da imagem |
| Tokenizer / Processor | Sim | Pré-processamento da entrada |
| Cabeça de saída PDD e configuração de amostragem | Sim | Dá suporte à amostragem em 6 passos, sem necessidade de CFG |
| Codificador de texto Qwen3-VL | Sim, reaproveita os pesos do repositório do H3 | Usa o estado oculto da camada 50, com cerca de 66,7 GB |
| Modelo de aprimoramento de comando H3-Image-PE | Sim, download separado | Cerca de 17,9 GB, pode rodar localmente |
| H3-Image-Context-IR | Não | Disponível apenas via API oficial |
Por que o codificador de texto precisa ser baixado do repositório do H3
O H3-Image reaproveita o codificador de texto Qwen3-VL do H3. Os pesos ficam no repositório do H3 e não são duplicados no repositório do H3-Image. Por isso, para implantar o H3-Image você precisa baixar o conteúdo dos dois repositórios: o modelo principal mais o codificador de texto somam cerca de 135,35 GB de armazenamento. E isso é só o tamanho dos arquivos, que não equivale ao requisito de memória de vídeo (VRAM).
Os frameworks de implantação recomendados oficialmente incluem SGLang, vLLM-Omni, Diffusers e ComfyUI. O hardware compatível listado inclui NVIDIA H200, RTX PRO 6000 Blackwell, AMD Instinct MI350X, entre outros, e também há soluções com paralelismo em várias GPUs. Para a maioria dos desenvolvedores individuais, essa barreira de hardware não é nada baixa.
Context-IR e PE não são a mesma coisa
O H3-Image-Context-IR é um serviço oficial na nuvem, capaz de expandir uma instrução curta em uma descrição completa para geração e de definir o tamanho de imagem adequado. Já o H3-Image-PE é um modelo de aprimoramento de comando que pode ser baixado separadamente e rodar localmente, e é a alternativa local oferecida oficialmente.
O fato de o PE ser aberto não significa que o fluxo de trabalho hospedado em múltiplas etapas do Context-IR também seja. Baixando apenas o modelo de imagem e o PE, você consegue montar um fluxo local funcional, mas isso não equivale a reproduzir por completo o resultado do serviço oficial na nuvem.
Declarações do fabricante e testes de framework devem ser analisados separadamente
“Gerar imagens 4K em até 10 segundos” e “até 16 imagens de referência” vêm do model card e dos comunicados oficiais, ou seja, são declarações do fabricante. Já na receita de implantação do vLLM, o limite de imagens de referência é de no máximo 9, então os critérios são diferentes. Quantas imagens de referência você consegue usar de fato depende do framework de inferência e da configuração adotados, e na hora de avaliar o melhor é se basear nos seus próprios testes.
O que as duas licenças do MiniMax H3 realmente restringem?
Essa é a parte mais fácil de interpretar errado nos dois lançamentos. O H3 e o H3-Image usam duas Community Licenses diferentes, com condições de licenciamento comercial bem distintas, então não dá para aplicar a mesma conclusão aos dois.
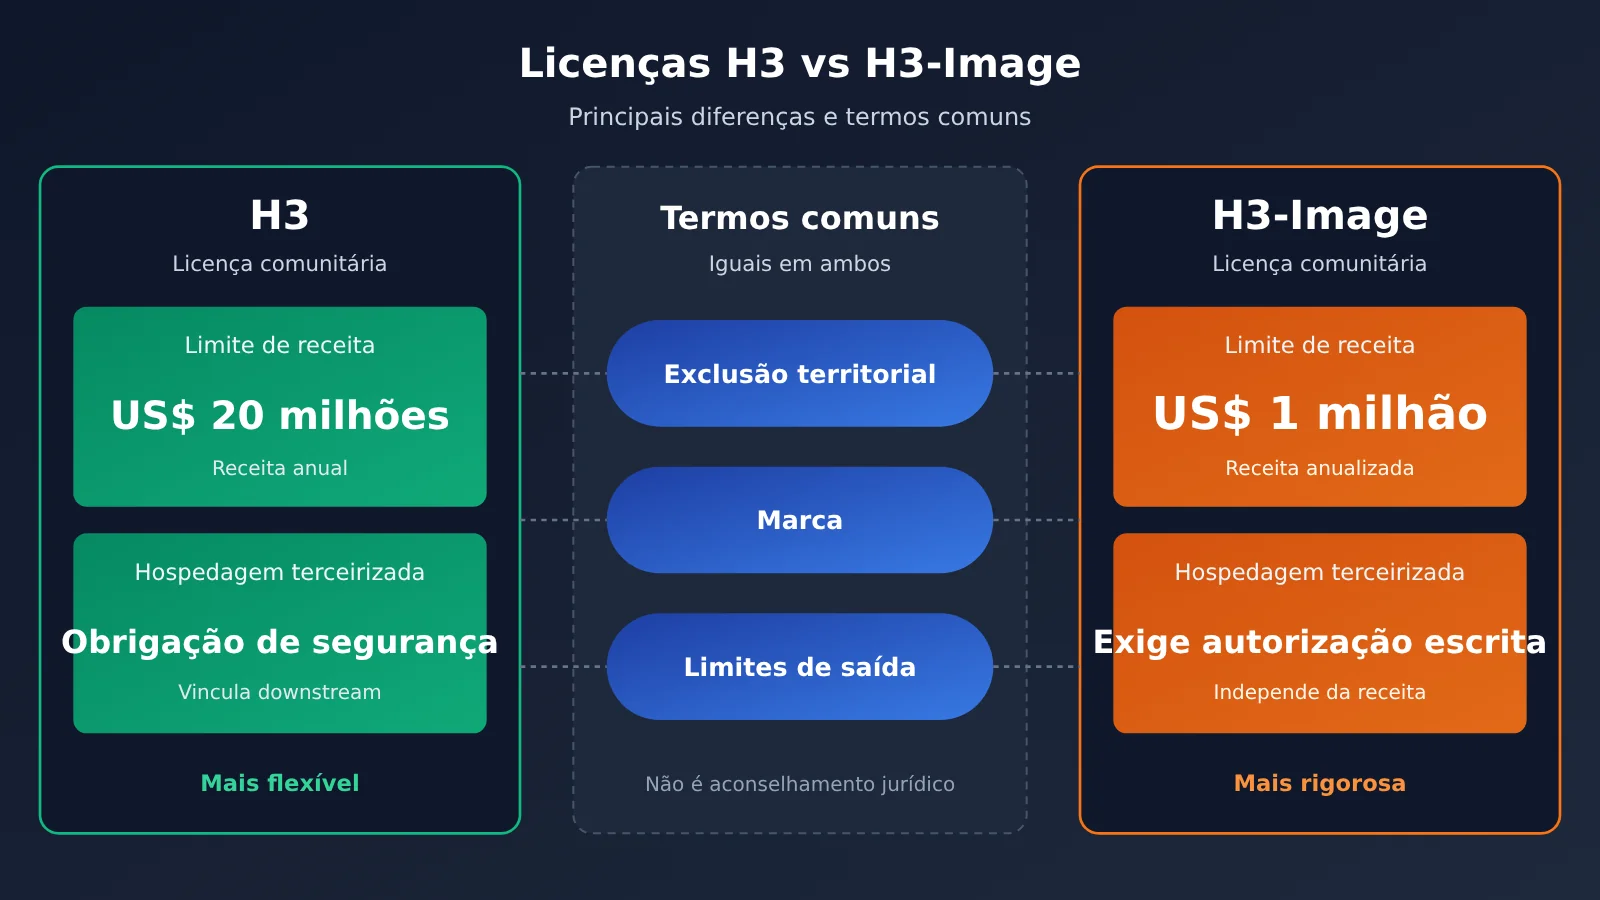
| Condição | H3 Community License | H3-Image Community License |
|---|---|---|
| Abrangência geográfica | Exclui Estados Unidos, União Europeia, Reino Unido e Coreia do Sul | Igual |
| Limite de receita para licenciamento | Produtos e serviços comerciais com receita anual acima de US$ 20 milhões exigem autorização prévia por escrito | Receita anualizada sua e/ou de afiliadas acima de US$ 1 milhão exige autorização prévia por escrito |
| Serviços hospedados por terceiros | Exige medidas de segurança razoáveis e que os usuários finais cumpram as restrições de uso | Oferecer serviço hospedado a qualquer terceiro exige autorização prévia por escrito |
| Identificação em produtos comerciais | Exibir MiniMax H3 de forma destacada na interface | Exibir MiniMax-H3-Image de forma destacada na interface |
| Uso das saídas para melhorar outros modelos de IA | Não permitido | Não permitido |
📌 Observação: o conteúdo acima é um resumo das cláusulas do texto original das licenças e não constitui aconselhamento jurídico. Para os detalhes sobre restrições geográficas e outras obrigações, consulte o texto original dos dois arquivos LICENSE. Se você só quer avaliar primeiro o desempenho de modelos generativos e de conversação, pode usar a interface unificada do APIYI (apiyi.com) para invocar os principais modelos e comparar as opções, antes de decidir se vale investir em implantação local e em pedidos de autorização.
Os limites do H3: uso comercial permitido, mas com obrigações
Dentro das regiões cobertas, o H3 vem com uma licença limitada e isenta de royalties, que permite uso comercial. Na prática, existem duas condições importantes: se a receita anual passar de US$ 20 milhões, é preciso ter autorização por escrito; e, ao oferecer o modelo como serviço a terceiros, é preciso implementar medidas de proteção de segurança e repassar as restrições de uso aos usuários finais.
Os limites do H3-Image: serviço hospedado é uma barreira rígida
As condições do H3-Image são bem mais rigorosas. O limite de receita anualizada cai para US$ 1 milhão e, sempre que você oferecer serviço hospedado a qualquer terceiro, independentemente da receita, é obrigatório ter autorização prévia por escrito. A licença também indica um canal para contatar a MiniMax e pedir uma licença específica.
Para plataformas de API, plataformas de hospedagem de modelos e desenvolvedores de SaaS, isso quer dizer que “dá para baixar os pesos” não significa “posso implantar e abrir uma API ao público”. E o quanto essa fronteira é flexível ou rígida varia bastante entre o H3 e o H3-Image.
Impacto da abertura do MiniMax H3 para os desenvolvedores
Quando você junta o nível de abertura dos módulos com os termos da licença, a liberdade que o desenvolvedor realmente tem muda bastante de um cenário para outro.
| Cenário de uso | O que dá para fazer | Principais limites |
|---|---|---|
| Pesquisa pessoal e experimentos locais | Baixar os pesos, rodar inferência local, estudar a arquitetura, fazer desenvolvimento derivado | Cláusula de exclusão geográfica; as saídas não podem ser usadas para melhorar outros modelos; exigência alta de hardware |
| Uso comercial interno em empresas | Implantar localmente e usar o conteúdo gerado nos próprios negócios | H3: limite de US$ 20 milhões; H3-Image: limite de US$ 1 milhão |
| Produtos comerciais voltados ao usuário | Integrar o modelo em aplicativos próprios | É preciso exibir o nome do modelo correspondente de forma destacada na interface |
| Hospedagem de API para terceiros | H3 pode ser oferecido depois de cumprir as obrigações de segurança | H3-Image exige autorização prévia por escrito |
| Reproduzir o resultado oficial completo | Vídeo em 768p local, geração de imagens local com PE | Vídeo em 2K e Context-IR ainda dependem da API oficial |
A liberdade real que a abertura traz
A liberdade que os pesos abertos oferecem é concreta. Dá para implantar offline, manter os dados dentro da rede interna, estudar a estrutura de um modelo omnimodal de 33B e até substituir ou adaptar as etapas de pré e pós-processamento no seu fluxo local. Os dois modelos vêm com os componentes de inferência completos, o que reduz bastante a barreira para a comunidade reproduzir os resultados.
As três camadas de limites que continuam existindo
A primeira camada é a do sistema: Context-IR e Regenerate-2K ficam fora do que foi aberto. A segunda é a da implementação: o código de Sparse Attention do H3 não estava incluído no lançamento inicial. A terceira é a da licença: as cláusulas de região, faturamento, serviços de hospedagem e identificação de marca é que, juntas, definem se você pode usar o modelo comercialmente.
Ou seja, pesos abertos e API na nuvem convivem, e um não substitui o outro. Compra de GPU, otimização de inferência, escalonamento para alta concorrência, aprimoramento de comandos e revisão de conformidade são custos que não desaparecem só porque os pesos foram liberados. Para muitas equipes, o ritmo mais seguro é validar primeiro a necessidade do negócio por uma plataforma agregadora como a APIYI (apiyi.com) e só depois avaliar se vale a pena montar a própria infraestrutura.
Exemplo da etapa prévia do fluxo local do MiniMax H3
Como o Context-IR não foi aberto ao público, quem roda o H3-Base localmente precisa resolver por conta própria a etapa de organização da entrada. Um jeito comum é usar um Modelo de Linguagem Grande de uso geral para expandir uma ideia curta em uma descrição estruturada e só depois entregá-la ao modelo local. Vale lembrar que isso é só uma alternativa de engenharia: o resultado não equivale ao Context-IR oficial.
Exemplo mínimo
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[
        {"role": "system", "content": "把简短视频创意扩写为详细镜头描述,包含主体、动作、镜头、光线和声音。"},
        {"role": "user", "content": "雨夜街头,一只猫跳上霓虹灯招牌"}
    ]
)
print(resp.choices[0].message.content)
Ver o código completo da implementação
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM_PROMPT = """你是视频生成提示词工程师。
请把用户的简短创意扩写为 JSON,字段包括:
- prompt: 详细的画面与动作描述
- camera: 镜头运动
- audio: 环境声与音乐描述
- duration: 视频时长(秒,取值 4 到 15)
只输出 JSON。"""

def build_context(idea: str, model: str = "gpt-4o-mini") -> dict:
    """Usa um Modelo de Linguagem Grande de uso geral para organizar a entrada, como etapa prévia do H3-Base local"""
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": idea},
        ],
        response_format={"type": "json_object"},
    )
    ctx = json.loads(resp.choices[0].message.content)
    # Limita a duração a 4-15 segundos, conforme a especificação oficial do H3
    ctx["duration"] = max(4, min(15, int(ctx.get("duration", 5))))
    return ctx

if __name__ == "__main__":
    ctx = build_context("雨夜街头,一只猫跳上霓虹灯招牌")
    print(json.dumps(ctx, ensure_ascii=False, indent=2))
    # Próximo passo: entregar o ctx ao seu fluxo de inferência local do H3-Base
    # (veja o exemplo de inferência FL2VA no repositório oficial do GitHub)
🚀 Início rápido: se a memória de vídeo (VRAM) local for insuficiente, você pode pegar uma cota gratuita de testes no APIYI (apiyi.com) e validar a etapa de organização dos comandos. A plataforma oferece uma interface compatível com a OpenAI, e uma única chave API permite alternar entre vários modelos, o que facilita comparar qual deles se sai melhor na expansão prévia.
MiniMax H3 open source: perguntas frequentes (FAQ)
Q1: O MiniMax H3 é realmente open source?
O mais correto é dizer que ele é um modelo de pesos abertos. Os pesos e os materiais de inferência do H3-Base estão disponíveis, mas o Context-IR e o Regenerate-2K não foram liberados, e a licença usada é a Community License, que tem restrições, e não MIT ou Apache 2.0.
Q2: O H3 e o H3-Image usam a mesma licença?
Não. As duas têm a mesma lista de exclusões geográficas, mas o limite de receita é diferente: no H3, é uma receita anual acima de US$ 20 milhões; no H3-Image, uma receita anualizada acima de US$ 1 milhão. Além disso, oferecer o H3-Image como serviço hospedado a qualquer terceiro exige autorização prévia por escrito, enquanto o H3 exige o cumprimento de obrigações de proteção de segurança e de restrições para os usuários finais.
Q3: Se eu implantar só o H3-Base, consigo gerar vídeo em 2K?
Não. O H3-Base local gera, por padrão, vídeos com o lado menor em 768px. A saída em 2K depende das APIs oficiais Context-IR e Regenerate-2K.
Q4: O H3-Image-PE substitui o Context-IR?
O PE é a solução oficial local para aprimorar comandos. Dá para baixar e rodar de forma independente, mas ele não equivale ao fluxo de trabalho hospedado em várias etapas do Context-IR. Se você quer chegar perto do resultado oficial, ainda vai precisar testar e ajustar por conta própria.
Q5: A barreira para rodar localmente é alta demais. Existe alguma alternativa?
Só o modelo principal do H3-Image mais o codificador de texto ocupam cerca de 135,35 GB de armazenamento, e o hardware oficialmente suportado é basicamente GPU de classe data center, como H200 e MI350X. Se por enquanto você só quer validar a ideia, dá para usar o APIYI (apiyi.com) para invocar os principais modelos já disponíveis, comparar os resultados por uma interface unificada e só depois decidir se compensa montar a infraestrutura própria.
Q6: Posso usar as saídas do H3 para treinar meu próprio modelo?
Não. As duas licenças proíbem usar o modelo ou suas saídas para melhorar outros modelos de IA. Antes de fazer síntese de dados ou destilação, confira o texto original da licença.
Pontos-chave da abertura do MiniMax H3 (Key Takeaways)
- Três módulos, só um aberto: o H3-Base foi liberado, enquanto o Context-IR e o Regenerate-2K continuam disponíveis apenas pela API oficial.
- Checkpoint completo: tanto o FL2VA quanto o Ref2VA vêm com tokenizer, VAE e os demais componentes de inferência.
- Local só até 768p: o fluxo completo de vídeo em 2K depende do serviço oficial na nuvem.
- Atenção esparsa ainda vai chegar: o código de inferência publicado agora inclui apenas Full Attention.
- As duas licenças são diferentes: o limite do H3 é de US$ 20 milhões, e o do H3-Image é de US$ 1 milhão.
- Serviço hospedado é linha vermelha: quem quiser oferecer o H3-Image como serviço hospedado para terceiros precisa de autorização prévia por escrito.
- Valide antes de montar a infraestrutura: dá para testar a necessidade do seu negócio a baixo custo usando a interface unificada do APIYI (apiyi.com).
Resumo
Os pontos centrais da abertura do MiniMax H3:
- O que foi aberto é o modelo central de geração: o H3-Base e o modelo principal do H3-Image podem ser baixados e implantados, e os componentes de inferência vêm completos.
- O serviço na nuvem continua fazendo parte do sistema: o Context-IR e o Regenerate-2K definem o teto de qualidade do resultado final.
- A licença define os limites do uso comercial: as duas Community Licenses têm condições diferentes, e a do H3-Image é bem mais rígida quanto a serviços hospedados.
Para saber o quanto um modelo é realmente aberto, não basta olhar se dá para baixar os pesos. É preciso considerar quatro dimensões: componentes, código de inferência, serviços complementares e licença. A abertura do MiniMax foi bem generosa, mas antes de implantar e comercializar, vale conferir uma a uma essas quatro camadas.
Se você está avaliando soluções de geração, o ideal é começar validando o fluxo do seu negócio com o crédito gratuito do APIYI (apiyi.com) e só depois decidir se vale investir em implantação local e em pedidos de autorização.
📚 Referências
- Anúncio oficial de código aberto do MiniMax H3: divisão em três módulos e explicação do Sparse Attention
- Link:
minimax.io/news/minimax-h3-open-source -
Descrição: fonte primária para entender a estrutura do sistema H3 e o que foi aberto
-
Hugging Face – repositório do modelo MiniMax-H3: checkpoints FL2VA e Ref2VA e componentes
- Link:
huggingface.co/MiniMaxAI/MiniMax-H3 -
Descrição: inclui os pesos compartilhados do codificador de texto Qwen3-VL
-
Texto original da MiniMax H3 Community License
- Link:
huggingface.co/MiniMaxAI/MiniMax-H3/blob/main/LICENSE -
Descrição: o texto da licença é a referência final para o limite de receita, o alcance geográfico e as obrigações downstream
-
Hugging Face – repositório do modelo MiniMax-H3-Image: lista de componentes e instruções de implantação
- Link:
huggingface.co/MiniMaxAI/MiniMax-H3-Image -
Descrição: model card oficial, com declarações do fabricante, como o limite de imagens de referência
-
Texto original da MiniMax H3-Image Community License
- Link:
huggingface.co/MiniMaxAI/MiniMax-H3-Image/blob/main/LICENSE -
Descrição: autorização para serviços hospedados e cláusula do limite de 1 milhão de dólares
-
Receita de implantação no vLLM – MiniMax-H3-Image
- Link:
recipes.vllm.ai/MiniMaxAI/MiniMax-H3-Image -
Descrição: configuração de testes do lado do framework; o critério do limite de imagens de referência é diferente do model card
-
GitHub – código-fonte e materiais de implantação do MiniMax-H3
- Link:
github.com/MiniMax-AI/MiniMax-H3 - Descrição: exemplos de inferência local e scripts de implantação
Autor: Equipe técnica da APIYI
Troca de experiências técnicas: fale com a gente na página inicial do site da APIYI; mais materiais de integração estão disponíveis na central de documentação em docs.apiyi.com