
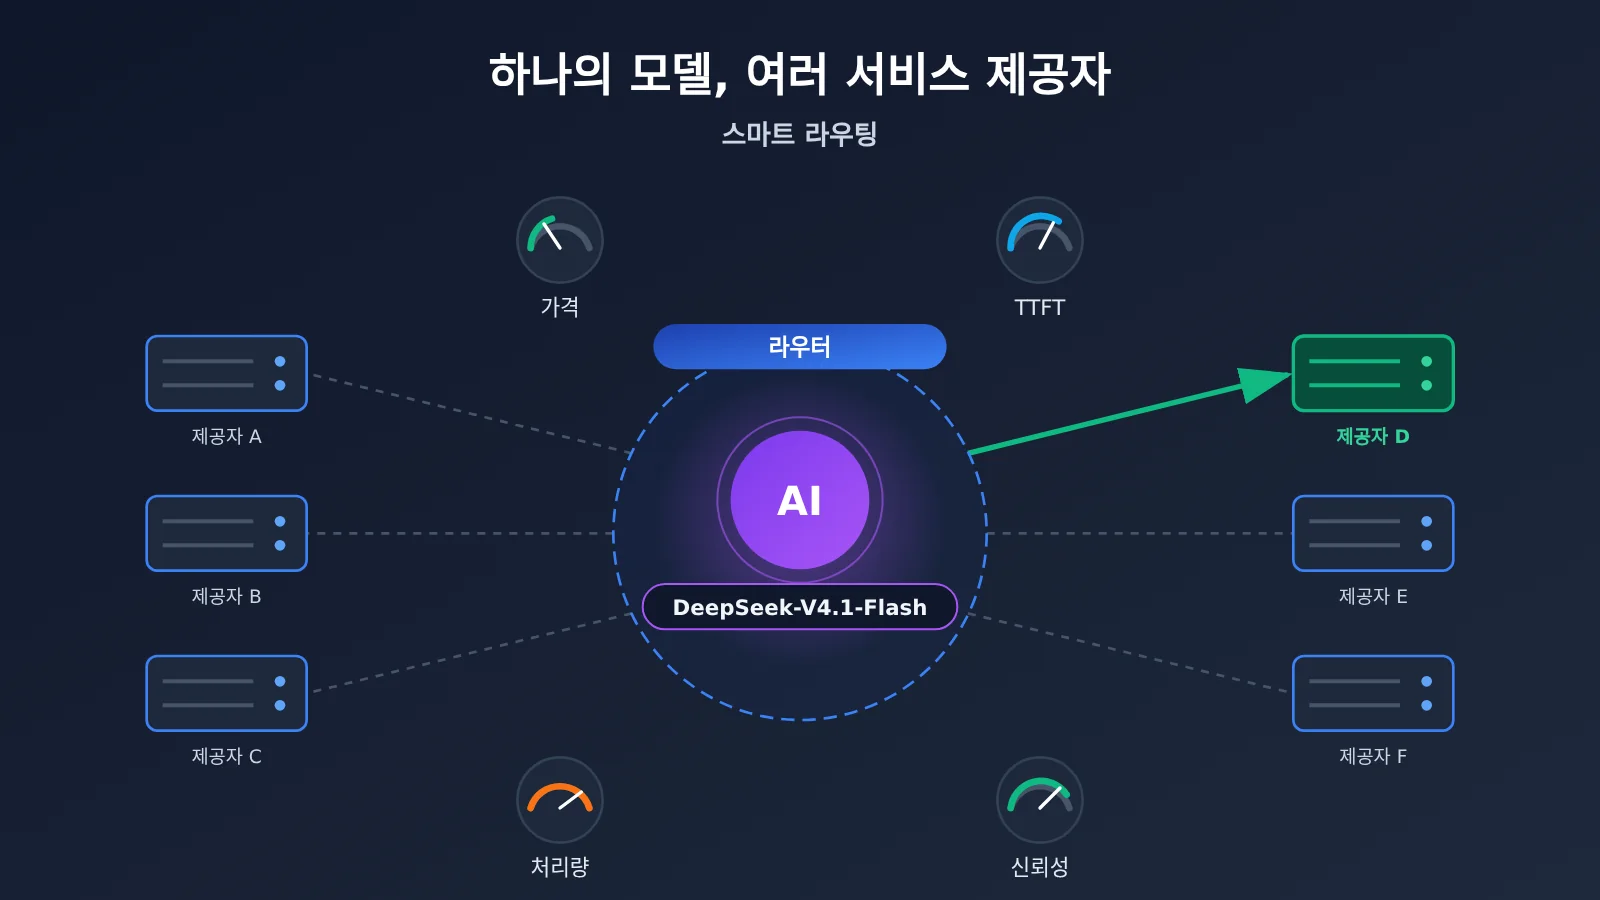
핵심 답변: 같은 오픈 가중치 모델을 여러 추론 서비스 제공업체가 각각 배포할 수 있기 때문에 API 서비스 제공업체가 수십 곳이나 생겨요. OpenRouter는 누가 표시 가격을 가장 낮게 부르는지만 보는 게 아니라, 사용 가능한 응답 한 번을 기준으로 한 종합 비용을 따져 제공업체를 골라요. 실제 유효 가격, 첫 토큰 지연 시간(TTFT), 처리량, 속도 제한, 안정성, 응답 품질 등 6가지 지표를 동시에 평가한 뒤, 현재 가장 적합한 프로바이더에 요청을 넘기고 실패하면 다른 프로바이더로 바꿔 재시도해요.
이는 AI API 집계 경쟁이 “통합 인터페이스 제공”에서 “서비스 제공업체 동적 스케줄링”으로 확장됐다는 뜻이에요. 2026년 11월 16일, Hugging Face는 Inference Providers의 언어 모델 라우팅을 OpenRouter에 넘기겠다고 발표했어요. 이번 협업은 이런 지표가 어떻게 자동으로 서비스 제공업체를 고르는 메커니즘으로 구현되는지 보여주는 구체적인 사례예요.
이 글을 읽고 나면 무엇을 알 수 있나요?
- 같은 AI 모델에 왜 여러 API 서비스 제공업체가 있는지, 모델 개발사와 추론 서비스 제공업체는 무엇이 다른지
- 프로바이더 라우팅은 어떤 의사결정 지표를 사용하며, 각 지표가 각각 어떤 문제를 해결하는지
- 장애 폴백(fallback)이 무엇까지 할 수 있고, 어떤 경계가 있는지
- Hugging Face 모델 카탈로그 API의 메타데이터로 여러 제공업체를 직접 비교하는 방법
목차: 객관적 사실 부분은 다음 순서로 전개해요. 먼저 여러 API 서비스 제공업체가 생겨난 배경을 설명하고, 이어서 지능형 라우팅의 의사결정 대상과 6가지 지표를 분석한 다음, 장애 전환의 흐름과 제한을 이야기하고, 마지막으로 개발자가 카탈로그 인터페이스로 프로바이더를 직접 비교하는 방법을 시연해요. 중간중간 OpenRouter가 공개한 라우팅 실험 데이터와 과금 변화도 곁들여요. 분석과 판단 부분에서는 API 집계 플랫폼의 다음 경쟁 방향과 개발자가 애플리케이션에서 어떻게 선택하고 검증해야 하는지를 다뤄요.
여러 API 서비스 제공자와 Provider 라우팅에서 알아둘 개념
| 개념 | 간단한 설명 |
|---|---|
| Provider | 모델을 배포하고 실제 추론 서비스를 제공하는 공급자예요. 예: Together AI, Novita |
| Router | 요청 조건과 사용 가능한 서비스 제공자 상태에 따라 요청을 어디로 보낼지 결정하는 라우팅 계층이에요 |
| 오픈 웨이트 모델 | 학습 후 가중치를 공개하고, 해당 라이선스에 따라 직접 배포할 수 있는 모델이에요 |
| TTFT | Time to First Token. 요청이 나간 뒤 첫 번째 토큰이 반환될 때까지의 대기 시간이에요 |
| 처리량 | 단위 시간당 생성되는 토큰 수이며, 보통 tok/s로 표시해요 |
| Failover | 현재 서비스 제공자가 실패하면 자동으로 다른 서비스 제공자로 전환해 재시도하는 기능이에요 |
| Prompt Caching | 서비스 제공자가 반복되는 입력을 캐시해 계산 비용과 응답 시간을 줄이는 방식이에요 |
| BYOK | Bring Your Own Key. 서비스 제공자의 키를 직접 가져와 해당 계정의 크레딧을 사용하는 방식이에요 |
| P50 / P95 | 통계 분위수예요. P50은 중앙값이고, P95는 더 느린 5%의 요청을 반영해요 |
여러 API 서비스 제공자 라우팅 변화의 영향 한눈에 보기
- 개발자: Hugging Face 쪽 코드와 토큰은 원칙적으로 바꿀 필요가 없어요. 하지만 실제 서비스 제공자는 라우팅에 따라 결정되므로, 같은 모델 ID라도 요청에 따라 다른 Provider로 갈 수 있어요. 도구 호출이나 구조화된 출력에 의존하는 앱은 회귀 테스트를 다시 해야 해요. 원래 Hugging Face에서 자체 언어 모델 Provider 키를 설정하던 개발자는 이 경로가 더 이상 지원되지 않으므로, 키와 과금 귀속을 다시 확인해야 해요.
- 기업 구매 및 플랫폼 팀: 공급업체 승인, 재해 복구 전략, 데이터 처리 조건을 다시 평가해야 해요. 조직에서 특정 Provider를 비활성화할 수는 있지만, 이것이 완전한 데이터 상주나 규정 준수 보장을 뜻하지는 않아요. 각 서비스 제공자의 데이터 정책을 하나씩 확인해야 해요.
동일한 AI 모델, 여러 API 제공업체: 객관적 사실
하나의 모델에 여러 API 제공업체가 존재하는 이유
모델을 개발하는 쪽과 추론 서비스를 제공하는 쪽은 서로 다른 역할이에요. 개발사는 모델을 학습시켜 가중치를 공개하죠. 공개 가중치 모델이라면, 충분한 컴퓨팅 자원을 갖추고 라이선스 조건을 충족하는 어떤 기관이든 가중치를 자체 GPU 클러스터에 배포해 API로 제공할 수 있어요. 그래서 DeepSeek, Qwen, GLM 같은 모델은 여러 추론 인프라에서 동시에 서비스되는 경우가 많아요.
deepseek-ai/DeepSeek-V4.1-Flash를 예로 들어볼게요. 개발자가 요청하는 모델 이름은 하나지만, 실제로 추론을 수행하는 곳은 Together AI나 Novita, 또는 이 모델을 지원하는 다른 Provider일 수 있어요. 각 업체는 하드웨어와 클러스터 규모, 스케줄링 방식, 가격 정책이 모두 달라서 같은 모델이라도 가격, 속도, 수용 가능한 처리량에 차이가 생겨요. 어떤 곳은 가격이 저렴하지만 피크 시간대에 속도 제한이 걸리기 쉽고, 어떤 곳은 첫 토큰 반환 속도가 빠르고, 어떤 곳은 더 긴 컨텍스트를 지원하고, 어떤 곳은 도구 호출 형식을 더 완벽하게 지원해요.
규모 데이터를 보면 이 시장이 얼마나 분산되어 있는지 알 수 있어요. OpenRouter는 협력 발표에서 자사 플랫폼이 600개 이상의 모델과 80개 이상의 Provider를 지원하고, 매월 800조 토큰 이상을 처리하며, 1,000만 명이 넘는 사용자에게 서비스를 제공한다고 밝혔어요. 이 수치는 OpenRouter 전체 플랫폼 기준 데이터이지, 이번 협력으로 새로 생긴 규모가 아니에요. Hugging Face의 Provider 페이지에도 Baseten, Cerebras, DeepInfra, Fireworks, Nebius, Novita, Together AI 등 십여 곳이 넘는 서비스 업체가 소개되어 있지만, 모델마다 사용 가능한 Provider는 달라요.
하나의 모델에 여러 업체가 연결되어 있고 각 업체의 조건이 실시간으로 변하기 때문에, “이번 요청은 누구에게 보낼 것인가”가 지속적인 의사결정 문제로 떠오르고, 여기서 멀티 Provider 라우팅이 등장하게 된 거예요.
스마트 라우팅은 대체 무엇을 결정할까
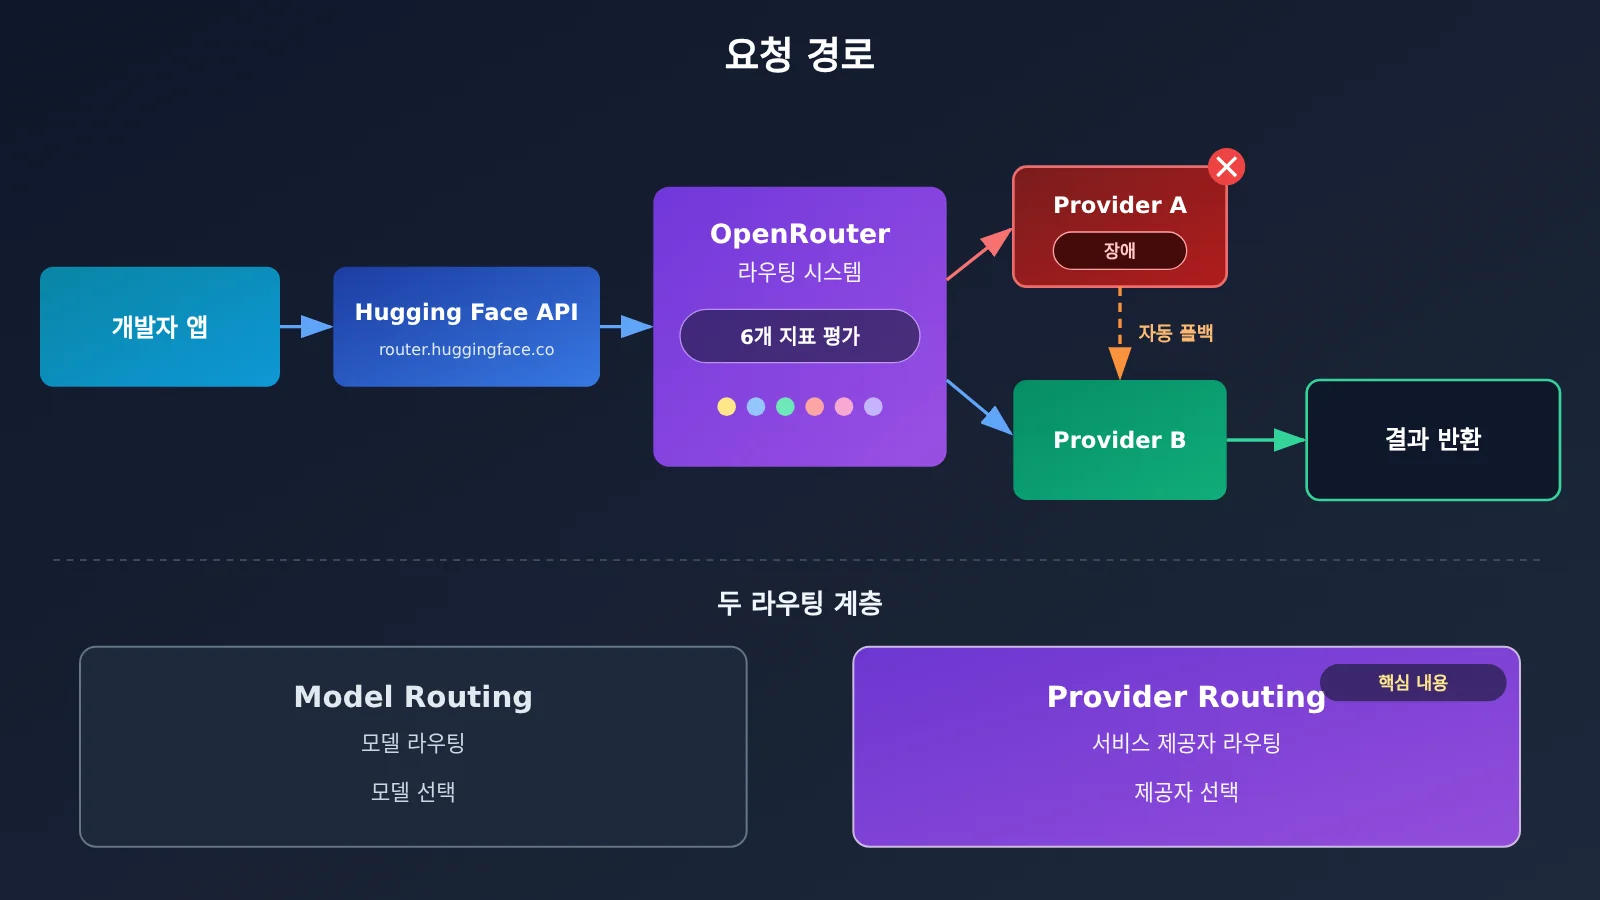
먼저 헷갈리기 쉬운 두 개념을 구분해야 해요. Model Routing(모델 라우팅) 은 어떤 모델이 답하게 할지를 결정해요. 예를 들어 간단한 질문은 작은 모델에, 복잡한 질문은 큰 모델에 맡기는 식이죠. Provider Routing(프로바이더 라우팅) 은 모델이 이미 정해진 상태에서 어느 프로바이더가 추론을 실행할지를 결정해요. 이 글에서 다루는 OpenRouter와 Hugging Face의 협업은 후자에 해당해요. 모델은 개발자가 지정하고, 라우팅 계층은 프로바이더만 고를 뿐 모델을 대신 바꿔 주지는 않아요.
협업 이후 언어 모델 요청 한 번의 흐름은 이렇게 됩니다: 개발자 앱 또는 코딩 에이전트 → Hugging Face API(router.huggingface.co) → OpenRouter 라우팅 시스템 → 특정 프로바이더가 추론 → 결과 반환. OpenRouter는 여기서 요청 라우팅과 프로바이더 선택을 맡고, 모든 모델의 추론을 직접 실행하지는 않아요. 사용자는 계속 Hugging Face Token을 사용하고, Hugging Face 계정 또는 조직 계정으로 정산해요. Hugging Face는 프로바이더 추론 가격에 추가 마진을 붙이지 않는다고 밝혔어요.
제어 방식에는 Hugging Face가 세 가지 계층을 제공해요:
- 기본 자동 라우팅: 공식 클라이언트에서
provider="auto"를 사용하면 시스템이 가격, 속도, 안정성을 종합해 프로바이더를 선택해요. - 프로바이더 지정: 예를 들어
provider="together"를 쓰거나 모델 ID 뒤에:novita접미사를 붙이면 요청이 해당 프로바이더에게 고정돼요. - 정책 라우팅: OpenAI 호환 인터페이스는
:cheapest(가격 우선)와:fastest(처리량 우선) 접미사를 지원해요.
주의할 점은 :fastest가 최적화하는 대상이 처리량일 뿐, 모든 의미에서의 “빠름”은 아니라는 거예요. TTFT, 생성 속도, 전체 요청 시간은 서로 다른 세 가지 지표예요. 한두 문장만 출력하는 짧은 응답에서는 첫 토큰 지연이 처리량보다 체감 속도에 더 크게 영향을 주는 경우가 많아요.
| 비교 항목 | 기존 Hugging Face 라우팅 | 새로운 OpenRouter 라우팅 |
|---|---|---|
| 라우팅 시스템 | Hugging Face 자체 라우터 | OpenRouter |
| 프로바이더 선택 | 기존 선택 메커니즘 | 실시간 종합 평가 |
| 가격 기준 | 기존 가격 정책 | 실제 유효 가격 |
| 속도 요소 | 기존 성능 메커니즘 | TTFT와 처리량 반영 |
| 단일 실패 | 오류를 바로 반환할 수 있음 | 같은 요청에서 다른 프로바이더로 재시도 가능 |
| 세션 캐시 | 기존 정책 | 세션별 프로바이더 유지 지원 |
| 사용자 자격 증명 | Hugging Face Token | 계속 Hugging Face Token 사용 |
좋은 멀티 프로바이더 라우팅 시스템은 어떤 지표를 봐야 할까요
OpenRouter는 2026년 10월 28일 차세대 Provider Routing 알고리즘을 공개했어요. 기존 기본 라우팅은 입력 토큰의 표시 가격에 크게 의존해서, 저렴한 프로바이더가 더 많은 트래픽을 받기 쉬웠어요. 새 알고리즘은 다음 6가지 신호를 하나의 실시간 라우팅 비용(Routing Cost)으로 합산해, 단순히 최저 단가를 쫓는 대신 “한 번에 성공하는, 사용 가능한 응답”의 종합 비용을 최적화하는 것을 목표로 해요.
① Effective Price(실제 유효 가격) 은 “표시 가격이 싸다고 해서 청구서도 싸지는 않다”는 문제를 다뤄요. 캐시되지 않은 입력, 캐시된 입력, 출력 세 가지 단가를 합산한 뒤, 실제 요청의 입력·출력 비율과 해당 프로바이더의 캐시 적중률을 반영해 계산해요. OpenRouter가 든 예시는 이래요: 캐시되지 않은 입력 토큰 40,000개($2/M)는 $0.080, 캐시된 입력 토큰 60,000개($0.50/M)는 $0.030, 출력 토큰 4,000개($8/M)는 $0.032로 합계 $0.142예요. Agent 시나리오에서는 캐시된 입력 비중이 높은 경우가 많아서, 입력 표시 가격만 비교하면 프로바이더를 잘못 선택할 수 있어요.
② TTFT(첫 토큰 지연) 은 “사용자가 응답을 보기까지 얼마나 기다려야 하는가”라는 문제를 다뤄요. 채팅 인터페이스와 Agent의 여러 턴에 걸친 도구 호출이 이에 가장 민감한데, 매 턴 첫 토큰을 기다려야 하기 때문이에요.
③ Throughput(처리량) 은 생성이 시작된 이후의 속도를 측정해요. 새 알고리즘은 순간 최고치만이 아니라 전체 응답 과정에서의 생성 처리량을 봐요. 긴 텍스트 생성, 코드 완성처럼 출력량이 많은 작업은 주로 이 지표의 영향을 받아요.
④ Rate Limits(속도 제한) 은 주로 HTTP 429 오류를 보며, “프로바이더 용량 부족” 문제를 다뤄요. 특정 Provider가 429를 자주 반환하면 컴퓨트 자원이 빠듯하다는 뜻이라, 라우팅은 그 프로바이더에 할당하는 트래픽을 줄여요.
⑤ Reliability(신뢰성) 은 요청 실패 빈도를 측정해요. 어떤 프로바이더의 오류율이 같은 모델을 쓰는 다른 프로바이더보다 확실히 높으면, 시스템은 트래픽 분산을 줄이고 필요하면 회복될 때까지 트래픽을 일시 중단해요.
⑥ Quality(응답 품질) 은 “같은 모델이라도 배포에 따라 성능이 일관되지 않다”는 문제를 다뤄요. 현재 공개된 설명에 따르면, 품질 신호는 주로 도구 호출이 올바르게 반환되는지, 구조가 요구사항을 충족하는지를 다뤄요. 도구 호출 형식이 비정상이거나 벤치마크 정확도가 눈에 띄게 뒤처지는 프로바이더는 경쟁력이 낮아져요.
이 6가지 지표 외에도, OpenRouter 자체 라우팅 문서는 데이터 정책을 제약 조건으로 포함해요. 예를 들어 data_collection: "deny"는 데이터 수집 요구사항을 충족하지 않는 Provider를 제외할 수 있고, zdr: true는 제로 데이터 보존 엔드포인트를 사용하도록 요구해요. Hugging Face 보안 문서에 따르면, Hugging Face는 사용자 요청 데이터를 모델 학습에 사용하지 않고, 라우팅할 때 요청 본문과 응답을 저장하지 않으며, 디버그 로그는 최대 30일까지만 보관하고 사용자 데이터나 토큰은 포함하지 않아요. 다만 개발자에게 실제 Provider의 데이터 보안 정책도 여전히 확인해야 한다고 알려요. 플랫폼의 약속이 각 프로바이더의 데이터 처리 계약을 대신할 수는 없어요.
OpenRouter 라우팅 실험 데이터와 트레이드오프
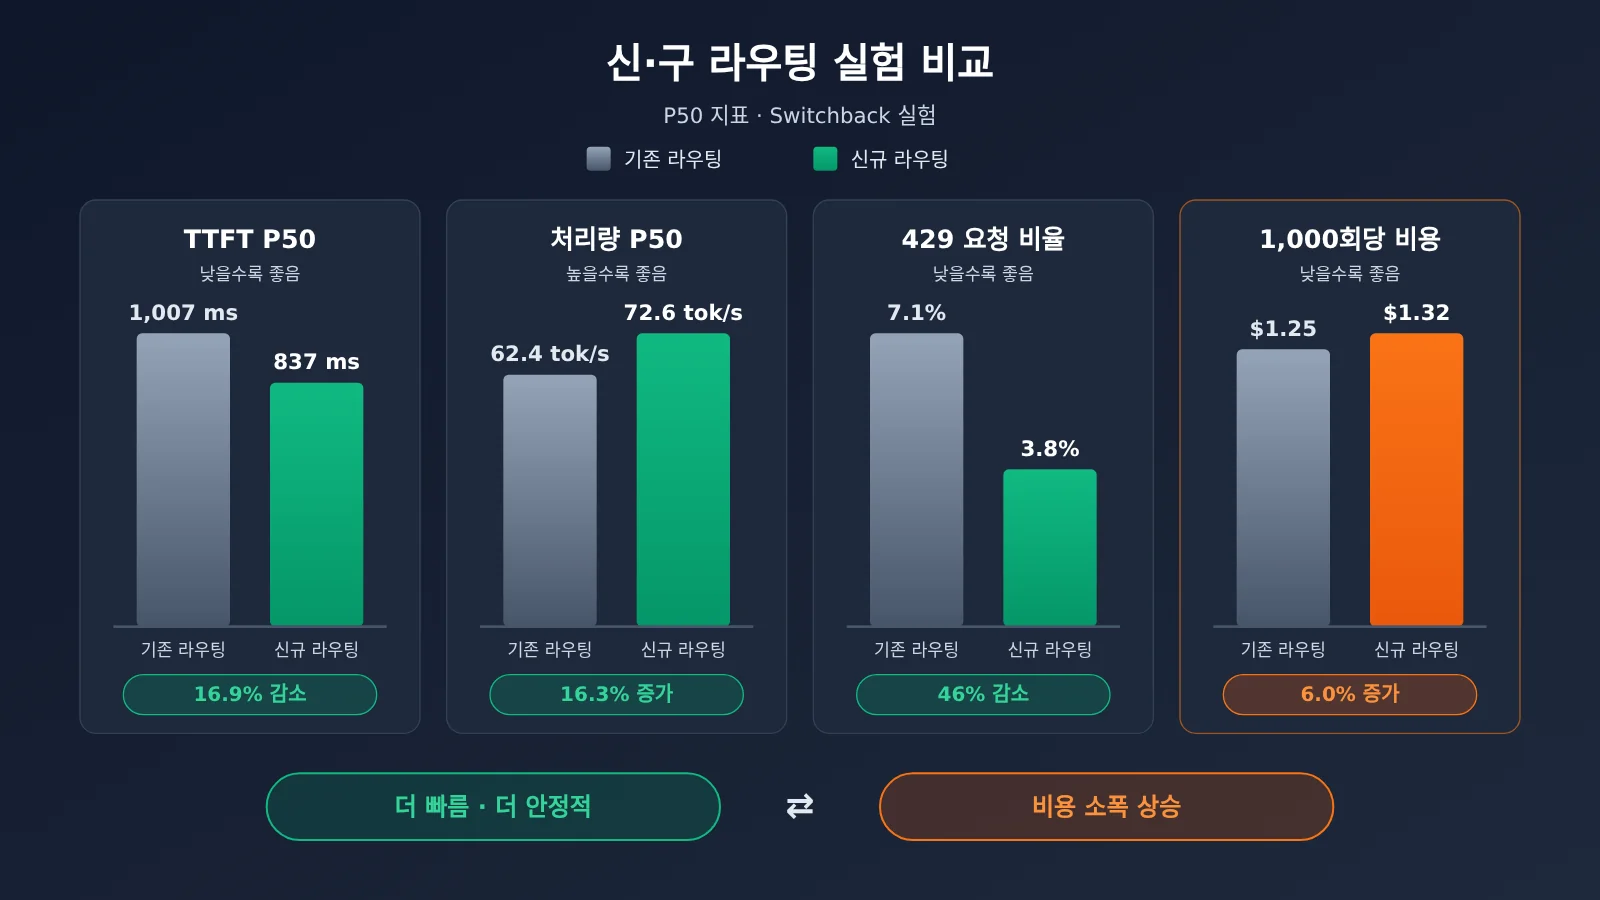
새 알고리즘을 출시하기 전, OpenRouter는 2026년 10월에 일주일 동안 Switchback 교대 실험을 진행했어요. 매일을 3시간 블록으로 나누고, 매칭된 블록은 각각 신·구 알고리즘을 사용했으며, 전환할 때마다 1시간의 워밍업 기간을 두어 측정에서 제외했어요. 총 2,400만 건이 넘는 요청과 1,030억 개의 입력 토큰을 처리했죠. 사용자 무작위 그룹 분할 대신 교대 실험을 사용한 이유는, 새 알고리즘이 과부하된 프로바이더에서 트래픽을 옮기면 기존 알고리즘 그룹도 덕을 보게 되어 비교가 교란되기 때문이에요.
| 지표 | 기존 라우팅 | 신규 라우팅 | 변화 |
|---|---|---|---|
| TTFT P50 | 1,007 ms | 837 ms | 16.9% 감소 |
| TTFT P95 | 4,601 ms | 3,733 ms | 18.9% 감소 |
| 처리량 P50 | 62.4 tok/s | 72.6 tok/s | 16.3% 증가 |
| 전체 요청 소요 시간 P50 | 4.00 s | 3.24 s | 19.0% 감소 |
| 429 응답이 1회 이상 발생한 요청 | 7.1% | 3.8% | 46% 감소 |
| 재시도가 필요한 요청 | 10.4% | 6.9% | 34% 감소 |
| 1,000회 요청당 비용 | $1.25 | $1.32 | 6.0% 증가 |
| 100만 토큰당 비용 | $0.301 | $0.324 | 7.3% 증가 |
이 데이터는 새 라우팅의 핵심 트레이드오프를 보여줘요. 1,000회 요청당 비용을 약 6% 늘리는 대신 더 낮은 지연 시간과 더 적은 용량 오류를 얻는 것이죠. 몇 가지 한계도 짚어야 해요. 이 실험은 OpenRouter가 직접 설계하고 발표한 것으로 제3자 감사를 받지 않았어요. 표본은 대표적인 오픈 모델 집합이므로 모든 모델과 서비스 제공자를 대표하지는 않아요. 결과는 전체 통계일 뿐, 모든 요청이 16.9% 개선을 얻는다는 뜻은 아니에요. 또한 이 데이터는 협업 이전에 진행된 OpenRouter 실험에서 나온 것으로, Hugging Face 출시 이후의 독립 실측은 아니에요.
💡 테스트 제안: 라우팅 실험은 전체 통계를 보여줄 뿐, 내 비즈니스의 성능은 직접 테스트해야 해요. 같은 코드 안에서 여러 주류 모델의 출력 품질과 비용을 가로로 비교해야 한다면 APIYI apiyi.com을 통해 하나의 키로 통합 호출할 수 있어요. 먼저 모델 레이어의 선택을 확정한 뒤, 서비스 제공자 레이어의 최적화를 고려해 보세요.
Provider에 장애가 생기면 시스템은 어떻게 전환할까요
자동 페일오버의 대표적인 흐름은 이렇습니다. 라우팅에서 Provider A를 선택하고, A가 정상이면 바로 응답을 반환해요. A에서 오류가 나거나 용량 문제가 생기면 시스템은 같은 요청 안에서 Provider B를 시도하고, B가 성공하면 결과를 반환해요. 실험에서 ‘재시도가 필요한 요청’ 비율은 10.4%에서 6.9%로 줄었고, 요청마다 실패한 시도에 쓰는 시간은 349 ms에서 242 ms로 감소했어요. 이는 좋은 라우팅이 재시도를 잘하는 것을 넘어, 애초에 상태가 나쁜 서비스 제공자를 최대한 피해야 한다는 뜻이에요.
자동 폴백과 Provider 지정은 서로 제약하는 선택이에요. 기본 라우팅은 전환을 허용해서 가용성이 더 높아요. 반면 Provider를 지정하면 요청을 한 곳에 고정해 공급업체 승인 요건을 충족할 수 있지만, 장애 대응 여지는 사라져요. OpenRouter 자체 API는 only(지정한 Provider만 허용)와 allow_fallbacks: false(자동 폴백 비활성화)를 조합해서, 규정을 충족하는 Provider가 없을 때 요청을 다른 공급업체로 넘기지 않고 바로 실패하게 할 수 있어요. 여기서 구분해야 할 점은, 이 매개변수들이 OpenRouter 전체 API의 매개변수이며, Hugging Face 인터페이스에서도 모두 제공된다고 이해하면 안 된다는 거예요. Hugging Face 쪽에서 이에 대응하는 기능은 Provider 지정과 설정에서 Provider를 비활성화하는 것이에요.
재시도에도 비용이 따르고, 무한히 할 수 있는 것도 아니에요:
- 시간 비용: 실패한 시도가 한 번씩 있을 때마다 전체 소요 시간이 늘어나고, 실시간 상호작용에 미치는 영향이 커요.
- 스트리밍 출력: 이미 출력이 시작된 스트리밍 응답은 다른 서비스 제공자로 끊김 없이 이어 붙일 수 없어요.
- 중복 부작용: 도구 호출이 첫 번째 시도에서 이미 외부 동작을 일으켰다면, 재시도로 같은 동작이 중복 실행될 수 있어요. 애플리케이션이 자체적으로 멱등 처리를 해야 해요.
- 캐시 손실: Prompt Caching은 보통 특정 서비스 제공자에 묶여 있어서, 제공자를 바꾸면 캐시 이점을 잃을 수 있어요. Hugging Face는 이를 위해
X-HF-Session-Id요청 헤더를 제공하고, 안정적인 UUID를 사용해 같은 세션이 캐시를 보유한 Provider에 최대한 남도록 해요. - 사용 가능한 서비스 제공자 없음: 특정 모델에 Provider가 하나뿐이거나, 다른 Provider가 현재 매개변수를 지원하지 않으면 전환할 대상이 없어요. 할당량 부족, Token 권한 부족, 유효하지 않은 요청, 컨텍스트 한도 초과 같은 문제는 라우팅으로도 해결할 수 없어요.
Hugging Face 과금과 자체 Key의 변화
이번 협력은 하나의 호환되지 않는 변경(breaking change)을 가져왔어요. Hugging Face를 통해 언어 모델을 호출할 때 자신이 설정한 Provider API Key를 더 이상 사용할 수 없어요. 관련된 모든 요청은 OpenRouter를 통해 라우팅되고, 비용은 Hugging Face 계정 또는 조직 계정에 청구돼요. 이미지·영상 생성 작업의 자체 Key는 여전히 사용할 수 있지만, 자세한 내용은 공식 설명을 기준으로 해요.
개발자가 자신이 구매한 서비스 제공자의 크레딧을 계속 사용하고 싶다면, 해당 제공자의 API를 직접 호출하거나 OpenRouter 자체 계정으로 바꿀 수 있어요. OpenRouter의 현재 BYOK 문서 기준으로 보면, BYOK의 무료 크레딧은 동등한 추론 카탈로그 비용으로 측정되며, Pay-as-you-go 계정은 월 25,000달러, Enterprise는 맞춤형 크레딧이에요. 초과분은 동등 추론 비용의 5%로 과금되어 플랫폼 Credits에서 차감돼요. 여기서 25,000은 달러로 측정한 추론 비용이며, 요청 횟수가 아니에요. 또한 공유 용량으로 폴백할 때 플랫폼 Credits를 소비할 수 있어요. OpenRouter에 직접 연결하는 것은 또 다른 독립적인 계정 및 과금 관계이며, 기존 Key가 자동으로 이전되지는 않아요.
Hugging Face의 현재 가격 문서를 보면, Free 사용자는 고정된 월별 무료 크레딧이 없고, PRO 사용자는 월 2달러, Team과 Enterprise는 좌석당 월 2달러예요. 이 크레딧은 범용 Compute Credits로, Inference Providers, Inference Endpoints, Spaces 등의 서비스에 사용할 수 있어요. 한 가지 더 주목할 점은, Provider의 가격 책정 방식이 변하지 않는다고 해서 요청당 비용이 변하지 않는 것은 아니라는 거예요. 라우팅이 가격이 조금 더 비싸지만 더 빠르고 안정적인 서비스 제공자를 선택할 수 있기 때문이에요.
개발자가 디렉토리 API로 여러 서비스 제공사를 직접 비교하는 방법
Hugging Face는 조회 가능한 모델 디렉토리 인터페이스를 제공하는데, 이는 라우팅 시스템이 의사결정 근거를 얻는 공개 창구예요:
- 전체 모델:
GET https://router.huggingface.co/v1/models - 단일 모델:
GET https://router.huggingface.co/v1/models/deepseek-ai/DeepSeek-V4-Pro
| 필드 | 의미 | 모델 선택에서의 역할 |
|---|---|---|
| provider | 실제로 추론을 제공하는 서비스 제공사 | 후보 목록 확정 |
| status | 현재 상태(예: live, error) | 사용할 수 없는 제공사 제외 |
| context_length | 해당 제공사가 지원하는 컨텍스트 길이 | 긴 컨텍스트 요구 필터링 |
| pricing.input / pricing.output | 입력·출력 100만 Token당 달러 가격 | 비용 정렬 |
| supports_tools | 도구 호출 지원 여부 | Agent 시나리오의 필수 조건 |
| supports_structured_output | 구조화 출력 지원 여부 | JSON 출력 필수 조건 |
| first_token_latency_ms | 최근 검증 프로브의 첫 Token 지연 | 대화형 유형 정렬 |
| throughput | 최근 검증 프로브의 생성 속도 | 긴 출력 유형 정렬 |
| is_free / is_model_author | 임시 무료 이벤트 / 모델 발행자 여부 | 보조 참고 |
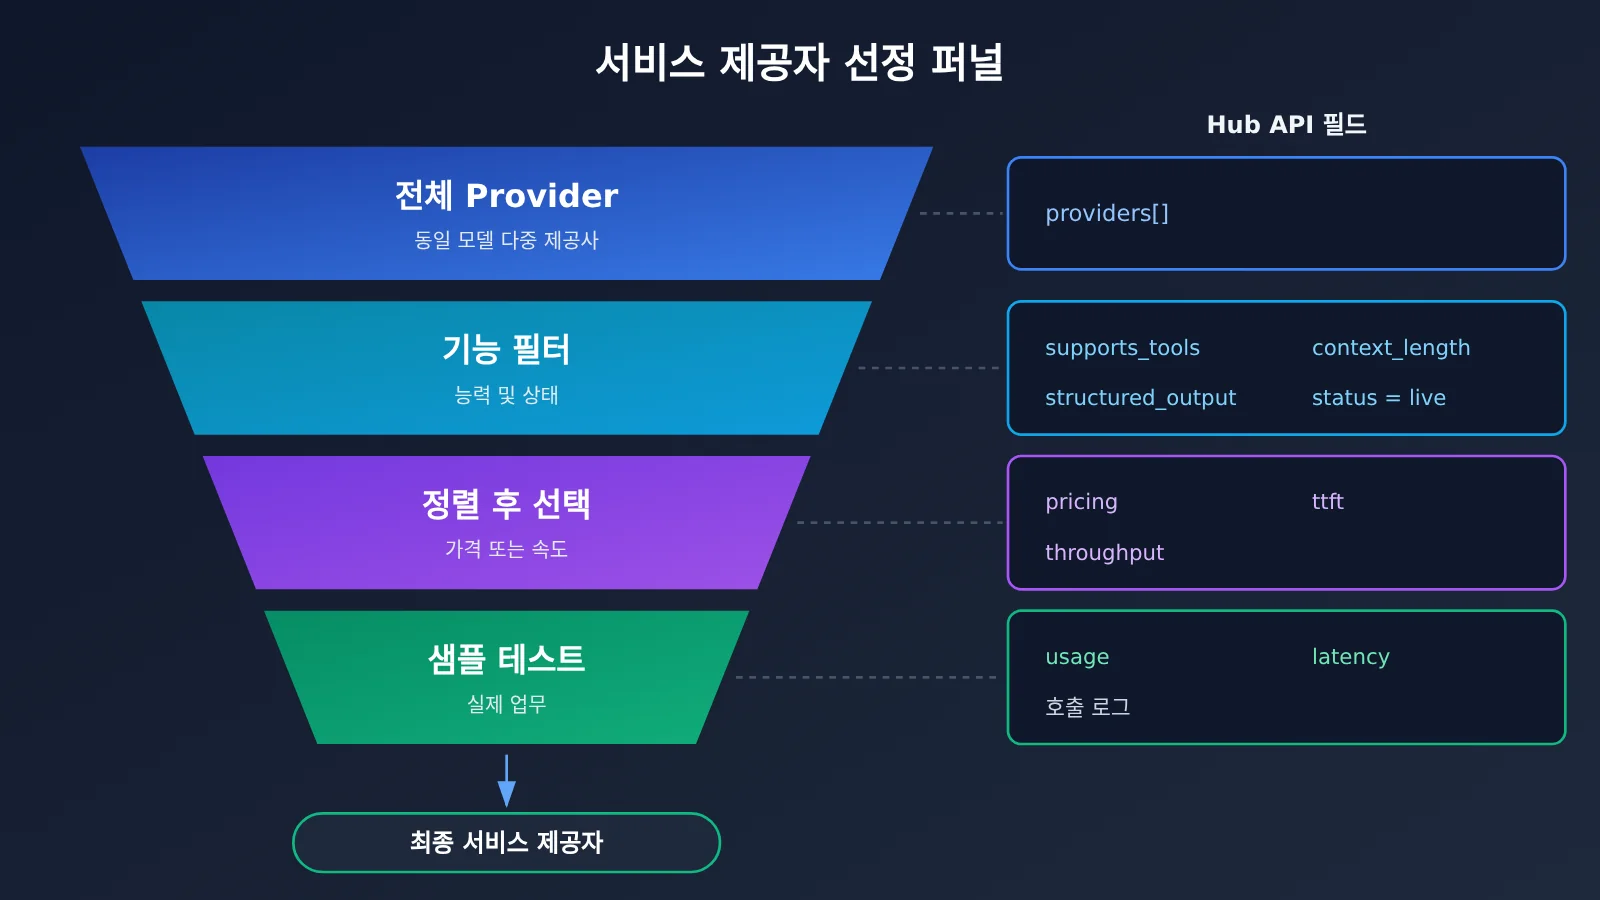
이 필드들이 모든 Provider에서 빠짐없이 제공되는 것은 아니고, 성능 데이터 역시 최근 검증 프로브에서 나온 값이라 여러분 환경의 엔드투엔드 실시간 성능과 같다고 볼 수 없어요. 합리적인 방법은 “먼저 필터링하고, 다음 정렬”이에요: 기능 필드로 호환되지 않는 제공사를 먼저 걸러낸 뒤 비용이나 속도로 정렬하는 거죠. 아래 예시가 이 흐름을 보여주며, 반환 구조는 공식 Hub API 문서를 기준으로 하세요:
import os
import requests

HF_TOKEN = os.environ["HF_TOKEN"]
MODEL = "deepseek-ai/DeepSeek-V4.1-Flash"

resp = requests.get(
    f"https://router.huggingface.co/v1/models/{MODEL}",
    headers={"Authorization": f"Bearer {HF_TOKEN}"},
    timeout=30,
)
data = resp.json()
providers = data.get("providers", [])  # 구체적인 구조는 공식 문서를 기준으로 합니다

# 1단계: 기능 필터링 (Agent는 도구 호출 + 구조화 출력 + 64K 컨텍스트 필요)
candidates = [
    p for p in providers
    if p.get("status") == "live"
    and p.get("supports_tools")
    and p.get("supports_structured_output")
    and (p.get("context_length") or 0) >= 64_000
]

# 2단계: 출력 단가 기준 정렬, 누락된 필드는 맨 뒤로
candidates.sort(key=lambda p: (p.get("pricing") or {}).get("output", float("inf")))

for p in candidates:
    print(p["provider"], p.get("pricing"), p.get("first_token_latency_ms"), p.get("throughput"))
후보를 걸러낸 뒤에는 반드시 실제 업무 요청으로 한 번 더 테스트해야 해요. 디렉토리 메타데이터는 서비스 제공사가 “무엇을 지원한다고 주장하는지”를 알려줄 뿐, 여러분 작업에서의 정확도, 도구 호출 성공률, 최종 완료율을 대신해 주지는 않아요.
서비스 제공사 수준에서 세부 조정을 하기 전에, 일반적으로 먼저 어떤 모델을 쓸지 정해야 해요. 아래 코드는 동일한 OpenAI 호환 인터페이스로 여러 모델의 응답을 일괄 비교하는 예시이며, 모델 ID는 플랫폼 모델 목록에 있는 실제 이름으로 바꿔 주세요:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스, 하나의 Key로 여러 모델 호출
)

prompt = "用 JSON 返回:{\"city\": 城市名, \"reason\": 一句话理由},推荐一个适合冬季旅行的城市"

for model in ["model-id-a", "model-id-b", "model-id-c"]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, resp.usage.total_tokens, resp.choices[0].message.content)
🚀 빠르게 시작하기: 신규 사용자는 APIYI apiyi.com에서 무료 테스트 크레딧을 받아 위 코드로 자신의 업무 샘플을 돌려볼 수 있어요. 백엔드 호출 로그에는 요청마다 모델, Token 소비량, 비용이 기록되므로, 표시 가격만 보는 대신 실제 작업 하나당 비용을 계산할 수 있어요.
먼저 짚고 넘어갈 부분이 있어요. 통합 접속과 호출 로그, 그리고 Hugging Face가 보여주는 Provider 수준의 실시간 성능 데이터는 서로 다른 계층의 기능이에요. 앞자는 “연결이 되고, 계산이 되는” 문제를 해결하는 쪽이고, 뒤자는 하위 서비스 제공업체의 동적 상태를 한 단계 더 드러내는 쪽이죠. 두 가지는 함께 활용할 수 있어요.
여러 API 서비스 제공업체와 스마트 라우팅: 분석과 판단
API 집계 플랫폼의 다음 경쟁은 어디에서 일어날까요
OpenRouter의 능력을 하나하나 뜯어보면 세 계층으로 나눌 수 있어요. 모델 집계는 “서로 다른 모델에 어떻게 접근할지”를 해결하고, Provider 집계는 “같은 모델을 누가 추론할지”를 해결하며, 동적 라우팅은 “이번 요청을 누구에게 맡길지”를 해결합니다. 통합 인터페이스가 이미 접근 문제를 거의 해결한 상황에서, 이번 협력은 두 번째와 세 번째 계층이 새로운 경쟁 지점으로 떠오르고 있음을 보여줘요. 이 판단의 근거는 이렇습니다. Hugging Face는 자체 라우터 구축을 포기하고 외부 라우팅 능력으로 전환했으며, OpenRouter도 라우팅 알고리즘을 별도로 공개하고 실제 운영 실험으로 그 가치를 증명했어요.
비용 최적화, 안정성, 데이터 거버넌스가 앞으로 API 플랫폼의 새로운 비교 축이 될 것으로 예상할 수 있어요. 다음은 예측이며 아직 이후 검증이 필요한 부분입니다. 라우팅 투명성은 점점 더 중요해질 거예요. 개발자들은 요청이 어느 서비스 제공자에게 도달했는지, 왜 그것을 선택했는지, 얼마를 지불했는지 알고 싶어 하게 됩니다. 데이터 정책 제약은 부가 옵션에서 기업 구매의 필수 조건으로 바뀔 수도 있어요.
그런데 라우팅이 만능 해결약은 아니에요. 실험 데이터에 따르면, 더 빠르고 더 안정적인 대가는 더 높은 단위 비용입니다. 협력 공지에 담긴 후속 계획(예: 양측 계정 연결, 더 많은 작업을 OpenRouter 라우팅에 포함)도 아직 계획에 불과해요. 라우팅은 모델 자체의 품질, 라이선스, 비즈니스 적합성 문제까지 해결할 수는 없습니다.
오픈 웨이트 모델의 수요와 기업의 비용 압박
“서비스 제공사의 라우팅이 중요해졌다”는 판단에는 수요 측 데이터가 뒷받침이 됩니다. OpenRouter 통계에 따르면 상위 50개 모델의 주간 토큰 사용량을 기준으로 2026년 9월 28일 오픈 웨이트 모델의 비중이 71.7%에 달했어요. 이 수치는 OpenRouter 플랫폼 내부 집계 기준이므로 전 세계 시장 점유율로 확대 해석할 수는 없어요. 오픈 웨이트 모델의 사용량이 커질수록 같은 모델에 여러 서비스 제공사가 함께 존재하는 경우가 흔해지고, 라우팅의 가치도 그만큼 뚜렷해집니다.
비용 측면에서는 Capgemini가 2026년 9월에 대형 기업 CXO 500명을 대상으로 설문한 결과, 59%가 AI 지출이 예상을 크게 초과했다고 응답했어요. 영향을 받은 기업들의 평균 초과 지출 폭은 24%였습니다. 이 데이터는 해당 설문 표본만을 대표하지만, 라우팅 실험에서 나온 “속도 향상에는 비용 상승이 동반된다”는 결론과 함께 보면 기업에 이런 점을 일깨워줘요. 즉 자동 라우팅은 기본적으로 종합적인 경험을 추구할 뿐, 최저 청구서를 보장하지는 않는다는 거죠. 비용에 민감한 업무라면 능동적으로 가격 우선 전략을 선택하거나 가격 상한을 설정하고, 호출 로그로 계속 확인해야 해요.
역할별로 어떻게 판단해야 할까
- 개인 개발자와 소규모 팀: 기본 자동 라우팅만으로도 자체 장애 대비(failover)를 구축하는 수고를 덜 수 있어요. 핵심은 실제 샘플로 도구 호출과 JSON 출력이 안정적인지 검증하는 것입니다. 먼저 APIYI apiyi.com 같은 통합 인터페이스로 모델을 확정하고, 필요에 따라 서비스 제공사 차원에서 최적화하는 방식이 투입 비용이 낮은 경로예요.
- 인터랙티브 제품: 처리량(throughput)보다 TTFT P95에 먼저 주목하세요.
:fastest가 짧은 응답의 체감 품질을 반드시 개선하지는 않아요. - 긴 출력과 배치 처리 작업: 처리량과 실효 가격이 더 중요하니 가격 우선 전략을 고려하고, 세션 고정(session affinity)을 활용해 캐시 이점을 지키세요.
- 기업과 플랫폼 팀: 먼저 어떤 애플리케이션이 자체 Provider Key에 의존하는지, 어떤 업무가 반드시 특정 서비스 제공사를 고정해야 하는지 파악한 다음, 폴백을 허용할지, 제공사를 제한할지, 직접 연결할지 결정하세요. 데이터 처리 계약은 제공사별로 하나하나 확인해야 합니다.
어떤 전략을 선택하든 결국 같은 행동으로 귀결돼요. 바로 자기 요청과 자기 지표로 한 라운드를 돌려보는 것이죠. APIYI apiyi.com의 무료 크레딧으로 소규모 비교를 하거나, Hugging Face 디렉터리 API로 먼저 후보 서비스 제공사를 추려내는 것 모두 비용이 아주 낮은 출발점이에요. 공식 실험의 16.9%는 전체 평균값일 뿐, 여러분의 업무에서 얼마나 얻을 수 있는지는 직접 측정해야 알 수 있어요.
The proof of the pudding is in the eating.(푸딩이 좋은지 나쁜지는 먹어봐야 안다; 실제 효과는 실천으로 검증해야 한다는 뜻이에요.)


