著者注:重みのオープン化、ターミナルタスク、長タスクの納品、視覚・動画、100万トークンあたりのコストという5つの軸で Qwen4-Max と Kimi K3.1 Pro を比較し、両社の公式 Terminal-Bench スコアがなぜ一致しないのかを解説します。
先に結論:重みを取得してファインチューニング、量子化、プライベートデプロイを行いたいなら Kimi K3.1 Pro を選んでください。マネージドAPIを利用し、視覚・動画・長タスクの納品を重視し、100万トークンあたりのコストを最小限に抑えたいなら Qwen4-Max を選んでください。中核となるワークロードがターミナル上のコマンドラインエージェントであれば、現時点では Kimi K3.1 Pro が明確に優位です。
これは「どちらにも良さがある」という妥協的な分析ではありません。以下のすべての数値には出典を明記します。Qwen の数値は Alibaba 公式ブログおよび公式が自己申告した同一グラフ対照に由来し、Kimi の数値は Moonshot 公式ドキュメント、第三者データは Arena 公開リーダーボードのスナップショット(2026-11-14)に由来します。両社が自己申告した同一ベンチマークの数値がなぜ食い違うのかは、本文で別途詳しく解説します。
本記事の価値:読み終えれば、明確な選定の分岐線が得られ、「より安い」「重みを取得できる」という2つの強みを自分のタスクにどう換算するかがわかります。
Qwen4-Max と Kimi K3.1 Pro の本質的な違い
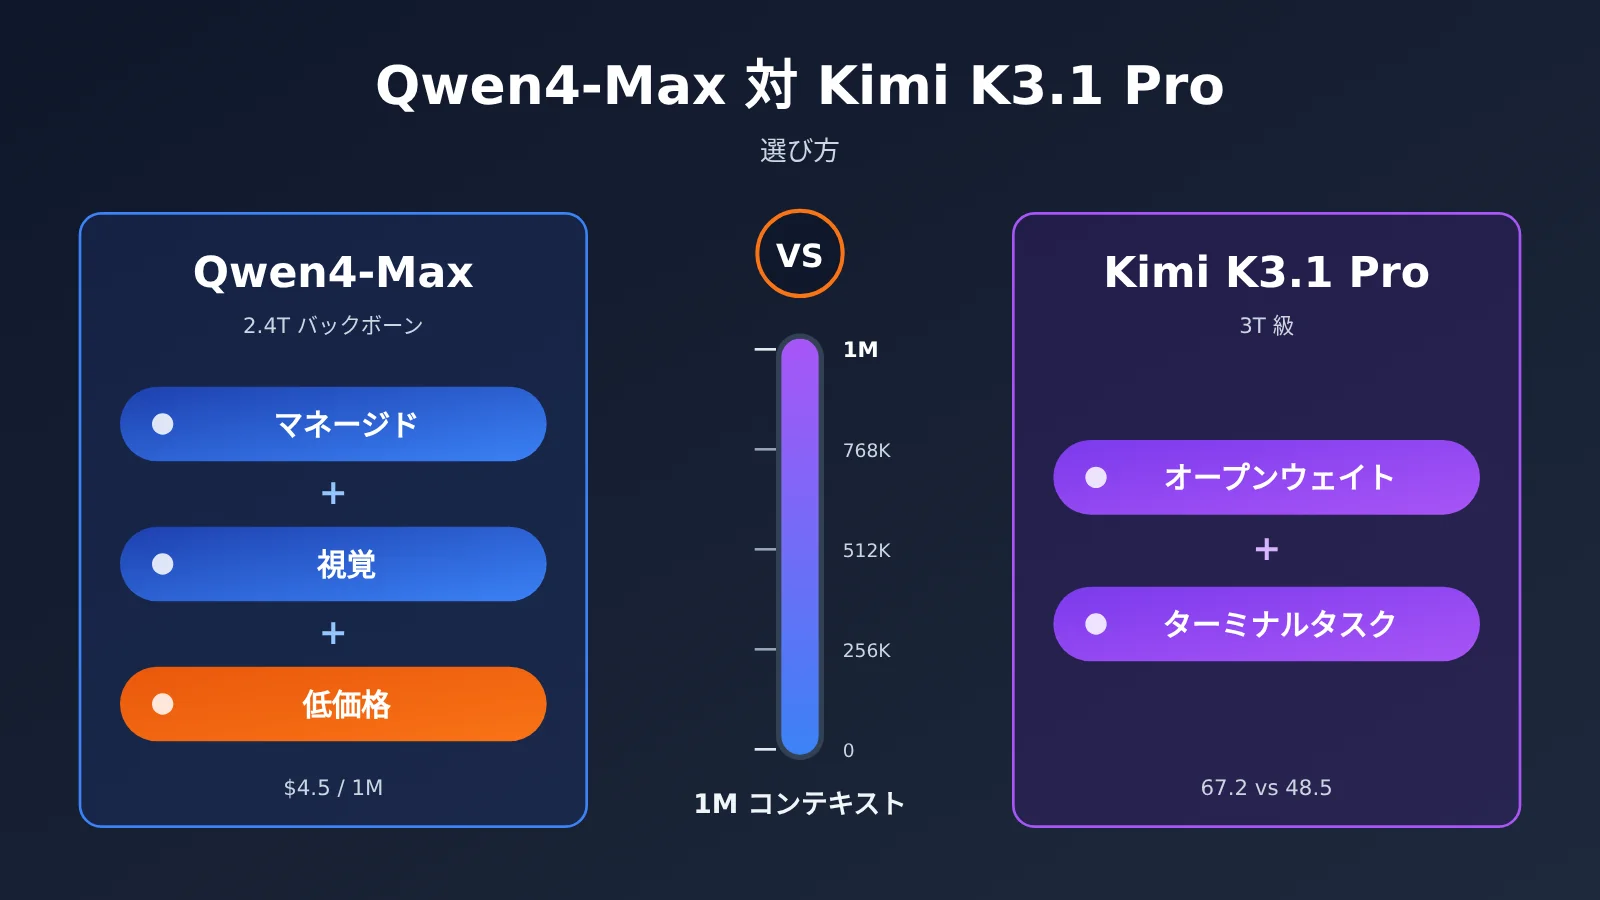
両モデルは 2026 年下半期の国産フラッグシップで、コンテキストはどちらも 1M 級、表面的なスペックは近いものの、位置づけには大きな差があります。Qwen4-Max は 2.4T のバックボーンに 71B のアクティブパラメータ、さらに 328B の N-gram Embedding を組み合わせ、視覚をネイティブサポート、最大出力 393K、最大思考連鎖 262K、デフォルトの reasoning_effort は high です。Kimi K3.1 Pro は K3.1 シリーズの最初のモデルで 3T 級に属し、公式には「最も能力の高い 3T 級オープンウェイトモデル」と称され、コンテキストは 1,048,576 token です。
| 比較軸 | Qwen4-Max | Kimi K3.1 Pro | 優位 |
|---|---|---|---|
| 規模 | 2.4T バックボーン / 71B アクティブ + 328B N-gram Embedding | 3T 級 | — |
| ウェイト | 公開情報では QwenCloud のホスト型 API のみ言及 | オープンウェイト | Kimi |
| コンテキスト | 1M、最大出力 393K | 1,048,576 token | 互角 |
| ターミナルタスク(Alibaba 同一図表) | 48.5 | 67.2 | Kimi |
| 長尺タスクと業界向け納品 | 複数項目でリード | AutomationBench はわずかに上 | Qwen4 |
| 視覚と動画 | ネイティブ視覚、図表・動画指標でリード | 指標は劣る | Qwen4 |
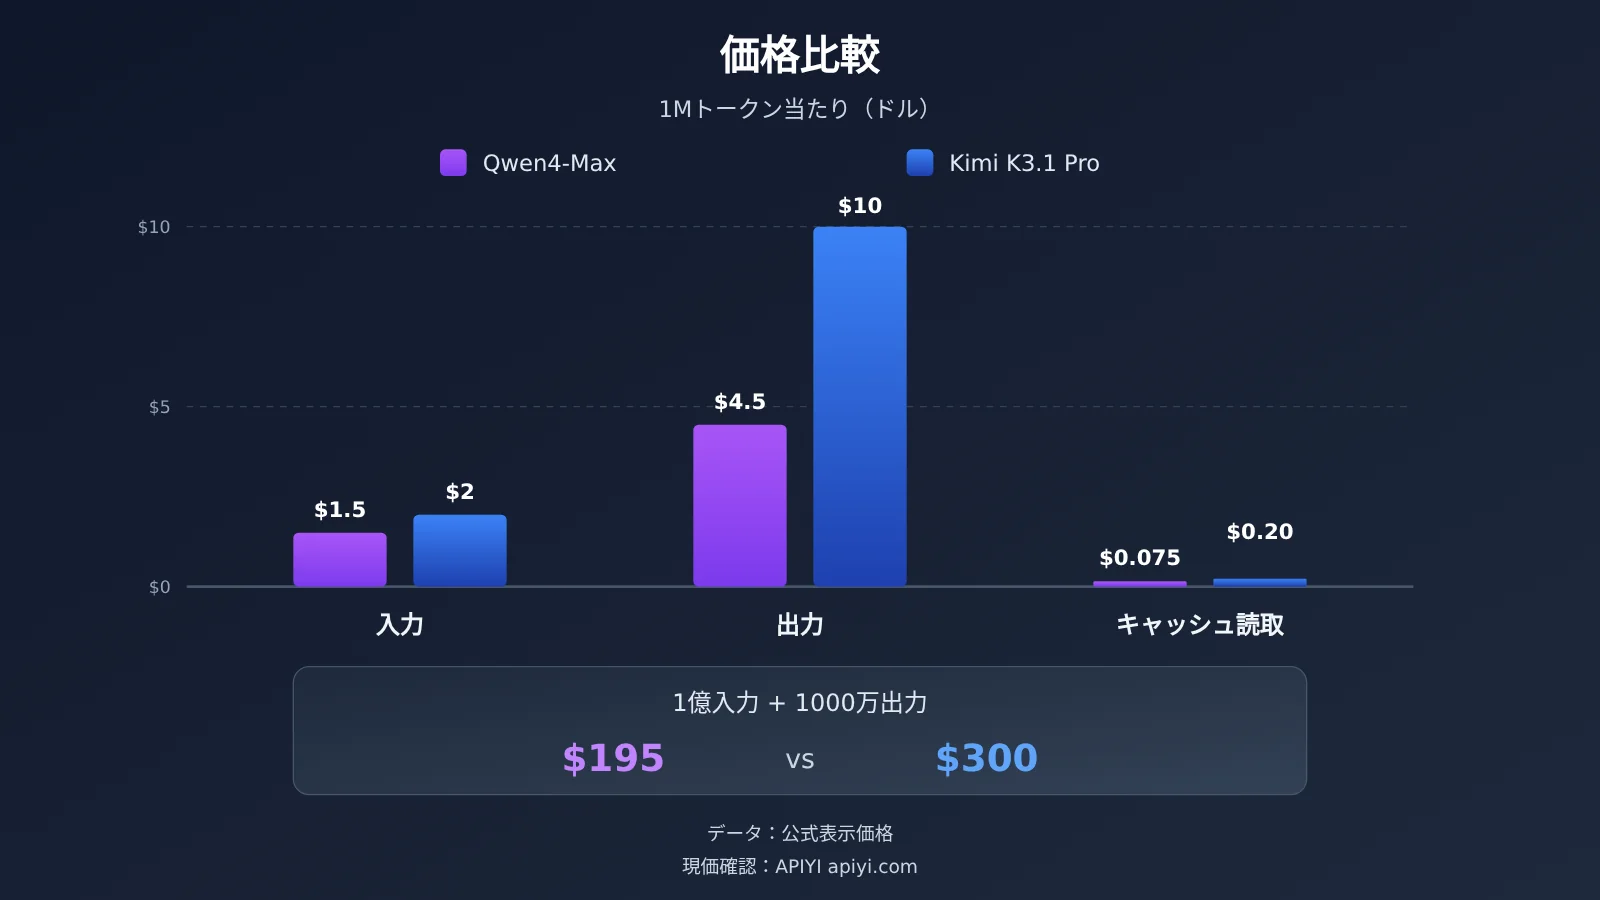
| 出力 1M あたりの価格 | $4.5 | $10 | Qwen4 |
ひと言でまとめると、Kimi の強みは「書き換えられる」ことと「ターミナルで動かせる」ことにあり、Qwen4 の強みは「納品できる範囲の広さ」と「安さ」にあります。以下、5 つの観点から順に掘り下げます。
Kimi K3.1 Pro と Qwen4-Max は重みを変更できるのか
これは両者を分ける最も明確な境界線です。Kimi K3.1 Pro はオープンウェイトモデルであり、チームは自社のクラスタに持ち込んでドメイン微調整、量子化・圧縮、蒸留を行ったり、コンプライアンス要件が厳しい環境でオフライン展開したりできます。「モデル自体を改変する」必要があるチームにとって、これに代わる選択肢はありません。どれほど高いベンチマークスコアでも、これを代替することはできません。
Qwen4-Max の現在の公開資料では、QwenCloud 経由でホスト型 API として提供されることだけが言及されており、参考資料にはオープンウェイトについての記載はありません。ホスティングの利点は GPU、推論フレームワーク、スケーリングを管理する必要がないこと、欠点はプロンプト、コンテキスト、ツール呼び出しを通じてしかビジネスに適応できないことです。補足しておきたいのは、オープンウェイトそのものが自動的に安全性を意味するわけではなく、安全性は依然としてデプロイ、アクセス制御、監査プロセスに依存するという点です。
換算方法:モデルを「呼び出す」だけなら、ウェイトのオープン化の価値はほぼゼロです。明確に微調整やプライベート化が必要なら、Kimi はこの比較の中で唯一の選択肢であり、後続のいくつかの軸はそれが「十分かどうか」を評価するためだけに使われます。
Qwen4-Max と Kimi K3.1 Pro、ターミナルタスクで強いのはどちらか
ターミナルタスクとは、モデルがコマンドライン環境でファイルを読み書きし、コマンドを実行し、エラーに応じて反復修正する作業を指します。コーディング agent が実際の業務に最も近い形で試されるシナリオです。この項目では Kimi K3.1 Pro が明らかに強く、Alibaba 公式が自己申告した同一チャートの比較では、Qwen4-Max の Terminal-Bench 4.0 スコアは 48.5、Kimi K3.1 は 67.2 で、18.7 ポイントの差があります。これはチャート全体の中で Qwen4 が最も大きく後れを取っている項目です。
なぜ Terminal-Bench の数値は両社で異なるのか
ここには見落としやすいポイントがあります。同じ Kimi K3.1 Pro でも、両社の公式資料に記載された Terminal-Bench 4.0 のスコアは一致しません。
| 出典 | Kimi K3.1 Pro | その他の参照 |
|---|---|---|
| Moonshot 公式ドキュメント | 65.7% | Claude Opus 5.5 は 66.4%、GPT-6 Astra は 58.2% |
| Qwen 公式の自己申告による同一チャート比較 | 67.2 | Qwen4-Max は 48.5 |
Kimi 側の資料では 65.7%、Alibaba のチャートでは Kimi が 67.2 とされており、1.5 ポイントの差があります。この差は、評価 harness(エージェントフレームワーク、ツール定義、タイムアウトとリトライ戦略)、reasoning effort の設定、問題セットのバージョンの違いに由来します。どちらかが不正をしたと解釈することはできませんし、2つの数値を混ぜて一つの「Kimi のターミナルタスクスコア」として引用することもできません。同様に、Claude Opus 5.5 は Moonshot のドキュメントでは 66.4% ですが、Alibaba の評価フレームワークでは別の数値になります。ドキュメントをまたいで数値をつなぎ合わせたランキングは成立しません。
正しい読み方は、同じチャート、同じ harness の中で相対的な位置だけを比較することです。Moonshot の基準では、Kimi は Opus 5.5 をわずかに下回り、GPT-6 Astra を明確に上回ります。Alibaba の基準では、Kimi は Qwen4-Max を大きくリードします。どちらの結論も成り立ち、方向性も一致しています。Kimi K3.1 Pro のターミナル能力はトップクラスに位置します。
🎯 技術的なアドバイス:ベンチマークスコアは harness と effort によって変動するため、最も確実な方法は、自分の agent フレームワークと実際のタスクでそれぞれ1回ずつ実行することです。APIYI apiyi.com 経由なら、同じ APIキーで
kimi-k3.1-proなどのモデルを呼び出せます。フレームワークを変えずmodelパラメータだけを切り替えて得た比較結果にこそ意味があります。
もう一つの関連項目として、コード系タスクのその他の指標を見てみましょう。Alibaba の同一チャートでは、DeepSWE v1.1 は両者ほぼ互角(75.7 対 75.5)で、ProgramBench では Qwen4-Max が 6.5 ポイント高い(31.5 対 25.0)結果です。Moonshot の公式ドキュメントでは、Kimi Code Bench 3.0 Long-horizon が 61.2% と、前世代 K3 の 55.95% から明確に向上していることも示されています。したがって正確には、Kimi はターミナル操作に強く、Qwen4 はターミナルを使わない一部のコーディングタスクでは引け劣らない、ということです。
Qwen4-Max と Kimi K3.1 Pro の長タスク・業界デリバリー
エージェントの役割が「一つの仕事を最後までやり遂げる」こと——レポートの整理、業務フローの完遂、専門領域の課題処理——であれば、Qwen4-Max は Alibaba の同一チャート上でより優れたパフォーマンスを発揮します。以下の表は、Qwen 公式が自己申告した同チャート比較から、長タスクと業界シナリオに関連する指標を抜粋したものです。
| ベンチマーク(Qwen 公式の自己申告による同チャート比較) | Qwen4-Max | Kimi K3.1 | 差分 |
|---|---|---|---|
| JobBench | 68.5 | 61.2 | Qwen4 が 7.3 高い |
| APEX-Agents v1.1 | 72.1 | 65.5 | Qwen4 が 6.6 高い |
| HLAB-Vals-1.1 | 21.3 | 11.7 | Qwen4 が 9.6 高い |
| AA-Briefcase v1.1 Elo | 1686 | 1674 | Qwen4 が 12 高い |
| AgentArena Net Improvement | 7.5 | 3.9 | Qwen4 が 3.6 高い |
| AutomationBench-AA | 72.5 | 73.3 | Kimi が 0.8 高い |
| BioMysteryBench | 85.0 | 80.6 | Qwen4 が 4.4 高い |
| HealthBench Professional | 60.0 | 57.2 | Qwen4 が 2.8 高い |
| Humanity’s Last Exam | 51.7 | 51.1 | ほぼ同等 |
このデータの傾向は非常に明快です。Qwen4-Max は業務タスク、エージェントによる納品、バイオ・医療などの専門領域で大半においてリードしており、その差は 3〜10 点の範囲に収まっています。Kimi がリードするのは AutomationBench-AA の 0.8 点のみで、HLE では両者はほぼ同じ数値です。留意すべき点として、これは Alibaba 側の評価フレームワークによる結果であり、Kimi が自社のハーネスで測定した数値は異なる可能性があります。
Qwen4-Max の最大出力 393K と最大思考チェーン 262K は、長いタスクにおいても実用的です。1 回の呼び出しで非常に長いレポートやコードファイルを生成できるため、頻繁な分割や結合が不要になり、エージェントのオーケストレーションにおけるエラーポイントを減らすことができます。
Qwen4-Max と Kimi K3.1 Pro の視覚・動画能力
Qwen4-Max は視覚入力をネイティブにサポートしています。これは Alibaba の同図でも示されているとおりで、チャート理解ベンチマークの Chartography では Qwen4 が 54.2、Kimi が 50.0、動画理解ベンチマークの Video-Index では Qwen4 が 68.1、Kimi が 63.2 となり、それぞれ 4.2 ポイントと 4.9 ポイントのリードを付けています。
スクリーンショットを読み取る、レポートのグラフを解析する、製品の画面録画を理解する、動画コンテンツを分析するといった業務では、Qwen4-Max のほうが手間が少なくて済みます。Kimi もこの 2 項目で相応の成績を残していますが、視覚処理が主な負荷となる場合は、規模が大きくなるにつれて差が拡大していきます。
フロントエンド生成については第三者データを参照するとよいでしょう。arena 公開ランキングのスナップショット(2026-11-14)の Code Arena WebDev では、Qwen4-Max(xHigh)が 1750 点で 6 位ですが、依然として Preliminary 表記で、票数は 1,814 です。一方、Kimi K3.1 Pro(Max)は 1686 点で 13 位、票数 5,215 で、すでに preliminary ではありません。Qwen4 のスコアのほうが高いもののサンプル数が少ないため、順位は今後も変動する可能性があります。
Qwen4-Max と Kimi K3.1 Pro のコスト計算方法
公式定価(100万トークンあたり、データ取得日 2026-11-16)
| 課金項目 | Qwen4-Max(QwenCloud) | Kimi K3.1 Pro(Moonshot) | Kimi K3.1 Pro Highspeed |
|---|---|---|---|
| 入力 | $1.5 | $2 | $4 |
| 出力 | $4.5 | $10 | $20 |
| キャッシュ読み取り / キャッシュヒット | $0.075 | $0.20 | $0.20 |
| 5分キャッシュ書き込み | $1.875 | $2 | — |
| 1時間キャッシュ書き込み | $3 | $4 | — |
定価ベースで換算すると、Qwen4-Max の入力価格は Kimi の75%、出力価格は45%、キャッシュ読み取りはわずか37.5%です。「入力1億 + 出力1000万」という典型的なエージェント負荷で試算すると、Qwen4-Max は約 $195、Kimi K3.1 Pro は約 $300 になります。Kimi にはバッチモードもあり、料金は標準価格の6割で、オフラインのバッチ処理に向いています。Highspeed 版は価格が2倍になる代わりに、約2〜3倍の速度が得られます。
単価が安いからといって、1タスクあたりのコストも安いとは限らない
これはコスト面で最も直感に反する点です。arena のスナップショットによると、Qwen4-Max(xHigh)の1タスクあたりコストは $4.18、Kimi K3.1 Pro(Max)はわずか $0.89 でした。Qwen4 はトークン単価が安いのに、1タスクあたりでは数倍高くなっています。理由は、高い effort 設定ではモデルが大量の思考の連鎖(Chain-of-Thought)トークンを生成し、出力量が Kimi をはるかに超えるためです。
そのため、実際のコストを計算する際は「価格 × 実際のトークン消費量」で見る必要があります。Qwen4-Max の reasoning_effort はデフォルトで high です。タスクが深い推論を必要としない場合は、自分で effort を下げることで、単価の優位性を総コストの優位性に変えられます。
APIYI の現行価格(2026-11-16)
| モデルID | 入力 | 出力 | キャッシュ読み取り | ステータス |
|---|---|---|---|---|
kimi-k3.1-pro |
$2 | $10 | $0.2 | 提供中 |
kimi-k3.1-pro-highspeed |
$4 | $20 | $0.2 | 提供中 |
qwen3.8-max |
$1.65 | $4.95 | $0.20625 | 提供中 |
qwen4-max |
— | — | — | 未提供(できるだけ早く追加予定) |
以上は100万トークンあたりの価格です。qwen4-max はまだ APIYI のモデル一覧に表示されていませんが、できるだけ早く追加する予定です。それまでは qwen3.8-max で呼び出し経路を先に構築しておけます。すべてのモデル名と価格は APIYI apiyi.com のモデル一覧を正とします。モデルを切り替える前に、モデル名を確認し、価格を照合し、呼び出しプロトコルを確かめることをおすすめします。
APIYI経由でKimi K3.1 ProとQwenシリーズを呼び出す方法
APIYIはOpenAI互換APIを提供しています。接続時に必要な変更は3か所だけで、SDKを変更する必要はありません。
- クライアントのbase_urlを
https://api.apiyi.com/v1に設定し、リクエストパスを/chat/completionsにします。 - APIYIコンソールで取得したAPIキーを入力します。
modelパラメータをkimi-k3.1-pro、kimi-k3.1-pro-highspeed、またはqwen3.8-maxに設定します。qwen4-maxが提供開始されたら、モデル名を置き換えるだけで済みます。
A/B比較を行う際は、プロンプト、ツール定義、effortのレベルを固定し、modelフィールドだけを切り替えて、各呼び出しの入力・出力・キャッシュのトークン数を記録することをおすすめします。これにより、前述の「harnessがスコアを変える」現象を再現しつつ、2つのモデルがあなたの業務で1タスクあたりに要する実際のコストも算出できます。
🚀 クイックスタート:新規ユーザーはAPIYI(apiyi.com)で登録すると無料のテスト枠が付与され、同じAPIキーでKimiとQwenシリーズを切り替えられます。まず小規模なトラフィックで効果を検証し、そのうえで本番環境の主力モデルを決めましょう。
Qwen4-MaxとKimi K3.1 Proのシーン別おすすめ
Kimi K3.1 Proを選ぶシーン
- プライベートデプロイとファインチューニング:オープンウェイトが必要で、ドメイン固有のファインチューニング、量子化、オフラインでのデプロイを行う場合;
- ターミナルコーディングエージェント:主な処理がコマンドライン上での読み書き、実行、修正のループである場合;
- オフラインバッチ処理:非同期の結果を許容でき、Batchの4割引を利用してコストを抑えたい場合;
- 低遅延の対話:速度が重要な場合はHighspeed版を選択でき、料金と引き換えに2〜3倍の速度を得られます。
Qwen4-Maxを選ぶシーン
- マネージドサービスを優先:推論クラスタを運用したくなく、安定したAPIだけが必要な場合;
- ビジョンと動画:スクリーンショットの理解、グラフの解析、動画の分析が主な入力である場合;
- 長いタスクの遂行:レポート生成、業務プロセスエージェント、医療・バイオなどの専門的なQ&Aが中心である場合;
- トークンコストを重視:effortを適切に制御できれば、100万トークンあたりのコストを最も低く抑えられます。
Qwen4-Max 対 Kimi K3.1 Pro の選定アドバイス
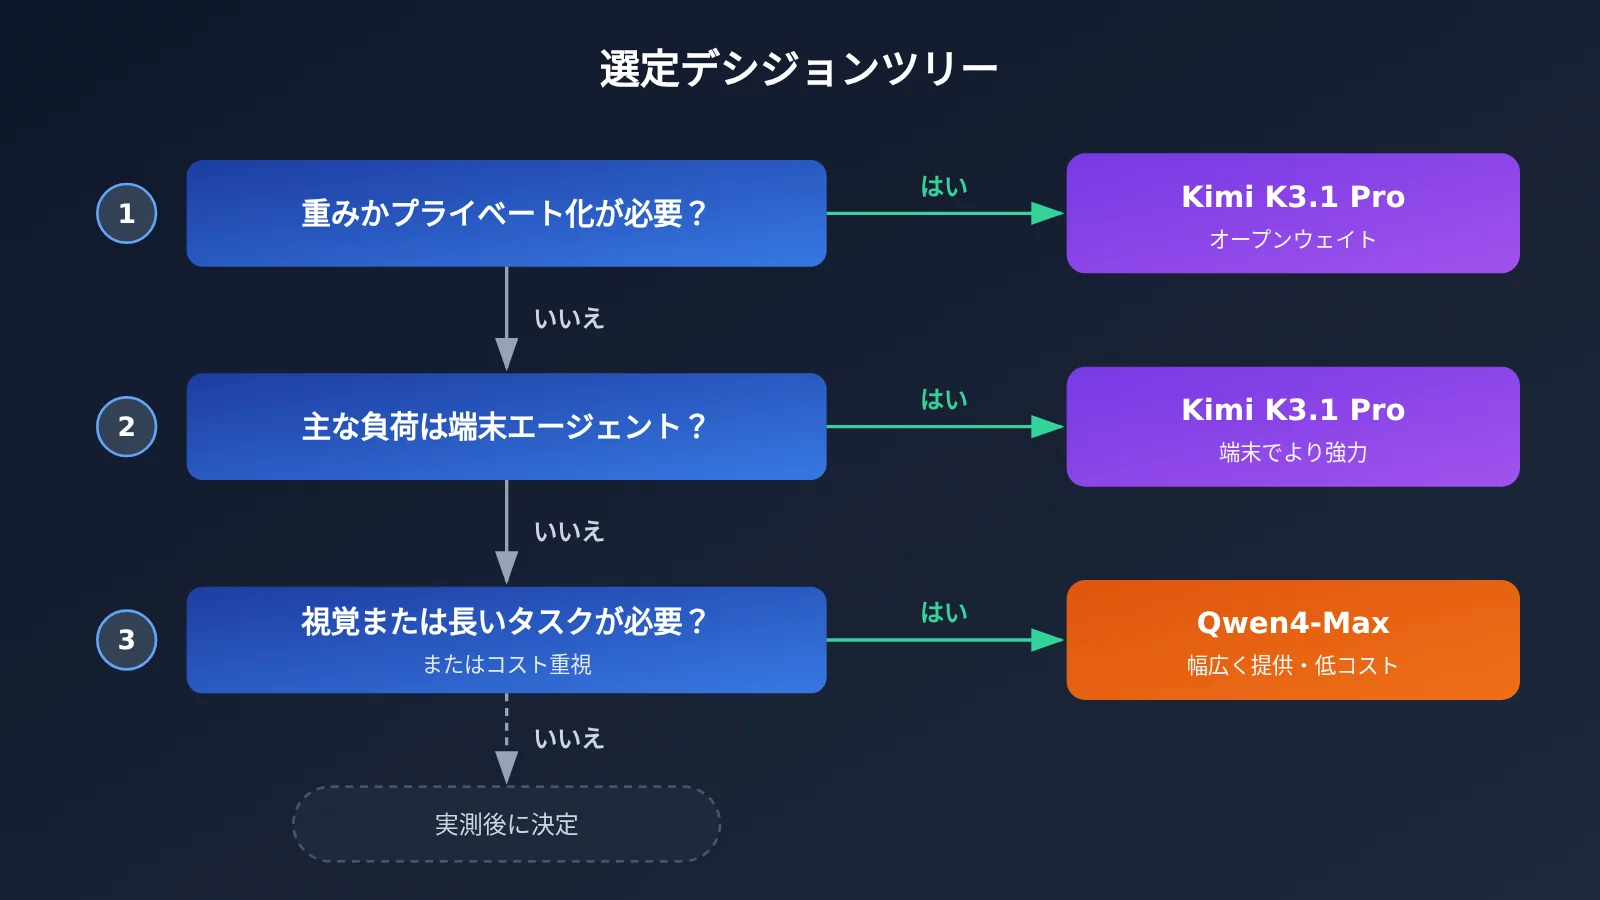
5つの評価軸を3つの問いに凝縮すると、こうなります。第1に、モデルの重みを必ず入手する必要があるか? はいなら Kimi K3.1 Pro を直接選びましょう。第2に、主な負荷がターミナルCLIエージェントか? はいなら Kimi のほうが安定します。第3に、どちらでもない場合、Qwen4-Max は視覚、長タスクの納品、単価の面で優位です。
混在利用もよくある方法です。Kimi K3.1 Pro にターミナル実行を担当させ、Qwen シリーズで視覚理解とレポート納品を処理します。こうした編成では両モデルが同じインターフェースを経由する必要があり、統一ゲートウェイを使えばアダプティング作業をかなり省けます。
💡 選定のヒント:最終的にはタスクの分布次第です。APIYI apiyi.com 上で実際のタスクを使った比較を1ラウンド実施し、同じ base_url で双方の成功率と token 消費量を記録したうえで、メインモデルを決めることをおすすめします。
よくある質問 FAQ
Q1: Qwen4-Max と Kimi K3.1 Pro の最大の違いは何ですか?
Kimi K3.1 Pro は 3T クラスのオープンウェイトモデルで、自前でのデプロイとファインチューニングが可能です。Qwen4-Max はホステッド API として提供され、ネイティブな視覚機能を備え、表示価格も安くなっています。前者はターミナルタスクに強く、後者は視覚と長タスクの納品に強いです。
Q2: Kimi K3.1 Pro の Terminal-Bench は 65.7 なのか 67.2 なのか?
どちらも正しいですが、基準が異なります。65.7% は Moonshot の公式ドキュメントによるもので、67.2 は Qwen 公式が自社で報告した同一図での比較によるものです。差異は harness、effort、問題セットのバージョンに由来します。引用する際は必ず出典を明記し、混在させたり、異なるドキュメントをまたいでランキングをつなぎ合わせたりしてはいけません。
Q3: 両者のコンテキスト長は同じですか?
ほぼ同じです。Kimi K3.1 Pro は 1,048,576 token、Qwen4-Max は 1M です。Qwen4-Max は最大出力 393K と最大思考連鎖(CoT)262K も追加公開しており、単発の長い出力に有利です。
Q4: Qwen4-Max は単価が安いのに、arena 上の単タスクコストはむしろ高いのはなぜですか?
arena のスナップショットでは Qwen4-Max が xHigh ティアを使用しており、思考連鎖の token 消費が多く、単タスクコストは $4.18 です。一方 Kimi K3.1 Pro(Max)は $0.89 です。実際のコストは単価 × token 消費量で決まるため、`reasoning_effort` を下げてこそ単価の優位性を実現できます。
Q5: 現在、APIYI 経由で Qwen4-Max を呼び出せますか?
`qwen4-max` はまだ未上架で、できるだけ早く上架する予定です。現在は APIYI apiyi.com で `kimi-k3.1-pro`、`kimi-k3.1-pro-highspeed`、`qwen3.8-max` を呼び出せます。base_url は `https://api.apiyi.com/v1` で、モデルと価格はプラットフォームのモデル一覧を基準とします。
Q6: 両モデルそれぞれの既知の弱点は何ですか?
Qwen4-Max はターミナルタスクで明らかに劣っています(Alibaba の同一図では 48.5 対 67.2)。arena のランキングはまだ Preliminary で、デフォルトの高 effort 設定は単タスクコストを押し上げる可能性があります。Kimi K3.1 Pro は出力価格が Qwen4 の2倍超で、視覚、動画、および多くの業界納品指標で劣っています。
Qwen4-Max と Kimi K3.1 Pro の比較:主なポイント Key Takeaways
- 重みが公開されているかが明確な分かれ目:ファインチューニングやプライベートデプロイを行いたい場合、選択肢は Kimi K3.1 Pro のみです。
- ターミナルタスクは Kimi が強い:Alibaba の同一チャートでは、Kimi が Qwen4-Max を 18.7 点上回っています。
- スコアは評価条件に注意:65.7 と 67.2 は異なる harness によるもので、混同できません。
- タスク遂行と視覚分野は Qwen4 が優勢:JobBench、APEX-Agents、Video-Index など複数の項目でリードしています。
- 単価は Qwen4 が安い:出力価格は Kimi のわずか 45% ですが、effort の制御が必要です。
- 検証の始め方:APIYI で同じ Key を使い、
kimi-k3.1-proと Qwen シリーズを切り替えて比較できます。
まとめ
Qwen4-Max と Kimi K3.1 Pro の比較から得られる主な結論は次のとおりです。
- モデルを改変できるか:オープンウェイトは Kimi K3.1 Pro だけの強みです。
- ターミナルとタスク遂行:Kimi はコマンドライン agent に強く、Qwen4-Max は長タスクの遂行、視覚、動画に強いです。
- コスト:Qwen4-Max は 100 万 token あたり最も安価ですが、実際の請求額は effort による token 消費量に左右されます。
ベンチマークスコアは方向性を示すだけであり、最終的な答えは自分のタスクで導き出す必要があります。APIYI(apiyi.com)の統一インターフェースを使い、小規模なトラフィックで一度比較することをおすすめします。qwen4-max が提供開始された後も、モデルをシームレスに差し替えて検証を続けられます。
📚 参考資料
- Qwen4-Max 公式ブログ:モデル仕様、コンテキスト、QwenCloud の料金
- リンク:
qwen.ai/blog?id=qwen4-max -
内容: Qwen 公式が自ら公表した同一画像での比較データを収録
-
Kimi K3.1 Pro クイックスタート:Moonshot 公式ドキュメント
- リンク:
platform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart.md -
内容: Terminal-Bench 4.0 と Kimi Code Bench 3.0 の公式公表スコアを収録
-
Kimi 対話モデルの料金:Moonshot 公式価格ページ
- リンク:
platform.kimi.ai/docs/pricing/chat.md -
内容: 標準版、Highspeed 版、Batch の課金ルール
-
Arena Code Arena WebDev:公開ランキングのスナップショット、2026-11-14
- リンク:
arena.ai - 内容: 第三者による投票ランキングとタスクあたりのコスト
著者: APIYI 技術チーム
技術交流: APIYI のウェブサイトトップページからお気軽にお問い合わせください。詳しい資料は docs.apiyi.com のドキュメントセンターをご覧ください。