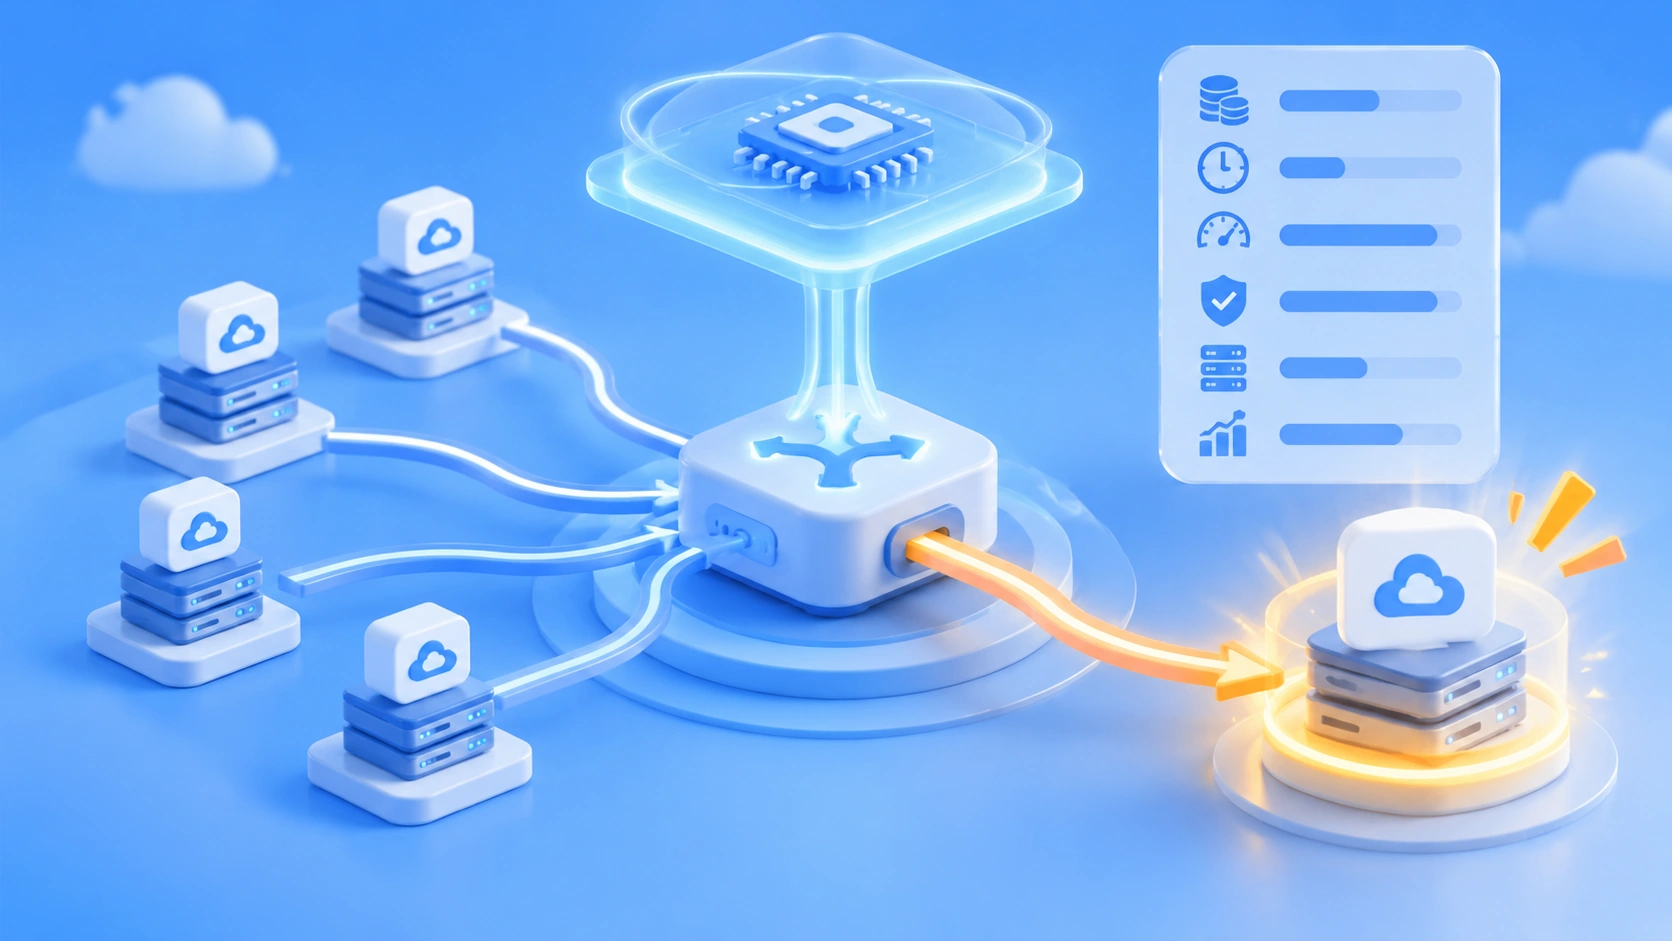
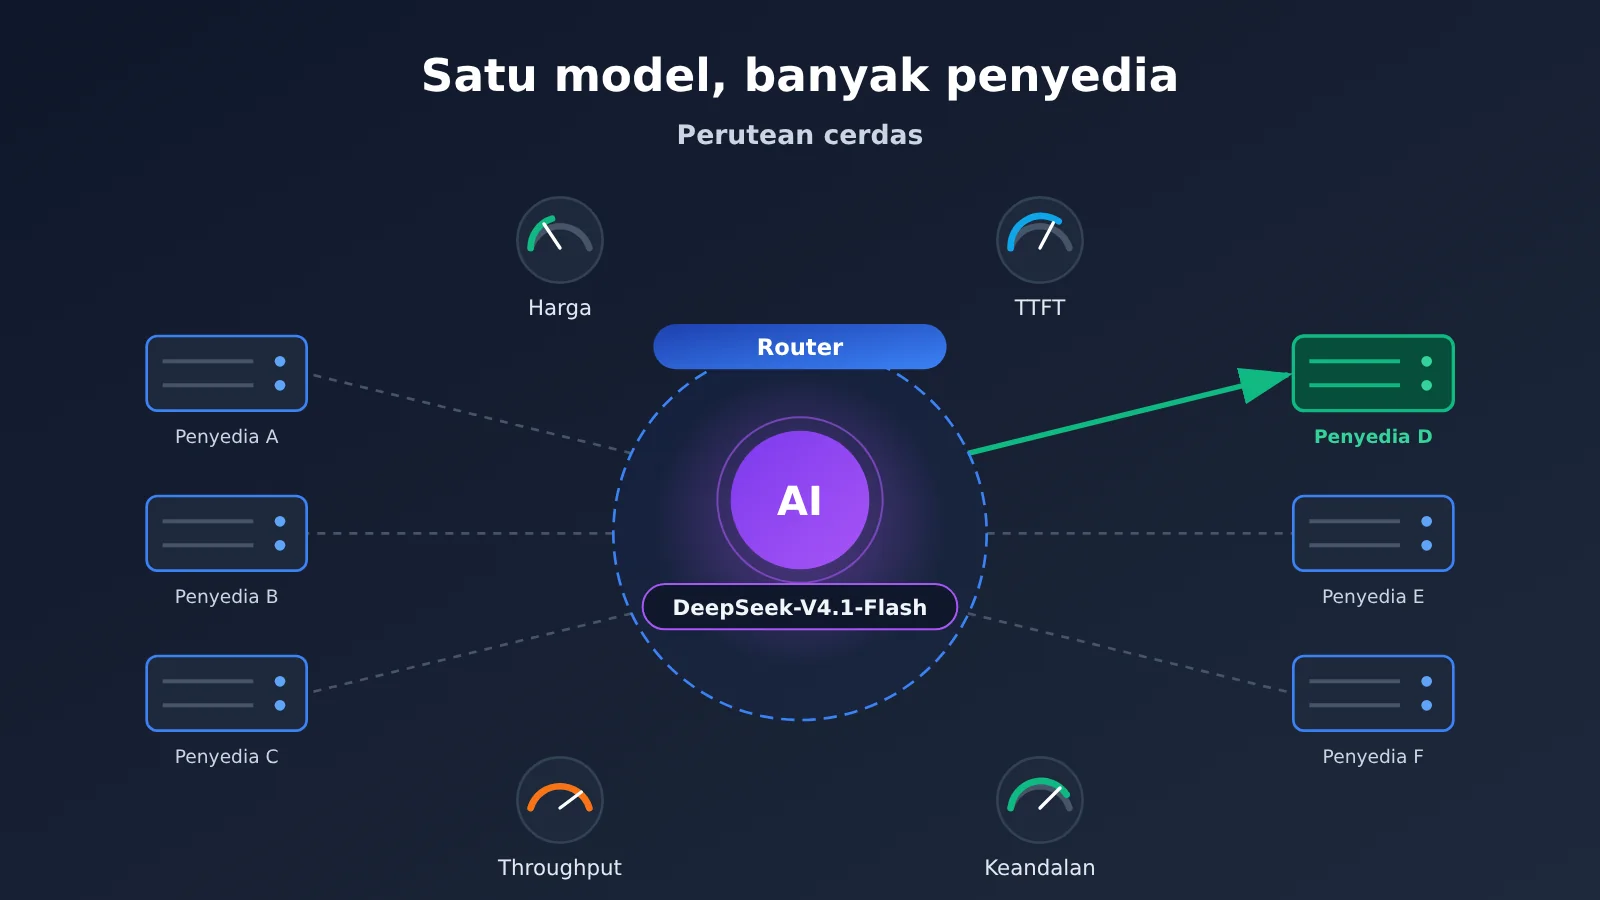
Jawaban langsung: Model open-weight yang sama dapat di-deploy oleh banyak penyedia inferensi, sehingga muncul puluhan penyedia API. OpenRouter tidak hanya melihat siapa yang memiliki harga terdaftar paling rendah, tetapi memilih penyedia berdasarkan biaya menyeluruh untuk satu respons yang benar-benar dapat digunakan. Ia mengevaluasi enam metrik sekaligus—harga efektif aktual, latensi Token pertama, throughput, batas laju, keandalan, dan kualitas respons—lalu menyerahkan permintaan kepada Provider yang paling sesuai saat itu; jika gagal, permintaan dialihkan ke Provider lain untuk dicoba lagi.
Hal ini menunjukkan bahwa kompetisi agregasi API AI telah bergeser dari sekadar “menyediakan antarmuka terpadu” menjadi “penjadwalan penyedia secara dinamis”. Pada 16 November 2026, Hugging Face mengumumkan menyerahkan routing model bahasa Inference Providers kepada OpenRouter. Kerja sama ini memberikan contoh konkret untuk memahami bagaimana metrik tersebut menjadi mekanisme otomatis pemilihan penyedia.
Apa yang bisa Anda pahami setelah membaca artikel ini?
- Mengapa model AI yang sama bisa memiliki banyak penyedia API, serta apa perbedaan antara pengembang model dan penyedia inferensi
- Metrik keputusan apa saja yang digunakan routing Provider, dan masalah apa yang dipecahkan oleh setiap metrik
- Sejauh mana failover dapat dilakukan, dan apa saja batasannya
- Cara membandingkan penyedia sendiri menggunakan metadata dari API katalog model Hugging Face
Indeks: Bagian fakta objektif disusun dengan urutan berikut: pertama menjelaskan asal-usul banyaknya penyedia API, lalu menguraikan objek keputusan routing cerdas dan 6 metrik, kemudian membahas alur dan batasan failover, dan terakhir mendemonstrasikan cara developer membandingkan Provider sendiri menggunakan API katalog. Di dalamnya akan diselingi data eksperimen routing dan perubahan penagihan yang dipublikasikan OpenRouter. Bagian analisis dan penilaian membahas arah kompetisi platform agregasi API berikutnya, serta bagaimana developer harus menentukan trade-off dan melakukan validasi dalam aplikasi.
Memahami konsep yang perlu diketahui seputar multi-penyedia API dan perutean Provider
| Konsep | Penjelasan singkat |
|---|---|
| Provider | Penyedia yang men-deploy model dan benar-benar menyediakan layanan inferensi, misalnya Together AI dan Novita |
| Router | Lapisan perutean yang menentukan tujuan permintaan berdasarkan kondisi permintaan dan status penyedia layanan yang tersedia |
| Model bobot terbuka | Model yang bobot pascapelatihannya dipublikasikan dan dapat di-deploy sendiri sesuai lisensinya |
| TTFT | Time to First Token, yaitu waktu tunggu sejak permintaan dikirim hingga Token pertama dikembalikan |
| Throughput | Jumlah Token yang dihasilkan per satuan waktu, biasanya diukur dalam tok/s |
| Failover | Beralih otomatis ke penyedia lain dan mencoba ulang saat penyedia saat ini gagal |
| Prompt Caching | Penyedia menyimpan cache input berulang untuk mengurangi beban komputasi dan waktu respons |
| BYOK | Bring Your Own Key, membawa kunci penyedia sendiri dan menggunakan kuota akun yang sesuai |
| P50 / P95 | Kuantil statistik; P50 adalah median, sedangkan P95 mencerminkan 5% permintaan yang lebih lambat |
Ringkasan cepat dampak perubahan perutean multi-penyedia API
- Pengembang: Kode dan Token di sisi Hugging Face secara prinsip tidak perlu diubah, tetapi penyedia layanan aktual akan ditentukan oleh perutean. ID model yang sama dapat mengarah ke Provider berbeda dalam permintaan yang berbeda. Aplikasi yang bergantung pada pemanggilan tool dan output terstruktur perlu menjalani pengujian regresi ulang. Pengembang yang sebelumnya mengonfigurasi kunci Provider model bahasa milik sendiri di Hugging Face tidak lagi dapat menggunakan jalur ini dan perlu memastikan ulang kunci serta atribusi penagihan.
- Tim pengadaan dan platform perusahaan: Penerimaan vendor, strategi pemulihan bencana, dan ketentuan pemrosesan data perlu dievaluasi ulang. Organisasi dapat menonaktifkan Provider tertentu, tetapi ini tidak berarti sudah mendapatkan jaminan residensi data atau kepatuhan yang lengkap; kebijakan data setiap penyedia tetap harus diperiksa satu per satu.
Model AI yang sama, banyak penyedia layanan API: fakta objektif
Mengapa model yang sama bisa memiliki banyak penyedia API
Pengembang model dan penyedia layanan inferensi adalah dua peran yang berbeda. Pengembang bertugas melatih model dan merilis bobotnya. Untuk model dengan bobot terbuka, siapa pun yang memiliki daya komputasi dan memenuhi syarat lisensi dapat men-deploy bobot tersebut ke cluster GPU miliknya sendiri dan menyediakan API ke publik. Karena itu, model seperti DeepSeek, Qwen, dan GLM sering kali berjalan di beberapa infrastruktur inferensi sekaligus.
Ambil contoh deepseek-ai/DeepSeek-V4.1-Flash. Pengembang meminta nama model yang sama, tetapi inferensi yang sebenarnya dijalankan bisa saja dilakukan oleh Together AI, Novita, atau penyedia lain yang mendukung model tersebut. Hardware, skala cluster, metode penjadwalan, dan strategi harga yang digunakan masing-masing penyedia berbeda-beda, sehingga harga, kecepatan, dan kapasitas yang dapat ditangani untuk model yang sama juga berbeda. Ada yang menawarkan harga lebih rendah tetapi mudah terkena pembatasan laju pada jam sibuk, ada yang mengembalikan Token pertama dengan cepat, ada yang mendukung konteks lebih panjang, dan ada pula yang dukungan format pemanggilan alatnya lebih lengkap.
Data skala dapat menunjukkan betapa terfragmentasinya pasar ini. Dalam pengumuman kerja samanya, OpenRouter mengungkapkan bahwa platform mereka secara keseluruhan mendukung lebih dari 600 model, terhubung dengan lebih dari 80 penyedia, memproses lebih dari 800 triliun Token per bulan, dan melayani lebih dari 10 juta pengguna. Ini adalah data seluruh platform OpenRouter, bukan skala yang dihasilkan oleh kerja sama ini saja. Halaman Provider Hugging Face juga mencantumkan lebih dari sepuluh penyedia layanan seperti Baseten, Cerebras, DeepInfra, Fireworks, Nebius, Novita, dan Together AI, tetapi penyedia yang tersedia untuk setiap model berbeda-beda.
Satu model memiliki banyak penyedia, dan kondisi masing-masing penyedia berubah secara real-time. “Permintaan ini harus diserahkan kepada siapa” pun menjadi masalah yang perlu diputuskan terus-menerus. Dari sinilah perutean multi-penyedia muncul.
Apa sebenarnya yang diputuskan oleh perutean cerdas
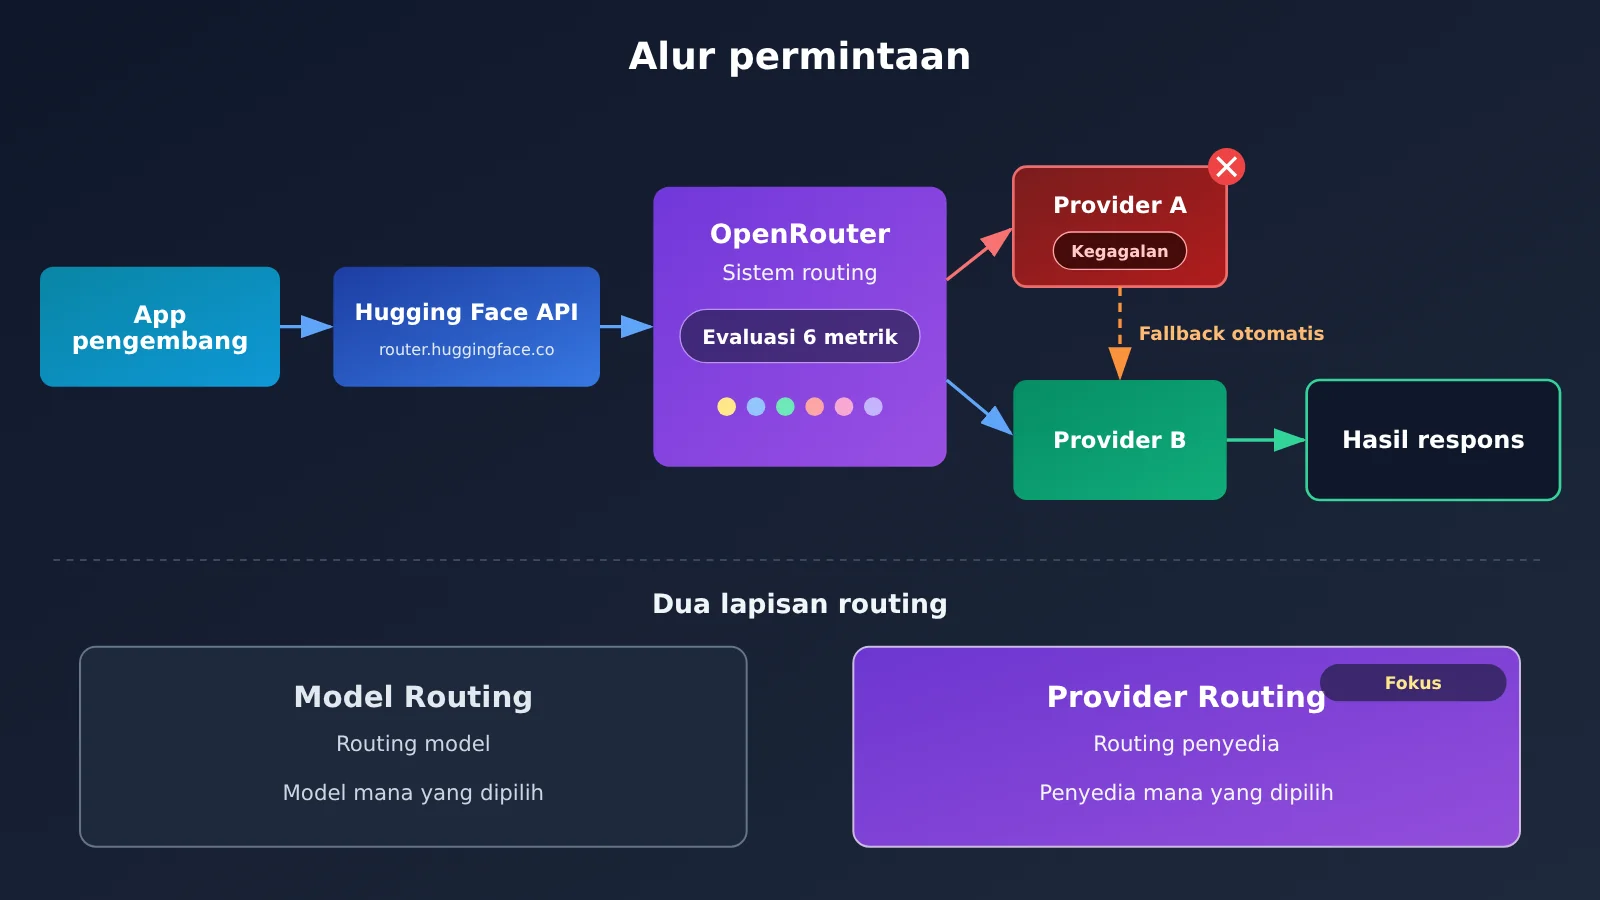
Pertama-tama, kita perlu membedakan dua konsep yang mudah tertukar. Model Routing (Perutean Model) memutuskan model mana yang menjawab — misalnya pertanyaan sederhana diserahkan ke model kecil, sedangkan pertanyaan kompleks ke model besar. Provider Routing (Perutean Penyedia) adalah, dengan model yang sudah ditentukan, memutuskan penyedia mana yang mengeksekusi inferensi. OpenRouter dan Hugging Face yang dibahas dalam artikel ini termasuk kategori kedua: model ditentukan oleh developer, lapisan perutean hanya memilih penyedia, dan tidak akan mengganti model untuk Anda.
Setelah kerja sama ini, rantai satu permintaan model bahasa adalah: aplikasi developer atau Coding Agent → Hugging Face API (router.huggingface.co) → sistem perutean OpenRouter → inferensi di salah satu Provider → mengembalikan hasil. OpenRouter di sini bertanggung jawab atas perutean permintaan dan pemilihan penyedia, dan tidak mengeksekusi inferensi semua model. Pengguna tetap menggunakan Token Hugging Face, dan menyelesaikan pembayaran melalui akun Hugging Face atau akun organisasi. Hugging Face menyatakan tidak menambahkan biaya ekstra di atas harga inferensi Provider.
Dalam hal cara kontrol, Hugging Face menyediakan tiga tingkatan:
- Perutean otomatis default: klien resmi menggunakan
provider="auto", sistem memilih penyedia berdasarkan kombinasi harga, kecepatan, dan keandalan. - Menentukan Provider: misalnya
provider="together", atau menambahkan sufiks:novitasetelah ID model, sehingga permintaan tetap diserahkan ke penyedia tersebut. - Perutean strategi: antarmuka kompatibel OpenAI mendukung sufiks
:cheapest(prioritas harga) dan:fastest(prioritas throughput).
Perlu diperhatikan, :fastest mengoptimalkan throughput, bukan “cepat” dalam semua pengertian. TTFT, kecepatan generasi, dan waktu permintaan penuh adalah tiga metrik yang berbeda. Untuk balasan pendek yang hanya mengeluarkan satu dua kalimat, latensi Token pertama sering kali lebih memengaruhi pengalaman daripada throughput.
| Item perbandingan | Perutean Hugging Face lama | Perutean OpenRouter baru |
|---|---|---|
| Sistem perutean | Router buatan Hugging Face sendiri | OpenRouter |
| Pemilihan Provider | Mekanisme pemilihan yang sudah ada | Evaluasi komprehensif real-time |
| Dasar harga | Strategi harga yang sudah ada | Harga efektif aktual |
| Faktor kecepatan | Mekanisme performa yang sudah ada | Memasukkan TTFT dan throughput |
| Kegagalan tunggal | Mungkin langsung mengembalikan error | Dapat mencoba ulang Provider lain dalam permintaan yang sama |
| Cache sesi | Strategi yang sudah ada | Mendukung mempertahankan Provider per sesi |
| Kredensial pengguna | Token Hugging Face | Tetap menggunakan Token Hugging Face |
Indikator apa saja yang perlu diperhatikan dalam sistem routing multi-penyedia yang layak
OpenRouter mengumumkan algoritma Provider Routing generasi baru pada 28 Oktober 2026. Routing default yang lama cenderung bergantung pada harga input Token, sehingga penyedia berharga murah lebih mudah mendapatkan lebih banyak trafik. Algoritma baru menggabungkan 6 jenis sinyal berikut menjadi satu Routing Cost real-time, dengan tujuan mengoptimalkan biaya komprehensif dari “respons yang berhasil dan dapat digunakan dalam sekali jalan”, bukan sekadar mengejar harga satuan terendah.
① Effective Price (harga efektif sebenarnya) menyelesaikan masalah “harga yang tertera murah belum tentu tagihannya murah”. Metrik ini menggabungkan tiga jenis harga satuan — input tanpa cache, input dengan cache, dan output — lalu menghitungnya berdasarkan proporsi input-output dari permintaan aktual dan tingkat cache hit penyedia tersebut. Contoh yang diberikan OpenRouter: 40.000 Token input tanpa cache ($2/M) sebesar $0.080, 60.000 Token input dengan cache ($0.50/M) sebesar $0.030, 4.000 Token output ($8/M) sebesar $0.032, totalnya $0.142. Dalam skenario Agent, proporsi input dengan cache seringkali sangat tinggi, sehingga hanya membandingkan harga tertera input bisa membuat kita salah memilih penyedia.
② TTFT (latensi Token pertama) menyelesaikan masalah “berapa lama pengguna harus menunggu sampai melihat respons”. Antarmuka chat dan pemanggilan tool multi-putaran pada Agent paling sensitif terhadapnya, karena setiap putaran harus menunggu Token pertama terlebih dahulu.
③ Throughput (kemampuan pemrosesan) mengukur kecepatan setelah proses generasi dimulai. Algoritma baru melihat throughput generasi selama keseluruhan proses respons, bukan hanya puncak sesaat. Tugas dengan volume output besar seperti generasi teks panjang dan penyelesaian kode terutama dipengaruhi olehnya.
④ Rate Limits (batas laju) terutama berfokus pada error HTTP 429, menyelesaikan masalah “kapasitas penyedia tidak mencukupi”. Jika suatu Provider sering mengembalikan 429, itu menandakan daya komputasinya sedang ketat, dan routing akan mengurangi trafik yang dialokasikan kepadanya.
⑤ Reliability (keandalan) mengukur frekuensi kegagalan permintaan. Jika tingkat error suatu penyedia jelas lebih tinggi dibandingkan penyedia lain untuk model yang sama, sistem akan mengurangi pembagian trafik, dan bila perlu menjeda trafik hingga pulih.
⑥ Quality (kualitas respons) menyelesaikan masalah “model yang sama, performa deployment-nya berbeda-beda”. Berdasarkan penjelasan publik saat ini, sinyal kualitas terutama berkaitan dengan apakah pemanggilan tool dapat mengembalikan hasil dengan benar dan apakah strukturnya sesuai persyaratan. Penyedia yang format pemanggilan tool-nya abnormal atau akurasi benchmark-nya jelas tertinggal akan diturunkan daya saingnya.
Selain 6 indikator tersebut, dokumentasi routing OpenRouter sendiri juga memasukkan kebijakan data sebagai syarat batasan. Misalnya, data_collection: "deny" dapat mengecualikan Provider yang tidak memenuhi persyaratan pengumpulan data, sedangkan zdr: true mewajibkan penggunaan endpoint tanpa penyimpanan data (zero data retention). Dokumentasi keamanan Hugging Face menjelaskan bahwa mereka tidak menggunakan data permintaan pengguna untuk melatih model, tidak menyimpan isi permintaan dan respons saat routing, serta log debugging disimpan maksimal 30 hari dan tidak berisi data pengguna atau Token. Namun mereka juga mengingatkan pengembang bahwa tetap perlu memeriksa kebijakan keamanan data dari Provider yang sebenarnya. Komitmen platform tidak bisa menggantikan perjanjian pemrosesan data masing-masing penyedia.
Data Eksperimen Routing OpenRouter dan Trade-off-nya
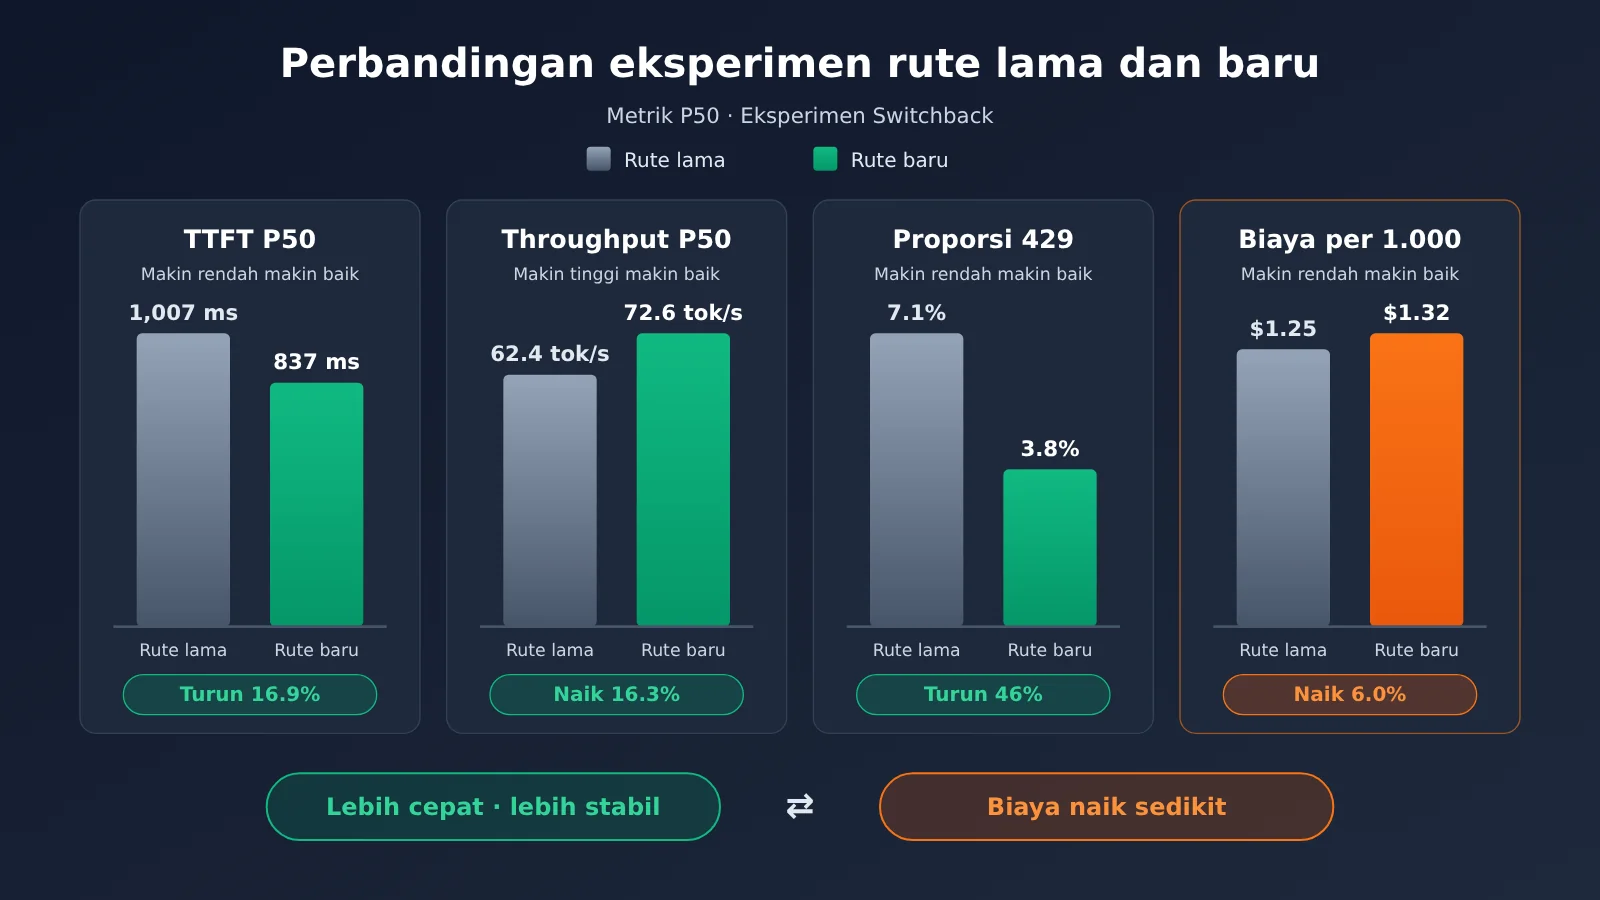
Sebelum algoritma baru diluncurkan, OpenRouter menjalankan eksperimen Switchback bergantian selama satu minggu pada Oktober 2026. Setiap hari dibagi menjadi blok-blok berdurasi 3 jam, dan blok-blok yang cocok dipasangkan untuk menggunakan algoritma lama dan baru secara bergantian; setelah setiap pergantian disisakan periode pemanasan 1 jam yang tidak dihitung dalam pengukuran. Totalnya mencakup lebih dari 24 juta permintaan dan 103 miliar Token input. Eksperimen bergantian dipilih alih-alih pengelompokan acak pengguna karena algoritma baru memindahkan trafik menjauh dari Provider yang kelebihan beban, sehingga kelompok algoritma lama juga ikut diuntungkan—hal ini akan mengganggu perbandingan.
| Metrik | Routing Lama | Routing Baru | Perubahan |
|---|---|---|---|
| TTFT P50 | 1.007 ms | 837 ms | Turun 16,9% |
| TTFT P95 | 4.601 ms | 3.733 ms | Turun 18,9% |
| Throughput P50 | 62,4 tok/s | 72,6 tok/s | Naik 16,3% |
| Waktu permintaan lengkap P50 | 4,00 s | 3,24 s | Turun 19,0% |
| Permintaan dengan setidaknya satu 429 | 7,1% | 3,8% | Turun 46% |
| Permintaan yang perlu diulang | 10,4% | 6,9% | Turun 34% |
| Biaya per seribu permintaan | $1,25 | $1,32 | Naik 6,0% |
| Biaya per juta Token | $0,301 | $0,324 | Naik 7,3% |
Data ini mencerminkan trade-off inti dari routing baru: dengan kenaikan biaya sekitar 6% per seribu permintaan, kita mendapatkan latensi yang lebih rendah dan error kapasitas yang lebih sedikit. Ada beberapa keterbatasan yang perlu dijelaskan: eksperimen ini dirancang dan dipublikasikan sendiri oleh OpenRouter, tanpa audit pihak ketiga; sampelnya adalah sekumpulan model terbuka yang representatif, bukan mewakili semua model dan penyedia layanan; hasilnya merupakan statistik agregat, bukan berarti setiap permintaan bisa memperoleh perbaikan 16,9%. Data ini juga berasal dari eksperimen OpenRouter sebelum kerja sama, bukan pengukuran independen setelah Hugging Face diluncurkan.
💡 Saran pengujian: Eksperimen routing memberikan statistik agregat; performa bisnis Anda sendiri tetap harus diukur sendiri. Jika Anda perlu membandingkan kualitas output dan biaya beberapa model utama secara berdampingan dalam satu basis kode yang sama, Anda bisa menggunakan APIYI apiyi.com untuk memanggil semuanya secara terpadu dengan satu Key. Tentukan dulu pilihan di tingkat model, baru kemudian pertimbangkan optimasi di tingkat penyedia layanan.
Bagaimana sistem beralih saat Provider mengalami gangguan
Alur khas Failover otomatis adalah: router memilih Provider A; jika A normal, hasil langsung dikembalikan; jika A error atau mengalami masalah kapasitas, sistem mencoba Provider B dalam permintaan yang sama; jika B berhasil, hasil dikembalikan. Dalam eksperimen, “permintaan yang perlu dicoba ulang” turun dari 10.4% menjadi 6.9%, dan waktu yang dihabiskan setiap permintaan untuk percobaan gagal turun dari 349 ms menjadi 242 ms. Ini menunjukkan bahwa routing yang baik tidak hanya harus bisa mencoba ulang, tetapi juga berusaha menghindari penyedia dengan status buruk sejak awal.
Fallback otomatis dan penetapan Provider adalah dua pilihan yang saling membatasi. Routing default mengizinkan peralihan, sehingga ketersediaannya lebih tinggi. Menetapkan Provider berarti mengunci permintaan ke satu penyedia, memenuhi persyaratan akses penyedia, tetapi kehilangan ruang untuk toleransi bencana. API OpenRouter sendiri menyediakan kombinasi only (hanya mengizinkan Provider tertentu) dengan allow_fallbacks: false (tanpa fallback otomatis), yang membuat permintaan langsung gagal ketika tidak ada penyedia yang patuh, alih-alih dialihkan ke penyedia lain. Yang perlu dibedakan, ini adalah parameter API lengkap OpenRouter, dan tidak bisa dipahami bahwa antarmuka Hugging Face sudah sepenuhnya terbuka. Kemampuan yang setara di sisi Hugging Face adalah menetapkan Provider dan menonaktifkan Provider di pengaturan.
Percobaan ulang juga punya biaya, dan tidak tak terbatas:
- Biaya waktu: Setiap percobaan gagal akan memperpanjang total waktu, yang berdampak jelas pada interaksi waktu nyata.
- Output streaming: Respons streaming yang sudah mulai mengeluarkan output tidak dapat disambung secara mulus ke penyedia lain.
- Efek samping berulang: Jika pemanggilan tool sudah memicu aksi eksternal pada percobaan pertama, percobaan ulang dapat menyebabkan eksekusi ganda, sehingga aplikasi perlu menangani idempotensi sendiri.
- Kehilangan cache: Prompt Caching biasanya terikat pada penyedia tertentu, dan beralih penyedia dapat menghilangkan manfaat cache. Hugging Face menyediakan header permintaan
X-HF-Session-Iduntuk ini, menggunakan UUID yang stabil agar sesi yang sama sebisa mungkin tetap berada di Provider yang memegang cache. - Tidak ada penyedia yang tersedia: Jika suatu model hanya punya satu Provider, atau Provider lain tidak mendukung parameter saat ini, maka tidak ada objek untuk dialihkan. Masalah seperti kuota tidak cukup, izin Token tidak memadai, permintaan tidak valid, dan konteks melebihi batas juga tidak bisa diselesaikan oleh routing.
Perubahan Penagihan Hugging Face dan Kunci API Milik Sendiri
Kerja sama ini membawa perubahan yang merusak kompatibilitas: saat memanggil model bahasa melalui Hugging Face, Anda tidak lagi dapat menggunakan kunci API Provider yang dikonfigurasi sendiri. Semua permintaan terkait dirutekan melalui OpenRouter, dan biayanya dibebankan ke akun Hugging Face atau akun organisasi. Kunci sendiri untuk tugas pembuatan gambar dan video masih dapat digunakan; detailnya mengikuti penjelasan resmi.
Jika pengembang ingin terus menggunakan kuota penyedia layanan yang mereka beli sendiri, mereka dapat langsung memanggil API penyedia tersebut, atau beralih ke akun OpenRouter milik mereka sendiri. Menurut ketentuan dokumentasi BYOK OpenRouter saat ini: kuota gratis BYOK dihitung berdasarkan biaya katalog inferensi ekuivalen; akun Pay-as-you-go mendapat 25,000 dolar AS per bulan; Enterprise mendapat kuota khusus; kelebihan pemakaian ditagih 5% dari biaya inferensi ekuivalen dan dipotong dari Credits platform. Angka 25,000 di sini adalah biaya inferensi yang diukur dalam dolar AS, bukan jumlah permintaan. Selain itu, fallback ke kapasitas bersama dapat memakai Credits platform. Mengintegrasikan langsung OpenRouter merupakan hubungan akun dan penagihan yang terpisah; kunci lama tidak akan otomatis dipindahkan ke sana.
Dalam dokumentasi harga Hugging Face saat ini, pengguna Free tidak memiliki kuota bulanan tetap, pengguna PRO mendapat $2 per bulan, sedangkan Team dan Enterprise mendapat $2 per kursi per bulan. Kuota ini adalah Compute Credits umum yang dapat dipakai untuk Inference Providers, Inference Endpoints, Spaces, dan layanan lainnya. Satu hal lagi yang perlu diperhatikan: mekanisme harga Provider tidak berubah bukan berarti biaya setiap permintaan tidak berubah, karena perutean dapat memilih penyedia yang sedikit lebih mahal tetapi lebih cepat dan lebih stabil.
Cara Developer Membandingkan Beberapa Penyedia Layanan Sendiri dengan API Direktori
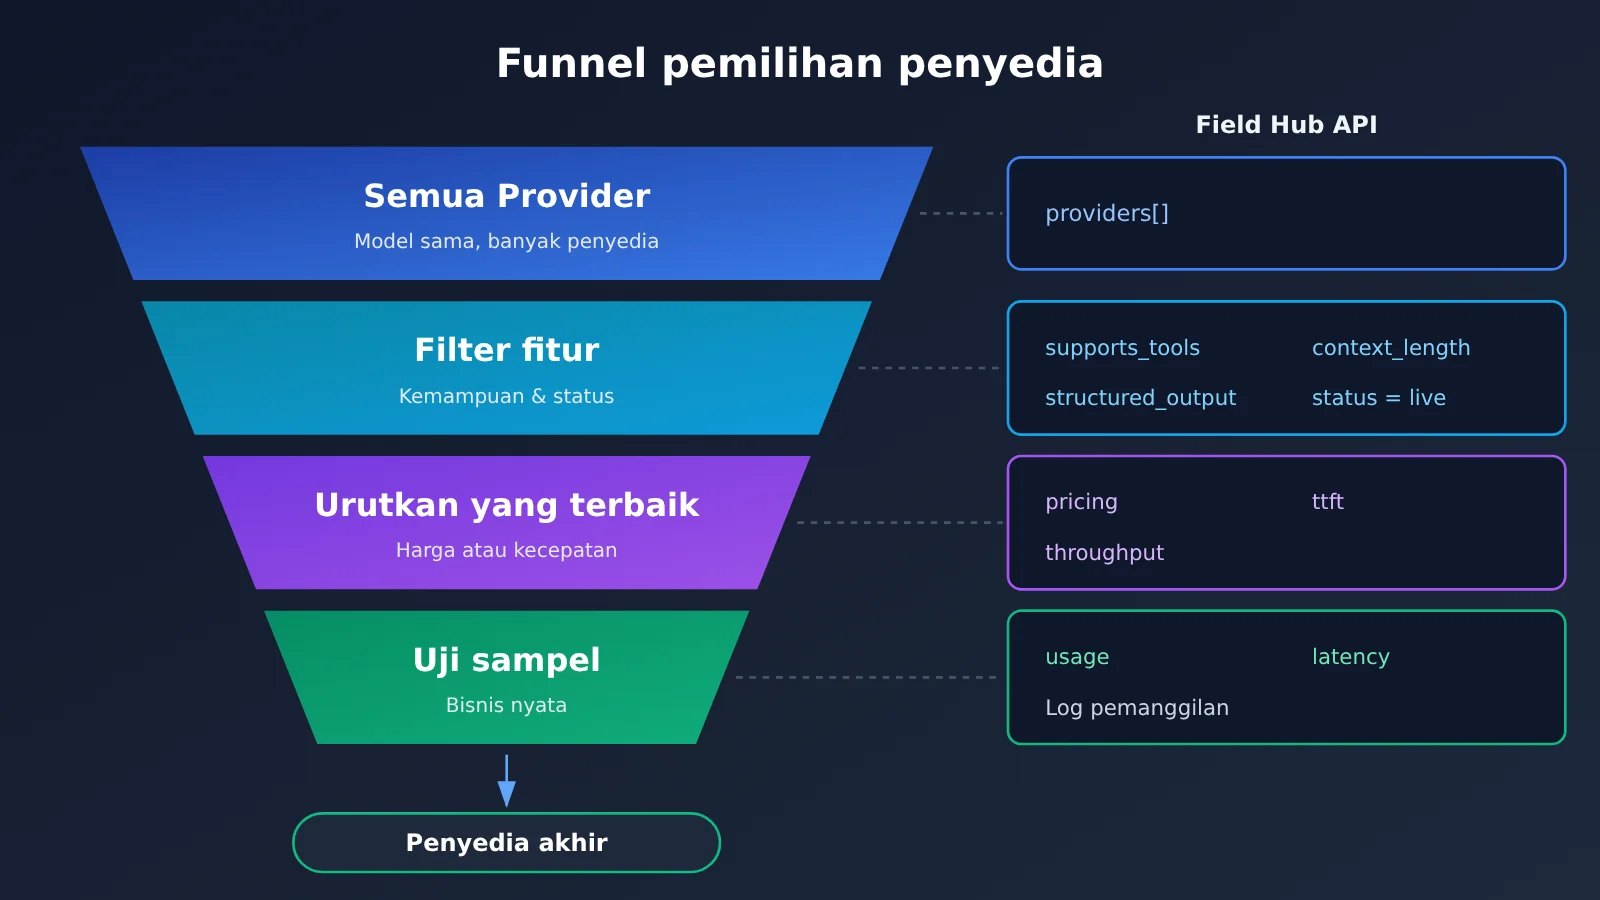
Hugging Face menyediakan antarmuka direktori model yang dapat dikueri, dan ini adalah jendela publik bagi sistem routing untuk memperoleh dasar keputusan:
- Semua model:
GET https://router.huggingface.co/v1/models - Model tunggal:
GET https://router.huggingface.co/v1/models/deepseek-ai/DeepSeek-V4-Pro
| Field | Arti | Peran dalam pemilihan model |
|---|---|---|
| provider | Penyedia layanan yang benar-benar menyediakan inferensi | Menentukan daftar kandidat |
| status | Status saat ini, seperti live, error | Menyingkirkan penyedia yang tidak tersedia |
| context_length | Panjang konteks yang didukung penyedia tersebut | Menyaring kebutuhan konteks panjang |
| pricing.input / pricing.output | Harga dolar per satu juta Token input, output | Pengurutan biaya |
| supports_tools | Apakah mendukung pemanggilan tool | Syarat wajib untuk skenario Agent |
| supports_structured_output | Apakah mendukung output terstruktur | Syarat wajib untuk output JSON |
| first_token_latency_ms | Latensi Token pertama dari probe verifikasi terakhir | Pengurutan untuk tipe interaktif |
| throughput | Kecepatan generasi dari probe verifikasi terakhir | Pengurutan untuk tipe output panjang |
| is_free / is_model_author | Aktivitas gratis sementara / apakah merupakan penerbit model | Referensi tambahan |
Field-field ini tidak selalu tersedia lengkap untuk setiap Provider, dan data performa juga berasal dari probe verifikasi terakhir, tidak sama dengan performa real-time end-to-end Anda sendiri. Pendekatan yang wajar adalah “saring dulu, baru urutkan”: pertama saring penyedia yang tidak kompatibel dengan field fungsional, lalu urutkan berdasarkan biaya atau kecepatan. Contoh di bawah ini mendemonstrasikan logika tersebut, untuk struktur respons silakan mengacu pada dokumentasi resmi Hub API:
import os
import requests

HF_TOKEN = os.environ["HF_TOKEN"]
MODEL = "deepseek-ai/DeepSeek-V4.1-Flash"

resp = requests.get(
    f"https://router.huggingface.co/v1/models/{MODEL}",
    headers={"Authorization": f"Bearer {HF_TOKEN}"},
    timeout=30,
)
data = resp.json()
providers = data.get("providers", [])  # Struktur spesifik mengacu pada dokumentasi resmi

# Langkah pertama: penyaringan fungsional (Agent membutuhkan pemanggilan tool + output terstruktur + konteks 64K)
candidates = [
    p for p in providers
    if p.get("status") == "live"
    and p.get("supports_tools")
    and p.get("supports_structured_output")
    and (p.get("context_length") or 0) >= 64_000
]

# Langkah kedua: urutkan berdasarkan harga satuan output, field yang hilang diletakkan di akhir
candidates.sort(key=lambda p: (p.get("pricing") or {}).get("output", float("inf")))

for p in candidates:
    print(p["provider"], p.get("pricing"), p.get("first_token_latency_ms"), p.get("throughput"))
Setelah menyaring kandidat, wajib diuji lagi dengan permintaan bisnis nyata. Metadata direktori menjelaskan “apa yang diklaim didukung” oleh penyedia, tidak dapat menggantikan akurasi, tingkat keberhasilan pemanggilan tool, dan tingkat penyelesaian akhir pada tugas Anda sendiri.
Sebelum menyetel detail di tingkat penyedia, biasanya perlu menentukan model mana yang akan dipakai terlebih dahulu. Kode berikut mendemonstrasikan perbandingan batch jawaban dari beberapa model menggunakan antarmuka yang sama yang kompatibel dengan OpenAI, ganti ID model dengan nama sebenarnya dari daftar model platform:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka terpadu APIYI, satu Key untuk memanggil banyak model
)

prompt = "用 JSON 返回:{\"city\": 城市名, \"reason\": 一句话理由},推荐一个适合冬季旅行的城市"

for model in ["model-id-a", "model-id-b", "model-id-c"]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, resp.usage.total_tokens, resp.choices[0].message.content)
🚀 Mulai cepat: Pengguna baru dapat mengambil kuota uji gratis di APIYI apiyi.com, dan menjalankan kode di atas dengan satu set sampel bisnis Anda sendiri. Log pemanggilan di backend akan mencatat model, konsumsi Token, dan biaya setiap permintaan, sehingga memudahkan menghitung biaya per tugas yang sebenarnya, bukan hanya melihat harga yang tertera.
Perlu dijelaskan bahwa akses terpadu plus log pemanggilan, serta data performa real-time tingkat Provider yang ditampilkan Hugging Face, merupakan fungsi pada tingkat yang berbeda: yang pertama menyelesaikan soal “bisa terhubung, bisa dihitung dengan jelas”, sedangkan yang kedua lebih jauh menampilkan status dinamis penyedia layanan di lapisan bawah. Keduanya bisa dipakai bersamaan.
Multi Penyedia Layanan API dan Routing Cerdas: Analisis dan Pertimbangan
Di Mana Persaingan Berikutnya Platform Agregasi API
Kalau kemampuan OpenRouter dibongkar, ada tiga lapisan: agregasi model menjawab “bagaimana mengakses model yang berbeda”, agregasi Provider menjawab “model yang sama dijalankan oleh siapa”, dan routing dinamis menjawab “permintaan kali ini harus diserahkan ke siapa”. Antarmuka terpadu pada dasarnya sudah menyelesaikan masalah akses, dan kolaborasi ini menunjukkan bahwa lapisan kedua dan ketiga sedang menjadi titik persaingan baru. Dasar penilaian ini adalah: Hugging Face memilih melepaskan router yang dibangun sendiri dan beralih ke kemampuan routing eksternal; OpenRouter juga mempublikasikan algoritma routingnya secara terpisah, sekaligus membuktikan nilainya lewat eksperimen produksi.
Bisa diperkirakan bahwa optimasi biaya, stabilitas, dan tata kelola data akan menjadi dimensi perbandingan baru bagi platform API. Berikut ini prediksi yang masih menunggu verifikasi: transparansi routing akan semakin penting — pengembang ingin tahu permintaan mereka mendarat di penyedia layanan mana, kenapa dipilih, dan berapa yang dibayar; batasan kebijakan data mungkin berubah dari opsi tambahan menjadi syarat ambang batas dalam pengadaan perusahaan.
Namun, routing bukan obat mujarab. Data eksperimen menunjukkan bahwa lebih cepat dan lebih stabil ada harganya: biaya per unit lebih tinggi. Rencana lanjutan dalam pengumuman kolaborasi (misalnya menghubungkan akun kedua pihak, memasukkan lebih banyak tugas ke routing OpenRouter) juga masih sekadar rencana. Routing juga tidak bisa menyelesaikan masalah kualitas, lisensi, dan kecocokan bisnis dari model itu sendiri.
Permintaan Model Berbobot Terbuka dan Tekanan Biaya Perusahaan
Data dari sisi permintaan mendukung penilaian bahwa “penjadwalan penyedia layanan menjadi semakin penting”. Statistik OpenRouter menunjukkan bahwa, jika dihitung berdasarkan volume Token mingguan dari 50 model teratas, pangsa model berbobot terbuka mencapai 71,7% pada 28 September 2026. Ini adalah cakupan statistik di dalam platform OpenRouter saja dan tidak bisa digeneralisasi menjadi pangsa pasar global. Semakin besar penggunaan model berbobot terbuka, semakin umum situasi di mana satu model yang sama tersedia di banyak penyedia layanan, dan semakin jelas pula nilai dari routing.
Dari sisi biaya, Capgemini pada September 2026 mensurvei 500 CXO perusahaan besar; 59% menyatakan pengeluaran AI mereka jelas melebihi ekspektasi; di antara perusahaan yang terdampak, rata-rata pembengkakan mencapai 24%. Data ini hanya mewakili sampel survei tersebut, tetapi jika disandingkan dengan temuan eksperimen routing bahwa “peningkatan kecepatan disertai kenaikan biaya”, data ini mengingatkan perusahaan: routing otomatis secara default mengejar pengalaman menyeluruh, bukan tagihan terendah. Untuk bisnis yang sensitif terhadap biaya, sebaiknya secara aktif memilih strategi mengutamakan harga atau menetapkan batas atas harga, serta terus memverifikasi dengan log pemanggilan.
Bagaimana Berbagai Peran Seharusnya Memilih
- Pengembang individu dan tim kecil: Routing otomatis default sudah bisa menghilangkan pekerjaan membangun sendiri mekanisme toleransi bencana; fokusnya adalah memverifikasi dengan sampel nyata apakah pemanggilan tool dan output JSON stabil. Menentukan model lebih dulu melalui antarmuka terpadu seperti APIYI apiyi.com, lalu mengoptimalkan di level penyedia layanan sesuai kebutuhan, adalah jalur dengan investasi yang relatif rendah.
- Produk interaktif: Prioritaskan perhatian pada TTFT P95, bukan throughput.
:fastestbelum tentu bisa memperbaiki pengalaman pada balasan pendek. - Tugas output panjang dan pemrosesan batch: Throughput dan harga efektif lebih krusial; pertimbangkan strategi mengutamakan harga, dan manfaatkan kelekatan sesi (session stickiness) untuk menjaga keuntungan cache.
- Tim perusahaan dan platform: Petakan lebih dulu aplikasi mana yang bergantung pada Provider Key milik sendiri dan bisnis mana yang harus memakai penyedia tetap, lalu putuskan apakah akan mengizinkan fallback, membatasi penyedia, atau terhubung langsung ke penyedia. Perjanjian pemrosesan data harus diverifikasi satu per satu.
Apa pun strategi yang dipilih, pada akhirnya semuanya bermuara pada satu tindakan yang sama: jalankan satu putaran uji dengan permintaan Anda sendiri dan metrik Anda sendiri. Melakukan perbandingan skala kecil di APIYI apiyi.com dengan kuota gratis, atau menyaring penyedia kandidat terlebih dahulu menggunakan API katalog Hugging Face, keduanya merupakan titik awal dengan biaya sangat rendah. Angka 16,9% dari eksperimen resmi adalah rata-rata keseluruhan; berapa banyak yang bisa bisnis Anda dapatkan, hanya bisa diketahui setelah diuji.
The proof of the pudding is in the eating.(Apakah pudingnya enak baru diketahui setelah dimakan; hasil nyata harus dibuktikan melalui praktik.)