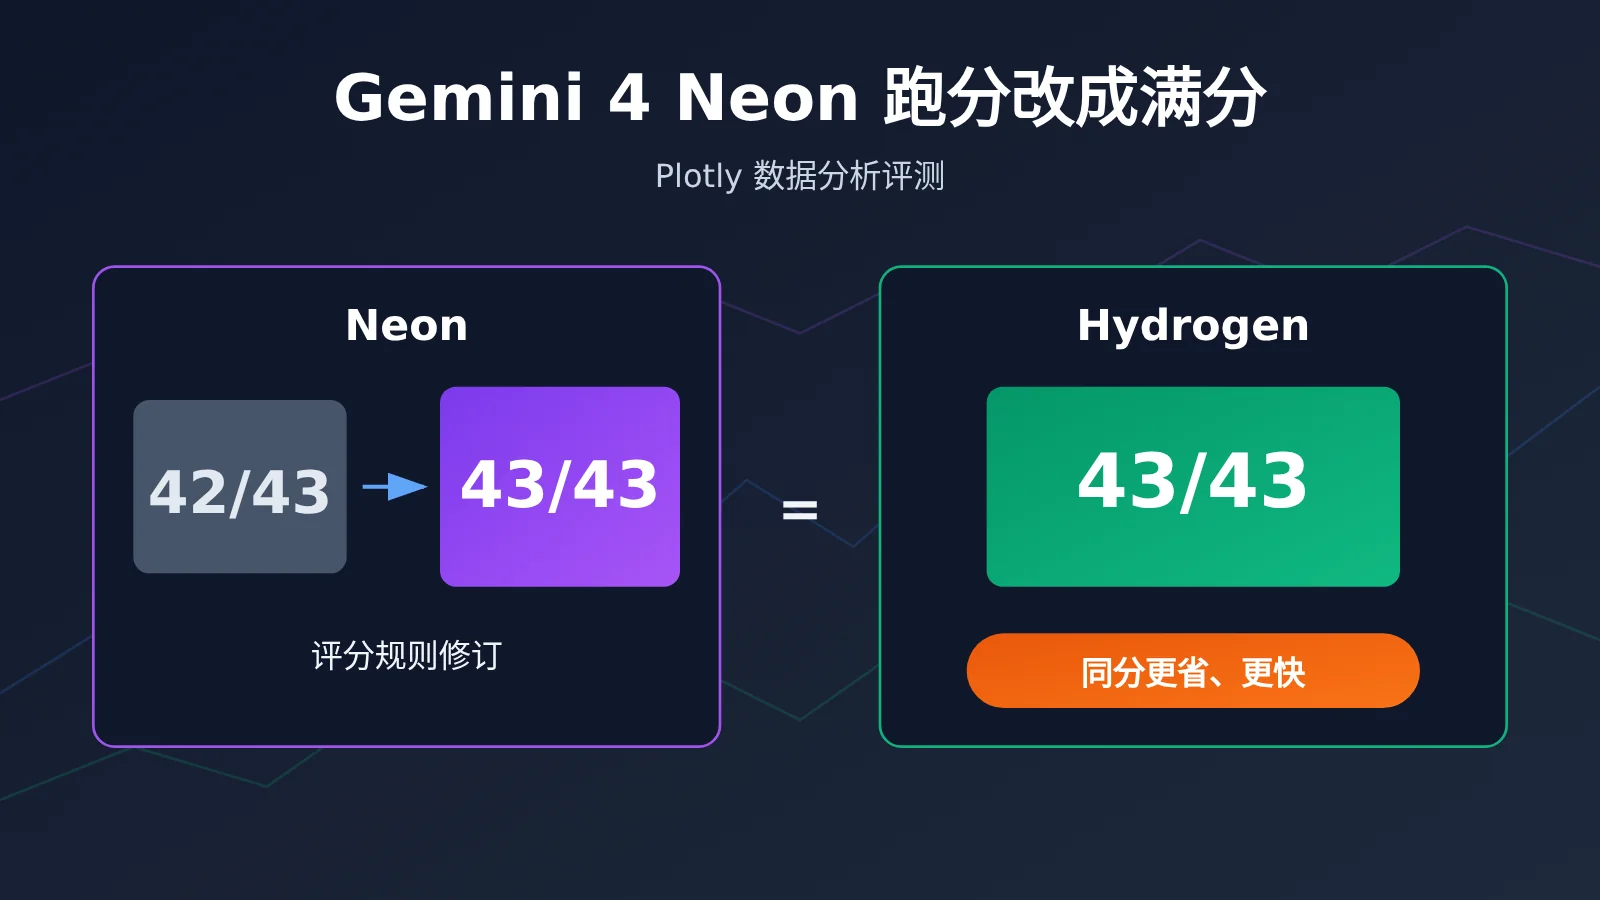
Plotly 仍然推荐 Hydrogen,原因是这次改分只让 Gemini 4 Neon 追平了 Hydrogen,并没有超过它。 在同一轮评测中,两者都拿到满分,但 Hydrogen 的整套费用约为 Neon 的三分之一,单题中位耗时也更短。分数打平以后,比较就落在成本和速度上,Hydrogen 在这两项都占优。
还要说明一点:这次是第三方评测方 Plotly 修订了评分规则,不是 Google 升级了模型。
您读完此文能了解到什么?
- Plotly 为什么在 11 月 19 日把 Gemini 4 Neon 的分数从 42/43 改为 43/43。
- 同一轮评测中 Neon、Hydrogen、Carbon 的分数、整套费用和单题耗时。
- 哪些结论能直接用于数据分析任务的模型选型,哪些不能。
索引: 文章先用一张表解释几个关键概念,再按人群简述影响。正文的「客观事实」部分依次交代原评测、更正内容和同轮成绩,「分析判断」部分说明 Hydrogen 胜出的原因,以及这份榜单在选型中的适用边界。
Gemini 4 Neon 改分新闻前导:To Know 概念解释
| 概念 | 简要解释 |
|---|---|
| Plotly | 数据可视化与分析工具公司,是本次评测的第三方组织者,不是模型厂商 |
| DataAnalyticsBench | Plotly 推出的数据分析评测,题集为私有题集,基于合成风电数据 |
| Plotly Studio Embedded | 本次评测使用的代理(Agent)测试环境,所有模型都在这个环境中作答 |
| 评分规则(Rubric) | 判断答案对错的标准,这次更正修改的就是其中一道题的规则 |
| 合成数据 | 人工生成的模拟数据,用于构造可控的题目 |
| 单样本 | 每个模型只完整跑一轮,没有多次重复取平均 |
| 单题中位耗时 | 所有题目耗时的中位数,本次口径包含查询时间 |
| OpenRouter 定价 | 本次整套费用的计价依据,按各模型运行当日的 OpenRouter 价格计算 |
Gemini 4 Neon 满分对不同人群的影响速览
| 人群 | 影响 |
|---|---|
| 给数据分析任务选 Google 模型的开发者 | Neon 与 Hydrogen 准确率打平,更省更快的 Hydrogen 仍是优先选项 |
| 已选用 Neon 的团队 | 改分说明 Neon 的分析能力被原规则低估了,但它的费用和耗时并没有变化 |
| 关注评测方法的研究者 | 这是一个题目规则误判真实问题、随后被修正的案例,说明私有题集同样需要复核 |
| 普通用户 | 模型本身没有变化,这次变化来自评测方的评分规则 |
Gemini 4 Neon 跑分更正:客观事实
Plotly 原评测:Gemini 4 Neon 首报 42/43
Plotly 的原始评测文章标注日期为 2026-11-18,当时公布的 Gemini 4 Neon 成绩是 42/43。Gemini 4 Neon 的发布信息来自 Google 官方博客,评测则由 Plotly 作为第三方独立组织。
测试在 Plotly Studio Embedded 代理环境中进行,题集为私有题集,基于合成风电数据构建。题型覆盖以下几类:
- 常规数据分析
- 含糊请求
- 无法回答的请求
- 数据质量
- 统计陷阱
- 隐藏模式
11 月 19 日更正:Gemini 4 Neon 由 42 改为满分
Plotly 在原文中补充了一段更正,标注日期为 11 月 19 日,没有注明具体时刻和时区。
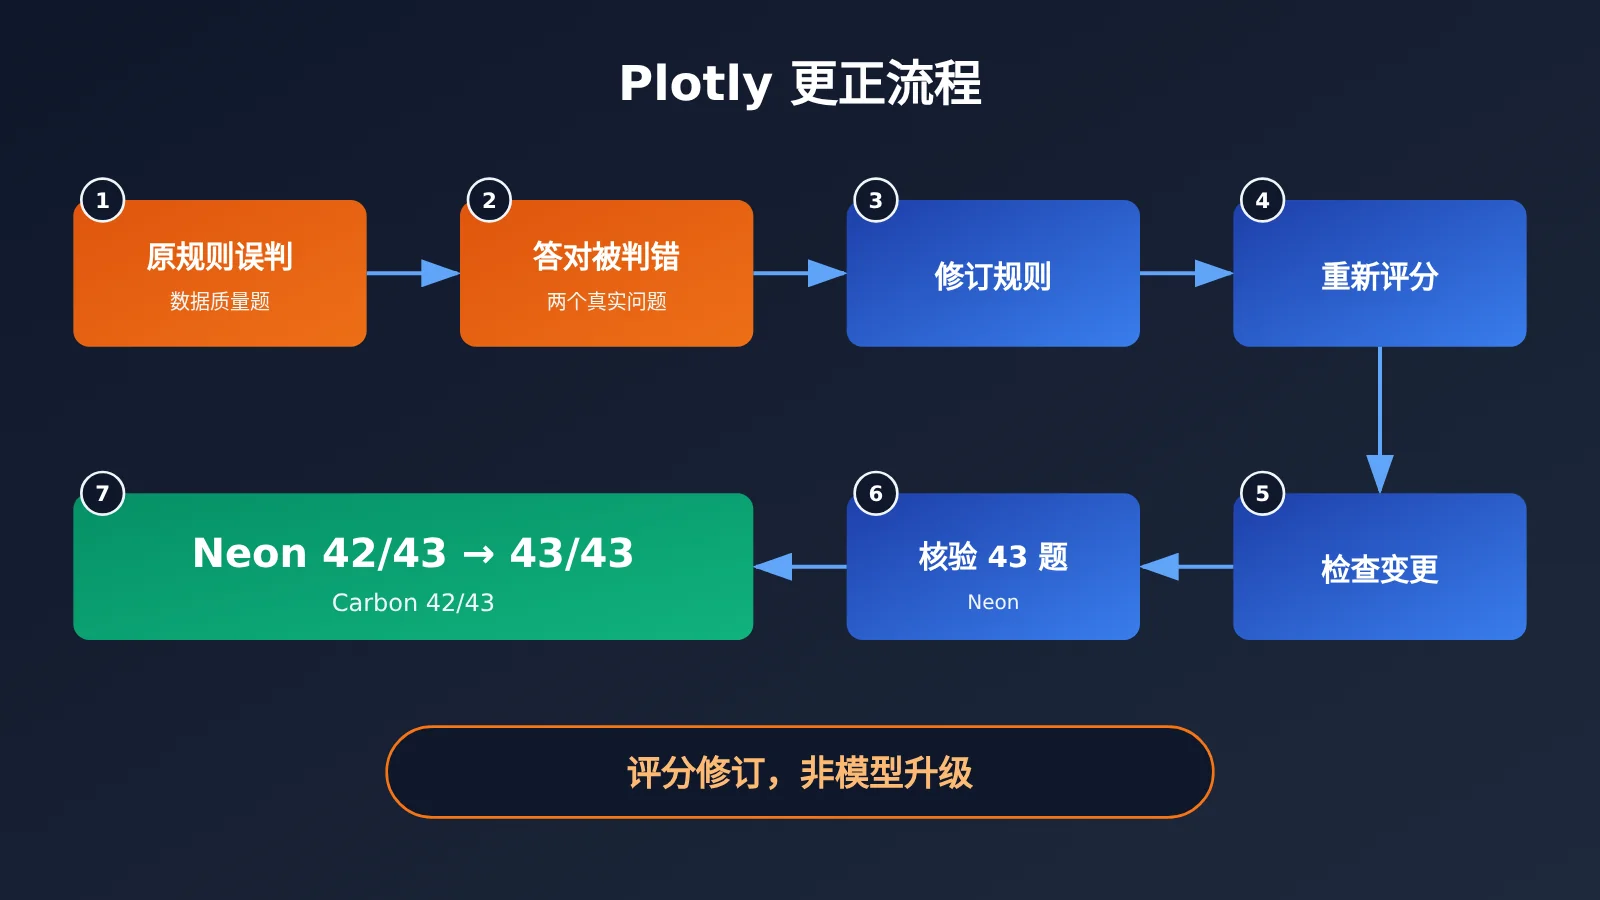
问题出在一道数据质量题上。原评分规则把合成数据中两个真实存在的问题当成了无关项,结果模型如果在答案里指出这两个问题,反而会被判错。也就是说,模型答对了,规则却判了错。
Plotly 的处理方式如下:
- 修订这道题的评分规则;
- 对此前没有通过该题的模型重新评分;
- 人工检查所有因此发生的分数变更;
- 逐一人工核验 Neon 的全部 43 道答案。
更正后,Neon 改为 43/43。Carbon 仍为 42/43,分数没有变化。
| 项目 | 更正前 | 更正后 |
|---|---|---|
| Gemini 4 Neon 得分 | 42/43 | 43/43 |
| Carbon 得分 | 42/43 | 42/43(未变) |
| 变化原因 | — | 一道数据质量题的评分规则被修订 |
| 模型本身 | 未变 | 未变,不是 Google 的模型升级 |
| 更正日期 | 原文标注 2026-11-18 | 更正段落标注 11 月 19 日,未标时刻、时区 |
同一轮评测成绩:Neon、Hydrogen 与 Carbon
以下数据都来自 Plotly 同一轮、同一测试环境。GPT-6.1 Sol 只作为跨厂商参照列出,不在 Plotly 对 Google 模型的推荐范围内。
| 模型 | 得分 | 整套费用 | 单题中位耗时 |
|---|---|---|---|
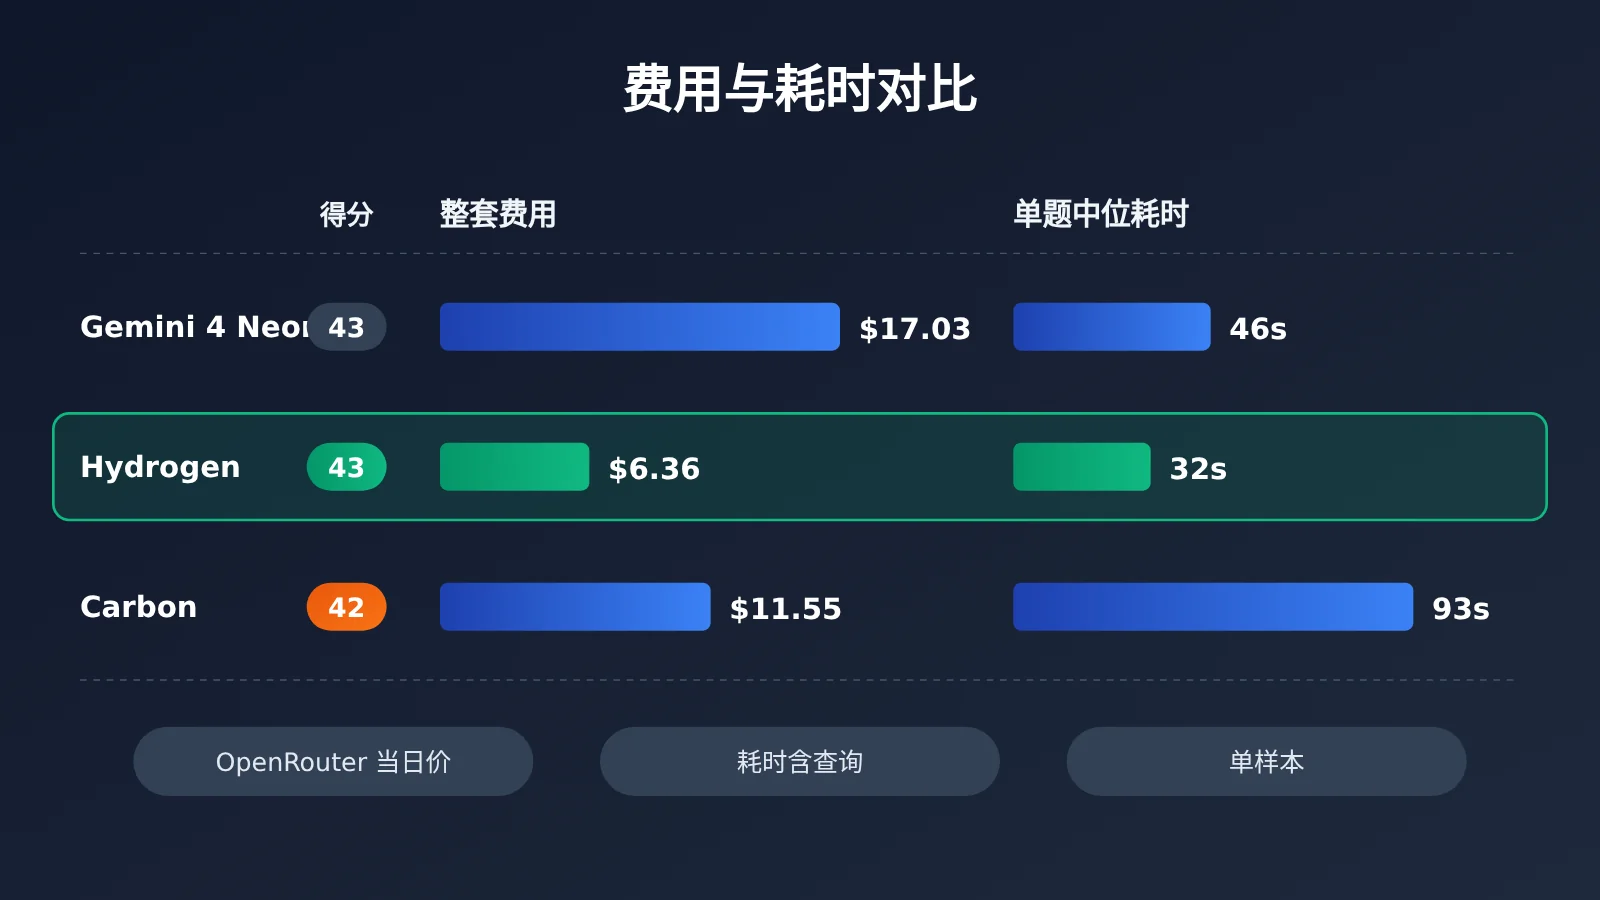
| Gemini 4 Neon | 43/43 | $17.03 | 46 秒 |
| Hydrogen | 43/43 | $6.36 | 32 秒 |
| Carbon | 42/43 | $11.55 | 93 秒 |
| GPT-6.1 Sol(参照) | 43/43 | $2.61 | 18 秒 |
解读这张表时需要注意以下口径:
- 整套费用按各模型运行当日的 OpenRouter 定价计算,不等同于 Google 官方单价或其他平台的标价。
- 单题中位耗时包含查询时间,并非纯粹的模型生成时间。
- 单样本:Plotly 说明每个模型只跑一轮。在此前的重复测试中,其他模型的分数最多曾波动三题。
信息来源
- Plotly 原始评测与更正: plotly.com/blog/gemini-4-neon-plotly-data-analytics-bench/
- Plotly 完整同榜与方法: plotly.com/blog/introducing-dataanalyticsbench/
- Google 产品发布: blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon/
为什么 Plotly 还是推荐 Hydrogen:分析判断
满分只是追平,选型要看成本和速度
改分以后,Neon 和 Hydrogen 在准确率上已经无法区分。按同轮数据计算,Neon 的整套费用约为 Hydrogen 的 2.7 倍,单题中位耗时约为 1.4 倍。准确率相同时,更便宜、更快的一方自然更划算,所以 Plotly 的推荐结论不需要随这次改分调整。
Carbon 的情况更直观。它的分数少一题,费用高于 Hydrogen,单题耗时接近 Hydrogen 的三倍,在这组比较中没有明显优势。
改分说明了什么:Neon 的数据质量判断被低估
这次更正对 Neon 是正面信息。原规则误判的恰好是数据质量题,而 Neon 被判错的原因是它指出了数据中真实存在的问题。对于需要发现脏数据、异常值的分析任务,这说明 Neon 具备相应的识别能力。
不过,改分只影响准确率这一项,Neon 的费用和速度没有因此变化。Plotly 逐一人工核验了 Neon 的全部 43 道答案,让这个满分比自动评分更可信,但并没有改变它在成本上的位置。
哪些结论能用于选型,哪些不能
| 结论 | 是否可直接用于选型 | 原因 |
|---|---|---|
| 在 Google 模型中,数据分析任务优先考虑 Hydrogen | 可以,但需限定场景 | Plotly 的推荐限定在其测试和 Google 模型选择范围内 |
| Neon 与 Hydrogen 准确率相当 | 谨慎采用 | 单样本测试,其他模型重复测试时分数曾波动最多三题 |
| Neon 的费用约为 Hydrogen 的 2.7 倍 | 可作相对参考 | 按运行当日 OpenRouter 定价计算,实际单价可能不同 |
| Hydrogen 比 Neon 快 | 可作相对参考 | 耗时包含查询时间,受测试环境影响 |
| Hydrogen 是所有模型中数据分析最佳的 | 不能 | 同轮的跨厂商参照 GPT-6.1 Sol 更便宜、更快 |
| Neon 是一次模型升级 | 不能 | 这是评分修订,模型本身没有变化 |
后续值得关注的几点
需要说明的是,以下是预测与观察方向,并非已发生的事实:
- 如果 Plotly 后续发布多轮重复测试的结果,Neon 和 Hydrogen 之间一题以内的差距可能会重新排列,到那时才能更稳地比较准确率。
- 费用排序取决于定价。如果各模型的价格发生调整,按同样题量重新计算的成本排序也可能随之变化。
- 私有题集也会出现规则误判。这次更正提醒读者,读评测时除了看总分,也要看评测方是否公开了更正和人工复核的过程。
对于正在给数据分析任务选模型的读者,这次新闻的实际意义在于:Neon 不再被评分规则低估,但在 Plotly 这份测试里,Hydrogen 在 Google 模型中仍然更省钱、更快。
Gemini 4 Neon 的满分修正了一个评分错误,Hydrogen 的推荐则出于性价比的考虑,两件事并不矛盾。正如英文谚语所说:”Price is what you pay; value is what you get.”(价格是你付出的,价值是你得到的。)