Note de l’auteur : un guide pas à pas pour utiliser les 177 Scientific Agent Skills de K-Dense-AI : vérification de l’environnement, choix et installation des compétences, ajout des dépendances et test de leur activation. Le dépannage et les risques sont aussi abordés séparément.
Les Scientific Agent Skills de K-Dense-AI sont un ensemble open source de 177 compétences scientifiques destinées aux agents de programmation comme Claude Code et Cursor. Elles présentent des workflows d’analyse de cellules uniques, de chimio-informatique, de revue de littérature ou de recherche dans des bases de données sous forme de guides que les agents peuvent suivre. Vous n’avez donc plus à rédiger chaque fois un workflow de contrôle qualité, à fouiller dans la documentation des API ou à vérifier les DOI.
Mieux vaut toutefois éviter de tout installer d’un coup : ces compétences peuvent amener l’agent à exécuter du code, installer des paquets et accéder à Internet. Et l’installation des fichiers de compétences ne suffit pas à installer les dépendances Python.
Ce n’est pas un article qui promet monts et merveilles après l’installation, mais un guide en 5 étapes, avec des résultats vérifiables à chacune d’elles.
L’essentiel : à la fin de cet article, vous saurez choisir les 5 à 10 Skills utiles à votre domaine, les installer dans le bon répertoire, ajouter les dépendances nécessaires et les faire utiliser par votre agent, tout en vérifiant les résultats et les chiffres un par un.
Que contiennent les 177 Skills scientifiques ?
Le dépôt s’appelle K-Dense-AI/scientific-agent-skills et est publié sous licence MIT. Au 28 octobre 2026, il comptait 54 959 stars et 4 846 forks. Sa version courante était la 2.72.0 et le répertoire skills/ contenait 177 sous-répertoires. Le README annonce « plus de 250 000 scientifiques utilisateurs » et se présente comme la « bibliothèque de Skills pour agents n° 1 en science » : ce sont des chiffres et affirmations fournis par le projet, pas des statistiques établies par un tiers. L’article associé est publié sous la référence arXiv:2609.00065.
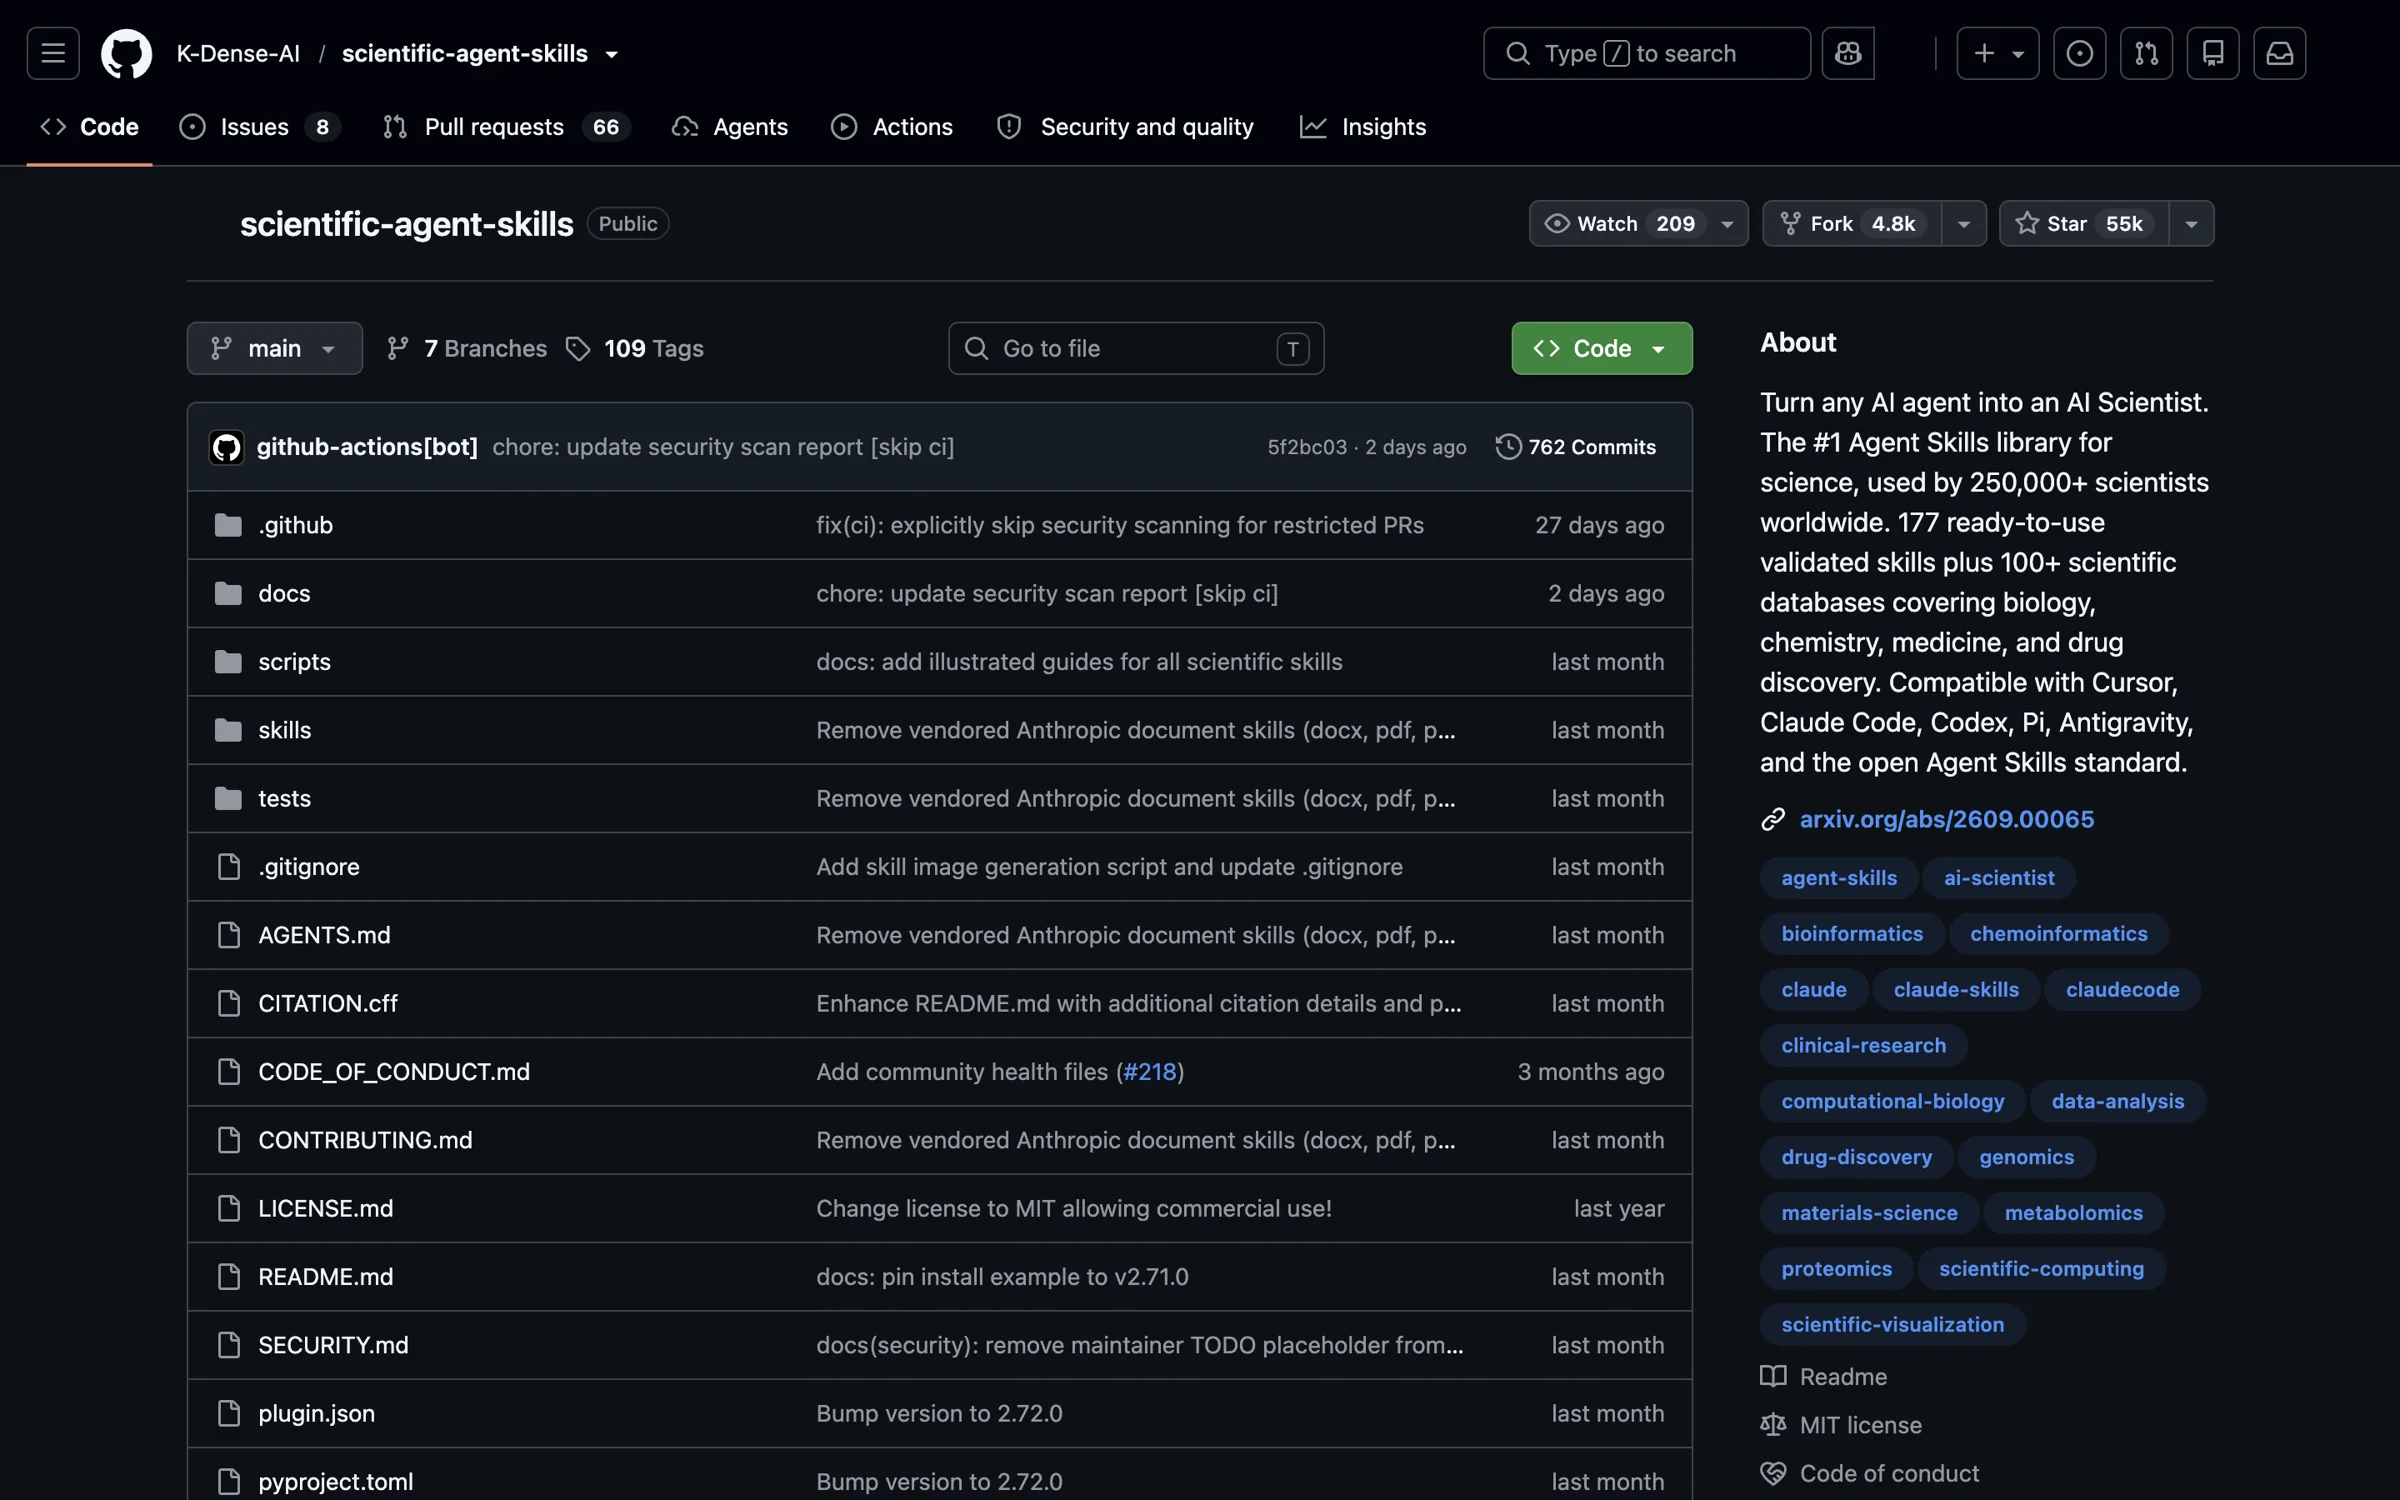
Figure 1 : page d’accueil du dépôt, capture du 28 octobre 2026. Elle affiche 55 000 stars et 4 800 forks ; la section About mentionne directement 177 Skills et plus de 100 bases de données.
Pourquoi 177 ? La version 2.71.0 comptait 181 Skills. Depuis la version 2.72.0, les quatre Skills documentaires docx, pdf, pptx et xlsx ne sont plus distribués avec le dépôt. Si vous en avez besoin, il faut les installer séparément depuis le dépôt d’Anthropic.
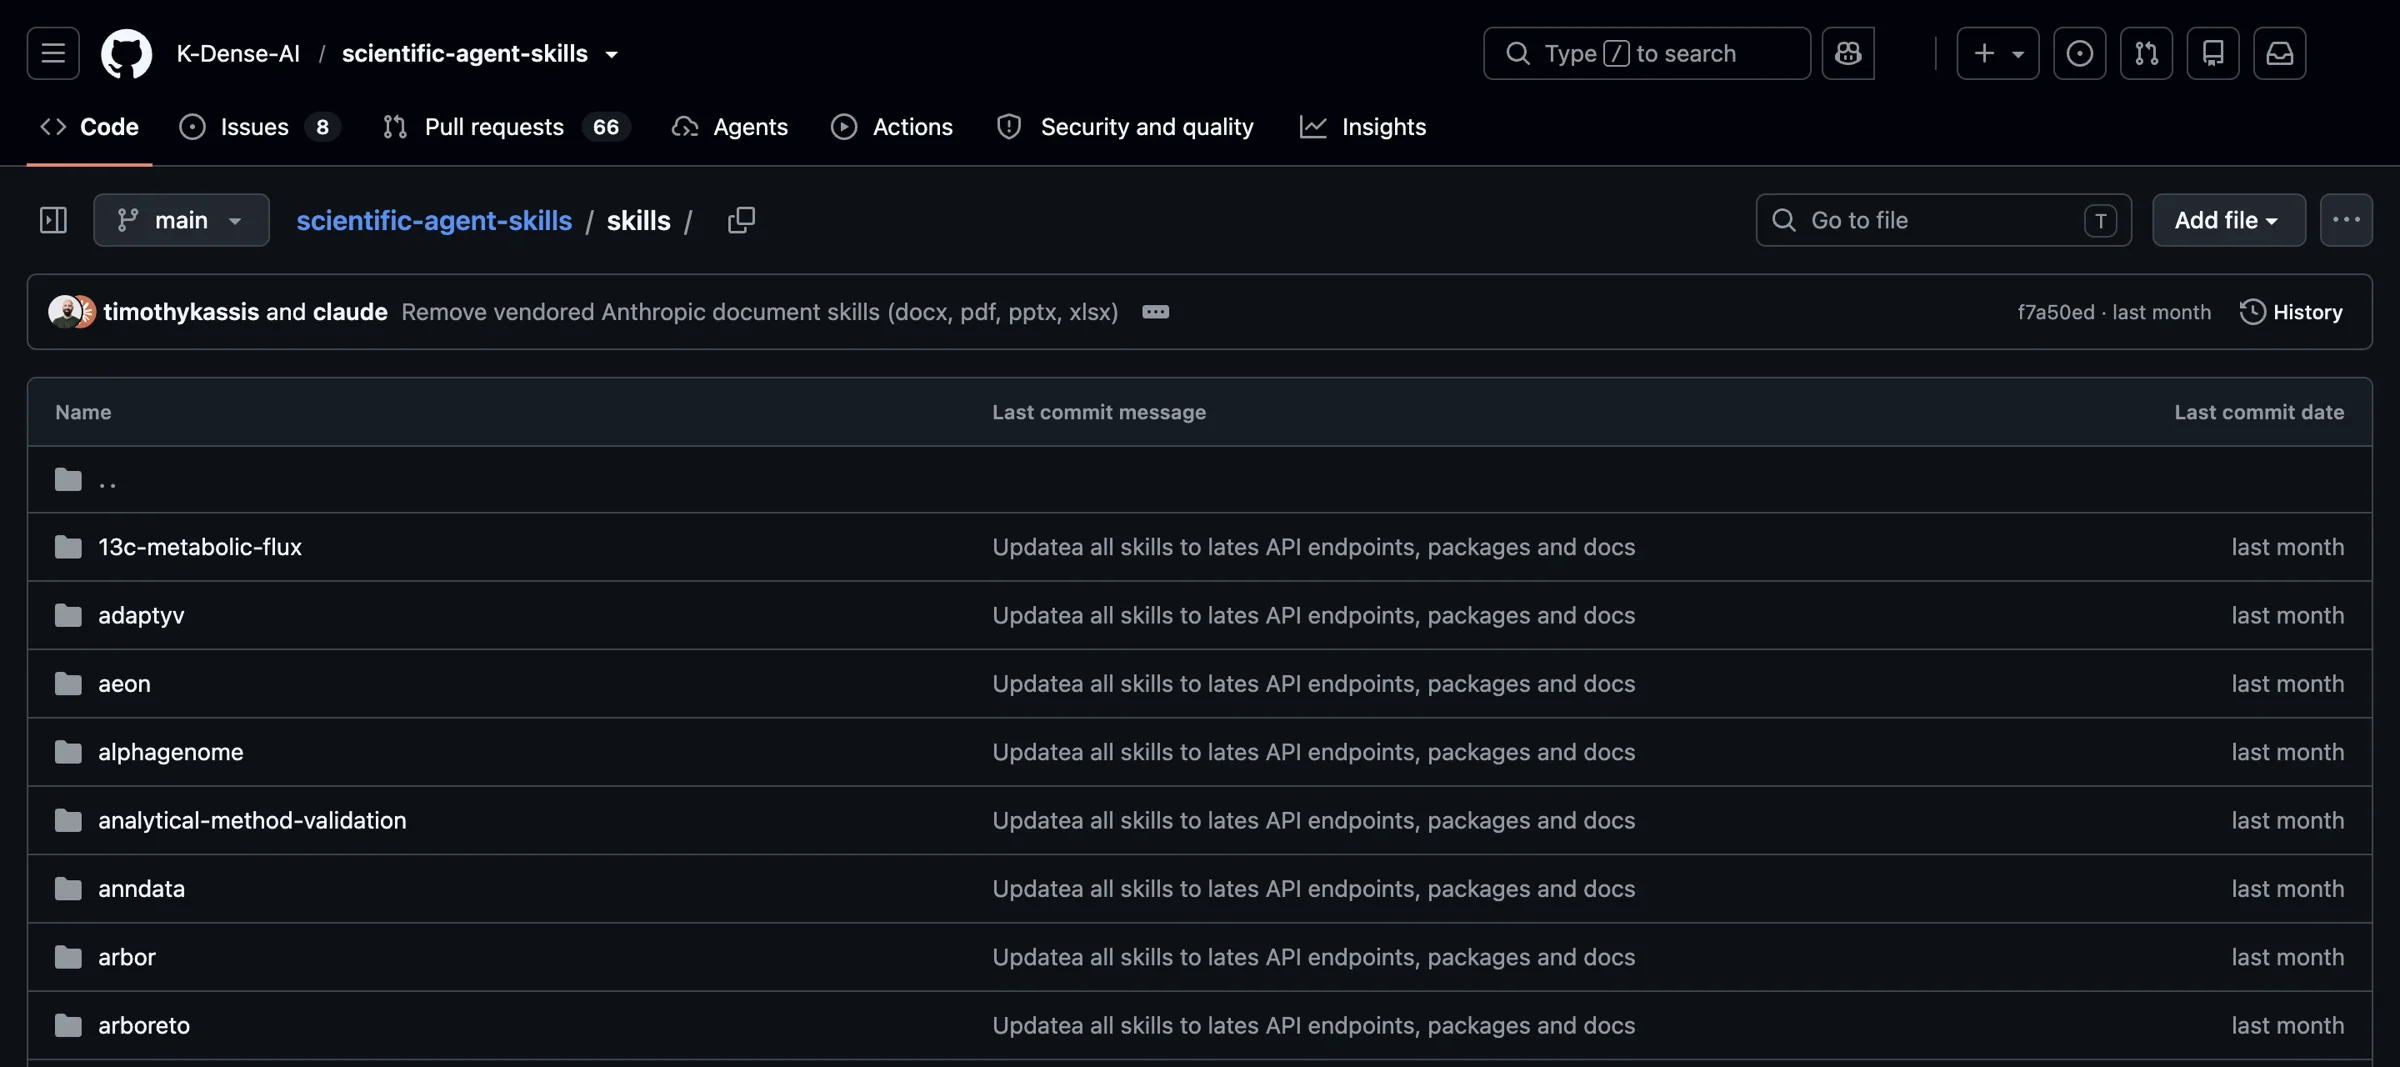
Figure 2 : le répertoire skills/ affiche des dizaines de dossiers de Skills sur un seul écran. Le message du dernier commit indique « Remove vendored Anthropic document skills » : c’est cette modification qui a fait passer le total de 181 à 177.
Le README classe tous les Skills en 22 grandes catégories. Le tableau ci-dessous les regroupe par domaine et présente seulement quelques Skills et packages représentatifs, sans chercher à tous les énumérer :
| Domaine (grandes catégories du README) | Skills / packages représentatifs | Usages typiques |
|---|---|---|
| Bio-informatique, multiomique, protéomique et spectrométrie de masse | scanpy, pydeseq2, pyopenms, nextflow, Skills pour des packages comme scVelo |
Contrôle qualité et regroupement de données unicellulaires, expression différentielle, traitement de données de spectrométrie de masse, orchestration de pipelines |
| Chimio-informatique et découverte de médicaments, science des matériaux | rdkit, pymatgen |
Filtrage et descripteurs moléculaires, structures cristallines et calculs sur les matériaux |
| Physique et astronomie, ingénierie et simulation | qiskit, Skills pour des packages comme QuTiP |
Circuits quantiques, simulation de systèmes quantiques |
| Recherche clinique, IA médicale, réglementation et normes | clinical-reports, Skills pour des packages comme pydicom |
Ébauches de rapports cliniques, lecture d’images médicales |
| Analyse et visualisation de données, apprentissage automatique, données géospatiales | scientific-visualization, timesfm-forecasting, Skills pour des packages comme scikit-learn, PyTorch Lightning et GeoPandas |
Graphiques de qualité publication, prévision de séries temporelles, modélisation, analyse de données spatiales |
| Communication scientifique, méthodologie de recherche | literature-review, scientific-writing, paper-lookup, paperzilla, scientific-slides, research-grants, peer-review, generate-image |
Revues systématiques, rédaction d’articles, diapositives pour les réunions d’équipe, demandes de financement, commentaires de relecture |
| Recherche dans les bases de données | database-lookup, Skills spécialisés comme DepMap, Imaging Data Commons, PrimeKG, NCATS ARAX et AlphaGenome |
Interrogation unifiée de sources de données publiques, nécessitant une inscription ou soumises à autorisation |
À lui seul, le skill database-lookup répertorie 80 sources de données. En ajoutant les skills spécialisés et les packs couvrant plusieurs bases, le README annonce plus de 100 bases de données. Le projet compte aussi plus de 70 skills consacrés à des packages Python, dont RDKit, Scanpy, scikit-learn, PyTorch Lightning, pydicom, QuTiP, GeoPandas, pymatgen, Qiskit, scVelo et TimesFM. Chacun précise les versions du package prises en charge et la façon de l’utiliser.
Structure du dossier d’un skill de recherche
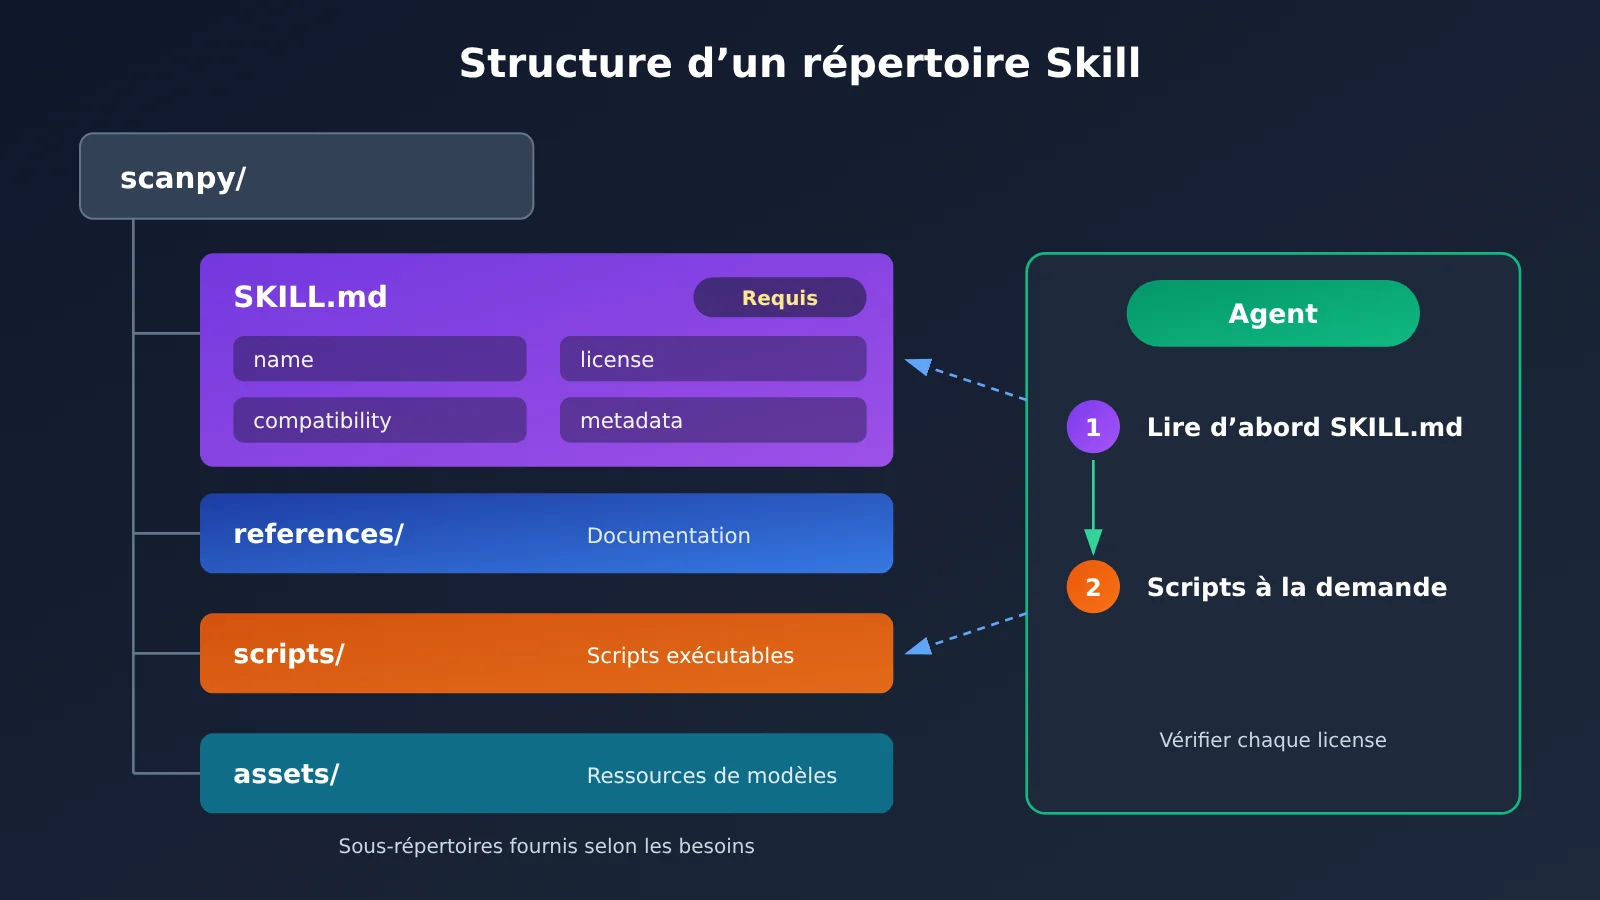
Chaque skill possède son propre dossier. Le fichier SKILL.md est obligatoire ; les dossiers references/, scripts/ et assets/ sont fournis selon les besoins. Pour scanpy, par exemple, le front matter indique la licence BSD-3-Clause, Python 3.12+, metadata.version 1.8 et last-reviewed 2026-10-01.
Un détail facile à manquer : le dépôt est globalement sous licence MIT, mais chaque skill indique sa propre licence dans le champ license de son fichier SKILL.md. Elle peut donc être différente de celle du dépôt. Pour un usage commercial ou une redistribution, vérifiez chaque licence individuellement.
Intégrer les Skills de recherche en 5 étapes
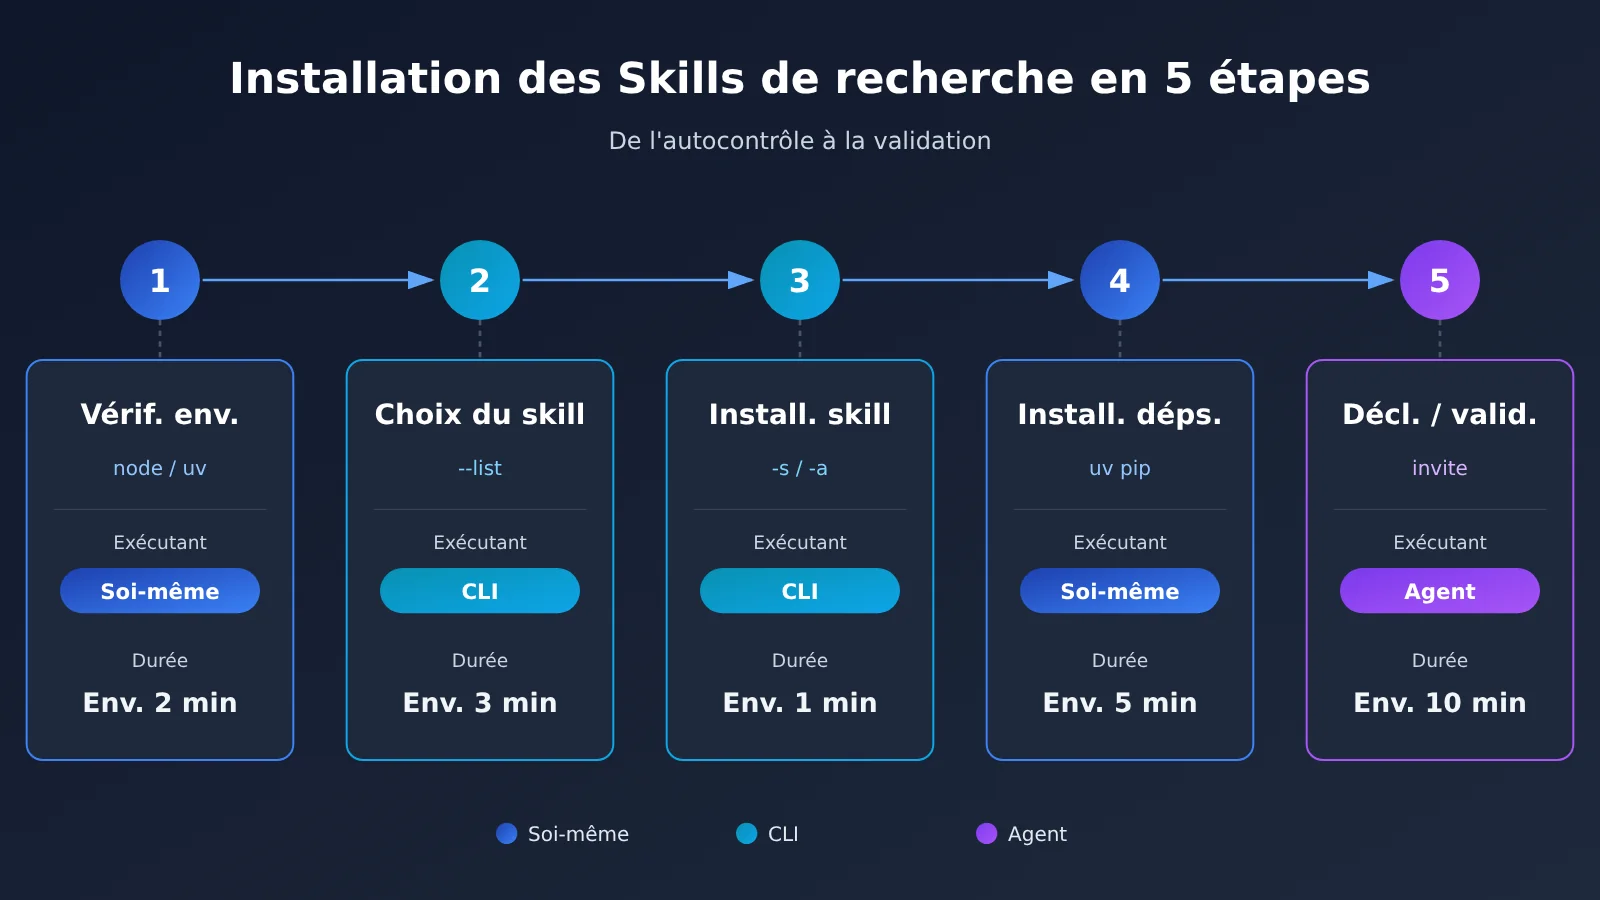
L’intégration se déroule en cinq étapes : vérifier l’environnement → consulter la liste et choisir les compétences → installer uniquement celles dont on a besoin → ajouter les dépendances et les identifiants → déclencher les compétences et vérifier leur fonctionnement. À chaque étape, nous préciserons si c’est vous, l’outil en ligne de commande ou l’Agent qui exécute les actions.
Étape 1 : comprendre l’installation des Skills de recherche et ses prérequis
Durée : environ 5 minutes Prérequis : pouvoir ouvrir un terminal Difficulté : faible (si votre environnement est déjà prêt, vous pouvez passer cette étape)
À faire : exécutez vous-même les commandes de vérification ci-dessous, une par une. Vous saurez ainsi si vous pouvez installer les compétences directement, si vous devez d’abord installer des outils ou si votre application hôte n’est pas compatible.
node -v: l’installateurnpx skillsnécessite Node.js 22.20 ou une version ultérieurepython3 --version: la chaîne d’outils fournie avec le dépôt nécessite Python 3.13 ou une version ultérieure (pour chaque compétence, consultez son champ compatibility pour connaître les versions prises en charge)uv --version: uv sert à installer les dépendances des compétencesgh --version: nécessaire uniquement si vous comptez installer les compétences avec GitHub CLI ; la version doit être supérieure à 2.90.0- Système : macOS, Linux ou Windows avec WSL2
Résultat attendu : chaque commande affiche un numéro de version. Si le message command not found apparaît, l’outil correspondant n’est pas encore installé.
Critères de validation : Node est en version 22.20 ou ultérieure, Python en version 3.13 ou ultérieure, uv affiche correctement son numéro de version et votre application hôte prend en charge le standard Agent Skills. L’installateur skills (paquet npm, vercel-labs/skills, licence MIT, dernière version : 1.7.4) prend officiellement en charge plus de 70 applications hôtes, dont Claude Code, Cursor, Codex, Gemini CLI, Antigravity et OpenClaw. Les compétences ne sont pas liées à un modèle : vous choisissez celui qu’utilise l’application hôte. L’étape 5 expliquera comment connecter concrètement le modèle à APIYI.
Étape 2 : lister les Skills scientifiques avant de choisir lesquels installer
Durée : environ 10 minutes Prérequis : étape 1 validée Difficulté : faible (étape à ne pas sauter)
À faire : exécutez vous-même la commande qui liste les Skills sans les installer. L’outil en ligne de commande récupère le dépôt et lit le nom et la description de tous les Skills, sans en installer sur votre machine.
npx skills add K-Dense-AI/scientific-agent-skills --list
Résultat attendu : le terminal affiche 177 Skills, chacun accompagné de son nom et d’une brève description.
À savoir d’après nos tests : cette étape commence par cloner l’ensemble du dépôt en local, soit plus de 400 Mo. Si la connexion est lente, le terminal peut rester longtemps bloqué sur Cloning repository…. Au-delà de 300 secondes, l’erreur Clone timed out s’affiche. Pour allonger le délai, relancez la commande avec SKILLS_CLONE_TIMEOUT_MS=600000 (10 minutes). Vous pouvez aussi cloner vous-même le dépôt avec git clone, puis exécuter skills add sur le répertoire local.
Critère de validation : vous avez une liste de 5 à 10 Skills candidats. Le README le dit explicitement : « Do not install everything at once » — n’installez pas tout d’un coup. Plus vous installez de Skills, plus la sélection devient difficile pour l’agent et plus vous avez de code à vérifier.
Voici quelques pistes selon votre domaine :
- Bio-informatique :
scanpy,pydeseq2,database-lookup; ajoutezpyopenmspour la spectrométrie de masse - Chémoinformatique :
rdkit,database-lookup; ajoutezpymatgenpour les matériaux - Littérature scientifique et rédaction :
literature-review,paper-lookup,scientific-writing,peer-review - Visualisation de données :
scientific-visualization; ajouteztimesfm-forecastingpour les séries temporelles - Automatisation de laboratoire : consultez la sortie de
--listpour connaître les noms exacts des Skills de cette catégorie ; pour l’orchestration des workflows, commencez par regardernextflow
Étape 3 : installer uniquement les Skills scientifiques nécessaires
Durée : environ 5 minutes Prérequis : avoir une liste de Skills présélectionnés Difficulté : moyenne
À faire : exécutez vous-même la commande d’installation. L’outil en ligne de commande se charge d’ajouter les Skills au répertoire de l’agent hôte. La « commande unique » mentionnée dans le titre est npx skills add K-Dense-AI/scientific-agent-skills. Si vous l’exécutez telle quelle, elle lance un mode interactif qui vous permet de sélectionner les Skills et les agents hôtes. Tout sélectionner revient à tout installer, ce qui n’est pas recommandé.
Signification des paramètres :
-s/--skill: précise le nom du Skill ;'*'désigne tous les Skills-a/--agent: précise l’agent hôte, par exempleclaude-codeoucodex-g: installe dans le répertoire utilisateur (global) ; sans ce paramètre, l’installation se fait dans le projet actuel--copy: copie les fichiers ; par défaut, l’outil utilise des liens symboliques (symlinks), ce qui ne conserve qu’une seule copie sur la machine et facilite les mises à jour-y: ignore la confirmation, pratique pour les scripts ou la CI
Commandes non interactives prêtes à copier (avec Claude Code et une installation au niveau du projet, un Skill par ligne) :
npx skills add K-Dense-AI/scientific-agent-skills -s scanpy -a claude-code -ynpx skills add K-Dense-AI/scientific-agent-skills -s database-lookup -a claude-code -ynpx skills add K-Dense-AI/scientific-agent-skills -s pydeseq2 -a claude-code -y
Pour une installation globale, ajoutez -g à la fin de la commande ; pour copier les fichiers plutôt que d’utiliser des liens symboliques, ajoutez --copy. Pour installer plusieurs Skills en une seule fois, consultez les instructions de npx skills add --help.
| Agent hôte | Répertoire du projet | Répertoire global |
|---|---|---|
| Claude Code | .claude/skills/ |
~/.claude/skills/ |
| Cursor | .agents/skills/ |
~/.cursor/skills/ |
| Codex | .agents/skills/ |
~/.agents/skills/ |
| Gemini CLI | .agents/skills/ |
~/.gemini/skills/ |
| Antigravity | .agents/skills/ |
~/.gemini/antigravity/skills/ |
| OpenClaw | skills/ |
~/.openclaw/skills/ |
Comment choisir entre installation au niveau du projet et installation globale ? Placez au niveau du projet les Skills liés à un sujet précis (par exemple, pydeseq2 pour un projet d’analyse donné) : vous pourrez ainsi les partager avec votre équipe en même temps que le projet. Installez globalement les Skills utilisés tous les jours, comme ceux consacrés à la littérature scientifique ou à la rédaction.
Ce que vous verrez : l’installateur confirme la réussite de chaque installation et affiche le chemin de destination.
Critères de vérification : exécutez vous-même npx skills list ou directement ls .claude/skills/, puis vérifiez que les répertoires des Skills installés sont bien présents et que chacun contient un fichier SKILL.md.
Il existe deux autres méthodes d’installation :
gh skill install K-Dense-AI/scientific-agent-skills --agent claude-code --pin v2.71.0: utilisez--pinpour fixer une version ou un SHA de commit, pratique pour les projets dont les résultats doivent être reproductiblesgit clonevers~/.agents/skills/scientific-agent-skills(niveau utilisateur) ou.agents/skills/scientific-agent-skills(niveau projet)
Étape 4 : installer les dépendances Python et configurer les clés des Skills scientifiques
Durée : 10 à 30 minutes (selon la taille des paquets) Prérequis : les Skills sont installés Difficulté : moyenne (étape obligatoire)
À faire : c’est l’étape où les problèmes sont les plus fréquents, alors rappelons-le : installer les fichiers d’un Skill ≠ installer ses dépendances. Ouvrez vous-même le fichier SKILL.md de chaque Skill, vérifiez le champ compatibility, puis installez les dépendances avec uv. Attention : uv sync installe uniquement les outils de développement et de vérification du dépôt, pas tous les paquets de calcul scientifique.
cat .claude/skills/scanpy/SKILL.md: vérifiez le champcompatibility. Pour le Skill scanpy, il indique « testé avec Python 3.13 + Scanpy 1.12.4 + AnnData 0.13.4 »uv venv .venv-scrna --python 3.13: créez un environnement distinct pour chaque workflow afin d’éviter les conflits entre les paquets d’analyse unicellulaire et de chimio-informatiquesource .venv-scrna/bin/activateuv pip install "scanpy[leiden]"
Certains Skills nécessitent votre propre clé. Par exemple, generate-image utilise l’API d’images d’OpenRouter : vous devez définir export OPENROUTER_API_KEY=votre_cle et chaque génération est facturée. Lister les modèles ou ajouter --dry-run ne coûte rien : essayez d’abord l’une de ces deux options. literature-review nécessite une connexion Internet pour vérifier les DOI. Pour exporter un PDF, vous devrez aussi installer Pandoc et XeLaTeX.
Si vous utilisez déjà APIYI, pas besoin de créer un compte OpenRouter pour générer des images : la documentation d’APIYI présente deux Skills proposés par la communauté, apiyi-gpt-image-2-gen (accès à l’API officielle gpt-image-2 via proxy, facturation par token, prise en charge de la 4K et des dimensions personnalisées) et apiyi-gpt-image-2-all-gen (accès par ingénierie inverse à l’API officielle, 0,025 $ par appel, modification d’images par conversation). Une fois le Skill installé dans Cursor, Codex CLI, Gemini CLI, OpenCode, GitHub Copilot ou Amp, il suffit de demander : « Utilise apiyi-gpt-image-2-gen pour générer une image de 3840×2160 ». La clé est configurée dans tous les cas via la variable d’environnement APIYI_API_KEY.
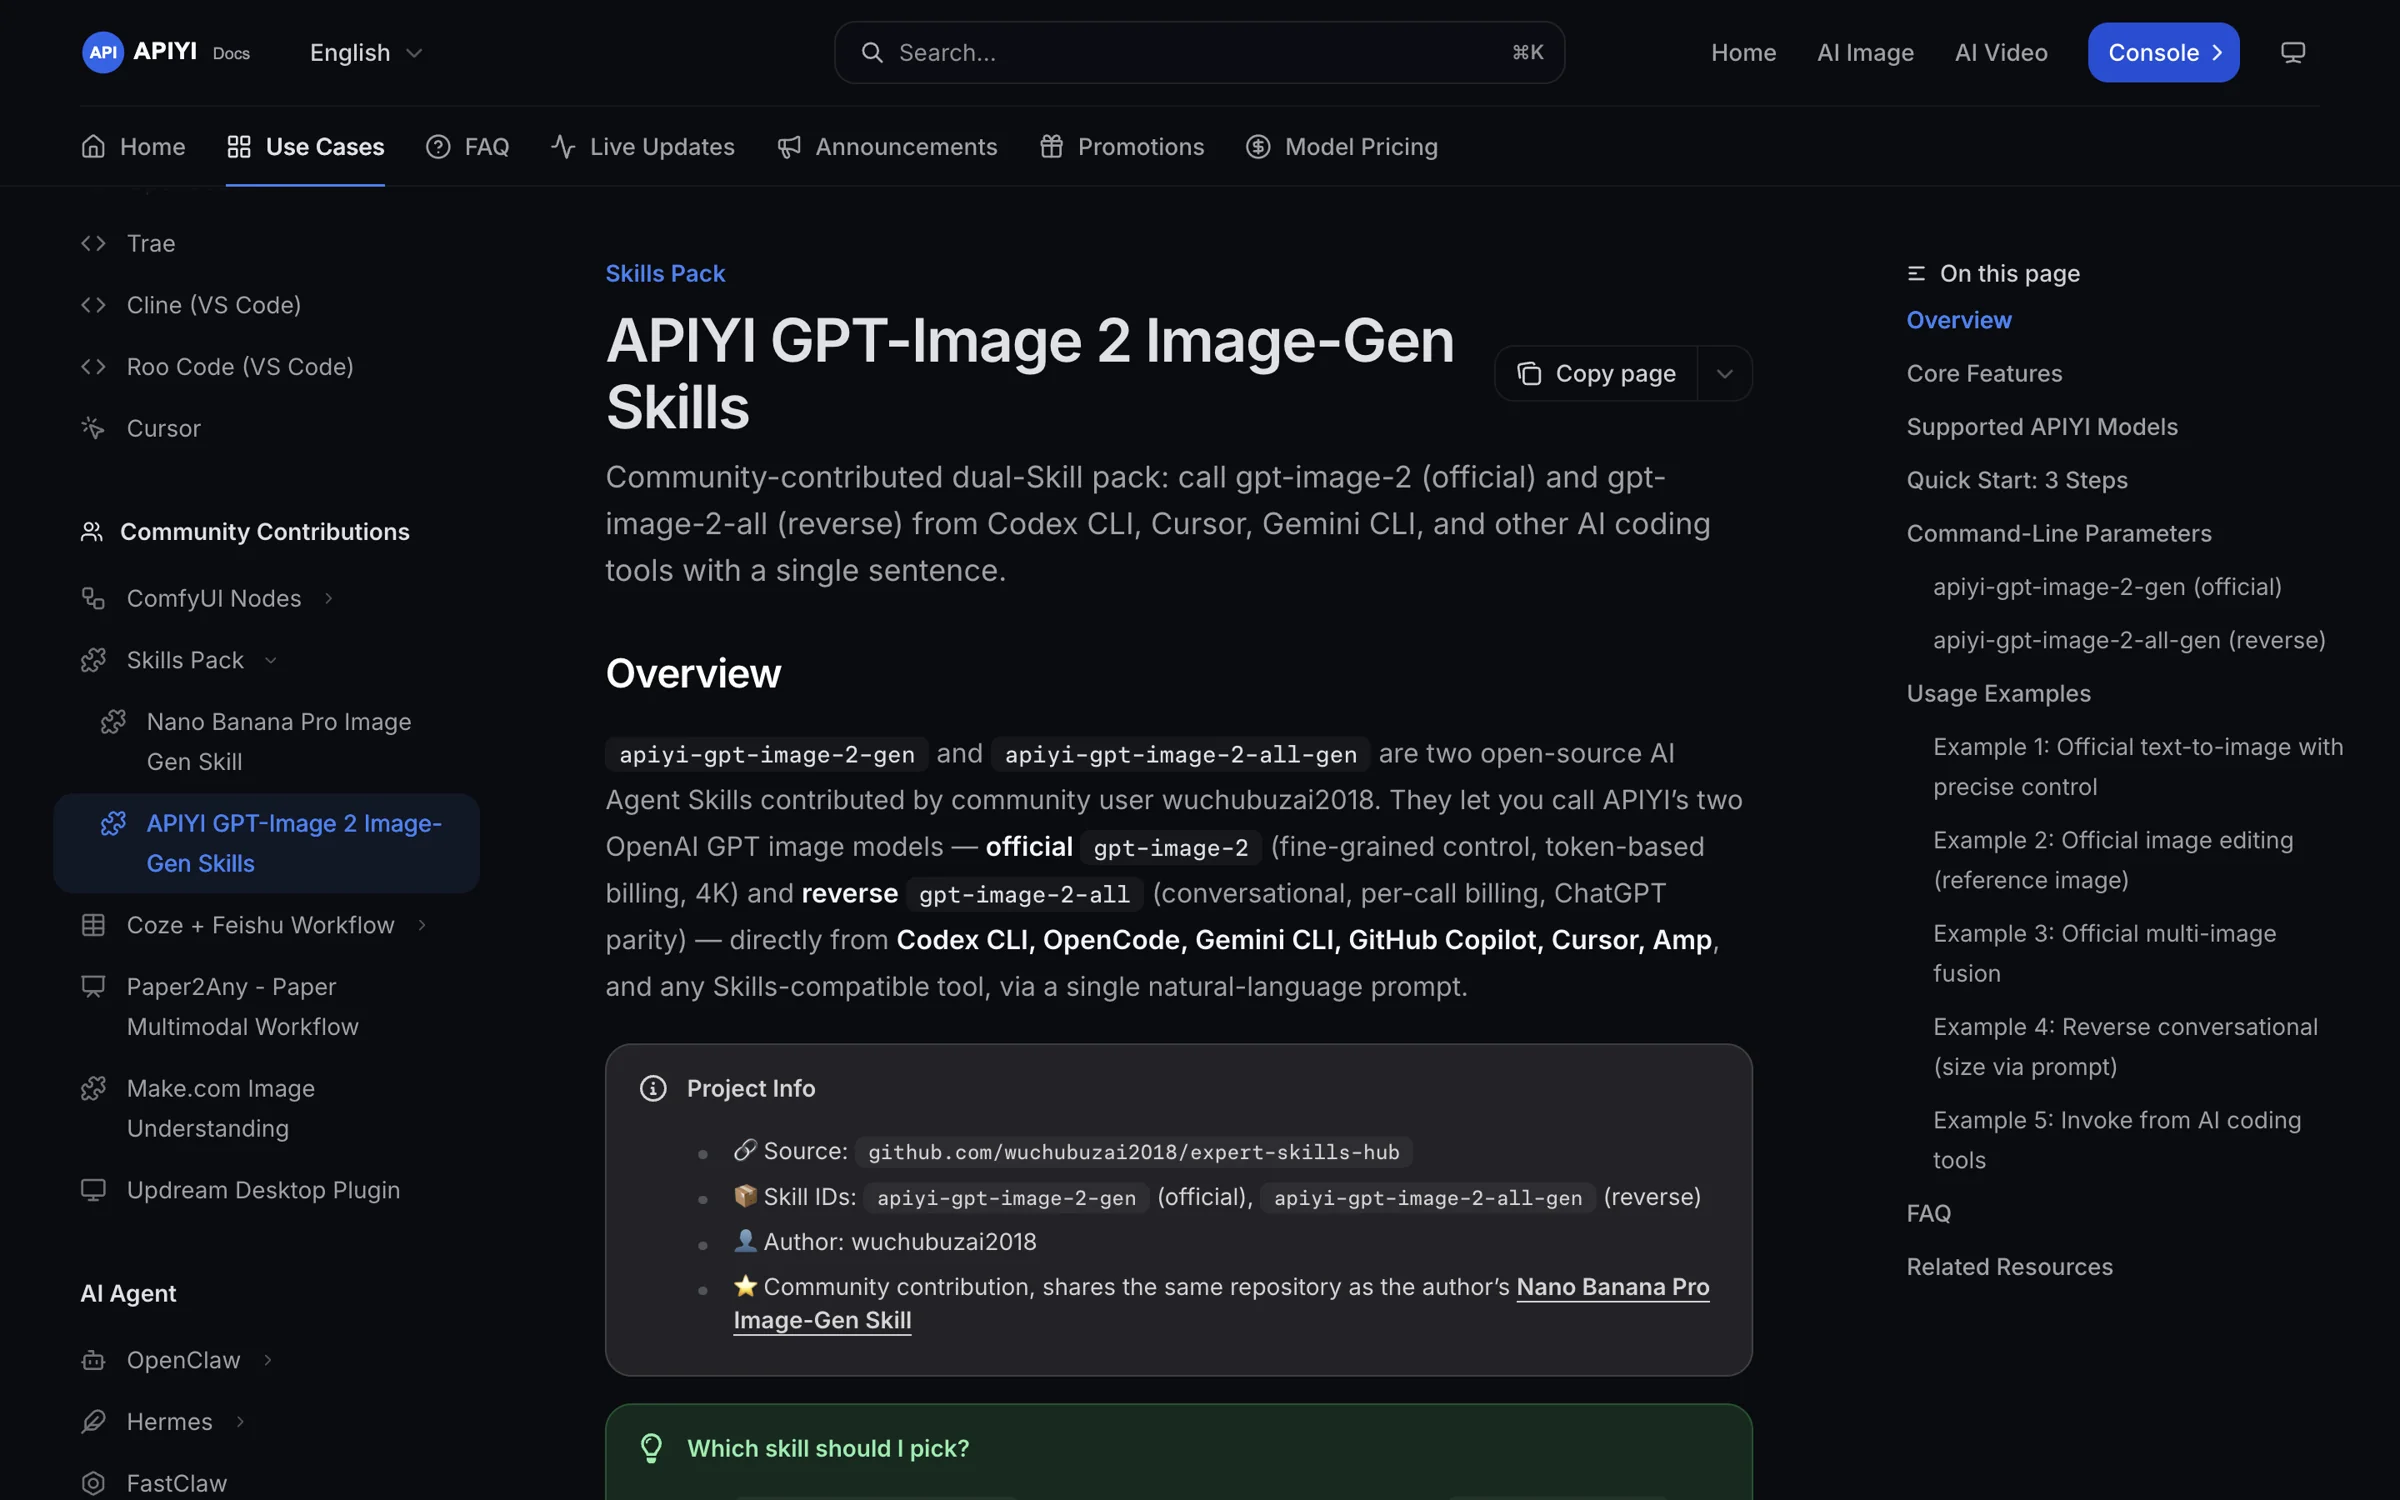
Figure 3 : la page de la documentation d’APIYI consacrée aux Skills. Pour chacun des deux Skills de génération d’images, elle indique l’identifiant du modèle, le mode de facturation et comment diagnostiquer les erreurs d’installation.
Ce que vous verrez : uv affiche la liste des paquets résolus et installés.
Critères de validation : exécutez vous-même python -c "import scanpy, anndata; print(scanpy.__version__, anndata.__version__)" et vérifiez que les numéros de version correspondent au champ compatibility. Pour les Skills qui nécessitent une clé, utilisez echo $OPENROUTER_API_KEY | head -c 6 pour vérifier que la variable d’environnement est bien définie.
Étape 5 : déclencher les Skills de recherche et vérifier les résultats
Durée : environ 10 minutes Prérequis : dépendances installées Difficulté : faible
Marche à suivre : redémarrez l’application hôte pour qu’elle analyse à nouveau le répertoire des compétences. Saisissez ensuite vous-même une invite dans la conversation. L’agent se charge du reste : lire le fichier SKILL.md, exécuter les scripts et générer les fichiers. La formule recommandée est « phrase d’introduction générale + nom de la compétence » :
- Commencez par
Use available skills you have access to whenever possible. - Nommez ensuite la compétence, par exemple : « utilise la compétence literature-review pour réaliser une revue systématique »
Ce que vous verrez : l’agent indiquera dans sa réponse quelle compétence il a lue et quelles commandes il compte exécuter.
Critères de vérification (les trois doivent pouvoir être contrôlés) :
- L’agent a-t-il clairement indiqué quelle compétence il a utilisée ? Sinon, demandez-lui : « quelle compétence as-tu utilisée ? »
- Dans quel répertoire se trouvent les fichiers produits ? Vérifiez vous-même avec
lsqu’ils existent bien. - Les chiffres du résultat correspondent-ils aux sources ? Les DOI s’ouvrent-ils et peut-on retrouver les identifiants des entrées dans les bases de données ?
Commandes de maintenance courante (à exécuter vous-même) : npx skills check pour vérifier les mises à jour, npx skills update pour les installer et npx skills remove pour désinstaller une compétence. Le programme d’installation collecte par défaut des données d’utilisation anonymes. Ajoutez DISABLE_TELEMETRY=1 ou DO_NOT_TRACK=1 pour désactiver cette collecte.
🎯 Une fois le processus validé, faites le calcul : les compétences elles-mêmes sont gratuites et open source. Ce qui coûte de l’argent, ce sont les invocations du modèle pendant leur exécution. Un workflow complet d’analyse de cellules uniques demande souvent plusieurs cycles de lecture de documentation, d’écriture de code et de correction d’erreurs : la consommation de tokens peut vite grimper. Si votre application hôte accepte un endpoint personnalisé compatible avec OpenAI, vous pouvez définir
base_urlsurhttps://api.apiyi.com/v1et utiliser APIYI apiyi.com pour passer de Claude à GPT, Gemini ou d’autres modèles avec une seule clé API. Vous pourrez ainsi comparer les résultats et les coûts pour une même compétence. Avec Claude Code, par exemple, la configuration se résume à deux variables d’environnement :ANTHROPIC_BASE_URLpointe vershttps://api.apiyi.cometANTHROPIC_AUTH_TOKENcontient votre clé API. Une fois configurées, ces compétences restent utilisables dans Claude Code.
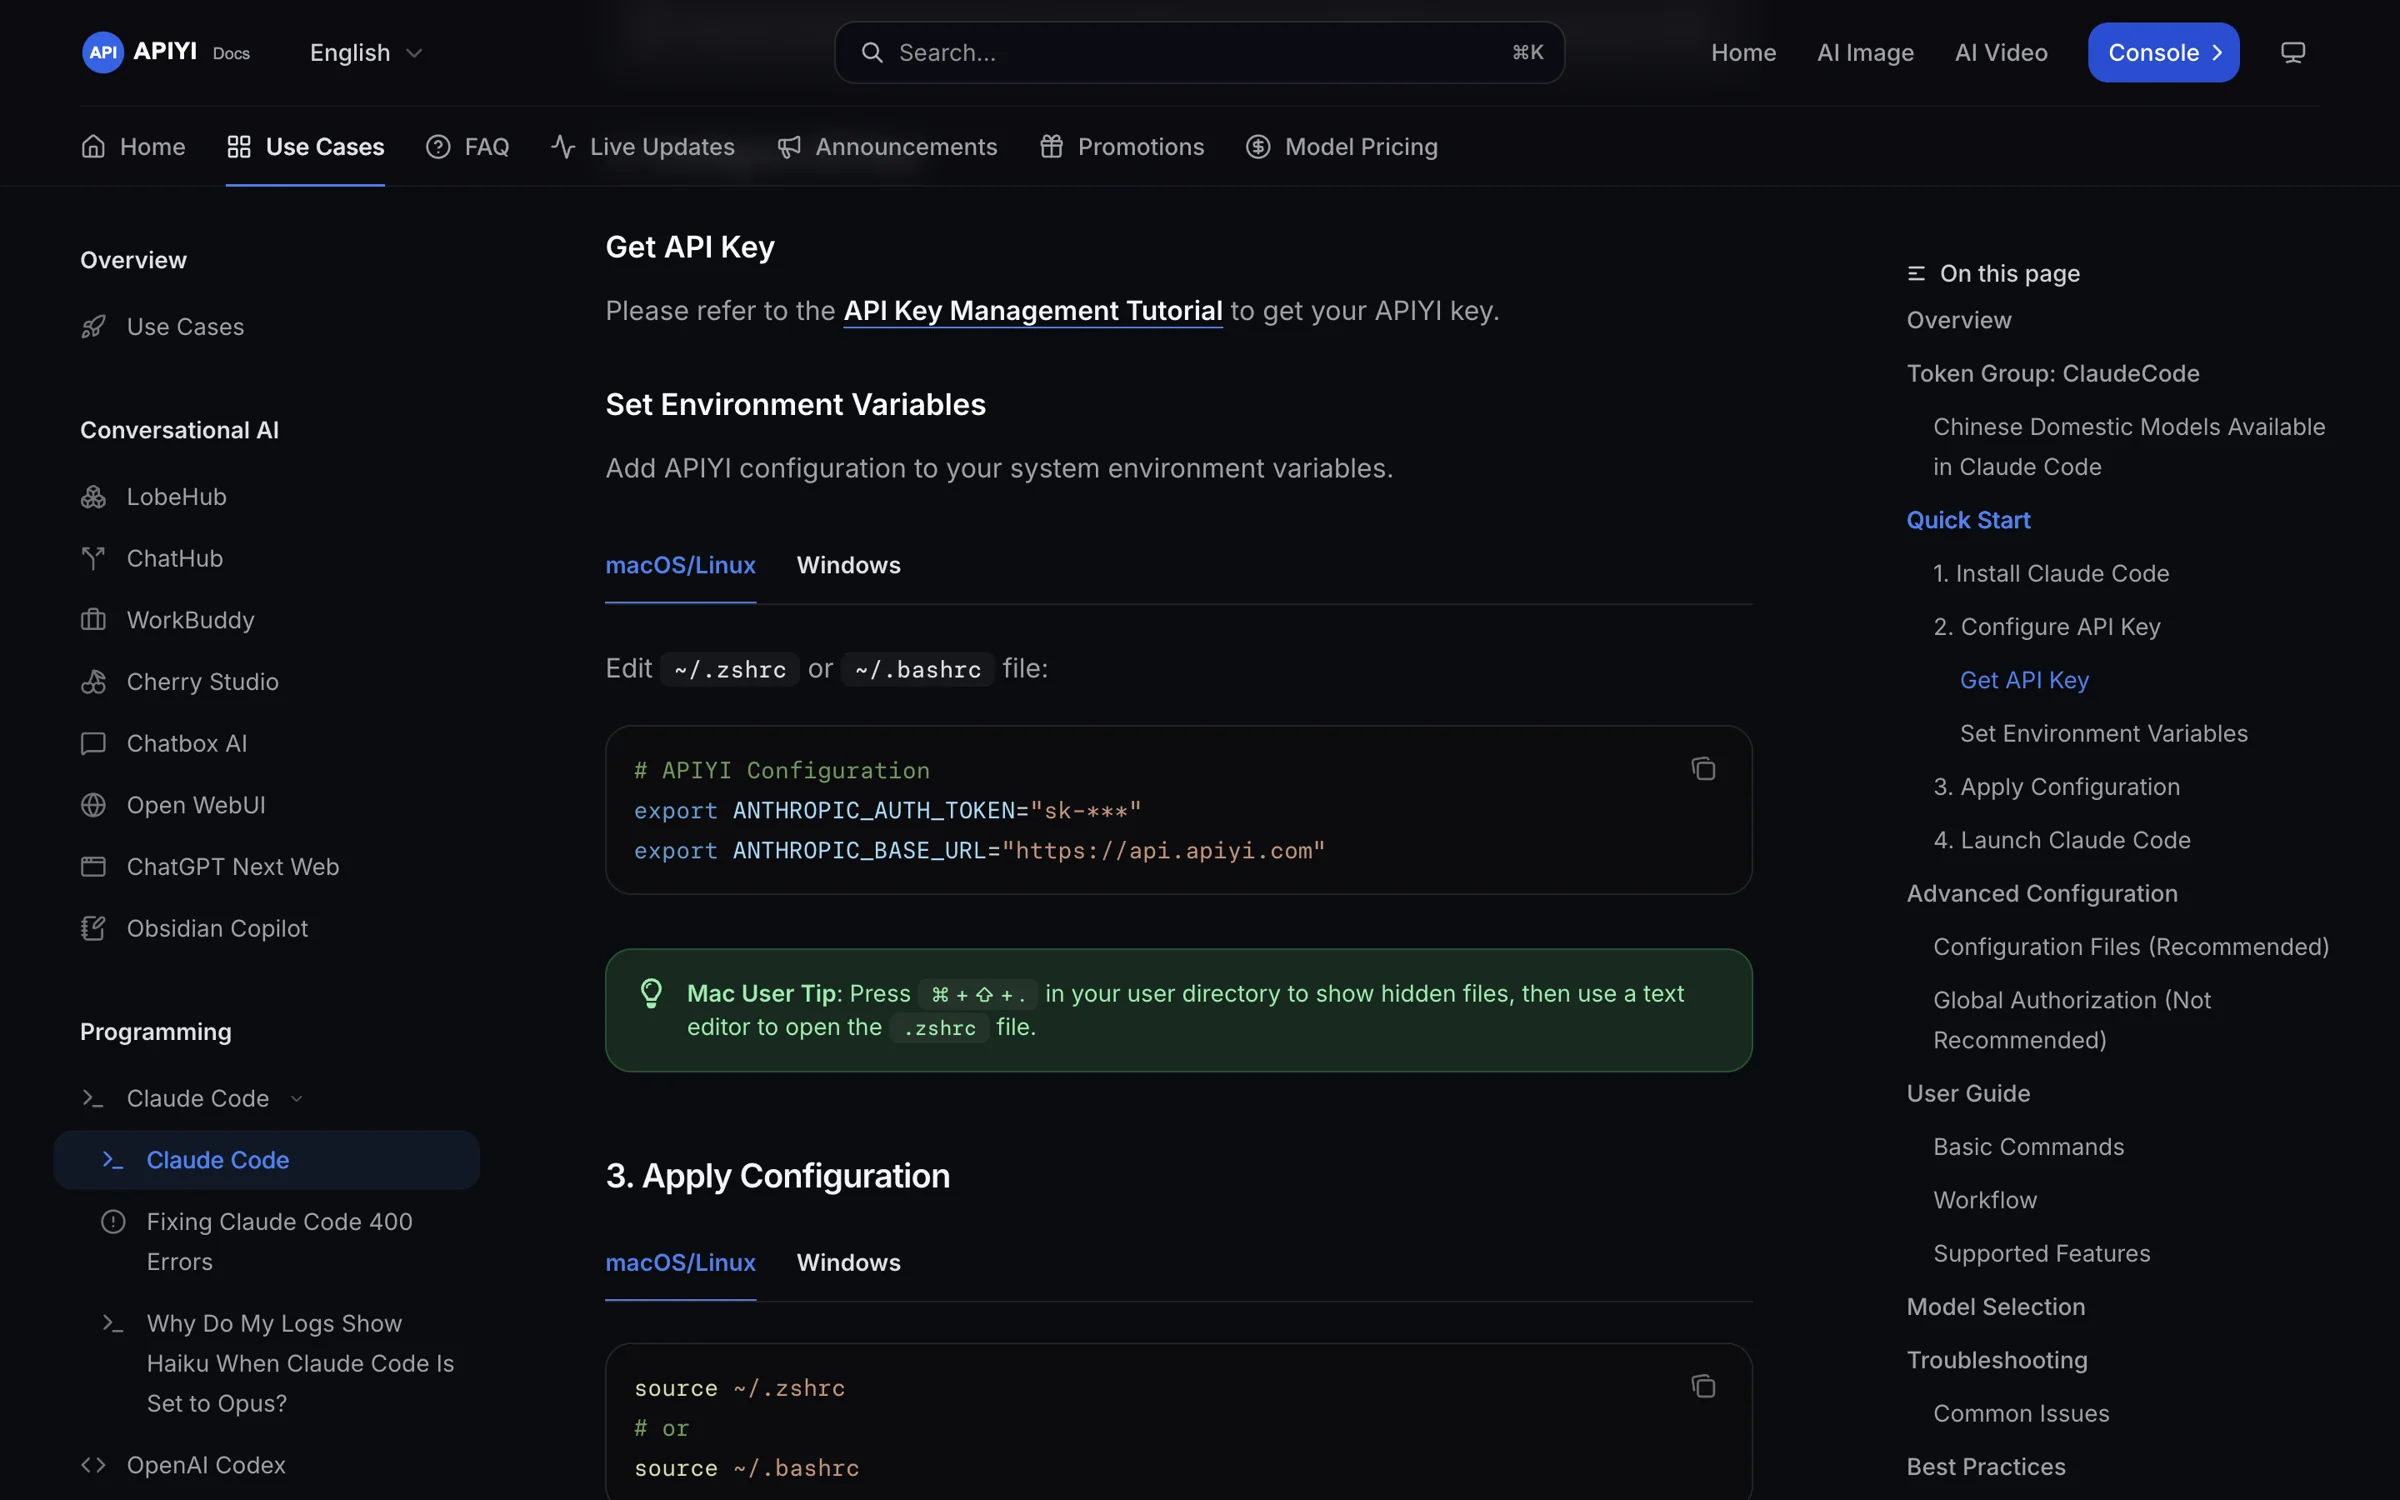
Figure 4 : configuration de Claude Code dans la documentation APIYI. Deux lignes de variables d’environnement suffisent (la clé API est masquée sur la capture).
| Modèle | Entrée | Sortie | Lecture du cache | Plateforme disponible |
|---|---|---|---|---|
| claude-opus-5-5 | 4 $ / million de tokens | 20 $ / million de tokens | 0,2 $ / million de tokens | APIYI apiyi.com |
Consultez la liste des modèles de la plateforme pour connaître les modèles et les tarifs à jour. Les invites destinées aux compétences de recherche incluent souvent le même fichier SKILL.md à plusieurs reprises. La lecture du cache coûte vingt fois moins cher que les tokens d’entrée : sur les longues sessions, l’économie peut être appréciable.
Trois scénarios concrets pour tester des Skills de recherche scientifique
Scénario 1 : analyse de cellules uniques
Invite : Use available skills you have access to whenever possible. Puis ajoutez : « Utilise scanpy pour le contrôle qualité, la normalisation, la réduction de dimension et le clustering ; cellxgene-census comme référence pour les types cellulaires ; database-lookup pour rechercher les gènes marqueurs ; et pydeseq2 pour l’analyse de l’expression différentielle. » L’agent lit ces compétences dans l’ordre, puis génère et exécute les scripts d’analyse.
Pour valider le résultat, vérifiez trois points : les seuils de contrôle qualité sont-ils indiqués ? Le fichier de résultats du clustering existe-t-il ? Les gènes différentiellement exprimés figurent-ils dans les sources renvoyées par database-lookup ?
Scénario 2 : revue de littérature
Invite : « Utilise la compétence literature-review pour réaliser une revue systématique sur un sujet précis, complète les références avec paper-lookup, puis utilise scientific-writing pour préparer une première version. » Cette compétence vérifie les DOI en ligne : ouvrez donc chaque DOI pour confirmer que la publication existe et que les auteurs et l’année sont corrects.
Scénario 3 : criblage de composés
Invite : « Utilise database-lookup pour récupérer une série de molécules candidates dans PubChem et ChEMBL, filtre-les avec rdkit selon une masse moléculaire de 300 à 500 et un logP de 2 à 4, puis produis un fichier CSV. » Pour valider le résultat, vérifiez vous-même quelques entrées : recalculez leur masse moléculaire avec RDKit et comparez-la à celle du CSV ; recherchez ensuite leurs identifiants dans PubChem pour confirmer qu’ils correspondent aux bons composés.
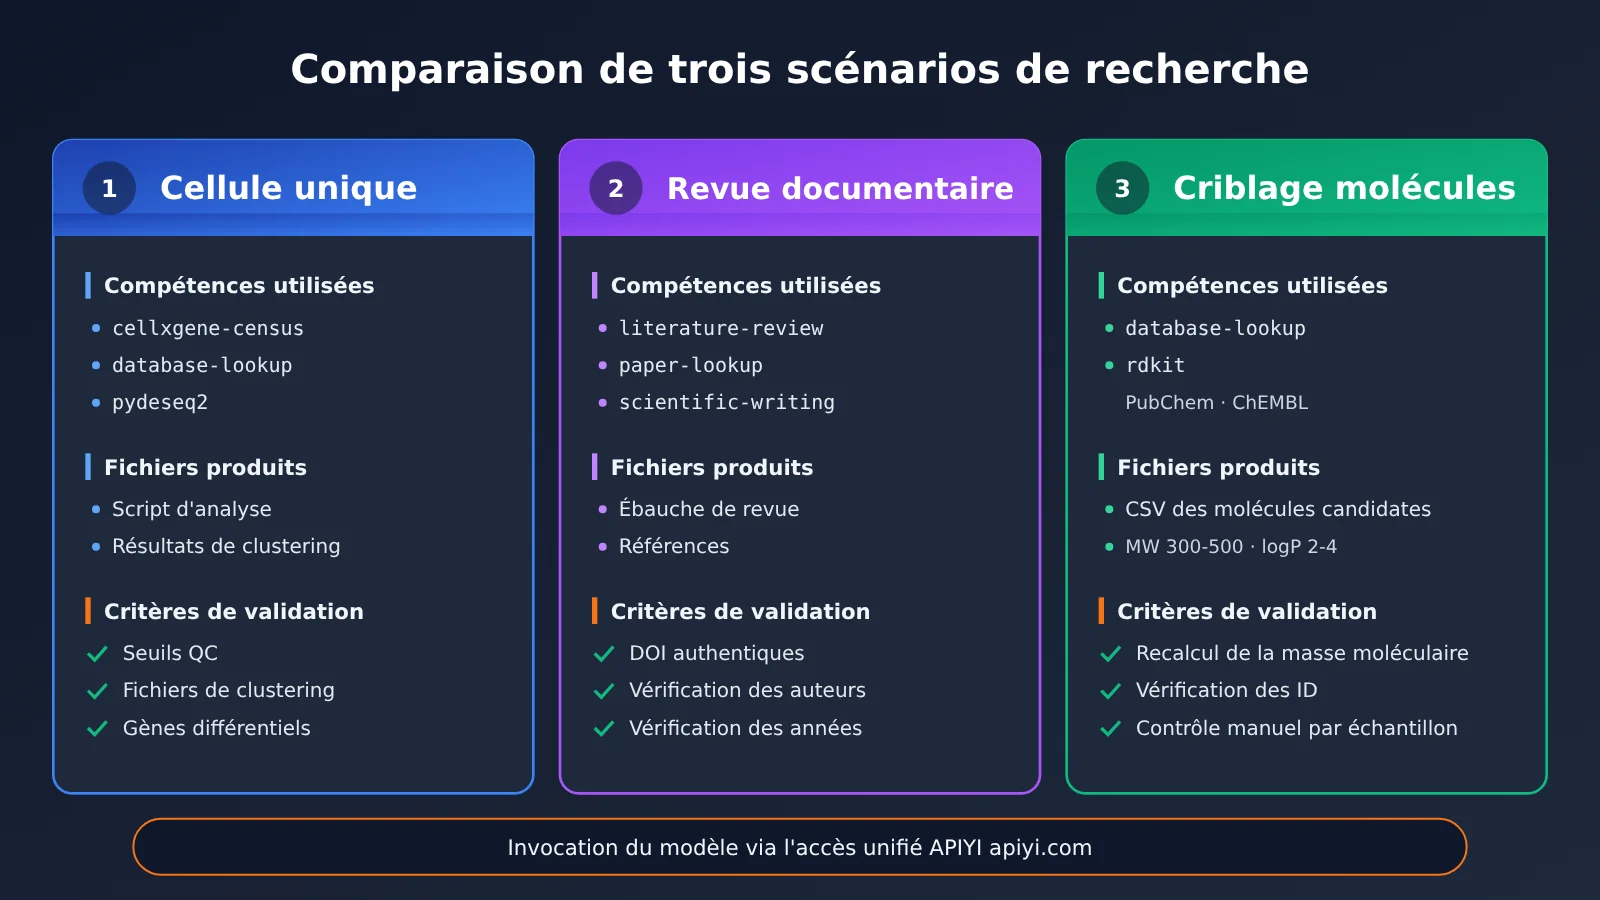
Tableau de dépannage des Skills pour la recherche
| Symptôme | Cause fréquente | Solution |
|---|---|---|
| Le Skill ne se charge pas | Le répertoire est mal placé ou ne contient pas de fichier SKILL.md |
Vérifiez les chemins dans le tableau de l’étape 3, puis redémarrez l’IDE. Dans Cursor, vérifiez dans Settings → Rules si le Skill est reconnu |
| Dépendances Python manquantes | Les fichiers du Skill ont été installés, mais pas ses dépendances | Installez-les avec uv pip install selon la section compatibility de SKILL.md et vérifiez que le bon environnement est activé |
| Limite de requêtes de la base de données atteinte | Les requêtes par lots sont trop rapides ou dépassent le quota gratuit | Consultez la documentation de la base, ajoutez un cache, répartissez les requêtes en lots et réduisez le nombre de requêtes simultanées |
| Erreur d’authentification | La clé n’est pas définie, a expiré ou ne dispose pas des permissions nécessaires | Utilisez echo pour vérifier la variable d’environnement, puis contrôlez les permissions dans l’interface du service concerné |
L’ancien chemin scientific-skills/ renvoie une erreur 404 |
Depuis la version v2.43.0, les Skills se trouvent dans skills/ |
Mettez à jour le chemin dans vos scripts locaux et vos favoris, ou réinstallez les Skills |
| Besoin de désinstaller puis de réinstaller | Les versions sont mélangées ou le lien symbolique ne fonctionne plus | Exécutez npx skills remove, puis npx skills add. Pour fixer une version, utilisez gh skill install --pin |
Blocage sur Cloning repository…, suivi de l’erreur Clone timed out |
Le dépôt pèse plus de 400 Mo et le délai de 300 secondes ne suffit pas | Relancez avec SKILLS_CLONE_TIMEOUT_MS=600000, ou utilisez d’abord git clone puis installez depuis le chemin local |
Risques et avertissement concernant les Skills pour la recherche
Prenez le temps de lire cette section. Scientific Agent Skills est un projet open source communautaire, pas une API officielle d’une plateforme. Nous le recommandons, mais nous ne nous portons pas garants de son fonctionnement.
Les compétences peuvent exécuter des actions. Elles peuvent demander à un agent d’exécuter du code arbitraire, d’installer des paquets, d’envoyer des requêtes réseau ou de modifier des fichiers locaux. Une compétence malveillante ou mal conçue peut détourner l’agent de sa tâche. Voici les précautions recommandées :
- Avant l’installation, lisez
SKILL.mdpour vérifier les paquets utilisés et les services externes contactés - Consultez l’historique des contributions : les compétences signées K-Dense-AI ont fait l’objet d’une revue interne ; celles de la communauté sont examinées dans la mesure du possible
- Effectuez aussi votre propre analyse : exécutez d’abord
uv pip install cisco-ai-skill-scanner, puisskill-scanner scan <path> --use-behavioral, en remplaçant<path>par le répertoire de la compétence. Le projet effectue des analyses incrémentales chaque semaine et une analyse complète au moins tous les 30 jours. Les résultats sont publiés dansdocs/security-report.md
Contraintes des services tiers. Certaines compétences nécessitent une inscription à des bases de données tierces ou l’utilisation de votre propre clé. Vous devez alors respecter les conditions et les quotas de ces services. La collecte de données en masse peut entraîner une limitation du débit, voire la suspension du compte. Faites d’abord vos essais avec un compte secondaire ou dans un environnement isolé.
Limites cliniques et réglementaires. Les compétences liées à la clinique, à la médecine ou à la réglementation servent uniquement à la recherche et à la rédaction. Elles ne remplacent pas les décisions de diagnostic, de mise en circulation ou de certification.
Responsabilité. Il appartient à chaque utilisateur d’évaluer et d’assumer les conséquences de l’utilisation de ces compétences. Ni cette plateforme ni l’auteur de cet article ne peuvent en être tenus responsables.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce que Scientific Agent Skills exactement ?
C’est une bibliothèque de compétences pour la recherche, maintenue par K-Dense-AI. Elle comprend 177 dossiers de compétences conformes au standard Agent Skills. Ils indiquent à l’agent comment mener un processus de recherche, quels packages utiliser et à quelles bases de données se connecter. Ce n’est ni un modèle ni un service API.
Q2 : Pourquoi est-il déconseillé d’installer les 177 compétences en une seule commande ?
D’abord, le README officiel déconseille explicitement de tout installer d’un coup. Ensuite, plus il y a de compétences, plus l’agent risque d’avoir du mal à choisir la bonne. Enfin, chaque compétence peut exécuter du code : plus vous en installez, plus vous avez de contenu à vérifier. Choisissez-en 5 à 10 selon votre domaine : cela suffit généralement.
Q3 : Pourquoi y a-t-il maintenant 177 compétences au lieu de 181 ?
Depuis la version 2.72.0, les quatre compétences documentaires docx, pdf, pptx et xlsx ne sont plus distribuées avec le dépôt. Si vous en avez besoin, installez-les séparément depuis le dépôt skills d’Anthropic.
Q4 : Si les compétences sont gratuites, d’où viennent les coûts ?
Ils viennent principalement des invocations du modèle lors de l’exécution des compétences. Certaines peuvent aussi entraîner des frais de services tiers : par exemple, `generate-image` passe par OpenRouter, avec une facturation à l’utilisation. Pour le modèle, APIYI apiyi.com propose une facturation à l’usage, sans abonnement mensuel fixe. Vous pouvez ainsi tester un petit processus pour mesurer sa consommation de tokens, puis choisir le modèle à utiliser à long terme.
Q5 : J’ai installé les compétences dans Cursor, mais l’agent ne les utilise pas. Que faire ?
Vérifiez d’abord dans Settings → Rules que les compétences sont bien reconnues. Ajoutez ensuite `Use available skills you have access to whenever possible.` au début de votre invite et nommez explicitement la compétence à utiliser. Si l’agent ne l’utilise toujours pas, essayez un autre modèle pour comparer. Avec APIYI apiyi.com, une seule clé API permet de passer d’un modèle à l’autre, ce qui facilite le diagnostic.
Q6 : Comment garantir la reproductibilité des résultats de recherche ?
Utilisez `gh skill install –pin` pour fixer la compétence à une version ou à un commit précis. Fixez également les versions des dépendances Python dans un environnement uv dédié, et notez la valeur de metadata.version ainsi que la date last-reviewed indiquées dans `SKILL.md`.
Q7 : Toutes ces compétences sont-elles sous licence MIT ?
Pas nécessairement. Le dépôt dans son ensemble est sous licence MIT, mais chaque compétence possède son propre champ license. Par exemple, `scanpy` est sous licence BSD-3-Clause. Vérifiez-les une par une avant toute utilisation commerciale.
Skills pour la recherche : points clés
- De quoi s’agit-il ? 177 compétences de recherche open source, réparties dans les 22 grandes catégories listées dans le README
- Installation : consultez d’abord la liste avec
--list, puis utilisez-set-apour n’installer que les compétences nécessaires - Prérequis : Node.js 22.20+, Python 3.13+, uv et un environnement hôte compatible avec la norme Agent Skills
- Piège fréquent : installer les fichiers de compétences ne suffit pas à installer leurs dépendances ; créez un environnement uv distinct pour chaque workflow
- Vérification : confirmez quelle compétence a été utilisée, dans quel répertoire se trouvent les résultats et si les chiffres correspondent aux sources
- Sécurité : lisez
SKILL.mdavant l’installation et lancez une analyse avec le scanner Cisco - Coût : les compétences sont gratuites ; les invocations de modèles peuvent être centralisées et comparées via APIYI apiyi.com
En résumé
Ces 177 Skills pour la recherche sont très pratiques, mais mieux vaut procéder dans l’ordre et ne pas en installer trop d’un coup :
- Vérifiez votre environnement avant l’installation : confirmez les versions et la compatibilité de l’hôte, puis sélectionnez 5 à 10 compétences avec
--list - Installez les compétences et les dépendances séparément : les fichiers de compétences s’installent avec
npx skills add, et les dépendances Python avec uv. Les deux étapes sont nécessaires - Assurez-vous que les résultats sont vérifiables : à chaque exécution, vérifiez quelle compétence a été utilisée, où se trouvent les résultats et d’où viennent les chiffres
Commencez par un petit workflow que vous maîtrisez bien, par exemple un clustering avec scanpy sur un petit jeu de données. Parcourez-le de bout en bout, puis ajoutez progressivement des compétences. Côté modèles, vous pouvez démarrer avec la facturation à l’usage d’APIYI apiyi.com, puis choisir un modèle à long terme en fonction de votre consommation de tokens.
📚 Ressources
- Dépôt Scientific Agent Skills : code source des compétences, README et rapport de sécurité
- Lien :
github.com/K-Dense-AI/scientific-agent-skills -
Description : contient 177 compétences, les instructions d’installation et de dépannage, ainsi que
docs/security-report.md -
Installateur skills : commandes et paramètres de npx skills
- Lien :
github.com/vercel-labs/skills -
Description : consultez les commandes add / list / check / update / remove et la correspondance des répertoires pour plus de 70 hôtes
-
Dépôt Anthropic Skills : compétences pour les documents docx, pdf, pptx et xlsx
- Lien :
github.com/anthropics/skills -
Description : après la version 2.72.0, ces quatre compétences doivent être installées séparément depuis ce dépôt
-
Article associé : Scientific Agent Skills: A Library of Procedural Knowledge for Research Agents
- Lien :
arxiv.org/abs/2609.00065 -
Description : pour comprendre les principes de conception de la bibliothèque de compétences
-
Documentation APIYI · Connexion à Claude Code : variables d’environnement, groupes et dépannage
- Lien :
docs.apiyi.com/scenarios/programming/claude-code -
Description : connectez Claude Code à APIYI avec deux variables d’environnement, puis utilisez le modèle une fois les compétences installées
-
Documentation APIYI · Skills de génération d’images GPT-Image 2 : deux compétences de génération d’images proposées par la communauté
- Lien :
docs.apiyi.com/scenarios/ecosystem/apiyi-gpt-image-skills -
Description : paramètres, facturation et erreurs courantes pour
apiyi-gpt-image-2-genetapiyi-gpt-image-2-all-gen -
Tableau des tarifs des modèles APIYI : modèles, types, modes de facturation et prix unitaires
- Lien :
docs.apiyi.com/models - Description : le prix unitaire de claude-opus-5-5 cité dans cet article est basé sur ce tableau. Les prix peuvent changer : vérifiez-les avant utilisation
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI. Pour en savoir plus sur l’intégration des modèles, consultez la documentation sur docs.apiyi.com