Nota del autor: OpenAI ha anunciado su intención de adquirir Pierre. En este artículo analizamos sus cinco productos: Trees y Diffs, que Codex ya utiliza, además de Highlights, DiffsHub y el servicio de pago Code Storage. Así podrás distinguir qué componentes de código abierto puedes usar directamente.
El 4 de noviembre de 2026, OpenAI anunció que tiene previsto adquirir Pierre Computer Company, una empresa de herramientas para desarrolladores. La primera reacción de mucha gente fue pensar que «OpenAI ha comprado otra empresa de alojamiento Git», pero esa interpretación no es del todo precisa. Pierre cuenta con un conjunto de tecnologías que abarca la exploración de código, la comparación de diferencias, la edición en línea, el resaltado de sintaxis y el almacenamiento Git. Además, dos de sus productos ya se usan en la aplicación Codex.
Esto no es un rumor ni una simple noticia de última hora. El anuncio oficial de OpenAI confirma que Codex utiliza las bibliotecas Trees y Diffs de Pierre. Sus repositorios de código abierto y paquetes de NPM también se pueden consultar públicamente. Eso sí, la operación todavía no se ha cerrado y no se ha revelado el importe de la adquisición.
Qué encontrarás aquí: un mapa claro de las tecnologías y productos de Pierre para distinguir entre componentes de código abierto, herramientas en línea y servicios de almacenamiento de pago, y saber cuáles puedes incorporar hoy mismo a tus proyectos.
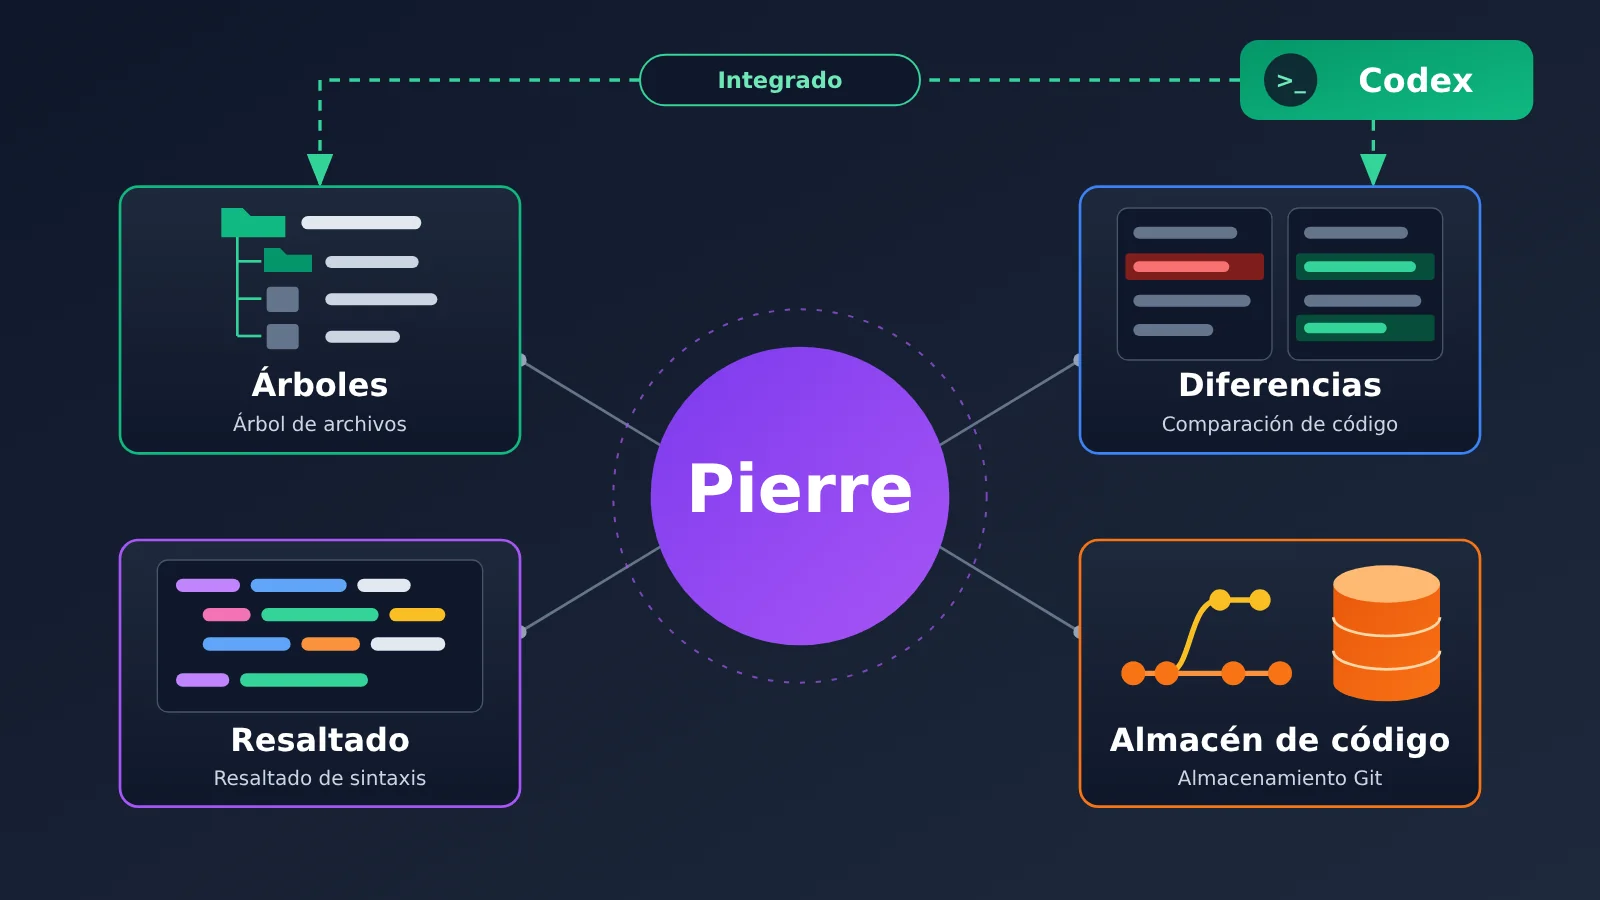
Claves de la adquisición de Pierre de un vistazo
Primero, separemos los hechos confirmados de lo que todavía no se sabe. Esta tabla recoge únicamente lo que OpenAI y los canales oficiales de Pierre han comunicado de forma explícita.
| Dato | Confirmado | No publicado o sin confirmar |
|---|---|---|
| Estado de la operación | El 2026-11-04 se anunció la intención de adquirir Pierre, sujeta a las condiciones habituales de cierre y a la aprobación regulatoria | Fecha de cierre, importe de la adquisición y valoración |
| Situación actual de Codex | La aplicación Codex ya utiliza las bibliotecas Trees y Diffs | Si el código de los usuarios de Codex se migrará a Code Storage |
| Planes futuros | Explorar gradualmente la incorporación de las capacidades de Code Storage a Codex | Calendario completo de integración y nuevos precios |
| Compromiso con el código abierto | Los proyectos de código abierto de Pierre seguirán siéndolo y OpenAI continuará contribuyendo | Planes de mantenimiento a largo plazo para cada versión |
| Clientes actuales | Los clientes actuales de Code Storage podrán seguir utilizándolo después de la operación | Política de precios a largo plazo y planes de migración de datos |
Hasta el cierre de la operación, ambas empresas seguirán funcionando de manera independiente. Axios interpreta esta adquisición como una expansión de Codex hacia la colaboración en código, un terreno dominado durante mucho tiempo por GitHub. Sin embargo, esa es la lectura de un medio sobre la competencia: OpenAI no ha anunciado que vaya a lanzar una alternativa completa a GitHub.
Mapa tecnológico de Pierre: componentes de código abierto, herramientas en línea y almacenamiento de pago
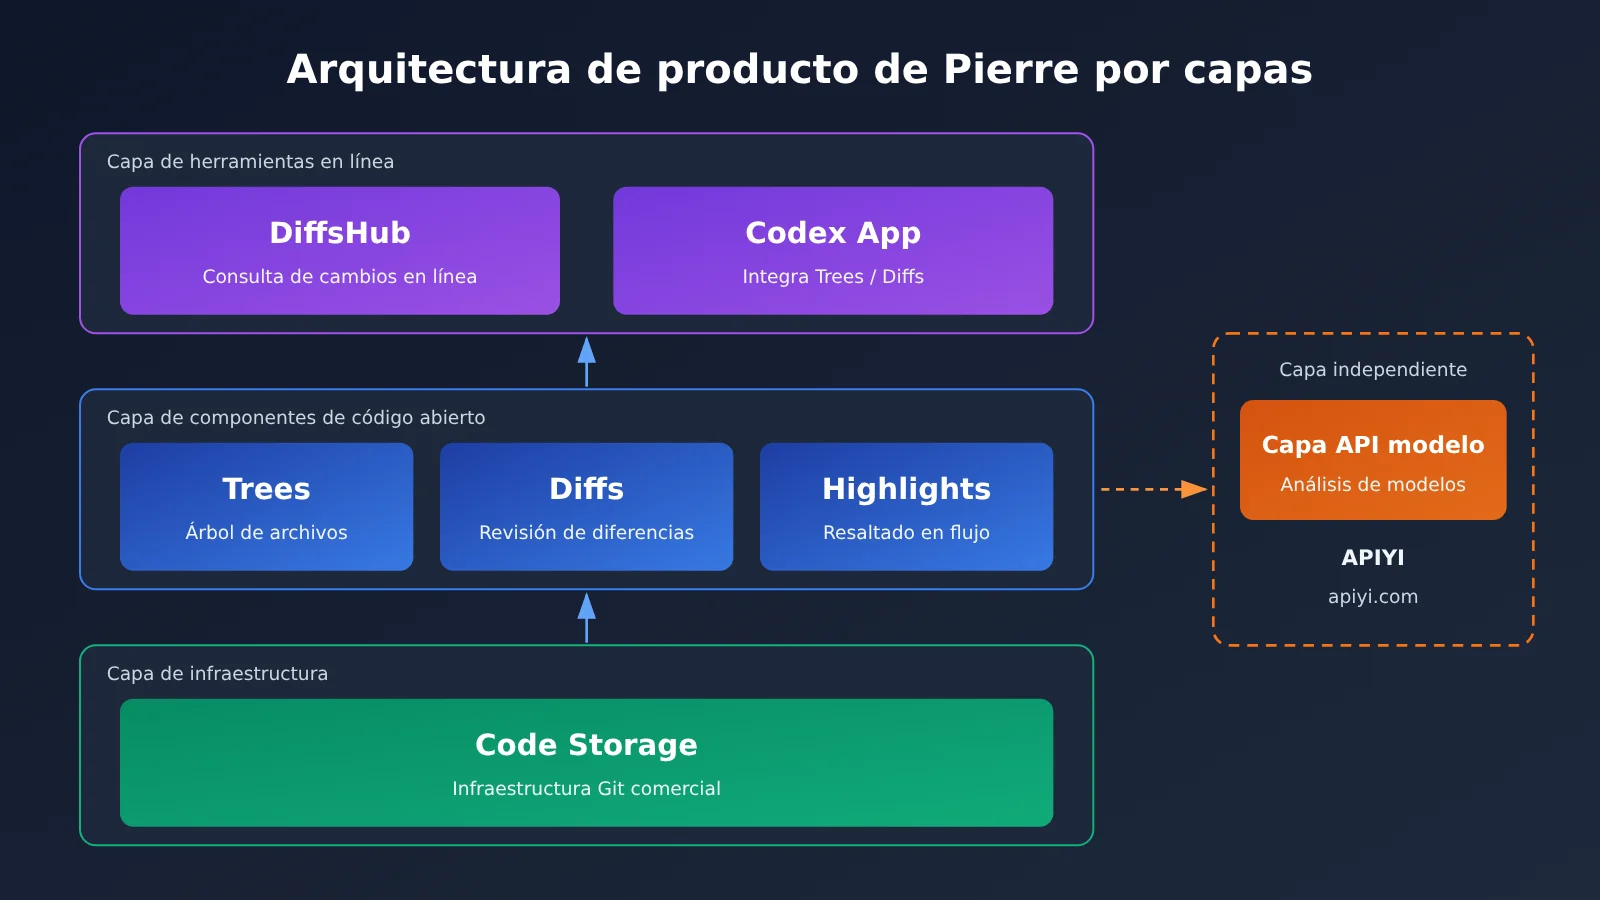
Para entender Pierre, conviene dividir sus productos en tres capas. Pierre no es una empresa dedicada a entrenar Modelos de Lenguaje Grande ni vende API de modelos. Lo que ofrece es el software y la infraestructura necesarios para mostrar, editar, almacenar y gestionar código. En su sitio web, se presenta como una plataforma de «infraestructura de bajo nivel y componible para cargas de trabajo impulsadas por máquinas».
| Producto | Capa | Problema que resuelve | Cómo obtenerlo |
|---|---|---|---|
| Trees | Componente de código abierto | Cómo explorar los archivos de un proyecto | pnpm add @pierre/trees |
| Diffs | Componente de código abierto | Cómo ver, comparar y editar cambios en el código | pnpm add @pierre/diffs |
| Highlights | Función de resaltado (Beta) | Cómo mostrar el resaltado de sintaxis rápidamente y en streaming | Consulta la documentación oficial de Diffs |
| DiffsHub | Herramienta en línea | Cómo explorar cambios de código de GitHub en la web | Visita diffshub.com |
| Code Storage | Servicio comercial | Cómo almacenar código a gran escala mediante Git y API | Pago por uso, con consumo mínimo mensual |
La parte de código abierto se concentra en el repositorio de GitHub pierrecomputer/pierre, bajo la licencia Apache License 2.0. Al 2026-11-05, el repositorio tenía aproximadamente 6,500 estrellas, 266 forks y unos 1,320 commits; estas cifras son una instantánea y pueden cambiar. Ten en cuenta que este repositorio no incluye todo el código del backend comercial de Code Storage.
Pierre Diffs por dentro: Edit Mode, interfaz de revisión y Merge Conflict
El paquete de código abierto de Diffs es @pierre/diffs. En el momento de la comprobación, la página oficial mostraba la versión v1.6.4 y el punto de entrada para React era @pierre/diffs/react. Su función principal es mostrar en una página web archivos de código, parches y diferencias entre dos versiones. Ofrece dos vistas: Split, con los cambios lado a lado, y Stacked/Unified, con los cambios combinados verticalmente. También puede resaltar diferencias de caracteres y palabras dentro de una línea. Los desarrolladores pueden proporcionar las dos versiones de un archivo o directamente un archivo de parche.
Diffs Edit Mode: modifica código directamente en la vista de diferencias
OpenAI destacó esta función en su anuncio: permite a quien revisa modificar una línea de código directamente en la vista Diff. Edit Mode admite selección y selección múltiple, sangría automática, deshacer y rehacer, búsqueda dentro del archivo, indicadores de lint, acciones de edición personalizadas y cursores locales y remotos. Además, ofrece EditProvider y las API de Editor relacionadas. Algunas funciones de edición siguen marcadas como Beta.
Esto resuelve un problema muy concreto: en un flujo tradicional, si detectas un error en una línea de código generado por IA, tienes que cambiar al editor completo, localizar el archivo, modificarlo y volver a la interfaz de revisión. Edit Mode reúne la detección y la corrección de problemas en una misma interfaz, algo especialmente útil cuando un agente genera muchos cambios y una persona los revisa por partes.
Interfaz de revisión de código de Diffs: un framework de anotaciones extensible
Diffs ofrece un framework flexible de anotaciones que permite asociar comentarios por línea, resultados de comprobaciones de CI, observaciones de revisión de IA y resultados de herramientas de terceros a líneas concretas de código. Los desarrolladores también pueden añadir botones personalizados a la vista de diferencias, como Accept Change y Reject Change, además de permitir respuestas a comentarios y explicaciones sobre las líneas seleccionadas.
Conviene dejar claro el límite: Diffs es un componente de visualización e interacción, no un modelo de IA que detecte vulnerabilidades automáticamente. El origen de las observaciones de revisión lo decide tu propio sistema. Por ejemplo, puedes conectar una API de un Modelo de Lenguaje Grande para generar sugerencias y luego usar Diffs para mostrarlas.
Diffs Merge Conflict: gestión estructurada de conflictos
Cuando un Diff de texto convencional encuentra un conflicto de combinación, solo puede mostrar una serie de marcadores de conflicto. Diffs ofrece una interfaz específica que presenta las zonas en conflicto como contenido añadido y eliminado de forma estructurada. Así, el usuario puede elegir entre conservar la versión actual, aceptar la versión entrante o mantener ambas, y después obtener una vista previa del archivo con el conflicto resuelto.
En cuanto a la implementación técnica, la documentación oficial indica que es compatible con Vanilla JavaScript y React, utiliza Shiki para el resaltado de sintaxis y emplea CSS Grid y Shadow DOM para organizar parte de la estructura de renderizado. También ofrece herramientas de SSR, Worker Pool y renderizado virtualizado. Este último evita que el navegador renderice de una sola vez grandes cantidades de contenido que no está visible.
Pierre Trees y Highlights: árboles de archivos grandes y resaltado en streaming
Trees: un componente de árbol de archivos diseñado para repositorios grandes
El paquete de código abierto de Trees es @pierre/trees; en el momento de la revisión, la versión que mostraba el sitio oficial era v1.0.0-beta.6. Se encarga de la barra lateral de navegación de archivos en herramientas como Codex. Permite expandir y contraer directorios, buscar y filtrar por nombre o ruta, comprimir automáticamente cadenas de directorios vacíos con un solo subdirectorio, arrastrar archivos y directorios, crear y renombrar elementos, y personalizar los menús contextuales y los iconos de archivos.
La función más relevante para la programación con IA es la visualización del estado de Git. Junto a cada archivo pueden aparecer las marcas M (modificado), A (añadido y preparado), D (eliminado), R (renombrado) y U (sin seguimiento). Los directorios que contienen archivos modificados también pueden mostrar una marca. Así, cuando un agente cambia decenas de archivos de una sola vez, basta con echar un vistazo al árbol para saber dónde están los cambios.
En cuanto al rendimiento, Trees utiliza virtualización automática para renderizar primero solo las filas visibles. El sitio oficial muestra un árbol con 2,956 archivos cuando está completamente expandido, además de una demostración de renderizado virtualizado con decenas de miles de elementos. Son demostraciones oficiales, no benchmarks independientes, y no garantizan el mismo rendimiento en todos los dispositivos. En accesibilidad, Trees ofrece navegación con las teclas de dirección, gestión del foco con Tab y roles ARIA tree/treeitem, entre otras funciones. Según sus creadores, su diseño sigue las pautas pertinentes de WCAG 2.1.
Highlights: resaltado a la velocidad de salida de un agente
Highlights aparece actualmente en versión beta en la documentación oficial de Diffs. Según esta, incluye analizadores léxicos para 152 lenguajes, está basado en WebAssembly y puede ejecutarse en el navegador, Node.js y Cloudflare Workers. Su salida puede ser HTML u objetos de tokens compatibles con Shiki.
Sus cuatro API principales tienen funciones bien definidas: codeToHtml() procesa código completo; codeToTokens() genera tokens organizados por línea; StreamTokenizer sirve para recibir contenido de forma progresiva y emitir las líneas ya completas; y LiveTokenizer realiza actualizaciones incrementales en documentos que se están editando. En pocas palabras, Highlights resuelve un problema de visualización: cómo mantener el resaltado al día mientras un agente genera código en streaming. No mejora la capacidad de programación del modelo.
DiffsHub: cambiar github.com por diffshub.com
DiffsHub es una herramienta en línea de Pierre que muestra cómo funcionan Trees y Diffs en situaciones reales. Si sustituyes github.com por diffshub.com en un enlace de Pull Request, Commit, Comparison, Patch o Diff de GitHub, puedes explorar el mismo conjunto de cambios con la interfaz de Pierre. Entre los ejemplos oficiales hay repositorios como oven-sh/bun y nodejs/node.
Para acceder a repositorios privados, debes proporcionar tu propio GitHub Personal Access Token con los permisos necesarios. El sitio oficial indica que el token se guarda en localStorage del navegador; eso no significa que Pierre pueda leer cualquier repositorio privado. El sitio también advierte que los navegadores móviles pueden fallar con diffs extremadamente grandes. DiffsHub no sustituye a GitHub ni es lo mismo que la biblioteca Diffs de código abierto.
¿En qué se diferencia Pierre Code Storage de un repositorio convencional de GitHub?
Si Trees y Diffs son la capa de interfaz para «ver código», Code Storage es la capa de infraestructura para «almacenarlo» y el eje estratégico de esta operación. Es un servicio de almacenamiento distribuido y programable basado en Git, dirigido a productos de IA que necesitan crear, leer, modificar y sincronizar repositorios a gran escala.
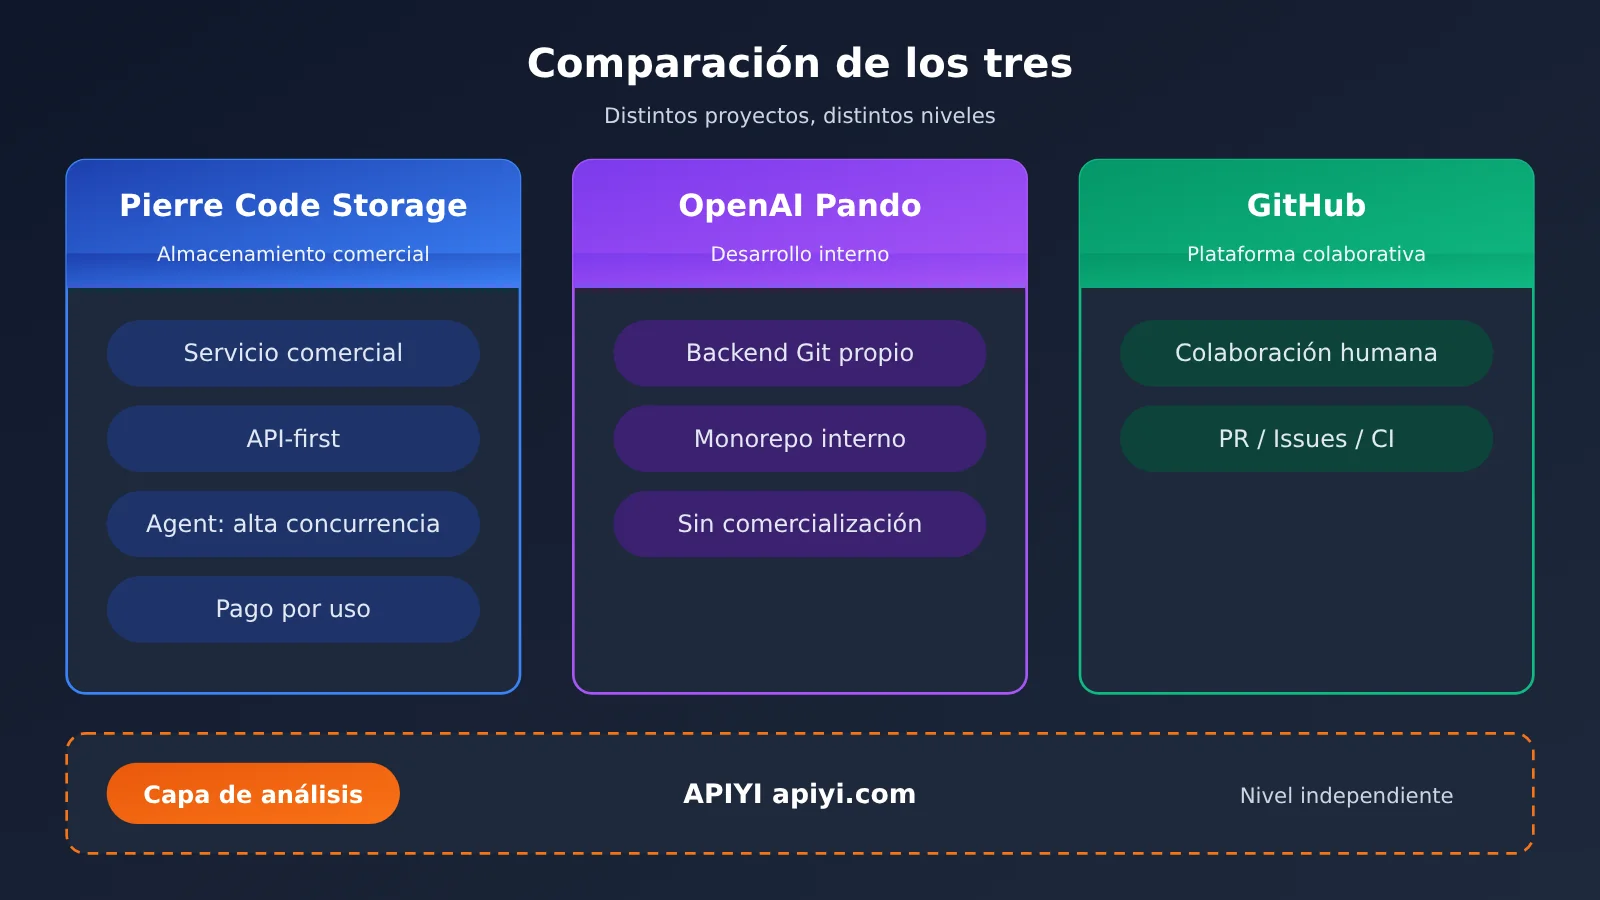
GitHub se centra en la colaboración entre personas: repositorios, PR, Issues y CI/CD. Code Storage apuesta por un enfoque headless y API-first: permite crear repositorios, commits, ramas y merges mediante API, escribir archivos directamente, leerlos en streaming y filtrar bases de código con Grep y Glob. También ofrece ramas temporales (Ephemeral Branches), Webhook, Git LFS y sincronización con GitHub, GitLab y Bitbucket. Las operaciones Clone, Push y Fetch del protocolo estándar Git over HTTPS también están disponibles.
En un hilo de Hacker News sobre Code Storage (66 puntos y 42 comentarios), Pierre puso un ejemplo: después de que un agente modifique 10 archivos, hacer el commit con la API REST de GitHub requiere obtener el SHA de la rama, crear la rama, los objetos Blob y Tree, el commit y, por último, actualizar la referencia. Son unas 15 solicitudes y, con cargas elevadas, también hay que gestionar los errores 422 causados por la consistencia eventual. Con Code Storage, en cambio, se puede enviar el diff completo con una sola llamada a createCommitFromDiff. Esta es la explicación del proveedor en la comunidad, no una prueba comparativa independiente.
| Indicador (según el sitio oficial) | Valor | Naturaleza del dato |
|---|---|---|
| Tamaño máximo por repositorio | 32 TB | Especificación del producto |
| Almacenamiento total y número de repositorios | Sin límite general | Especificación del producto |
| Escrituras concurrentes | 30+ | Especificación del producto |
| Solicitudes Git por repositorio | Se han observado 500+ por segundo | Dato observado por el proveedor, no garantizado |
| Solicitudes API | Se han observado 15.000+ por segundo | Dato observado por el proveedor, no garantizado |
| Disponibilidad | SLA del 99,99 % | Compromiso de servicio, no una tasa histórica medida de forma independiente |
En cuanto a la arquitectura, la empresa afirma que utiliza un protocolo de confirmación en tres fases de Git y una arquitectura basada en quorum de tipo «Spoke-like» para garantizar la consistencia y la durabilidad en entornos distribuidos, aunque no ha publicado la topología completa del clúster. Para empresas, también declara contar con SOC 2 Type II, soporte relacionado con HIPAA, cifrado por inquilino y pruebas de penetración anuales. Antes de contratar, conviene verificar los informes y las condiciones contractuales.
Los casos de clientes también han sido publicados por la propia Pierre. El caso de Lovable revela que se crean más de 8 millones de repositorios nuevos por semana, con picos de 250 por segundo. Poke utiliza Git para guardar la memoria de los agentes y la configuración de sus flujos de trabajo, y declara una latencia P95 de Push de 90 milisegundos. Skydive da a más de 150 agentes su propio repositorio privado para guardar definiciones de identidad, configuración de MCP, Skills y memoria persistente. Estos casos apuntan a una tendencia: los repositorios Git están pasando de «almacenar código» a también «almacenar el estado de los agentes».
Novedades del SDK, la CLI y las Agent Skills de Pierre
El día anterior al anuncio de la adquisición, el 3 de noviembre de 2026, Pierre lanzó un nuevo SDK y una CLI unificados. El cambio más importante es que el SDK, la CLI y la API HTTP usan nombres de operaciones coherentes. Por ejemplo, para crear una rama se utilizan, respectivamente, pierre.repos.branches.create(), pierre repos:branches create y /api/repos/{repo_name}/branches/create. Así, un agente puede usar el mismo «catálogo de operaciones» para cambiar entre interfaces.
# SDK de TypeScript (Node.js 22 / 24 / 26)
npm install @pierre/sdk

# SDK de Python (Python 3.10+)
pip install pierre-sdk

# SDK de Go (Go 1.25+)
go get github.com/pierrecomputer/sdk/go

# CLI
npm install -g @pierre/cli

# Instalar Pierre Skills para agentes de programación
npx skills add pierrecomputer/skills

# Crear una rama a partir de main con la CLI
pierre repos:branches create feature/preview --repo-name my-repo --base-ref main
La autenticación utiliza las variables de entorno PIERRE_ORG y PIERRE_PRIVATE_KEY. Para cada operación, el SDK emite un token con los permisos adecuados y una validez de 5 minutos. El nuevo SDK sustituye a los paquetes anteriores @pierre/storage, pierre-storage y code-storage-go, que aún se pueden usar, pero ya no recibirán nuevas versiones. Es importante aclarar que este SDK y esta CLI están diseñados para Code Storage; eso no significa que Codex CLI de OpenAI haya incorporado nuevos comandos integrados.
Cómo se calcula el precio de Pierre Code Storage
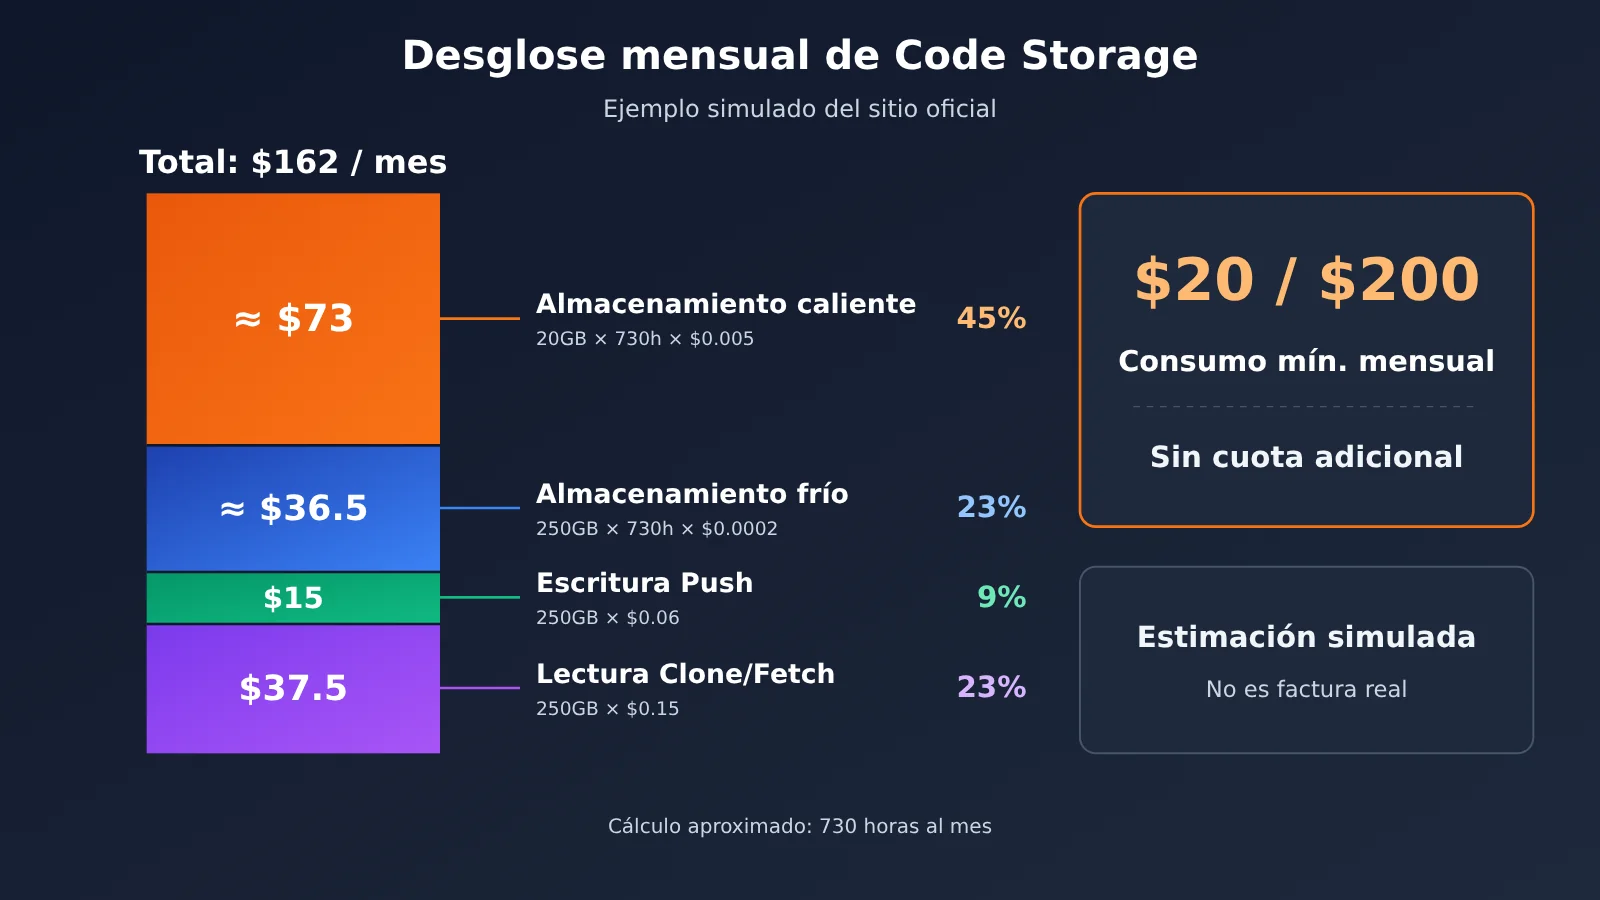
El precio de Code Storage se presta a confusión. Starter figura a $20/mes y Scale a $200/mes, pero esas cifras son el consumo mensual mínimo, no una suscripción fija que se cobra además del uso. Es decir, si un usuario de Starter supera los 20 dólares de consumo en un mes, paga según su uso real; si no llega a esa cifra, paga 20 dólares.
| Concepto | Precio | Descripción |
|---|---|---|
| Starter | Consumo mínimo de $20/mes | Entorno multiinquilino, soporte por correo electrónico |
| Scale | Consumo mínimo de $200/mes | Opción de inquilino único, SSO, soporte 24/7 |
| Enterprise | Contrato personalizado | Opciones de red como VPC; precio no publicado |
| Almacenamiento caliente Hot | $0.005/GB/hora | Datos a los que se ha accedido en los últimos 7 días |
| Almacenamiento frío Cold | $0.0002/GB/hora | Datos a los que no se ha accedido durante más de 7 días |
| Escritura Push | $0.06/GB | Facturación mensual |
| Lectura Clone/Fetch | $0.15/GB | Facturación mensual |
El simulador oficial ofrece este ejemplo: 20 GB de almacenamiento caliente, 250 GB de almacenamiento frío y 250 GB tanto de escritura como de lectura, con un costo estimado de unos $162/mes. Si calculamos aproximadamente 730 horas al mes, el almacenamiento caliente cuesta unos $73, el frío unos $36.5, la escritura $15 y la lectura $37.5: un total de exactamente $162. Como se ve, el tráfico de lectura representa una parte considerable, y esa es una de las razones por las que algunos desarrolladores en HN han criticado el cobro por tráfico de red. Este ejemplo es una estimación simulada, no una factura real. Además, estos precios pertenecen a un sistema de facturación completamente distinto al de la suscripción de Codex y los precios por token de los modelos de OpenAI.
Primeros pasos con la pila tecnológica de Pierre: crea un prototipo de revisión con IA usando Diffs
Los componentes de Pierre no incluyen capacidades de modelo, así que una combinación práctica consiste en obtener los cambios con git diff, llamar a la API de un Modelo de Lenguaje Grande para generar comentarios por línea y entregar los resultados a Diffs como Annotation para que los muestre. El siguiente esquema ilustra la arquitectura; no significa que OpenAI haya lanzado una API integrada para este flujo.
| Capa | Productos representativos | Función en el proceso de revisión | Plataformas disponibles |
|---|---|---|---|
| Almacenamiento | Code Storage / GitHub | Guardar repositorios, ramas e historial | Pierre oficial, plataformas de alojamiento Git |
| Modelo | GPT, Claude, Gemini, entre otros | Leer el Diff y generar comentarios de revisión | APIYI apiyi.com, API oficiales de cada proveedor |
| Interfaz | Diffs + Trees | Mostrar cambios, añadir comentarios y editar en línea | @pierre/diffs, @pierre/trees |
Este ejemplo mínimo ocupa apenas unas líneas: envía el diff al modelo y le pide que devuelva JSON.
import subprocess, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI
)

diff = subprocess.run(["git", "diff", "HEAD~1"], capture_output=True, text=True).stdout
resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Sustituir por cualquier modelo disponible en la plataforma
    messages=[{"role": "user", "content": f"逐行审查以下 diff,返回 JSON 列表 [{{file, line, comment}}]:\n{diff}"}]
)
print(resp.choices[0].message.content)
Ver el código completo de la implementación (incluye análisis de JSON y gestión de errores)
import json
import subprocess
from typing import List, Dict
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM_PROMPT = (
    "你是资深代码审查员。只针对 diff 中新增或修改的行给出意见,"
    "严格输出 JSON 数组,每项包含 file、line、severity、comment 四个字段。"
)

def get_diff(base: str = "HEAD~1") -> str:
    result = subprocess.run(
        ["git", "diff", base], capture_output=True, text=True, check=True
    )
    return result.stdout

def review_diff(diff: str, model: str = "gpt-4o-mini") -> List[Dict]:
    if not diff.strip():
        return []
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": diff[:60000]},  # Truncamiento simple para evitar una entrada demasiado larga
        ],
        temperature=0.2,
    )
    text = resp.choices[0].message.content.strip()
    text = text.removeprefix("```json").removesuffix("```").strip()
    try:
        return json.loads(text)
    except json.JSONDecodeError:
        return [{"file": "", "line": 0, "severity": "info", "comment": text}]

if __name__ == "__main__":
    annotations = review_diff(get_diff())
    # Escribir el resultado en un archivo para que el frontend lo vincule a las líneas correspondientes con Annotation de @pierre/diffs
    with open("review_annotations.json", "w", encoding="utf-8") as f:
        json.dump(annotations, f, ensure_ascii=False, indent=2)
    print(f"生成 {len(annotations)} 条审查意见")
En el frontend, después de instalar @pierre/diffs, vincula los comentarios de review_annotations.json a la vista Diff según el archivo y el número de línea. Combínalo con Edit Mode para que quien revise pueda modificar el código directamente. Consulta la documentación oficial de diffs.com/docs para conocer los parámetros concretos de los componentes.
🚀 Inicio rápido: al crear este tipo de prototipo, puedes llamar a la capa de modelo a través de APIYI apiyi.com. Con una sola clave puedes cambiar entre modelos como GPT, Claude y Gemini, y comparar la calidad de sus revisiones en tu base de código. Los usuarios nuevos también reciben crédito gratuito para pruebas.
Análisis del impacto de la adquisición de Pierre
Impacto para los desarrolladores
- Los componentes de código abierto ya se pueden usar: Diffs y Trees ya funcionan en el entorno de producción de Codex. Tienen licencia Apache-2.0 y sirven para crear barras laterales de asistentes de programación con IA, plataformas internas de revisión o espacios de trabajo para agentes. OpenAI también se ha comprometido a mantenerlos como código abierto.
- El cuello de botella de la revisión aparece antes: OpenAI reveló que su número interno de PR semanales se había más que duplicado frente al trimestre anterior. Ahora que el código se genera más rápido, una interfaz de revisión que permita «ver con claridad y modificar con rapidez» será clave para ganar eficiencia.
- Una nueva idea para almacenar el estado de los agentes: Los casos de Poke y Skydive muestran que Git puede usarse para guardar la memoria y la configuración de los agentes, con historial y capacidad de reversión integrados.
Impacto para el sector
- Codex cubre una parte más amplia del ciclo de desarrollo: pasa de la generación a la revisión y el almacenamiento. Sin embargo, hasta el 2026-11-05, no hay pruebas de que se vaya a cancelar la integración con GitHub.
- No confundas Pando con Code Storage: Pando, presentado por OpenAI el 2 de noviembre, es un backend de Git desarrollado internamente para dar soporte a su monorepositorio. Es un proyecto independiente de Code Storage de Pierre.
- La opinión de la comunidad aún no es concluyente: en los debates de HN, algunas personas plantean dudas sobre el archivo en almacenamiento frío y las diferencias de posicionamiento frente a GitHub; otras critican los cargos por tráfico. Unas decenas de comentarios no representan a toda la comunidad de desarrolladores, y todavía no hay evaluaciones independientes con muestras amplias.
Preguntas frecuentes (FAQ)
Q1: ¿Pierre es una empresa de alojamiento Git?
No exactamente. Pierre ofrece componentes de interfaz de código abierto (Diffs y Trees), funciones de resaltado (Highlights), una herramienta en línea (DiffsHub) y un servicio comercial de almacenamiento Git (Code Storage). Describirla únicamente como una plataforma de alojamiento Git deja fuera la tecnología de interfaz que Codex ya utiliza.
Q2: ¿OpenAI ya completó la adquisición de Pierre?
No. El 4 de noviembre de 2026, OpenAI solo anunció su intención de adquirirla. La operación aún está sujeta a las condiciones habituales de cierre y a la aprobación de los reguladores. No se han hecho públicos ni el importe ni la fecha de cierre, y ambas empresas operarán de forma independiente hasta entonces.
Q3: ¿Los $20 al mes de Code Storage son una nueva tarifa de Codex?
No. Es el consumo mensual mínimo del plan Starter de Pierre Code Storage y no tiene relación con la suscripción de Codex ni con el precio de los tokens de los modelos. El anuncio de la adquisición tampoco incluyó ningún precio nuevo para los planes de Codex.
Q4: ¿Qué componentes de Pierre puedo usar directamente en mi proyecto?
Las opciones más directas son `@pierre/diffs` y `@pierre/trees`. Ambos son paquetes públicos de NPM compatibles con Vanilla JS y React. Highlights figura actualmente como Beta en la documentación de Diffs, DiffsHub es una herramienta en línea y Code Storage es un servicio de pago.
Q5: ¿Cómo puedo añadir comentarios de revisión de IA a la interfaz de Diffs?
Diffs solo se encarga de la visualización y la interacción; los comentarios tienes que generarlos por tu cuenta. Siguiendo el ejemplo de este artículo, puedes enviar un `git diff` a un Modelo de Lenguaje Grande y añadir los comentarios que devuelva para cada línea como Annotation. Para la capa del modelo, puedes usar la interfaz compatible con OpenAI de APIYI apiyi.com: basta con cambiar base_url para reutilizar el código existente. Después de registrarte, puedes usar el crédito gratuito para probar el flujo.
Q6: ¿Se puede integrar APIYI directamente con Pierre Code Storage?
Por el momento no existe esa integración. APIYI apiyi.com ofrece un servicio de agregación de API de Modelos de Lenguaje Grande, que corresponde a la capa del modelo en el flujo de revisión. Code Storage requiere una integración independiente mediante el SDK o la CLI oficial de Pierre. Ambos pueden combinarse en la arquitectura, pero no son el mismo producto.
Puntos clave sobre Pierre Trees, Diffs y Code Storage
- Estructura de tres capas: Pierre combina componentes de código abierto, herramientas en línea y un servicio de almacenamiento de pago; no es una plataforma Git única.
- Integración confirmada: Codex App ya usa Trees y Diffs; la integración de Code Storage sigue siendo un plan futuro.
- Lo más destacado de Diffs: edición en línea con Edit Mode, interfaz de revisión Annotation y gestión estructurada de conflictos de fusión con Merge Conflict.
- Lo más destacado de Trees: renderizado virtualizado de árboles de archivos grandes y visualización nativa de estados Git como M/A/D/R/U.
- Papel de Code Storage: infraestructura Git con enfoque API-first; todas las cifras de rendimiento proceden del propio proveedor.
- Precios: $20/$200 son consumos mínimos mensuales. Se cobra por almacenamiento y tráfico, no como una suscripción adicional.
- Primeros pasos: instala el componente Diffs y usa APIYI apiyi.com para invocar los modelos y crear un prototipo de revisión.
Conclusión
La tecnología de Pierre se puede resumir en tres puntos:
- La capa de interfaz ya está validada: Trees y Diffs ya funcionan en Codex y son componentes de código abierto que puedes integrar gratis desde hoy.
- La capa de almacenamiento es la prioridad estratégica: Code Storage convierte Git en infraestructura programable para agentes, aunque las cifras de escala y rendimiento siguen siendo datos comunicados por el proveedor.
- Conviene distinguir los límites: la adquisición propuesta aún no se ha cerrado, Pando no tiene relación con Code Storage y los precios de almacenamiento y de los modelos son independientes.
Si estás creando una herramienta de programación con IA o una plataforma interna de revisión de código, lo más práctico es construir primero la interfaz con @pierre/diffs y @pierre/trees, y después integrar un Modelo de Lenguaje Grande para generar comentarios de revisión. Una opción para validar los resultados rápidamente es APIYI apiyi.com: con una sola interfaz puedes comparar el rendimiento de varios modelos en tu repositorio de código.
📚 Referencias
- Anuncio de adquisición de OpenAI: OpenAI to acquire Pierre Computer Company, Inc.
- Enlace:
openai.com/index/openai-to-acquire-pierre -
Descripción: Fuente primaria sobre el estado de la operación, los componentes que ya usa Codex y el compromiso con el código abierto
-
Sitio web y documentación de Diffs: componentes de Diffs, Edit Mode y Highlights
- Enlace:
diffs.com/docs -
Descripción: Incluye ejemplos interactivos y documentación completa de la API
-
Sitio web de Trees: demostración del componente de árbol de archivos
- Enlace:
trees.software -
Descripción: Información sobre el estado de Git, la virtualización y la accesibilidad
-
Precios de Code Storage: tarifas oficiales y simulador de precios
- Enlace:
code.storage/pricing -
Descripción: Detalles del consumo mínimo mensual y la facturación por uso
-
Notas de lanzamiento de Pierre SDK and CLI: actualización del 2026-11-03
- Enlace:
code.storage/changelog/pierre-sdk-and-cli -
Descripción: Comandos de instalación, requisitos del entorno y nomenclatura unificada
-
Repositorio de código abierto de Pierre: código fuente con licencia Apache-2.0
- Enlace:
github.com/pierrecomputer/pierre -
Descripción: Código fuente de los componentes y novedades de la comunidad
-
Scaling Git at OpenAI: presentación de Pando, desarrollado por OpenAI
- Enlace:
openai.com/index/scaling-git-at-openai - Descripción: Para distinguir Pando de Code Storage
Autor: Equipo técnico de APIYI
Intercambio técnico: Si quieres comparar varios Modelos de Lenguaje Grande en proyectos de revisión de código con IA, visita APIYI en apiyi.com para obtener crédito de prueba y conversar con nosotros.