Nota del autor: a partir de una prueba real de Apple Intelligence en la versión para China continental de iOS 27.3, desglosamos la lógica de reparto de tareas entre los modelos que se ejecutan en el dispositivo y los grandes modelos en la nube, y ofrecemos un marco de decisión de 5 dimensiones que puedes aplicar tal cual, además de pasos para llevarlo a tu aplicación.
Con la distribución de la beta para desarrolladores de iOS 27.3, Apple Intelligence en su versión para China continental por fin abre sus pruebas. La base tecnológica combina modelos propios de Apple y Qwen de Alibaba: la eliminación de elementos en fotos, el pulido básico de texto y la traducción en tiempo real se ejecutan en el dispositivo, mientras que las tareas prolongadas de Siri y la función «Preguntar» de la inteligencia visual quedan a cargo de la nube de Qwen. Este despliegue en China continental es, justamente, una muestra muy concreta del reparto de tareas entre dispositivo y nube.
Este no es otro resumen de funcionalidades; es un análisis, a partir de este caso, de la lógica de diseño que hay detrás del reparto entre dispositivo y nube: qué tareas de IA conviene ejecutar en el dispositivo, cuáles deben pasar forzosamente a un Modelo de Lenguaje Grande en la nube y cómo debería trazar esa línea un desarrollador en su propio producto.
Valor clave: al terminar este artículo, tendrás un marco de decisión de 5 dimensiones para repartir tareas entre dispositivo y nube, y podrás implementar en tu propia aplicación, en 4 pasos, una arquitectura híbrida de «respaldo en el dispositivo + refuerzo en la nube».
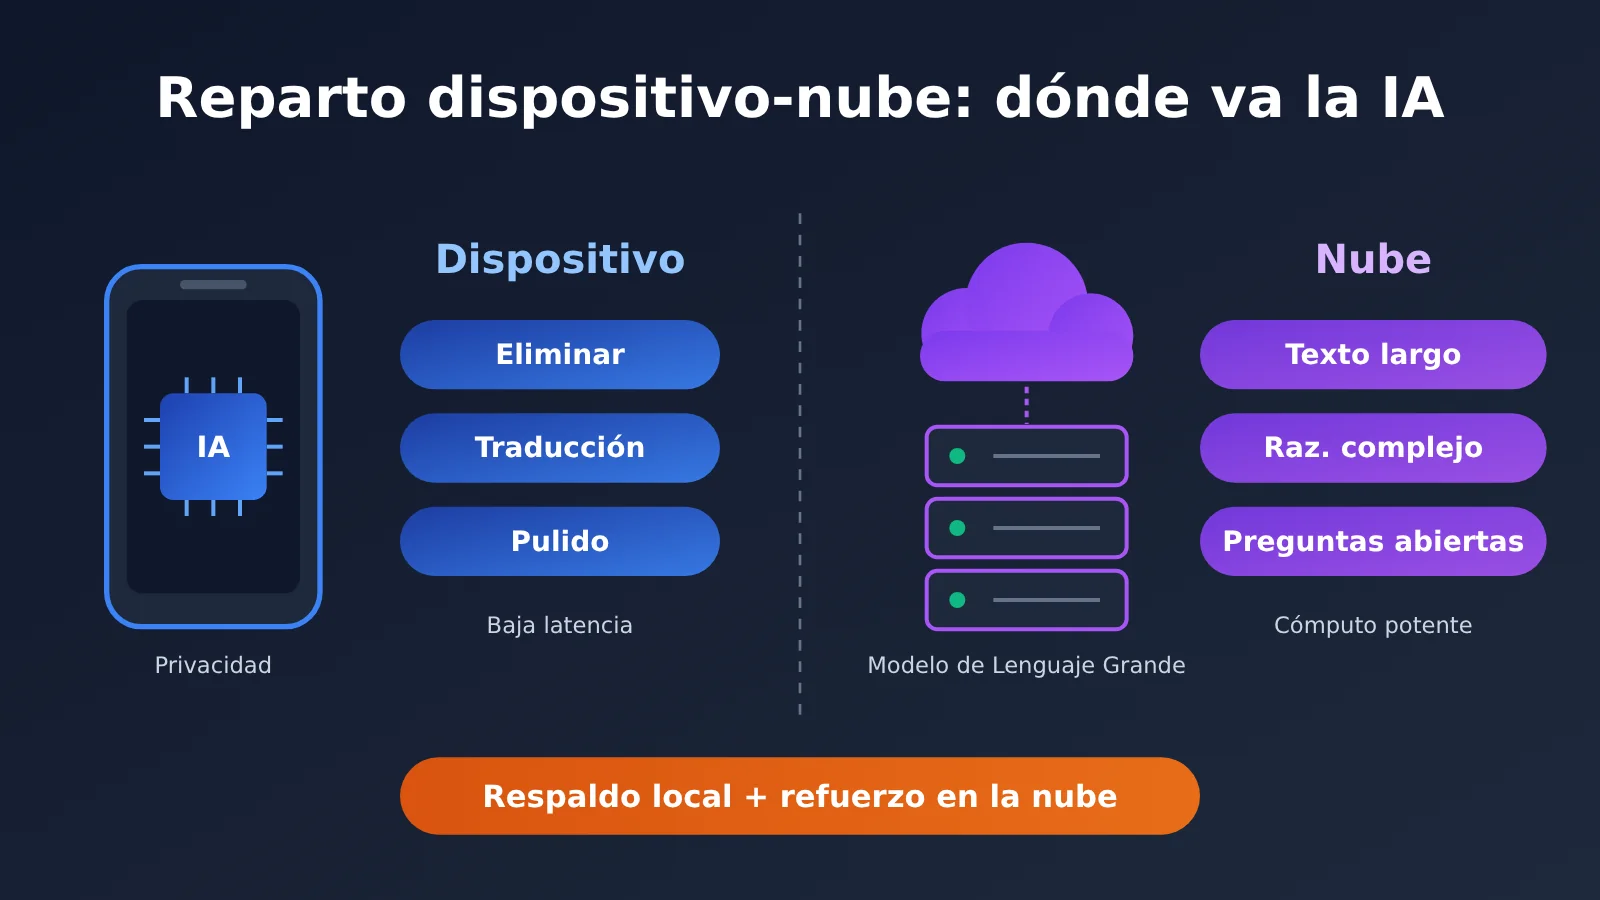
Puntos clave del reparto entre dispositivo y nube en Apple Intelligence para China continental
Primero, veamos en una tabla el reparto de tareas que se puede confirmar en las pruebas reales. Tanto la columna «Ubicación de ejecución» como la de «Rendimiento en pruebas» proceden de pruebas públicas; se puede observar que el reparto de Apple no es arbitrario, sino que sigue una lógica clara.
| Función | Ubicación de ejecución | Origen del modelo | Rendimiento en pruebas |
|---|---|---|---|
| Eliminación de fotos | En el dispositivo | Modelo propio de Apple para el dispositivo | Con fondos simples el resultado queda limpio; con texturas complejas suelen quedar bloques de color de baja resolución |
| Traducción en tiempo real | En el dispositivo | Modelo de Apple en el dispositivo; requiere descargar paquetes de idioma (unos 2 GB cada uno) | En conversación cotidiana, la latencia es inferior a 1 segundo y la precisión es buena |
| Herramientas de escritura (pulido básico) | Principalmente en el dispositivo | Modelo propio de Apple | La invocación a nivel de sistema es cómoda; la reescritura en chino resulta algo rígida |
| Resumen de notificaciones / búsqueda en lenguaje natural en el álbum de fotos | En el dispositivo | Modelo propio de Apple; requiere crear un índice local | Justo después de actualizar, hay que esperar uno o dos días a que termine la indexación |
| Tareas complejas de Siri | En la nube | Qwen de Alibaba; requiere autorización del usuario e iniciar sesión en la cuenta de Qwen | Los resultados aparecen en unos 7 u 8 segundos y el contenido tiende a ser breve |
| «Preguntar» / «Buscar» de inteligencia visual | En la nube | «Preguntar» se conecta a Qwen; «Buscar» usa por defecto el modelo visual de Baidu y puede conectarse a apps de terceros | Tras la adaptación de apps de terceros, estas pueden aparecer en la lista de servicios de búsqueda |
Detalle clave de la división de trabajo entre dispositivo y nube: por qué la eliminación y la traducción se quedan en el dispositivo
La eliminación de fotos y la traducción en tiempo real tienen tres cosas en común: la entrada son datos privados del usuario (fotos, voz de llamadas), son extremadamente sensibles a la latencia y los límites de la tarea están claros. Los rostros y la información de ubicación de las fotos no salen del dispositivo, así que el riesgo para la privacidad es mínimo; la traducción tiene que permitir traducir mientras se conversa, y cualquier ida y vuelta por la red rompe el ritmo de la conversación. La latencia inferior a 1 segundo en el dispositivo es precisamente la clave de la experiencia.
El precio también es evidente. El tamaño de los parámetros de los modelos en el dispositivo está limitado por la potencia de cálculo y el almacenamiento del teléfono, así que la eliminación falla cuando se encuentra con texturas complejas como grandes extensiones de césped o guijarros, y cada paquete de idioma de traducción ocupa unos 2 GB. Esta vez, el paquete de actualización del sistema llega a 12 GB; en esencia, es pagar el alquiler de los modelos en el dispositivo.
Detalle clave de la división de trabajo entre dispositivo y nube: por qué las tareas largas de Siri van a la nube
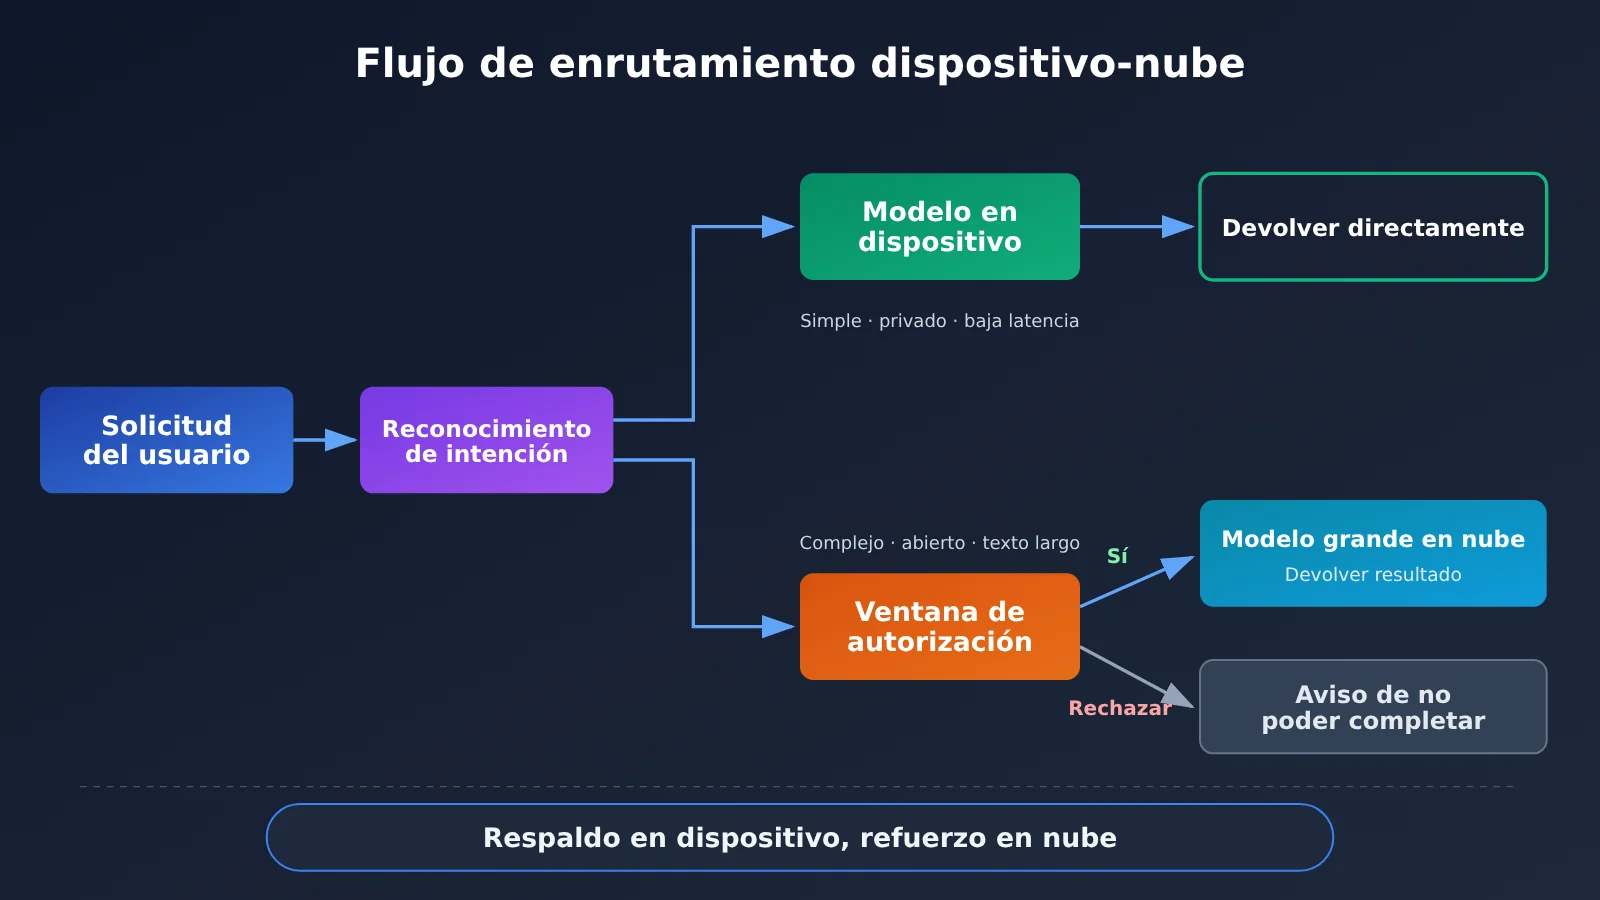
«Ayúdame a organizar una guía de cuatro días para Jiuzhaigou»: este tipo de peticiones requiere mucho conocimiento del mundo, generación de textos largos y planificación en varios pasos, y un modelo pequeño en el dispositivo no puede con ello. El enfoque de Apple es: cuando Siri detecta una pregunta que supera sus capacidades, muestra una ventana emergente y pregunta al usuario si acepta invocar a Qwen; si rechaza, directamente renuncia a responder.
Esta ventana emergente merece mucho que los desarrolladores se fijen en ella. Hace explícito ante el usuario que «los datos van a salir del dispositivo» y le devuelve la decisión sobre la privacidad. Al mismo tiempo, las pruebas reales también nos recuerdan que la calidad de los resultados en la nube depende del contexto y del diseño de indicaciones que el sistema proporcione al modelo. La guía de la versión de Siri es claramente inferior a preguntar directamente en la app Qwen, lo que demuestra que «haber conectado un Modelo de Lenguaje Grande» no equivale a «haberlo utilizado bien».
Marco para decidir el reparto entre dispositivo y nube: 5 dimensiones que determinan dónde va cada tarea
A partir del reparto de tareas de Apple Intelligence en China, se pueden abstraer 5 dimensiones de decisión. A la hora de diseñar una solución, puedes puntuar cada tarea según estas 5 dimensiones; si la mayoría se inclina por un lado, colócala ahí.
| Dimensión de decisión | Características que favorecen el dispositivo | Características que favorecen la nube | Ejemplo en Apple Intelligence |
|---|---|---|---|
| Sensibilidad de los datos | Fotos, contactos, historial de chats y otros datos privados | Conocimiento público, preguntas enviadas activamente por el usuario | Clean Up se ejecuta en el dispositivo; las consultas sobre guías van a la nube |
| Requisitos de latencia | Necesita responder en menos de 1 segundo; si se interrumpe, deja de ser útil | Puede aceptar esperas de varios segundos | Traducción en el dispositivo; las tareas largas de Siri tardan unos 7 u 8 segundos |
| Complejidad de la tarea | Límites claros, salida corta | Preguntas abiertas, planificación de varios pasos, generación de textos largos | Retoque básico en el dispositivo; las preguntas complejas se delegan a Qwen |
| Actualidad del conocimiento | No depende de la información externa más reciente | Requiere conocimiento del mundo o búsqueda en tiempo real | La «búsqueda» de Visual Intelligence se conecta con Baidu y terceros |
| Disponibilidad sin conexión | Debe funcionar con red débil o sin red | Escenario en línea por defecto | La traducción en tiempo real puede ejecutarse localmente tras descargar el paquete de idioma |
Errores habituales al repartir tareas entre dispositivo y nube
Muchos equipos, al definir el reparto entre dispositivo y nube, suelen caer en los siguientes errores, que conviene evitar desde el principio:
- Error 1: si cabe en el dispositivo, que vaya todo al dispositivo. Los modelos en el dispositivo tienen un límite de capacidad; forzar tareas complejas solo produce resultados de baja calidad, como el fiasco de Clean Up, y además perjudica la experiencia.
- Error 2: con conectarse a la nube, todo resuelto. El ejemplo de las guías de Siri demuestra que las indicaciones del sistema, la organización del contexto y el control de la longitud de la salida también determinan la calidad.
- Error 3: ignorar la autorización y la degradación. Las llamadas a la nube deben contemplar rutas de degradación cuando el usuario rechaza la autorización o falla la red; no se puede dejar que la función simplemente «desaparezca».
- Error 4: calcular el costo una sola vez. En el dispositivo, el costo de almacenamiento y del paquete es único; en la nube, el costo por llamada según consumo es continuo. Ambos deben calcularse por separado.
Reparto de tareas entre dispositivo y nube: 4 pasos para implementarlo en tu propia aplicación
Ahora vamos a convertir el marco de decisión en pasos concretos y ejecutables. Aunque no estés creando un sistema operativo móvil, sino una app normal, un miniprograma o una herramienta de escritorio, este enfoque también te sirve.
Primer paso: inventariar las tareas y etiquetarlas según el reparto dispositivo-nube
Haz una lista de todas las funciones del producto que planeas conectar a la IA y evalúalas una por una con las 5 dimensiones de la sección anterior. Te recomiendo generar una lista de tareas que incluya, como mínimo, columnas para «nombre de la tarea, sensibilidad de los datos, requisitos de latencia, complejidad y ubicación objetivo». Así la revisión será mucho más clara.
Segundo paso: elegir una solución ligera para las tareas en el dispositivo
Para las tareas que se ejecutan en el dispositivo, prioriza las capacidades nativas del sistema o los modelos ligeros, como las interfaces de traducción, OCR y reconocimiento de voz que ofrece el sistema, o modelos pequeños con pocos parámetros y cuantizados. Céntrate en controlar el tamaño del modelo y la experiencia de la primera descarga. Toma como referencia lo que hace Apple: descarga los recursos voluminosos bajo demanda y muestra un aviso claro la primera vez que se usan.
Tercer paso: conectar las tareas en la nube a una API de Modelos de Lenguaje Grande
Las tareas en la nube necesitan un Modelo de Lenguaje Grande con suficiente capacidad. Si quieres usar la familia Qwen como en la versión para China continental de Apple Intelligence, o comparar al mismo tiempo GPT, Claude y otros modelos, puedes llamarlos de forma unificada a través de APIYI. APIYI ofrece acceso mediante API a los principales Modelos de Lenguaje Grande mencionados en este artículo y es compatible con los dos formatos de interfaz de OpenAI y Anthropic. Por lo general, el código existente solo necesita cambiar la dirección del endpoint y la clave para migrar. Los modelos disponibles concretos se indican en la lista de la página de precios.
Estos son los parámetros de configuración clave que debes revisar al integrar. Usa como referencia la dirección de endpoint que indica la documentación de APIYI en docs.apiyi.com:
| Parámetro de configuración | Función | Recomendación para escenarios de reparto dispositivo-nube |
|---|---|---|
| Dirección del endpoint (base_url) | Indica el servidor al que se envían las solicitudes | Rellénala según la documentación de APIYI en docs.apiyi.com; los formatos de OpenAI y Anthropic tienen cada uno su propia dirección indicada en la documentación |
| Clave API | Autenticación y facturación | Guárdala solo en el servidor; no la incluyas en el paquete de instalación del cliente |
| model | Especifica el modelo que se va a invocar | Para tareas complejas de planificación, elige un modelo con razonamiento potente; para reescrituras sencillas, puedes usar un modelo ligero |
| max_tokens | Controla la longitud de la salida | En tareas como guías o informes, amplíalo lo suficiente para evitar respuestas demasiado escuetas al estilo Siri |
| stream | Indica si la salida es en streaming | En tareas largas en la nube, se recomienda activarlo para compensar la latencia percibida por la espera de varios segundos |
| Tiempo de espera y reintentos | Gestión de errores de red | Configura un tiempo de espera razonable; si falla, recurre al resultado simplificado en el dispositivo o muestra un aviso claro |
Cuarto paso: diseñar el diálogo de autorización y la ruta de degradación
Fíjate en el diálogo de confirmación que muestra Siri antes de llamar a Qwen: cualquier función que envíe datos del usuario a la nube debe explicar en la primera llamada «qué contenido se enviará y a quién». Si el usuario rechaza, no lo dejes correr como hace Siri: puedes volver a las capacidades del dispositivo para ofrecer un resultado simplificado o pedirle que complete la información manualmente.
🚀 Inicio rápido: te sugiero empezar con una tarea en la nube de máxima complejidad para validar el prototipo. Regístrate en APIYI apiyi.com y obtén cuota de prueba; con el mismo formato compatible con OpenAI puedes cambiar entre modelos y comparar cuál da la mejor calidad de salida en tu escenario antes de decidir la solución definitiva.
Comparativa de esquemas de división dispositivo-nube: solo en el dispositivo, solo en la nube y colaboración dispositivo-nube
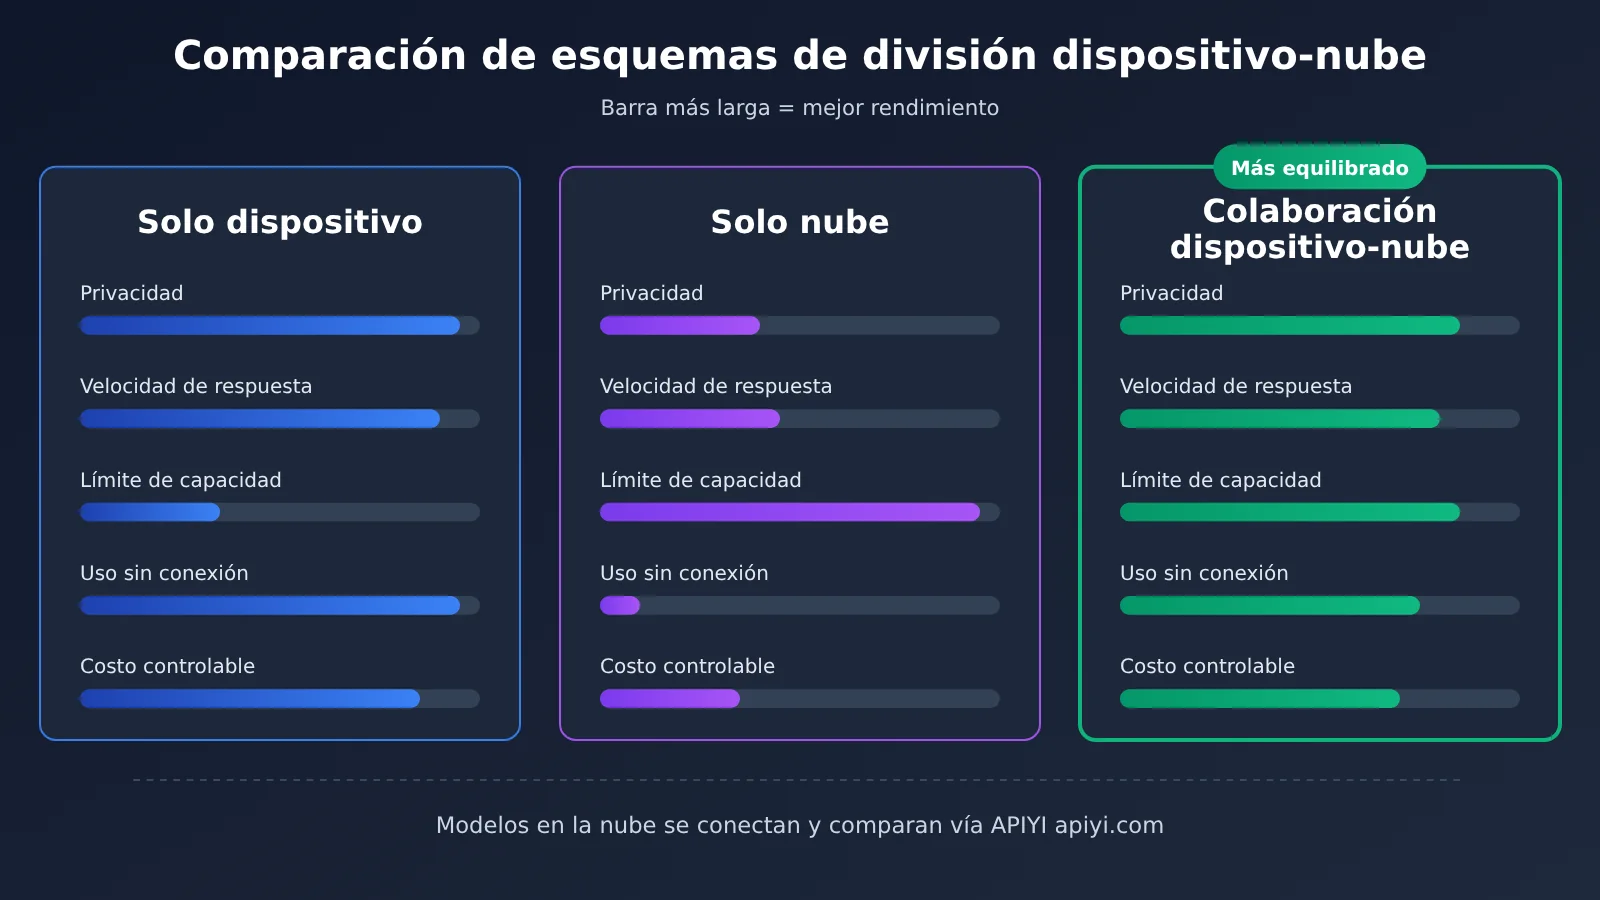
| Esquema | Características clave | Escenarios de aplicación | Principales desventajas | Plataforma disponible para modelos en la nube |
|---|---|---|---|---|
| Solo en el dispositivo | Los datos no salen del dispositivo, disponible sin conexión | Traducción, eliminación de objetos, reconocimiento de voz y otras tareas con límites claros | Techo de capacidad bajo, gran presión sobre el tamaño del paquete y el almacenamiento | No aplica |
| Solo en la nube | Techo de capacidad alto, iteración rápida | Preguntas abiertas, textos largos, planificación de varios pasos | Depende de la red, con preocupaciones de privacidad y costos continuos de invocación | APIYI apiyi.com, API oficial de cada modelo |
| Colaboración dispositivo-nube | Respaldo en el dispositivo, mejora en la nube, enrutamiento según la tarea | La gran mayoría de productos de IA orientados al consumidor | Arquitectura compleja, requiere diseñar enrutamiento, autorización y degradación | APIYI apiyi.com, API oficial de cada modelo |
Interpretación comparativa de los esquemas de división dispositivo-nube
Análisis comparativo de solo en el dispositivo: el enfoque solo en el dispositivo mantiene el liderazgo en privacidad y velocidad de respuesta; la latencia de menos de 1 segundo en traducción en tiempo real es la mejor prueba. Pero los modelos en el dispositivo están limitados por la capacidad de cómputo y el almacenamiento, y la calidad cae notablemente ante eliminación de texturas complejas o reescritura compleja en chino. En comparación, la colaboración dispositivo-nube puede transferir estos problemas a la nube, elevando el techo de capacidad mientras mantiene la privacidad como línea base.
Análisis comparativo de solo en la nube: el enfoque solo en la nube destaca en amplitud de conocimiento y capacidad de generación; tras integrar Qwen, Siri por fin puede responder preguntas del tipo «guía práctica». Pero cada invocación depende de la red y de la autorización del usuario; si el usuario la rechaza o la conexión es débil, la función deja de funcionar directamente. Para funciones principales que deben estar «disponibles en todo momento», la colaboración dispositivo-nube sigue siendo la opción más segura.
💡 Recomendación de elección: la elección del esquema depende de la composición de tus tareas. Si la parte en la nube necesita elegir entre modelos como Qwen, GPT, Claude, etc., puedes usar APIYI apiyi.com para hacer pruebas comparativas con la misma pregunta mediante una interfaz unificada, y decidir según la calidad real de salida y no según los parámetros de marketing.
La cuenta de costes del reparto dispositivo-nube: en el dispositivo, pago único; en la nube, pago por uso
El coste es uno de los aspectos que más se subestima en el reparto de tareas entre el dispositivo y la nube. El coste en el dispositivo se manifiesta sobre todo en el tamaño del paquete, el espacio de almacenamiento que ocupa al usuario y la experiencia de la primera descarga: el paquete de actualización de 12 GB de Apple y los paquetes de idioma de unos 2 GB cada uno son un reflejo directo de ese coste local. El coste en la nube, en cambio, es un gasto continuo por invocaciones según consumo: cuanto más activo es el usuario, más caro resulta.
Apple también está haciendo sus propias cuentas. En la conferencia de resultados financieros, la dirección de Apple mencionó que, en el futuro, funciones como Siri AI o el retoque fotográfico inteligente avanzado —que dependen de modelos de lenguaje grandes en la nube— contarán con una cuota de uso básica, y los usuarios intensivos tendrán que pagar por cuotas adicionales. Dicho de otro modo, «cuota básica gratuita + pago por uso intensivo» probablemente se convierta en el modelo de negocio dominante de las funciones de IA en la nube, y los desarrolladores pueden inspirarse en esta idea al diseñar sus propios productos.
En cuanto al coste concreto de invocación de los modelos en la nube, el precio unitario de entrada, el de salida y los criterios de facturación de caché varían mucho de un modelo a otro, y además se ajustan continuamente. Este artículo no ofrece ninguna cifra de precio concreta: todos los precios de modelos, criterios de facturación, precios unitarios de entrada y salida y precios de caché deben consultarse en los datos reales de la página de precios de APIYI https://docs.apiyi.com/models.
💰 Optimización de costes: al calcular el coste en la nube, conviene estimarlo con la lógica «tokens de entrada medios por tarea × precio unitario de entrada + tokens de salida medios × precio unitario de salida», tomando siempre los precios unitarios de la página de precios de APIYI, docs.apiyi.com/models. Para las indicaciones de sistema que se repiten con alta frecuencia, vale la pena fijarse en si la página de precios indica facturación de caché, para reducir aún más el coste continuo.
Preguntas frecuentes
P1: ¿Qué es la división de trabajo entre dispositivo y nube?
La división de trabajo entre dispositivo y nube consiste en separar las tareas de IA según sus características: una parte se procesa con el modelo local del dispositivo y la otra se envía al Modelo de Lenguaje Grande en la nube. El caso de Apple Intelligence en China continental es el ejemplo típico: el borrador de objetos y la traducción se ejecutan en el dispositivo, mientras que las tareas complejas de Siri y la opción «Preguntar» de Visual Intelligence se delegan a Qwen en la nube.
P2: ¿Cuál es la diferencia clave entre un modelo local y un Modelo de Lenguaje Grande en la nube?
Los modelos locales siguen llevando la delantera en privacidad, latencia y disponibilidad sin conexión, pero su techo de capacidad está limitado por la potencia de cómputo y el almacenamiento. Los Modelos de Lenguaje Grande en la nube tienen un conocimiento mucho más amplio y una capacidad de generación superior, aunque dependen de la red, requieren autorización del usuario y generan un costo continuo por invocación. No son alternativas excluyentes, sino complementarias.
P3: ¿Cuándo se podrá usar oficialmente Apple Intelligence en China continental?
Apple Intelligence para China continental abrió sus pruebas con la beta de desarrolladores de iOS 27.3, a la que se accede iniciando sesión en la app Apple Developer y luego desde Actualización de software. La primera versión beta del firmware tiene errores y, según reportes públicos, la versión estable llegaría en diciembre; si es tu teléfono principal, conviene esperar a esa versión para actualizar.
P4: ¿Qué tareas de IA encajan mejor en el dispositivo?
Los escenarios más adecuados son:
– **Procesamiento de datos privados**: borrador de objetos en fotos, búsqueda en el carrete con lenguaje natural, resúmenes de notificaciones
– **Interacción de latencia ultrabaja**: traducción de voz en tiempo real, sugerencias del teclado
– **Funciones imprescindibles sin conexión**: traducción, reconocimiento de voz y corrección básica de textos en redes débiles
P5: ¿Cómo llamar rápidamente a Qwen u otros Modelos de Lenguaje Grande en la nube mediante API?
Recomendamos probar a través de una plataforma que agrega múltiples modelos:
1. Entra en APIYI apiyi.com, registra una cuenta y obtén tu clave API
2. En el centro de documentación docs.apiyi.com consulta las instrucciones de integración en formato compatible con OpenAI o compatible con Anthropic
3. En la página de precios docs.apiyi.com/models confirma los modelos disponibles y los criterios de facturación; después solo tienes que sustituir la URL del endpoint y la clave para empezar a invocar
Así puedes comparar los resultados de Qwen con los de otros modelos principales usando una misma interfaz.
Q6: ¿Qué hacer si el usuario rechaza la autorización en una llamada a la nube?
La postura de Siri es renunciar directamente a responder, lo que resulta algo brusco. Una solución mejor es diseñar una ruta de degradación: volver al dispositivo para ofrecer un resultado simplificado, o guiar al usuario para que añada información y vuelva a intentarlo, respetando siempre su decisión y sin bombardearlo con ventanas emergentes.
P7: ¿Qué limitaciones conocidas tiene el esquema de división de trabajo entre dispositivo y nube?
Siendo objetivos, hay tres principales:
– **Complejidad de arquitectura**: hay que mantener por separado el enrutamiento de intenciones, el flujo de autorización y la lógica de degradación
– **Consistencia de la experiencia**: el estilo de salida del dispositivo y el de la nube difieren, y el usuario puede percibir una sensación de discontinuidad
– **Límites del ecosistema**: como señalan las pruebas reales, la IA del sistema no puede entrar en apps de terceros como WeChat o Meituan, el contexto personal sigue fragmentado y la división de trabajo entre dispositivo y nube no resuelve el problema de los silos de datos
Puntos clave de la división de tareas entre dispositivo y nube
- La esencia del reparto: las tareas privadas, de baja latencia y con límites claros se quedan en el dispositivo; las tareas complejas, abiertas y de texto largo van a la nube.
- Ejemplo en China continental: el modelo propio de Apple se encarga del borrado y la traducción, mientras que Qwen de Alibaba asume las tareas largas de Siri y las consultas visuales.
- Marco de decisión: puntuar cada tarea según sensibilidad de los datos, latencia, complejidad, actualidad y disponibilidad sin conexión.
- Consentimiento obligatorio: obtener permiso explícito del usuario antes de que los datos salgan del dispositivo y preparar una ruta de degradación por si los rechaza.
- La clave está en la calidad: conectar un Modelo de Lenguaje Grande es solo el punto de partida; las indicaciones, el contexto y la longitud de salida determinan la experiencia final.
- Cómo empezar: se puede acceder a los modelos en la nube de forma unificada a través de APIYI apiyi.com, con compatibilidad para los formatos de OpenAI y Anthropic.
Conclusión
La llegada de Apple Intelligence en China continental nos deja una referencia clara para repartir tareas entre el dispositivo y la nube:
- El dispositivo protege la privacidad y la velocidad: tareas como el borrado, la traducción y el resumen de notificaciones se quedan en el equipo; el precio a pagar es un mayor tamaño de la app y más almacenamiento.
- La nube cubre el techo de capacidades: las preguntas complejas y las consultas visuales pasan a Qwen; el costo es latencia, consentimiento y gasto continuo.
- La colaboración es la norma: el dispositivo como base y la nube como refuerzo, junto con ventanas de consentimiento y rutas de degradación, es la forma viable de llevar esto a un producto.
Para los desarrolladores, el camino más práctico es etiquetar primero las tareas con el marco de decisión y luego elegir una tarea en la nube para validar un prototipo. Recomendamos usar APIYI apiyi.com para comparar con una interfaz unificada el rendimiento real de distintos Modelos de Lenguaje Grande; los precios y criterios de facturación deben consultarse en la página de precios docs.apiyi.com/models.
📚 Referencias
- ifanr (爱范儿): prueba real de la AI del iPhone versión china: primera prueba real de la versión beta para desarrolladores de Apple Intelligence en China
- Enlace:
ifanr.com/1687733 -
Descripción: fuente de los hechos sobre la división de funciones entre el dispositivo y la nube, así como del rendimiento en las pruebas reales que se mencionan en este artículo
-
Centro de documentación de APIYI: instrucciones de acceso con formato compatible con OpenAI y Anthropic
- Enlace:
docs.apiyi.com -
Descripción: la dirección de la interfaz, el método de autenticación y los parámetros de invocación se rigen por este documento
-
Página de precios de modelos de APIYI: lista de modelos disponibles y criterios de facturación
- Enlace:
docs.apiyi.com/models - Descripción: los precios unitarios de entrada y salida, los precios de caché y demás información de facturación se rigen por los datos reales de esta página
Autor: equipo técnico de APIYI
Contacto técnico: puedes contactarnos en la página principal de APIYI apiyi.com; hay más materiales de integración disponibles en el centro de documentación docs.apiyi.com