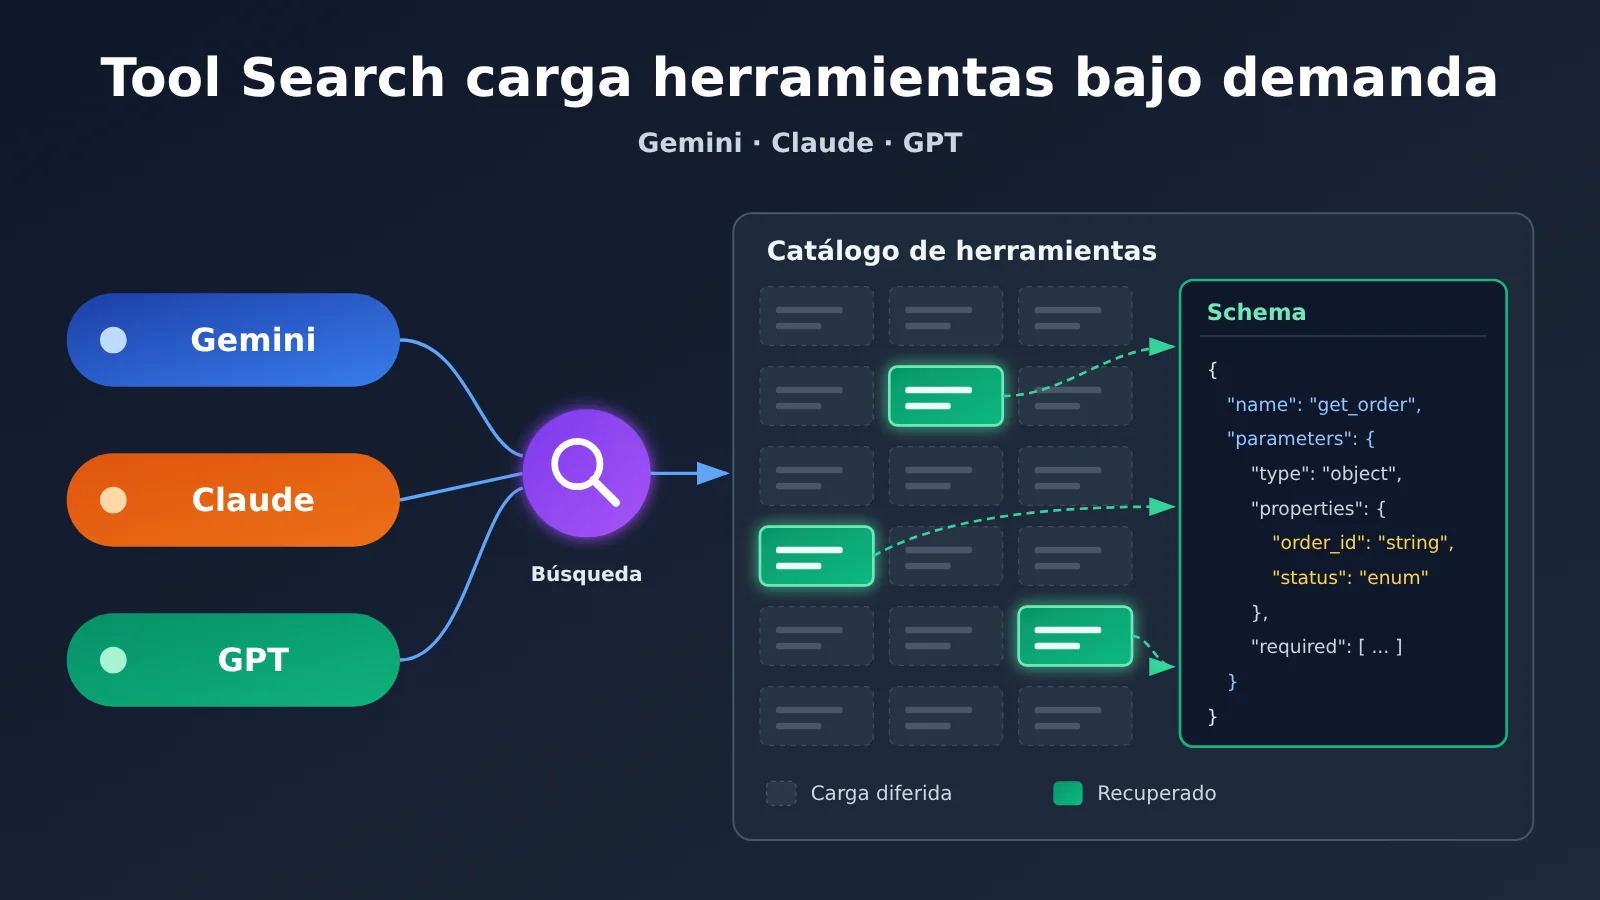
El Tool Search de las tres empresas resuelve el mismo problema, pero las rutas de implementación son muy diferentes. Las tres permiten que el modelo vea al inicio solo pistas breves de las herramientas y cargue el Schema completo de parámetros cuando necesite invocarlas. Las diferencias están principalmente en tres puntos: Gemini tiene modos de recuperación del lado del servidor y del lado del cliente, y la recuperación en cliente puede incorporar nuevas herramientas; Claude expone dos métodos de búsqueda del lado del servidor, Regex y BM25, y realiza descubrimiento dentro del conjunto de herramientas ya declaradas mediante tool_reference; GPT usa namespace para agrupar herramientas, y el modo cliente puede inyectar dinámicamente nuevas herramientas mediante tool_search_output. Al elegir, hay que considerar si la biblioteca de herramientas es fija o cambia con frecuencia, y también la arquitectura API existente del equipo.
¿Qué podrás entender después de leer este artículo?
- A qué API pertenece cada Tool Search y con qué campo se habilita.
- En qué se diferencia lo que se conserva en el contexto inicial del modelo y qué papel cumplen
short_description,tool_referenceynamespace. - Cómo se compone la cadena de eventos entre la recuperación de herramientas y la llamada real a funciones, y dónde es fácil equivocarse al adaptarlo.
- Cuál permite añadir en la conversación herramientas nuevas que no estaban en la solicitud inicial.
- Cómo elegir según la estructura de la biblioteca de herramientas para agentes empresariales como los de pedidos e inventario.
Índice: el texto primero explica las fechas de publicación y el enfoque común de las tres empresas; después desglosa los mecanismos de recuperación y los campos nativos de Gemini, Claude y GPT; luego compara ocho dimensiones en una tabla general y muestra las tres rutas técnicas con un mismo agente de pedidos e inventario. La sección final de análisis presenta principios de selección y discute problemas a tener en cuenta al adaptar protocolos en una pasarela entre modelos.
Conceptos clave sobre Tool Search
| Concepto | Explicación breve |
|---|---|
| Catálogo de herramientas | Conjunto de herramientas de negocio disponible para búsqueda, que incluye nombres, descripciones, definiciones de parámetros e información de permisos |
| Tool Search | Capacidad de buscar las herramientas necesarias para la tarea actual e importar sus definiciones completas según sea necesario |
defer_loading |
Campo que los tres proveedores utilizan para marcar que la definición completa de una herramienta se cargue de forma diferida |
| Regex | Usa expresiones regulares para hacer coincidir nombres de herramientas, descripciones o pistas de parámetros |
| BM25 | Algoritmo clásico que ordena los resultados de búsqueda según la relevancia entre los términos de la consulta y el texto |
tool_reference |
Bloque de contenido que Claude usa para referenciar una herramienta ya declarada, y que después la API expande a su definición completa |
namespace |
Declaración de OpenAI Responses API que agrupa funciones relacionadas por capacidad de negocio |
| Inyección dinámica de herramientas | La aplicación entrega al modelo definiciones de herramientas no declaradas en la solicitud inicial para que continúe usándolas |
tool_search_output |
Elemento de respuesta que el cliente de OpenAI devuelve durante la búsqueda con las declaraciones de herramientas coincidentes |
| MCP remoto | Servicio remoto que ofrece herramientas detectables y ejecutables mediante Model Context Protocol |
| Prefijo de caché | Parte inicial de la entrada que se mantiene igual entre varias invocaciones del modelo y cuyo caché se puede reutilizar |
Impacto de Tool Search: panorama rápido
- Desarrolladores de agentes: cuando hay muchas herramientas, ya no es necesario incluir todos los esquemas en el contexto de una sola vez, pero como los cuerpos de solicitud y los eventos de respuesta difieren entre los tres proveedores, un agente que use varios modelos necesita implementar la lógica de parseo por separado para cada uno.
- Responsables de plataformas empresariales y catálogos de herramientas: la forma de nombrar las herramientas, las descripciones breves y la manera de agruparlas empiezan a afectar directamente la eficacia de la búsqueda; el catálogo de herramientas en sí se ha convertido en un activo que hay que diseñar.
- Responsables de costes y operaciones: Tool Search no necesariamente ahorra dinero. El ejemplo oficial de cálculo de Google muestra tanto casos en los que se ahorran tokens como casos en los que se añaden; para decidir si activarlo, hay que guiarse por la factura medida en la práctica.
Hechos objetivos: la cronología y el mecanismo de Tool Search en las tres compañías
Por qué Gemini, Claude y GPT ofrecen Tool Search
Cuando un Agent se conecta al mismo tiempo a CRM, pedidos, inventario, logística, tickets y varios servidores MCP, las declaraciones de herramientas por sí solas ya consumen una parte importante del contexto. La documentación de Google señala que unas pocas docenas de declaraciones de funciones pueden ocupar decenas de miles de Tokens. Anthropic puso un ejemplo: cinco servidores MCP —GitHub, Slack, Sentry, Grafana y Splunk— con un total de 58 herramientas, donde solo las definiciones de herramientas ocupan aproximadamente 55.000 Tokens.
La cronología de lanzamiento de las tres compañías es la siguiente: Anthropic lanzó Tool Search Tool el 24 de noviembre de 2025; OpenAI lanzó API Tool Search el 5 de marzo de 2026 junto con GPT-5.4; Google lanzó Tool Retrieval de Gemini API en versión preliminar el 19 de noviembre de 2026. La idea básica de las tres es la misma: el modelo primero sabe qué capacidades existen y, cuando realmente necesita usar alguna, lee la definición completa de los parámetros.
Las tres compañías han publicado datos de rendimiento, pero las condiciones de prueba son completamente distintas, así que no se pueden usar para establecer un ranking. En el ejemplo de Anthropic, el contexto inicial bajó de aproximadamente 77.000 Tokens a aproximadamente 8.700 Tokens, y en la evaluación interna de MCP la precisión de selección de herramientas de Claude Opus 4 pasó del 49% al 74%. OpenAI midió en MCP Atlas, con 250 tareas y 36 servidores MCP, una reducción del 47% en el total de Tokens, manteniendo la precisión sin cambios. Google por ahora solo ofrece cálculos hipotéticos: con 200 herramientas se reduce aproximadamente un 85,6%, mientras que con 10 herramientas combinadas con contexto largo en realidad aumenta aproximadamente un 36,5%.
Búsqueda de herramientas de Gemini: los dos modos de recuperación, servidor y cliente
La recuperación de herramientas (Tool Retrieval) de Gemini se apoya en la Interactions API, exige usar v1beta, y la antigua generateContent no la admite. Para activar el modo servidor basta añadir {"type": "tool_search"} dentro de tools y luego marcar con defer_loading: true las function o mcp_server de baja frecuencia. Al principio, el modelo solo ve el nombre y la short_description de las herramientas diferidas. Las primeras pruebas de Google mostraron que cada entrada de herramienta consume de media unos 26 tokens. Si no se configura una descripción corta, se usa como sustituto la primera frase de la description completa.
Hay un punto que suele generar confusión: en el modo servidor, el desarrollador sigue teniendo que enviar la definición completa de las herramientas. Incluso cuando se usa previous_interaction_id, cada petición debe reenviar el array tools completo. La carga diferida solo evita que el Schema completo entre en el contexto del modelo por adelantado. Además, un Schema ya cargado no se puede descargar dentro de la sesión actual; una misma petición puede declarar como máximo un tool_search; y la recuperación del servidor y la del cliente no se pueden mezclar en la misma petición.
| Dimensión | Recuperación del servidor | Recuperación del cliente |
|---|---|---|
execution |
server (predeterminado) |
client |
| Recuperador | Lo gestiona la API de Gemini | Lo construye el propio desarrollador |
| ¿Hay que declarar la biblioteca de herramientas de antemano? | Sí | No |
defer_loading |
Aplica | No aplica |
| Ida y vuelta adicional | Ninguna adicional desde el cliente | Una ida y vuelta más por cada búsqueda |
| Escenario típico | Conjuntos de herramientas grandes y relativamente fijos | Registro de herramientas privado, multiinquilino, herramientas dinámicas |
En el modo cliente, el modelo invoca una función de búsqueda definida por el desarrollador (por ejemplo, search_tool_registry), y la aplicación devuelve los objetos de declaración completos de las herramientas que coinciden dentro de function_result.result. Este enfoque permite introducir durante la conversación herramientas que no estaban declaradas en la petición original, como cuando el usuario conecta sobre la marcha un nuevo servicio SaaS en la sesión.
Claude Tool Search: Regex, BM25 y tool_reference
La Tool Search Tool de Claude forma parte de la Messages API, y el servidor ofrece dos tipos de herramienta de búsqueda: tool_search_tool_regex_20251119, donde el modelo genera expresiones regulares y resulta ideal para bibliotecas de herramientas con convenciones de nombres muy marcadas; y tool_search_tool_bm25_20251119, donde el modelo genera consultas en lenguaje natural y encaja mejor cuando se trata de descubrir herramientas por la descripción de sus capacidades. Ambos métodos buscan en los nombres de las herramientas, sus descripciones, los nombres de los parámetros y las descripciones de esos parámetros. En Claude, el campo de parámetros se llama input_schema, lo cual lo diferencia del parameters de las otras dos plataformas.
La cadena de eventos de una búsqueda típica es la siguiente: Claude primero lanza una llamada server_tool_use al invocar la herramienta de búsqueda integrada, la API devuelve un tool_search_tool_result que contiene un tool_reference, luego la API lo expande a la definición completa y, por último, el modelo genera el tool_use a nivel de negocio. Anthropic aclara específicamente que el identificador srvtoolu_... de la herramienta de búsqueda integrada no requiere que el desarrollador devuelva un tool_result: la aplicación solo tiene que ejecutar el tool_use real de negocio.
| Regla de Claude Tool Search | Normativa oficial |
|---|---|
| Límite de herramientas diferidas por solicitud | 10.000 |
| Resultados devueltos por búsqueda (por defecto) | Máximo 5, ajustable mediante limit |
| Longitud de la consulta Regex | Máximo 200 caracteres |
| Longitud de la consulta BM25 | Máximo 500 caracteres |
| Modelos no compatibles | Claude Opus 4.1 y modelos anteriores |
| Restricción de caché | Las herramientas con defer_loading: true no pueden tener cache_control |
El desarrollador también puede implementar su propia búsqueda con algoritmos propios, como embeddings, pero lo que se devuelve sigue siendo un tool_reference, y la herramienta referenciada debe estar ya declarada en el tools de nivel superior. Por eso, el diseño de Claude se parece más a «encontrar la herramienta necesaria dentro de una biblioteca de herramientas previamente declarada». En el ámbito de MCP, Claude configura la estrategia de diferimiento mediante el mcp_toolset del MCP Connector: se puede establecer de forma global en default_config o herramienta por herramienta en configs.
GPT Tool Search: Namespace e inyección dinámica de herramientas
El Tool Search de OpenAI está dentro de Responses API, es compatible con GPT-5.4 y modelos compatibles más recientes, y también se habilita mediante tool_search y defer_loading. Su particularidad es el namespace: los desarrolladores pueden agrupar funciones relacionadas por dominio de negocio, como crm, billing, etc. El modelo primero decide, a partir del nombre y la descripción del namespace, qué tipo de capacidad viene al caso, y cuando hace falta expande las funciones diferidas de ese grupo. Así, la agrupación de herramientas pasa a ser una estructura a nivel de API, y no solo una convención de nombres.
En el modo servidor, la cadena de eventos es tool_search_call → tool_search_output → function_call → y la aplicación devuelve function_call_output. En el modo cliente, tras recibir tool_search_call, la aplicación consulta por su cuenta el catálogo de herramientas y devuelve tool_search_output con el mismo call_id; su campo tools contiene las declaraciones completas de las herramientas que coinciden, y el modelo llama a esas funciones en la siguiente ronda. La documentación oficial permite aquí devolver herramientas que no se declararon en la solicitud original, y al mismo tiempo exige que el desarrollador valide estrictamente el Schema dinámico y exponga solo definiciones de herramientas confiables.
En cuanto a la caché, OpenAI añade las definiciones de herramientas recién descubiertas al final del contexto, para reducir el impacto sobre el prefijo de caché ya existente. En MCP hay que tener en cuenta lo siguiente: el Tool Search de Responses API admite el descubrimiento bajo demanda de herramientas MCP, mientras que Agents API conecta automáticamente el descubrimiento de herramientas desde el runtime cuando el modelo y el proveedor lo permiten. La documentación oficial advierte claramente que ambas configuraciones no se pueden aplicar la una a la otra directamente.
A continuación, una solicitud ilustrativa a Responses API que muestra la estructura básica de la carga diferida. Los campos se rigen por la documentación oficial de OpenAI:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Punto de acceso compatible con OpenAI de APIYI
)

tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "inventory_get_stock",
        "description": "Inventory: check stock level by SKU.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {"sku": {"type": "string"}},
            "required": ["sku"]
        }
    }
]

resp = client.responses.create(
    model="gpt-5.4",
    input="订单 A-1042 还没发货,帮我查一下 SKU-88 的库存。",
    tools=tools
)
for item in resp.output:
    print(item.type)  # Se esperan eventos como tool_search_call / function_call
Ver el código ilustrativo de recuperación en el cliente e inyección dinámica
import requests

BASE_URL = "https://api.apiyi.com/v1"  # Reenvía la solicitud a Responses API a través de APIYI
HEADERS = {"Authorization": "Bearer YOUR_API_KEY"}

def search_registry(query: str) -> list:
    """Busca en el catálogo privado de herramientas de la empresa y filtra por permisos del usuario (ilustrativo)"""
    return [{
        "type": "function",
        "name": "warehouse_schedule_shipment",
        "description": "Warehouse: schedule a new shipment date.",
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {"type": "string"},
                "date": {"type": "string"}
            },
            "required": ["order_id", "date"]
        }
    }]

def handle(output_items: list) -> list:
    follow_ups = []
    for item in output_items:
        if item["type"] == "tool_search_call":
            query = item.get("arguments", {}).get("query", "")
            follow_ups.append({
                "type": "tool_search_output",
                "call_id": item["call_id"],      # Usa el mismo call_id que la llamada de búsqueda
                "tools": search_registry(query)  # Puede incluir herramientas no declaradas en la solicitud inicial
            })
    return follow_ups
# Nota: valida siempre el Schema devuelto dinámicamente y expón solo herramientas confiables
🚀 Consejo de validación rápida: antes de conectar el negocio real, puedes usar la clave unificada de APIYI apiyi.com para invocar GPT, Claude y Gemini por separado, ejecutar el mismo catálogo de herramientas en las tres plataformas y confirmar que tu capa de análisis reconoce correctamente la estructura de eventos; luego decide la solución principal.
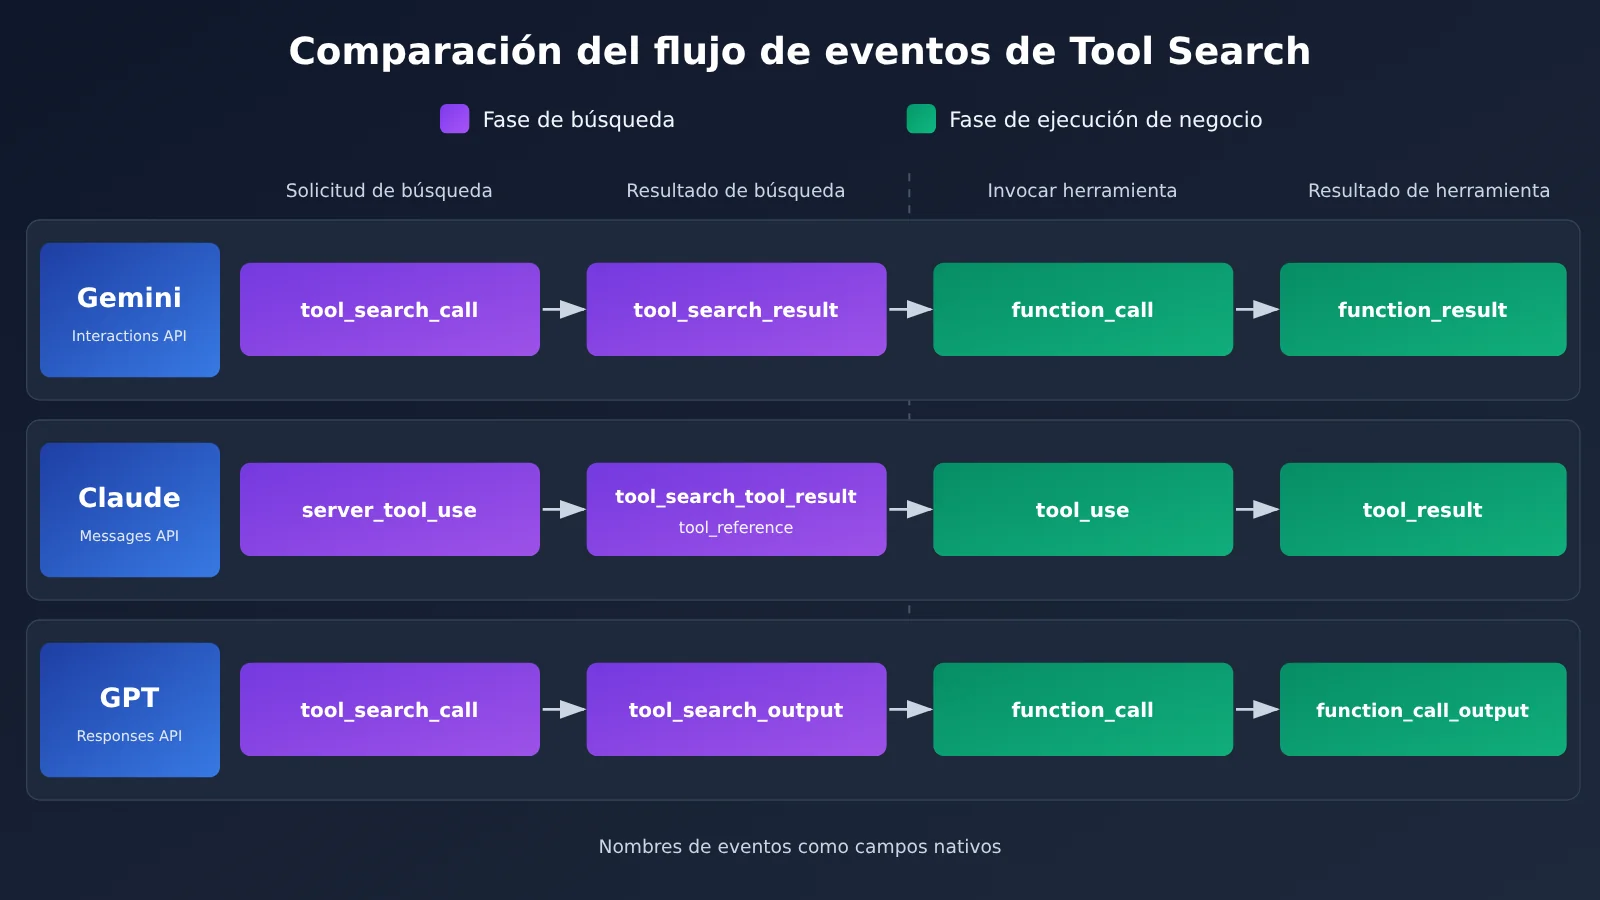
Los nombres de eventos del diagrama anterior son campos nativos de cada plataforma. Quienes necesiten probar el flujo de eventos de cada una por separado pueden cambiar de modelo con el mismo conjunto de scripts de prueba a través de APIYI apiyi.com para compararlos.
Comparación concentrada de los tres mecanismos de Tool Search
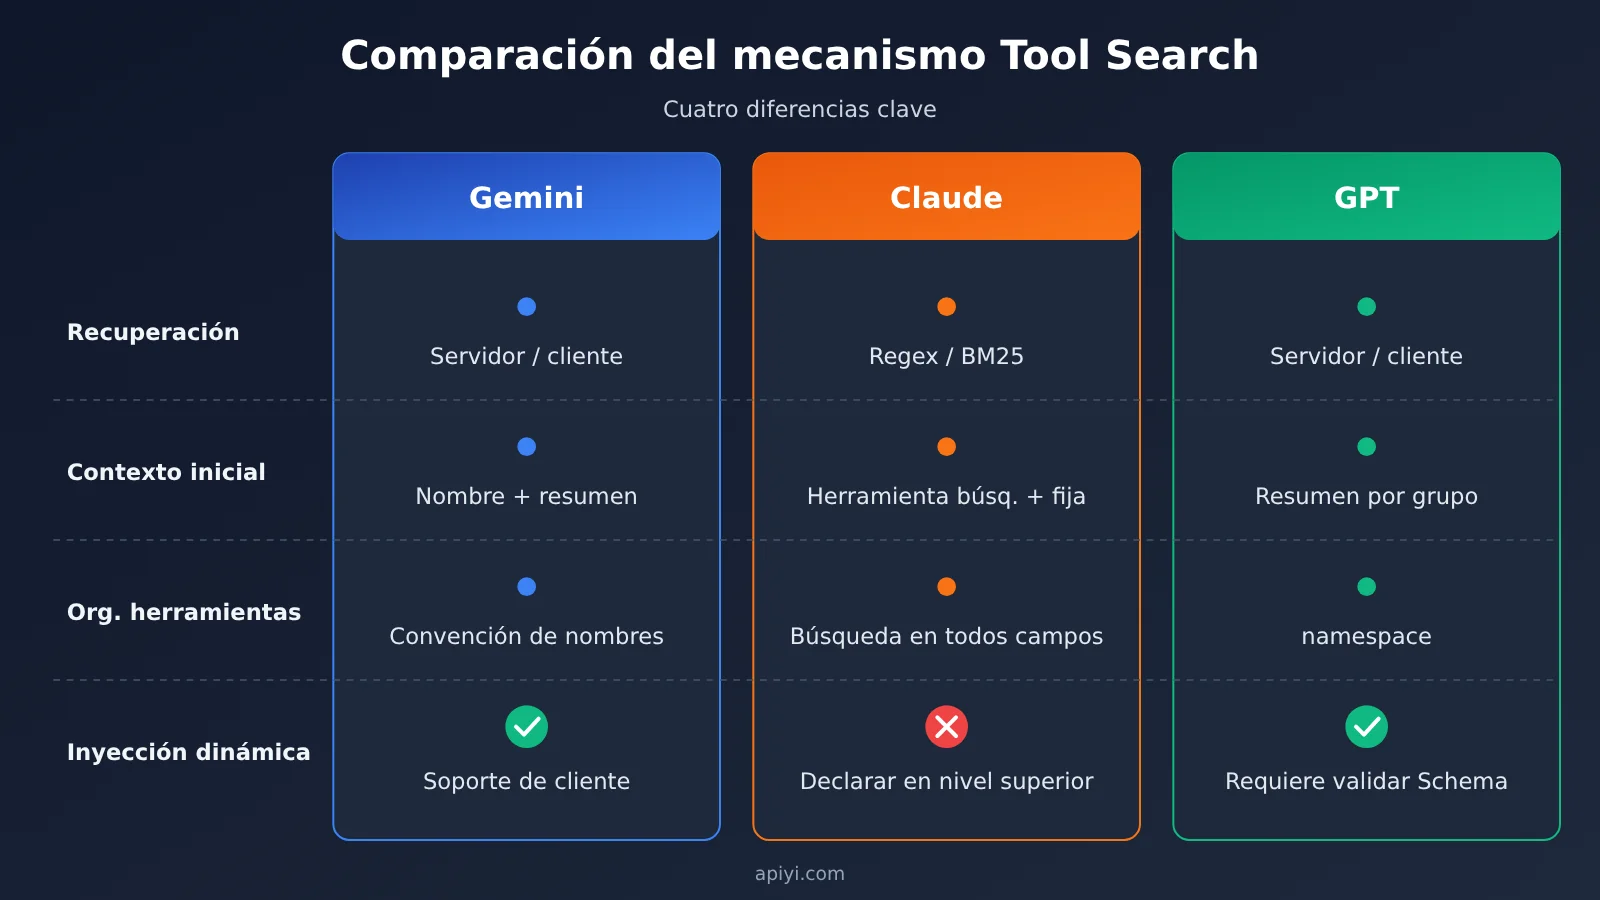
| Dimensión | Gemini | Claude | GPT |
|---|---|---|---|
| API a la que pertenece | Interactions API (v1beta) |
Messages API | Responses API |
| Método de recuperación | Lado del servidor (algoritmo no divulgado) / lado del cliente | Regex / BM25 / búsqueda personalizada | Lado del servidor / lado del cliente |
| Retención del contexto inicial | Nombre + short_description |
Herramienta de búsqueda + herramientas no diferidas | Herramientas diferidas o resumen de namespace |
| Organización de herramientas | Convención de nombres + descripción breve | Nombre, descripción y parámetros, todo recuperable | Agrupación por namespace |
| Campo de parámetros | parameters |
input_schema |
parameters |
| Recuperación del lado del cliente | Compatible | La búsqueda personalizada devuelve tool_reference |
Compatible (tool_search_output) |
| Adición dinámica de nuevas herramientas | Compatible en modo cliente | Las herramientas referenciadas deben estar ya declaradas en el nivel superior | Compatible en modo cliente, requiere validación de Schema |
| Integración con MCP | mcp_server + defer_loading |
default_config / configs de mcp_toolset |
Reglas distintas entre Responses y Agents |
| Caché y facturación | Sin cargo funcional independiente; atención a total_tool_use_tokens |
No se cobra por separado; las herramientas diferidas no admiten cache_control |
Las nuevas herramientas se añaden al final para proteger el prefijo de caché |
💡 Recomendación de elección: la tabla anterior solo compara reglas de interfaz verificables. El resultado real depende de tu biblioteca de herramientas y de la duración de la conversación; se recomienda hacer una prueba A/B con muestras pequeñas aprovechando el punto de entrada unificado multimodelo de APIYI apiyi.com, y luego calcular el costo según los campos de facturación de cada plataforma.
Análisis y decisión: condiciones de idoneidad para elegir Tool Search
Ver las tres rutas técnicas a través de un Agent de pedidos e inventario
Imaginemos una necesidad de negocio: un usuario consulta el estado de un pedido, descubre que el producto aún no ha sido enviado, luego consulta el inventario y, a continuación, determina si se puede programar una nueva fecha de envío. En el sistema hay nueve tipos de herramientas: CRM, pedidos, inventario, planificación de almacenes, logística, reembolsos, facturación, notificaciones y aprobaciones, y cada tipo contiene múltiples funciones.
- Ruta Gemini: cargar directamente las consultas de pedidos de uso frecuente, configurar como carga diferida las herramientas de cola larga como inventario y planificación de almacenes, redactar bien
short_descriptiony dejar que el servidor recupere y seleccione el Schema deget_inventory. Si las herramientas de planificación de almacenes se habilitan dinámicamente por tenant, cambiar a recuperación del lado del cliente y devolverlas desde un Registry privado. - Ruta Claude: si los nombres de las herramientas siguen un patrón regular (como
inventory_*ywarehouse_*), Regex puede acertar con precisión; si el usuario dice algo coloquial como “veamos si todavía se puede reponer stock”, BM25 es más adecuado. Finalmente,tool_referencelo expande a untool_useinvocable. - Ruta GPT: crear
namespacesegúncrm,inventoryylogistics; el modelo primero determina que se ven involucrados dos dominios, inventario y logística, y luego expande las funciones dentro del grupo. Un nuevo proveedor logístico conectado temporalmente se puede inyectar mediantetool_search_outputdel lado del cliente.
Este escenario solo sirve para ilustrar las diferencias de mecanismo; no representa la tasa de éxito real medida ni la latencia de las tres opciones.
Cuatro principios de elección para desarrolladores
- Biblioteca de herramientas grande y fija: prioriza la capacidad de recuperación en el lado del servidor. Las tres plataformas pueden cubrirlo, pero ojo: Gemini tiene que reenviar el array completo de herramientas en cada solicitud, y Claude tiene un límite de 10,000 herramientas diferidas por solicitud.
- Necesidad de controlar explícitamente la estrategia de búsqueda: el Regex y BM25 que Claude expone públicamente son la única solución que revela claramente el algoritmo, ideal para equipos que quieren acertar con precisión según reglas de nomenclatura. Los algoritmos del lado del servidor de Gemini y GPT no están divulgados, así que no conviene suponer que son iguales a los de Claude.
- Biblioteca de herramientas que cambia con frecuencia o requiere filtrado por permisos de usuario: fíjate sobre todo en la inyección dinámica del lado del cliente. Tanto el modo cliente de Gemini como el de GPT pueden incorporar herramientas nuevas; la búsqueda personalizada de Claude solo puede referenciar herramientas ya declaradas, por lo que hay que armar el conjunto de candidatas antes de enviar la solicitud.
- Escala de herramientas pequeña: los cálculos de Google muestran que, con 10 herramientas y una ventana de contexto larga de 30,000 Tokens, el consumo de Tokens aumenta alrededor de 36.5%. Google recomienda seguir con carga estática cuando hay menos de unas 20 herramientas estables; esto también resulta orientativo para las otras dos plataformas, aunque cada una requiere sus propias pruebas.
El problema de adaptación de protocolos en gateways multi-modelo
El error más común entre los equipos que construyen Agents multimodelo es equiparar «poder invocar este modelo» con «el Tool Search de este modelo funciona». Conviene desglosar la capacidad en cuatro capas: acceso al modelo, endpoint de protocolo (Interactions / Messages / Responses), campos de declaración de herramientas (tool_search, defer_loading, namespace, configuración MCP), y ejecución y gestión de estado (eventos de recuperación, resultados de funciones, signature, historial de sesión). Que la integración del modelo funcione solo demuestra que la primera capa está bien.
Hay que prestar especial atención a una regla de Gemini: en sesiones sin estado con store=false, ni tool_search_call, ni tool_search_result, ni su signature se pueden modificar o eliminar; de lo contrario se devuelve HTTP 400. Esto significa que el gateway no puede comprimir ni reescribir el historial de mensajes a voluntad. Abstraer las tres plataformas en una interfaz unificada de Tool Search exige mantener una tabla de mapeo de eventos a nivel del framework del Agent; no se puede esperar que cambiar la Base URL haga que el mismo cuerpo de solicitud sirva para todas.
🎯 Consejo técnico: al integrar varios modelos a través de una plataforma agregadora como APIYI apiyi.com, conviene confirmar primero con poco tráfico si el endpoint objetivo y campos como
tool_search,defer_loading,namespacese transmiten completos, y luego incorporar Tool Search a la cadena de producción.
Variables que conviene seguir de cerca
Gemini Tool Retrieval sigue siendo una versión preliminar, y su interfaz podría cambiar antes del lanzamiento oficial. A fecha del 20 de noviembre de 2026, todavía no existen pruebas independientes verificables sobre el porcentaje medio de ahorro, la latencia y la precisión en entornos de producción reales. Una dirección que se puede anticipar es que las tres compañías están delegando la «gobernanza del catálogo de herramientas» a los desarrolladores, y la nomenclatura, las descripciones breves, la agrupación y los permisos se parecerán cada vez más a la ingeniería de índices de un sistema de recuperación. Antes del lanzamiento, se recomienda montar experimentos controlados basados en los tokens de entrada iniciales, los tokens de uso de herramientas, la tasa de selección correcta de herramientas, la tasa de búsquedas sin coincidencia y el número medio de búsquedas, y validarlos de forma transversal con entornos multimodelo como APIYI apiyi.com sobre el mismo conjunto de tareas, para no dejarse arrastrar por las cifras promocionales de un único proveedor.
Tener más herramientas no significa que el Agent sea más inteligente; lo que determina el techo del Agent es si puede encontrar con precisión la herramienta adecuada cuando la necesita. Como dice el Lunyu (Analectas), capítulo Wei Ling Gong: «Si un artesano quiere hacer bien su trabajo, primero debe afilar sus herramientas».
Referencias
- Documentación técnica de Google Tool Retrieval: recuperación en servidor y cliente, limitaciones, facturación y ejemplos de cálculo
- Enlace:
aistudio.google.com/docs/tool-retrieval
- Enlace:
- Anuncio oficial de Google: Introducing Tool Retrieval in the Gemini API
- Enlace:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval
- Enlace:
- Documentación de Anthropic Tool Search Tool: Regex, BM25, tool_reference y limitaciones
- Enlace:
platform.claude.com/docs/en/agents-and-tools/tool-use/tool-search-tool
- Enlace:
- Anuncio de Anthropic Advanced Tool Use: lanzamiento de Tool Search y evaluación interna
- Enlace:
anthropic.com/research/advanced-tool-use
- Enlace:
- Documentación de OpenAI Tool Search: namespace, recuperación en cliente e inyección dinámica
- Enlace:
developers.openai.com/api/docs/guides/tools-tool-search
- Enlace:
- Anuncio de OpenAI GPT-5.4: lanzamiento de Tool Search y pruebas de MCP Atlas
- Enlace:
openai.com/index/introducing-gpt-5-4
- Enlace:
Autor: equipo técnico de APIYI
Contacto técnico: si quieres profundizar sobre la adaptación de la invocación de herramientas en Agents multimodelo, puedes visitar APIYI apiyi.com para contactarnos; en el centro de documentación docs.apiyi.com encontrarás más material de integración.