Nota del autor: comparamos Qwen4-Max y Claude Opus 5.5 en cuatro tipos de tareas —terminal y repositorio de código, tareas de oficina de larga duración, documentos multimodales extensos y costo—, revisando puntuaciones de benchmark, especificaciones, precio de caché y costo de migración, y cerramos con recomendaciones de selección que puedes poner en práctica.
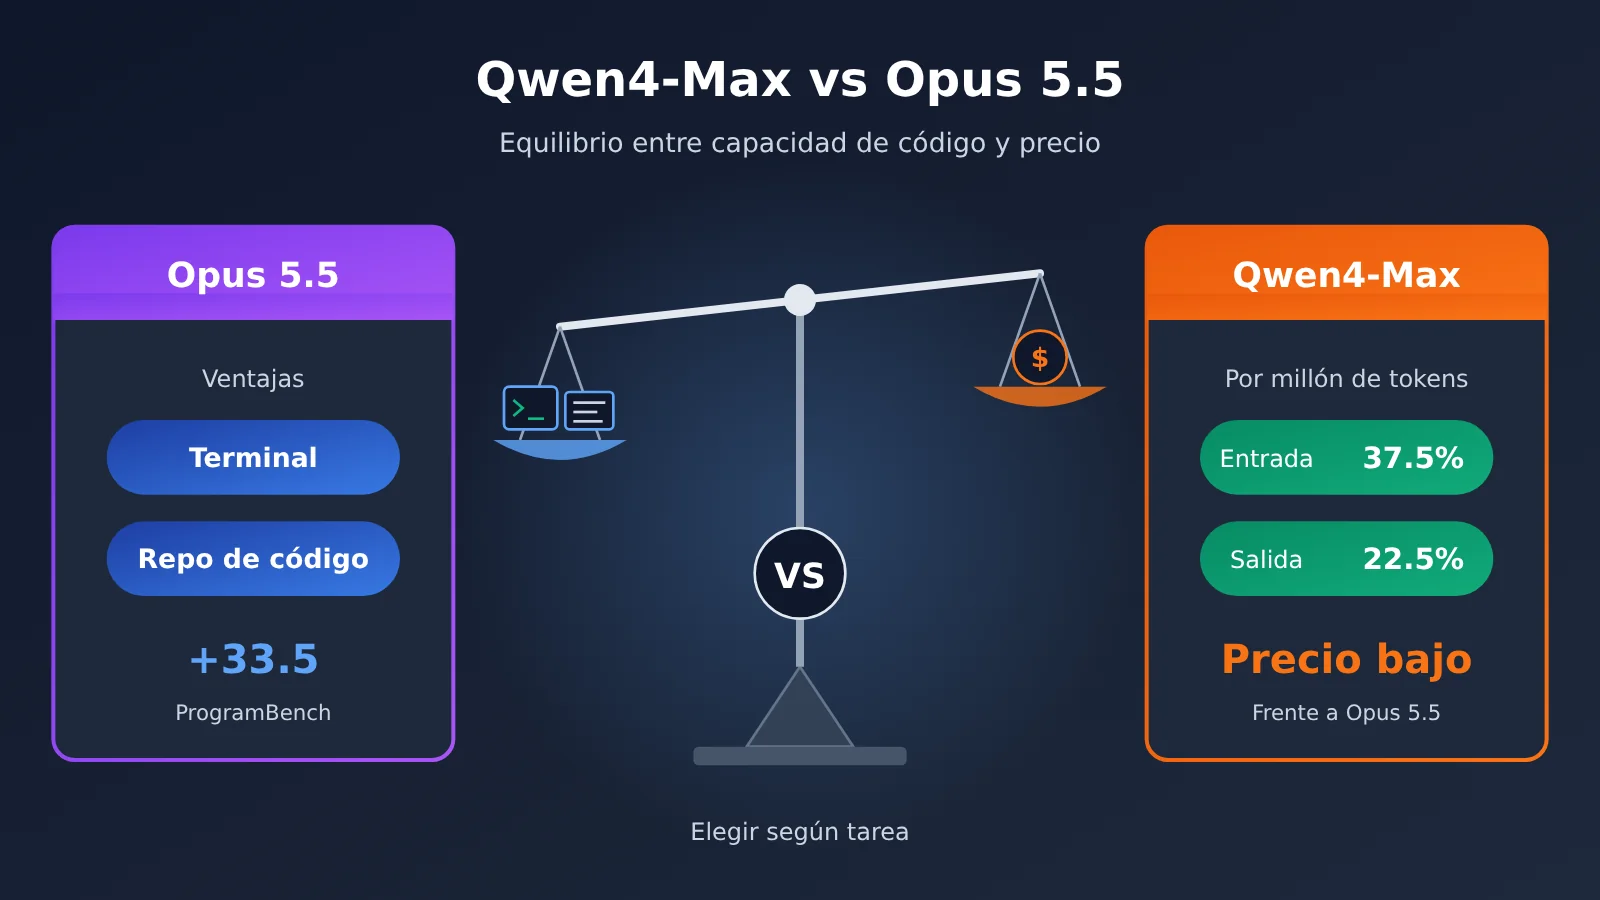
Si tu equipo ya usa Claude Opus 5.5 como modelo principal y lo ejecuta en producción dentro de Claude Code o de un agente propio, Qwen4-Max —publicado el 2026-11-16— te hará recalcular las cuentas: su precio de entrada es solo el 37.5% del de Opus 5.5, y el precio de salida, solo el 22.5% del de Opus 5.5.
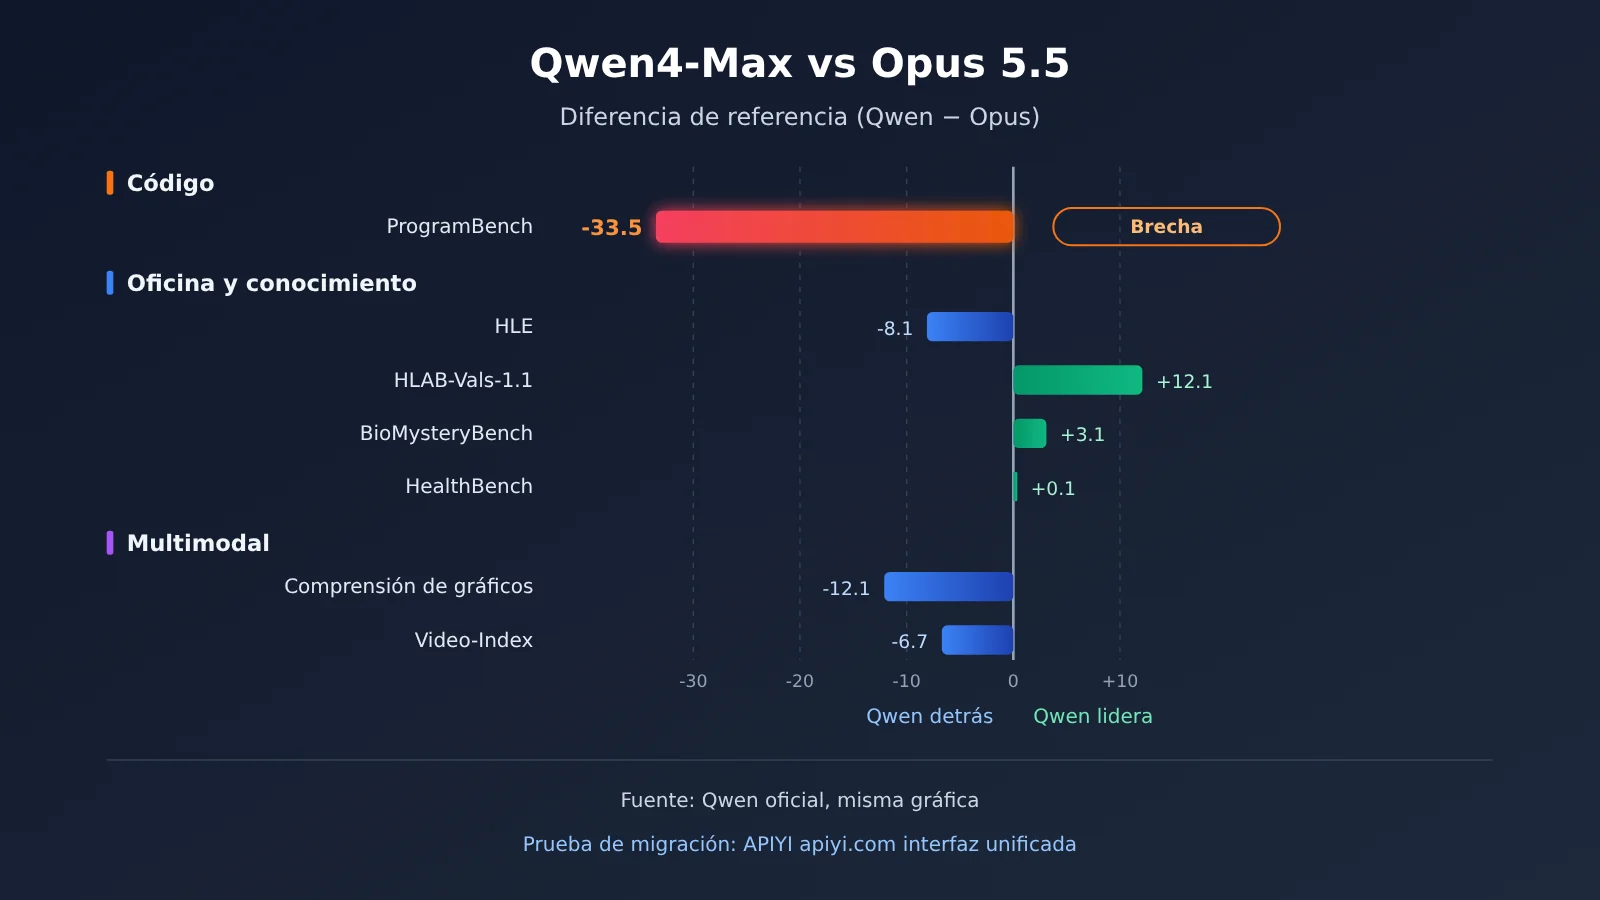
Conclusión directa, sin medias tintas: las operaciones de terminal y la refactorización a nivel de repositorio se quedan con Opus 5.5; Qwen4-Max pierde por 33.5 puntos en ProgramBench, que es su punto más débil en esta comparación. Para automatización de flujos de trabajo, agentes de alta concurrencia sensibles al costo y tareas documentales con salidas extremadamente largas, vale la pena probar Qwen4-Max primero. En entregables de oficina y tareas de comprensión de gráficos y video, Opus 5.5 sigue teniendo una ventaja clara.
Valor central: al terminar de leer, tendrás una tabla de decisión por tipo de tarea y entenderás con claridad las diferencias entre ambos en precio de caché, nivel de razonamiento predeterminado y pasos reales de migración.
Qwen4-Max frente a Opus 5.5: diferencias clave de un vistazo
Primero dejemos claro de dónde salen los datos. Las cifras de este artículo provienen de tres fuentes distintas que no deben leerse mezcladas:
- Comparación en la misma gráfica reportada por Qwen: Alibaba, en su blog de lanzamiento, usa una misma gráfica para listar las puntuaciones de Qwen4-Max y Opus 5.5; son resultados ejecutados por el propio fabricante, no una reproducción de terceros.
- Instantánea de clasificaciones públicas, 2026-11-14: la clasificación Code Arena WebDev de arena.ai, basada en votos públicos.
- Documentación original de Anthropic: las especificaciones y el precio de Opus 5.5 provienen de la página oficial del modelo de Anthropic y de su página de precios.
La siguiente tabla condensa las conclusiones de todo el artículo; los capítulos posteriores desarrollan la evidencia punto por punto.
| Tipo de tarea | Recomendación | Evidencia clave | Razón en una frase |
|---|---|---|---|
| Operaciones de terminal y refactorización a nivel de repositorio | Opus 5.5 | Terminal-Bench 11.1 menos, ProgramBench 33.5 menos | Las cadenas de comandos de varios pasos y los cambios en todo el repositorio son el punto más débil de Qwen4-Max |
| Codificación de corrección de un solo issue | Qwen4-Max, vale probar | DeepSWE 1.5 más | La capacidad de corrección local ya está pareja y la ventaja de precio es clara |
| Entregables de oficina y tareas largas | Opus 5.5 | AA-Briefcase 115 Elo menos, JobBench 6.9 menos | La diferencia de calidad en documentos e informes se nota |
| Automatización de workflows | Qwen4-Max | AutomationBench 3.0 más | Las tareas de proceso con reglas claras no pierden y cuestan menos |
| Comprensión de gráficos y vídeo | Opus 5.5 | Chartography 12.1 menos, Video-Index 6.7 menos | Sigue habiendo diferencias en la lectura multimodal de imágenes |
| Agentes de alta concurrencia sensibles al coste | Qwen4-Max | Entrada 37.5 %, salida 22.5 % | Con volumen alto, la diferencia en la factura se multiplica |
Diferencias de especificaciones entre Qwen4-Max y Opus 5.5
A nivel de especificaciones, ambos tienen una ventana de contexto de 1M, pero los valores por defecto de salida y razonamiento difieren bastante:
- Qwen4-Max: backbone de 2.4T, 71B activos, más 328B de N-gram Embedding; visión nativa; salida máxima de 393K, cadena de pensamiento máxima de 262K;
reasoning_effortpor defecto en high. - Opus 5.5 (documentación original de Anthropic): orientado a codificación agentic de larga duración y trabajo de conocimiento; salida máxima 128K; effort por defecto en medium; corte de conocimiento junio de 2026.
El detalle del nivel por defecto se pasa por alto con facilidad. Qwen4-Max arranca directamente en high y el proceso de pensamiento se factura como salida, así que la diferencia real en la factura suele ser menor que ese 22.5 % del precio de lista; la sección de precios más adelante ofrece un indicio de apoyo tomado de una clasificación pública.
Qwen4-Max frente a Opus 5.5: tareas de terminal y repositorios de código
Esta es la parte que más preocupa a los usuarios actuales de Opus, y también la que Qwen4-Max debe tratar con más cautela.
| Benchmark (comparación sobre la misma figura reportada por Qwen) | Qwen4-Max | Opus 5.5 | Diferencia |
|---|---|---|---|
| DeepSWE v1.1 | 75.7 | 74.2 | Qwen 1.5 más |
| CodeArena WebDev Elo | 1750 | 1816 | Qwen 66 menos |
| Terminal-Bench 4.0 | 48.5 | 59.6 | Qwen 11.1 menos |
| ProgramBench | 31.5 | 65.0 | Qwen 33.5 menos |
Veamos qué significan, punto por punto, en el trabajo real:
- DeepSWE 1.5 más: En tareas como hacer correcciones puntuales sobre un issue dado, Qwen4-Max ya está al mismo nivel que Opus 5.5; 1.5 puntos se pueden considerar prácticamente un empate, y es adecuado para ejecutar colas de corrección de bugs de bajo riesgo.
- WebDev 66 Elo menos: En la apariencia general de las páginas front-end generadas, los votos de los usuarios se inclinan más hacia Opus; a la hora de hacer landing pages o prototipos de componentes, la diferencia se nota a simple vista.
- Terminal-Bench 11.1 menos: La capacidad de ejecutar comandos en la terminal de forma continua, leer la salida y decidir el siguiente paso se queda claramente atrás; esto es el pan de cada día de los flujos de trabajo tipo Claude Code, así que cambiarse implica más bloqueos a mitad de camino o más intervenciones manuales.
- ProgramBench 33.5 menos: Esta es la mayor debilidad de esta comparación, con una puntuación casi reducida a la mitad. En tareas de construir un programa desde cero o reescribirlo a gran escala, Qwen4-Max no es actualmente un sustituto adecuado para Opus 5.5.
La clasificación pública también ofrece información de posición similar. Según la instantánea de la clasificación pública del 2026-11-14, arena.ai Code Arena WebDev suma 1,007,405 votos y 159 modelos: Opus 5.5 (Max) ocupa el puesto 2 con 1816 puntos, y Qwen4-Max (xHigh) el puesto 6 con 1750 puntos; pero este último solo tiene 1,814 votos y sigue marcado como Preliminary, así que su posición aún puede fluctuar.
Recomendaciones de uso de Qwen4-Max en escenarios de repositorios de código
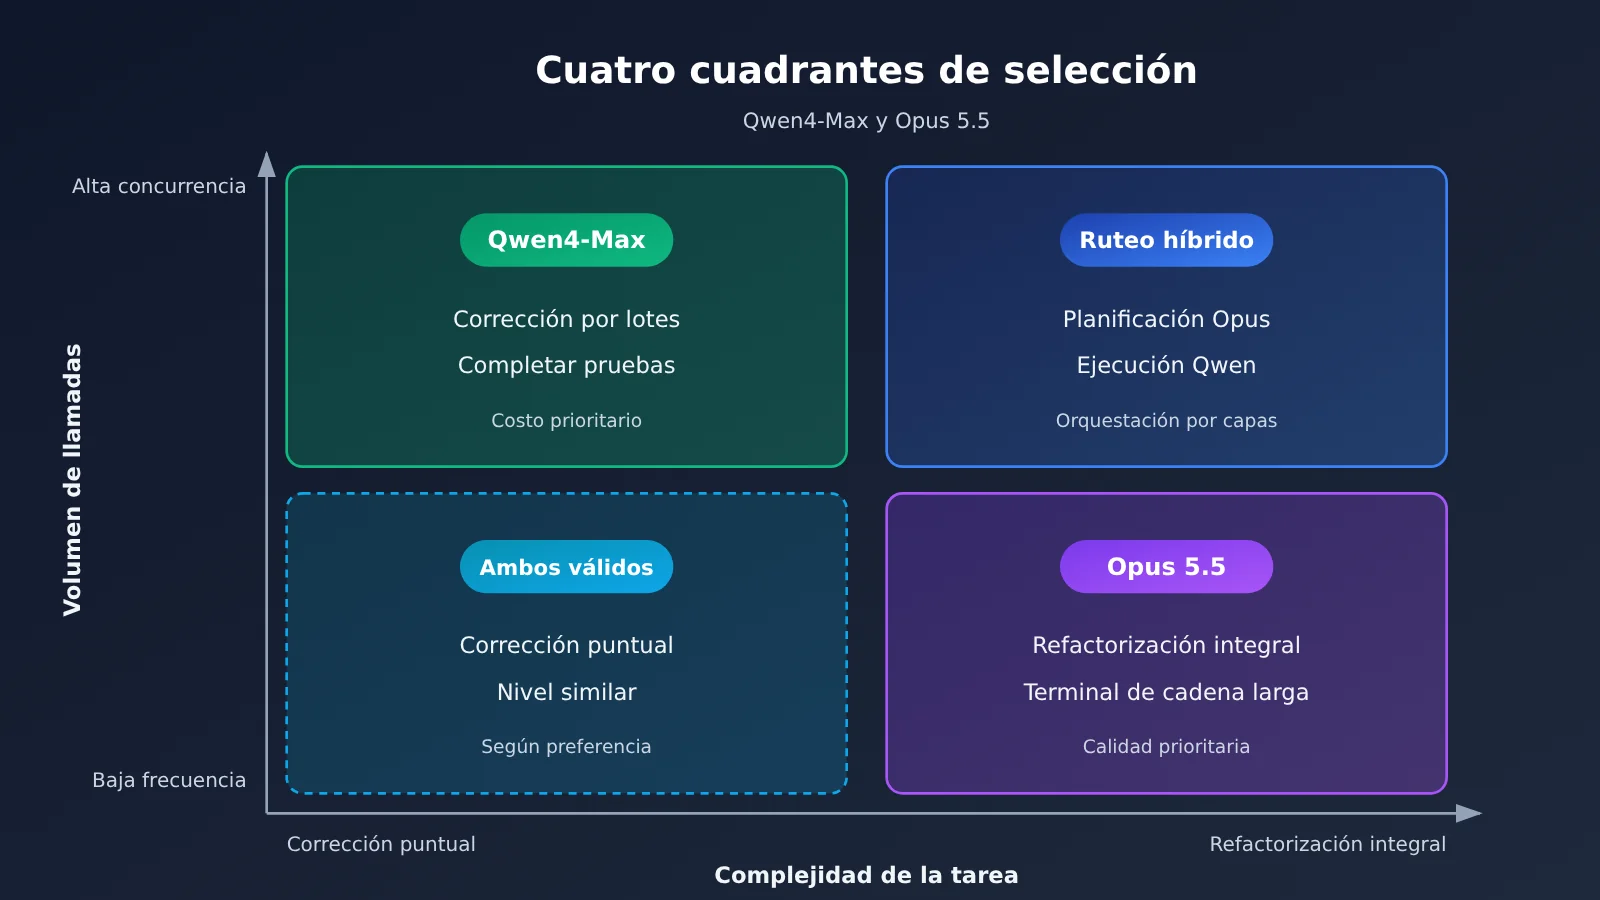
Si tu agente se dedica principalmente a refactorizaciones de todo el repositorio, migraciones entre módulos u operaciones de terminal de cadena larga, se recomienda mantener Opus 5.5 tal cual. Si divides las tareas en dos capas de «planificación + ejecución», puedes considerar dejar que Opus 5.5 se encargue de la planificación y los cambios clave, y derivar a Qwen4-Max las tareas locales como correcciones de archivos individuales o complementos de pruebas.
Qwen4-Max vs. Opus 5.5: trabajo de oficina y tareas largas
Los resultados en tareas de oficina y tareas de agente prolongadas están más divididos que los de programación: hay victorias y derrotas por ambas partes.
| Benchmark (comparación oficial de Qwen en la misma tabla) | Qwen4-Max | Opus 5.5 | Diferencia |
|---|---|---|---|
| AA-Briefcase v1.1 Elo | 1686 | 1801 | Qwen 115 por debajo |
| JobBench | 68.5 | 75.4 | Qwen 6.9 por debajo |
| APEX-Agents v1.1 | 72.1 | 73.5 | Qwen 1.4 por debajo |
| AutomationBench-AA | 72.5 | 69.5 | Qwen 3.0 por encima |
| AgentArena Net Improvement | 7.5 | 18.2 | Qwen 10.7 por debajo |
Trasladado al trabajo real:
- AA-Briefcase 115 Elo por debajo: en entregables de oficina como informes, propuestas y hojas de cálculo, los resultados finales de Opus 5.5 son más fáciles de adoptar directamente; esta es la mayor brecha en escenarios de oficina.
- JobBench 6.9 por debajo: Opus sigue liderando en la calidad general de tareas cercanas a puestos reales, lo que implica que la tasa de retrabajo en entregas de extremo a extremo podría ser mayor.
- APEX-Agents 1.4 por debajo: las tareas generales de agente están prácticamente empatadas; cambiar de modelo no debería suponer una diferencia perceptible en la experiencia.
- AutomationBench 3.0 por encima: la automatización de procesos con reglas bien definidas es, en cambio, un punto fuerte de Qwen4-Max; el procesamiento de formularios, el traslado de datos y la orquestación de tareas programadas son buenos candidatos para migrar primero.
- AgentArena Net Improvement 10.7 por debajo: la capacidad de mejora continua a lo largo de múltiples iteraciones es más débil; cuanto más larga es la tarea y más depende de la autocorrección del modelo, más sólido resulta Opus.
Además, la salida máxima de 393K de Qwen4-Max y su límite de 262K para la cadena de pensamiento son una ventaja real para tareas largas que necesitan generar contenido muy extenso de una sola vez; la salida máxima de Opus 5.5 es 128K.
Qwen4-Max frente a Opus 5.5: chino y documentos largos multimodales
Conviene aclararlo desde el principio: el gráfico comparativo de las referencias no incluye un benchmark específico para chino, así que este artículo no puede responder con cifras a la pregunta «quién lo hace mejor en chino». Si la calidad en chino es tu métrica principal, haz tu propia prueba A/B con tu conjunto de muestras y no te fíes de conclusiones de segunda mano.
Donde sí podemos hablar con números es en las tareas multimodales y de conocimiento:
| Benchmark (comparación sobre la misma imagen reportada por Qwen) | Qwen4-Max | Opus 5.5 | Diferencia |
|---|---|---|---|
| Chartography | 54.2 | 66.3 | Qwen 12.1 por debajo |
| Video-Index | 68.1 | 74.8 | Qwen 6.7 por debajo |
| Humanity’s Last Exam | 51.7 | 59.8 | Qwen 8.1 por debajo |
| HLAB-Vals-1.1 | 21.3 | 9.2 | Qwen 12.1 por encima |
| BioMysteryBench | 85.0 | 81.9 | Qwen 3.1 por encima |
| HealthBench Professional | 60.0 | 59.9 | Prácticamente empatados |
Lo que estos números significan en la práctica: al leer gráficos y extraer datos visuales de informes financieros y de investigación, Qwen4-Max queda 12.1 puntos por detrás, y es fácil que omita o malinterprete las coordenadas; en comprensión de vídeo también hay una diferencia de 6.7 puntos; en preguntas de conocimiento integral de alta dificultad (HLE) va 8.1 puntos por debajo. A la inversa, en razonamiento biológico y preguntas médicas especializadas, Qwen4-Max empata o incluso lleva una ligera ventaja, y en HLAB-Vals lidera por 12.1 puntos.
Por eso, conviene segmentar aún más las tareas con documentos largos: para documentos predominantemente textuales que exigen salidas muy extensas, Qwen4-Max puede ser la primera opción; para PDF con muchos gráficos o materiales que incluyen vídeo, sigue siendo recomendable usar Opus 5.5.
Precios por millón de tokens y cuentas de caché de Qwen4-Max y Opus 5.5
El precio es el argumento más contundente de Qwen4-Max. En la siguiente tabla, todas las unidades son por 1M tokens; los precios oficiales se tomaron de los documentos originales de QwenCloud y Anthropic, y el precio actual de APIYI se tomó de docs.apiyi.com/models. Fecha de consulta: 2026-11-16.
| Concepto de facturación ($/1M tokens) | Qwen4-Max oficial | Opus 5.5 oficial | Qwen/Opus | APIYI qwen3.8-max |
APIYI claude-opus-5-5 |
|---|---|---|---|---|---|
| Entrada | 1.5 | 4 | 37.5% | 1.65 | 4 |
| Salida | 4.5 | 20 | 22.5% | 4.95 | 20 |
| Lectura de caché | 0.075 | 0.20 | 37.5% | 0.20625 | 0.2 |
| Escritura de caché de 5 minutos | 1.875 | 5 | 37.5% | Según la lista de la plataforma | Según la lista de la plataforma |
| Escritura de caché de 1 hora | 3 | 8 | 37.5% | Según la lista de la plataforma | Según la lista de la plataforma |
En realidad, la estructura de caché de ambos proveedores es totalmente isomorfa: la lectura de caché es el 5% del precio de entrada, la escritura de caché de 5 minutos es 1.25 veces el precio de entrada y la escritura de caché de 1 hora es 2 veces. Esto significa que la estrategia de caché que diseñaste para Opus puedes trasladarla tal cual a Qwen4-Max, y la factura se reduce proporcionalmente al 37.5%. Ten en cuenta que en APIYI la lectura de caché de qwen3.8-max es el 12.5% del precio de entrada, una proporción distinta de la oficial de Qwen4-Max; al migrar, calcula por separado según el modelo real.
Un cálculo concreto
Tomemos como ejemplo 100 millones de tokens de entrada + 10 millones de tokens de salida: Qwen4-Max cuesta aproximadamente $195 (150 + 45) y Opus 5.5 aproximadamente $600 (400 + 200). La diferencia es de unos $405, equivalente a dos tercios de la factura de Opus.
Pero el precio de lista no es lo que se paga realmente. Instantánea del ranking público, 2026-11-14 ofrece el costo P50 por tarea: Opus 5.5 (Max) $8.99, Qwen4-Max (xHigh) $4.18, una ratio de aproximadamente 46%, y no el 22.5% del precio de lista. La razón es que los niveles de razonamiento de ambos son diferentes: Qwen4-Max viene por defecto en high, la cadena de pensamiento se factura como salida y consume más tokens. Cuánto ahorras realmente depende de la longitud de tus tareas y del nivel de razonamiento; te recomendamos medirlo reproduciendo tu propio tráfico.
💰 Recomendación de costos: al comparar facturas, registra también los volúmenes de tokens de entrada, salida, lectura y escritura de caché, no solo el precio unitario. Llamando a ambos modelos en paralelo bajo la misma cuenta a través de APIYI apiyi.com, los detalles de uso quedan alineados en un solo lugar.
Qwen4-Max frente a Opus 5.5: recomendaciones de decisión y tres pasos para migrar
Migrar un agente de Opus a Qwen implica inevitablemente tres pasos: verificar el modelo, comparar precios y revisar el protocolo.
Primer paso: verificar el modelo. A fecha de 2026-11-16, Qwen4-Max aún no está disponible en APIYI; incorporaremos este modelo lo antes posible. Actualmente, el modelo más potente del lado Qwen es qwen3.8-max. En el lado Opus está disponible claude-opus-5-5, además de claude-opus-5-5-thinking, con el mismo precio. Los modelos y precios deben consultarse en la lista de modelos del centro de documentación de apiyi.com; antes de que Qwen4-Max esté disponible, se puede usar qwen3.8-max para preparar la canalización de despliegue gradual.
Segundo paso: comparar precios. Siguiendo el método de la sección anterior, estime el coste de ambos lados con el tráfico real de una semana y compare después de alinear los niveles de razonamiento. La lista de modelos de APIYI en apiyi.com reúne entrada, salida y lectura de caché en una misma tabla general, por lo que se puede usar directamente como fuente de datos para la hoja de cálculo de costes.
Tercer paso: revisar el protocolo. APIYI ofrece una interfaz compatible con OpenAI, con endpoint https://api.apiyi.com/v1; al cambiar de modelo solo hay que modificar el campo model, por ejemplo, de claude-opus-5-5 a qwen3.8-max, manteniendo api_key y base_url sin cambios. Hay dos puntos adicionales que conviene verificar: en el lado Qwen, el parámetro de intensidad de razonamiento se llama reasoning_effort y su valor predeterminado es high; si se quiere alinear con el nivel medium de Opus, hay que establecerlo explícitamente. También deben verificarse de nuevo, según el modelo de destino, la duración de escritura en caché y las reglas de acierto de caché.
🎯 Recomendación para el despliegue gradual: no cambie todo el agente de una sola vez. Se recomienda enrutar por tipo de tarea el tráfico que pasa por el mismo
base_url(https://api.apiyi.com/v1): migre primero las tareas de automatización y de corrección local, y mantenga en Opus 5.5 las tareas de terminal y de repositorio completo; observe durante dos semanas la tasa de retrabajo antes de decidir el siguiente paso.
Preguntas frecuentes (FAQ)
Q1: ¿Qwen4-Max u Opus 5.5, cuál encaja mejor como agente de código?
Depende de la granularidad de la tarea. Para arreglar un único issue (DeepSWE), ambos están empatados y puedes ahorrar usando Qwen4-Max; en operaciones multiturno de terminal y en la construcción de repositorios completos (Terminal-Bench, ProgramBench), Opus 5.5 va claramente por delante, sobre todo en ProgramBench, donde saca 33.5 puntos de ventaja. Para ese tipo de tareas, sigue con Opus.
Q2: ¿Se pueden comparar directamente las puntuaciones del gráfico de Alibaba con la tabla de arena?
No bajo el mismo criterio. Lo primero es una comparación sobre el mismo gráfico que declara la propia Qwen; lo segundo es una instantánea de una tabla pública (2026-11-14), y además Qwen4-Max solo tiene 1,814 votos en la tabla y sigue en estado Preliminary. Puedes usar una y otra para contrastar tendencias, pero no deberías fusionarlas en una conclusión del tipo «cuántos puntos va por delante».
Q3: ¿Cuánto dinero se ahorra realmente al cambiarse a Qwen4-Max?
A precio de lista, la entrada ahorra un 62.5% y la salida un 77.5%. Pero el ratio de coste por tarea P50 en la tabla pública ronda el 46%, porque Qwen4-Max usa por defecto un nivel de razonamiento más alto y más tokens de pensamiento. El ahorro real tienes que medirlo reproduciendo tu propio tráfico.
Q4: ¿Ya se puede invocar Qwen4-Max en APIYI?
Por ahora no: Qwen4-Max todavía no está en el catálogo, pero lo añadiremos lo antes posible. Mientras tanto puedes usar `qwen3.8-max` para montar la ruta de migración; cuando esté disponible, solo tendrás que cambiar el campo `model`. Consulta el estado de los modelos en la lista de modelos de APIYI apiyi.com.
Q5: ¿Cuánto código hay que cambiar para pasar de Opus a Qwen?
Si ya usas la interfaz compatible con OpenAI, basta con apuntar `base_url` a `https://api.apiyi.com/v1`, cambiar el nombre del modelo y ajustar `reasoning_effort` según lo necesites. Después de registrarte en APIYI apiyi.com, puedes usar el crédito gratuito de prueba para nuevos usuarios y hacer primero una ronda de comparación.
Q6: ¿Qué limitaciones conocidas tiene Qwen4-Max?
La terminal y la codificación de repositorios completos son sus puntos más flojos: la comprensión de gráficos va 12.1 puntos por detrás, el Elo en entregables de oficina es 115 puntos más bajo y la capacidad de automejora en varias rondas también es más bien débil. Además, todas las puntuaciones comparativas las declara el fabricante, sin reproducción independiente por terceros, y tampoco hay datos de referencia específicos para sus capacidades en chino.
Qwen4-Max vs Opus 5.5: puntos clave (Key Takeaways)
- Mayor punto débil: ProgramBench 33,5 puntos por debajo; para construir y refactorizar repositorios completos, sigue usando Opus 5.5.
- Zonas de empate: DeepSWE, APEX-Agents y HealthBench están prácticamente igualados; se pueden derivar primero.
- Ventajas de Qwen: automatización de flujos de trabajo, razonamiento biomédico, salidas ultralargas de 393K.
- Estructura de precios: entrada 37,5 %, salida 22,5 %, y las cuatro proporciones de caché son exactamente isomórficas con Opus.
- Diferencia de pago real: el nivel de razonamiento predeterminado es high; la relación de coste de tareas en las clasificaciones públicas es de aproximadamente 46 %.
- Ruta de migración: en APIYI apiyi.com, usa primero
qwen3.8-maxcon el mismo endpoint; cuando Qwen4-Max esté disponible, simplemente reempláza.
Resumen
La elección entre Qwen4-Max y Opus 5.5 se puede resumir en tres puntos:
- Terminal y repositorios de código se quedan con Opus 5.5: la diferencia en Terminal-Bench y ProgramBench es tal que la diferencia de precio no compensa el coste de retrabajo.
- Automatización y alta concurrencia para Qwen4-Max: en tareas donde la capacidad está empatada o va por delante, una factura del 30 al 50 % es beneficio puro.
- Enrutar por tarea en lugar de reemplazar por completo: la misma interfaz, enrutando según el tipo de tarea, es la forma de migración con menor riesgo.
Se recomienda ejecutar primero una ronda de replay de tus propias tareas en APIYI apiyi.com con qwen3.8-max y claude-opus-5-5, y tomar la decisión final de cambio una vez que Qwen4-Max esté disponible.
📚 Referencias
- Blog de lanzamiento de Qwen4-Max: comparación entre las especificaciones del modelo y los benchmarks autodeclarados por el fabricante
- Enlace:
qwen.ai/blog?id=qwen4-max -
Descripción: incluye parámetros de arquitectura, límites de contexto y salida, y puntuaciones comparativas en un mismo gráfico
-
Descripción general de modelos de Anthropic: especificaciones de Opus 5.5
- Enlace:
platform.claude.com/docs/en/about-claude/models/overview.md -
Descripción: contexto, salida máxima, effort predeterminado y corte de conocimiento
-
Página de precios de Anthropic: precios de entrada, salida y caché de Opus 5.5
- Enlace:
platform.claude.com/docs/en/about-claude/pricing.md -
Descripción: incluye precios de escritura en caché de 5 minutos y 1 hora
-
Lista de modelos de APIYI: precios actuales y modelos disponibles en la plataforma
- Enlace:
docs.apiyi.com/models - Descripción: verificar el estado de disponibilidad y el precio de los modelos antes de migrar
Autor: Equipo técnico de APIYI
Comunicación técnica: puedes contactarnos en la página de inicio del sitio web de APIYI apiyi.com; para más materiales de integración, visita el centro de documentación en docs.apiyi.com