Anmerkung des Autors: Dieser Artikel erklärt die Neuerungen und Schwächen von Gemini Omni 1.2 Flash und hilft Entwicklern einzuschätzen, ob sich eine Evaluierung für die Videogenerierung lohnt.
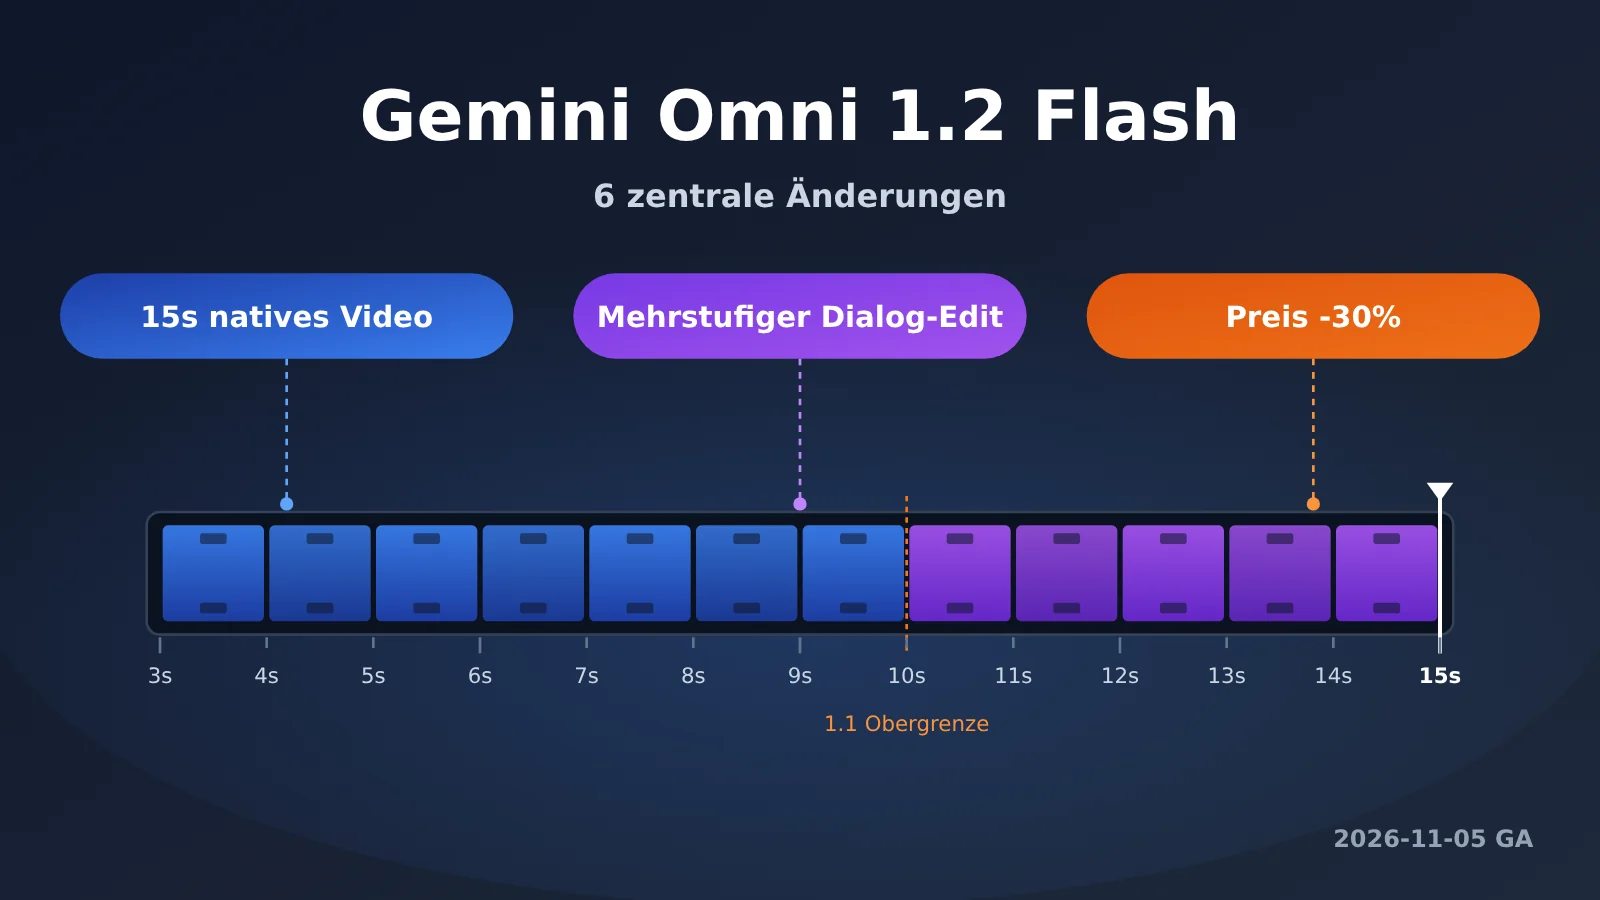
Google hat Gemini Omni 1.2 Flash am 5. November 2026 veröffentlicht und gleichzeitig über die Gemini API und Gemini for business allgemein verfügbar gemacht (GA). Die drei wichtigsten Neuerungen sind native 15-Sekunden-Videos, dialogbasierte Bearbeitung über mehrere Gesprächsrunden und ein Preis von 0,07 US-Dollar pro Sekunde bei 720p – 30 % weniger als bei Version 1.1. Auch Referenztreue, Konsistenz sowie Sprach- und Kamerasteuerung wurden verbessert.
Das ist kein Gerücht: Alle Angaben stammen aus dem offiziellen Google-Blogbeitrag zur Veröffentlichung, der von einem Produktmanager bei Google DeepMind verfasst wurde. Der Beitrag konzentriert sich allerdings auf die Darstellung der Ergebnisse und geht kaum auf Parameter, Modell-IDs und Ratenlimits ein – also auf das, was Entwickler wirklich interessiert. Dieser Artikel übersetzt die Marketingaussagen in konkrete Spezifikationen und Grenzen und zeigt, was Sie mit Ihrem eigenen Material noch überprüfen sollten.
Das Wichtigste auf einen Blick: Erfahren Sie in wenigen Minuten, was sich bei Gemini Omni 1.2 Flash gegenüber Version 1.1 geändert hat, welche Funktionen über die API verfügbar sind, welche nur in Google-Anwendungen und ob sich eine Evaluierung derzeit lohnt.
Gemini Omni 1.2 Flash: Das Wichtigste im Überblick
Die folgende Tabelle fasst die wichtigsten Punkte der Veröffentlichung zusammen. Alle Angaben stammen aus dem offiziellen Veröffentlichungsartikel. Nicht genannte Parameter wie Modell-ID, Schnittstellenform und Ratenbegrenzungen bleiben offen und werden später im Abschnitt „Noch zu prüfen“ behandelt.
| Information | Details zu Gemini Omni 1.2 Flash |
|---|---|
| Veröffentlichung | 2026-11-05, am selben Tag GA (allgemein verfügbar) |
| Anbieter | Google / Google DeepMind |
| Videolänge | 3–15 Sekunden, in Schritten von 1 Sekunde einstellbar (bei Version 1.1 maximal 10 Sekunden) |
| Preis | 0,07 US-Dollar pro Sekunde bei 720p (umgerechnet aus 12 US-Dollar pro 1 Million Tokens für die Videoausgabe und 5.792 Tokens pro Sekunde bei 720p), 30 % günstiger als Omni 1.1 |
| Auflösungs-Workflow | Zunächst schnell Entwürfe in 360p / 720p erstellen, anschließend zufriedenstellende Ergebnisse auf 1080p oder 4K hochskalieren |
| Referenzeingaben | Bilder von Figuren, Produkten oder Stilen, Bewegungsclips von bis zu 3 Sekunden und Audio-Eingabeaufforderungen |
| Bearbeitung | Dialogbasierte Bearbeitung über mehrere Runden hinweg, für den gesamten 15-Sekunden-Clip |
| Unternehmensfunktionen | Basierend auf der Infrastruktur von Google Cloud, mit Provisioned Throughput |
| Inhaltskennzeichnung | In die Ausgabe eingebettetes, nicht wahrnehmbares SynthID-Wasserzeichen |
| Offiziell eingeräumte Schwächen | Schnelle Sportbewegungen, schnelle Änderungen im Skript und komplexe Physik werden noch verbessert |
Was GA und Provisioned Throughput bei Gemini Omni 1.2 Flash bedeuten
Google betont, dass Gemini Omni zum ersten Mal den GA-Status erreicht hat. Für Entwickler bedeutet GA, dass das Modell die Vorschau- oder Experimentierphase verlassen hat und in Produktionsumgebungen eingesetzt werden kann. Üblicherweise sind Schnittstelle und Verhalten damit auch stabiler als bei einer Vorschauversion.
Provisioned Throughput bezeichnet reservierte Verarbeitungskapazität bei Google Cloud: Unternehmen kaufen im Voraus eine bestimmte Kapazität und erhalten dafür eine besser vorhersehbare Verfügbarkeit und Latenz zu Spitzenzeiten. Wenn dein Unternehmen Werbematerial in grossem Umfang generieren muss oder ein SLA für die rechtzeitige Bereitstellung der Videos gilt, kann das wichtiger sein als der Einzelpreis. Der Veröffentlichungsartikel nennt keine konkreten Abrechnungsmodalitäten; diese müssen auf der Preisseite von Google Cloud geprüft werden.
6 wichtige Änderungen in Gemini Omni 1.2 Flash gegenüber 1.1
Der offizielle Artikel veranschaulicht die Fortschritte anhand zahlreicher Beispielvideos. Wir haben die beschriebenen Änderungen aus Entwicklersicht zusammengefasst und unterscheiden zwischen „quantifizierbaren Änderungen an den Spezifikationen“ und „Verbesserungen der Ergebnisse“. Erstere lassen sich direkt in ein technisches Konzept übernehmen, Letztere müssen selbst getestet werden.
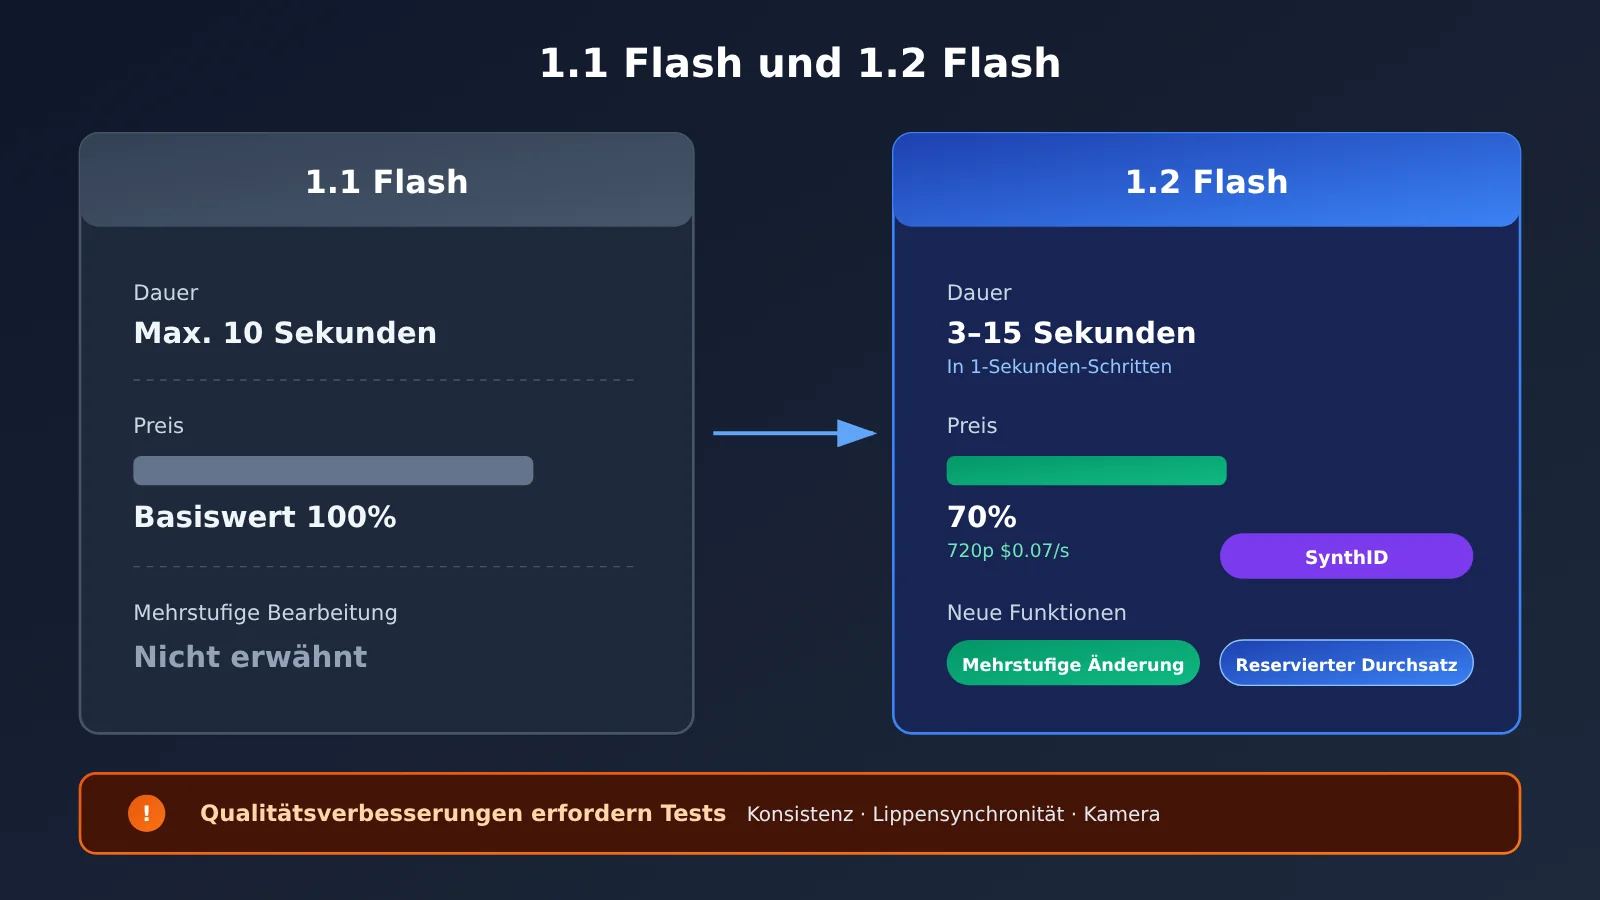
| Dimension | Gemini Omni 1.1 Flash | Gemini Omni 1.2 Flash | Art der Änderung |
|---|---|---|---|
| Maximale Dauer | 10 Sekunden | 15 Sekunden, 3–15 Sekunden in Schritten von 1 Sekunde einstellbar | Änderung der Spezifikation |
| Preis für 720p | 0,10 US-Dollar/Sekunde (17,50 US-Dollar pro 1 Million Tokens für die Videoausgabe) | 0,07 US-Dollar/Sekunde (12 US-Dollar pro 1 Million Tokens für die Videoausgabe) | Preisänderung |
| Einhaltung der Referenz | In offiziellen Beispielen geringere Übereinstimmung mit dem Referenzbild | Gesichter, Kleidung, Schrift auf Verpackungen und Markenfarben bleiben über Kameraperspektiven hinweg konsistent | Verbesserung der Ergebnisse |
| Konsistenz zwischen Anfangs- und Endframe | In Beispielen treten Abweichungen auf, etwa eine Katze auf dem Dach oder ein Suppenlöffel, der sich in Essstäbchen verwandelt | Weniger Detailabweichungen und Verformungen | Verbesserung der Ergebnisse |
| Bearbeitung über mehrere Runden | Im Ankündigungsartikel nicht erwähnt | Produkt/Hintergrund, Beleuchtung/Wetter und Seitenverhältnis lassen sich schrittweise ändern | Neue Funktion |
| GA-Status | Kein GA | Erstmals GA, mit Unterstützung für Provisioned Throughput | Änderung der Spezifikation |
💡 Hinweis zur Preisgestaltung: Google rechnet die Videoausgabe nach Tokens ab, nicht nach Sekunden. Die im Artikel genannten Preise pro Sekunde sind daher umgerechnete Werte. Beide Angaben stammen von der Preisseite der Gemini API: Für die Videoausgabe von 1.1 werden 17,50 US-Dollar pro 1 Million Tokens berechnet, für 1.2 sind es 12 US-Dollar. Bei 5.792 Ausgabetokens pro Sekunde für 720p ergibt das rund 0,10 beziehungsweise 0,07 US-Dollar pro Sekunde – ein Rückgang um etwa 30 %. Laut Preisseite werden Anfragen an gemini-omni-1.1-flash ab dem 3. Dezember 2026 automatisch an 1.2 weitergeleitet und zu dessen Preisen abgerechnet.
Änderung 1: Gemini Omni 1.2 Flash unterstützt flexible Laufzeiten von 3 bis 15 Sekunden
Die maximale Laufzeit steigt von 10 auf 15 Sekunden. Das sind zwar nur 5 Sekunden mehr, doch für viele Anwendungsfälle macht der Unterschied viel aus: Ein vollständiger Social-Media-Werbespot, eine Erklärung einer Produktfunktion oder eine Kurzgeschichte mit Anfang, Wendung und Schluss braucht oft 12–15 Sekunden. Früher musste man dafür zwei Clips zusammensetzen, jetzt lässt sich alles in einem Durchgang erzeugen.
Ein weiteres Detail übersieht man leicht: Die Laufzeit lässt sich sekundengenau festlegen. Bei Modellen mit sekundengenauer Abrechnung muss man für einen Clip von 7 Sekunden nicht mehr für 10 Sekunden bezahlen. Gerade bei der Massenerstellung hilft das, die Kosten zu kontrollieren.
Änderung 2: Referenzen umfassen Bilder, Bewegungsclips und Audio
Mit 1.2 Flash lassen sich verschiedene Referenzen kombinieren: Bilder von Figuren, Produkten oder Stilvorlagen, Bewegungsclips von bis zu 3 Sekunden und Audio-Vorgaben. In einem offiziellen Beispiel wurde aus einem Foto eines Models und Produktbildern von drei Outfits, jeweils von vorne und hinten, ein 15 Sekunden langes Video zur virtuellen Anprobe erzeugt. Bei einer 360-Grad-Drehung blieben das Aussehen des Models sowie Schnitt, Fall und Rückendetails jedes Kleidungsstücks erhalten.
Der naheliegendste Einsatzbereich ist der E-Commerce: Vorhandene Produktfotos oder Bilder von Figuren lassen sich in Anprobe-Clips, 360-Grad-Produktpräsentationen und Markenwerbung verwandeln. Wichtig ist dabei: Die maximale Länge von 3 Sekunden für Bewegungsclips ist eine feste Grenze. Längeres Referenzmaterial muss vorher zugeschnitten werden.
Änderung 3: Bessere Konsistenz bei Start- und Endframes sowie bei der Clipverlängerung
Laut Anbieter bleiben Figuren, Objekte und Szenen vom ersten bis zum letzten Frame stabiler. Bei Bewegungen und Kameraschnitten treten weniger visuelle Abweichungen und Verformungen auf. Das gilt für beide Anwendungsfälle: die Interpolation zwischen Start- und Endframe und die Verlängerung bestehender Clips zu längeren Sequenzen.
Interessant ist, dass der Anbieter im Vergleich der Start- und Endframes von 1.1 und 1.2 auch offen auf kleine Unterschiede hinweist – etwa eine Katze auf dem Dach oder einen Suppenlöffel, der sich in Essstäbchen verwandelt. Die Konsistenz hat sich also „deutlich verbessert“, das Problem ist aber nicht „vollständig gelöst“. Bei Szenen, in denen es auf Details ankommt, bleibt eine manuelle Prüfung nötig.
Änderung 4: Dialogbasierte Bearbeitung über mehrere Runden mit Gemini Omni 1.2 Flash
Diese Neuerung hat die grössten Auswirkungen auf den Workflow. Du kannst dasselbe Video Schritt für Schritt bearbeiten, etwa Produkte oder Hintergründe austauschen, Licht oder Wetter ändern oder das Seitenverhältnis wechseln – ohne es jedes Mal von Grund auf neu erzeugen zu müssen. In einem offiziellen Beispiel wird der Hintergrund eines generierten Videos fünfmal hintereinander geändert. Das Spiel der beiden Figuren, die Lichtreflexe auf ihren Rüstungen und die Bildkomposition bleiben dabei unverändert.
Die Bearbeitung über mehrere Runden erstreckt sich auf den gesamten 15-Sekunden-Clip. Als typische Anwendung nennt der Anbieter die Erstellung von Werbevarianten für verschiedene Zielgruppen und Platzierungen. Ein weiteres Beispiel ist die „Bewegungsübertragung“: In der ersten Runde wird ein sich wiegender Oktopus erzeugt, in der zweiten durch eine Tänzerin ersetzt. Ihr Kleid übernimmt dabei die fliessenden Bewegungen des Oktopus.
Änderung fünf: Natürlichere Sprache und Dialoge mit mehreren Personen
Die Dialoge in 1.2 Flash klingen flüssiger, die Lippensynchronisation ist präziser und das Modell kann mehrere Sprecher unterscheiden. In einem offiziellen Beispiel werden ein Szenenbild sowie vier Sets aus Rolle, Lippenbewegung und jeweils einer einsekündigen Sprachreferenz verwendet. So wird jede Sprachprobe der richtigen Figur zugeordnet.
Dabei ist wichtig: Die meisten Anwendungen, die Google in diesem Abschnitt nennt, sind eigene Produkte – Dialoge mit mehreren Figuren in Flow, Erklärvideos in Gemini for business sowie fertige Videos mit virtuellem Avatar und Sprechertext in Google Vids. Wie sich die Sprachfunktionen über die API aufrufen lassen und welche Parameter dafür nötig sind, erklärt der Ankündigungsartikel nicht.
Änderung sechs: Besser kontrollierbare kontinuierliche Kamerabewegungen
Laut Google treten bei komplexen, kontinuierlichen Kamerafahrten – etwa FPV-Flügen durch eine Szene, dramatischen Rückfahrten und Umkreisungen – deutlich weniger unbeabsichtigte Sprungschnitte auf. Auch die Proportionen bleiben stabiler. Zu den Beispielen gehören ein ungeschnittener FPV-Flug auf Basis von zwei Architekturfotos, der von einem Platz durch ein Kupfertor bis zur Kuppel des Pantheons führt, sowie eine zehnsekündige, durchgehende Kamerafahrt von einer Küstennahaufnahme zu einem Inselpanorama.
Wie der Kosten-Workflow von Gemini Omni 1.2 Flash funktioniert
Die Preissenkung um 30 % ist nur ein Teil der Rechnung. Google betont vor allem einen Workflow, der die Gesamtkosten senken soll: schnell einen Entwurf in niedriger Auflösung erstellen → Details in mehreren Bearbeitungsrunden verfeinern → nur die finale, zufriedenstellende Version hochskalieren. Im Vergleich dazu, bei jedem unbefriedigenden Ergebnis das gesamte Video neu zu generieren, kann das die Kosten für verworfene Versionen deutlich senken.
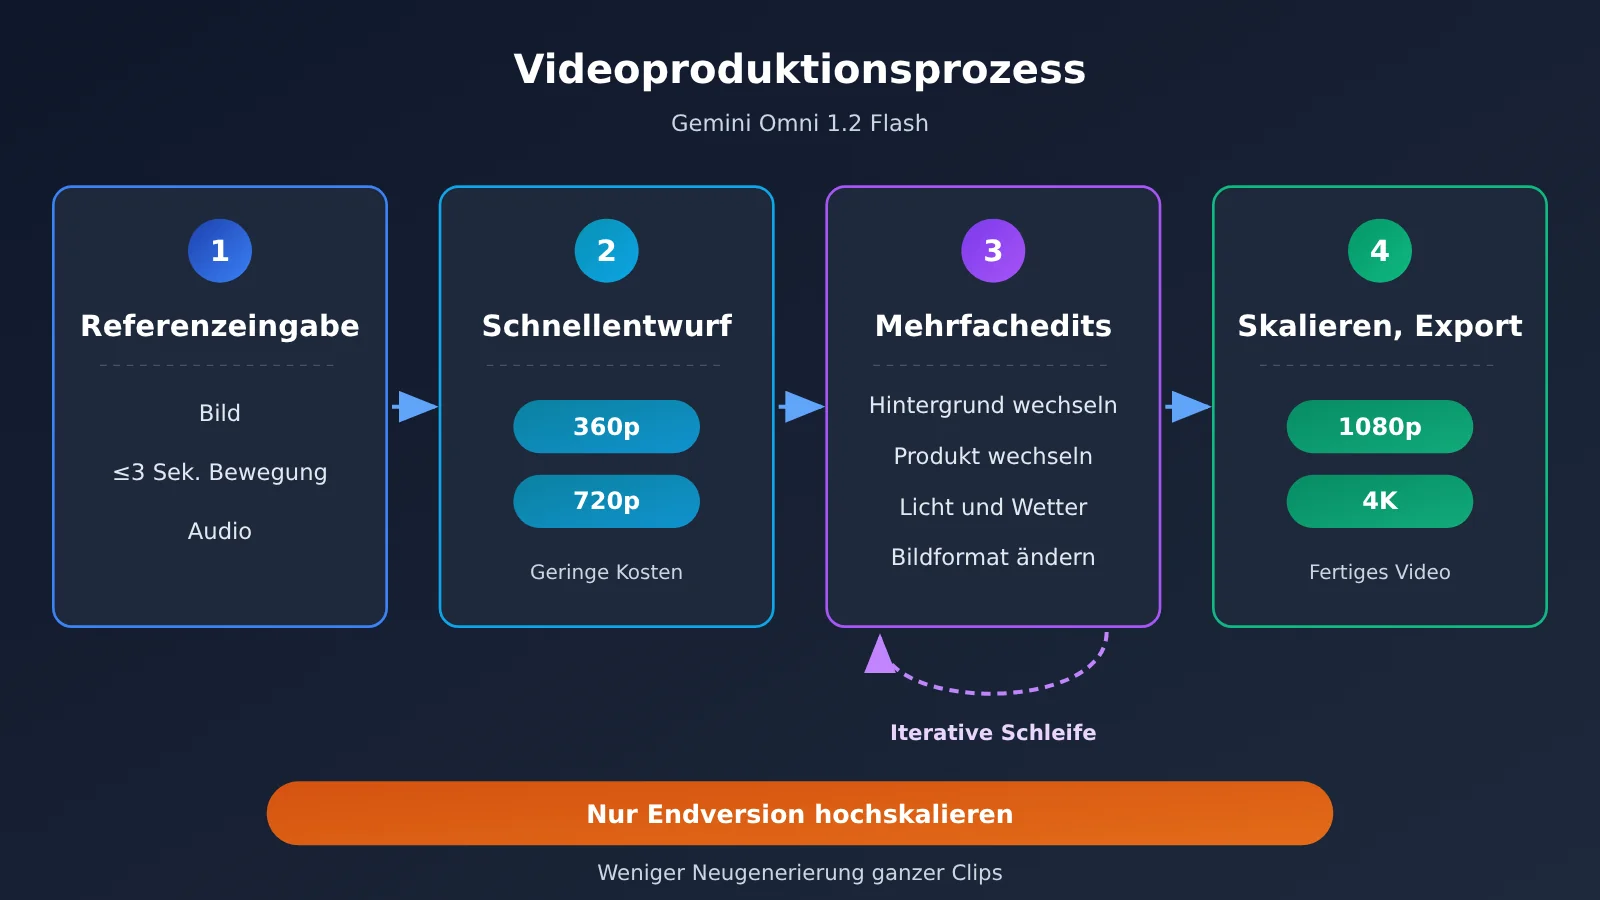
In Google AI Studio zeigt die Modellkarte Tokenpreise an: 1,50 US-Dollar pro 1 Million Eingabe-Tokens, 9 US-Dollar pro 1 Million Textausgabe-Tokens und 12 US-Dollar pro 1 Million Videoausgabe-Tokens. Das entspricht den oben genannten „0,07 US-Dollar pro Sekunde“ – lediglich die Abrechnungseinheit ist anders. Die offizielle Preisseite rechnet für 720p mit 5.792 Ausgabe-Tokens pro Sekunde und gibt auch Preise für die anderen Auflösungen an:
- 360p: 1.931 Ausgabe-Tokens pro Sekunde, ca. 0,023 US-Dollar/Sekunde
- 720p: 5.792 Ausgabe-Tokens pro Sekunde, ca. 0,07 US-Dollar/Sekunde
- 1080p (Hochskalierung): 8.688 Ausgabe-Tokens pro Sekunde, ca. 0,104 US-Dollar/Sekunde
- 4K (Hochskalierung): 17.376 Ausgabe-Tokens pro Sekunde, ca. 0,209 US-Dollar/Sekunde
Zum 720p-Preis ergeben sich für einen einzelnen Clip ungefähr folgende Kosten:
| Dauer | Kosten pro 720p-Clip (0,07 US-Dollar/Sekunde) | Typischer Einsatz |
|---|---|---|
| 3 Sekunden | ca. 0,21 US-Dollar | Einstellungstests, animierte Titelbilder |
| 6 Sekunden | ca. 0,42 US-Dollar | Kurze In-Feed-Werbeanzeigen |
| 10 Sekunden | ca. 0,70 US-Dollar | Präsentation von Produkt-Highlights |
| 15 Sekunden | ca. 1,05 US-Dollar | Vollständiger Werbespot, Produkterklärung |
Ob bei der Bearbeitung über mehrere Runden jede Runde für die volle Videolänge abgerechnet wird, geht aus dem Veröffentlichungsartikel nicht hervor. Das entscheidet unmittelbar darüber, wie viel günstiger die Bearbeitung gegenüber einer Neugenerierung tatsächlich ist. Deshalb empfiehlt es sich, bei einem kleinen Testlauf die tatsächlichen Kosten jeder Runde zu erfassen.
Ein weiterer großer Kostenfaktor bei der Videogenerierung ist das wiederholte Ausprobieren von Eingabeaufforderungen. Viele Teams lassen zunächst ein textbasiertes Großes Sprachmodell das Kreativbriefing in ein Storyboard und Bearbeitungsanweisungen für jede Runde aufteilen. Erst danach übernimmt das Videomodell die Umsetzung. So lassen sich erfolglose Generierungen reduzieren. In der einfachsten Variante ruft man ein Textmodell über eine OpenAI-kompatible Schnittstelle auf und lässt damit Eingabeaufforderungen für mehrere Bearbeitungsrunden auf einmal erstellen:
- SDK installieren: In Python
import openaiausführen und mitopenai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")einen Client erstellen. Die base_url verweist auf die OpenAI-kompatible Schnittstelle von APIYI. Verwende den Schlüssel aus der Konsole. - Modell für die Eingabeaufforderungen auswählen: Ersetze
YOUR_TEXT_MODELdurch ein verfügbares Gemini-, GPT- oder Claude-Textmodell aus der Modellliste der Plattform. Dieses Modell schreibt nur die Eingabeaufforderungen; das Videomodell wird separat aufgerufen. - Briefing als user-Nachricht senden: Übergib
messages=[{"role": "user", "content": "为一段 15 秒运动鞋广告写 4 轮编辑指令:换背景、换天气、换灯光、切 9:16"}]zusammen mit der Modell-ID anclient.chat.completions.create(...). - Ergebnis auslesen:
print(resp.choices[0].message.content)gibt die Bearbeitungsanweisungen aus. Übergib sie der Reihe nach an das Videomodell, sodass jede Runde das Ergebnis der vorherigen bearbeitet, statt das gesamte Video neu zu erzeugen.
Soll dasselbe Skript verschiedene Briefings verarbeiten, hilft die folgende Variante mit einer festen Ausgabestruktur.
- System-Eingabeaufforderung schreiben: Definiere sie als Python-String. Das Modell soll als Storyboard-Designer für Videoanzeigen arbeiten und ausschließlich JSON mit drei Schlüsseln ausgeben:
duration_sec(eine Ganzzahl von 3 bis 15),base_prompt(die Eingabeaufforderung für die erste Generierungsrunde) undedit_turns(die Bearbeitungsanweisungen ab der zweiten Runde). Ergänze eine Regel: Pro Runde wird nur eine Variable geändert – Hintergrund, Produkt, Beleuchtung, Wetter oder Bildformat. Figuren und Kameraeinstellung bleiben unverändert. - Funktion definieren:
build_video_plan(brief, variants, model="YOUR_TEXT_MODEL")nimmt ein Kreativbriefing und eine Liste der gewünschten Varianten entgegen. - user-Nachricht zusammensetzen: Hänge das Briefing per f-String an
创意简报:an und füge die Varianten, durch Kommas getrennt, nach需要的变体:ein. - Zwei Nachrichten auf einmal an das Textmodell senden: Die System-Eingabeaufforderung kommt in
system, der zusammengesetzte String inuser. Ergänzeresponse_format={"type": "json_object"}, damit sich die Antwort direkt als JSON parsen lässt. - Dauer parsen und begrenzen: Führe zuerst
plan = json.loads(resp.choices[0].message.content)aus, danachplan["duration_sec"] = max(3, min(15, int(plan.get("duration_sec", 15)))). Der Grund: Die Dauer liegt bei diesem Modell zwischen 3 und 15 Sekunden, in Schritten von einer Sekunde. - Mit einem echten Briefing testen: Zum Beispiel „Neuer Laufschuh, morgendlicher Lauf durch die Stadt, Leichtigkeit und Rückfederung hervorheben“. Als Varianten dienen „Straße bei Regen“, „Strand in der Abenddämmerung“ und „Wechsel zum Hochformat 9:16“. Gib das Ergebnis mit
json.dumps(plan, ensure_ascii=False, indent=2)aus. - An das Videomodell übergeben: Übergib
base_promptundedit_turnsan die Video-API deiner Wahl und führe die Runden nacheinander aus. Notiere die tatsächlichen Kosten pro Runde, bevor du viele Runden im Batch ausführst.
🚀 Tipp für den schnellen Einstieg: Storyboards und Bearbeitungsanweisungen lassen sich gut im Batch von einem Textmodell erstellen. Über APIYI apiyi.com kannst du mit demselben API-Schlüssel vergleichen, wie gut verschiedene Textmodelle Eingabeaufforderungen schreiben. Neue Nutzer erhalten ein kostenloses Testguthaben. Für Informationen zum Videomodell Gemini Omni selbst sind die offiziellen Google-Kanäle maßgeblich; ob APIYI dieses Modell bereits angebunden hat, steht in der Modellliste der Plattform.
Was Gemini Omni 1.2 Flash für Entwickler bedeutet
API-Funktionen von Gemini Omni 1.2 Flash und Funktionen in Google-Anwendungen unterscheiden
Der offizielle Artikel stellt die API, die Cloud-Plattform und mehrere Google-Anwendungen gemeinsam vor. Bei der Bewertung kann dadurch leicht der falsche Eindruck entstehen, dass sich jede Funktion über die API aufrufen lässt. Die folgende Tabelle trennt die Angebote nach Kanal.
| Kanal | Zielgruppe | Offiziell beschriebene Funktionen | Hinweise zur Auswahl |
|---|---|---|---|
| Gemini API / Google AI Studio | Entwickler | GA; Prototyping in AI Studio, interaktive Starter-Apps und Entwicklerdokumentation | Konkrete Parameter, Modell-IDs und Ratenlimits in der offiziellen Dokumentation prüfen |
| Google Cloud Console | Unternehmen | GA; Infrastruktur und Sicherheit auf Unternehmensniveau, Provisioned Throughput | Geeignet für Teams mit SLA- und hohen Volumenanforderungen |
| Flow | Kreative | Szenenregie, mehrstufige Bearbeitung, Dialoge mit mehreren Figuren | Funktion innerhalb der Anwendung, nicht gleichbedeutend mit API-Funktionen |
| Google Vids | Nutzer mit Google-Konto / Workspace-Nutzer | 15-Sekunden-Clips ohne zusätzliche Kosten | Funktion innerhalb der Anwendung; geeignet für nichttechnische Teams, um die Ergebnisse zu testen |
| Gemini-App | Abonnenten von Google AI Ultra | 15-Sekunden-Videos, schrittweiser Rollout | Der Rollout kann je nach Region und Konto unterschiedlich schnell erfolgen |
| Google Ads | Werbeteams | Erweiterung von Video-Marketingkampagnen | Für Werbekampagnen ausgelegt |
| Textunterstützung (Storyboards/Eingabeaufforderungen) | Entwickler | Kein offizieller Omni-Kanal; Textmodelle erzeugen Skripte und Bearbeitungsanweisungen | Verschiedene Textmodelle lassen sich über Plattformen wie APIYI apiyi.com aufrufen |
Auswirkungen für App-Entwickler
- Workflows verändern sich: Mehrstufige Bearbeitung macht das Prinzip „einmal generieren, mehrfach bearbeiten“ praktikabel. Produkte können eine chatähnliche Oberfläche zur Videobearbeitung anbieten, statt Nutzer jedes Mal eine vollständige Eingabeaufforderung neu schreiben zu lassen.
- Kostenmodelle müssen neu kalkuliert werden: Die sekundengenaue Abrechnung und die in 1-Sekunden-Schritten einstellbare Dauer bieten zusammen mit Entwürfen in niedriger Auflösung Potenzial für geringere Kosten pro Einheit. Zunächst muss aber klar sein, wie Bearbeitungsrunden abgerechnet werden.
- Compliance wird einfacher: Das SynthID-Wasserzeichen ist standardmäßig eingebettet. Das ist ein Plus für Plattformen, die KI-generierte Inhalte kennzeichnen müssen.
Auswirkungen für Content-Ersteller und Produktverantwortliche
- E-Commerce und Markenmaterial profitieren am stärksten: Die verbesserte Einhaltung von Referenzen und die höhere Konsistenz kommen häufigen Anforderungen wie virtuellen Anproben, 360-Grad-Produktansichten und Anzeigenvarianten entgegen.
- Bei bekannten Schwächen vorerst zurückhaltend investieren: Laut offizieller Aussage werden schnelle Sportbewegungen, schnelle Skriptwechsel und komplexe Physik noch verbessert. Für Sport- und Actioninhalte sowie Szenen mit ausgeprägten physikalischen Interaktionen eignet sich das Modell daher vorerst nicht als Hauptlösung.
Checkliste zur Auswahl von Gemini Omni 1.2 Flash
Die offiziellen Beispiele sind sorgfältig ausgewählte Vorzeigefälle. Unabhängige Tests der Ergebnisse gibt es bislang nur wenige. Prüfe die folgenden Punkte deshalb mit deinem eigenen Material, bevor du entscheidest, ob du das Modell in deine Lösung aufnimmst.
| Prüfpunkt | Warum testen? | Empfohlenes Vorgehen |
|---|---|---|
| Referenzkonsistenz | Offizielle Beispiele entsprechen nicht unbedingt deinen Produktbildern und Charakterdesigns | Mit eigenen Produktbildern und Verpackungen mit Schrift 10–20 Bilder generieren und die Verformungsrate erfassen |
| Schnelle Bewegungen und komplexe physikalische Vorgänge | Diese Schwächen räumt der Anbieter selbst ein | Gezielt Szenen mit Laufen, Springen, Kollisionen und Flüssigkeiten testen |
| Stabilität bei mehrstufiger Bearbeitung | Mit jeder Runde können sich Abweichungen ansammeln | Mehr als 5 Runden hintereinander bearbeiten und prüfen, ob Charaktere und Bildkomposition erhalten bleiben |
| Abrechnung bei Bearbeitungen | Bestimmt, wie viel sich tatsächlich sparen lässt | Mit einem kleinen Budget testen und die Kosten pro Runde dokumentieren |
| Schnittstellenparameter und Ratenlimits | Im Artikel zur Veröffentlichung nicht angegeben | Gemini API-Entwicklerdokumentation prüfen und Lasttests durchführen |
| Sprache und Lippensynchronität | Die Qualität bei nicht englischen Dialogen, etwa auf Chinesisch, ist unbekannt | Dialoge mit mehreren Personen in der Zielsprache testen |
Häufig gestellte Fragen (FAQ)
Q1: Was ist Gemini Omni 1.2 Flash?
Gemini Omni 1.2 Flash ist ein Videogenerierungsmodell, das Google am 2026-11-05 veröffentlicht und allgemein verfügbar gemacht hat (GA). Es ist auf Geschwindigkeit und niedrige Kosten ausgelegt und unterstützt native Videos von 3–15 Sekunden, verschiedene Referenzeingaben und dialogbasierte Bearbeitung über mehrere Runden. Bei 720p kostet es 0,07 US-Dollar pro Sekunde.
Q2: Was unterscheidet Gemini Omni 1.2 Flash von Version 1.1?
Version 1.1 erzeugt Videos von höchstens 10 Sekunden. Bei 1.2 sind es bis zu 15 Sekunden, wobei sich die Länge in Schritten von 1 Sekunde einstellen lässt. Der Preis ist um 30 % gesunken, und die dialogbasierte Bearbeitung über mehrere Runden ist hinzugekommen. Auch die Orientierung an Referenzen, die Konsistenz zwischen Anfangs- und Endframe, die Lippensynchronität und kontinuierliche Kamerafahrten wurden verbessert. Zudem ist das Modell erstmals allgemein verfügbar und bietet Provisioned Throughput.
Q3: Ist Gemini Omni 1.2 Flash bereits verfügbar?
Ja. Es ist in der Gemini API und auf Google Cloud allgemein verfügbar. Entwickler können Prototypen in Google AI Studio testen. Google Vids, Flow und Google Ads bieten es ebenfalls an. In der Gemini-App wird es schrittweise für Abonnenten von Google AI Ultra freigeschaltet.
Q4: Für welche Einsatzbereiche eignet sich Gemini Omni 1.2 Flash besonders?
– **Virtuelle Anprobe und Produktpräsentation im E-Commerce**: Mit Modelfotos und Produktbildern Anprobevideos und 360-Grad-Präsentationen erzeugen
– **Werbevarianten in grosser Stückzahl**: Ein Video über mehrere Runden bearbeiten und Versionen mit unterschiedlichen Hintergründen, Wetterbedingungen und Bildformaten erstellen
– **Kurze Produkt- und Erklärvideos**: In 15 Sekunden eine Erklärung mit mehreren Einstellungen umsetzen; im offiziellen Beispiel sind die eingeblendeten Texte korrekt geschrieben
– **Räume mit kontinuierlicher Kamerafahrt zeigen**: FPV-Flüge durch Gebäude und Sehenswürdigkeiten sowie Kamerafahrten, die sich davon entfernen
Q5: Lässt sich Gemini Omni 1.2 Flash über APIYI aufrufen?
APIYI bietet bereits Zugang zu den Textmodellen der Gemini-Reihe. Ob die Gemini-Omni-Videomodelle verfügbar sind, entnehmen Sie bitte der Modellliste auf der Plattform; dieser Artikel macht dazu keine Zusage. Bis dahin können Sie über APIYI unter apiyi.com Textmodelle aufrufen, um Storyboards und Anweisungen für mehrstufige Bearbeitungen zu erstellen. Die Videos selbst erzeugen Sie über die offiziellen Google-Kanäle.
Q6: Welche bekannten Einschränkungen hat Gemini Omni 1.2 Flash?
Google räumt ein, dass schnelle Sportbewegungen, schnelle Skriptänderungen und komplexe physikalische Abläufe noch verbessert werden müssen. Auch im Beispiel mit Anfangs- und Endframe sind leichte Abweichungen in den Details zu erkennen. Ausserdem nennt der Veröffentlichungsartikel weder API-Parameter noch Modell-ID oder Rate-Limits; diese finden Sie in der offiziellen Dokumentation. Die Hochskalierung auf 1080p kostet etwa 0,104 US-Dollar pro Sekunde, auf 4K etwa 0,209 US-Dollar pro Sekunde. Beide Preise stehen auf der Preisseite.
Q7: Wie lassen sich die Kosten für das Ausprobieren von Eingabeaufforderungen bei der Videogenerierung senken?
Lassen Sie zunächst ein Textmodell das Briefing in ein strukturiertes Storyboard und Bearbeitungsanweisungen aufteilen, die pro Runde nur eine Variable ändern. Übergeben Sie diese dann an das Videomodell. So lassen sich deutlich mehr unbrauchbare Ergebnisse vermeiden. Über die einheitliche Schnittstelle von APIYI unter apiyi.com können Sie schnell vergleichen, wie gut verschiedene Textmodelle Eingabeaufforderungen formulieren, und das passende Modell für Ihren Anwendungsfall auswählen.
Gemini Omni 1.2 Flash: Das Wichtigste auf einen Blick
- Längere Videos: bis zu 15 Sekunden, von 3 bis 15 Sekunden in Ein-Sekunden-Schritten einstellbar – genug, um einen vollständigen Werbeclip in einem Durchgang zu erzeugen
- Günstiger: 720p kostet 0,07 US-Dollar pro Sekunde, 30 % weniger als bei Version 1.1
- Kostensparender Workflow: Entwurf in niedriger Auflösung erstellen, mehrfach bearbeiten und nur die finale Version hochskalieren
- Zuverlässigere Referenzen: Bilder, bis zu 3 Sekunden lange Bewegungsclips und Audio geben gemeinsam den Rahmen vor und sorgen für Konsistenz über verschiedene Kameraperspektiven hinweg
- Erstmals allgemein verfügbar: Unterstützung für Provisioned Throughput; die Ausgabe enthält ein eingebettetes SynthID-Wasserzeichen
- Klare Grenzen: Bei schnellen Bewegungen und komplexer Physik ist weiterhin Vorsicht geboten – unbedingt mit eigenem Material testen
- Ergänzender Workflow: Storyboards und Bearbeitungsanweisungen lassen sich über Textmodelle bei APIYI apiyi.com automatisiert in grösseren Mengen erstellen
Fazit: Lohnt es sich, Gemini Omni 1.2 Flash schon jetzt zu testen?
Die wichtigsten Punkte zu Gemini Omni 1.2 Flash:
- Konkrete technische Verbesserungen: 15 Sekunden Dauer, Einstellung in Ein-Sekunden-Schritten, 30 % günstiger und erstmals allgemein verfügbar – diese Angaben lassen sich direkt in ein technisches Konzept übernehmen
- Mehrstufige Bearbeitung verändert den Workflow: Statt den gesamten Clip neu zu erzeugen, lässt er sich Schritt für Schritt überarbeiten. Das ist besonders für Werbevarianten und E-Commerce-Material interessant
- Verbesserungen müssen sich im Praxistest beweisen: Die Fortschritte bei Konsistenz, Lippensynchronität und Kameraführung stammen aus offiziellen Beispielen. Wie gut das mit deinem Material funktioniert, musst du selbst überprüfen
Wenn du Videos für E-Commerce, Markenwerbung oder Produkterklärungen erstellst, lohnt sich jetzt ein Vergleichstest mit eigenem Material in Google AI Studio. Geht es hauptsächlich um Sport, schnelle Bewegungen oder intensive physikalische Interaktionen, kannst du zunächst spätere Versionen abwarten.
Für die Evaluierung empfiehlt es sich, über APIYI apiyi.com mit demselben API-Schlüssel verschiedene Textmodelle aufzurufen und damit Storyboards sowie Bearbeitungsanweisungen zu erstellen. So lassen sich die Kosten für das Experimentieren mit Eingabeaufforderungen senken. Neue Nutzer erhalten auf der Plattform ein kostenloses Testguthaben.
📚 Quellen
- Offizieller Google-Blog – Ankündigung von Gemini Omni 1.2 Flash: Quelle für alle Fakten in diesem Artikel
- Link:
blog.google/innovation-and-ai/technology/developers-tools/introducing-gemini-omni-1-2-flash/ -
Inhalt: Offizielle Angaben zu Dauer, Preisen, Referenzeingaben, mehrstufiger Bearbeitung, verfügbaren Zugangswegen und bekannten Schwächen
-
Google AI Studio: Einstiegspunkt für Prototypen mit der Gemini API
- Link:
aistudio.google.com - Inhalt: Der offiziell empfohlene Zugang für Entwickler zum Ausprobieren, mit Starter-Apps und Entwicklerdokumentation
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI auf apiyi.com. Weitere Informationen zur Anbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com.