ملاحظة المؤلف: نقارن هنا بين Qwen4-Max وClaude Opus 5.5 عبر أربع فئات من المهام — الطرفية ومستودعات الأكواد، والمهام المكتبية الطويلة، والمستندات الطويلة متعددة الوسائط، والتكلفة — من حيث نتائج الاختبارات والمواصفات وسعر التخزين المؤقت وتكلفة الانتقال، ثم نقدّم توصيات قابلة للتنفيذ لاختيار النموذج.
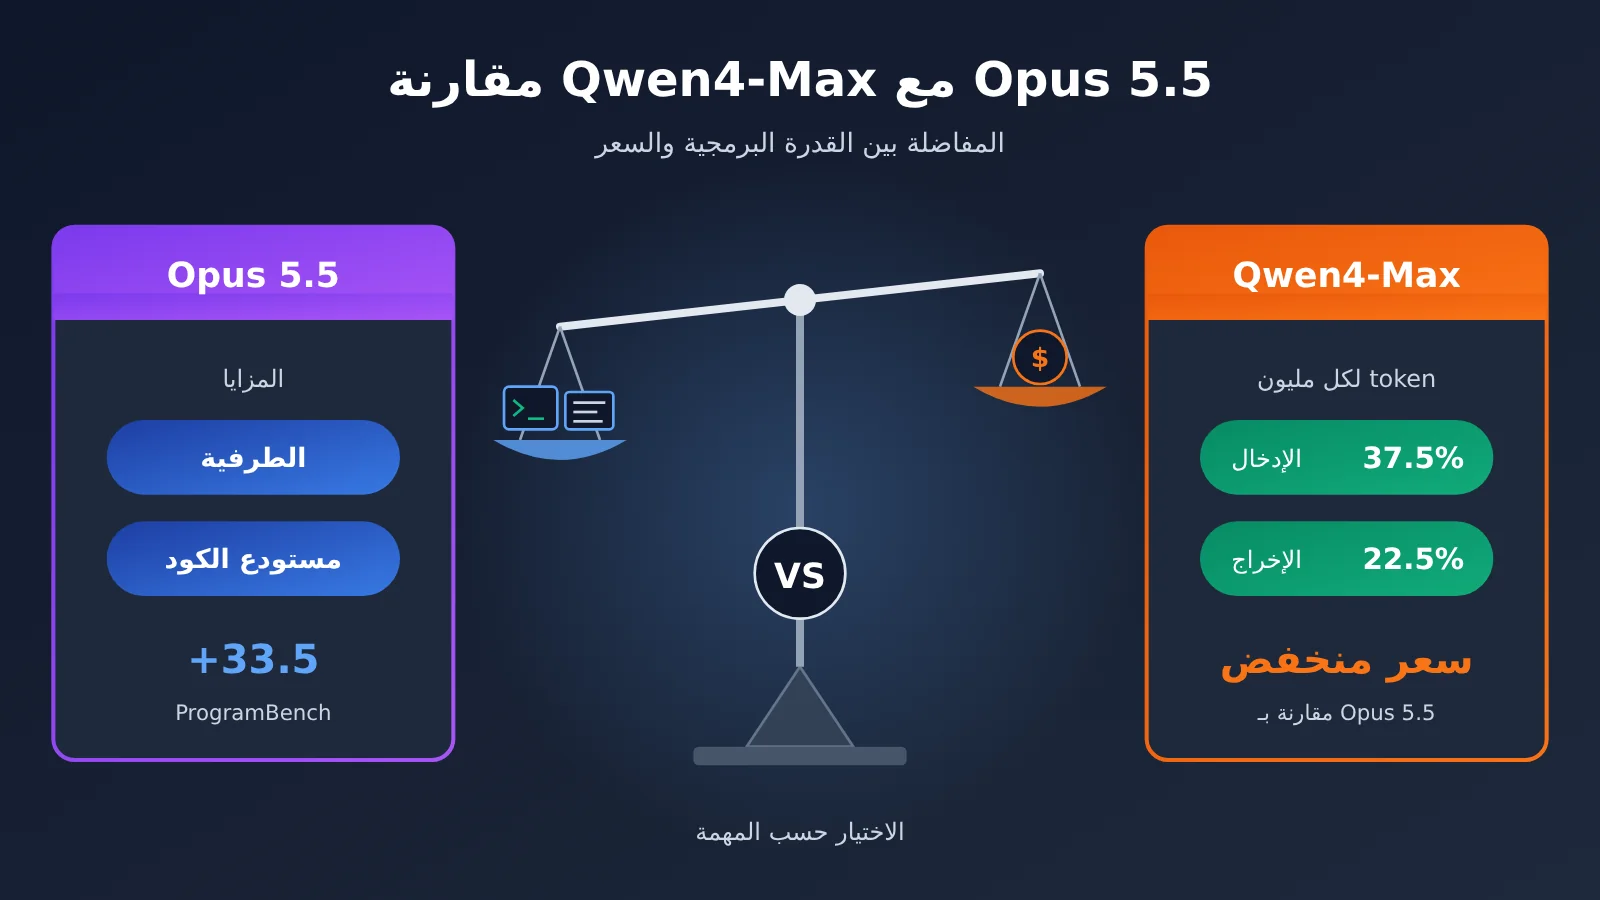
إذا كان فريقك يعتمد Claude Opus 5.5 بوصفه النموذج الرئيسي ويشغّله في الإنتاج داخل Claude Code أو داخل وكيل مُنشأ ذاتيًا، فإن Qwen4-Max الذي صدر في 2026-11-16 سيجعلك تعيد حساب الفاتورة: فسعر الإدخال لديه لا يتجاوز 37.5% من سعر Opus 5.5، وسعر الإخراج لا يتجاوز 22.5%.
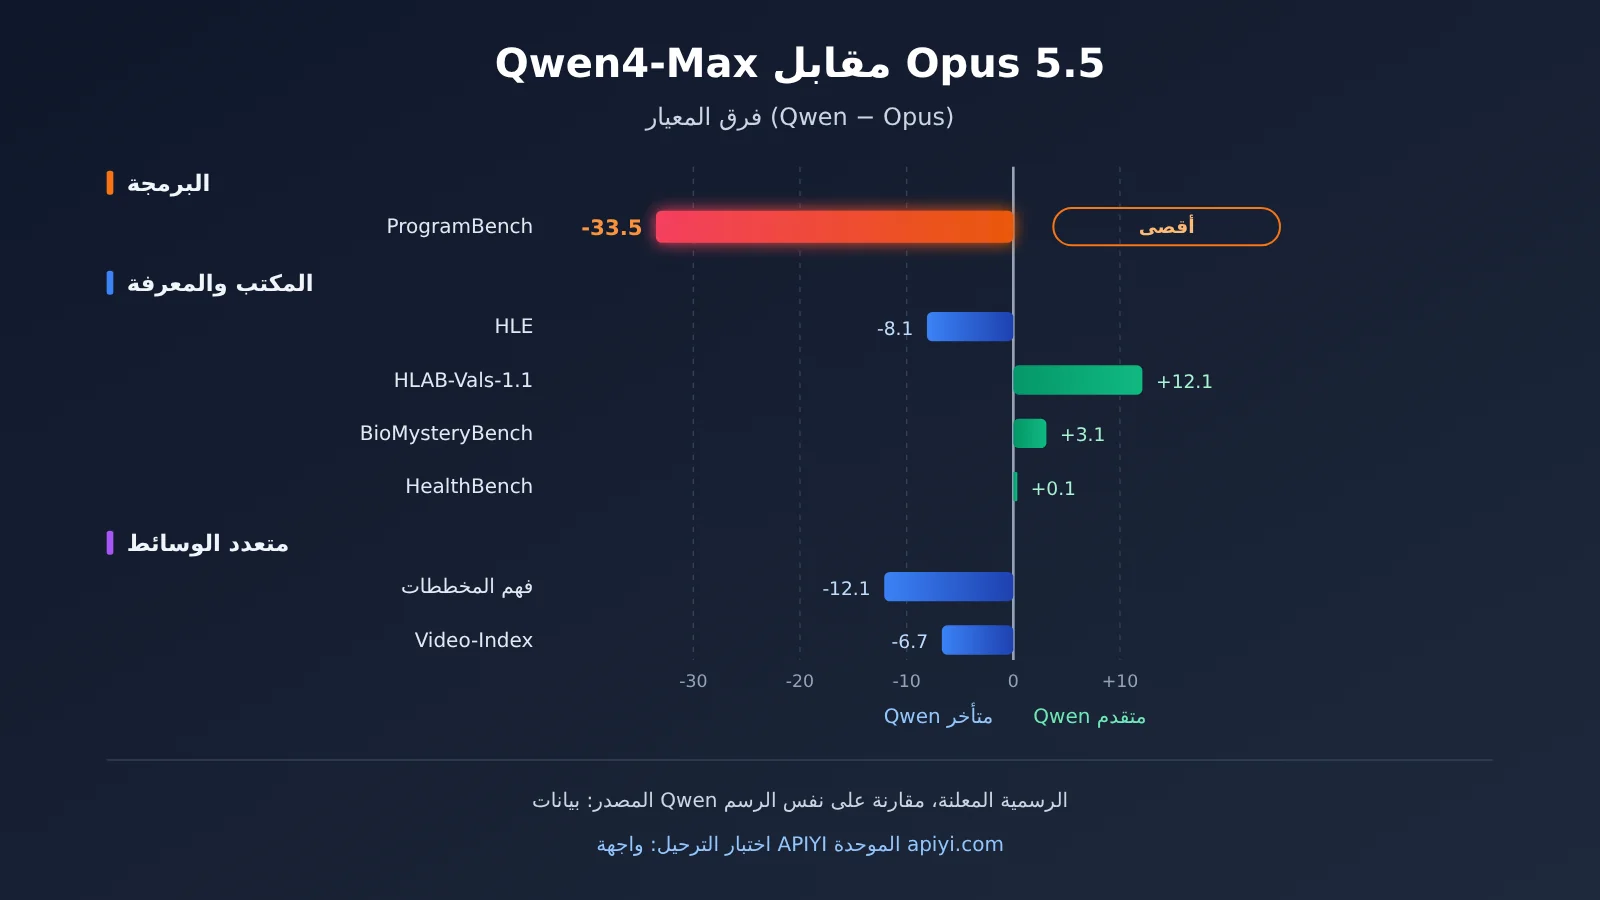
الخلاصة أولاً، وبلا حلول وسط: يبقى العمل على الطرفية وإعادة الهيكلة على مستوى المستودع مع Opus 5.5، إذ يتأخر Qwen4-Max على ProgramBench بمقدار 33.5 نقطة، وهي أكبر نقطة ضعف في هذه المقارنة؛ أما أتمتة سير العمل، والوكلاء ذوو التزامن العالي الحساسون للتكلفة، ومهام المستندات ذات الإخراج الطويل جدًا، فيمكن تجربة Qwen4-Max فيها أولاً؛ وفي مخرجات العمل المكتبي والرسوم البيانية وفهم الفيديو، لا يزال Opus 5.5 متقدّمًا بوضوح.
القيمة الأساسية: بعد قراءة هذا المقال ستكون لديك جدول مفاضلة مقسّم حسب نوع المهمة، مع وضوح الفروق بين الجانبين في سعر التخزين المؤقت ومستوى الاستدلال الافتراضي وخطوات الانتقال الفعلية.
نظرة سريعة على الفروق الجوهرية بين Qwen4-Max و Opus 5.5
لنوضّح أولاً مصدر البيانات. الأرقام الواردة في هذا المقال تأتي من ثلاث مجموعات مختلفة تماماً، ولا يجوز خلطها عند القراءة:
- مقارنة على الرسم نفسه أعلنتها Qwen رسمياً: نشرت علي بابا في مدونة الإطلاق رسماً واحداً يضم درجات Qwen4-Max و Opus 5.5، وهي نتائج شغّلها المصنّع بنفسه ولم يعِدها طرف ثالث.
- لقطة من لوحة تصنيف عامة، 2026-11-14: لوحة Code Arena WebDev على arena.ai، مبنية على تصويت عام.
- نص وثائق Anthropic: مواصفات Opus 5.5 وأسعاره مأخوذة من صفحة النموذج الرسمية وصفحة الأسعار لدى Anthropic.
الجدول التالي يلخّص استنتاجات المقال كاملة، وستتناول الأقسام اللاحقة الأدلة بنداً بنداً.
| نوع المهمة | التوصية | الدليل الأساسي | السبب في سطر واحد |
|---|---|---|---|
| عمليات الطرفية وإعادة الهيكلة على مستوى المستودع | Opus 5.5 | أقل بـ 11.1 في Terminal-Bench، وأقل بـ 33.5 في ProgramBench | سلاسل الأوامر متعددة الخطوات والتعديلات على المستودع كاملاً هي أضعف حلقة عند Qwen4-Max |
| البرمجة من نوع إصلاح مشكلة واحدة | Qwen4-Max يستحق التجربة | أعلى بـ 1.5 في DeepSWE | قدرته على الإصلاح الموضعي باتت تضارع المنافس، وميزته السعرية واضحة |
| مخرجات العمل المكتبي والمهام الطويلة | Opus 5.5 | أقل بـ 115 نقطة Elo في AA-Briefcase، وأقل بـ 6.9 في JobBench | فارق الجودة في مخرجات المستندات والتقارير ملموس |
| أتمتة سير العمل | Qwen4-Max | أعلى بـ 3.0 في AutomationBench | لا يقلّ عنه في مهام العمليات ذات القواعد الواضحة، وتكلفته أدنى |
| فهم الرسوم البيانية والفيديو | Opus 5.5 | أقل بـ 12.1 في Chartography، وأقل بـ 6.7 في Video-Index | لا يزال هناك فارق في القراءة متعددة الوسائط للصور |
| وكلاء بحساسية عالية للتكلفة مع توازٍ كبير | Qwen4-Max | الإدخال 37.5%، والإخراج 22.5% | عند الأحجام الكبيرة يتضاعف فارق الفاتورة |
الفروق في مواصفات Qwen4-Max و Opus 5.5
على مستوى المواصفات، نافذة السياق لدى كليهما 1M، لكن القيم الافتراضية للإخراج والاستدلال تختلف اختلافاً كبيراً:
- Qwen4-Max: هيكل أساسي بسعة 2.4T و71B معاملاً نشطاً، إضافة إلى 328B من N-gram Embedding؛ رؤية أصلية؛ أقصى إخراج 393K وأقصى سلسلة تفكير 262K؛ القيمة الافتراضية لـ
reasoning_effortهي high. - Opus 5.5 (بحسب نص وثائق Anthropic): موجّه للبرمجة الوكيلية الطويلة الأمد والعمل المعرفي؛ أقصى إخراج 128K؛ مستوى effort الافتراضي medium؛ المعرفة محدّثة حتى يونيو 2026.
مسألة المستوى الافتراضي هذه يسهل تجاهلها. فـ Qwen4-Max يبدأ افتراضياً عند high، وتُحاسَب عملية التفكير ضمن الإخراج، لذا فإن فارق الفاتورة الفعلي عادةً أقل من نسبة 22.5% المعلنة على مستوى السعر؛ وسيقدّم قسم الأسعار لاحقاً قرينة على ذلك من لوحة تصنيف عامة.
مقارنة Qwen4-Max مع Opus 5.5: مهام الطرفية ومستودعات الشيفرة
هذا هو الجزء الذي يهم مستخدمي Opus الحاليين أكثر من غيره، وهو أيضًا الجزء الذي يحتاج فيه Qwen4-Max إلى أكبر قدر من الحذر.
| المعيار (مقارنة على الرسم البياني نفسه، وفق ما أعلنته Qwen رسميًا) | Qwen4-Max | Opus 5.5 | الفرق |
|---|---|---|---|
| DeepSWE v1.1 | 75.7 | 74.2 | Qwen أعلى بـ 1.5 |
| CodeArena WebDev Elo | 1750 | 1816 | Qwen أقل بـ 66 |
| Terminal-Bench 4.0 | 48.5 | 59.6 | Qwen أقل بـ 11.1 |
| ProgramBench | 31.5 | 65.0 | Qwen أقل بـ 33.5 |
لننظر إلى معنى كل بند على حدة في العمل الفعلي:
- DeepSWE أعلى بـ 1.5: في المهام من نوع الإصلاح النقطي المحدد استنادًا إلى issue معيّنة، أصبح Qwen4-Max في المستوى نفسه مع Opus 5.5، ويمكن اعتبار 1.5 نقطة تعادلًا في الأساس، ما يجعله مناسبًا لتشغيل قوائم إصلاح الأخطاء منخفضة المخاطر.
- WebDev أقل بـ 66 نقطة Elo: في الانطباع العام لصفحات الواجهة الأمامية المولّدة، يميل تصويت المستخدمين أكثر إلى Opus، والفرق يمكن رؤيته بالعين المجردة عند إعداد صفحات الهبوط ونماذج المكوّنات.
- Terminal-Bench أقل بـ 11.1: القدرة على تنفيذ الأوامر تتابعيًا في الطرفية وقراءة المخرجات ثم تحديد الخطوة التالية متأخرة بوضوح، وهذا هو بالضبط روتين سير العمل من نوع Claude Code؛ والانتقال إليه يعني المزيد من التوقف في منتصف الطريق أو الحاجة إلى تدخل بشري.
- ProgramBench أقل بـ 33.5: هذه هي أكبر نقطة ضعف في هذه المقارنة، والنتيجة تقارب النصف. في مهام بناء برنامج من الصفر أو إعادة كتابته على نطاق واسع، لا يصلح Qwen4-Max حاليًا بديلًا عن Opus 5.5.
وتقدّم اللوحة العامة معلومات موقع مشابهة. وفق لقطة اللوحة العامة بتاريخ 2026-11-14، تضم arena.ai Code Arena WebDev ما مجموعه 1,007,405 صوتًا و159 نموذجًا: Opus 5.5 (Max) بـ 1816 نقطة في المركز الثاني، وQwen4-Max (xHigh) بـ 1750 نقطة في المركز السادس، لكن الأخير لديه 1,814 صوتًا فقط، ولا يزال موسومًا بـ Preliminary، ولا يزال ترتيبه عرضة للتغير.
توصيات لاستخدام Qwen4-Max في سيناريوهات مستودعات الشيفرة
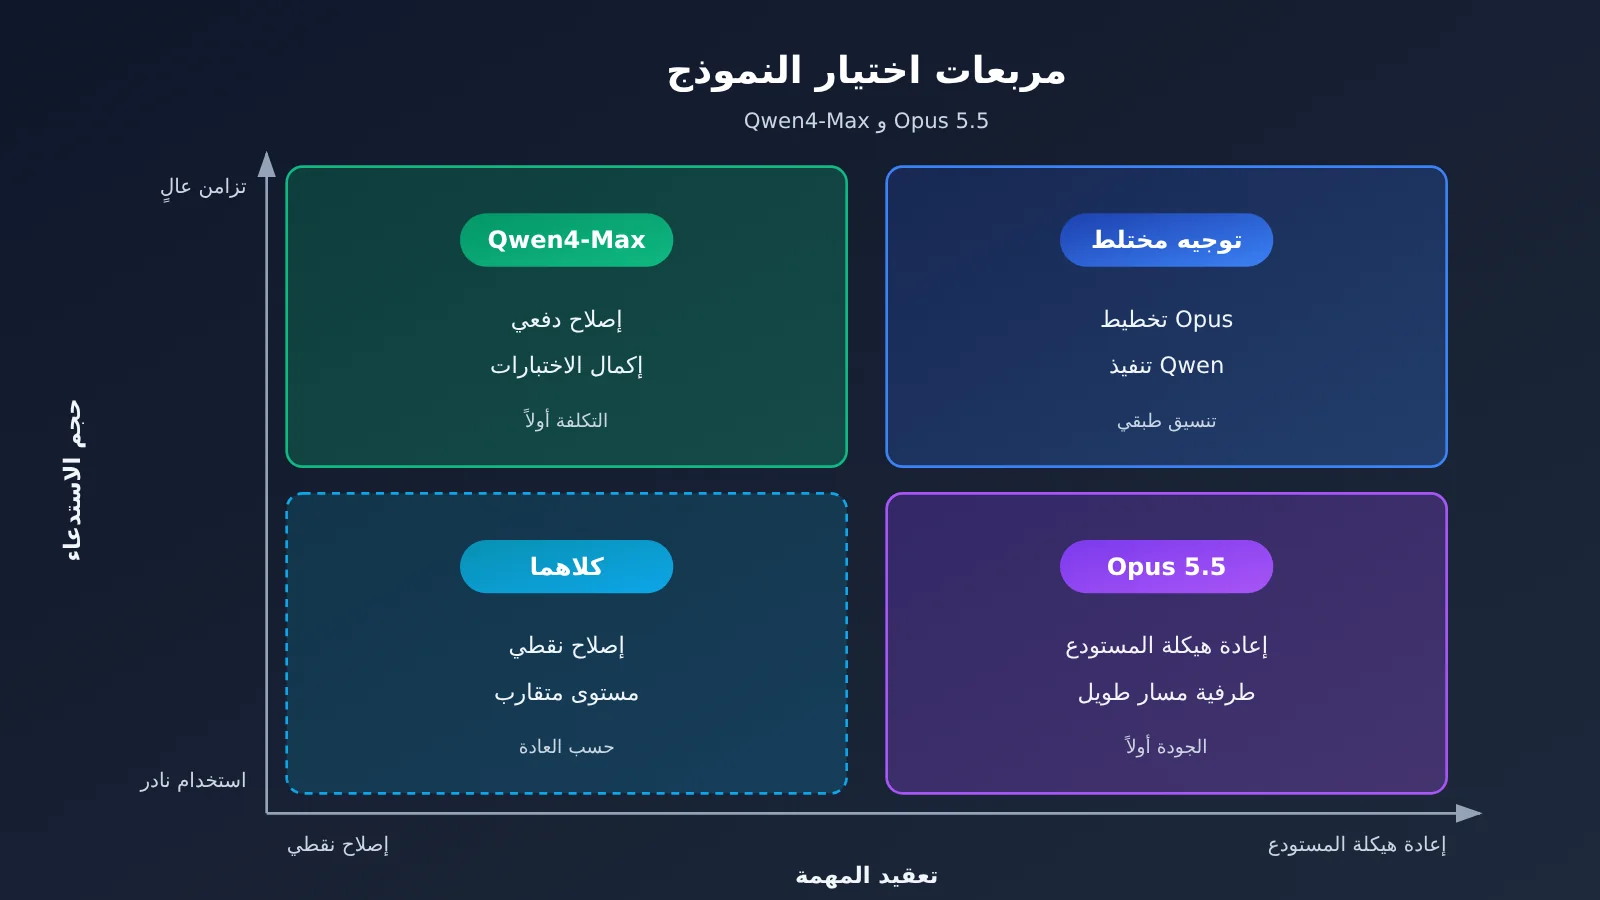
إذا كان الوكيل (agent) لديك يعمل أساسًا على إعادة هيكلة المستودع بالكامل أو الترحيل بين الوحدات أو عمليات طرفية طويلة السلسلة، فمن المستحسن الإبقاء على Opus 5.5 دون تغيير. وإذا قسّمت المهام إلى طبقتين هما «التخطيط + التنفيذ»، فيمكنك أن تترك Opus 5.5 مسؤولًا عن التخطيط والتغييرات الحاسمة، وتوجّه المهام الموضعية مثل إصلاح ملف واحد أو استكمال الاختبارات إلى Qwen4-Max.
Qwen4-Max مقابل Opus 5.5: المهام المكتبية والمهام الطويلة
تأتي نتائج المهام المكتبية ومهام الوكلاء الطويلة أكثر تباينًا من نتائج البرمجة، ففيها فوز وخسارة.
| المعيار (مقارنة على نفس الرسم البياني أعلنتها Qwen رسميًا) | Qwen4-Max | Opus 5.5 | الفرق |
|---|---|---|---|
| AA-Briefcase v1.1 Elo | 1686 | 1801 | Qwen أقل بـ 115 |
| JobBench | 68.5 | 75.4 | Qwen أقل بـ 6.9 |
| APEX-Agents v1.1 | 72.1 | 73.5 | Qwen أقل بـ 1.4 |
| AutomationBench-AA | 72.5 | 69.5 | Qwen أعلى بـ 3.0 |
| AgentArena Net Improvement | 7.5 | 18.2 | Qwen أقل بـ 10.7 |
وبالإسقاط على العمل الفعلي:
- AA-Briefcase أقل بـ 115 Elo: في المخرجات المكتبية مثل التقارير والخطط والجداول، يكون ناتج Opus 5.5 أقرب إلى التبني المباشر، وهذه أكبر فجوة في المهام المكتبية.
- JobBench أقل بـ 6.9: لا يزال Opus متفوقًا في الإنجاز الشامل للمهام القريبة من الوظائف الحقيقية، ما يعني احتمال ارتفاع معدل إعادة العمل عند التسليم من البداية إلى النهاية.
- APEX-Agents أقل بـ 1.4: مهام الوكلاء العامة متكافئة تقريبًا، وتغيير النموذج لن يُحدث فرقًا ملموسًا في التجربة.
- AutomationBench أعلى بـ 3.0: أتمتة العمليات ذات القواعد الواضحة هي نقطة قوة Qwen4-Max، لذا يُناسب الترحيل إليها أولًا معالجة النماذج ونقل البيانات وجدولة المهام الدورية.
- AgentArena Net Improvement أقل بـ 10.7: القدرة على التحسّن المستمر عبر دورات متعددة أضعف، وكلما طالت المهمة واعتمدت أكثر على التصحيح الذاتي للنموذج، كان Opus أكثر ثباتًا.
إضافة إلى ذلك، فإن حد المخرجات الأقصى 393K وحد سلسلة التفكير 262K في Qwen4-Max ميزة حقيقية للمهام الطويلة التي تتطلب إنتاج محتوى طويل جدًا دفعة واحدة، في حين أن الحد الأقصى لمخرجات Opus 5.5 هو 128K.
Qwen4-Max مقابل Opus 5.5: المستندات الطويلة باللغة الصينية والمهام متعددة الوسائط
يلزم توضيح أمر في البداية: الرسم البياني المقارن في المواد المرجعية لا يتضمن اختبارًا مرجعيًا متخصصًا في اللغة الصينية، لذلك لا يمكن لهذه المقالة أن تجيب بالأرقام عن سؤال «أي النموذجين أفضل في الصينية». إذا كانت جودة اللغة الصينية مؤشرك الأساسي، فقم بإجراء اختبار A/B على مجموعة عيناتك الخاصة، ولا تعتمد على أي استنتاجات من مصادر ثانوية.
أما ما يمكن الإجابة عنه بالأرقام فهو المهام متعددة الوسائط والمهام المعرفية:
| الاختبار المرجعي (مقارنة على الرسم نفسه وفق ما أعلنته Qwen رسميًا) | Qwen4-Max | Opus 5.5 | الفرق |
|---|---|---|---|
| Chartography | 54.2 | 66.3 | Qwen أقل بـ 12.1 |
| Video-Index | 68.1 | 74.8 | Qwen أقل بـ 6.7 |
| Humanity’s Last Exam | 51.7 | 59.8 | Qwen أقل بـ 8.1 |
| HLAB-Vals-1.1 | 21.3 | 9.2 | Qwen أعلى بـ 12.1 |
| BioMysteryBench | 85.0 | 81.9 | Qwen أعلى بـ 3.1 |
| HealthBench Professional | 60.0 | 59.9 | متعادلان تقريبًا |
المعنى العملي لهذه الأرقام هو أن Qwen4-Max يتأخر بـ12.1 نقطة في قراءة المخططات واستخراج البيانات الرسومية من التقارير المالية وتقارير الأبحاث، ما يجعله أكثر عرضة لإغفال الإحداثيات أو قراءتها بشكل خاطئ؛ كما أن هناك فجوة 6.7 نقطة في فهم الفيديو؛ ويتأخر بـ8.1 نقطة في أسئلة المعرفة الشاملة عالية الصعوبة (HLE). وعلى الجانب الآخر، فإن Qwen4-Max متعادل أو متقدم قليلًا في الاستدلال البيولوجي والأسئلة الطبية المتخصصة، ويتقدم في HLAB-Vals بـ12.1 نقطة.
لذا ينبغي تقسيم مهام المستندات الطويلة إلى فئات أدق: في المستندات التي يغلب عليها النص وتتطلب مخرجات فائقة الطول، يمكن اعتبار Qwen4-Max المرشح الأول؛ أما ملفات PDF المزدحمة بالرسوم البيانية أو المواد التي تتضمن مقاطع فيديو، فيُوصى بالاستمرار في استخدام Opus 5.5.
Qwen4-Max و Opus 5.5: سعر كل مليون token وحساب التخزين المؤقت
السعر هو أقوى حجة لصالح Qwen4-Max. جميع الوحدات في الجدول التالي لكل 1M tokens؛ الأسعار الرسمية مأخوذة من النص الأصلي لوثائق QwenCloud وAnthropic، بينما الأسعار الحالية على APIYI مأخوذة من docs.apiyi.com/models، بتاريخ جمع البيانات 2026-11-16.
| بند الفاتورة ($/1M tokens) | Qwen4-Max الرسمي | Opus 5.5 الرسمي | Qwen/Opus | APIYI qwen3.8-max |
APIYI claude-opus-5-5 |
|---|---|---|---|---|---|
| الإدخال | 1.5 | 4 | 37.5% | 1.65 | 4 |
| الإخراج | 4.5 | 20 | 22.5% | 4.95 | 20 |
| قراءة التخزين المؤقت | 0.075 | 0.20 | 37.5% | 0.20625 | 0.2 |
| كتابة التخزين المؤقت لمدة 5 دقائق | 1.875 | 5 | 37.5% | حسب قائمة المنصة | حسب قائمة المنصة |
| كتابة التخزين المؤقت لمدة ساعة | 3 | 8 | 37.5% | حسب قائمة المنصة | حسب قائمة المنصة |
بنية التخزين المؤقت لدى الشركتين متطابقة فعليًا: قراءة التخزين المؤقت = 5% من سعر الإدخال، وكتابة التخزين المؤقت لمدة 5 دقائق = 1.25 ضعف سعر الإدخال، وكتابة التخزين المؤقت لمدة ساعة = ضعفان. وهذا يعني أن استراتيجية التخزين المؤقت التي صممتها على Opus يمكن نقلها كما هي إلى Qwen4-Max، مع انكماش الفاتورة وفق النسبة نفسها 37.5%. ما يجب الانتباه إليه هو أن قراءة التخزين المؤقت لـ qwen3.8-max على APIYI تساوي 12.5% من سعر الإدخال، وهي نسبة مختلفة عن Qwen4-Max الرسمي، لذا احسبها بشكل منفصل حسب الطراز الفعلي عند الانتقال.
حساب ملموس
لنأخذ مثالاً: 100 مليون token إدخال + 10 ملايين token إخراج: Qwen4-Max حوالي $195 (150 + 45)، وOpus 5.5 حوالي $600 (400 + 200). الفرق حوالي $405، أي ما يعادل ثلثي فاتورة Opus.
لكن السعر المعلن لا يساوي المبلغ المدفوع فعليًا. لقطة لوحة التصنيفات العامة، 2026-11-14 أعطت تكلفة المهمة الواحدة عند P50: Opus 5.5 (Max) $8.99، وQwen4-Max (xHigh) $4.18، أي نسبة حوالي 46%، وليس 22.5% كما في السعر المعلن. السبب هو اختلاف مستوى الاستدلال بينهما؛ فـ Qwen4-Max افتراضيًا على high، وسلسلة التفكير تُحاسب على الإخراج، مما يستهلك tokens أكثر. كم ستوفر فعليًا يعتمد على طول مهمتك ومستوى الاستدلال، ويُنصح بإعادة تشغيل حركة المرور الخاصة بك لاختبارها مرة واحدة.
💰 نصيحة حول التكلفة: عند مقارنة الفواتير، سجّل في الوقت نفسه كميات tokens للأربعة بنود: الإدخال، والإخراج، وقراءة التخزين المؤقت، وكتابته، بدلاً من النظر إلى سعر الوحدة فقط. من خلال APIYI apiyi.com يمكنك استدعاء النموذجين بالتوازي تحت الحساب نفسه، فتصطف تفاصيل الاستخدام في مكان واحد.
مقارنة Qwen4-Max بـ Opus 5.5: توصيات القرار وخطوات الترحيل الثلاث
عند ترحيل وكيل ذكي من Opus إلى Qwen، لا بد من ثلاث خطوات: التحقق من الطراز، ومقارنة السعر، ومطابقة البروتوكول.
الخطوة الأولى: التحقق من الطراز. حتى تاريخ 2026-11-16، لم يكن Qwen4-Max متاحًا بعد على APIYI، وسنعمل على إتاحته في أقرب وقت. أقوى طراز متاح حاليًا في جانب Qwen هو qwen3.8-max. وفي جانب Opus يمكن استخدام claude-opus-5-5، وهناك أيضًا claude-opus-5-5-thinking بالسعر نفسه. يعتمد الطراز والسعر على قائمة الطرازات في مركز التوثيق على apiyi.com، وقبل الإتاحة يمكن تجهيز مسار النشر التدريجي باستخدام qwen3.8-max.
الخطوة الثانية: مقارنة السعر. وفق طريقة القسم السابق، قدّر تكلفة الجانبين باستخدام بيانات حركة مرور حقيقية لمدة أسبوع، ثم قارن بعد محاذاة مستويات الاستدلال. تعرض قائمة الطرازات لدى APIYI على apiyi.com أسعار الإدخال والإخراج وقراءة التخزين المؤقت جميعها في جدول إجمالي واحد، ما يجعلها مناسبة مباشرة كمصدر بيانات لجدول الحساب.
الخطوة الثالثة: مطابقة البروتوكول. توفر APIYI واجهة متوافقة مع OpenAI، ونقطة النهاية هي https://api.apiyi.com/v1. عند تبديل النموذج لا يلزم سوى تغيير حقل model، مثلًا من claude-opus-5-5 إلى qwen3.8-max، مع بقاء api_key وbase_url دون تغيير. هناك نقطتان إضافيتان يجب فحصهما: يُسمى معامل شدة الاستدلال في جانب Qwen باسم reasoning_effort، وقيمته الافتراضية high، وإذا أردت مطابقته مع medium في Opus فيجب ضبطه صراحةً؛ كما يجب إعادة التحقق من مدة كتابة ذاكرة التخزين المؤقت وقواعد الإصابة وفق النموذج الهدف.
🎯 توصية النشر التدريجي: لا تبدّل الوكيل بالكامل دفعة واحدة. يُوصى بتقسيم حركة المرور ضمن
base_urlنفسه (https://api.apiyi.com/v1) حسب نوع المهمة: انقل أولًا مهام الأتمتة والإصلاحات الموضعية، وأبقِ مهام الطرفية والمستودع الكامل على Opus 5.5، وراقب معدل إعادة العمل لمدة أسبوعين قبل تحديد الخطوة التالية.
الأسئلة الشائعة FAQ
س1: أي النموذجين أنسب لبناء وكيل برمجي (coding agent): Qwen4-Max أم Opus 5.5؟
يعتمد الأمر على حجم المهمة. في إصلاح مشكلة واحدة (DeepSWE) يتعادل النموذجان، ويمكن استخدام Qwen4-Max لتقليل التكلفة؛ أما في العمليات الطرفية متعددة الخطوات وبناء المستودع كاملًا (Terminal-Bench وProgramBench) فيتقدم Opus 5.5 بفارق واضح، خصوصًا في ProgramBench حيث يبلغ الفرق 33.5 نقطة، لذا يُفضّل الاستمرار مع Opus في هذا النوع من المهام.
س2: هل يمكن مقارنة الدرجات الواردة في مخططات علي بالدرجات الموجودة في لوحة arena؟
لا يمكن اعتبارهما مقياسًا واحدًا. الأولى مقارنة على المخطط نفسه أعلنتها Qwen رسميًا، والثانية لقطة من لوحة عامة (بتاريخ 2026-11-14)، كما أن Qwen4-Max حصل على 1,814 صوتًا فقط في اللوحة ولا يزال في حالة Preliminary. يمكن الاستعانة بكل منهما لاستقراء الاتجاه، لكن لا ينبغي دمجهما في استنتاج واحد يقول “إن الفارق كذا نقطة”.
س3: كم يمكن أن أوفر فعليًا عند الانتقال إلى Qwen4-Max؟
وفقًا للأسعار المعلنة، يبلغ التخفيض في الإدخال 62.5% وفي الإخراج 77.5%. لكن نسبة تكلفة المهمة الواحدة (P50) على اللوحة العامة تبلغ نحو 46%، لأن Qwen4-Max يعمل افتراضيًا بمستوى استدلال أعلى ويستهلك عددًا أكبر من رموز التفكير (thinking tokens). ولحساب التخفيض الفعلي تحتاج إلى قياسه عبر إعادة تشغيل حركة المرور الخاصة بك.
س4: هل يمكنني الآن استدعاء Qwen4-Max عبر APIYI؟
ليس بعد، فـ Qwen4-Max لم يُطرح في الكتالوج بعد، وسنعمل على طرحه في أقرب وقت. حاليًا يمكنك استخدام `qwen3.8-max` لبناء مسار الترحيل، وبعد الطرح لن تحتاج إلا إلى تغيير حقل `model`. وللتحقق من حالة الطُرُز، اعتمد على قائمة الطُرُز في موقع APIYI على apiyi.com.
س5: كم مقدار الشفرة التي سأحتاج إلى تعديلها عند الانتقال من Opus إلى Qwen؟
إذا كنت تستخدم واجهة متوافقة مع OpenAI، فبعد توجيه `base_url` إلى `https://api.apiyi.com/v1` لن يتبقى سوى تغيير اسم النموذج، وضبط `reasoning_effort` حسب الحاجة. وبعد التسجيل في APIYI على apiyi.com يمكنك الاستفادة من رصيد تجريبي مجاني للمستخدمين الجدد لتشغيل جولة مقارنة أولى.
س6: ما القيود المعروفة في Qwen4-Max؟
أكبر نقاط ضعفه هي العمليات الطرفية والبرمجة على مستوى المستودع كاملًا، كما أنه متأخر بـ 12.1 نقطة في فهم المخططات والرسوم البيانية، وأقل بـ 115 في تقييم Elo للمخرجات المكتبية، وقدرته على التحسين الذاتي عبر الجولات المتعددة أضعف نسبيًا. إضافة إلى ذلك، جميع درجات المقارنة معلنة من الشركة المصنّعة نفسها ولم يعِد أحد طرف ثالث التحقق منها، كما تنقصه بيانات معيارية مخصصة لقدراته في اللغة الصينية.
النقاط الأساسية في مقارنة Qwen4-Max مع Opus 5.5
- أكبر نقطة ضعف: انخفاض بمقدار 33.5 نقطة في ProgramBench، لذا استمر في استخدام Opus 5.5 لبناء المستودع الكامل وإعادة هيكلته.
- المجالات المتكافئة: DeepSWE وAPEX-Agents وHealthBench متساوية تقريبًا، ويمكن توجيه المهام إليها في المقام الأول.
- مزايا Qwen: أتمتة سير العمل، والاستدلال الطبي الحيوي، ومخرجات فائقة الطول تبلغ 393K.
- هيكل الأسعار: الإدخال 37.5% والإخراج 22.5%، ونسب التخزين المؤقت الأربعة متطابقة تمامًا في البنية مع Opus.
- فرق التكلفة الفعلية: مستوى الاستدلال الافتراضي هو high، ونسبة تكلفة المهام في التصنيفات العامة حوالي 46%.
- مسار الترحيل: استخدم في APIYI apiyi.com نفس نقطة النهاية لتشغيل
qwen3.8-maxأولاً، ثم استبدله مباشرة بعد توفّر Qwen4-Max.
الخلاصة
يمكن اختصار الاختيار بين Qwen4-Max وOpus 5.5 في ثلاث نقاط:
- اترك الطرفية ومستودعات الشيفرة لـ Opus 5.5: الفجوة في Terminal-Bench وProgramBench لا يغطيها فرق السعر مقابل تكلفة إعادة العمل.
- أسنِد الأتمتة والتزامن العالي إلى Qwen4-Max: في المهام التي تتساوى فيها القدرة أو يتفوق فيها، تكون فاتورة بنسبة 30% إلى 50% مكسبًا صافيًا.
- التوجيه حسب المهمة، وليس الاستبدال الشامل: نفس واجهة البرمجة مع توجيه حسب نوع المهمة هو أقل طرق الترحيل خطرًا.
نوصي أولاً بتشغيل جولة من إعادة تشغيل مهامك في APIYI apiyi.com باستخدام qwen3.8-max وclaude-opus-5-5، ثم اتخاذ قرار التبديل النهائي بعد توفّر Qwen4-Max.
📚 المراجع
- مدونة إصدار Qwen4-Max: مواصفات النموذج ومقارنتها بالمعايير المُعلنة رسميًا
- الرابط:
qwen.ai/blog?id=qwen4-max -
الوصف: تتضمن معاملات البنية، وحدود السياق والإخراج، والدرجات المقارنة في الرسم البياني نفسه
-
نظرة عامة على نماذج Anthropic: مواصفات Opus 5.5
- الرابط:
platform.claude.com/docs/en/about-claude/models/overview.md -
الوصف: نافذة السياق، والحد الأقصى للإخراج، ومستوى الجهد الافتراضي، وتاريخ انقطاع المعرفة
-
صفحة أسعار Anthropic: أسعار الإدخال والإخراج والتخزين المؤقت لـ Opus 5.5
- الرابط:
platform.claude.com/docs/en/about-claude/pricing.md -
الوصف: تشمل أسعار كتابة ذاكرة التخزين المؤقت لمدة 5 دقائق ولمدة ساعة واحدة
-
قائمة الطُرز في APIYI: الأسعار الحالية والطُرز المتاحة على المنصة
- الرابط:
docs.apiyi.com/models - الوصف: التحقق من حالة إتاحة الطُرز وأسعارها قبل الترحيل
المؤلف: فريق APIYI التقني
التواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI على apiyi.com، ولمزيد من مواد التكامل يمكنكم زيارة مركز التوثيق docs.apiyi.com