作者注:从 OpenAI 企业收入过半的新动态出发,结合 Harness 调查与“每个成功任务成本”指标,拆解企业 AI 采购的 5 个步骤与成本治理方法。
2026 年 11 月 4 日,OpenAI 总裁 Greg Brockman 在 WSJ 科技大会上表示,OpenAI 超过一半的收入已经来自企业业务。他同时说明,消费者业务收入仍在增长,只是企业业务增长更快。与此同时,多份行业调查显示,企业 AI 账单正在以超出预期的速度膨胀。
这不是又一篇 ChatGPT 套餐比价文章。Reuters、TechCrunch 已报道 Brockman 的表态,Harness 的 FinOps 调查也给出了企业 AI 账单失控的样本数据。对企业来说,真正难的已经不是“买哪个模型”,而是如何同时管理多家供应商、持续增长的调用费用,以及每个任务的真实成本。
核心价值:读完本文,你将理解 ChatGPT 企业采购的几种计费方式,并拿到一套从任务定义到效果评估的 5 步 AI 采购与成本治理框架。
ChatGPT 企业采购核心信息速览
先把这次动态的关键事实放在一起。需要提醒的是,“OpenAI 企业收入过半”说的是 OpenAI 自身的收入结构,和行业报告中的企业 API 市场份额不是同一个统计口径,不能混为一谈。
| 信息项 | 详情 |
|---|---|
| 发布时间 | 2026 年 11 月 4 日(美国当地时间),WSJ Technology Conference |
| 发布方 | Greg Brockman,OpenAI 联合创始人、总裁 |
| 核心内容 | 企业业务收入占比超过一半,此前约为企业 30%、消费者 70% |
| 增长驱动 | 第三季度企业业务规模翻倍,Codex、ChatGPT Work、GPT-5.6 Sol 被列为关键因素 |
| 行业背景 | Menlo Ventures 估算企业 AI 支出平均为上一年的 4.7 倍,而企业原先预计约 1.9 倍 |
| 影响范围 | 企业采购、预算管理、多模型接入与 API 成本治理 |
ChatGPT 企业采购的三种主流形态
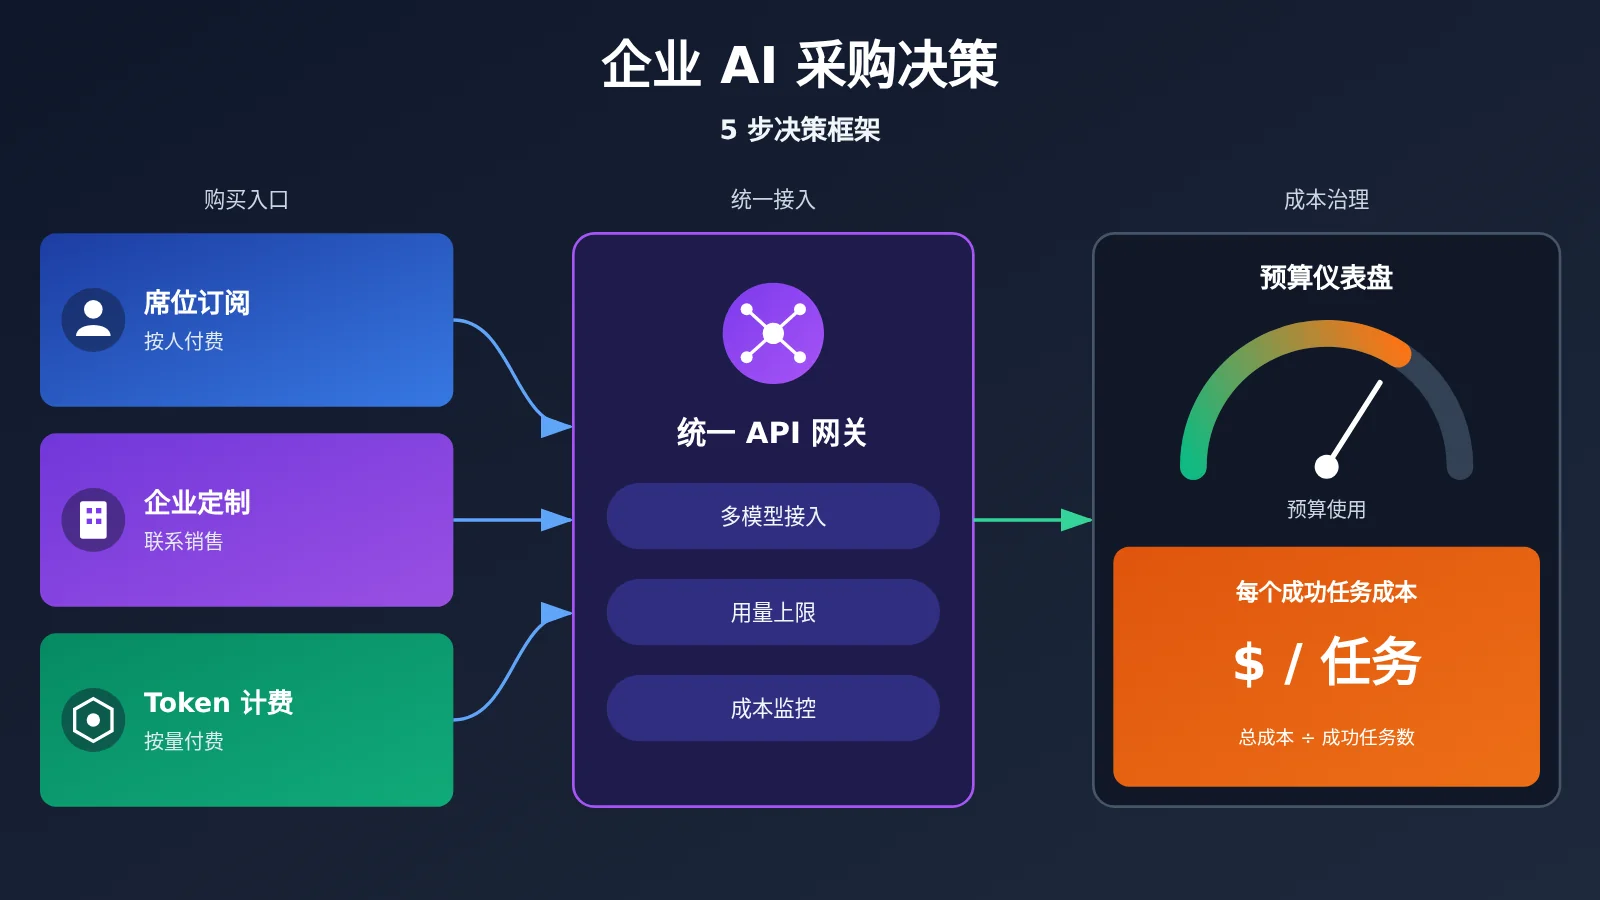
从公开价格看,ChatGPT 企业采购大致有三条路径。ChatGPT Business 面向 2—200 人团队,Standard 席位年付折算约每人每月 20 美元、月付 25 美元,Premium 席位提供约 5 倍于 Standard 的使用额度。ChatGPT Enterprise 则需要联系销售定制报价,包含 SCIM、EKM、RBAC、数据驻留、SLA 和定制法律条款,并可采用 Credit-based 或 Token-based 计费。
第三条路径是直接按 Token 采购 API。API 与 ChatGPT 订阅是两套独立的计费体系,按实际输入、输出和缓存 Token 计费,不同模式和上下文长度还会影响最终成本。值得注意的是,2026 年 10 月 OpenAI 为符合条件的 Business 工作区提供了促销 API credits,但这些额度与 ChatGPT 使用额度分开计算,这也说明席位和 API 在财务上要分别管理。
企业 AI 采购为什么总是超预算
如果只看单价,AI 似乎并不贵;但企业真正收到的账单往往和预期相差很远。Harness 在《State of AI in FinOps 2026》中调查了 700 名工程负责人和从业者,调查时间为 2026 年 5—6 月,覆盖美国、英国、法国、德国和印度,受访企业均在 1000 人以上。
调查显示,67% 的受访组织每月 AI 支出超过 25 万美元,20% 已经超过 100 万美元。80% 表示过去六个月 AI 总支出增加,78% 预计还会继续增长。更值得关注的是账单管理层面暴露的问题:
| Harness 调查结果 | 比例 | 反映的采购问题 |
|---|---|---|
| 遭遇过意外 AI 账单 | 72% | 预算与实际调用脱节 |
| 没有明确 AI 成本负责人 | 52% | 成本归属不清 |
| 认为 AI 预算制定主要靠猜测 | 56% | 缺少历史用量数据 |
| 经常担心下一笔 Token 账单 | 47% | 用量缺乏上限控制 |
| 至少需要一天定位成本异常 | 79% | 监控与告警滞后 |
| 需要一周才能定位成本异常 | 32% | 多平台账单难以合并 |
另一组对比更能说明问题:73% 的企业已经制定 AI 成本政策,但只有 13% 具备基本的成本可见性。换句话说,制度写在纸上,执行和监控能力却没有跟上。需要说明的是,Harness 本身是 FinOps 工具厂商,样本限定在千人以上企业和五个国家,结论更适合作为大中型企业的参考,而不是全行业的统计结论。
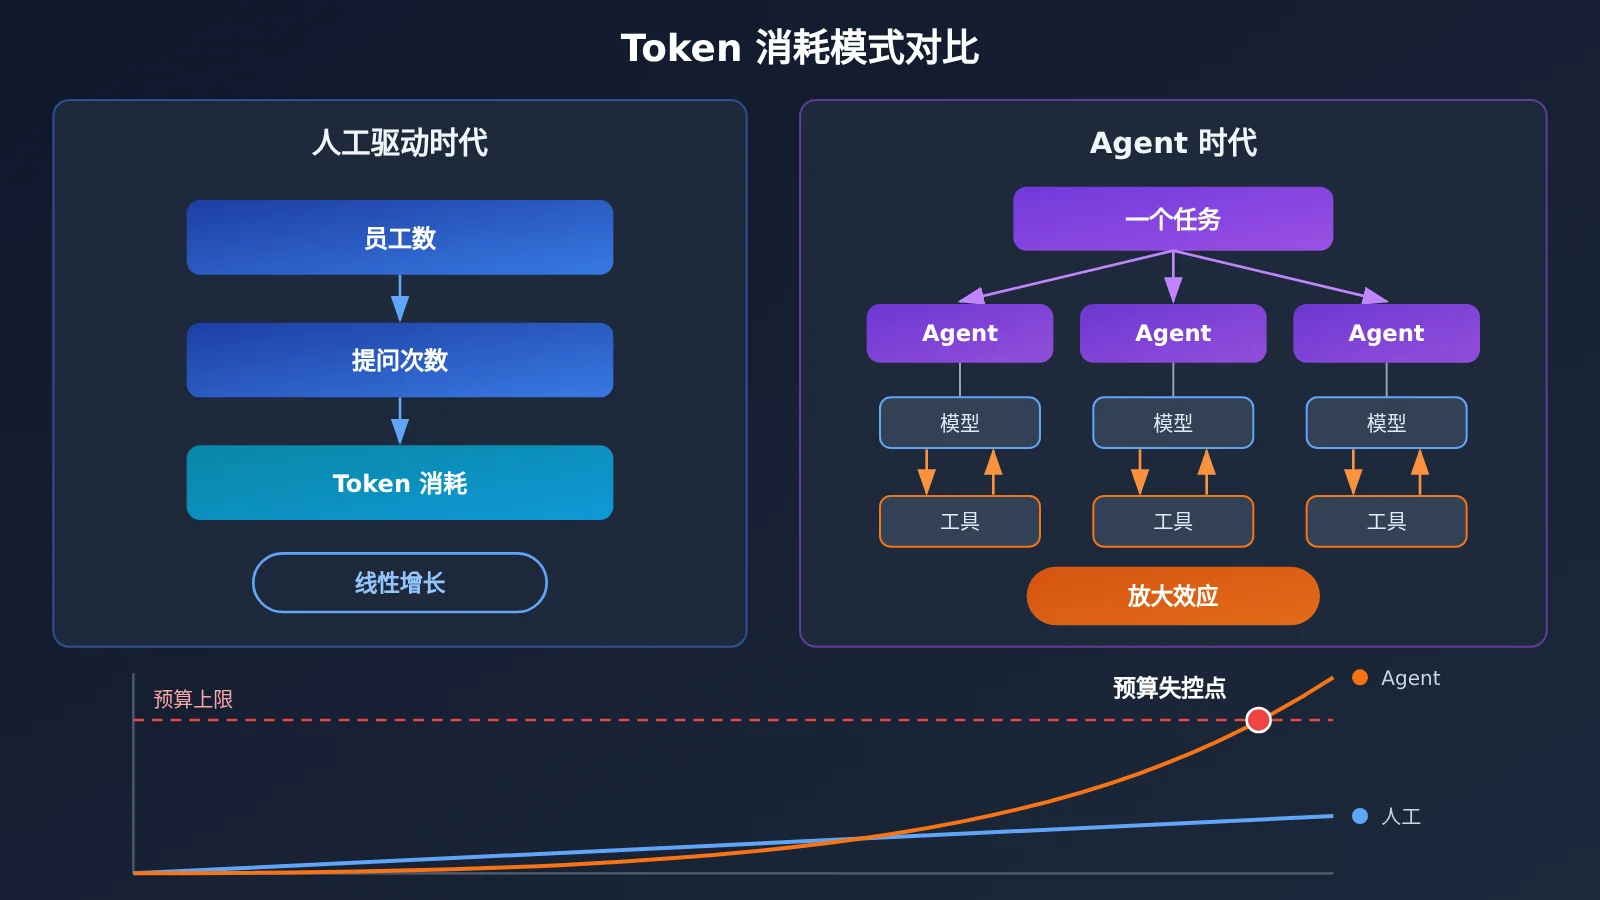
Agent 让 Token 消耗与人数脱钩
传统 SaaS 采购按人头计算,预算相对可控。但 Agent 改变了这一逻辑:Menlo Ventures 基于 OpenRouter 数据的分析显示,Agent 已占该平台 Token 消耗量约 80%,自 2026 年 2 月超过人工驱动流量后增长约 37 倍。Menlo 也指出,Agent 的并行运行和后台持续执行,是企业支出超过预算的重要原因之一。
这组数据同样有局限:OpenRouter 用户结构偏向开发者和创业公司,不能代表整个行业。但趋势本身很清晰,Token 消耗越来越取决于任务数量、并行度和执行时长,而不只是员工人数。Axios 报道中,超过 60% 的 Codex 用户在一天中的某个时段会同时运行多个任务,这正是账单难以预测的根源。
ChatGPT 企业采购为何走向多模型
很多企业最初只采购一家供应商,但很快就会发现单一模型难以覆盖所有任务。Harness 调查中,企业生产环境使用 OpenAI 的比例为 69%,Azure OpenAI 为 58%,Google Vertex AI 为 53%,AWS Bedrock 为 41%,Anthropic 为 37%。这些比例可以重叠,说明的是“多数企业同时使用多个平台”,而不是市场份额,更不能相加计算。
2026 年 7 月发布在 arXiv 的预印本《The Multi-Lab Enterprise》给出了类似线索:全球 2000 强企业中,81% 使用三个或更多模型系列,79% 曾经超过 AI 预算,即便 FinOps 成熟的企业平均超支也达到 30.9%。不过这是一篇尚未经过同行评审的预印本,只能作为研究线索参考,不宜单独作为决策依据。
多模型采购带来的麻烦很具体。各平台的计费单位、账单格式、用量统计口径都不一致,财务部门很难按部门或项目归集成本,技术团队也难以在同一套指标下比较模型效果。这正是统一 API 接入层存在的价值:把多家模型收敛到同一个接口和同一份用量报表中。
ChatGPT 企业采购方式对比
| 采购方式 | 计费逻辑 | 适合场景 | 治理重点 |
|---|---|---|---|
| ChatGPT Business 席位 | 按人每月计费,Standard/Premium 可混配 | 2—200 人团队的日常办公与知识工作 | 席位利用率、闲置席位回收 |
| ChatGPT Enterprise 合同 | 定制报价,可选 Credit 或 Token 计费 | 对合规、数据驻留、SLA 有要求的大型组织 | 合同条款、额度消耗节奏 |
| 模型 API 按 Token | 按输入/输出/缓存 Token 计费 | 自研应用、Agent 工作流、批量任务 | 单任务成本、异常调用、重试率 |
| 云平台模型服务 | 并入云账单 | 已深度使用某云厂商的企业 | 跨云成本归属 |
| 合作伙伴集成 | 项目制或服务费 | 需要流程改造与系统整合 | 交付成果与业务指标挂钩 |
Cost per Successful Task:Token 单价不等于真实成本
企业比价时最常见的误区,是只看每百万 Token 的价格。设想两个模型:模型 A 单次调用便宜,但完成任务需要多次重试,输出质量不稳定,需要大量人工检查;模型 B 单价更高,但一次成功率更高,人工复核时间更短。最终摊到每个交付成果上,模型 A 反而可能更贵。
因此更有意义的采购指标是 Cost per Successful Task(每个成功任务的实际成本)。它把模型费用、工具费用、失败重试和人力复核都算进来,再除以真正成功交付的任务数量。最便宜的模型并不天然是最优选择,关键是在你的任务上谁的综合成本更低。
| 成本构成 | 含义 | 常被忽略的原因 |
|---|---|---|
| 模型调用成本 | 输入、输出、缓存 Token 费用 | 只看单价不看用量 |
| 工具调用成本 | 检索、代码执行、外部 API 等费用 | 分散在其他账单中 |
| 失败重试成本 | 超时、格式错误、质量不合格后的重跑 | 日志未区分首次与重试 |
| 人工复核成本 | 员工检查、修改、返工的时间 | 不计入 IT 预算 |
| 任务耗时 | 从发起到交付的总时长 | 只统计模型延迟 |
| 任务成功率 | 一次即可交付的任务比例 | 缺少业务侧验收标准 |
这一点在 Agent 场景中尤其明显。Axios 报道过斯坦福商学院教授 Andrew Hall 用 Claude Code 更新旧论文的案例,Agent 能完成数据搜集、分析和画图,但后续人工审查发现了数据和代码错误。人工监督成本是真实存在的,忽略它就会严重低估 AI 的总成本。
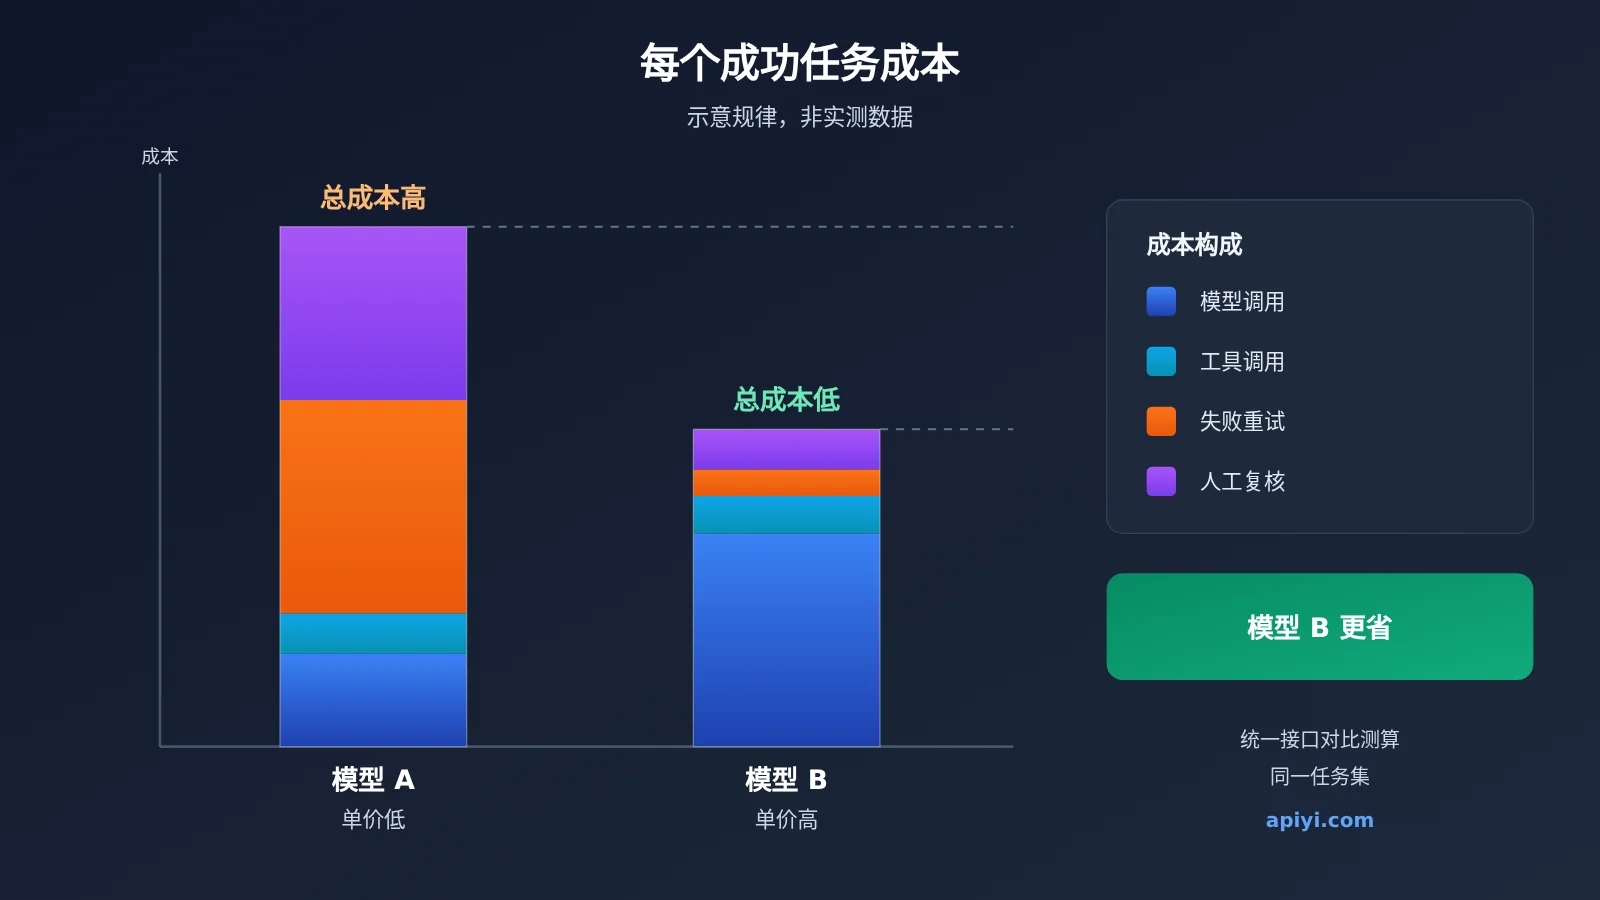
上图展示的是一种常见规律,而不是某两个具体模型的实测结论。实际评估时,建议用同一批真实业务样本分别跑不同模型,再按上表口径计算。通过 API易 apiyi.com 这类统一接口平台,可以用同一套代码切换模型,减少对比测试的工程量。
如何测算 ChatGPT 企业采购的单任务成本
下面的示例展示如何记录每次调用的 Token 用量,这是计算 Cost per Successful Task 的数据基础:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="your-model-id",  # 模型 ID 以平台模型列表为准
    messages=[{"role": "user", "content": "总结这份合同的关键风险条款"}]
)
print(resp.choices[0].message.content)
print("输入 Token:", resp.usage.prompt_tokens, "输出 Token:", resp.usage.completion_tokens)
查看完整实现:按部门归集成本并计算单任务成本
import openai
from collections import defaultdict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 统一接口,切换模型只改 model 参数
)

# 单价按你实际采购的模型填写,单位:美元 / 百万 Token
PRICE = {
    "model-a-id": {"input": 0.0, "output": 0.0},
    "model-b-id": {"input": 0.0, "output": 0.0},
}
REVIEW_COST_PER_MIN = 0.0  # 人工复核每分钟成本,按企业人力成本测算

ledger = defaultdict(lambda: {"cost": 0.0, "tasks": 0, "success": 0})

def run_task(dept: str, model: str, prompt: str, validator, max_retry: int = 2):
    """执行一个任务,记录模型费用与重试,返回是否成功"""
    key = (dept, model)
    ledger[key]["tasks"] += 1
    for _ in range(max_retry + 1):
        resp = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
        )
        u = resp.usage
        p = PRICE[model]
        ledger[key]["cost"] += (u.prompt_tokens * p["input"]
                                + u.completion_tokens * p["output"]) / 1_000_000
        if validator(resp.choices[0].message.content):
            ledger[key]["success"] += 1
            return True
    return False

def add_review(dept: str, model: str, minutes: float):
    """把人工复核时间折算进成本"""
    ledger[(dept, model)]["cost"] += minutes * REVIEW_COST_PER_MIN

def report():
    for (dept, model), d in ledger.items():
        cpst = d["cost"] / d["success"] if d["success"] else float("inf")
        rate = d["success"] / d["tasks"] if d["tasks"] else 0
        print(f"{dept} | {model} | 成功率 {rate:.0%} | 每个成功任务成本 ${cpst:.4f}")
🚀 快速上手建议:在正式签订年度合同前,建议先用真实业务样本做两到四周的小规模测算。通过 API易 apiyi.com 注册即可获得免费测试额度,一个 API Key 调用 OpenAI、Claude、Gemini 等主流模型,便于在同一份用量报表里比较不同模型的单任务成本。
ChatGPT 企业采购的 5 步决策框架
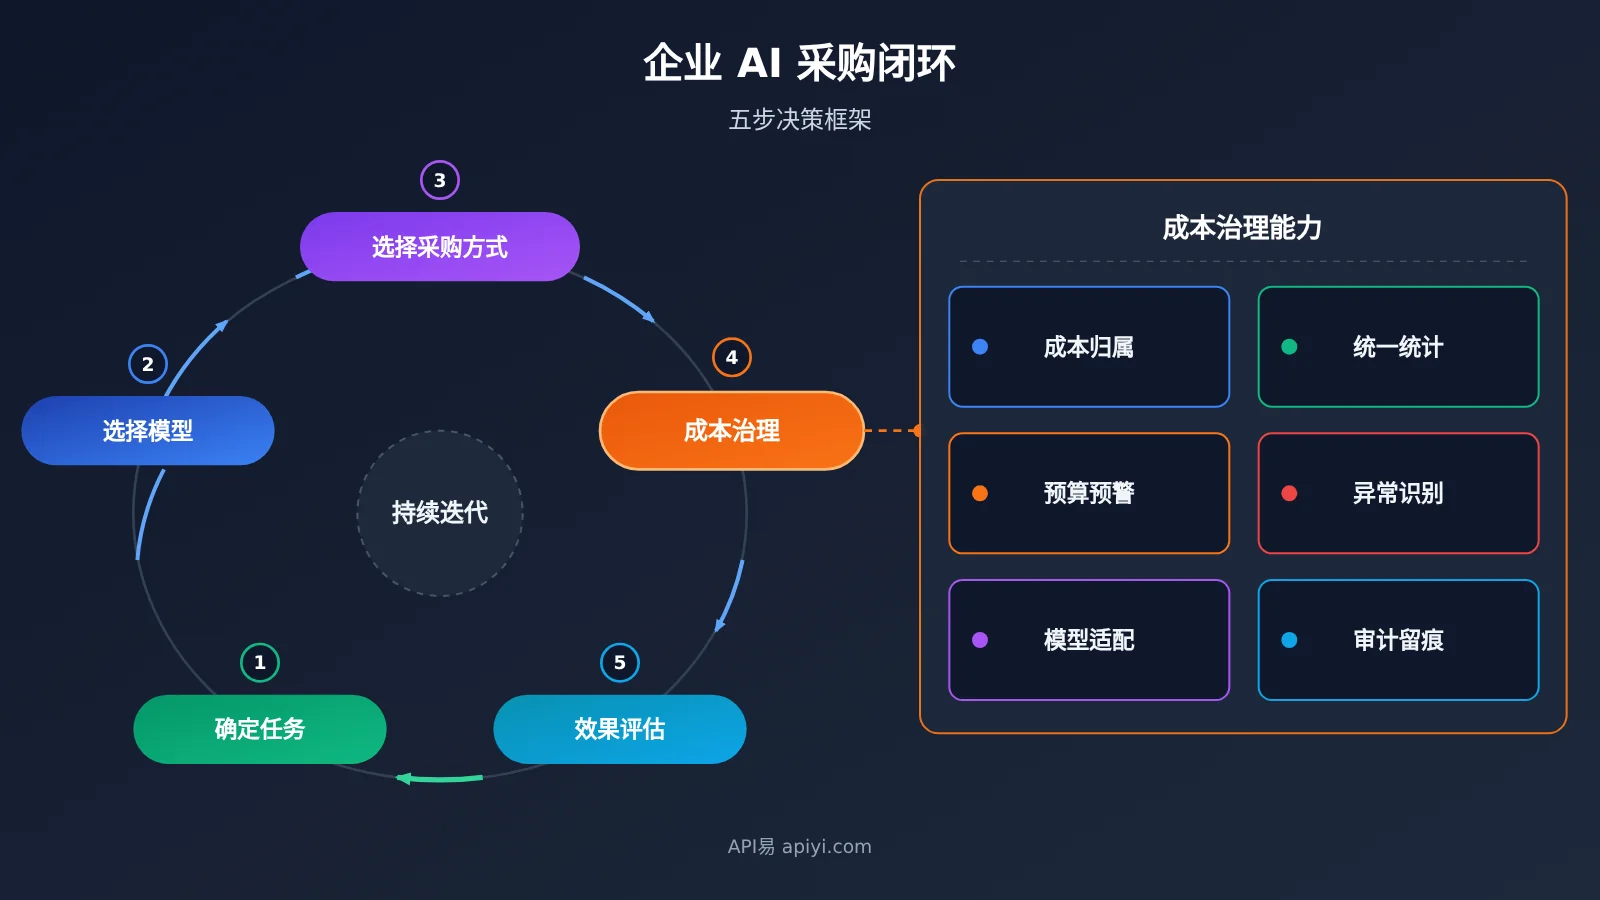
把前面的讨论落地,企业 AI 采购可以按五个步骤推进。每一步都对应一个明确的产出物,避免“先买了再说”导致的预算失控。
| 步骤 | 关键问题 | 产出物 | 可借助的工具 |
|---|---|---|---|
| 1. 确定任务 | 哪些工作交给 AI,哪些必须由人处理 | 任务清单与验收标准 | 业务访谈、流程梳理 |
| 2. 选择模型 | 准确性、推理能力、延迟、安全要求 | 每类任务的候选模型 | 统一接口平台如 API易 apiyi.com 做横向测试 |
| 3. 选择采购方式 | 按席位、按 API 用量还是企业定制合同 | 采购组合方案 | 供应商报价、合同条款 |
| 4. 成本治理 | 实际调用、预算、异常、成功率 | 预算预警与异常告警规则 | 用量统计、调用日志 |
| 5. 效果评估 | 是否真正改善业务结果 | 业务指标复盘报告 | 试点数据、财务核算 |
步骤详解:从任务到效果评估
第一步和第五步最容易被跳过,却决定了整个采购是否有意义。Credit Saison 的案例可以参考其节奏:先用 315 人做一个多月的 ChatGPT Enterprise 试点,再根据结果决定全员推广。该公司报告的试点 ROI 为 954%,每位参与者每月节省约 14 小时,但这是 OpenAI 发布的客户案例和企业自报数据,并非独立审计结论,更不是行业平均水平。
第三步通常不是单选题。比较常见的组合是:知识工作者使用 Business 或 Enterprise 席位,研发团队和自动化流程走 API 按量计费。第四步则需要覆盖 Harness 调查中归纳出的几项能力:
- 成本归属:按部门、团队、项目拆分 AI 支出,解决“没有成本负责人”的问题
- 统一统计:把不同供应商的账单合并到同一口径
- 预算预警:设置用量阈值,在超支前而不是月底发现问题
- 异常识别:及时发现异常 Token 消耗和 Agent 无限循环
- 模型适配:简单任务用轻量模型,复杂任务再调用高阶模型
- 审计留痕:保留调用日志、任务结果和审计记录
ChatGPT 企业采购对企业与行业的影响分析
对企业技术负责人的影响
- 预算模型需要重建:Agent 让 Token 消耗与人数脱钩,按人头编预算会系统性低估支出
- 评估指标需要升级:从比较 Token 单价,转向比较每个成功任务的成本
- 架构需要预留切换能力:多模型已是常态,业务代码不应深度绑定单一供应商 SDK
对 AI 采购与财务团队的影响
- 采购形式更复杂:席位、Credits、Token、云平台、合作伙伴服务可能同时存在
- 需要指定成本负责人:Harness 调查中超过一半组织缺少明确负责人
- 合同谈判有了新筹码:清晰的用量数据是谈批量折扣和 Token 计费方案的基础
对行业的影响
OpenAI 企业收入过半,说明大模型厂商的主战场正在向企业侧倾斜,企业级的安全、数据驻留和 SLA 会成为竞争重点。与此同时,Menlo 估算的企业 API 支出份额显示多家供应商并存,这意味着模型接入、路由、用量统计和预算控制等“中间层”能力会越来越重要。不过这属于趋势判断,并不代表任何单一服务商已经因此获得增长。
常见问题 FAQ
Q1: ChatGPT 企业采购和个人买 Plus 有什么区别?
企业采购不是批量购买个人账号。ChatGPT Business 和 Enterprise 提供集中账单、SSO、权限管理、使用分析、默认不使用企业数据训练等能力,Enterprise 还包括数据驻留、SLA 和定制法律条款,本质是带组织治理能力的企业产品。
Q2: 买了 ChatGPT Enterprise 还需要单独采购 API 吗?
通常需要分别考虑。ChatGPT 席位面向员工交互使用,API 面向自研应用和自动化流程,两者计费体系独立。如果研发团队要做 Agent 或批量任务,建议先通过 API易 apiyi.com 用免费额度测算真实 Token 消耗,再决定 API 预算规模。
Q3: OpenAI 企业收入过半是否意味着它占据了企业 API 市场一半份额?
不是。Brockman 说的是 OpenAI 自身收入结构,Menlo Ventures 估算的则是整个企业 API 市场的供应商支出份额,二者统计口径不同。此外,Brockman 并未披露精确百分比,企业收入也不能直接等同于 API 收入。
Q4: 企业如何快速搭建多模型的成本对比测试?
建议准备一批真实业务样本,用同一套代码在不同模型上运行,记录 Token、重试次数、人工复核时间和成功率。使用 API易 apiyi.com 的 OpenAI 兼容接口,只需替换 base_url 和 model 参数即可切换模型,用量也能在同一处统计。
Q5: 最便宜的模型是不是最划算?
不一定。低单价模型如果成功率低、需要多次重试或大量人工返工,每个成功任务的综合成本可能更高。应以 Cost per Successful Task 为准,并针对不同任务分别选型。
Q6: 本文引用的调查数据有哪些局限?
Harness 调查样本为五国、千人以上企业的 700 名受访者,且发布方为 FinOps 厂商;《The Multi-Lab Enterprise》是未经同行评审的预印本;Menlo 的支出与份额数据是市场估算;Credit Saison 的 ROI 是企业自报案例数据。这些数据适合用于识别趋势,不宜直接当作行业基准。
ChatGPT 企业采购核心要点 Key Takeaways
- 收入结构转向:OpenAI 企业收入已超过一半,消费者业务仍在增长
- 账单失控普遍:Harness 调查中 72% 企业遭遇过意外 AI 账单
- 多模型是常态:多数企业同时使用多个平台,使用比例不能相加为份额
- 单价不等于成本:用每个成功任务成本替代每百万 Token 价格做决策
- Agent 放大消耗:并行与后台执行让 Token 用量与员工人数脱钩
- 五步闭环采购:任务、模型、采购方式、成本治理、效果评估缺一不可
- 先测后签:可借助 API易 apiyi.com 统一接口用真实样本测算成本
总结
ChatGPT 企业采购的核心要点:
- 采购方式是组合题:Business 席位、Enterprise 定制合同和 API 按 Token 计费各有适用场景,多数企业需要混合使用
- 成本治理比选型更难:成本归属、统一统计、预算预警和异常识别,决定了 AI 支出是否可控
- 以任务成本为核心指标:把重试、工具调用和人工复核计入成本,才能做出真正划算的采购决策
对于正在制定 AI 预算的技术负责人和采购人员,比较稳妥的做法是先小规模试点、拿到真实用量数据,再签订长期合同。推荐通过 API易 apiyi.com 快速验证不同模型在你业务上的单任务成本,平台提供免费测试额度和多模型统一接口。
📚 参考资料
- Reuters:OpenAI 企业收入过半报道:Brockman 在 WSJ 科技大会的表态
- 链接:
reuters.com/legal/transactional/openai-ready-ipo-2027-now-counts-majority-sales-enterprises-brockman-says-2026-11-05 -
说明: 企业收入占比、第三季度增长与 IPO 相关表态
-
Harness:State of AI in FinOps 2026:企业 AI 成本管理调查
- 链接:
harness.io/state-of-ai-in-finops-2026 -
说明: 意外账单、成本可见性与多平台使用数据
-
OpenAI Business Pricing:ChatGPT Business 与 Enterprise 官方价格页
- 链接:
openai.com/business/pricing -
说明: 席位类型、企业功能与计费方式
-
Menlo Ventures:2026 The State of Enterprise AI:企业 AI 市场研究报告
- 链接:
menlovc.com/perspective/2026-the-state-of-enterprise-ai -
说明: 企业 AI 支出估算、API 份额与 Agent 消耗趋势
-
The Multi-Lab Enterprise:多模型企业治理研究预印本
- 链接:
arxiv.org/abs/2609.31622 - 说明: 多模型使用与预算超支的研究线索,尚未经过同行评审
作者: APIYI 技术团队
技术交流: 欢迎在 API易 apiyi.com 首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心