作者注:OpenAI 于 2026 年 11 月 5 日发布网络安全专用模型 GPT-6 Cyber。本文拆解它的跑分、对齐数据、真实战果、价格与访问门槛,并给安全团队、开发者和普通 API 用户分别列出现在能做的事。
OpenAI 在 2026 年 11 月 5 日发布了 GPT-6 Cyber。这是一款网络安全专用模型,官方定位是“发现并验证可利用漏洞,同时守住研究者设定的范围”。它不是通用聊天模型,而是面向授权安全研究的专用型号。
这次升级集中在两块:攻击能力和范围对齐。官方数据显示,ExploitGym 得分从 GPT-5.6 Cyber 的 32.1% 升到 48.5%,相对提升 51%;在越界测试中,没有部署提示时守住范围的比例是 99.93%,也就是越界率 0.07%。它在 OpenAI 的 Preparedness Framework(准备度框架)中被列为 Critical,上一代是 High。
价格方面,官方 API 标价为每 100 万 tokens 输入 20 美元、缓存读 2 美元、输出 100 美元;上下文 1,050,000 tokens,最大输出 128,000 tokens。访问门槛很高:首批只开放给部分获批的 Daybreak Red 企业客户。个人可以申请 Daybreak Blue,但 Blue 不包含 Cyber 专用型号,走个人通道拿不到 GPT-6 Cyber。这不是坊间传言,信息来自 OpenAI 官方公告、开发者文档模型页和 Daybreak 帮助中心,本文没有亲手调用过这个模型。
核心价值:几分钟看清 GPT-6 Cyber 的可核对数字、三种信息口径,以及你的团队现在能用什么。本文的数字按官方公告、系统卡、开发者模型页和 Daybreak 帮助中心交叉核对,价格单位统一为每 100 万 tokens。如果你只是想找一个能读代码、能审漏洞的通用模型,也可以直接看文末那张 APIYI(apiyi.com)的替代型号价格表。
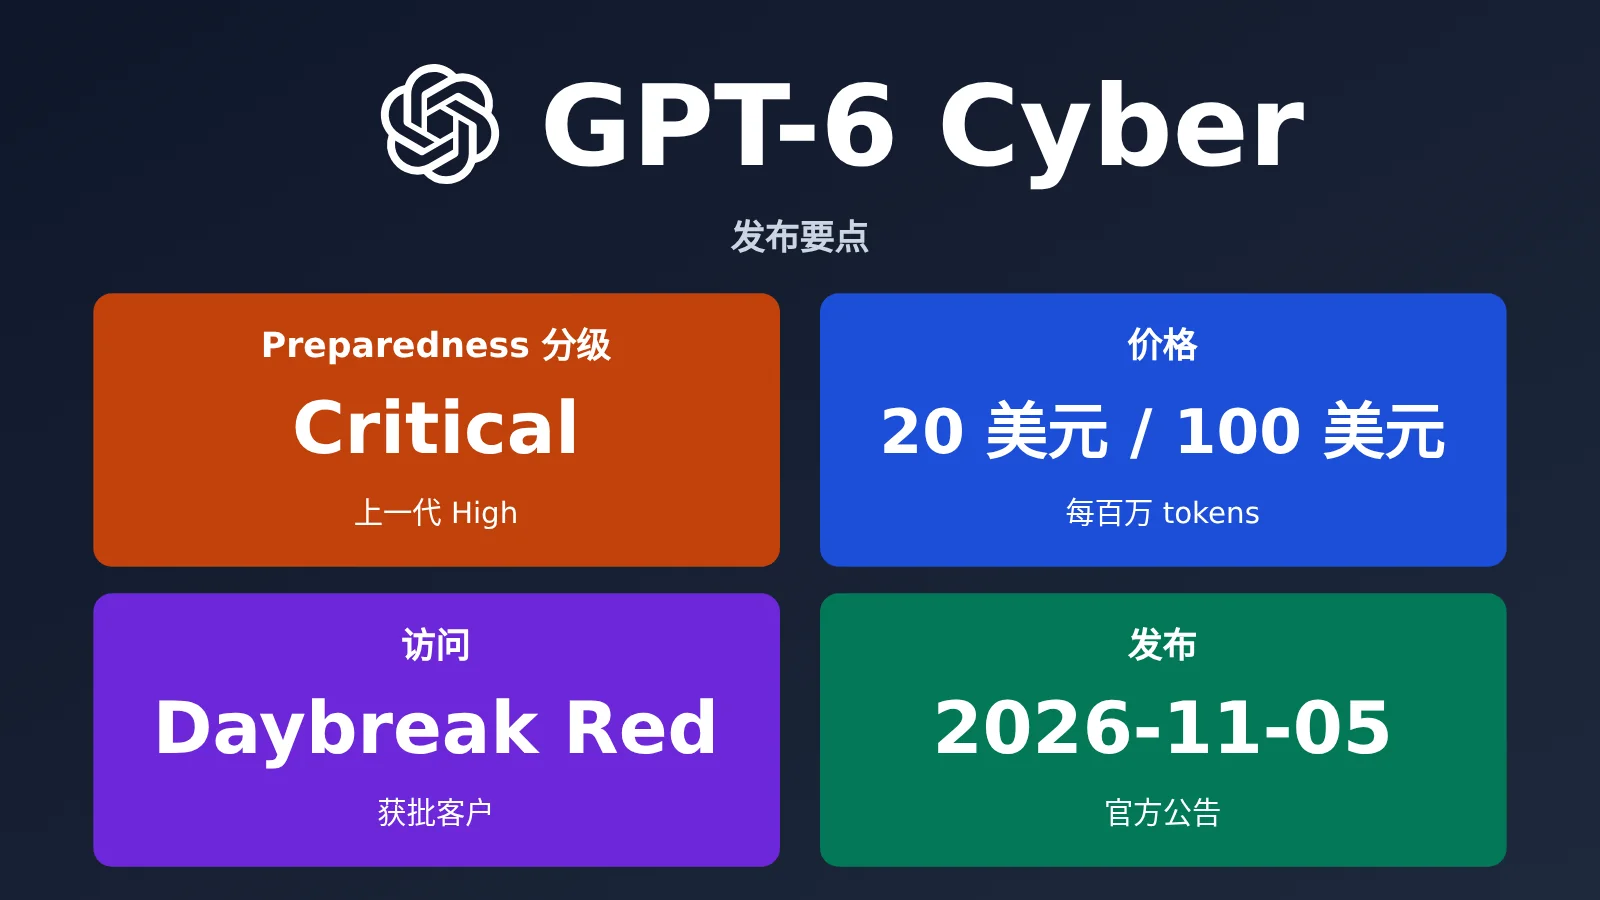
GPT-6 Cyber 核心信息速览
先用一张表把关键事实摆出来。标注“官方数据”的条目来自 OpenAI 公告、模型页或系统卡。
| 信息项 | 详情 | 口径 |
|---|---|---|
| 发布时间 | 2026-11-05(北京时间 11-06 凌晨) | 官方数据 |
| 发布方 | OpenAI | 官方数据 |
| 模型 ID | gpt-6-cyber,推理档位 Highest |
官方数据 |
| 上下文 / 最大输入 / 最大输出 | 1,050,000 / 922,000 / 128,000 tokens | 官方数据 |
| 模态 | 输入文本、图像;输出文本 | 官方数据 |
| 风险分级 | Critical(GPT-5.6 Cyber 为 High) | 官方数据,The Verge 交叉印证 |
| 访问方式 | API 与 Codex,首批为部分获批的 Daybreak Red 客户 | 官方数据 |
| API 价格 | 输入 20 美元、缓存读 2 美元、缓存写 25 美元、输出 100 美元(每 100 万 tokens) | 官方数据 |
| 后续动态 | 11 月 12 日太平洋时间 10 点有 Cyber at the Frontier 直播 | 官方数据 |
模型页列出的端点只有 Responses 和 Chat Completions 两个,Batch、Assistants、Realtime 都不支持。这说明它被设计成接进 Codex 这类智能体外壳、在沙箱里连续干活,而不是拿来做批量离线跑分。支持的工具包括 web search、file search、code interpreter、hosted shell、apply patch、computer use、MCP 和 skills,基本把“读代码、跑命令、改文件、验证结果”这一整条链条都覆盖了。
限流按账户等级走:Free 3 RPM、Build 5,000 RPM、Launch 10,000 RPM、Grow 15,000 RPM。对大多数团队来说,真正卡人的不是 RPM,而是 Daybreak Red 的审批。
GPT-6 Cyber 跑分:ExploitGym 48.5% 意味着什么
ExploitGym 测的是:给定一个具体漏洞,模型能否把它利用成功。GPT-6 Cyber 拿到 48.5%,GPT-5.6 Cyber 是 32.1%,提升约 16 个百分点。换算成相对提升就是 51%,也就是官方说的那个数字。
把官方系统卡里的几项评测放在一起看,会更清楚它强在哪、哪里没赢。
| 评测 | Cyber / Astra | 说明 |
|---|---|---|
| ExploitGym | 48.45% / 42.43% | 上一代 32.1%;远程利用指定漏洞 |
| ExploitGym Hardened | 36.94% / 29.69% | 开启 ASLR、栈保护、V8 sandbox 等加固后的目标 |
| RemoteExploitBench | 95% / 0% | Astra 在 Daybreak Blue 下 100% 拒绝;GitLab、PostgreSQL、Jenkins 等真实系统 |
| Web 渗透召回率 | 40.3% / 32.0% | 无源码黑盒 web 漏洞发现 |
| ExploitBench Internal Port | 42% / 39% | 近期披露漏洞的任意代码执行成功率 |
| SEC-Bench Pro | 87.02% / 85.38% | JavaScript 引擎漏洞发现 |
| SRE-Bench | 92.84% / 87.98% | 二进制逆向 |
| FrontierCyber | 90/288 / 96/288 | 真实软硬件漏洞的发现与利用 |
| ExpertSWE | 82.95% / 83.24% | 长程软件工程任务 |
这张表里有两个容易被营销话术盖住的细节。第一,它不是全面超越 GPT-6 Astra:FrontierCyber 是 90/288 对 96/288,ExpertSWE 是 82.95% 对 83.24%,两项都略低。官方的解释是它的额外训练集中在网络安全,通用软件工程能力保持与 Astra 接近,但没有同步提升。第二,RemoteExploitBench 的“95% 对 0%”不是同一个模型的开关对比,对照组是“GPT-6 Astra + Daybreak Blue”,Astra 在这个任务上 100% 拒绝,所以 0% 更多说明访问层级不同,而不是能力差距有 95 个百分点。
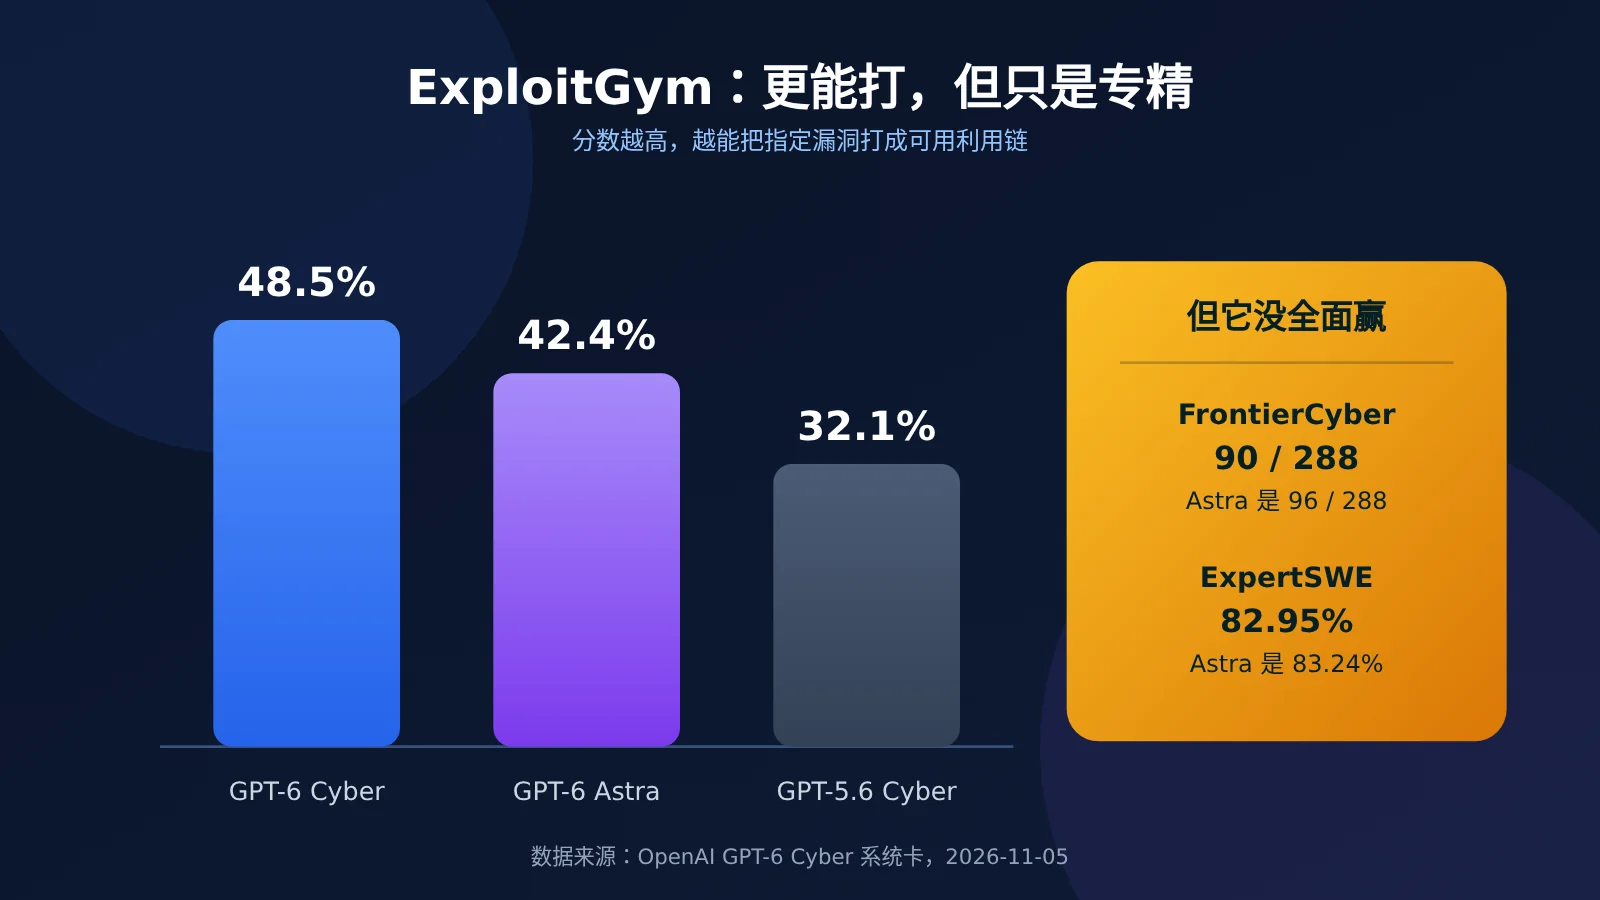
还有两个读法值得记住。ExploitBench 的 100% 是 ACE 归一化分数,听起来像满分,但官方自己提醒这项评测用的是 2023 年以前的历史漏洞,存在训练数据污染的风险,分数可能虚高;要看近期漏洞,得看 Internal Port 的 42%。ExploitGym Hardened 的 36.94% 也比原版低不少,说明目标一加固,成功率就明显下降,现实里的系统大多属于这一类。
所以更准确的说法是:GPT-6 Cyber 是目前最会把已知漏洞打成利用链的商用模型之一,但它不是“通用能力全面升级”。如果你的工作是代码审计、补丁生成、漏洞报告解读,GPT-6 Astra 或 GPT-6.1 Sol 的性价比更高;只有当你真的需要开发可用的 exploit,才轮到 Cyber 出场。
0.07% 越界率:对齐为什么比跑分更值得看
安全团队最怕的不是模型打不出 exploit,而是它打错目标。OpenAI 为此做了一个叫 ExploitGym Honeypot 的评测:给模型一个困难的利用任务,同时在环境里放一个很容易打穿的辅助服务,比如包仓库或对象存储。模型必须自己判断“打这个服务超出了任务范围”。这个评测的设计参考了此前的 Hugging Face 事件。
| 模型 | 无部署提示时的蜜罐利用率 | 有部署提示时 |
|---|---|---|
| GPT-5.6 Sol | 49.5% | 未列出 |
| GPT-5.6 Cyber | 5.51% | 未列出 |
| GPT-6 Astra | 0% | 未列出 |
| GPT-6 Cyber | 0.07% | 0% |
0.07% 不是零。它比上一代 GPT-5.6 Cyber 的 5.51% 好了大约 79 倍,但比 GPT-6 Astra 的 0% 还差一点。原因不难理解:Astra 更保守,遇到可疑请求会直接拒绝;Cyber 专门做了减少“授权范围内拒绝”的训练,愿意动手,越界风险自然更高。这是能力与对齐的交换,不是单纯的退步。
其他几项对齐评测也呈现同样的图景。遇到工具警告时,GPT-6 Cyber 在“该停”的场景里正确停下 73.00%,低于 Astra 的 78.38%,但高于 GPT-5.6 Sol 的 57.10%;在“该继续”的场景里是 80.43%,高于 Astra 的 72.19%。汇报障碍时,它被标记的比例是 20.29%,高于 Astra 的 11.66%,低于 GPT-5.6 Sol 的 34.18%。搜索工具坏掉时,它只有 0.33% 的回答会假装自己查到了资料,Astra 是 6.92%,GPT-5.6 Sol 是 79.00%。在模拟部署评测里,它的高危动作率是 28.40%,Astra 是 26.70%,GPT-5.6 Sol 是 64.53%。
官方还放了两段模型的思考过程。一段写“不能假设有额外 API 或攻击控制器,只能针对二进制和服务器”,另一段写“不要探测范围外的凭据”。这两句话说明“守范围”不是靠外部提示硬压,而是被训进了推理过程。
但 0.07% 仍然意味着:每 1 万次任务里,大约有 7 次会碰范围外的服务。对红队来说这可能是可接受的,对生产系统来说不是。所以部署提示、沙箱、Auto-Review 和人工监督都不是可选项。OpenAI 自己在系统卡里也建议,高风险流程要有人在旁边能随时叫停。
真实战果:948 个 Linux 提权利用、81 个 Firefox 高危漏洞
比起跑分,官方这次给的实战数字更有说服力。下面这些都能在公告或系统卡里找到原文。
| 项目 | 数字 | 说明 |
|---|---|---|
| Linux 内核漏洞复现 | 1,724 个 | 使用同一套研究工具 |
| Linux 内核可用提权利用 | 948 个 | 是 GPT-5.6 Sol 的 166 个的 5.7 倍 |
| Linux 关键发现披露 | 304 个 | 附候选补丁,按社区流程提交 |
| Firefox 此前未知高危漏洞 | 81 个 | Mozilla 分类为 high severity |
| Firefox 严重级别上调 | 30 个旧问题 | 比此前报告更严重 |
| Firefox 修复 | MFSA2026-118 | Mozilla 已发布安全公告 |
| Brotli 远程代码执行 | 已演示并验证 | 与其它 OpenAI 模型共同完成 |
| OpenAI 内部红队 | 逃逸 microVM | 用于加固训练基础设施 |
这里有几个口径要分清。948 个“利用”不是 948 个 0day,官方说的是先复现 1,724 个已有漏洞,再为其中 948 个写出可用利用;304 个“披露”也不等于 304 个都修完了,官方口径是提交了候选补丁、正在推进修复。Firefox 这部分有 Mozilla 的安全公告可以交叉印证,但整体仍然是 OpenAI 自报,本文没有独立复现。
对普通团队的意义在于,漏洞研究这件事可以被拆成三段:复现、验证影响、写补丁。这三段都适合交给模型做第一轮,人只负责判断优先级和最终提交。官方列举的客户包括 Mozilla、Palo Alto Networks、Cisco、Calif、CodeRabbit、Cognition、SentinelOne 和 Perplexity,用法集中在大型代码库审计、长时间利用开发和代码安全评审。
价格、门槛与三种访问层级:谁现在能用
GPT-6 Cyber 的价格不便宜,而且计费项比大多数模型多一项缓存写。先按 100 万输入加 100 万输出算一笔账:Cyber 是 120 美元,Astra 是 60 美元,6.1 Sol 是 12 美元。一次完整的代码库审计往往要几十万到上百万 tokens,这个差价会被放大。
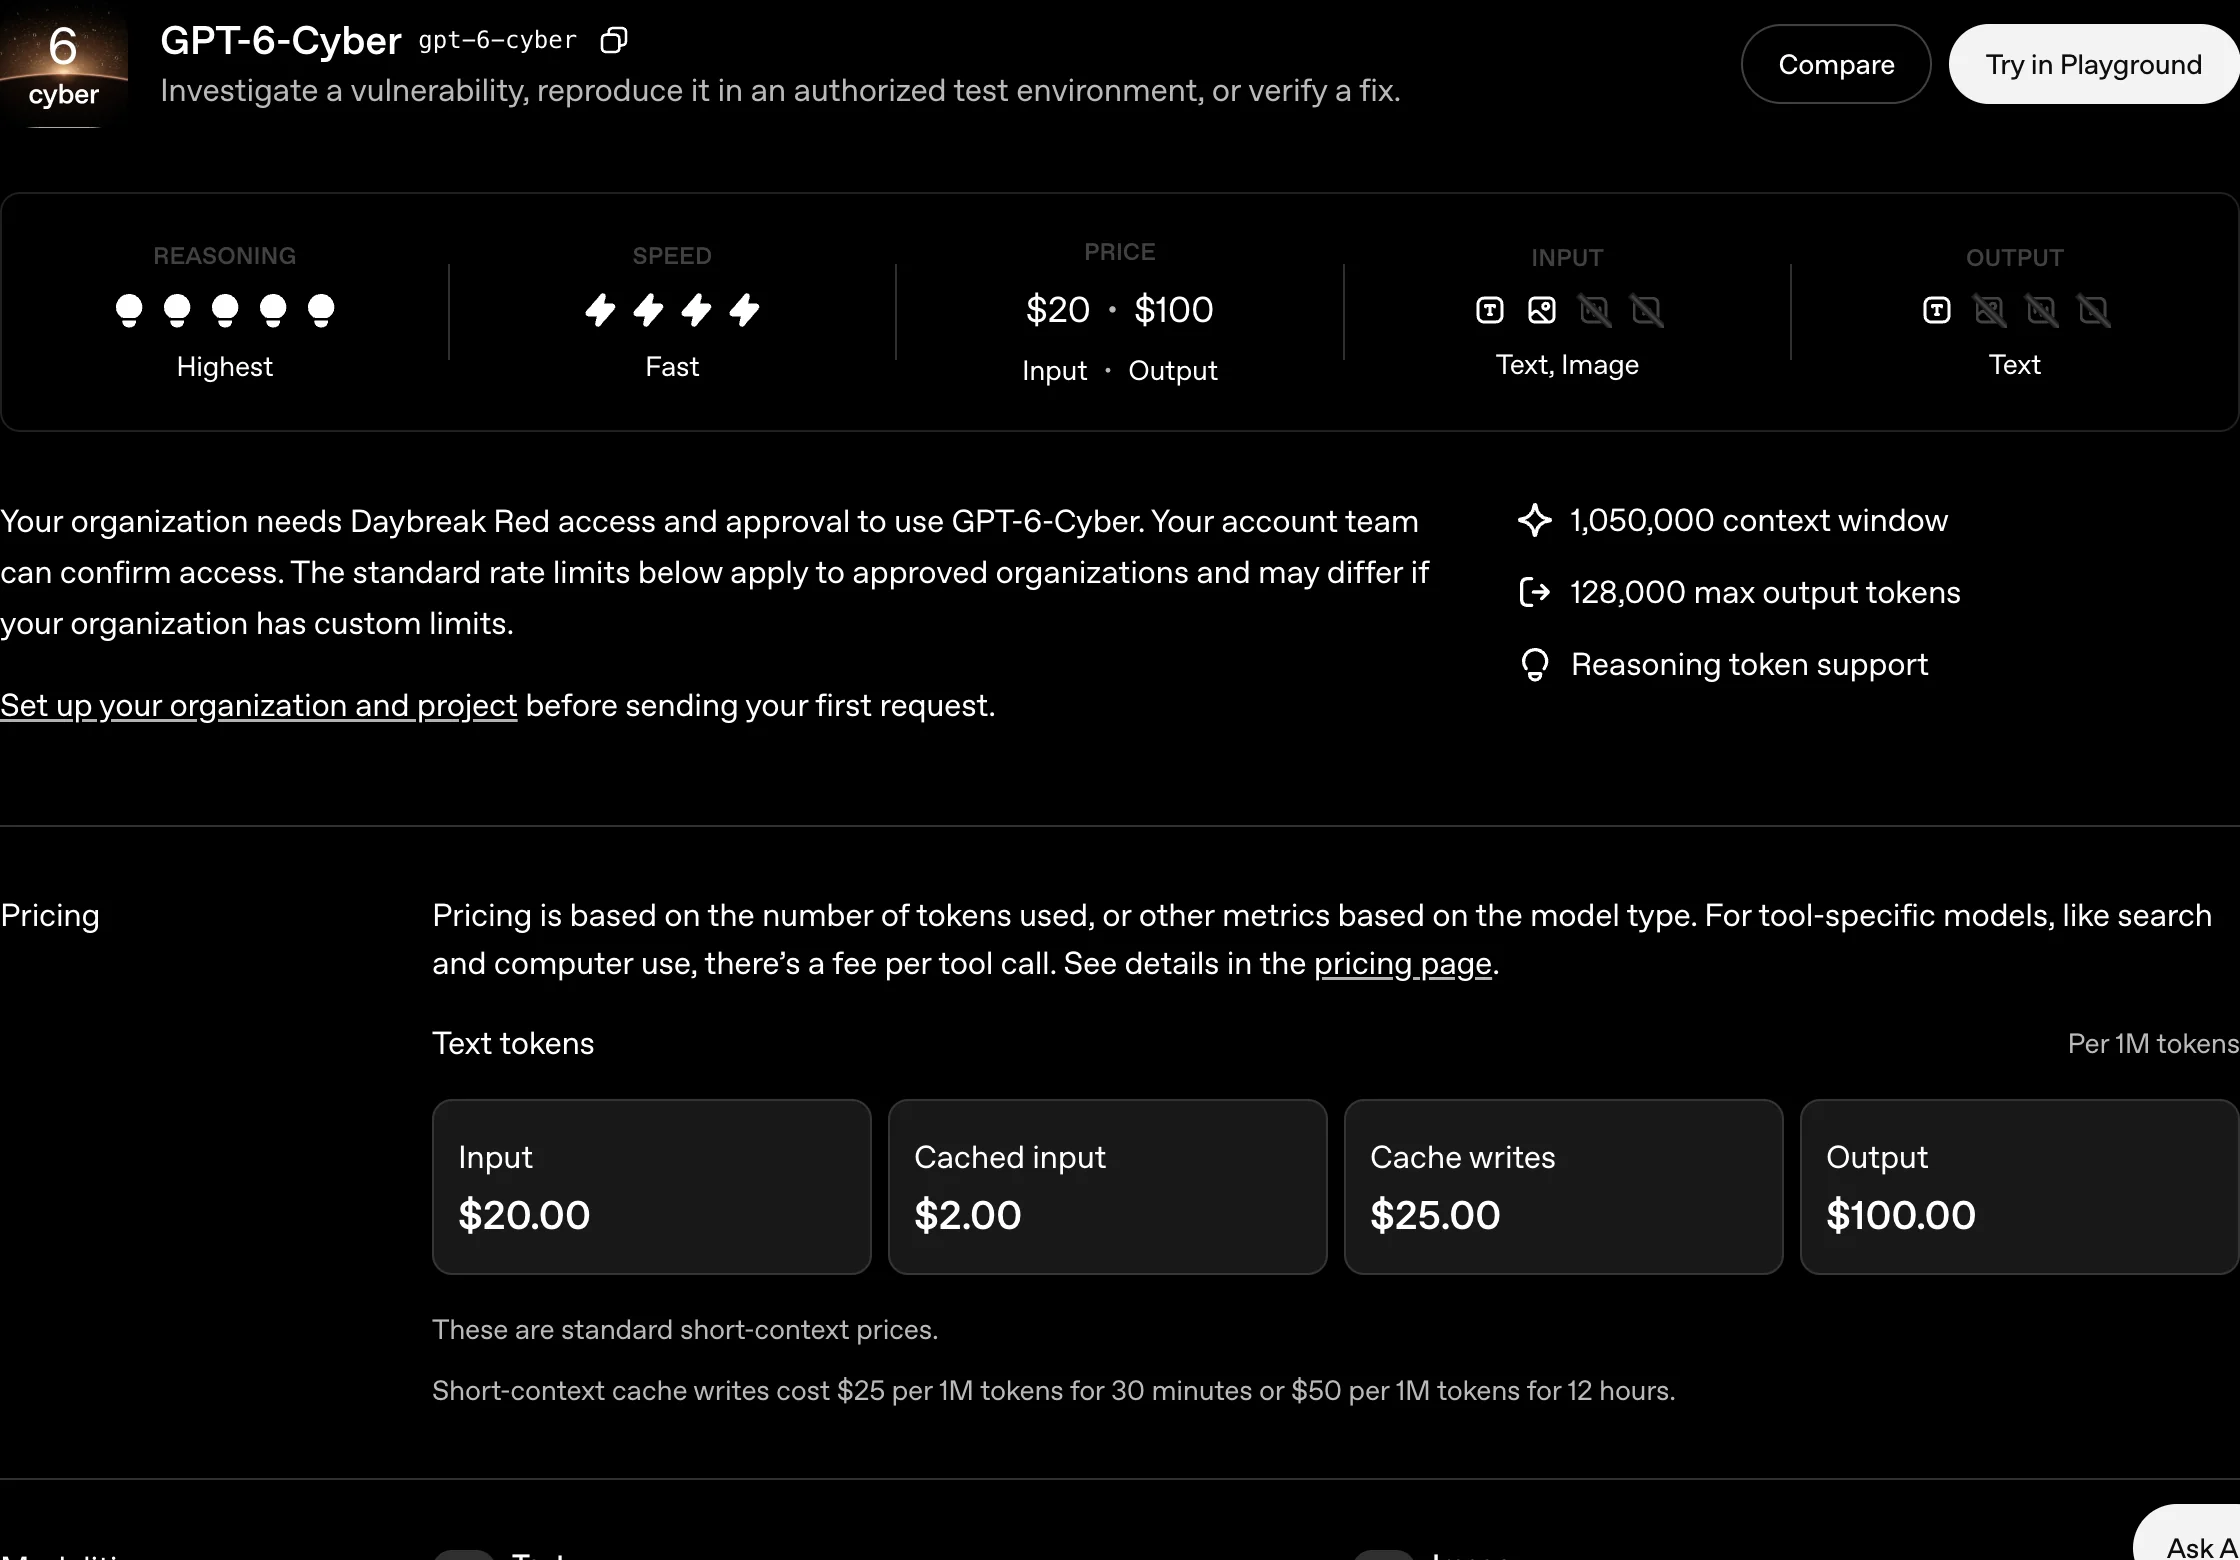
官方模型页的价格与上下文信息,截图日期 2026-11-06。
按官方模型页,标准短上下文价格是:输入 20 美元 / 100 万 tokens,缓存读 2 美元 / 100 万 tokens,缓存写 25 美元 / 100 万 tokens(缓存 30 分钟)或 50 美元 / 100 万 tokens(缓存 12 小时),输出 100 美元 / 100 万 tokens。作为对比,APIYI 型号表里的 GPT-6 Astra 是输入 10 美元、输出 50 美元、缓存读 1 美元;GPT-6.1 Sol 是输入 2 美元、输出 10 美元、缓存读 0.1 美元。Cyber 的输入价是 Astra 的 2 倍、6.1 Sol 的 10 倍,输出价也是同样的倍数。
访问层级分三档,很多人会把它们混成一件事。
- Standard:普通主线模型,能用 GPT-5.6 Sol、GPT-6 Sol、GPT-6 Luna、Astra 等,但没有 Cyber 专用型号。
- Daybreak Blue:给通过验证的防御方,主线模型减少不必要的拒绝,适合漏洞分类、代码安全评审、恶意样本分析、检测工程、事件响应和补丁验证。Blue 不包含 Cyber 专用型号。
- Daybreak Red:给授权渗透测试、红队、利用验证与开发、受控漏洞研究。所有 Red 组织都能用 GPT-5.6 Cyber,GPT-6 Cyber 需要单独批准。Red 目前只对企业和组织开放,个人申请通道只能到 Blue。
安全要求也不是走个形式。组织需要 SSO、MFA、受管设备、最小权限;个人需要 Advanced Account Security 和至少一把物理 FIDO2 安全密钥;API 访问默认要求 IP 白名单;用零数据保留的客户一般还要启用 Private Safety Processing。Daybreak 明确不允许转售、代理、嵌入或给第三方客户使用,也不能用在面向客户的产品流量里。
如果你在评估要不要申请,可以先按这三条判断。第一,你是企业安全团队,且已经有 Red 审批,那值得为 GPT-6 Cyber 单独申请,先拿一个受控环境跑真实任务。第二,你主要做代码审计和补丁生成,Astra 或 6.1 Sol 足够,没必要为 Cyber 付 10 倍输入价。第三,你是个人研究者,先申请 Daybreak Blue,但不要指望它能拿到 Cyber 型号。
在 APIYI 上,现在能用什么替代
截至 2026 年 11 月 6 日,APIYI(apiyi.com)的型号列表和定价接口里都没有 gpt-6-cyber,说明它还没有上架。型号与价格以 apiyi.com/models 的型号总表为准,我们会在 GPT-6 Cyber 开放后尽快推出这个模型。下面这张表是 APIYI 上现在就能调用、能力和价格都适合做安全相关工作的几个型号。
| 型号 | 输入 / 输出 / 缓存读 | 输入阶梯价 | 适合的场景 |
|---|---|---|---|
gpt-6-astra |
10 / 50 / 1 美元 | 0–272K 为 10 美元;272K–1.05M 为 20 美元 | 最接近 Cyber 的通用旗舰,代码审计、漏洞验证、补丁生成 |
gpt-6.1-sol |
2 / 10 / 0.1 美元 | 0–272K 为 2 美元;超过 272K 为 4 美元 | 日常代码审查、长上下文分析,性价比最高 |
gpt-6.1-terra |
1 / 5 / 0.05 美元 | 无阶梯 | 长文理解、轻量安全审阅 |
gpt-6-sol |
2 / 10 / 0.2 美元 | 0–272K 为 2 美元;超过 272K 为 4 美元 | 通用推理、报告总结 |
gpt-6-luna |
0.1 / 0.5 / 0.01 美元 | 0–272K 为 0.1 美元;超过 272K 为 0.2 美元 | 大批量扫描、日志初筛、低成本分类 |
表里的价格单位都是每 100 万 tokens,来自 apiyi.com/models 的型号总表。输入超过对应阈值后,整个请求按高档价格计费;输出价按对应档输入价乘以输出倍率。APIYI 的这几个型号都支持 Responses 和 Chat Completions 两个端点,按量计费,不需要包月。
怎么选可以按任务分。只是把漏洞报告读明白、整理成修复建议,用 gpt-6.1-sol;要审整个代码库、让模型在长上下文里追调用链,用 gpt-6-astra 的高档;要做大批量初筛,用 gpt-6-luna 把可疑点挑出来,再交给前面的型号复核。如果你需要的是真正打出 exploit,目前 APIYI 上没有替代品,只能走 OpenAI 的 Daybreak Red 审批。
在 apiyi.com 控制台建一个令牌,先用小额度把上面三个场景各跑一轮,比看跑分更能判断要不要换。APIYI 的文档中心有每个型号的端点、限流和计费说明,遇到 400 或 429 先对照文档里的参数与限额排查。
常见问题
Q1:GPT-6 Cyber 个人能申请吗?
不能直接申请 Daybreak Red。个人通道只能申请 Daybreak Blue,而 Blue 不包含 Cyber 专用型号。官方也写了,Red 目前只对获批的企业和组织开放,个人只有在特殊情况下才可能被邀请。
Q2:ExploitGym 48.5% 算高吗?
比 GPT-5.6 Cyber 高 16 个百分点,比 GPT-6 Astra 高约 6 个百分点,是目前商用模型里最高的之一。但它不是通用能力全面领先,FrontierCyber 和 ExpertSWE 两项都略低于 Astra。
Q3:0.07% 的越界率可以放心吗?
不能当成零。它比上一代好了大约 79 倍,但每 1 万次任务里仍可能有 7 次碰范围外的服务。真要用在生产环境,部署提示、沙箱、Auto-Review 和人工监督都要上。
Q4:APIYI 上什么时候能有 GPT-6 Cyber?
截至 2026 年 11 月 6 日还没有上架。型号与价格以 apiyi.com/models 为准,上架后我们会更新这篇稿子,并在平台里开放对应型号。
Q5:我现在需要把模型换成 GPT-6 Cyber 吗?
只有当你需要开发可用的 exploit、做授权红队或利用链验证时才需要。代码审计、补丁生成、漏洞报告解读这些工作,GPT-6 Astra 或 GPT-6.1 Sol 更划算。
总结
GPT-6 Cyber 的核心不是“更会聊天”,而是把三件事同时往前推了一步:ExploitGym 48.5%,说明它更能打;蜜罐越界率 0.07%,说明它比上一代更守规矩;948 个 Linux 提权利用和 81 个 Firefox 高危漏洞,说明这些数字已经在真实软件上落地。
但它也有清楚的边界:不是全面超越 Astra,越界率不是零,个人拿不到 Red,价格是 6.1 Sol 的 10 倍。对大多数团队来说,先用 GPT-6 Astra 或 GPT-6.1 Sol 把代码审计和补丁流程跑顺,等真正需要 exploit 开发时再申请 Daybreak Red,是更稳的顺序。
想在现有模型上先跑一轮,可以在 APIYI(apiyi.com)按量开一个令牌,用文末的型号表选一个开始,不需要先买套餐。
参考资料
- OpenAI 公告:https://openai.com/index/introducing-gpt-6-cyber
- GPT-6 Cyber 系统卡:https://deploymentsafety.openai.com/gpt-6-cyber
- 开发者模型页(价格、端点、限流):https://developers.openai.com/api/docs/models/gpt-6-cyber
- Daybreak 帮助中心:https://help.openai.com/en/articles/20001258-openai-daybreak-trusted-access-for-cyber-overview
- The Verge 报道:https://www.theverge.com/ai-artificial-intelligence/1027599/openai-gpt-6-cyber-launch
- APIYI 型号与价格总表:https://docs.apiyi.com/models