作者注:基于 OpenAI Images 2.6 安全系统卡,解读 AI 动图审核的时间维度难题、77.66% 召回率的含义,以及开发者如何处理审核拦截。
2026 年 11 月 4 日,OpenAI 随 Images 2.6 发布安全系统卡,并披露了一组专门针对动图的测试结果:在 310 个已标注违规的 GIF 样本上,审核机制的 召回率为 77.66%。这个数字很容易被误读,它既不是线上违规率,也不是审核系统的总体准确率。
这不是一份渲染风险的解读。本文以官方系统卡和 API 文档为依据,并明确区分官方事实、测试结果和我们的技术分析。
核心价值:3 分钟了解 AI 动图审核为什么更难、这些数字该怎么读,以及开发者需要调整什么。
AI 动图审核核心信息速览
| 信息项 | 官方披露内容 | 阅读时要注意 |
|---|---|---|
| 发布时间 | 2026 年 11 月 4 日随 Images 2.6 发布 | 事实截至 2026 年 11 月 5 日 |
| 新增风险 | 部分违规含义体现在连续动作和帧间关系中 | 系统卡将其与静态图片评估分开讨论 |
| 新增防护 | 联合审核动画帧网格(frame grid)和生成说明(generation caption) | 具体算法与帧采样方式未公开 |
| GIF 测试 | 310 个违规 GIF 样本,召回率 77.66% | 针对性样本,不代表普通用户内容分布 |
| 静态图片测试 | 3,077 条对抗性请求 | 属于离线评估,与 GIF 测试的口径不同 |
为什么 AI 动图比静态图片更难审核
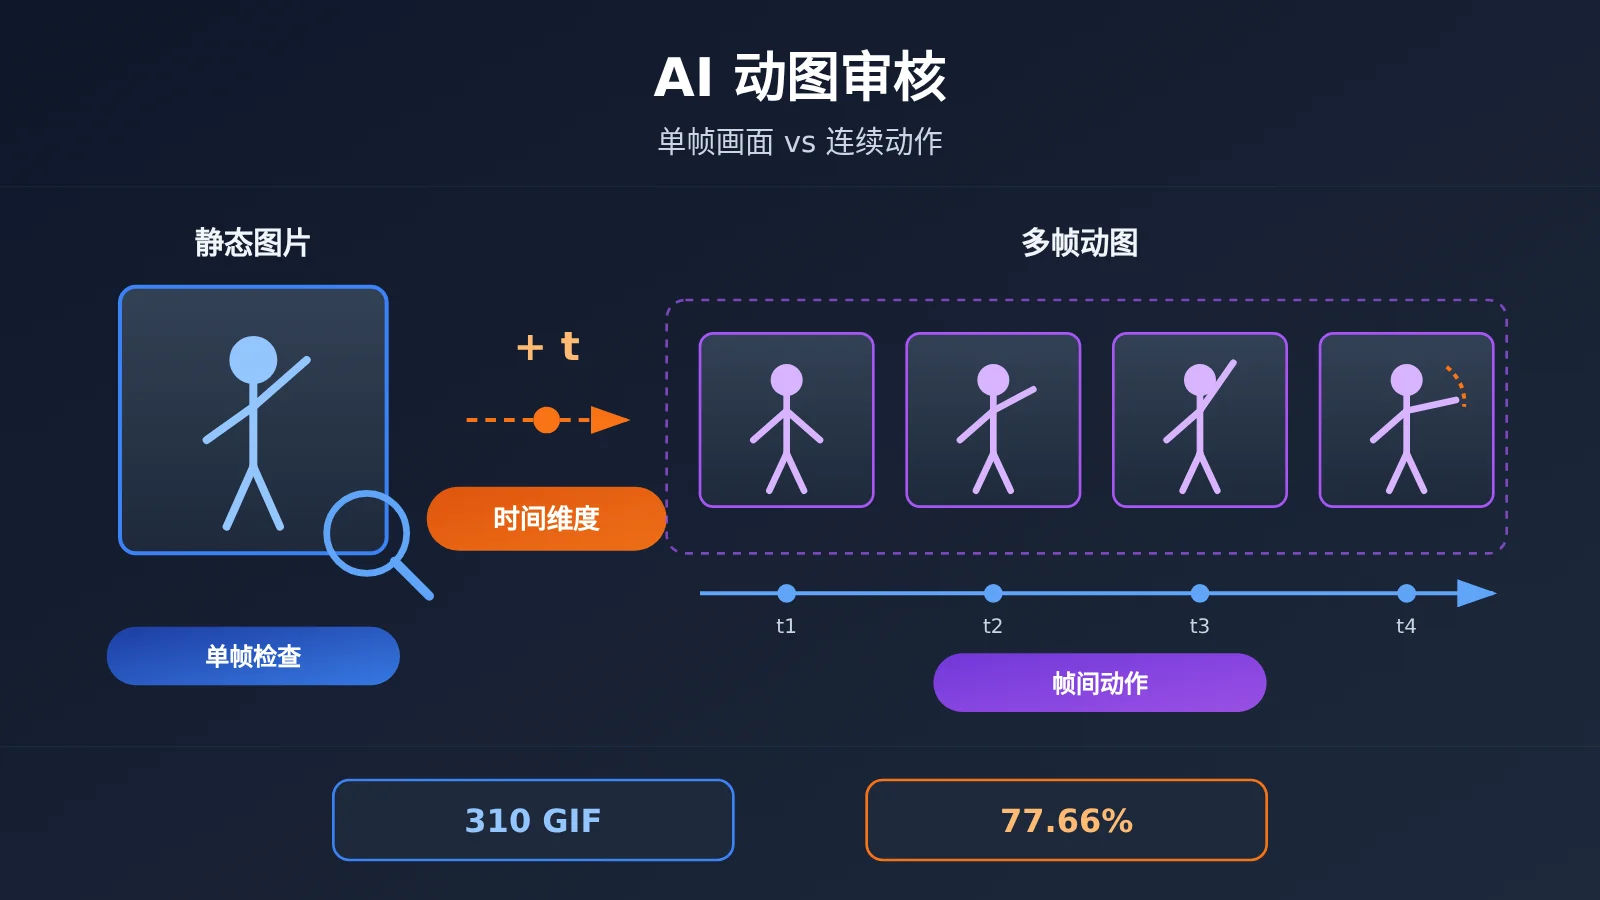
OpenAI 在系统卡第 3.2.2 节指出,某些违规含义存在于动作过程中,而不在某一帧里。多帧之间的关系、同一元素的运动方式,都可能改变内容的含义。因此,孤立分析静态画面可能无法充分判断动画风险。官方举出的风险类别之一,是带有性意味的动作。
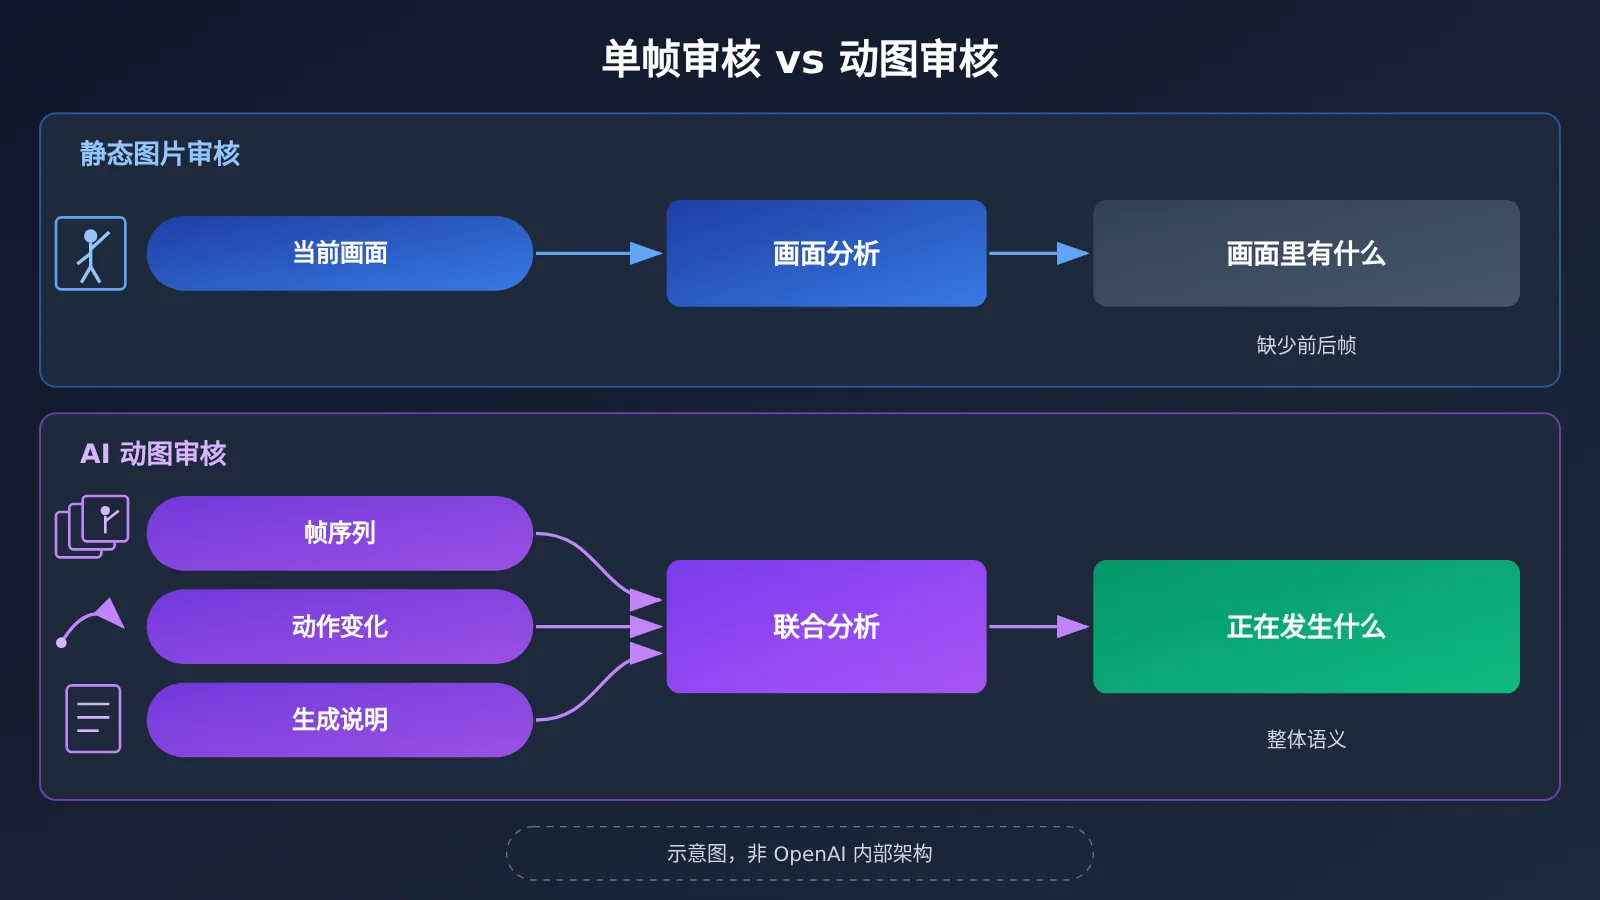
下面用一个我们自拟的中性例子说明,它并非官方案例。一张“手臂抬起”的图片信息有限,单看这一帧,很难判断对方是在打招呼还是准备攻击。只有看到后续帧中手臂是左右摆动,还是快速挥向另一个人,才能得出更可靠的判断。单帧回答的是“画面里有什么”,连续帧还要回答“正在发生什么”。
由此可以归纳出动图审核的三个额外判断点。这部分是我们的技术分析,不代表 OpenAI 披露的算法细节:
- 时间顺序:相同的几帧换一种排列,可能呈现完全不同的事件。
- 动作关系:人物或物体之间是靠近、接触还是分开,往往要跨帧才能看清。
- 整体语义:每一帧单看都不违规,并不代表连起来播放后依然合规。
AI 动图审核与静态图片审核的差异
| 对比维度 | 静态图片审核 | AI 动图审核 |
|---|---|---|
| 判断对象 | 单个画面的视觉内容 | 整组帧及其整体语义 |
| 关键信息 | 物体、场景、文字等 | 还包括动作、顺序、帧间关系 |
| 官方新增措施 | 沿用多层安全检查 | 帧网格加生成说明的联合审核 |
| 拦截策略 | 按现有政策判断 | 部分类别采用更宽的拦截范围 |
| 公开数据缺口 | 有 3,077 条对抗性请求评估 | 缺少误报率、延迟和第三方复测 |
API 参数也能说明这个问题的复杂度。官方文档显示,GIF 输出支持 2 到 64 帧,默认 9 帧;每帧时长可设为 20 到 2000 毫秒,默认 200 毫秒。我们认为,帧数越多,审核时越需要兼顾细节与成本,而播放节奏也可能影响观感。但官方并未公开是否逐帧分析所有画面,也未说明帧时长如何参与判断。
OpenAI 如何审核 AI 动图:多层机制加帧网格
根据系统卡第 3.1 节,Images 2.6 的静态图像安全系统由三层检查组成,GIF 防护是在此基础上增加的额外机制。
- 生成前的请求审核:用基于语言模型的政策检查判断用户请求,不合规的请求可能在进入生成阶段前被拒绝。
- 输入审核:用多模态安全推理模型检查提示词和输入图片,并判断编辑请求是否具有违规意图。
- 输出审核:审查生成结果,在展示给用户之前拦截被判定违规的内容。
对于 GIF,官方说明安全推理模型会检查整组动画帧,同时参考生成说明,并结合时间上的动作变化作出判断。某些内容类别还采用了比静态图像更宽的拦截范围,以覆盖推断出的动作风险。这说明审核对象已从孤立的画面,扩展到动画的整体语义。
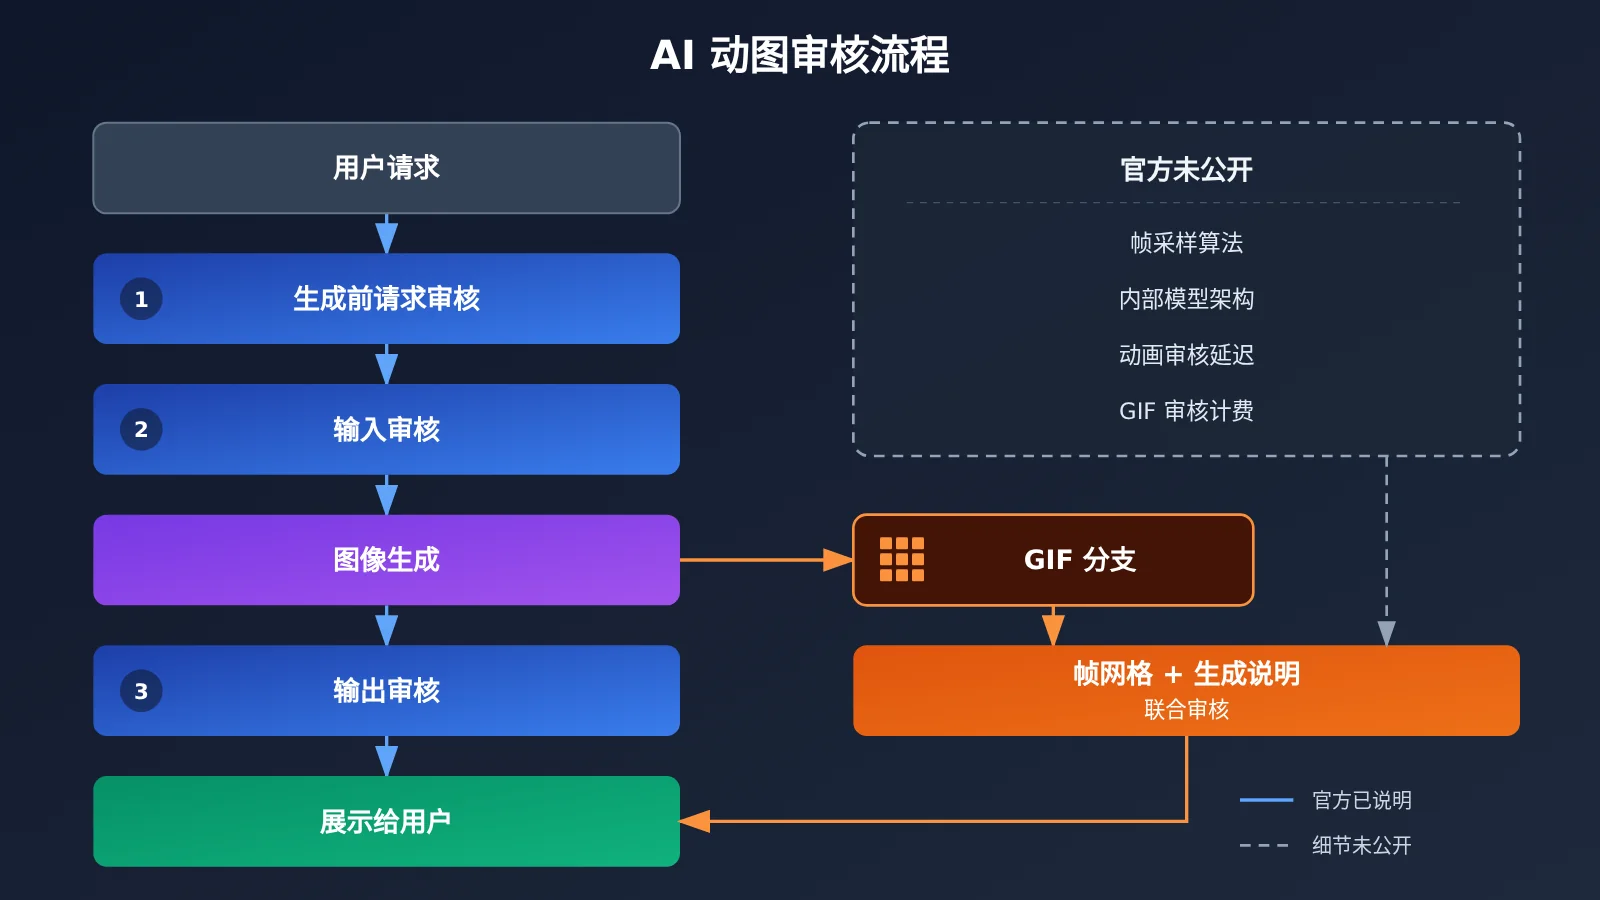
官方没有公开的内容同样值得注意,包括帧采样算法、内部模型架构、动画审核引入的延迟,以及 GIF 审核的单独计费方式。如果你想了解审核拦截在自己业务中如何表现,可以通过 API易 apiyi.com 的统一接口先跑通错误处理流程,再结合实际模型逐项验证。
如何理解 AI 动图审核的 77.66% 召回率
这项测试针对 310 个被标注为违反政策的 GIF,对生成说明和动画帧网格进行联合审核。召回率回答的问题是:在这批已知违规样本中,有多大比例被审核机制检测到。OpenAI 也明确承认,基于动作的违规仍然难以检测,现有措施可能遗漏部分违规内容。
| 这个数字 | 判断 | 原因 |
|---|---|---|
| 是已知违规样本的检出比例 | ✅ 可以这样理解 | 这正是召回率的测试含义 |
| 是审核系统的总体准确率 | ❌ 不能这样理解 | 测试只覆盖违规样本 |
| 是正常内容的通过率 | ❌ 不能这样理解 | 样本中没有用于计算该指标的正常内容 |
| 22.34% 是线上违规 GIF 的出现概率 | ❌ 不能这样理解 | 样本经过针对性选取,不代表真实分布 |
| 能说明误报情况 | ❌ 不能这样理解 | 测试未提供误报率或完整精确率 |
所以,77.66% 更适合作为衡量“困难样本检出能力”的参考,而不是对线上安全水平的总体评价。它的价值在于官方给出了可讨论的测试结果,同时也暴露了动作类风险尚未完全解决。
3,077 条对抗测试揭示的 AI 图片审核分层逻辑
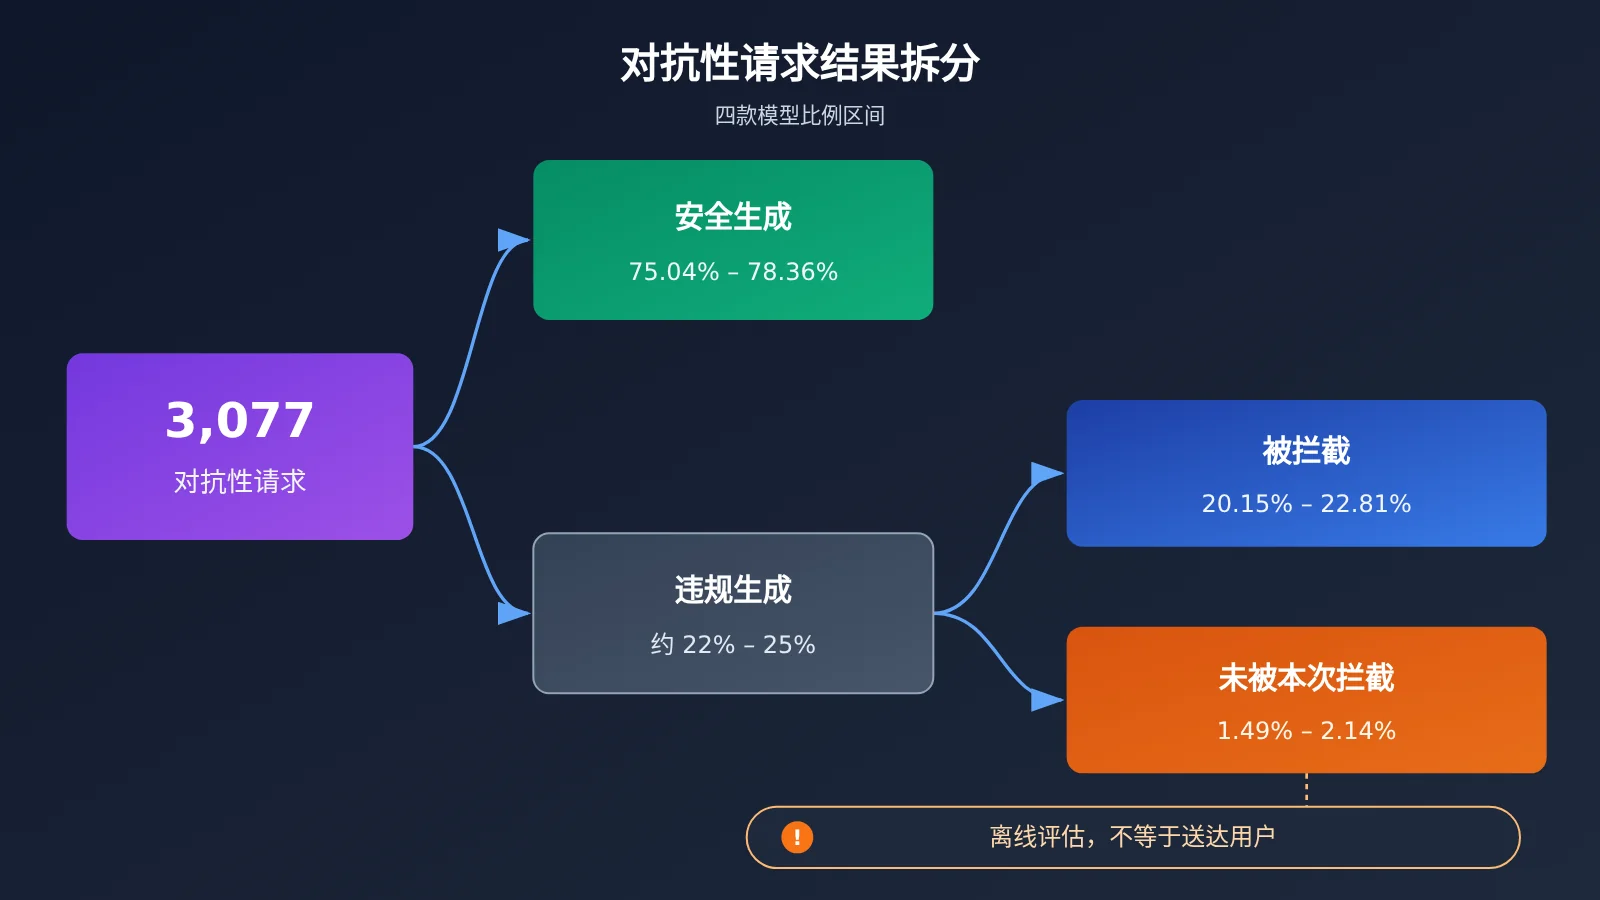
系统卡还用 3,077 条专门设计的困难请求评估静态图片安全。需要强调的是,这组数据不是 GIF 测试结果,但它清楚地展示了“模型自身安全”“审核拦截能力”“最终未拦截结果”是三个不同的指标。
| 模型(静态图片评估) | 安全生成 | 违规生成且被拦截 | 违规生成未被本次审核拦截 |
|---|---|---|---|
| GPT-Image-2.5 Sunburst | 76.15% | 21.94% | 1.92% |
| GPT-Image-2.6 Sunburst | 75.50% | 22.78% | 1.72% |
| GPT-Image-2.5 Flare | 78.36% | 20.15% | 1.49% |
| GPT-Image-2.6 Flare | 75.04% | 22.81% | 2.14% |
这些数据不支持“新版全面更安全”或“新版更危险”的简单结论。官方说明,Sunburst 和 Flare 的总体未拦截比例变化都没有达到统计显著性。不过,Flare 的安全生成比例从 78.36% 降至 75.04%,这一变化具有统计显著性。
“未被本次审核拦截”也只是离线评估结果,不等于违规内容实际送达了用户。此外,77.66% 与这组静态数据的样本和机制都不相同,不宜直接比较后得出“动图比图片差多少”的结论。
AI 动图审核对开发者和内容平台的影响
对 API 开发者:把审核拦截当成正常业务状态
OpenAI 图像 API 的 moderation 参数支持 auto 和 low 两个取值,其中 low 只是过滤限制相对较少,并不等于关闭安全系统。请求被拦截时,可能返回 error.code = "moderation_blocked"。部分错误还会附带审核阶段和粗粒度类别,但这些字段不保证每次返回。
| 字段或动作 | 官方说明 | 落地建议 |
|---|---|---|
error.code |
可能为 moderation_blocked |
作为错误分支的主要判断依据 |
moderation_stage |
可能是 input、output、unknown |
写入日志,供客服和排查使用 |
categories |
如 sexual、violence 等粗粒度类别 |
按存在与否处理,不作为必需字段 |
| 用户提示 | 清晰但不过度透露内部规则 | 引导用户修改描述 |
| 重试策略 | 不自动重试需用户修正输入的审核错误 | 由用户修改后重新提交 |
下面的极简示例演示如何捕获审核拦截,请把模型名替换为你实际可用的模型:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

try:
    result = client.images.generate(model="YOUR_IMAGE_MODEL", prompt="一只挥手的卡通吉祥物")
except openai.APIStatusError as e:
    if e.code == "moderation_blocked":
        print("内容未通过审核,请修改描述后重新提交")
    else:
        raise
查看 GIF 生成与审核日志完整示例
import base64
import logging
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def generate_gif(prompt: str, model: str = "YOUR_IMAGE_MODEL") -> str | None:
    try:
        result = client.images.generate(
            model=model,
            prompt=prompt,
            extra_body={
                "output_format": "gif",
                "frame_count": 9,
                "frame_duration_ms": 200,
            },
        )
    except openai.APIStatusError as e:
        if e.code != "moderation_blocked":
            raise
        # 详情字段不保证返回,需要做兼容处理
        body = e.body if isinstance(e.body, dict) else {}
        details = body.get("moderation_details") or {}
        logging.warning(
            "moderation_blocked stage=%s categories=%s",
            details.get("moderation_stage"),
            details.get("categories"),
        )
        # 不自动重试,交由用户修改描述
        return None

    with open("output.gif", "wb") as f:
        f.write(base64.b64decode(result.data[0].b64_json))
    return "output.gif"
以上 GIF 参数来自 OpenAI 官方文档。官方的 GIF 输出属于 `images/generations` 功能,`images/edits` 接口不支持直接输出 GIF。
建议:先用稳定的
error.code建立错误分支,再补充日志和界面提示。可以通过 API易 apiyi.com 获取免费测试额度来验证调用流程;具体模型和 GIF 参数的支持情况,请以平台最新模型列表和文档为准。
对内容平台:误报和漏报都要有处理路径
官方尚未公布 GIF 审核的误报率。不过,部分类别采用更宽的拦截范围,这意味着平台应当考虑正常创作被误拦的可能,并设计好提示和申诉渠道。同时,官方也承认可能存在遗漏,所以允许用户发布和传播 GIF 的平台,不宜把上游审核当作唯一防线。
以下是我们的实践建议,不是官方要求:
- 发布前复核:对公开传播的内容保留平台自身的政策检查和用户举报入口。
- 按完整动画复核:人工或自动复核时不要只看封面帧,要结合完整播放效果。
- 分开记录:将“请求被拦截”“发布后被举报”分开统计,便于定位问题环节。
对来源识别:水印不能替代内容审核
系统卡介绍了多层来源识别方案,包括继续支持 C2PA 元数据,以及引入 Google DeepMind 的 SynthID 隐形水印。前者主要记录来源信息,后者则将不可见信号嵌入媒体内容。但这并不意味着每个导出的 GIF 都一定带有可验证水印,也不能保证水印经过压缩或转码后依然保留。
未检测到水印,同样不能证明内容不是 AI 生成的。OpenAI 也承认不存在单一、完整的来源识别方案。来源标记回答的是“它可能从哪里来”,审核回答的是“它能否被生成或传播”,两者应该互相补充。
AI 动图审核常见问题 FAQ
Q1:77.66% 是否说明 22.34% 的违规动图已经发给了用户?
不能这样解读。77.66% 是 310 个已标注违规 GIF 上的测试召回率,样本经过针对性选取,既不反映线上内容分布,也不是真实违规内容的送达概率。
Q2:AI 动图审核能否直接用静态图片分类器逐帧检查?
逐帧检查可以发现部分单帧违规,但难以覆盖只有在连续动作中才显现的含义。因此,动图审核不等于简单地把每帧分别输入静态分类器。OpenAI 的做法是结合帧网格和生成说明进行联合审核,具体算法并未公开。
Q3:目前有独立的 GIF 审核复测数据吗?
截至 2026 年 11 月 5 日,本文掌握的资料中尚无可靠公开的独立第三方复测。不同动画长度下的性能、误报率、实际延迟和各类违规动作的细分检出率也都缺少公开数据。
Q4:把 moderation 设为 low,能关闭 AI 动图审核吗?
不能。`low` 只是限制相对较少的过滤模式,并不等于关闭安全系统或绕过内容政策。生产环境建议从默认的 `auto` 开始,并根据业务场景评估是否需要调整。
Q5:收到 moderation_blocked 后应该怎么处理?
建议停止自动重试,向用户展示清晰的修改提示,并在日志中记录可用的审核阶段和类别。想快速验证这条错误处理链路,可以在 API易 apiyi.com 注册并获取测试额度,把本文示例中的模型名替换为平台当前可用的模型后运行。
Q6:如何在不同图像模型之间比较审核差异?
建议准备一组符合政策、贴近业务且边界清晰的测试提示词,分别记录生成结果、拦截情况和错误字段。通过 API易 apiyi.com 的统一接口可以减少切换模型时的代码改动,但测试结果只适用于你的样本,不应推广成模型的总体安全结论。
AI 动图审核核心要点 Key Takeaways
- 核心难点:违规含义可能存在于动作过程和帧间关系中。
- 官方措施:在多层审核基础上,联合审核帧网格与生成说明。
- 关键数字:77.66% 是 310 个违规 GIF 样本上的召回率。
- 常见误读:该数字不是线上违规率、总体准确率或正常内容通过率。
- 评估方法:模型自身安全、审核拦截和最终未拦截结果要分开看。
- 数据缺口:GIF 误报率、审核延迟和第三方复测目前都缺少可靠公开数据。
- 落地动作:以
error.code处理拦截,可通过 API易 apiyi.com 验证调用流程。
总结
AI 动图不仅增加了生成维度,也给内容安全判断增加了时间维度。审核系统不能只看“画面里有什么”,还要判断“这些画面连起来在表达什么”。
OpenAI 的帧网格联合审核和 310 个 GIF 样本的测试结果,体现了这一思路,也说明动作类风险仍未完全解决。在误报率和第三方复测缺位的情况下,开发者和平台更应该关注测试范围,并为拦截、误拦和漏检都设计好处理路径。
如果你正在把图像生成接入产品,可以通过 API易 apiyi.com 先用免费额度验证接口调用和错误处理,再结合平台文档确认具体模型与参数的支持情况。
📚 参考资料
- OpenAI:ChatGPT Images 2.6 System Card:多层审核与 GIF 风险的主要来源
- 链接:
deploymentsafety.openai.com/chatgpt-images-2-6 -
说明: 重点查看 3.1、3.2.1、3.2.2 和第 4 节
-
OpenAI:System Card PDF:310 个 GIF 样本测试数据的出处
- 链接:
deploymentsafety.openai.com/chatgpt-images-2-6/chatgpt-images-2-6.pdf -
说明: 适合核对本文引用的评估数字和测试范围
-
OpenAI API:Image generation 文档:开发者接口说明
- 链接:
developers.openai.com/api/docs/guides/image-generation -
说明: 包含 GIF 参数、
moderation参数和审核错误处理建议 -
OpenAI:Introducing Images 2.6:官方发布公告
- 链接:
openai.com/index/introducing-images-2-6 - 说明: 用于了解 GIF 功能的发布背景和产品范围
作者:API易 技术团队
技术交流:欢迎在 API易 apiyi.com 网站首页联系我们,更多资料可访问 docs.apiyi.com 文档中心