作者注:基于官方展示、智东西与 TOKRACE 第三方实测,拆解 LongCat-2.5 在截图转网页、交互页面和 3D 生成上的真实能力、典型失败案例与验收边界。
美团于 2026-11-02 正式发布 LongCat-2.5,官方把 Visual Coding(视觉编程) 作为重点能力之一,并展示了实时流体模拟、三星堆青铜神树三维展示、照片生成活动邀请页等案例。很多前端开发者看到后,第一个问题是:把一张设计稿或网页截图丢给它,能不能直接拿到一个可交付的网页?
这不是一篇复述官方宣传的文章。官方展示是挑选过的成功案例,第三方实测里则同时出现了完成度很高的作品和尺寸错 1000 倍的工程。本文把这两类证据放在一起对照,并说明哪些结论有证据支撑、哪些目前还没有。
核心价值:读完本文,你会知道 LongCat-2.5 的视觉编程能做到什么程度,网页交付时应该从哪五个维度验收,以及哪些环节必须由人复核。
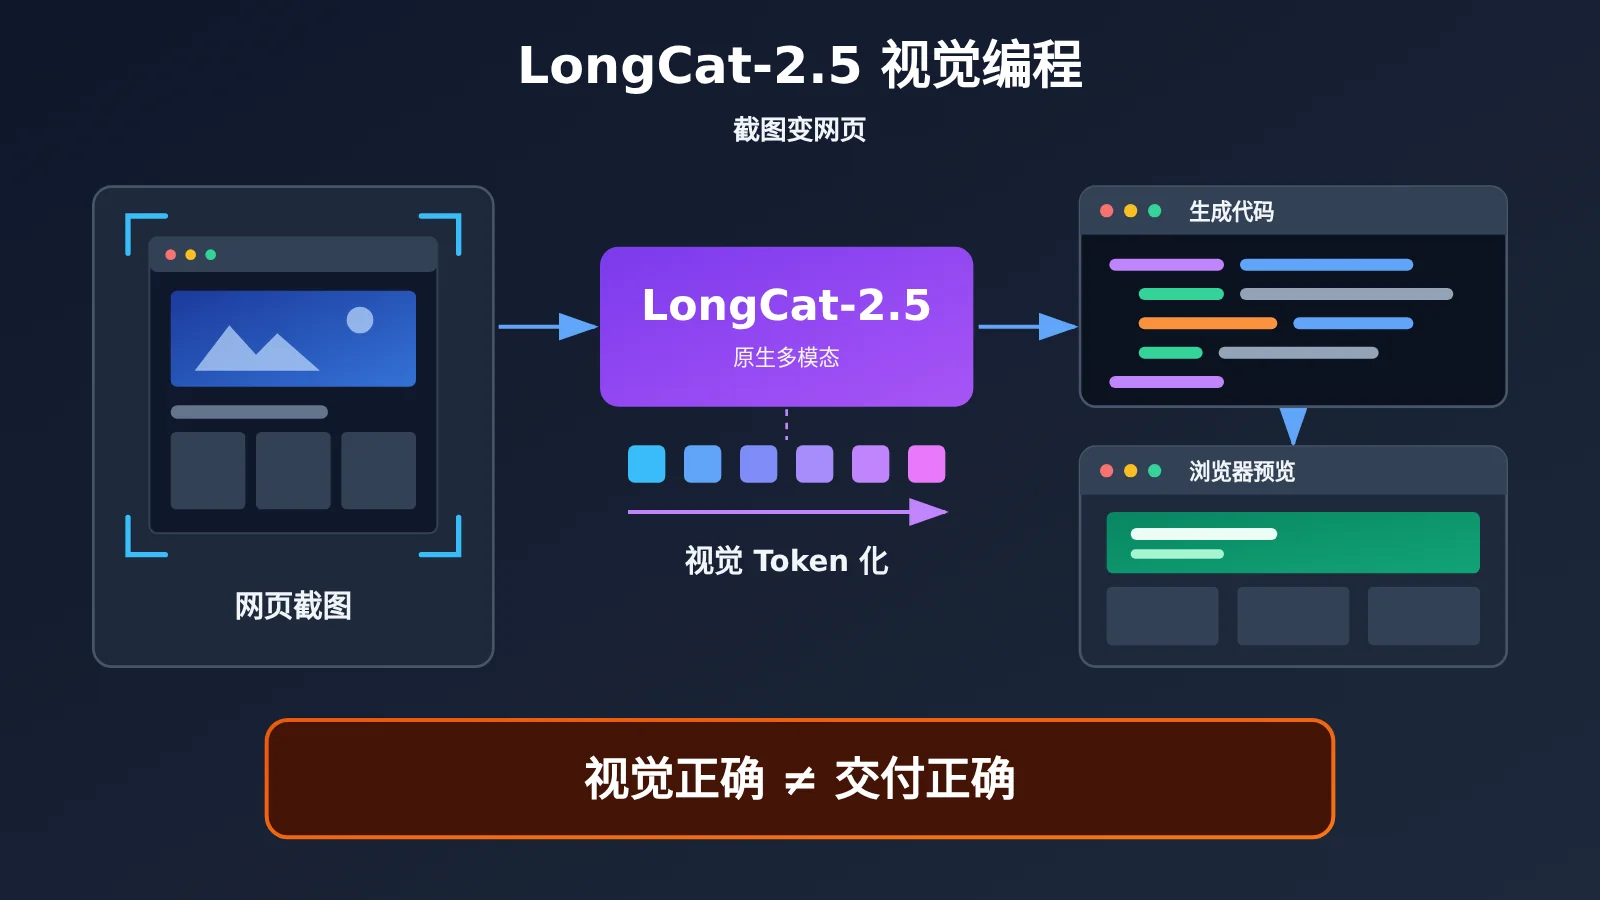
LongCat-2.5 视觉编程核心信息速览
先把和视觉编程相关的公开事实整理成一张表。下面的信息来自美团官方技术博客、API 文档和发布报道,模型权重在发布时尚未开放下载,所以“官方 API 已开放”不等于“已经开源”。
| 信息项 | 已公开内容 |
|---|---|
| 正式发布时间 | 2026-11-02(Preview 版于 2026-09-25 上线 API 平台) |
| 发布方 | 美团 LongCat 团队 |
| 模型规模 | 总参数 1.6T,每 Token 激活约 48B,稀疏 MoE 架构 |
| 上下文窗口 | 1,048,576 Tokens(约 1M) |
| 视觉输入 | 图片支持 PNG、JPG、JPEG、WebP、GIF;视频通过 URL 输入 |
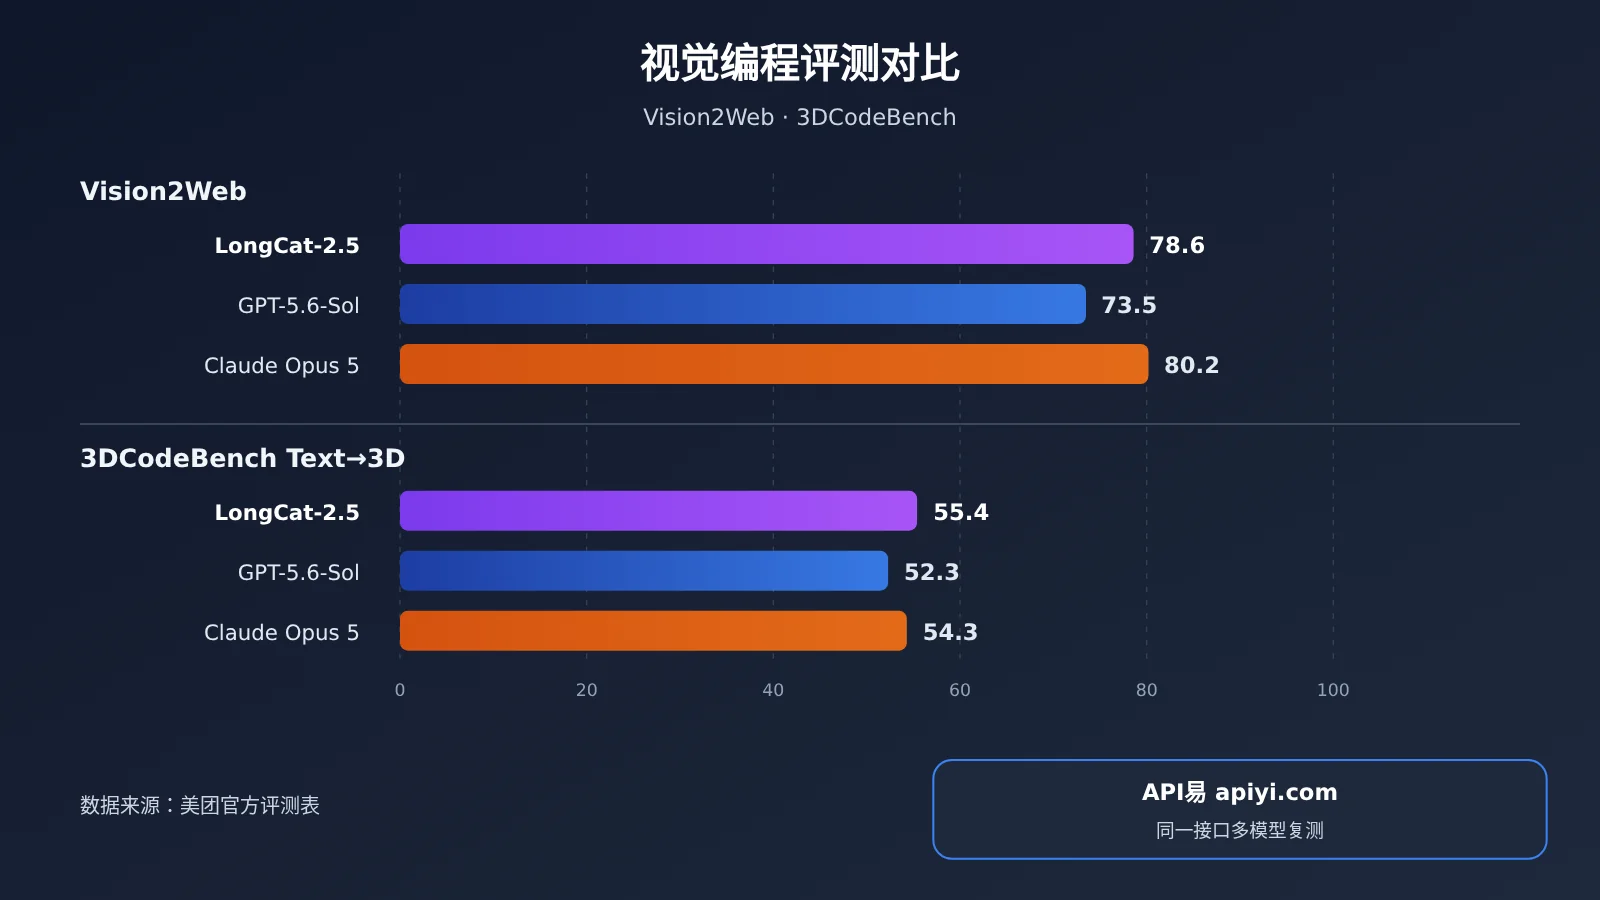
| 视觉编程相关成绩 | Vision2Web 78.6、3DCodeBench Text→3D 55.4(官方表格) |
| 接口形式 | OpenAI 兼容与 Anthropic 兼容两种格式 |
| 开源状态 | 正式版权重发布时未开放,官方称后续上线 |
需要特别注意的一点是:官方文档支持的是图像和视频理解,并不代表 LongCat-2.5 提供图片生成或视频生成接口。第三方测试中出现的图片和视频,都是模型写代码后由 Blender、浏览器等工具渲染出来的。
截图复刻与视觉参考生成网页不是一回事
讨论“截图变网页”之前,必须先把两类任务分开。第一类是视觉参考生成:给一张场地照片或氛围图,再加一段文字需求,让模型设计一个风格匹配的网页。这类任务允许模型自由发挥布局,只要“看起来对味”就算成功。
第二类是严格截图复刻:给一张现成网页截图,要求在布局、间距、字体、交互和响应式表现上尽量一致。这类任务的验收标准硬得多,任何偏移都会被看出来。官方的活动邀请页案例属于前者,目前没有足够的独立样本证明 LongCat-2.5 在后者上的通用还原准确率,更不能说它已经能做到像素级复刻。
LongCat-2.5 视觉 Token 机制简述
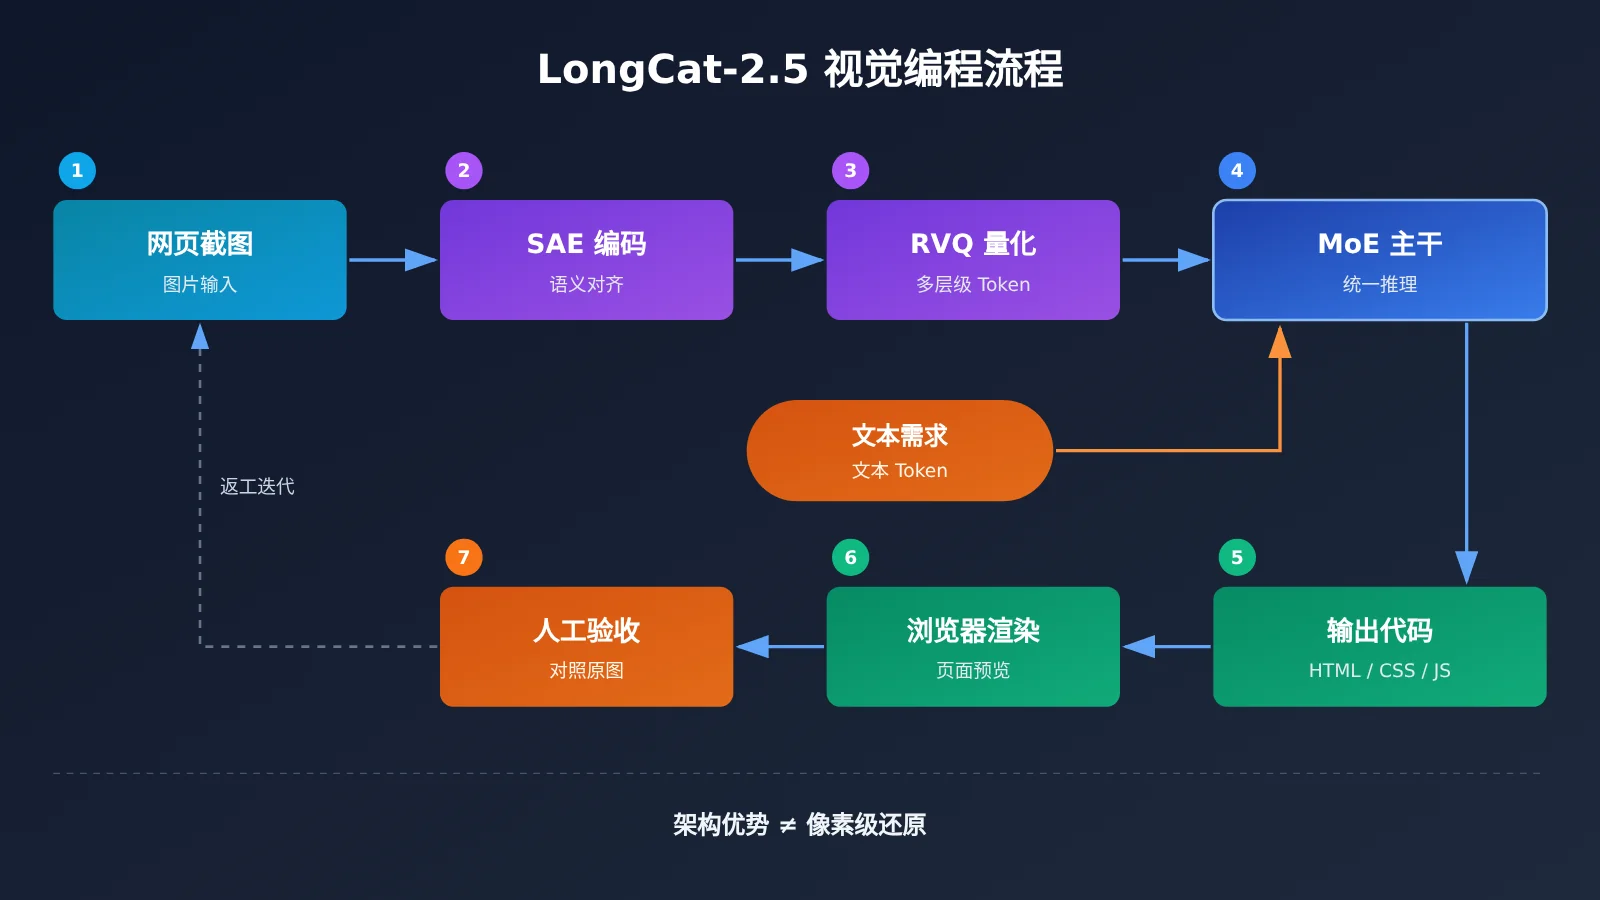
LongCat-2.5 的“原生多模态”来自它处理图片的方式。官方披露,模型先用 SAE(语义对齐编码器)提取视觉特征,再通过 RVQ(残差向量量化)把特征编码成多层级离散 Token,最后与文本 Token 一起进入主干模型统一处理。
这套设计还包括原生分辨率视觉离散化、视觉 Token 离线预计算,以及视觉码本 Embedding 与主干模型联合学习。对开发者来说,可以把它理解为:图片不是被“翻译成一段文字描述”再交给模型,而是以接近原生的形式参与推理和写代码。不过,架构上的优势只是能力基础,并不等于每张截图都能被准确还原。
LongCat-2.5 Vision2Web 成绩怎么看
官方公布了两项和视觉编程直接相关的 Benchmark。数据全部来自美团发布的评测表,比较对象只有表内两款模型,不覆盖截至 2026-11-03 的全部最新模型。
| 评测项目 | LongCat-2.5 | GPT-5.6-Sol | Claude Opus 5 | 评测说明 |
|---|---|---|---|---|
| Vision2Web | 78.6 | 73.5 | 80.2 | Claude Code v2.1.7、256K 序列长度、top_k=50 |
| 3DCodeBench Text→3D | 55.4 | 52.3 | 54.3 | 文本生成 3D 代码 |
| DeepSWE v1.1(参照) | 64.6 | 72.7 | 68.8 | 真实仓库问题修复,mini-swe-agent |
从数字看,LongCat-2.5 在 Text→3D 上处于官方比较表的领先位置;Vision2Web 比 GPT-5.6-Sol 高 5.1 分,但比 Claude Opus 5 低 1.6 分。把 DeepSWE 放进来作为参照很有必要:视觉编程最终仍要落到工程代码上,而 LongCat-2.5 在真实软件仓库问题修复上和 GPT-5.6-Sol 还有 8.1 分的差距。
更重要的是,Benchmark 分数不等于像素级还原率,也不等于产品验收通过率。LongCat-2.5 的默认评测设置是开启思考、temperature=1.0、top_p=0.95,不同模型的部分成绩来自公开报告、部分由美团自测,测试条件并不完全统一。
💡 选择建议:公开榜单只能当作参考,真正有意义的是在你自己的截图和需求上跑一遍。通过 API易 apiyi.com 这样的 OpenAI 兼容聚合接口,可以用同一份测试脚本对比多个视觉模型的输出,再决定主力模型。
LongCat-2.5 视觉编程案例对照:成功与失败
下面把三类来源的案例放在一起。官方展示是经过选取的成功案例,智东西和 TOKRACE 是第三方小样本测试,三者的证据强度不同,阅读时请注意区分。
| 来源 | 任务 | 实际要求 | 观察结果 |
|---|---|---|---|
| 官方展示 | 实时流体模拟 | 交互式流体网页 | 鼠标点击、拖动可触发流体效果 |
| 官方展示 | 活动邀请网页 | 场地照片 + 自然语言需求 | 风格匹配,含报名表单、名单管理与导出 |
| 智东西 | 鹈鹕骑自行车动画 | HTML 动画 | 主体清晰、风格一致,围巾局部位置偏差 |
| TOKRACE | 中文活动海报 SVG | 保留 6 段指定中文 | 6 段均正确且各出现一次,排版清晰 |
| TOKRACE | 季度数据图表 SVG | 按数据画柱状图 | 比例与汇总值 84 正确,但编造了财年、美元单位和数据来源 |
| TOKRACE | 行星减速器 3D | 140mm 尺寸及视频交付 | 齿面破碎,写成 140m,视频未交付 |
| TOKRACE | 两居室空间模型 | 室内布局建模 | 门窗未开洞、床与隔墙重叠、次卧方位错误 |
官方展示:视觉参考 + 交互逻辑的成功样本
官方博客共列出八项端到端任务,和网页直接相关的有流体模拟、三星堆青铜神树三维展示、城市沙盘、中国风视觉设计和活动邀请网页。三星堆案例需要同时处理三维结构、材质和旋转缩放交互,活动邀请页则需要把照片氛围转成页面风格,并实现报名、名单管理和表格导出。
这些案例能证明 LongCat-2.5 具备把视觉要求转成可运行前端代码的能力。但它们不能证明“所有交互式网页都能一次完成”,也不能说明页面性能已经达到商业上线标准。
智东西实测:整体完成度高,局部细节仍需修
智东西在 2026-11-02 让 LongCat-2.5 生成鹈鹕骑自行车的 HTML 动画。记者观察到动画整体完成度较高、主体清晰、风格统一、细节丰富,但围巾的局部位置略有偏差。
另一项亚马逊第三季度财报 PPT 任务里,分析框架完整,有趋势图、结构图和风险提示,记者初步比对未发现明显数据错误。问题集中在呈现层:部分页面信息密度偏高、字号偏小,个别结论表达过于绝对。这对网页开发同样有启示,内容基本正确不代表可读性和布局合格。
TOKRACE 实测:约束越明确,成功率越高
TOKRACE 把 LongCat-2.5 接入 Claude Code,配合 Blender 和浏览器完成 15 项创作任务,其中 6 项 3D、4 项知识视频、4 项静态 SVG、1 项动画。成功案例有一个共同特征:约束清晰、结构简单。
- 参数化书架:0.8m 三格版和 1.0m 四格版尺寸正确,18mm 板厚符合要求,六张视角图交付完整,耗时约 36 分钟、47 次请求、输出 69,708 Token。
- 中文活动海报:约 3 分钟、10 次请求完成,六段中文全部正确保留,图标没有挤压正文。
- 4 秒骑行动画:轮子、脚踏和双腿同步,测试方抽查 40 个时点,脚端与脚踏最大偏差约 0.19px,但浅色主体对比度偏低。
失败案例则暴露了视觉编程最容易忽视的问题。行星减速器任务中,三颗行星轮位置基本正确,但 140mm 被写成 140m,出现 1000 倍单位错误,要求的视频也没有交付;两居室模型“看上去像个客厅”,却存在门窗未开洞、床与隔墙重叠、部分机位被墙体遮挡等结构错误。钟表 SVG 的 9:41 指针角度正确,数字却和粗刻度重叠。
TOKRACE 还做了思考模式对照:开启思考后部分画面排版更清晰,但推理和请求成本可能明显增加;在鹈鹕骑车 SVG 对照中,关闭思考首次请求就成图,开启思考到第 5 次请求才成图。这只是单个任务的观察,不能推导出开关思考的平均成功率。
LongCat-2.5 视觉编程的五个验收维度
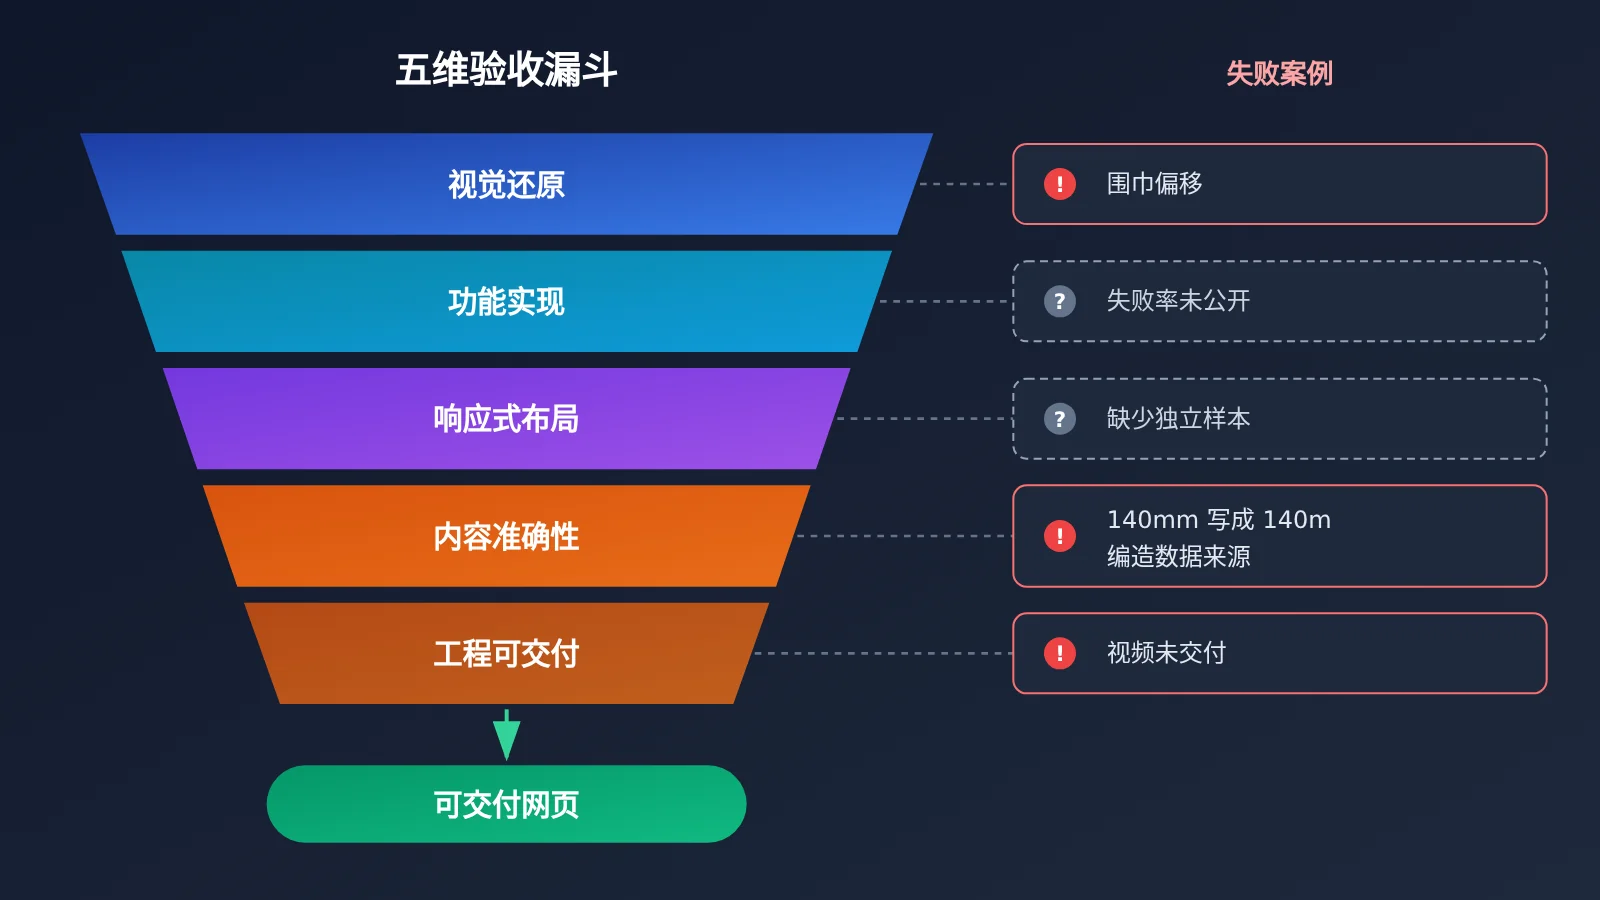
从上面的案例可以看出,“看起来对”和“能交付”之间至少隔着四道关。下面这套验收框架是根据案例整理的工程检查方法,不是 LongCat 官方的评测标准。
| 验收维度 | 检查内容 | 案例中暴露的风险 | 建议检查方式 |
|---|---|---|---|
| 视觉还原 | 配色、布局、字体、间距、图形 | 围巾偏移、数字与刻度重叠 | 与原图叠加对比,逐区域截图核对 |
| 功能实现 | 点击、导航、表单、状态变化 | 官方展示未公开失败率 | 手动走一遍主流程,写简单 E2E 测试 |
| 响应式布局 | 不同屏宽下是否溢出、遮挡 | 目前缺少独立样本 | 至少检查手机、平板、桌面三个断点 |
| 内容准确性 | 数字、单位、文案、来源 | 编造财年和数据来源、140mm 写成 140m | 逐项核对所有文字和单位 |
| 工程可交付 | 依赖安装、运行、打包、文件齐全 | 视频未交付、长任务超时中断 | 按交付清单逐项勾选 |
这五个维度里,最容易被 AI 生成结果“骗过去”的是内容准确性和工程可交付。一个页面配色漂亮、动画流畅,很容易让人忽略里面多出来的一个虚构数据来源,或者少交的一个文件。截图转网页时,建议把“模型额外添加了什么”单独列为一个检查项。
如何用 API 测试 LongCat-2.5 截图转网页
如果你想在自己的设计稿上验证 LongCat-2.5,可以用 OpenAI 兼容格式发送“图片 + 文字需求”。图片支持 Base64 和公开 URL,单张最大 10MB,单次请求最多 50 张,原始宽高比超过 200:1 会报错,长截图需要先切分。
需要说明的是,截至本文核查日期(2026-11-03),尚未确认 API易 平台已上线 LongCat-2.5,模型是否可用请以 API易 模型列表为准。下面的脚本采用标准 OpenAI 格式,同一份代码也可以先接入平台上已有的视觉模型跑通流程,模型上线后只需替换模型名。
极简示例
import base64, openai

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")
img = base64.b64encode(open("screenshot.png", "rb").read()).decode()

resp = client.chat.completions.create(
    model="LongCat-2.5",  # 以 API易 模型列表中的实际名称为准
    messages=[{"role": "user", "content": [
        {"type": "text", "text": "按截图复刻为单文件 HTML,只用截图中出现的文字,不要补充任何数据"},
        {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{img}"}}
    ]}],
)
print(resp.choices[0].message.content)
查看完整实现代码(含验收约束与重试)
import base64
import time
import openai
from pathlib import Path

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

SYSTEM_PROMPT = """你是前端工程师。根据截图生成单文件 HTML(内联 CSS/JS)。
硬性要求:
1. 只使用截图中可见的文字,禁止补充数据、单位、来源或年份
2. 无法辨认的文字用 [待确认] 占位
3. 支持 375px / 768px / 1440px 三个断点
4. 代码末尾用注释列出:你做的假设、未实现的交互"""

def encode_image(path: str) -> str:
    data = Path(path).read_bytes()
    if len(data) > 10 * 1024 * 1024:
        raise ValueError("单张图片超过 10MB,请压缩后再试")
    return base64.b64encode(data).decode()

def screenshot_to_html(path: str, model: str = "LongCat-2.5",
                       retries: int = 3) -> str:
    img = encode_image(path)
    messages = [
        {"role": "system", "content": SYSTEM_PROMPT},
        {"role": "user", "content": [
            {"type": "text", "text": "请复刻这张网页截图。"},
            {"type": "image_url",
             "image_url": {"url": f"data:image/png;base64,{img}"}},
        ]},
    ]
    for i in range(retries):
        try:
            resp = client.chat.completions.create(
                model=model, messages=messages, max_tokens=16000
            )
            return resp.choices[0].message.content
        except openai.RateLimitError:
            time.sleep(2 ** i)  # 429 限流时指数退避
    raise RuntimeError("多次重试失败")

if __name__ == "__main__":
    html = screenshot_to_html("screenshot.png")
    Path("output.html").write_text(html, encoding="utf-8")
    print("已生成 output.html,请按五维清单验收")
代码里有两处设计值得说明。一是在系统提示词中明确禁止补充数据、单位和来源,这是针对 TOKRACE 图表案例中“编造财年和数据来源”问题的直接防护;二是要求模型在代码末尾列出自己的假设,便于人工复核时快速定位“猜”出来的部分。思考模式的具体请求结构,请以 LongCat 官方参数文档为准,不要直接套用其他模型的 reasoning 参数。
🚀 快速上手:建议先通过 API易 apiyi.com 领取新用户免费测试额度,用 3-5 张不同复杂度的截图(落地页、表单页、数据看板)跑一遍完整流程,按五维清单打分后再决定是否纳入正式工作流。
LongCat-2.5 视觉编程影响分析
对前端开发者的影响
- 原型阶段提效明显:从视觉参考快速生成可交互页面,适合做方案演示、活动页初稿和内部工具,官方活动邀请页和 TOKRACE 海报案例都属于这一类。
- 验收工作量不会消失:模型能写出“看起来对”的页面,但单位、文案、结构关系的错误更隐蔽,开发者的角色会从“写代码”部分转向“定约束和做验收”。
- 约束写得越清楚越好:书架案例给出明确尺寸和交付清单后表现良好,模糊需求则更容易出现自由发挥。
对 AI Coding 工作流的影响
LongCat-2.5 官方文档提供了 Claude Code、Codex、OpenCode、Cline 等工具的接入指南,通常只需改 Base URL、API Key 和模型名。这意味着视觉编程可以被放进已有的 Agent 工作流,而不是单独开一个聊天窗口。不过兼容 API 格式不代表所有工具功能和参数都完全一致,长任务还可能出现超时或中断,TOKRACE 的部分视频任务就因此没有完成。
成本方面,官方当前标注的限时优惠价为未命中缓存输入 ¥2.00、命中缓存输入 ¥0.04、输出 ¥8.00(每百万 Token),实际以官方平台和账单为准。书架这类多轮任务输出接近 7 万 Token,在规划视觉编程批量任务时,请求次数和输出长度比单价更值得关注。
LongCat-2.5 截图转网页的使用边界
结合全部证据,可以把使用场景分成三档:
| 档位 | 典型场景 | 建议做法 |
|---|---|---|
| 可以直接用 | 活动页初稿、SVG 海报、简单交互动画、内部演示页 | 生成后做视觉和文案检查即可 |
| 需要人工复核 | 截图复刻上线页面、数据图表、响应式落地页、多步骤表单 | 按五维清单逐项验收,重点核对数据与单位 |
| 不建议依赖 | 高精度工程尺寸、空间结构设计、需要像素级还原的品牌页、无人值守长任务 | 只用于草稿,最终交付由人完成 |
💰 成本建议:视觉编程往往需要多轮迭代,建议先用小批量截图测算单页面平均 Token 消耗。API易 apiyi.com 按量计费、提供统一账单,便于在多个模型之间横向比较单页面成本。
常见问题 FAQ
Q1:LongCat-2.5 能把一张截图直接变成完整网页吗?
能生成可运行的网页,但“完整可交付”需要打折扣。官方展示和第三方测试证明它能把视觉参考转成带交互的前端代码,但目前没有独立样本证明其截图复刻的通用准确率,也不能宣称已实现像素级还原。
Q2:LongCat-2.5 的 Vision2Web 成绩和 Claude Opus 5 比怎么样?
官方表格中 LongCat-2.5 为 78.6,Claude Opus 5 为 80.2,GPT-5.6-Sol 为 73.5。LongCat-2.5 在 Text→3D 上领先,但 Vision2Web 仍略低于 Claude Opus 5。这些都是美团公布的数据,测试条件不完全统一,建议用自己的任务复测。
Q3:LongCat-2.5 视觉编程最常见的失败是什么?
从 TOKRACE 测试看,主要有四类:单位错误(140mm 写成 140m)、空间结构错误(床与隔墙重叠)、编造内容(图表中添加不存在的数据来源)、交付不完整(要求的视频未生成)。这些问题在视觉上往往不明显,必须专门检查。
Q4:可以通过 API易 调用 LongCat-2.5 吗?
截至 2026-11-03,尚未确认 API易 平台已接入 LongCat-2.5,请以 API易 apiyi.com 的实时模型列表为准。你可以先用本文的 OpenAI 兼容脚本接入平台已有的视觉模型跑通验收流程,模型上线后替换模型名即可。
Q5:做截图转网页时开启思考模式更好吗?
没有统一结论。TOKRACE 观察到开启思考后部分排版更清晰,但成本可能明显增加,鹈鹕 SVG 对照中关闭思考反而首次成图。建议在 API易 apiyi.com 上用同一批截图分别测试,用实际成功率和 Token 消耗来决定。
Q6:LongCat-2.5 能生成图片或视频吗?
官方 API 支持的是图片和视频理解,不是生成。第三方测试中的图片、视频和 3D 画面,都是模型写代码后由浏览器、Blender 等工具渲染出来的,不能视为模型原生的图像生成能力。
LongCat-2.5 视觉编程核心要点 Key Takeaways
- 能力定位:LongCat-2.5 能把视觉参考转成可运行网页代码,但不等于像素级截图复刻。
- 官方成绩:Vision2Web 78.6,略低于 Claude Opus 5;Text→3D 55.4,在官方比较表中领先。
- 成功规律:约束明确、结构简单的任务完成度高,如海报 SVG 和参数化书架。
- 失败规律:单位、空间关系、虚构内容和交付完整性是主要风险点。
- 验收方法:从视觉还原、功能、响应式、内容准确性、工程可交付五个维度逐项检查。
- 上手方式:可在 API易 apiyi.com 用 OpenAI 兼容脚本搭建测试流程,LongCat-2.5 可用性以模型列表为准。
总结
LongCat-2.5 截图转网页能力的核心结论:
- 能做原型,不等于能直接交付:官方案例和第三方测试都证明了视觉编程能力,但截图到上线页面之间仍有明显差距。
- 视觉正确只是第一关:交互、响应式、内容准确性和工程完整性需要单独验收,其中“模型额外添加了什么”最容易被忽略。
- 用约束换稳定性:明确尺寸、文案、断点和交付清单,并在提示词里禁止补充数据,能显著减少自由发挥带来的错误。
如果你打算把视觉编程纳入日常开发,建议先用自己的真实截图做一轮小样本测试,再按本文的三档边界划定使用范围。推荐通过 API易 apiyi.com 用统一接口对比多个视觉模型的实际表现,平台提供新用户免费额度,方便低成本验证。
📚 参考资料
- LongCat-2.5 官方技术博客:模型架构、Benchmark 与官方展示案例
- 链接:
longcat.ai/blog/longcat-2.5 -
说明:Vision2Web、3DCodeBench 成绩及评测条件的原始出处
-
美团技术团队博客:LongCat-2.5 视觉 Token 技术说明
- 链接:
tech.meituan.com/2026/11/02/Meituan-LongCat-2.5.html -
说明:SAE、RVQ 等视觉编码机制介绍
-
LongCat 视觉理解接口文档:图片与视频输入限制
- 链接:
longcat.ai/platform/docs/image-video-understanding -
说明:图片格式、大小、数量与宽高比限制
-
智东西实测报道:鹈鹕动画与财报 PPT 测试
- 链接:
tech.ifeng.com/c/8xjHpT7wJEN -
说明:媒体视角的正式版使用体验
-
TOKRACE 正式版测试:15 项创作任务案例记录
- 链接:
www.tokrace.com/zh-CN/guides/longcat-2-5-release - 说明:包含原始图片、工程与运行记录,成功与失败案例均有
作者:APIYI 技术团队
技术交流:欢迎访问 API易 apiyi.com 首页联系我们,更多接入资料可查阅 docs.apiyi.com 文档中心