作者注:基于官方披露信息解读 Astra for Law 的 2.3 亿 URL 法律搜索索引、测试成绩与 API 定价,厘清其专业能力的来源。
OpenAI 官方 API 定价页面新增了法律配置 gpt-6-astra-law,多家科技媒体于 2026 年 10 月 31 日关注到这一条目。与它一同受到关注的,还有 Astra for Law 超过 2.3 亿个 URL 的法律搜索索引。这引出一个核心问题:它的专业能力究竟来自模型,还是来自索引?
这不是小道消息,产品说明、索引规模和价格都能在 OpenAI 官方页面核实。但官方数据目前只能说明“完整配置优于通用配置”,还无法把提升幅度拆分到模型、索引或指令上。
核心价值:3 分钟了解 Astra for Law 的真实构成、关键数字的准确含义,以及开发者现阶段能做什么。
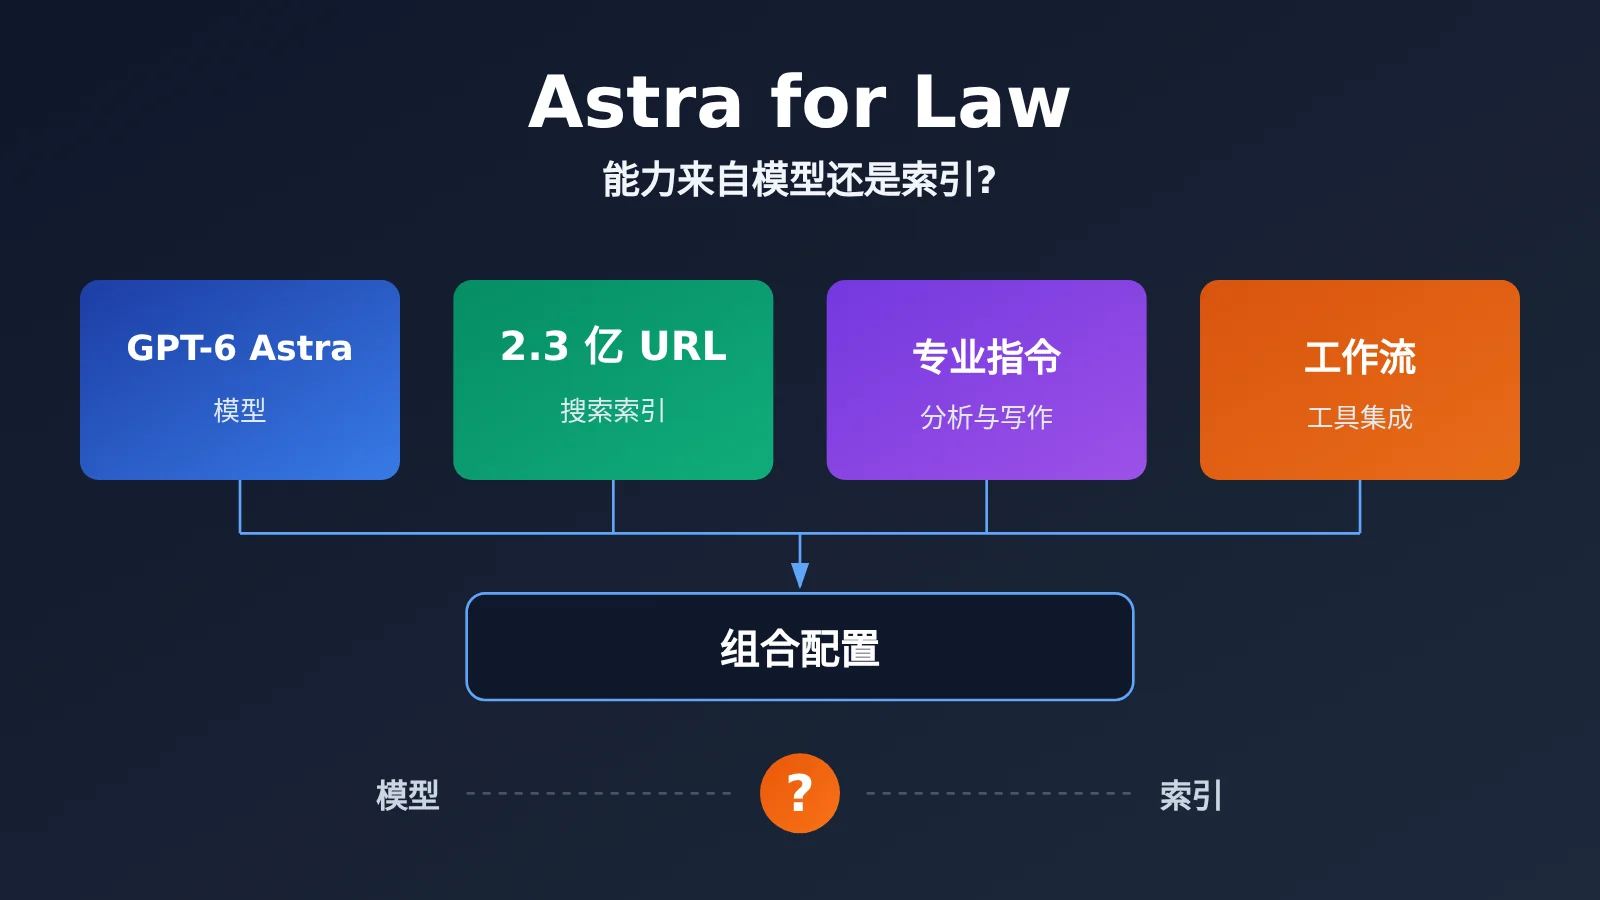
Astra for Law 2.3 亿 URL 核心信息速览
截至 2026 年 11 月 2 日,公开信息可以汇总如下。其中最容易被误读的是 API 状态:价格已经公开,但不等于所有开发者都能调用。
| 信息项 | 详情 |
|---|---|
| 发布时间 | 2026 年 9 月 17 日 |
| 发布方 | OpenAI |
| 产品定位 | 面向律师事务所和法律科技公司的专业 AI 基础平台 |
| 技术构成 | GPT-6 Astra、法律搜索索引、法律分析与写作指令、工具及工作流集成 |
| 索引规模 | 超过 2.3 亿个 URL,每日添加新来源 |
| 使用范围 | 初期通过 Trusted Access 面向符合资格的美国律师事务所 |
| API 状态 | 官方仍描述为未来开放,正式开放日期未公布 |
Astra for Law 的 2.3 亿 URL 法律搜索索引包含什么
这个索引覆盖美国判例法、成文法、行政法规、法院规则和行政裁决。OpenAI 还与非营利机构 Free Law Project 合作,把 CourtListener 的美国判例数据引入研究环境。
一个 URL 可能对应页面、文书、记录或其他法律资料,因此“2.3 亿 URL”不等于“2.3 亿份判决书”。下面几组数字的统计口径也不同,不能相减,也不能用来推算其他资料的数量。
| 数字 | 披露方 | 准确含义 | 不能理解为 |
|---|---|---|---|
| 超过 2.3 亿 URL | OpenAI | 完整法律搜索索引的规模 | 2.3 亿份独立判决书 |
| 超过 900 万条 | Free Law Project | CourtListener 的法律裁判记录 | OpenAI 索引的全部内容 |
| 超过 2000 个法院 | Free Law Project | CourtListener 的数据来源范围 | 全球法院覆盖 |
| 超过 99.9% | Free Law Project | 已发表美国先例性判例的覆盖率 | 全部法律资料的完整率 |
覆盖范围也有明确边界。该索引目前以美国法律材料为核心,尚无可信官方材料证明它对中国现行法律法规、裁判文书和司法解释有同等级的专用覆盖。
Astra for Law 的专业能力来自模型还是法律搜索索引
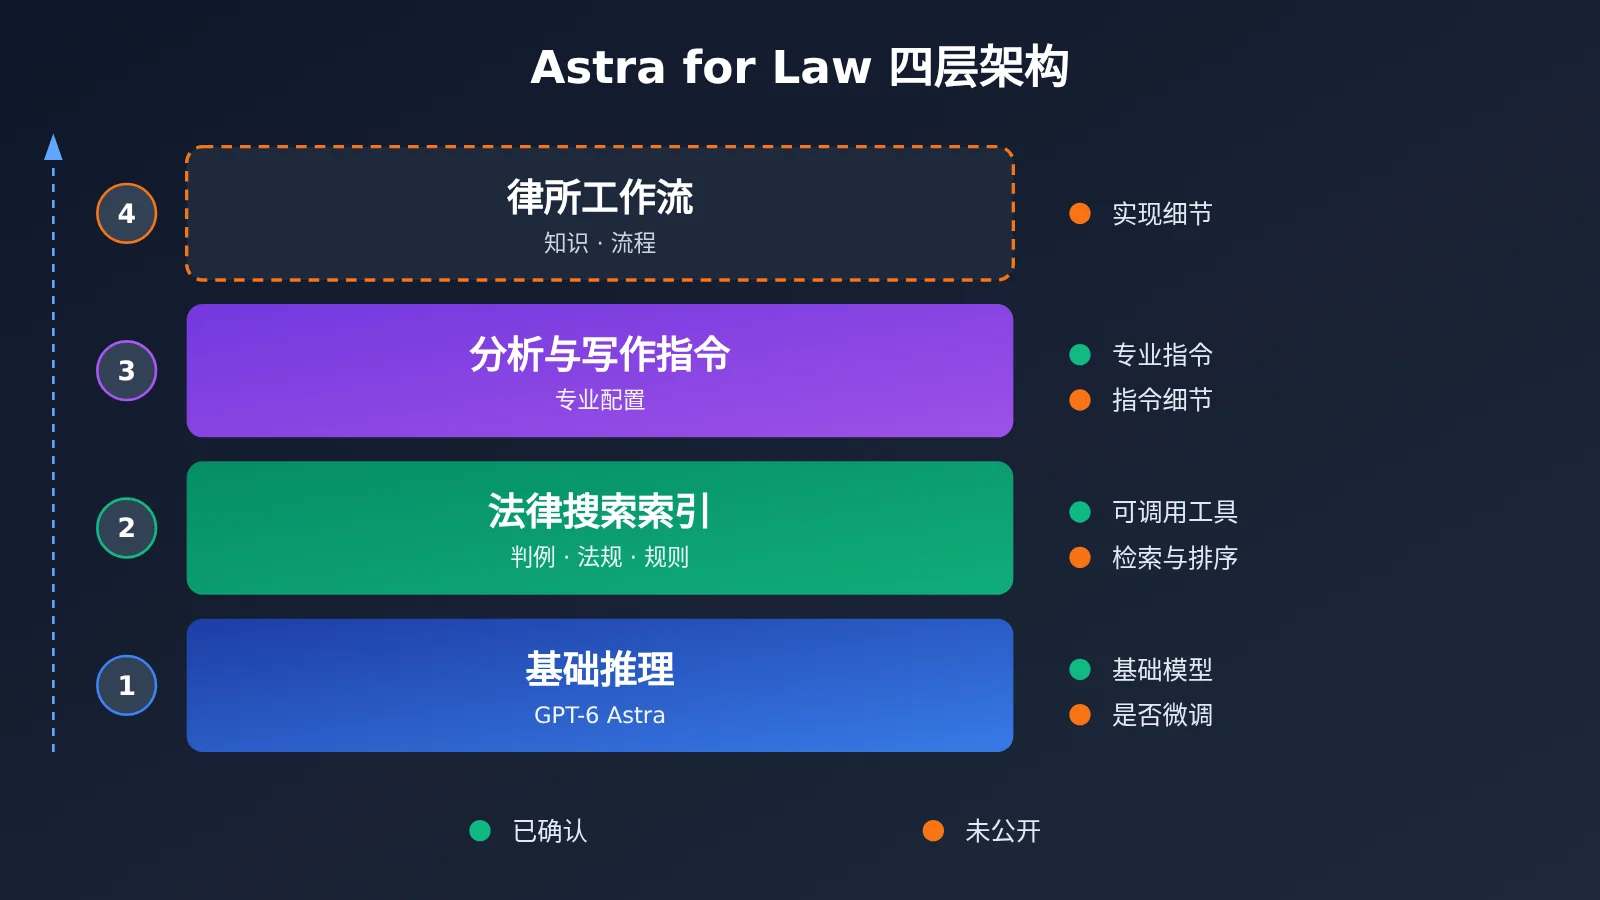
目前最准确的答案是:来自组合,而且现有数据无法精确拆分。 OpenAI 将 Astra for Law 定义为基于 GPT-6 Astra 的法律专业配置,并明确把法律搜索索引称为可调用的工具之一。公开说明强调的是配置、检索、工具和指令,但没有确认是否做过法律领域微调、蒸馏或独立参数训练。
最有力的数据来自 OpenAI 报告的一项测试。它使用 Vals AI Legal Research Bench 私有验证集中的 200 道美国法律研究题,在最高推理强度下比较两种配置。
| 对比指标 | Astra for Law | 通用 Astra + 网页搜索 | 差异 |
|---|---|---|---|
| 总体正确性检查通过率 | 54.0% | 38.7% | 提升 15.3 个百分点,相对提升约 40% |
| 判例法问题的参考判例数量 | 更多 | 基线 | 多 24% |
| 正确判决书中的相关段落(同等推理强度) | 更多 | 基线 | 最多增加 54% |
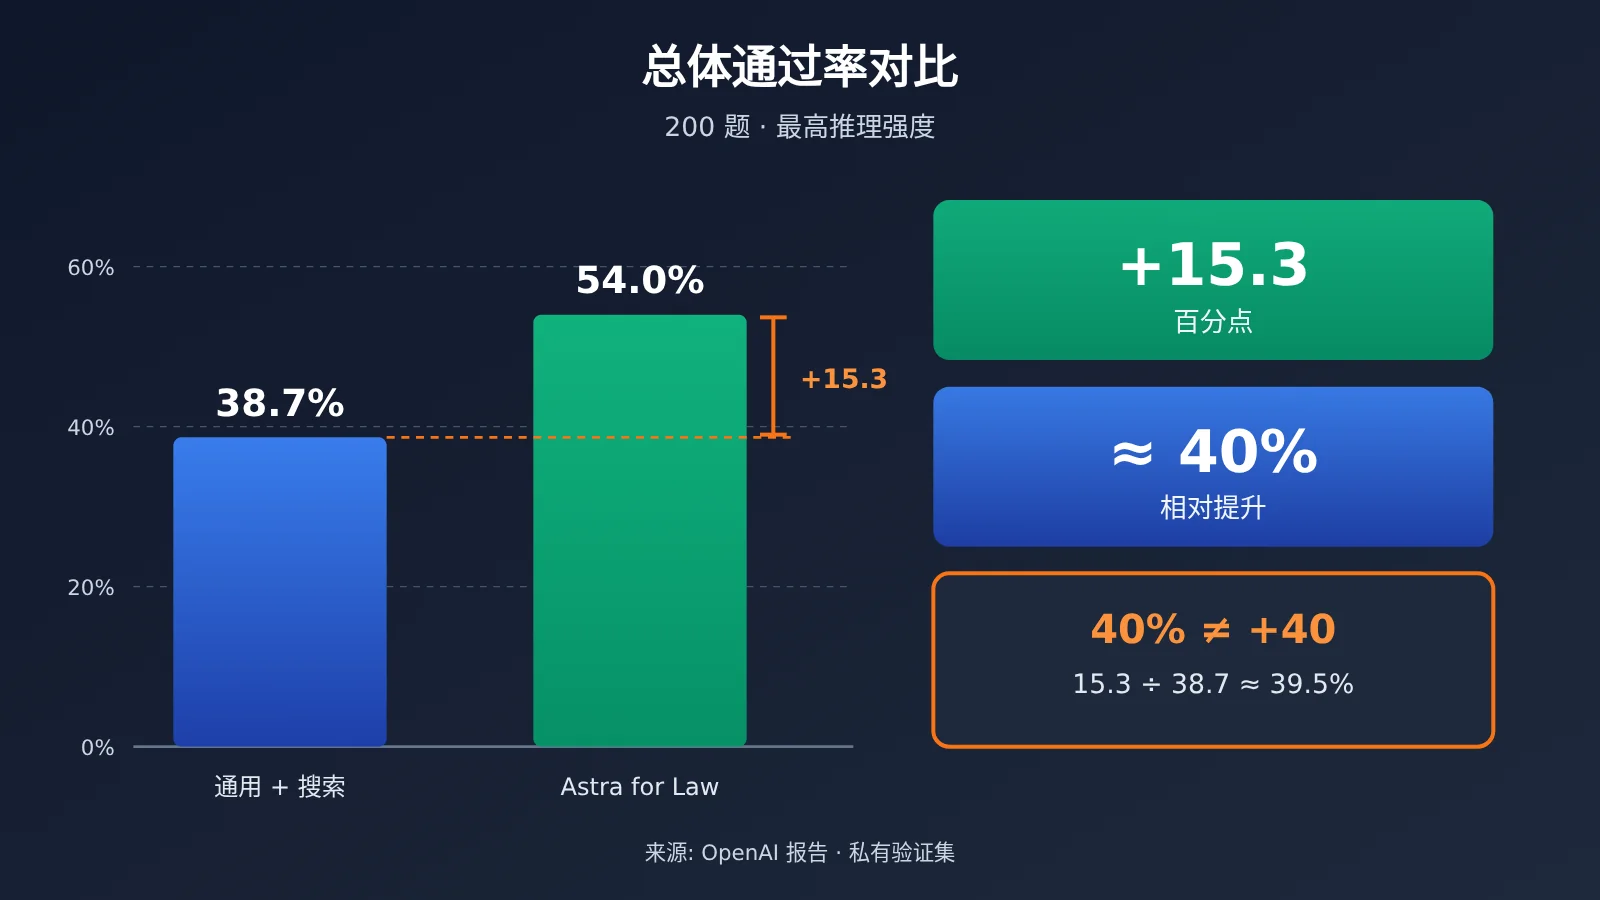
从这组结果可以得出三点判断:
- 基础模型仍是地基:查找资料后的理解、推理和生成都依赖 GPT-6 Astra,但这组测试没有单独测量模型本身的贡献。
- 检索指标提升明显:判例数量和相关段落指标都指向专用检索更强,但找到更多案例不等于法律意见一定更正确。
- 无法归因到单一组件:测试比较的是完整配置,索引、指令和其他设置同时发生变化,所以不能写成“法律索引单独提升了 40%”。
这项结果还有明确的使用边界。它是 OpenAI 使用私有验证集报告的成绩,不等于 Vals AI 独立复现,也不代表法律咨询、胜诉预测或合同审查的准确率就是 54%。公开榜单上的通用模型结果与这次测试配置不同,同样不能直接混合排名。
为什么法律搜索索引不能只靠网页搜索替代
法律研究要找的不只是语义相关的文本。法院层级、司法辖区、判例是否具有约束力、是否已被推翻或限制适用,都会影响一份依据的实际价值。同一个合同争议,在不同州的法律体系下也可能得出不同结论。
普通搜索可以找到相关内容,却不能保证引用的法律权威真正适用。这正是专用法律索引和专业指令要共同解决的问题,不过也不能据此认为所有引用都已自动通过有效性验证。
🎯 技术建议:如果你在做垂直领域知识库,可以先用同一组题目比较“仅模型”“模型 + 通用搜索”“模型 + 专用知识库”三种配置。通过 API易 apiyi.com 的统一接口切换模型,能减少重复对接的工作量。
Astra for Law 与传统 RAG 架构有什么关系
传统 RAG 的流程是:用户提问、查询知识库、取回相关片段,再由模型结合上下文生成回答。Astra for Law 在思路上与之相近,都不只依赖模型参数中的知识。但这只是思想层面的相似,不能把常见 RAG 方案直接当成它的内部实现。
| 技术问题 | 公开状态 | 正确写法 |
|---|---|---|
| 是否使用法律搜索索引 | 已确认 | 属于 Astra for Law 可调用的工具 |
| 索引内容类型 | 已确认 | 判例法、成文法、法规、法院规则、行政裁决 |
| 向量或混合检索方式 | 未公开 | 不应断言具体方案 |
| Embedding 与 Reranking | 未公开 | 不应推测具体模型或算法 |
| 切块策略与召回数量 | 未公开 | 不应套用通用参数 |
| 权威性排序实现 | 未公开 | 只能描述目标,不能描述实现 |
OpenAI 的通用 File Search 确实采用向量存储,并结合语义搜索与关键词搜索。但目前没有公开信息确认它和法律索引使用同一底层实现,因此其参数不能直接套用到法律版。
用 RAG 思路复现法律研究的基本模式
下面的示例不会调用 gpt-6-astra-law,也无法复现 Legal Search Index。它只演示“检索依据、限定来源、要求引用”这一通用模式,模型名称请以实际可用列表为准。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

context = "[DOC-1] 示例资料:此处放入检索到的法律片段"
response = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[
        {"role": "system", "content": "仅依据给定资料回答,并标注来源编号。资料不足时明确说明。"},
        {"role": "user", "content": f"资料:{context}\n问题:该条款有哪些风险?"}
    ]
)
print(response.choices[0].message.content)
查看带元数据过滤的完整示例
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 以下均为虚构演示数据,不是真实法律资料
DOCS = [
    {
        "id": "DOC-1",
        "title": "示例判决 A",
        "jurisdiction": "示例州",
        "year": 2024,
        "text": "示例内容:合同终止条款需要事先书面通知。"
    },
    {
        "id": "DOC-2",
        "title": "示例判决 B",
        "jurisdiction": "其他州",
        "year": 2023,
        "text": "示例内容:合同终止通知可以采用电子方式。"
    }
]


def retrieve(keywords, jurisdiction, top_k=3):
    """按司法辖区过滤,再按关键词命中数和年份排序"""
    candidates = [d for d in DOCS if d["jurisdiction"] == jurisdiction]
    scored = []
    for doc in candidates:
        score = sum(keyword in doc["text"] for keyword in keywords)
        if score > 0:
            scored.append((score, doc["year"], doc))
    scored.sort(key=lambda item: (item[0], item[1]), reverse=True)
    return [item[2] for item in scored[:top_k]]


def answer(question, keywords, jurisdiction):
    docs = retrieve(keywords, jurisdiction)
    if not docs:
        return "未检索到符合司法辖区要求的资料,请人工复核。"

    context = "\n".join(
        f"[{d['id']}] {d['title']}({d['jurisdiction']},{d['year']}):{d['text']}"
        for d in docs
    )
    response = client.chat.completions.create(
        model="gpt-6.1-sol",  # 以平台实际可用模型为准
        messages=[
            {
                "role": "system",
                "content": (
                    "你是法律研究助手。仅依据给定资料回答,并标注来源编号。"
                    "指出不确定性和缺失信息。输出仅供专业人员复核,不构成法律意见。"
                )
            },
            {
                "role": "user",
                "content": f"资料:\n{context}\n\n问题:{question}"
            }
        ]
    )
    return response.choices[0].message.content


print(answer("终止合同是否需要书面通知?", ["合同", "通知"], "示例州"))
建议:可以通过 API易 apiyi.com 获取免费测试额度,用自己的题集验证不同模型的表现。评估时建议同时记录引用是否准确、依据是否适用,而不只看回答读起来是否流畅。
Astra for Law API 定价对开发者的影响
定价条目透露出一个重要信号:gpt-6-astra-law 与通用 gpt-6-astra 的基础 Token 单价相同,目前没有额外溢价。以下为官方定价页列出的标准模式费率,促销价格至少持续到 2026 年 12 月 31 日。
| 模型 | 输入 / 百万 Token | 缓存输入 / 百万 Token | 输出 / 百万 Token |
|---|---|---|---|
gpt-6-astra-law |
$10 | $1 | $50 |
gpt-6-astra |
$10 | $1 | $50 |
gpt-6.1-sol |
$2 | $0.10 | $10 |
gpt-6.1-terra |
$1 | $0.05 | $5 |
按单价计算,10 万普通输入 Token 加 1 万输出 Token 的费用约为 $1.50;若输入全部符合缓存计费条件,则约为 $0.60。这只是示意账单,未包含可能发生的工具、检索或特殊处理费用。法律索引在 API 中如何计费也尚未获得全面确认,不能默认检索免费。
💰 成本说明:法律版的 Token 单价是 Sol 的 5 倍,但实际任务成本还取决于输出长度、工具调用和任务成功率。预算敏感的项目可以先通过 API易 apiyi.com 用现有模型跑通检索流程,再按完整任务成本评估升级必要性。
对开发者的影响
- 能力建设重心变化:垂直 AI 的竞争不只在模型选择,还包括数据质量、来源追溯和专业规则设计。
- 评估方式需要升级:应在同一题集上比较完整配置,并把引用准确性和辖区适用性纳入指标。
- 上线计划要留余地:开放日期、速率限制和工具参数都未确认,暂不宜把它作为产品上线的唯一依赖。
对法律 AI 行业的影响
- 竞争继续升温:Anthropic、Google、Thomson Reuters、Harvey 和 Legora 都在推进法律 AI 产品或能力。
- 竞合关系并存:Harvey、Legora 既可能是竞争者,也被 OpenAI 列为未来的 API 客户。
- 律所知识仍有价值:Sullivan & Cromwell 的合同分析器引入了内部谈判手册和历史合同先例,说明公共法律索引并不能替代组织知识。Ropes & Gray、Cooley 等合作案例也有类似特点,但不能都视为最终版 API 的生产实测。
常见问题 FAQ
Q1:Astra for Law 是独立训练的法律模型吗?
目前没有证据支持这种说法。官方定位是基于 GPT-6 Astra 的法律专业配置,包含法律索引、专业指令和工具。是否额外进行过法律领域微调或参数训练,尚无公开确认。
Q2:54.0% 是否代表法律咨询准确率?
不代表。54.0% 是特定法律研究测试中的总体正确性检查通过率,不适用于所有法律场景,也不代表胜诉率或合同审查准确率。产品输出仍需要律师审核。
Q3:现在可以调用 gpt-6-astra-law 吗?
不能据此认为普通开发者已可调用。官方帮助中心仍说明,产品初期面向符合资格的美国律所,API 将在未来开放。模型标识和价格公开,不等于所有 API Key 都有访问权限。
Q4:2.3 亿 URL 适合中国法律场景吗?
目前无法确认。该索引明确以美国法律材料为核心,没有可信官方材料证明它对中国法律具有同等级覆盖。中国场景需要接入合规的本地数据源,并单独进行实测。
Q5:现阶段如何验证类似的法律 RAG 方案?
可以按三步进行:
1. 在 API易 apiyi.com 注册并获取 API Key 和免费测试额度。
2. 用本文示例接入自有的合规法律资料。
3. 建立带标准答案的题集,比较不同模型和检索方案。
Q6:Astra for Law 目前有哪些限制?
主要限制是访问范围窄、API 细节未公开,也缺少独立第三方的大规模实测。延迟、吞吐、真实错误率和单案成本等数据同样不足。隐私控制也不能消除幻觉或错误引用,正式结论仍需人工复核。如果想先比较通用模型的表现,可以通过 API易 apiyi.com 做小规模测试。
Astra for Law 核心要点 Key Takeaways
- 产品本质:Astra for Law 是基于 GPT-6 Astra 的法律专业配置,并非已确认的独立模型。
- 索引规模:2.3 亿是 URL 数量,不是判决书数量,覆盖重点是美国法律资料。
- 能力来源:专业表现来自模型、索引、指令和工作流的组合,现有数据无法精确拆分。
- 测试成绩:54.0% 对比 38.7% 是官方报告结果,相对提升约 40%。
- 价格信号:法律版与通用 Astra 基础单价相同,检索工具费用仍未完全确认。
- API 状态:价格已公开,但普通开发者的开放时间和权限尚未确认。
- 落地方式:可先通过 API易 apiyi.com 测试通用模型,验证自有知识库和检索流程。
总结:Astra for Law 2.3 亿 URL 带来的启示
回到最初的问题,Astra for Law 的专业能力不能简单归功于模型或索引。模型负责理解、推理和生成,法律搜索索引提供可追溯的依据,专业指令规范分析和写作方式,律所知识则把能力带入实际工作流。
官方测试证明了完整配置在特定法律研究任务中的优势,却没有给出各组件的贡献比例。对开发者来说,更实际的做法是先建好自己的数据、检索和评测体系,并持续关注 API 的正式开放信息。
如果你正在规划专业知识库应用,推荐通过 API易 apiyi.com 用统一接口对比多个模型,先以较低成本验证方案的可行性。
📚 参考资料
- OpenAI:Astra for Law 产品发布:产品定位、索引规模、测试结果和合作案例
- 链接:
openai.com/index/astra-for-law -
说明:本文核心技术信息和官方测试数据的主要来源
-
OpenAI API 定价页面:法律配置的模型标识和 Token 价格
- 链接:
developers.openai.com/api/docs/pricing -
说明:可核实价格和促销期限,建议调用前再次确认
-
OpenAI 帮助中心:Astra for Law:访问资格与 API 开放状态
- 链接:
help.openai.com/en/articles/20001528-astra-for-law -
说明:判断当前能否使用时应优先查看
-
Free Law Project:CourtListener 数据覆盖:美国判例数据来源和覆盖范围
- 链接:
wiki.free.law/c/courtlistener/help/data-coverage/case-law -
说明:有助于理解 99.9% 覆盖率的准确口径
-
Vals AI Legal Research Bench:法律研究测试方法和公开榜单
- 链接:
www.vals.ai/benchmarks/legal_research -
说明:适合用来设计法律 AI 的评测维度
-
OpenAI File Search 技术说明:通用文件检索工具的工作方式
- 链接:
developers.openai.com/api/docs/guides/tools-file-search -
说明:可作为 RAG 技术参照,但不代表法律索引的内部实现
-
Reuters:OpenAI 法律业务发布报道:法律 AI 市场竞争背景
- 链接:
www.reuters.com/legal/litigation/openai-launches-legal-focused-ai-platform-escalating-race-law-firm-users-2026-09-17 - 说明:有助于了解行业竞争格局
作者:API易技术团队
技术交流:欢迎在 API易网站首页联系我们,更多资料可访问 docs.apiyi.com 文档中心