作者注:Gemini 4 Carbon 的「全球第一」有第三方评测支撑,但它现阶段只开放给少数网络安全团队。本文拆清每个分数的口径,并说明国内开发者现在可以先接哪个型号。
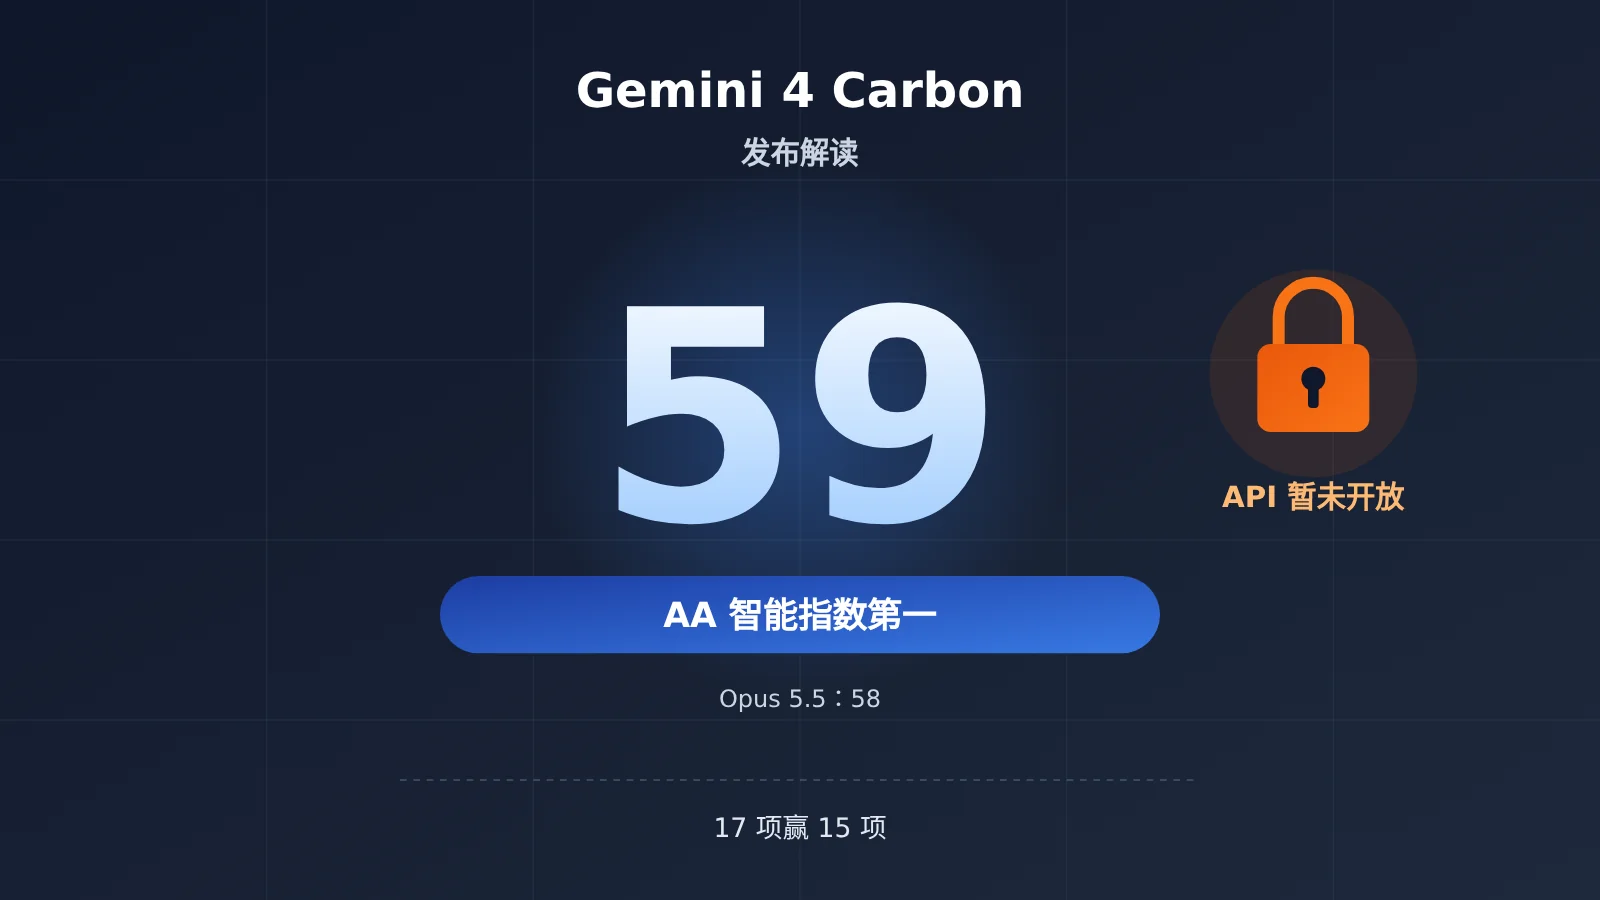
先说结论:Gemini 4 Carbon 的全球第一是真的,你现在调不到它也是真的。Artificial Analysis 独立评测的综合智能指数里,Carbon 以 59 分排第一,比 Claude Opus 5.5 的 58 分高 1 分。但 Google 在 2026-10-28 发布时没有给出 API 型号 ID,也没有给开放时间表。
这不是又一篇复述发布会的稿子。文中每个分数都会标明出处:Google 自己公布的分数写「Google 公布」,第三方的分数写「Artificial Analysis 独立评测」。分数之外,本文更关心一个问题:这次发布对你现在写代码、接 API 有什么实际影响。
核心价值:读完本文,你会知道 Carbon 哪些能力确实领先、哪些地方被夸大了、为什么现在调不到,以及想用 Gemini 4 系列的话今天该接哪个型号。
Gemini 4 Carbon 三个数字速览
如果只看三个数字,可以看下面这张表。三个数字分别对应 Carbon 的综合能力、安全攻防能力和对齐能力,其中只有第一个来自第三方。
| 数字 | 代表什么 | 口径 |
|---|---|---|
| 59 | Artificial Analysis Intelligence Index v5.0 得分,全球第一,第二名 Claude Opus 5.5(Max)58 分 | Artificial Analysis 独立评测 |
| 88.2% | SEC-bench Pro 漏洞检出率,测的是在真实软件里找出漏洞的能力 | Google 公布,未启用护栏 |
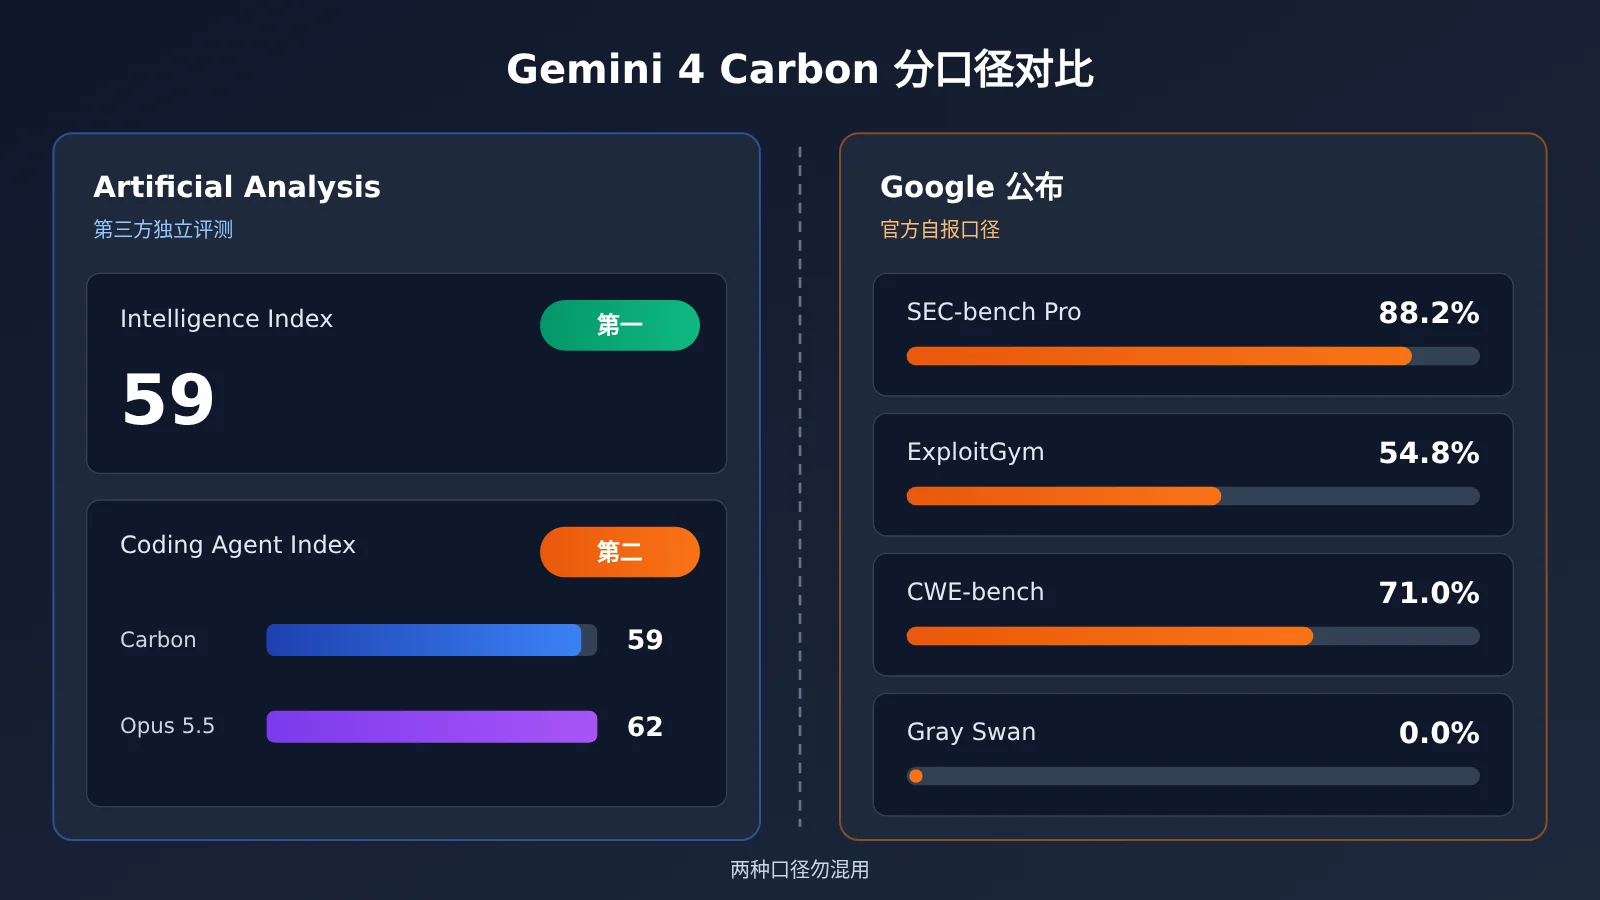
| 0.0% | Gray Swan 间接提示词注入基准的攻击成功率,Argon 为 0.7% | Google 公布 |
第一个数字最有分量,因为它是第三方给出的。后两个数字是 Google 自测的结果,AA 也说明了第三方目前无法复现。读后两个数字时要记住这一点:它们是 Google 给出的成绩,外部还没有人验证过。
Gemini 4 Carbon 核心信息速览
Carbon 是 Google 两周内发布的第二个 Gemini 4 型号。2026-10-13,Argon 向开发者开放;2026-10-28,Carbon 发布。Google 对 Carbon 的定位是「最强的模型」,重点是网络安全能力和长周期任务能力。
| 信息项 | 详情 |
|---|---|
| 发布时间 | 2026-10-28(距 Gemini 4 Argon 开放两周) |
| 发布方 | Google / Google DeepMind |
| 官方定位 | Google 最强模型,主打 SOTA 网络安全与长周期任务 |
| 综合排名 | AA Intelligence Index v5.0 第一(59 分) |
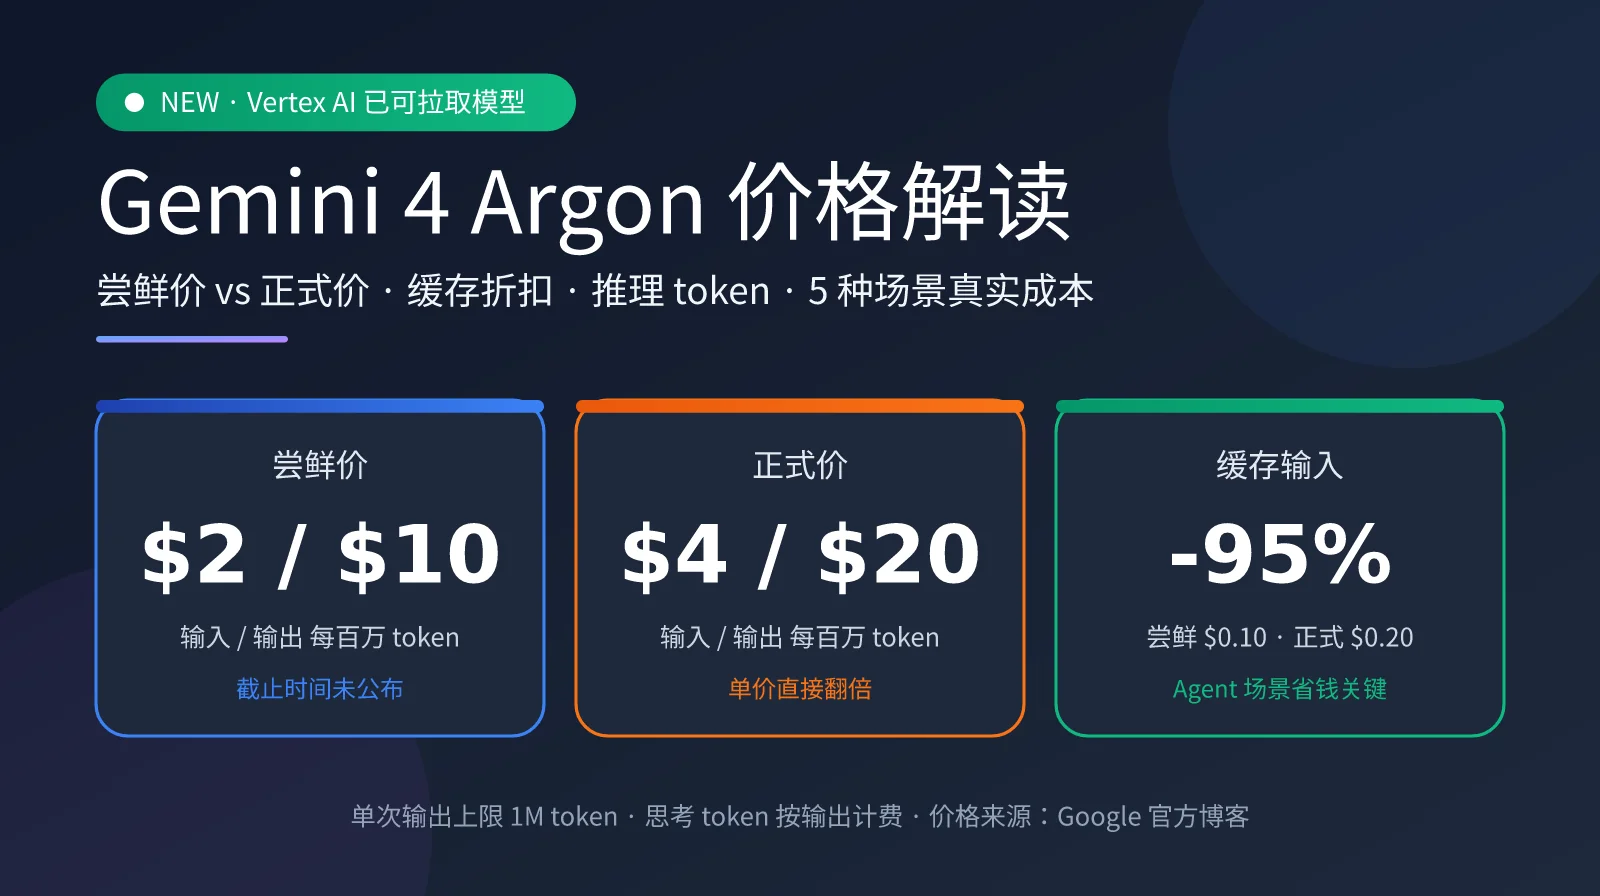
| 首发价格 | 输入 $2、输出 $10 每百万 tokens,缓存输入 $0.10,与 Argon 相同 |
| 介绍期后价格 | $4 / $20 每百万 tokens,介绍期结束日期官方没说 |
| API 型号 ID | 官方没给,AA 标注为「No publicly available API」 |
| 开放范围 | 首批只开放给 Fairwind 计划内的网络安全防御方 |
价格这一项要单独说。AA 把首发价称为「50% 首发折扣」,意思是介绍期结束后价格翻倍。Argon 的介绍期结束日期是明确的,Carbon 没有公布,所以现在用首发价来估算长期成本,结果可能偏乐观。
Gemini 4 Carbon 相对 Argon 的提升
和两周前的 Argon 相比,Google 公布的数据里提升最大的有三项:
- AA Index 从 50 分升到 59 分。
- GraphWalks 长上下文从 84.2% 升到 96.2%。
- 编码代理基准 SWE-sweep 从 4.3% 升到 9.6%。
另外,Google 称 Carbon 生成安全代码的成功率是 Argon 的 2 倍以上。
Google 还提到,内部团队观察到 Carbon 能连续运行数天,在大型代码库和底层系统中定位并修复隐蔽 bug。这一条是 Google 内部的观察,不是第三方能复现的结果。Chrome 团队说 Carbon 生成补丁的质量比「另一家实验室的一款大型前沿模型」好 10 倍以上,这同样属于客户和内部口径,而且没有说明对比的是哪个模型。
官方口径之外,也能看到早期使用者的产出。X 用户 @thtbee_ 在 10 月 22 日展示了自己用 Carbon 复刻两张参考图的结果:整个场景用 three.js 生成,自述耗时 1 小时 40 分,视频里是两套不同配色与镜头(Aurum 与 Viola)。这类「像不像、能不能跑起来」的视觉还原,是目前少数能直接看到 Carbon 输出质量的方式;但它同样属于使用者自述,不是可复现的评测。
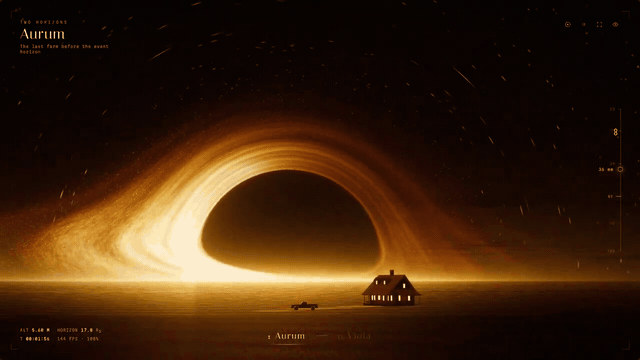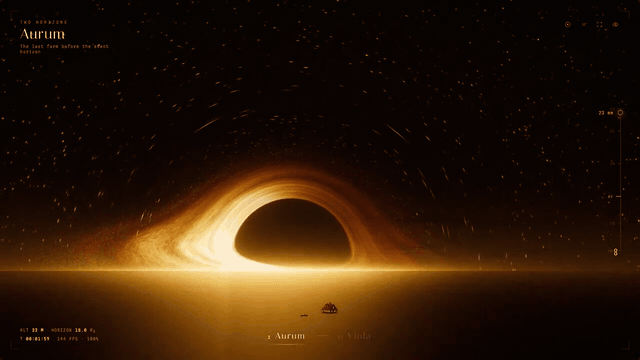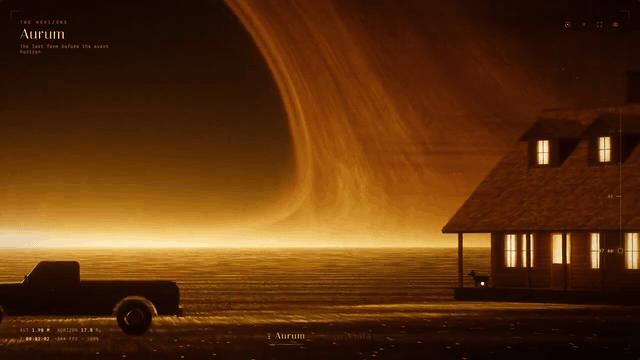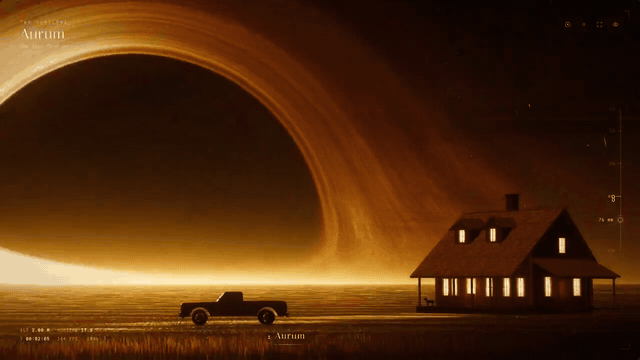
图:X 用户 @thtbee_ 展示的复刻结果,画面由 three.js 生成、自述耗时 1 小时 40 分(来源:@thtbee_,2026-10-22)。
Gemini 4 Carbon 官方 17 项对比:赢 15 项,输 2 项
下表是 Google DeepMind 方法论页给出的完整对比表,共 17 项基准。Carbon 在 15 项中排第一,另外 2 项输给了竞品。
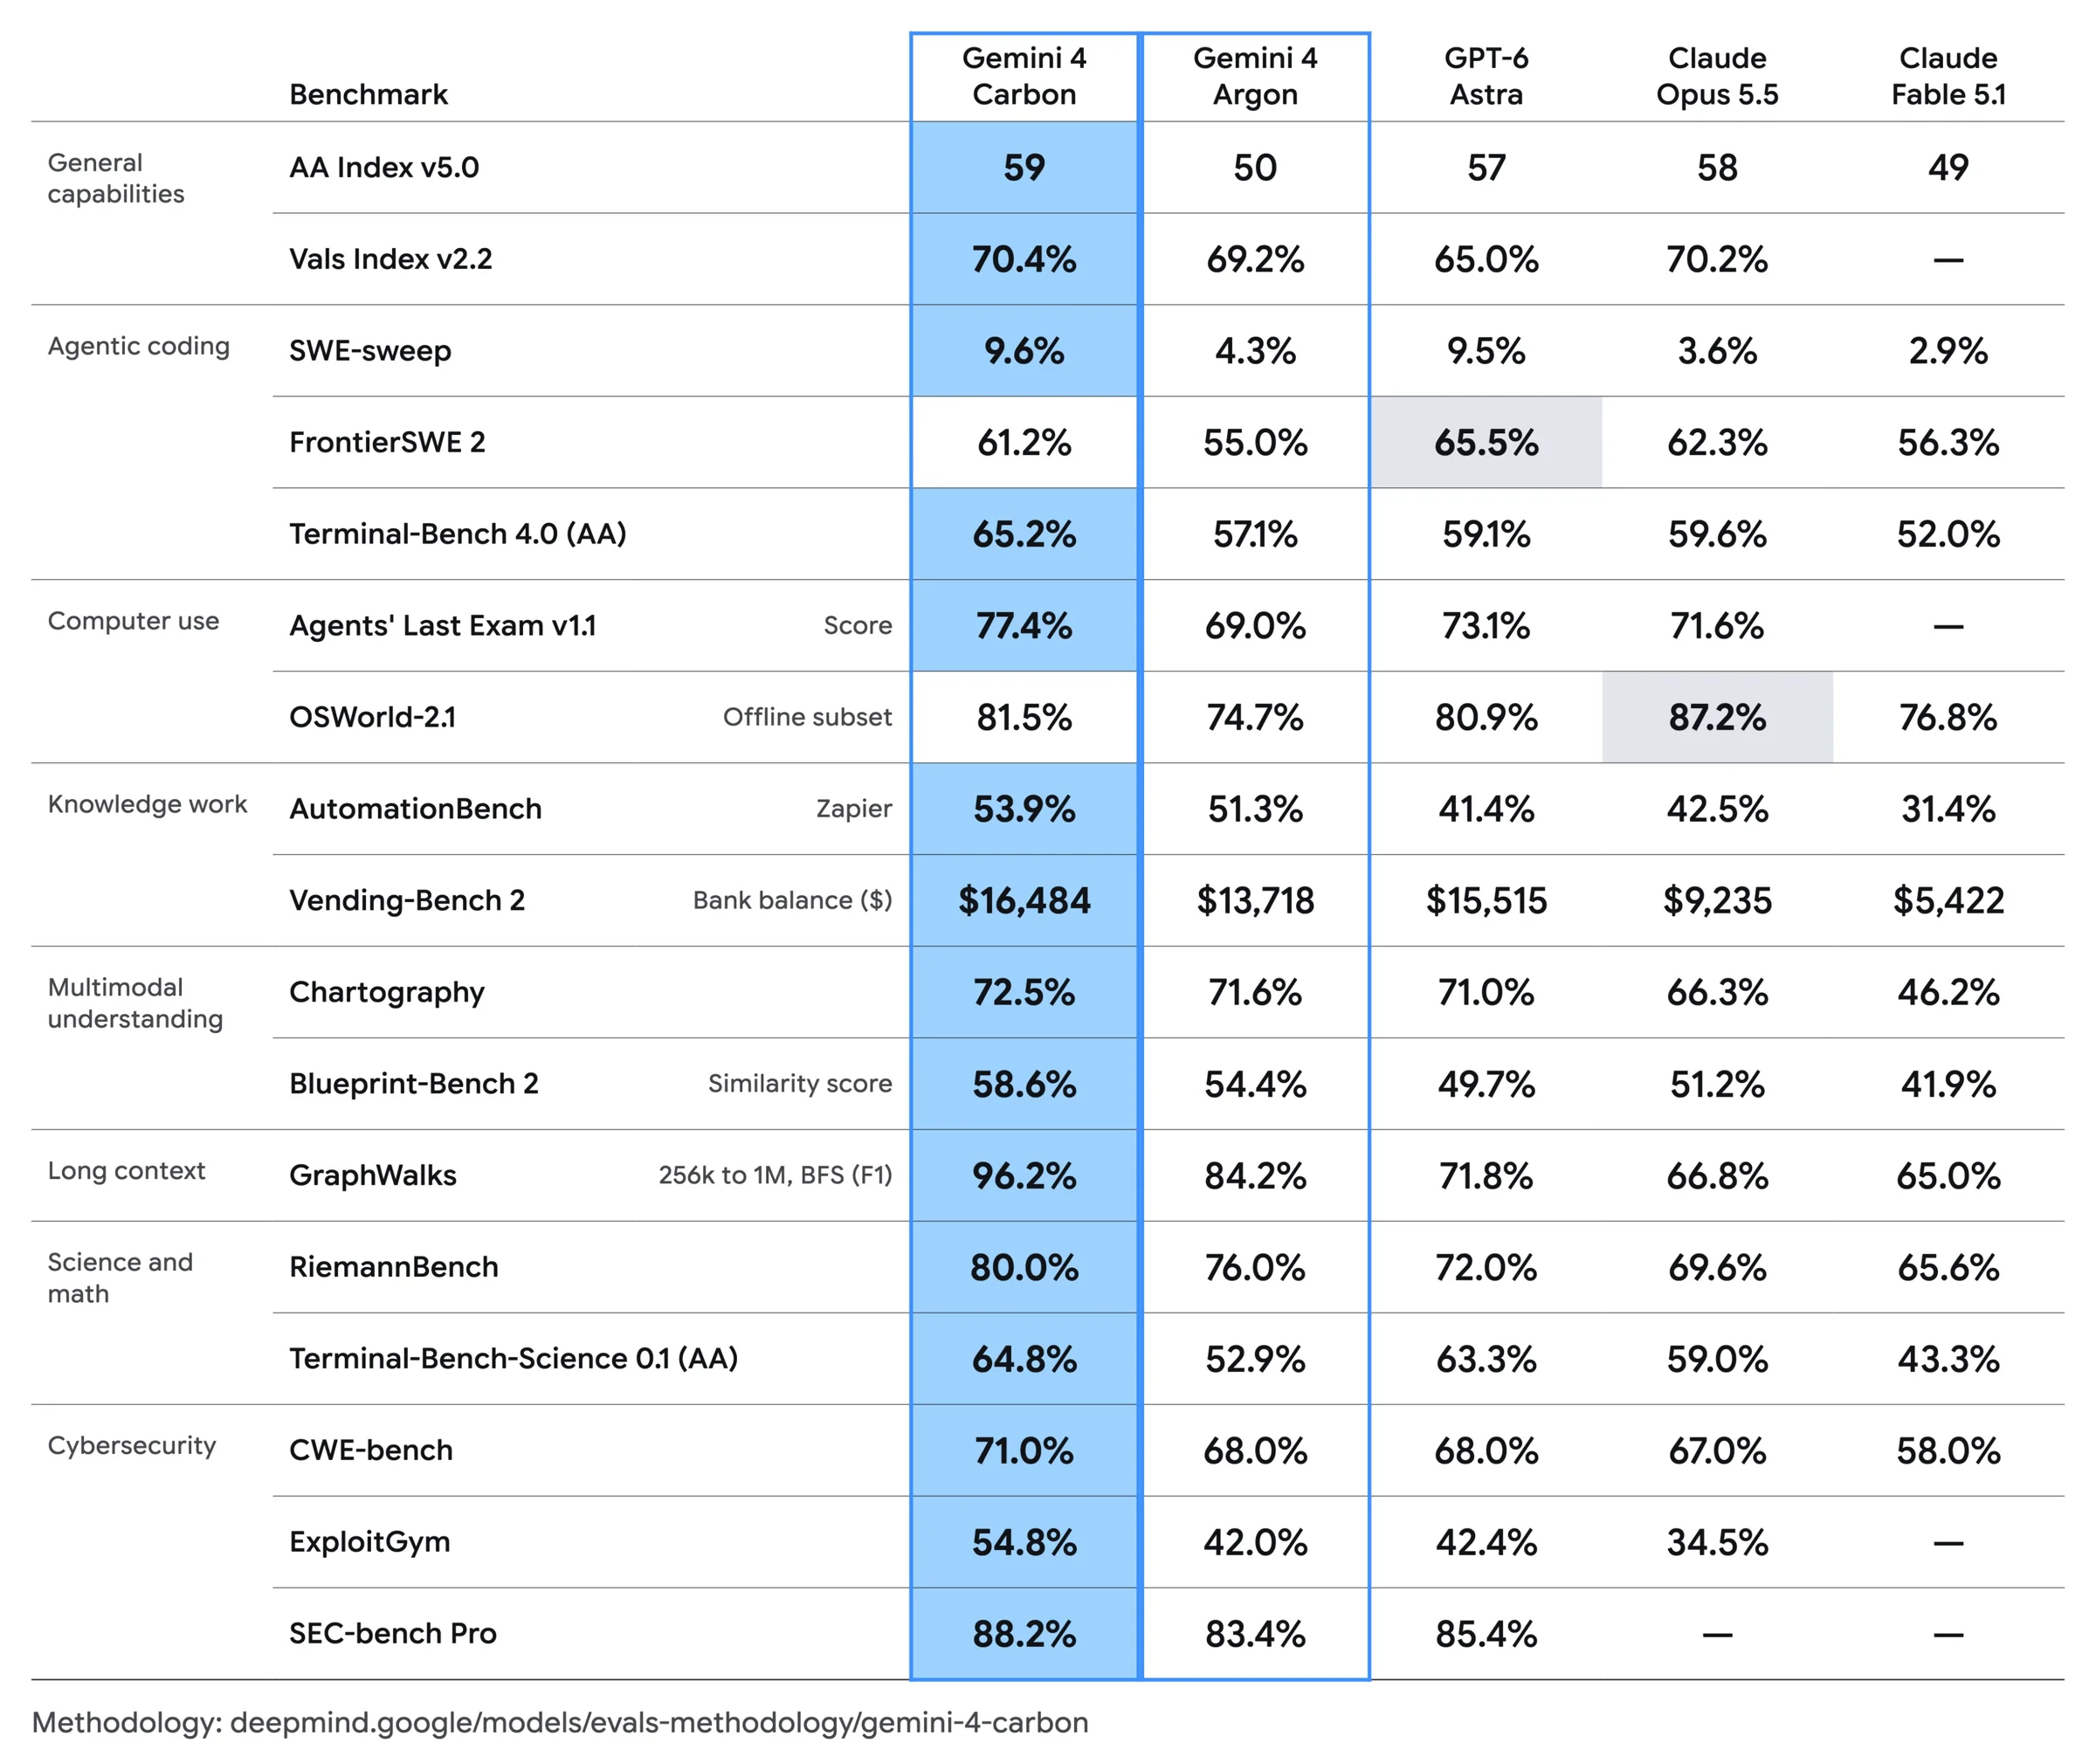
图:Google DeepMind 官方 17 项对比表,Carbon 的 15 项领先用蓝色标出,FrontierSWE 2 与 OSWorld 2.1 两项被竞品反超(来源:@GoogleDeepMind,2026-10-28)。
| 类别 | 基准 | Gemini 4 Carbon | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|---|---|
| 通用能力 | AA Index v5.0 | 59 | 50 | 57 | 58 | 49 |
| 通用能力 | Vals Index v2.2 | 70.4% | 69.2% | 65.0% | 70.2% | — |
| 编码代理 | SWE-sweep | 9.6% | 4.3% | 9.5% | 3.6% | 2.9% |
| 编码代理 | FrontierSWE 2 | 61.2% | 55.0% | 65.5% | 62.3% | 56.3% |
| 编码代理 | Terminal-Bench 4.0(AA) | 65.2% | 57.1% | 59.1% | 59.6% | 52.0% |
| 电脑操作 | Agents’ Last Exam v1.1 | 77.4% | 69.0% | 73.1% | 71.6% | — |
| 电脑操作 | OSWorld-2.1(离线子集) | 81.5% | 74.7% | 80.9% | 87.2% | 76.8% |
| 知识工作 | AutomationBench(Zapier) | 53.9% | 51.3% | 41.4% | 42.5% | 31.4% |
| 知识工作 | Vending-Bench 2(期末余额) | $16,484 | $13,718 | $15,515 | $9,235 | $5,422 |
| 多模态理解 | Chartography | 72.5% | 71.6% | 71.0% | 66.3% | 46.2% |
| 多模态理解 | Blueprint-Bench 2 | 58.6% | 54.4% | 49.7% | 51.2% | 41.9% |
| 长上下文 | GraphWalks(256k–1M,BFS F1) | 96.2% | 84.2% | 71.8% | 66.8% | 65.0% |
| 科学与数学 | RiemannBench | 80.0% | 76.0% | 72.0% | 69.6% | 65.6% |
| 科学与数学 | Terminal-Bench-Science 0.1(AA) | 64.8% | 52.9% | 63.3% | 59.0% | 43.3% |
| 网络安全 | CWE-bench | 71.0% | 68.0% | 68.0% | 67.0% | 58.0% |
| 网络安全 | ExploitGym | 54.8% | 42.0% | 42.4% | 34.5% | — |
| 网络安全 | SEC-bench Pro | 88.2% | 83.4% | 85.4% | — | — |
Gemini 4 Carbon 输掉的两项
Carbon 输掉的两项都和实际编程、操作电脑有关:
- FrontierSWE 2:Carbon 61.2%,输给 GPT-6 Astra 的 65.5%,也低于 Claude Opus 5.5 的 62.3%。在这项里 Carbon 只排第三。
- OSWorld-2.1:Carbon 81.5%,输给 Claude Opus 5.5 的 87.2%,差距接近 6 个百分点。
如果你主要拿模型做 Coding Agent 或电脑操作类 Agent,这两项比 AA 总分更值得参考。另外,有几项领先幅度很小,比如 SWE-sweep 只比 GPT-6 Astra 高 0.1 个百分点,Vals Index 只比 Opus 5.5 高 0.2 个百分点,基本可以视为打平。
读 Gemini 4 Carbon 对比表前要知道的口径
Google 方法论页写明了几条前提,会直接影响对表格的解读:
- Carbon 和 Argon 的分数是 pass@1,使用 Gemini API 的最高 thinking 设置,不允许多数投票,也不允许并行 test-time compute。
- 非 Gemini 模型的分数,除另行说明外,都来自各家自己公布的数字。因此这张表并不是同一个评测方在同一套环境下跑出来的。
- OSWorld 2.1 用的是 82 个任务的离线子集,GraphWalks 用的是 200 道题、上下文 256k 到 1M 的子集。
- SEC-bench Pro 每题独立尝试 3 次取平均,ExploitGym 每题默认 6 小时超时,并且关闭了缓解措施。
- AA Index、Terminal-Bench 4.0 来自 Artificial Analysis,FrontierSWE 来自 Proximal 公开榜,Vending-Bench 2 和 Blueprint-Bench 2 来自 Andon Labs,CWE-bench 由 Collinear AI 统一评测。
Gemini 4 Carbon 的「第一」要分口径看
「全球第一」这个说法成立,但只适用于综合智能指数。Artificial Analysis 发布的其他榜单显示,Carbon 并不是在所有方向上都排第一。
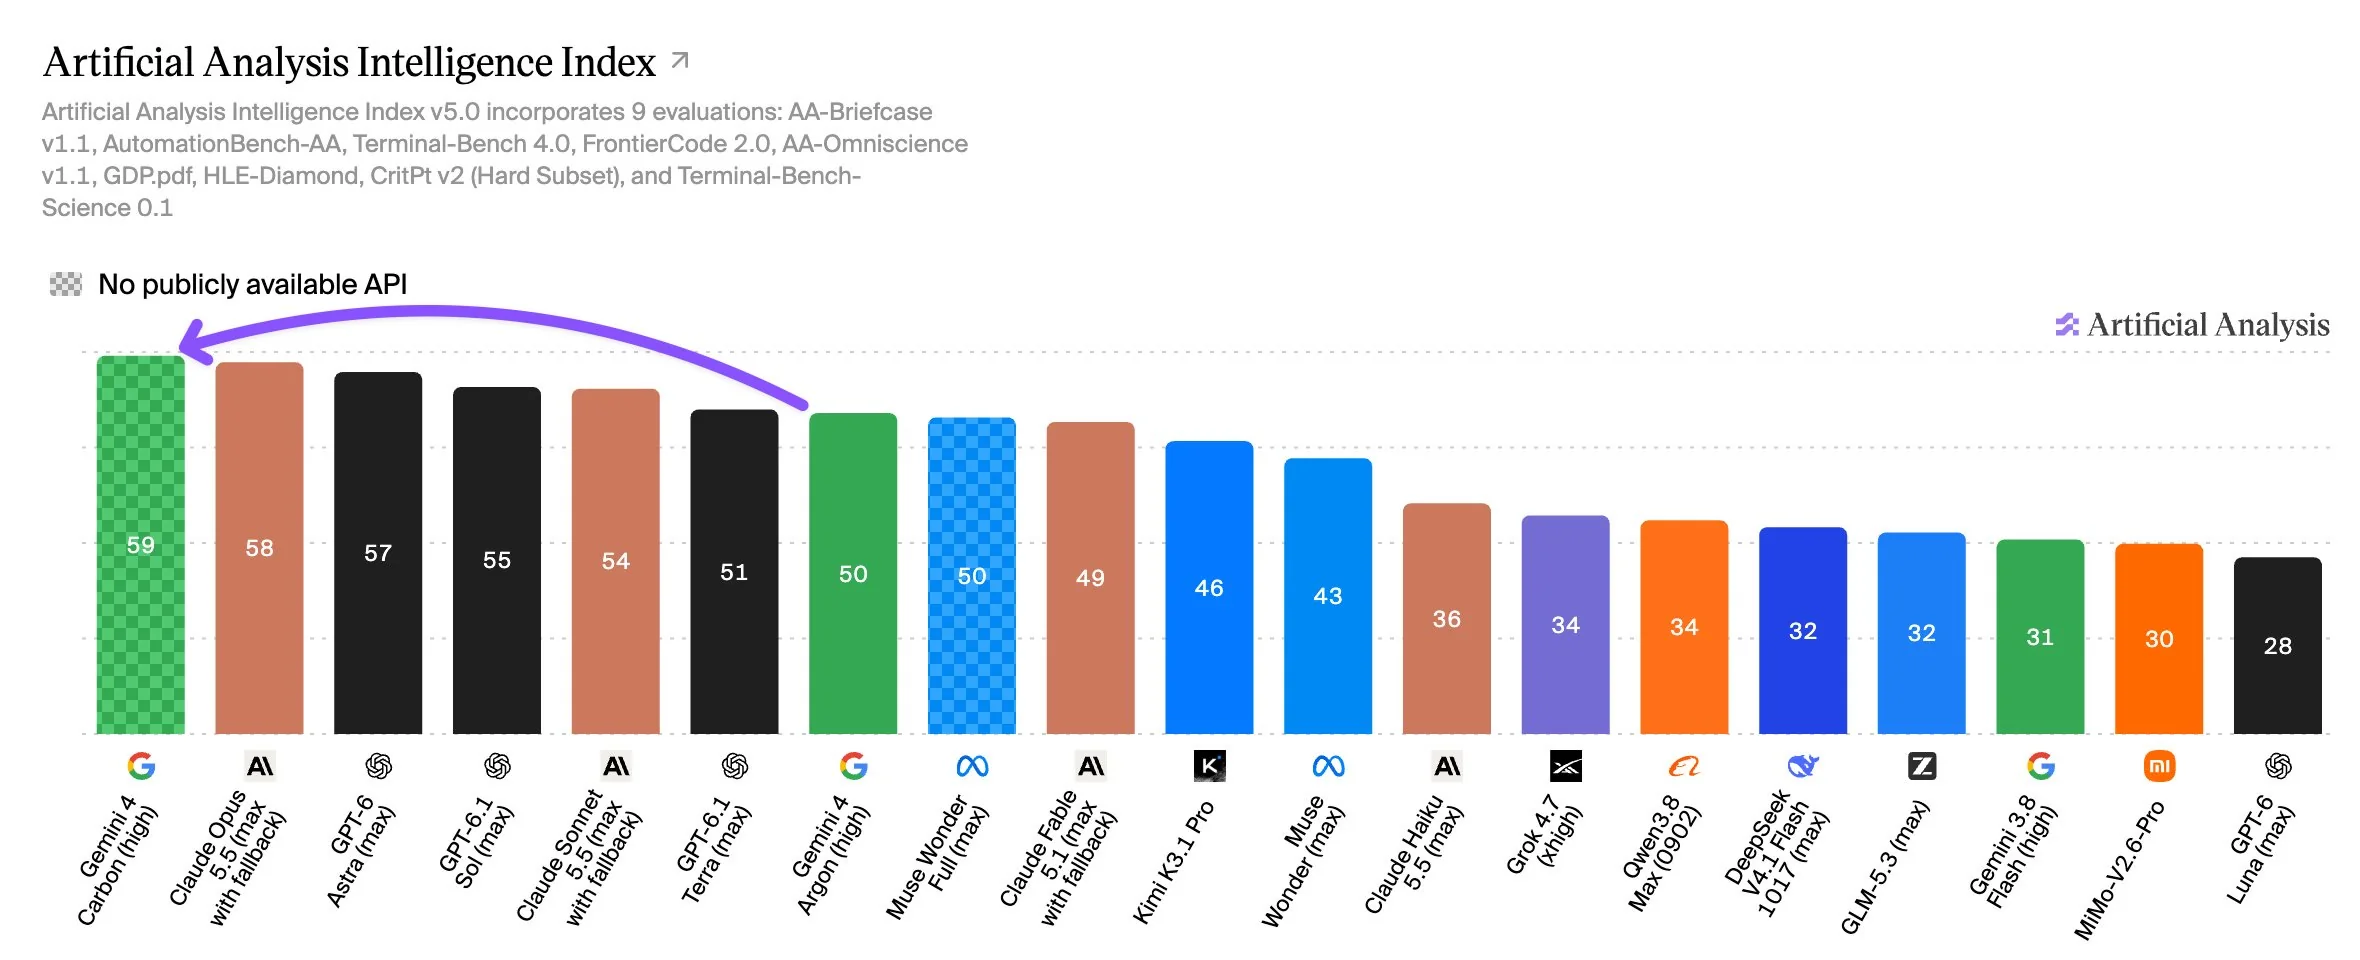
图:Artificial Analysis Intelligence Index v5.0,Carbon 59 分第一、Claude Opus 5.5(Max)58 分第二,图上同时标注了 Carbon「No publicly available API」(来源:@ArtificialAnlys,2026-10-28)。
| 指标 | Gemini 4 Carbon | 对比对象 | 结论 | 口径 |
|---|---|---|---|---|
| Intelligence Index v5.0 | 59 | Claude Opus 5.5(Max)58 | 第一 | Artificial Analysis 独立评测 |
| Coding Agent Index | 59(Antigravity CLI,high) | Claude Code + Opus 5.5(max)62 | 第二,落后 3 分 | Artificial Analysis 独立评测 |
| Terminal-Bench 4.0 | 64% | Opus 5.5(max)56% | 领先 | Artificial Analysis 独立评测 |
| FrontierCode v1.1 | 51% | Opus 5.5 56% | 落后 | Artificial Analysis 独立评测 |
| SEC-bench Pro / ExploitGym / CWE-bench | 88.2% / 54.8% / 71.0% | — | 官方称领先 | Google 公布 |
编码代理指数 Carbon 只排第二。AA 的 Coding Agent Index 中,Carbon 得 59 分,Claude Code 配 Opus 5.5 得 62 分。Intelligence Index 的 9 个子项里,Carbon 只在 HLE-Diamond、Terminal-Bench-Science、AA-Omniscience、AutomationBench-AA 这 4 项排第一,在编码和知识工作两个方向上都不是第一。
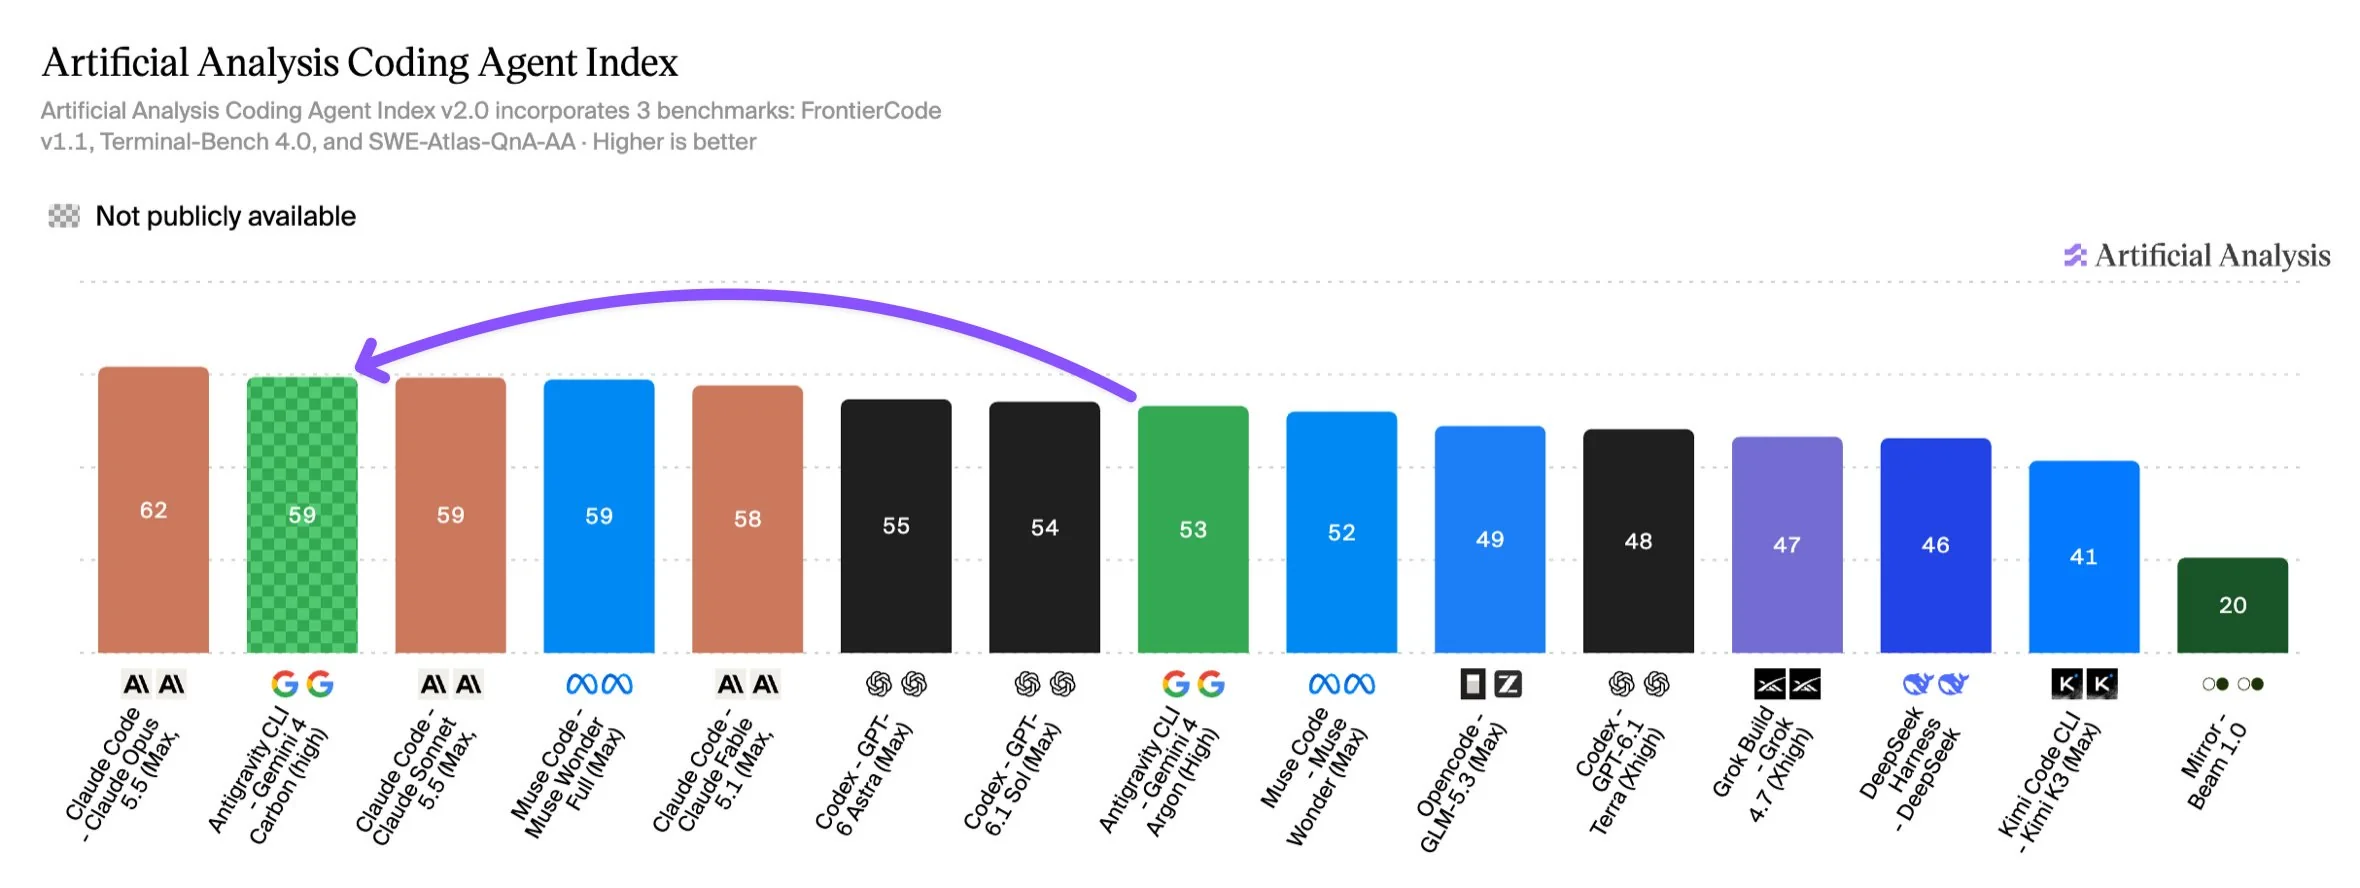
图:Artificial Analysis Coding Agent Index,Claude Code 配 Opus 5.5(Max)62 分第一,Antigravity CLI 配 Gemini 4 Carbon 59 分第二(来源:@ArtificialAnlys,2026-10-28)。
还有一个口径差异需要注意。Terminal-Bench 4.0 在官方表里写的是 65.2%,在 AA 推文里写的是 64%,两者相差约 1 个百分点。引用这个分数时应写明来源,不要混用。
💡 选择建议:现在 Carbon 还调不到,榜单分数只能作为参考。确定 Coding Agent 选型前,建议在自己的代码库里实际跑一遍。通过 API易 apiyi.com 可以用同一个 API Key 切换 Claude、GPT、Gemini 等模型,方便横向对比。
为什么你现在调不到 Gemini 4 Carbon
这次发布最确定的一点是:普通开发者现在还用不了 Carbon。原因有以下几条,每一条都有官方或第三方信息作为依据:
- 没有 API 型号 ID:官方发布稿没有给出 Carbon 的型号 ID,AA 榜单页标注为「No publicly available API」。
- 没有开放时间表:Google 官方账号的说法是「as soon as possible」,没有给出具体日期。
- 首批只开放给 Fairwind 计划内的安全团队:Fairwind 目前有 650 多家合作伙伴,优先对象是国家网络安全机构,以及医疗、电信、能源、金融等关键基础设施运营方和大型科技平台。
- 需要通过背景审查:申请机构要经过 Google Cloud 客户团队申请,Google 会核实其安全历史和运营记录。参与机构还必须具备用户级认证和抗钓鱼 MFA,访问权只能交给内部的安全、事件响应和渗透测试团队,并且要记录员工的访问和使用情况。
- 访问权不能转售:Google 明确禁止合作伙伴共享、再分发或出售前沿模型的访问权。所以如果有人声称能「转卖 Carbon 额度」,基本可以判断为不可信。
Sundar Pichai 在 X 上的说法是「Some trusted cyber defenders will get access starting this week」,也就是本周起先向一部分可信的网络安全防御方开放,之后通过 Fairwind 扩大范围,最后一句是「so hang tight!」,请大家再等等。Logan Kilpatrick 的说法也类似:「Carbon is rolling out first to cyber defenders and we are working to make it more widely available soon!」
两人都用了「soon」,但都没有给出日期。Argon 发布当天,Google AI Pro、Ultra 订阅用户和付费 API 开发者就能使用;Carbon 发布时,普通用户和开发者都用不上。有不少网友对这种「先宣布、迟迟不开放」的做法表示不满。
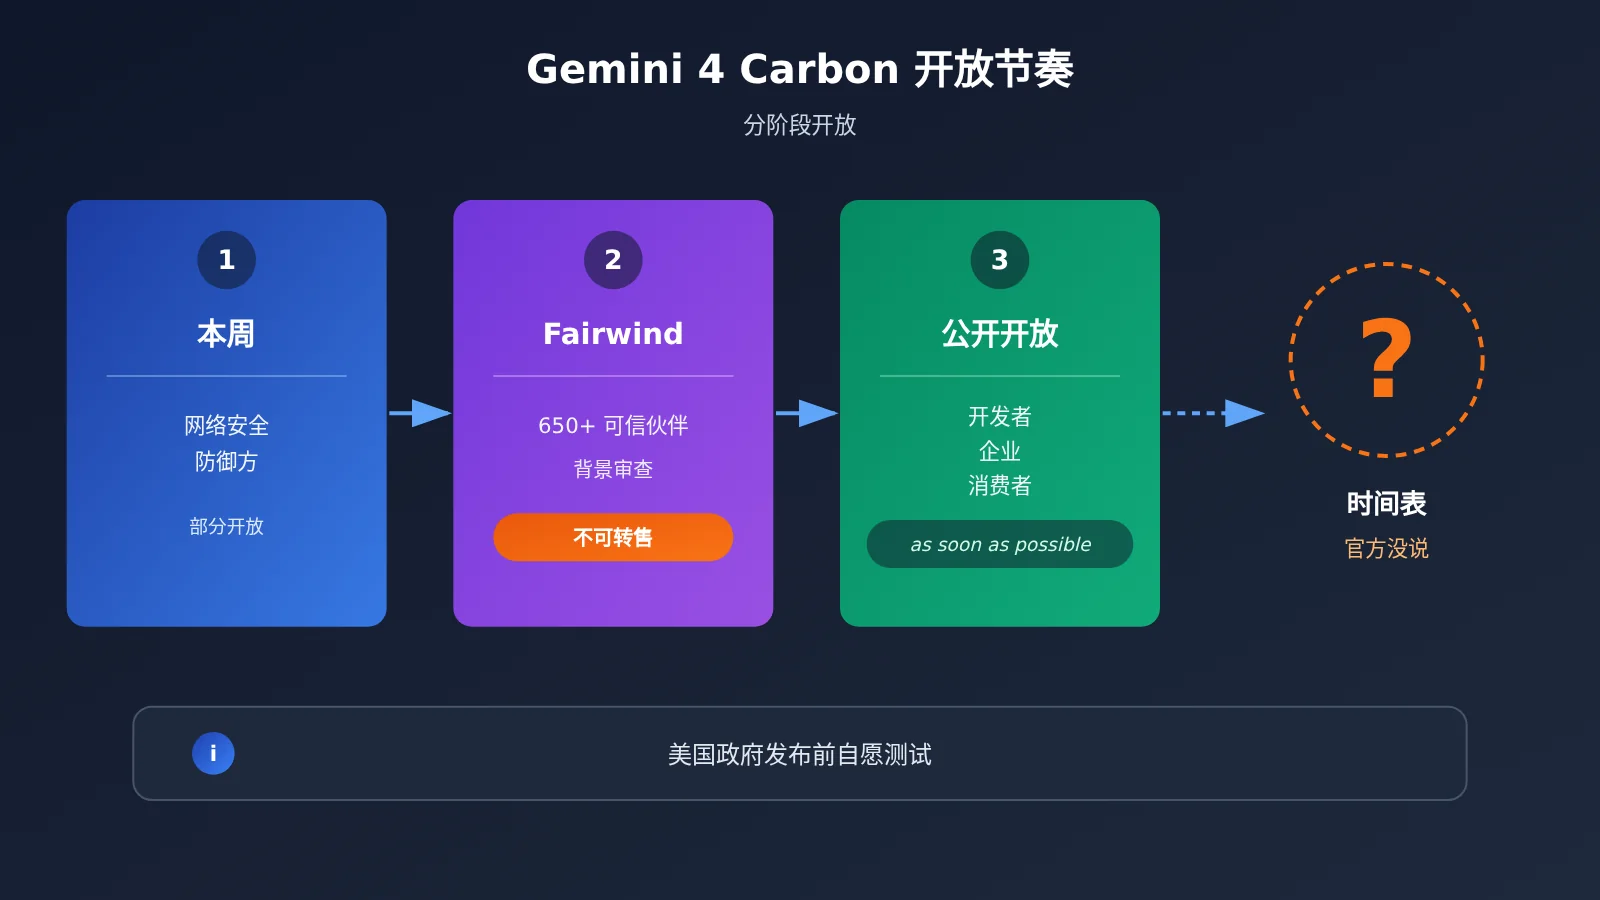
另外,Google 正在参与美国政府的前沿模型发布前自愿测试流程。Carbon 的网络安全攻防能力很强,官方的安全基准成绩也是在未启用护栏的条件下测出来的,因此 Google 采取分阶段开放,在逻辑上说得通。不过对开发者来说,这也意味着无法根据官方信息估计什么时候能用上。
现在想用 Gemini 4 系列该走哪个型号
如果你想今天就把 Gemini 4 系列接入项目,可以直接用的是 Gemini 4 Argon。API易 已经上架了这个型号,信息如下:
- 型号 ID:
gemini-4-argon - 支持端点:
chat(OpenAI 兼容)与gemini(原生格式) - OpenAI 兼容接入的 base_url:
https://api.apiyi.com/v1 - 可用分组:
default、svip - 价格:输入 $2、输出 $10、缓存读 $0.1,单位都是每百万 tokens,按量计费
- 型号文档:
https://docs.apiyi.com/models/gemini-4-argon - 价格接口:
https://api.apiyi.com/api/pricing
价格方面有一个时间点要记下:Argon 的官方介绍价在 2026-11-30 结束,之后翻倍为输入 $4、输出 $20 每百万 tokens。如果你的业务每月 tokens 用量较大,现在做成本预算时应该按 12 月以后的价格计算,不要只按介绍价算。型号与价格以平台型号列表为准,变动时以 API易 apiyi.com 的型号列表为准。
| 型号 | 当前状态 | 介绍期价格(输入/输出) | 介绍期后价格 | 可用平台 |
|---|---|---|---|---|
gemini-4-argon |
已开放 | $2 / $10 | $4 / $20(2026-11-30 后) | API易 apiyi.com、Google 官方 API |
| Gemini 4 Carbon | 仅 Fairwind 安全团队 | $2 / $10 | $4 / $20(结束日期官方没说) | 暂无公开 API |
关于 Carbon:10-29 当天,API易 价格接口共列出 279 个型号,其中有 gemini-4-argon,没有 carbon。10-27 生成的型号注册表里也没有 carbon,这是因为 Carbon 在 10-28 才发布。我们会尽快推出此模型。Google 开放公开 API 之后,Carbon 会出现在平台型号列表里,届时把 model 参数从 gemini-4-argon 改成新的型号 ID 即可,接入代码不需要改动。
🚀 快速开始:现在先用
gemini-4-argon把 Gemini 4 系列的调用链路接通,Carbon 开放后只需要改 model 参数。可以到 API易 apiyi.com 注册,用新用户的免费测试额度验证 Argon 在你业务中的效果。
Gemini 4 Carbon 影响分析
Gemini 4 Carbon 对国内开发者的影响
- 短期没有直接影响:Carbon 是否开放,与你这个季度的技术选型基本无关。生产环境该用什么,仍然看现在能调用的型号。
- Gemini 4 系列可以提前接入:Carbon 和 Argon 首发价相同。先基于 Argon 写好提示词和评测集,Carbon 开放后能马上做对比。
- Coding Agent 选型暂不需要调整:AA 编码代理指数中 Opus 5.5 仍然领先,OSWorld 也是 Opus 5.5 第一。如果你现在用的是 Claude 系列,没有必要为了一个暂时调不到的模型改变方案。
- 长上下文场景值得关注:GraphWalks 96.2% 这个成绩明显高于其他模型(Google 公布),文档检索、代码库理解这类场景在 Carbon 开放后值得测试。
- 成本要按翻倍后的价格算:Argon 和 Carbon 的介绍价都是限时的,长期预算应按 $4/$20 计算。
Gemini 4 Carbon 对行业的影响
- 前沿模型发布节奏加快:Argon 到 Carbon 只隔了两周,AA 第一名在 Carbon、Opus 5.5 和 GPT-6 Astra 之间只相差 1 到 2 分,头部模型的差距越来越小。
- 网络安全能力开始限制开放范围:当模型的漏洞检出和利用能力足够强时,厂商会先向防御方开放,之后才面向公众。这种「先安全团队、后开发者」的模式以后可能会更常见。
- 官方自测成绩需要谨慎看待:Carbon 的安全三项成绩、「连续跑数天」以及「好 10 倍」等说法都无法在外部复现。在第三方完成复现之前,这些数据只适合作为参考。
常见问题 FAQ
Q1:Gemini 4 Carbon 的「全球第一」靠谱吗?
综合智能指数的第一名是有依据的:Artificial Analysis 独立评测的 Intelligence Index v5.0 中,Carbon 得 59 分,比 Claude Opus 5.5 高 1 分。但在 AA 的编码代理指数里,Carbon 以 59 对 62 排在 Opus 5.5 之后。官方 17 项对比表中,Carbon 也输了 FrontierSWE 2 和 OSWorld-2.1 两项。
Q2:Gemini 4 Carbon 和 Argon 有什么区别?
根据 Google 公布的数据,Carbon 的 AA 指数是 59 分,Argon 是 50 分;GraphWalks 从 84.2% 提高到 96.2%,安全代码生成成功率提高到 2 倍以上。两者首发价格相同。最大的区别是可用性:Argon 已经开放,Carbon 目前只给安全团队使用。
Q3:Gemini 4 Carbon 什么时候对开发者开放?
官方没说。Google 的说法是「as soon as possible」,Sundar Pichai 和 Logan Kilpatrick 用的也是「soon」,三方都没有给出具体日期。Carbon 介绍价什么时候结束,官方同样没有公布。
Q4:现在想用 Gemini 4 系列,最快怎么接入?
直接调用 `gemini-4-argon`。在 API易 apiyi.com 注册后获取 API Key,OpenAI 兼容接口的 base_url 填 `https://api.apiyi.com/v1`,model 参数填 `gemini-4-argon`。型号与价格以平台型号列表为准,Carbon 上架后改 model 参数就能切换。
Q5:API易 什么时候会上 Gemini 4 Carbon?
我们会尽快推出此模型。前提是 Google 先开放公开 API 并给出型号 ID,目前这两项都还没有。上架后会出现在 API易 apiyi.com 的型号列表中,型号与价格以平台型号列表为准。
Q6:Gemini 4 Carbon 有哪些已知限制?
主要有三点。第一,现在没有公开 API,Fairwind 的访问权也禁止转售。第二,安全三项成绩和「连续跑数天」等说法都是 Google 自测或内部观察,第三方暂时无法复现。第三,介绍价是限时的,之后会翻倍到 $4/$20,但结束日期还没有公布。
Gemini 4 Carbon 核心要点 Key Takeaways
- 综合第一有第三方支撑:AA 独立评测中,Carbon 以 59 分领先 Opus 5.5 的 58 分。
- 编码代理不是第一:AA 编码代理指数中,Carbon 以 59 分落后于 Opus 5.5 的 62 分。
- 17 项赢 15 项:输掉的是 FrontierSWE 2 和 OSWorld-2.1。
- 安全成绩来自 Google 自测:88.2%、54.8%、71.0% 都是在未启用护栏的条件下测得。
- 目前调不到:没有型号 ID,没有开放时间表,首批仅开放给 Fairwind 计划内的 650 多家伙伴。
- 现在可用 Argon:API易 已上架
gemini-4-argon,2026-11-30 之后价格翻倍。
总结
Gemini 4 Carbon 的主要信息可以概括为三点:
- 能力领先,但要看口径:AA 综合指数排第一;编码代理和 OSWorld 方向,Claude Opus 5.5 仍然领先。
- 官方数据还需要验证:网络安全成绩、长周期任务和对齐方面的数据,大多是 Google 自己公布的。
- 短期内用不上:没有 API、没有时间表,普通开发者现阶段无法申请使用。
对国内开发者来说,比较实际的做法是先用 Argon 接通 Gemini 4 系列,同时准备好自己的评测集,等 Carbon 开放后直接做对比。推荐通过 API易 apiyi.com 接入 gemini-4-argon,用同一个 API Key 也可以调用 Claude、GPT 做横向测试。我们会尽快推出此模型,型号与价格以平台型号列表为准。
📚 参考资料
- Google 官方博客:Introducing Gemini 4 Carbon:发布稿、价格与开放节奏
- 链接:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon -
说明:官方定位、安全三项成绩、介绍价脚注的来源
-
Google DeepMind:Gemini 4 Carbon 评测方法论:17 项对比表与评测口径
- 链接:
deepmind.google/models/evals-methodology/gemini-4-carbon -
说明:pass@1 设置、非 Gemini 模型分数来源等说明
-
Google DeepMind:Fairwind Program:首批访问计划的规则
- 链接:
deepmind.google/fairwind-program -
说明:650 多家伙伴、背景审查、不可转售等限制
-
Artificial Analysis 榜单:第三方独立评测
- 链接:
artificialanalysis.ai -
说明:Intelligence Index v5.0 与 Coding Agent Index 排名
-
API易 Gemini 4 Argon 文档:现阶段可用的 Gemini 4 型号
- 链接:
docs.apiyi.com/models/gemini-4-argon -
说明:型号 ID、端点与价格
-
X 上的原始素材:本文配图的出处
- 官方对比表:
x.com/GoogleDeepMind/status/2115489356437651654(2026-10-28) - 两张榜单截图:
x.com/ArtificialAnlys/status/2115494553780367384(2026-10-28) - three.js 复刻演示:
x.com/thtbee_/status/2113301369826464147(2026-10-22)
作者:APIYI 技术团队
技术交流:欢迎在 API易 apiyi.com 首页联系我们,更多资料可访问 docs.apiyi.com 文档中心