作者注:手把手接入 K-Dense-AI 的 177 个科研 Agent Skills,从环境自检、挑选、安装、补依赖到触发验收,并单独讲清排错和风险。
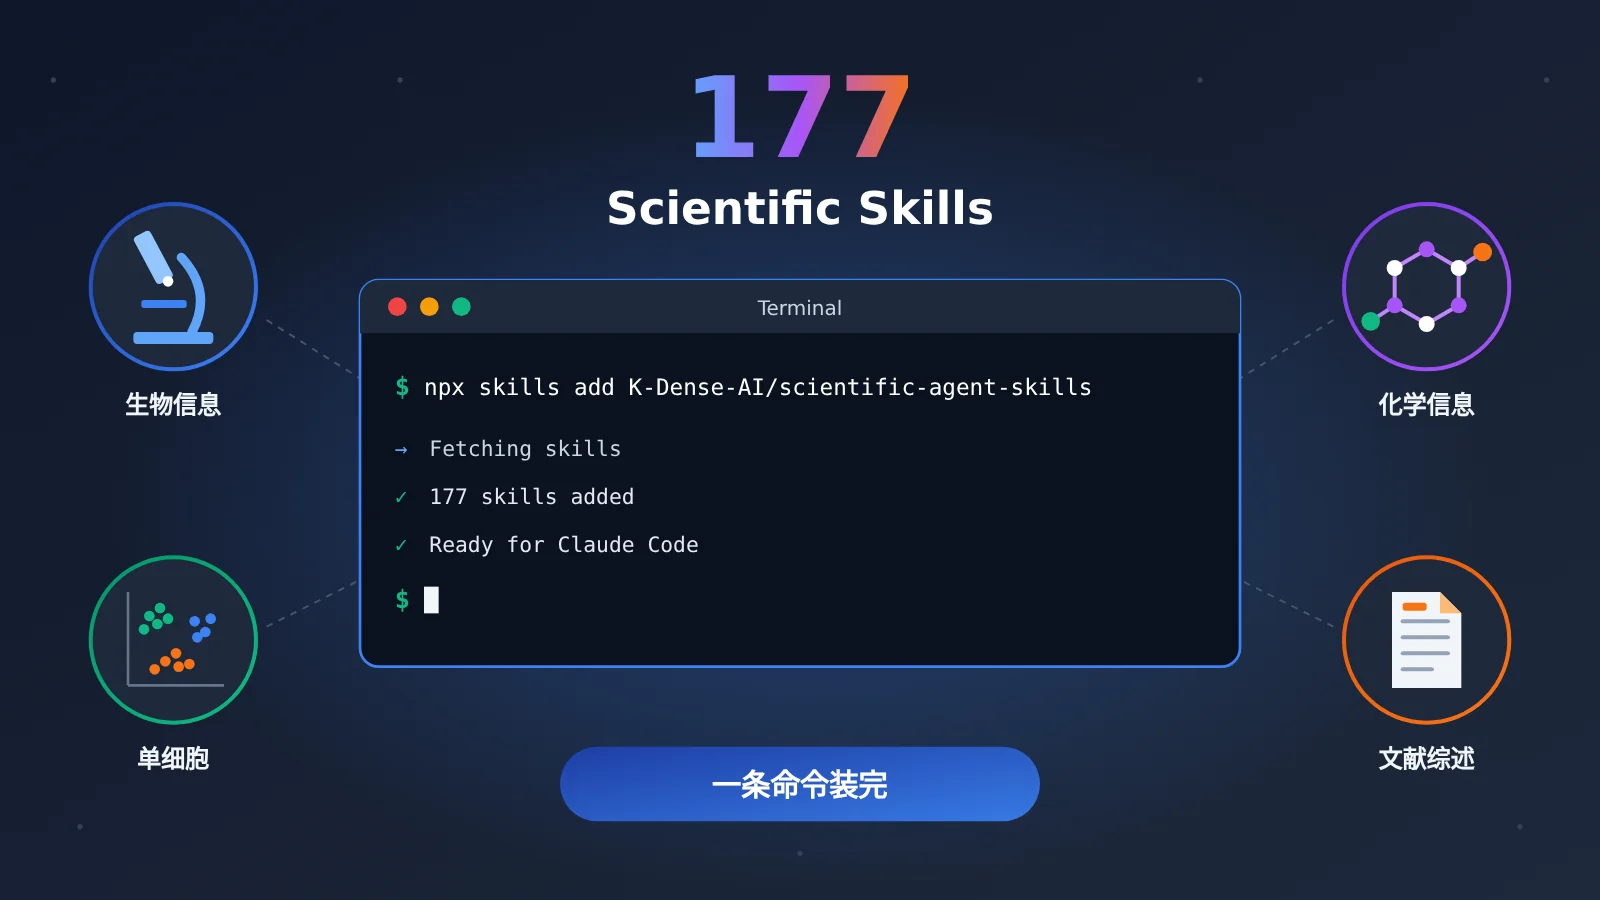
K-Dense-AI 开源的 Scientific Agent Skills 是一套给 Claude Code、Cursor 等编码 Agent 用的科研技能包,共 177 个技能。它把单细胞分析、化学信息、文献综述、数据库检索这些流程写成 Agent 能读懂的操作手册,你就不用每次都从头写 QC 流程、翻 API 文档、核对 DOI。不过它不适合一口气全装:技能能让 Agent 执行代码、装包、联网,而且装技能文件不会顺带装好 Python 依赖。
这不是“装完就无敌”的安利文,而是一份按 5 个步骤走、每一步都能核对结果的接入指南。
核心价值:读完本文,你能挑出自己方向需要的 5-10 个科研 Skills,装进正确目录并补齐依赖,再让 Agent 真正调用起来,产物和数字都能逐项核对。
177 个科研 Skills 里到底有什么
仓库地址是 K-Dense-AI/scientific-agent-skills,许可为 MIT。截至 2026-10-28,它有 54,959 个 star、4,846 个 fork,当前版本 2.72.0,skills/ 目录下共 177 个子目录。README 自称“250,000+ 科学家在用”“#1 Agent Skills library for science”,这些都是官方自报口径,并不是第三方统计。配套论文为 arXiv:2609.00065。
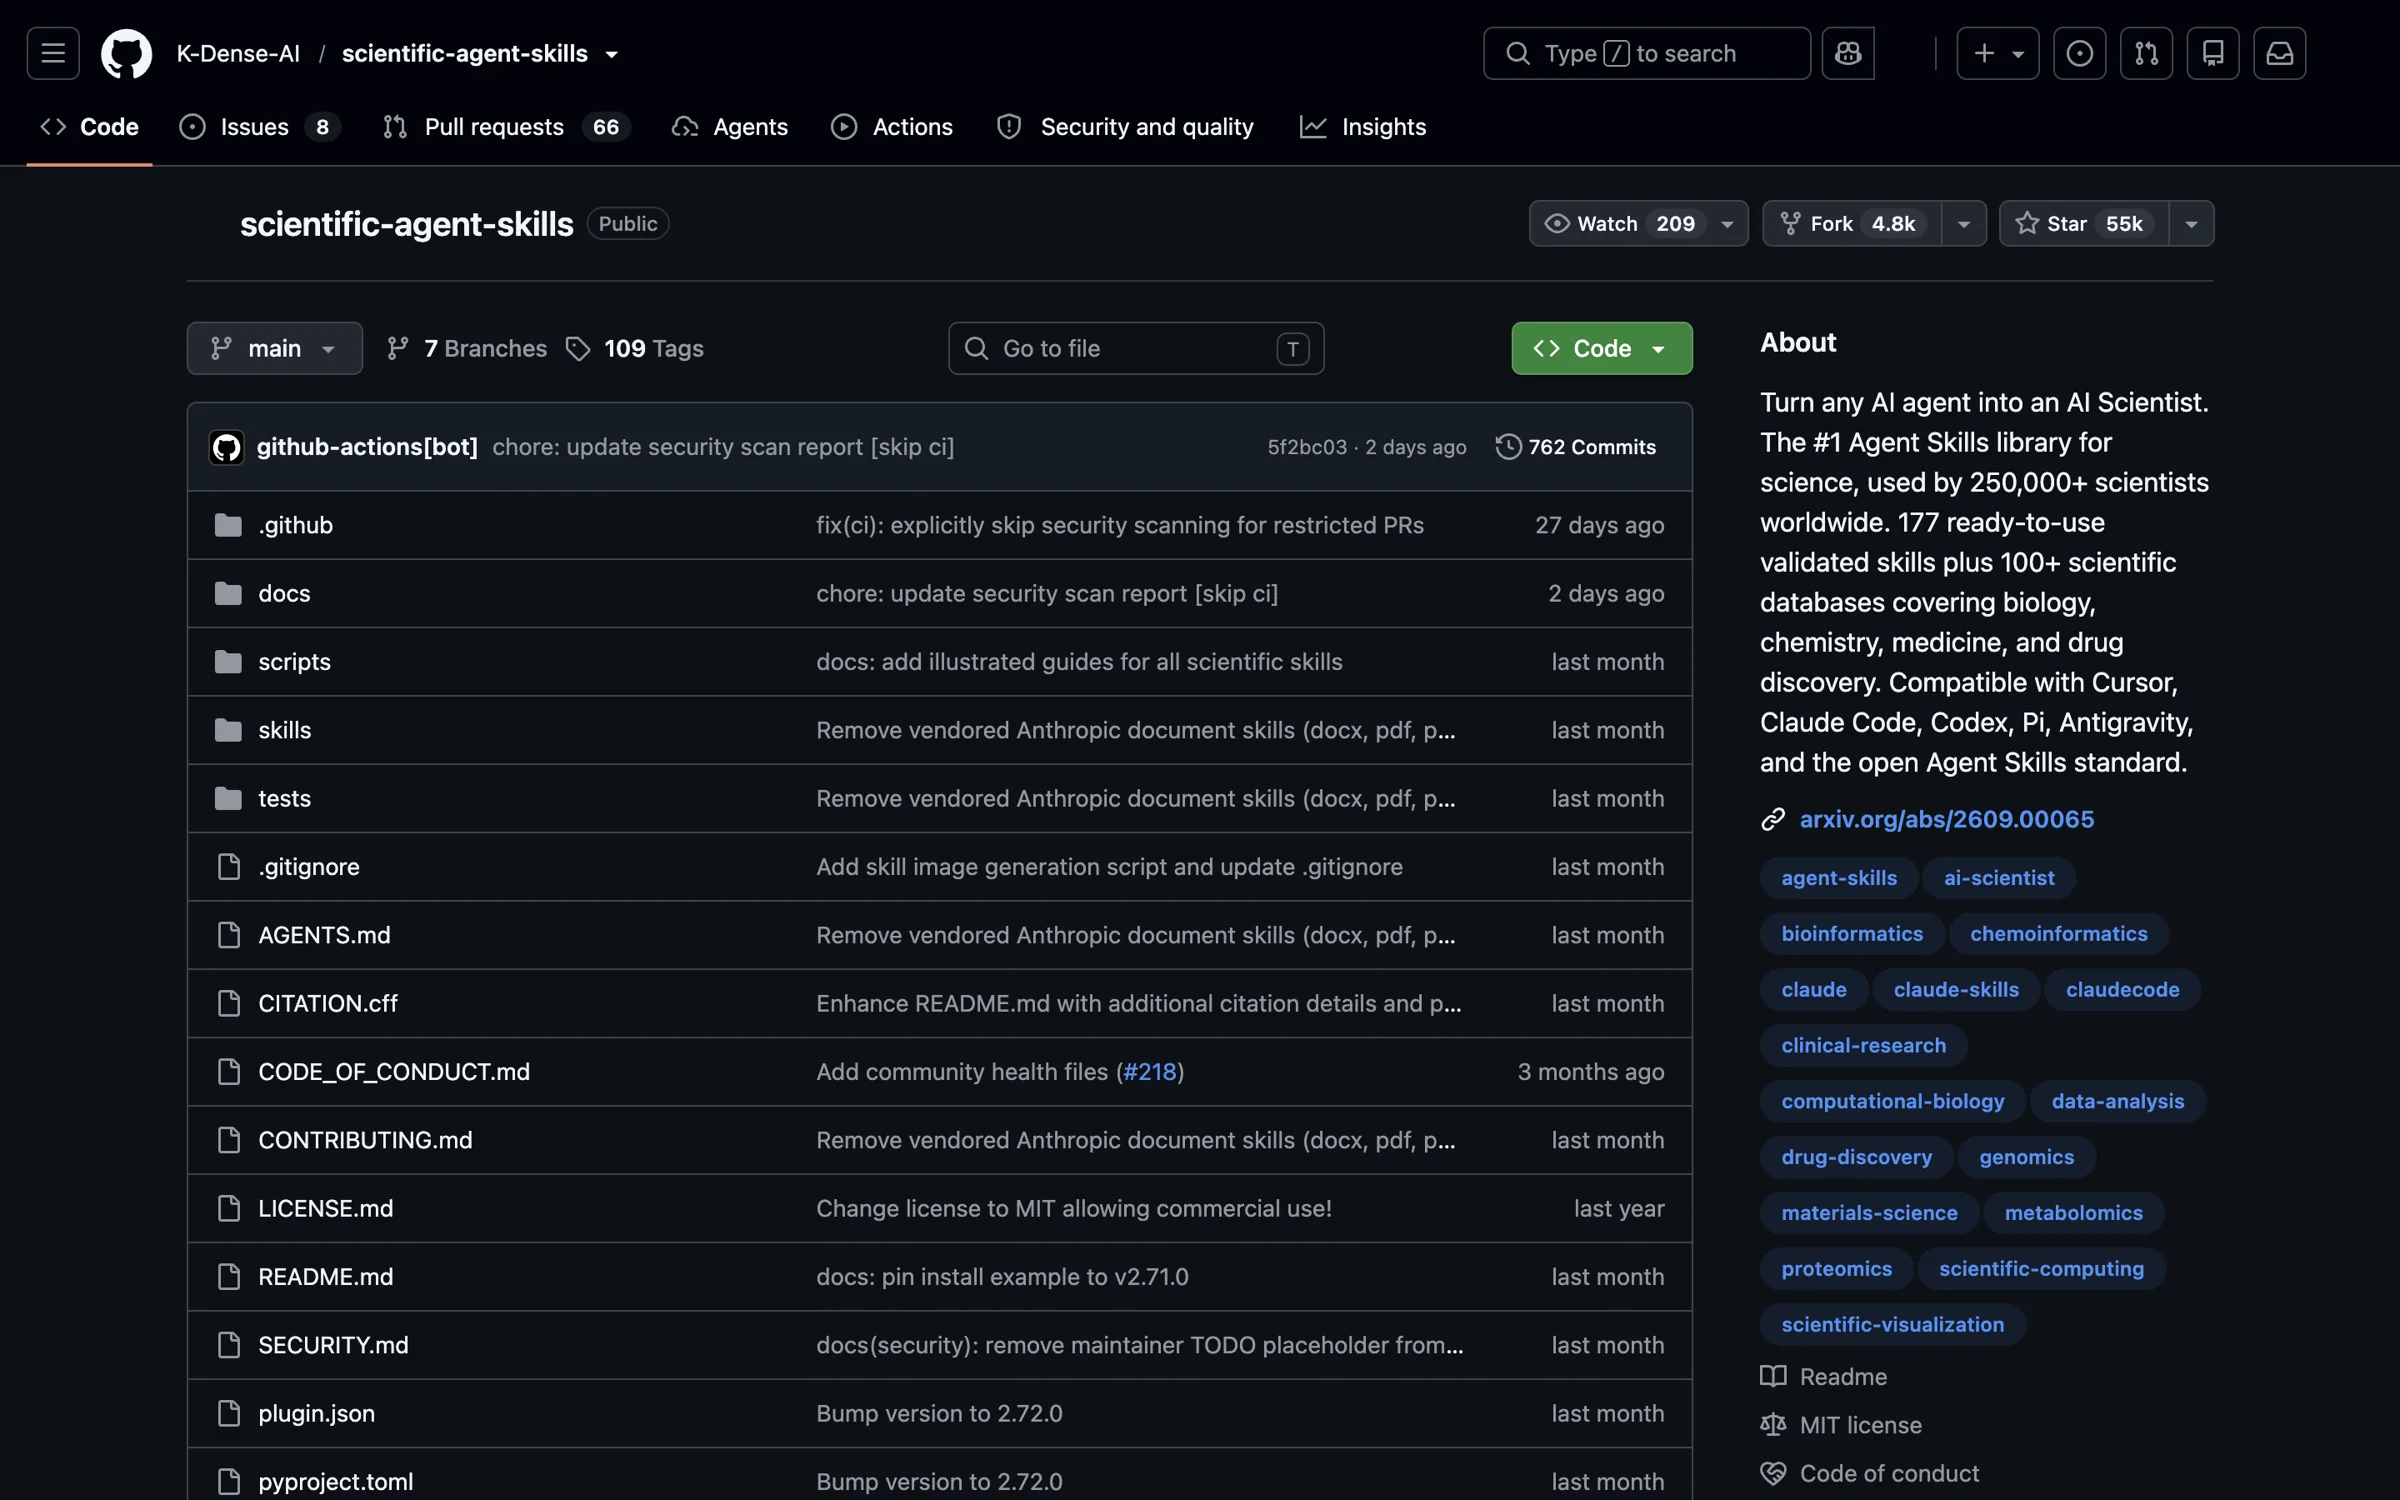
图 1:仓库首页(2026-10-28 截图),Star 55k、Fork 4.8k,About 一栏直接写明 177 个技能与 100+ 数据库
数量为什么是 177?2.71.0 时共有 181 个技能。从 2.72.0 开始,docx、pdf、pptx、xlsx 四个文档技能不再随仓库分发,需要的话要去 Anthropic 的仓库单独安装。
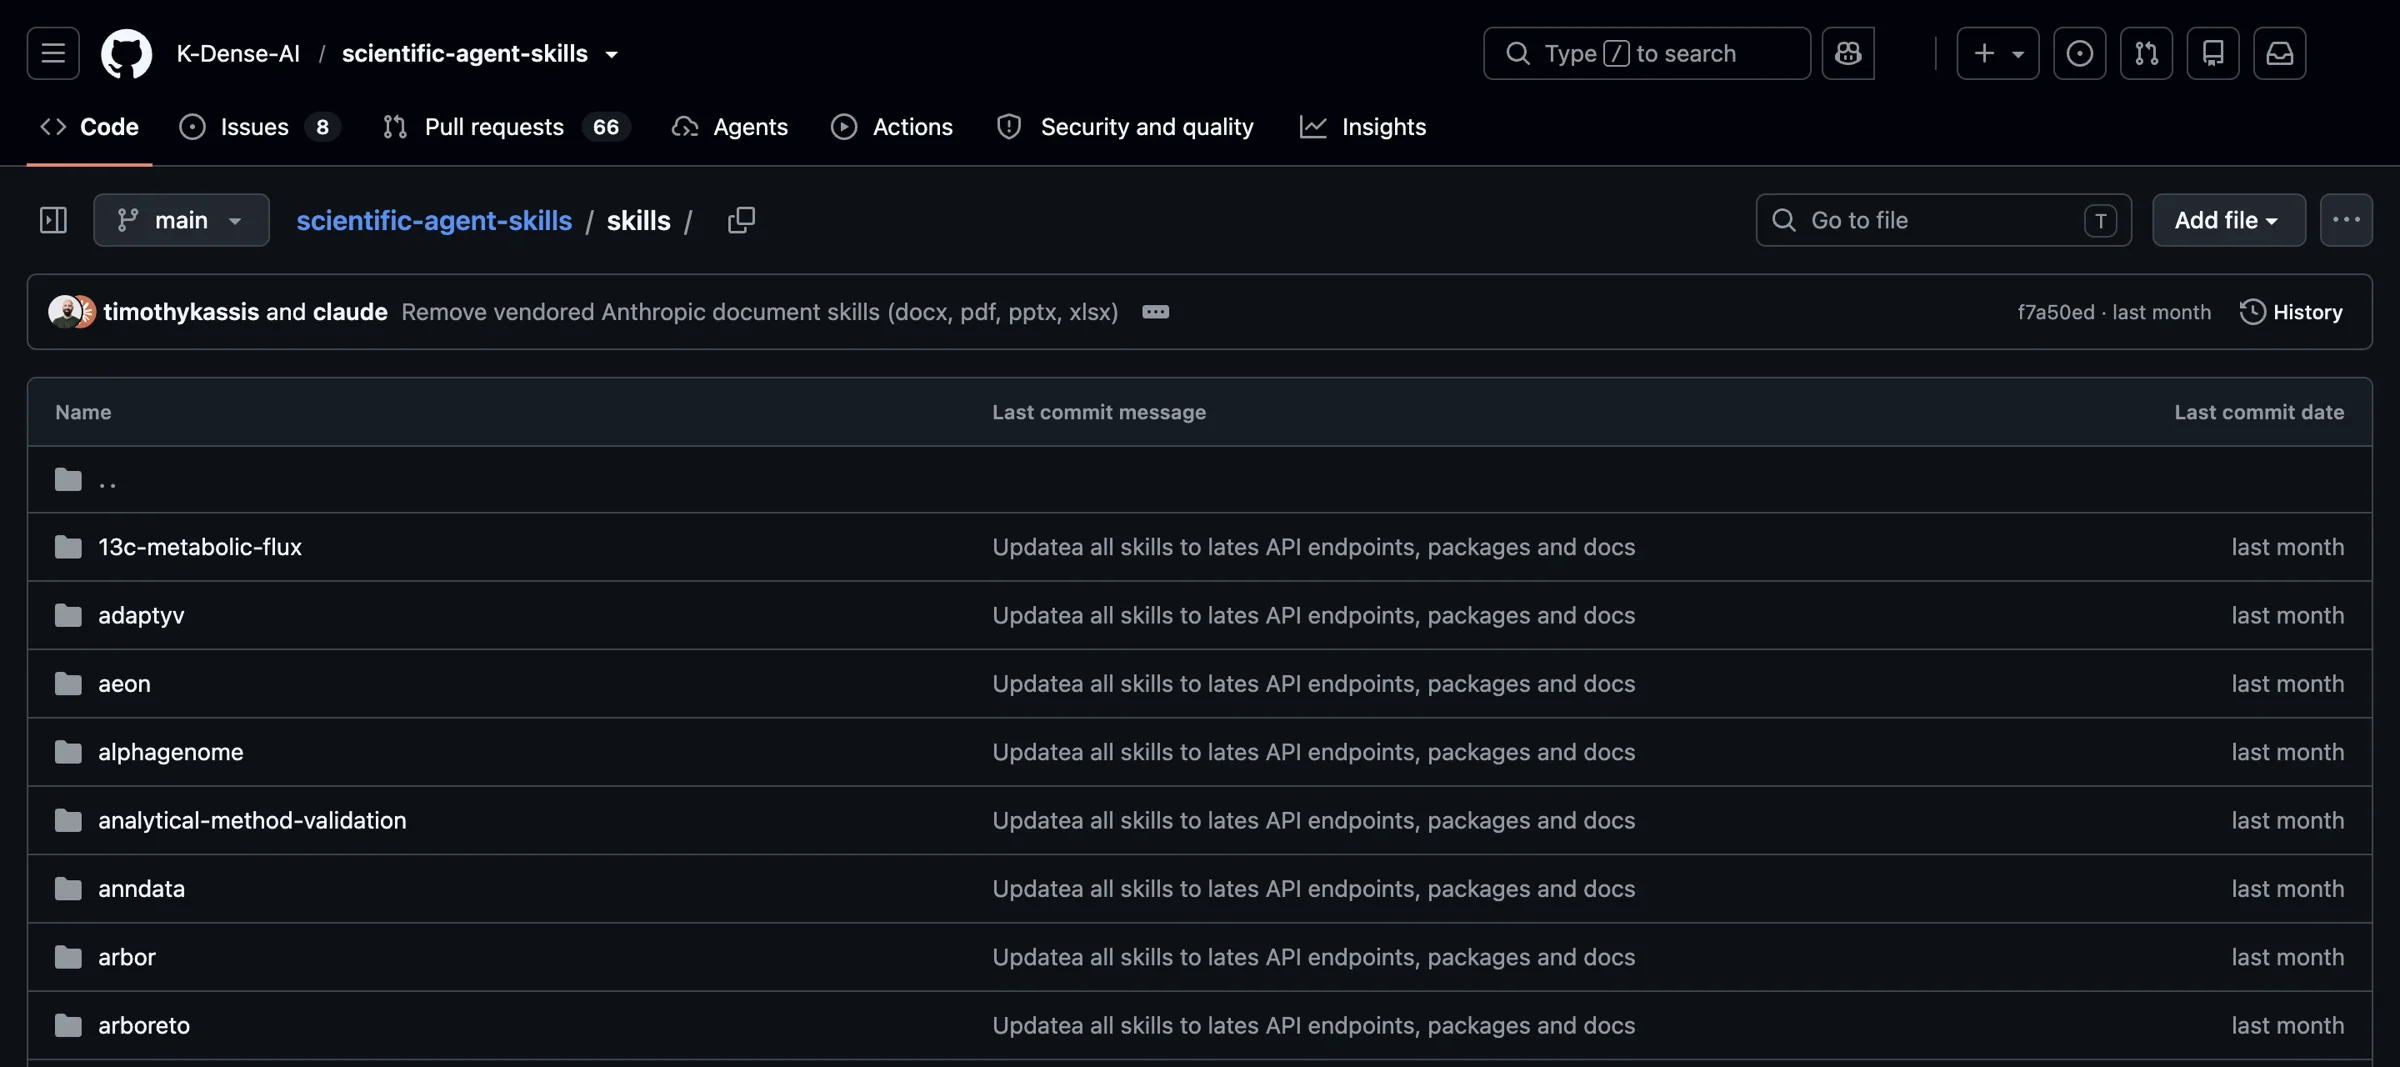
图 2:skills/ 目录里一屏就是几十个技能文件夹;最近一次提交的说明写着 Remove vendored Anthropic document skills,这就是数量从 181 变成 177 的那次改动
README 把全部技能分成 22 个大类。下表按方向合并成几组,只列有代表性的技能和包,不逐个罗列:
| 方向(README 大类) | 代表技能 / 包 | 典型用途 |
|---|---|---|
| 生物信息、多组学、蛋白组与质谱 | scanpy、pydeseq2、pyopenms、nextflow,包技能如 scVelo |
单细胞 QC 与聚类、差异表达、质谱处理、流程编排 |
| 化学信息与药物发现、材料科学 | rdkit、pymatgen |
分子过滤与描述符、晶体结构与材料计算 |
| 物理与天文、工程与仿真 | qiskit,包技能如 QuTiP |
量子线路、量子系统仿真 |
| 临床研究、医疗 AI、法规与标准 | clinical-reports,包技能如 pydicom |
临床报告草稿、医学影像读取 |
| 数据分析与可视化、机器学习、地理空间 | scientific-visualization、timesfm-forecasting,包技能如 scikit-learn、PyTorch Lightning、GeoPandas |
出版级图表、时间序列预测、建模、空间数据分析 |
| 科学传播、研究方法论 | literature-review、scientific-writing、paper-lookup、paperzilla、scientific-slides、research-grants、peer-review、generate-image |
系统综述、论文写作、组会幻灯片、基金申请、审稿意见 |
| 数据库检索 | database-lookup,专项技能如 DepMap、Imaging Data Commons、PrimeKG、NCATS ARAX、AlphaGenome |
统一查询公开、注册和授权类数据源 |
其中 database-lookup 一个技能就整理了 80 个数据源,再加上专项技能和多库包,README 对外的口径是 100+ 数据库。Python 包类技能有 70+ 个,RDKit、Scanpy、scikit-learn、PyTorch Lightning、pydicom、QuTiP、GeoPandas、pymatgen、Qiskit、scVelo、TimesFM 都在其中,每个技能会写明适用的包版本和用法。
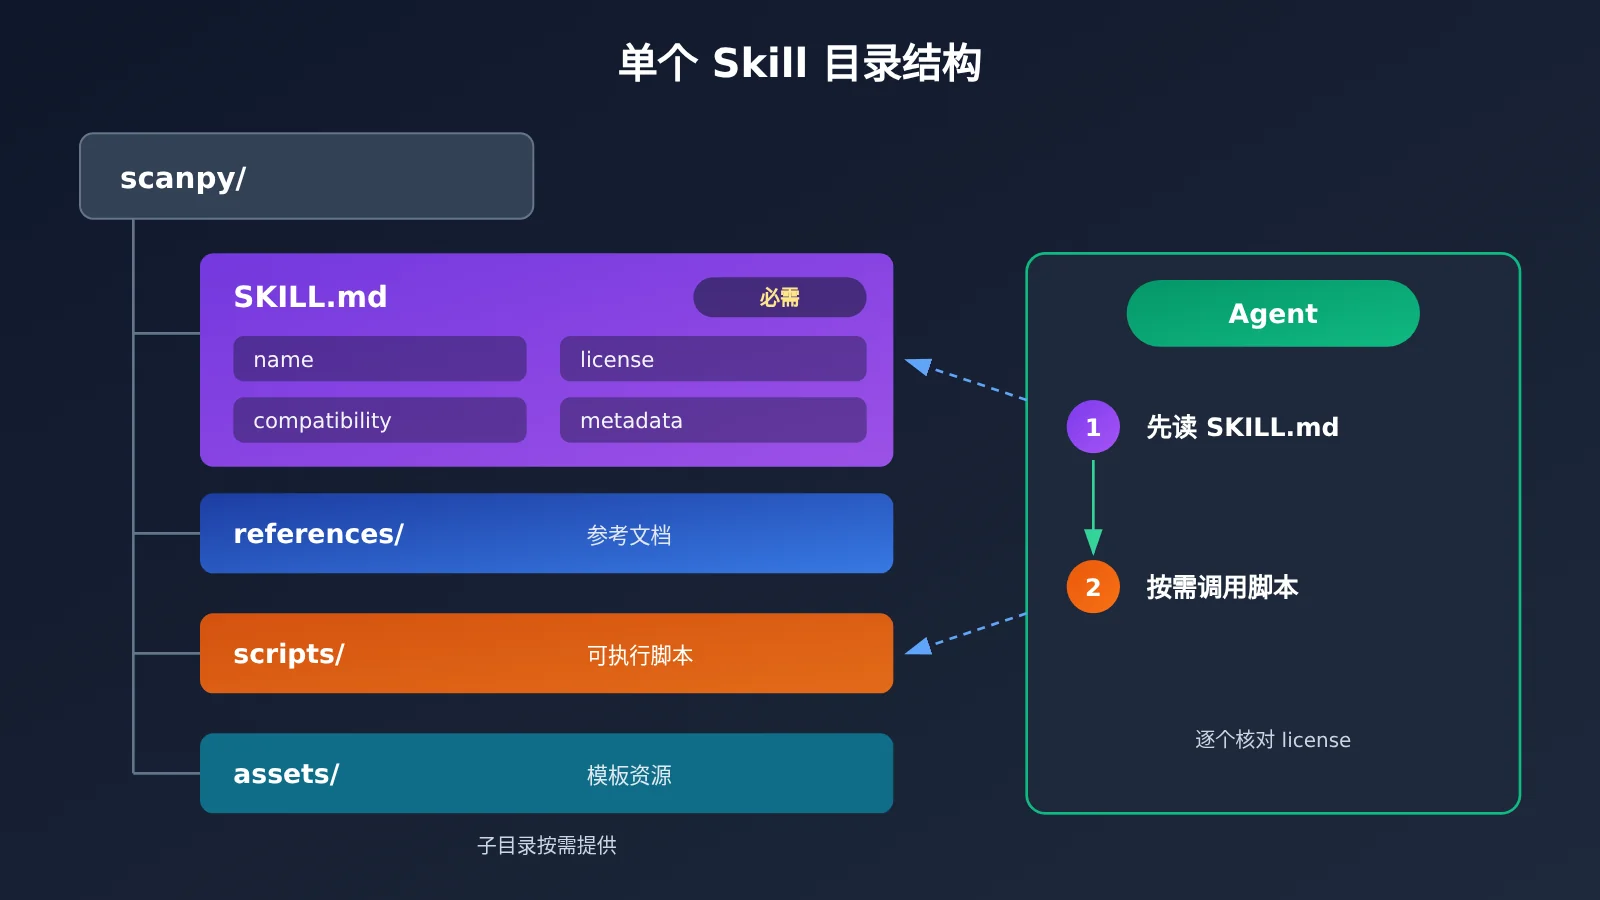
科研 Skills 单个技能的目录结构
每个技能都是一个文件夹,SKILL.md 必须有,references/、scripts/、assets/ 按需提供。以 scanpy 为例,它的 frontmatter 写着 license 为 BSD-3-Clause、Python 3.12+、metadata.version 1.8、last-reviewed 2026-10-01。
这里有个容易忽略的地方:仓库整体是 MIT,但每个技能在 SKILL.md 的 license 字段里写的是自己的许可,可能和仓库不一致。如果要商用或二次分发,请逐个核对。
科研 Skills 5 步接入流程
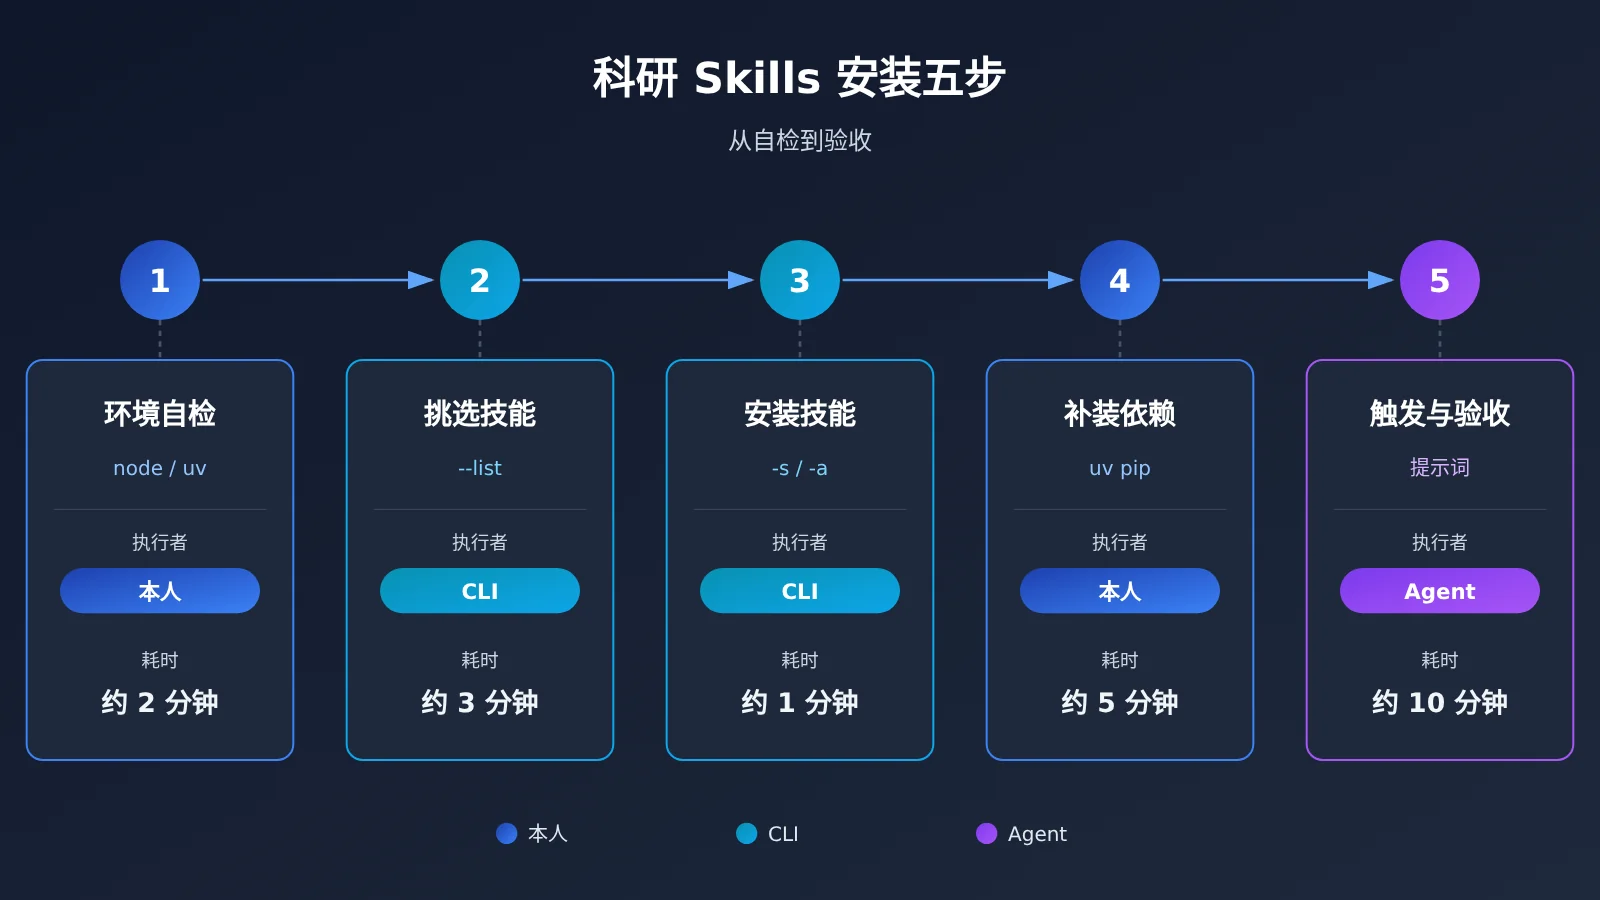
整个接入过程分五步:环境自检 → 看清单挑技能 → 只装需要的 → 补依赖和凭据 → 触发并验收。每一步都会注明是你本人在敲命令、命令行工具在执行,还是 Agent 在执行。
第 1 步:认清科研 Skills 的安装形态和前置条件
耗时:约 5 分钟 前置条件:能打开终端 难度:低(环境都齐的话可以跳过)
要做什么:由你本人逐条运行下面的自检命令,确认自己属于“直接能装”“缺工具要先补”“宿主不支持”中的哪一种。
node -v:安装器npx skills要求 Node.js 22.20 或更高python3 --version:仓库自带的工具链要求 Python 3.13+(单个技能的依赖范围以各自的 compatibility 为准)uv --version:uv 用来安装技能依赖gh --version:只有打算用 GitHub CLI 安装时才需要,版本需在 2.90.0 以上- 系统:macOS、Linux,或者 Windows + WSL2
会看到什么:每条命令输出一个版本号。如果提示 command not found,说明还没装这个工具。
验收标准:Node 版本不低于 v22.20,Python 不低于 3.13,uv 能正常输出版本号,并且你正在用的宿主支持 Agent Skills 标准。安装器 skills(npm 包,vercel-labs/skills,MIT,最新版本 1.7.4)官方支持 70+ 个宿主,常见的有 Claude Code、Cursor、Codex、Gemini CLI、Antigravity、OpenClaw。技能本身不绑定模型:宿主用什么模型由你决定,第 5 步会说到把模型接到 API易 的具体做法。
第 2 步:先列科研 Skills 清单,再决定装哪些
耗时:约 10 分钟 前置条件:第 1 步通过 难度:低(不建议跳过)
要做什么:由你本人运行“只列不装”的命令。命令行工具会把仓库拉下来,读取全部技能的名称和描述,但不会往本机写入任何技能。
npx skills add K-Dense-AI/scientific-agent-skills --list
会看到什么:终端里列出 177 个技能,每个都带有名称和简介。
实测提醒:这一步会先把整个仓库 clone 到本地,仓库体积四百多 MB。网络慢的时候终端会长时间停在 Cloning repository…,超过 300 秒会直接报 Clone timed out。要放宽就用 SKILLS_CLONE_TIMEOUT_MS=600000(10 分钟)再跑一次;或者先自己 git clone 到本地,再对本地目录执行 skills add。
验收标准:你手上有一份 5-10 个技能的候选清单。README 原话就是“Do not install everything at once”,官方也不建议一次全装。技能装得越多,Agent 选技能时干扰越大,需要你审查的代码也越多。
可以按方向这样挑:
- 生信:
scanpy、pydeseq2、database-lookup,做质谱再加pyopenms - 化学信息:
rdkit、database-lookup,做材料方向加pymatgen - 文献与写作:
literature-review、paper-lookup、scientific-writing、peer-review - 数据可视化:
scientific-visualization,涉及时间序列再加timesfm-forecasting - 实验室自动化:这个大类里的具体技能名以
--list的输出为准,流程编排可以先看nextflow
第 3 步:只装需要的科研 Skills
耗时:约 5 分钟 前置条件:已有候选清单 难度:中
要做什么:由你本人运行安装命令,命令行工具负责把技能写进宿主的技能目录。标题里说的“一条命令”指的就是 npx skills add K-Dense-AI/scientific-agent-skills。直接执行它会进入交互模式,让你勾选技能和宿主;如果在交互里选了全部,就等于全装,不推荐这样做。
参数含义:
-s/--skill:指定技能名,'*'表示全部-a/--agent:指定宿主,例如claude-code、codex-g:装到用户目录(全局);不加则装到当前项目--copy:复制文件;默认是软链(Symlink),本机只保留一份副本,更新起来更省事-y:跳过确认,适合脚本或 CI
可以直接复制的非交互命令(以 Claude Code、项目级安装为例,每行装一个技能):
npx skills add K-Dense-AI/scientific-agent-skills -s scanpy -a claude-code -ynpx skills add K-Dense-AI/scientific-agent-skills -s database-lookup -a claude-code -ynpx skills add K-Dense-AI/scientific-agent-skills -s pydeseq2 -a claude-code -y
如果要全局安装,在命令末尾加 -g;想用复制代替软链,就加 --copy。一次装多个技能的写法请以 npx skills add --help 的说明为准。
| 宿主 | 项目级目录 | 全局目录 |
|---|---|---|
| Claude Code | .claude/skills/ |
~/.claude/skills/ |
| Cursor | .agents/skills/ |
~/.cursor/skills/ |
| Codex | .agents/skills/ |
~/.agents/skills/ |
| Gemini CLI | .agents/skills/ |
~/.gemini/skills/ |
| Antigravity | .agents/skills/ |
~/.gemini/antigravity/skills/ |
| OpenClaw | skills/ |
~/.openclaw/skills/ |
项目级和全局怎么选:只跟某个课题相关的技能(比如某个分析项目专用的 pydeseq2)放项目级,方便连同项目一起分享给组里的人;文献、写作这类每天都用的技能放全局。
会看到什么:安装器逐个提示安装成功,并显示目标路径。
验收标准:由你本人运行 npx skills list,或者直接 ls .claude/skills/,确认刚装的技能目录都在,并且每个目录下都有 SKILL.md。
还有两种备选装法:
gh skill install K-Dense-AI/scientific-agent-skills --agent claude-code --pin v2.71.0:用--pin固定到某个版本或 commit SHA,适合需要复现结果的课题git clone到~/.agents/skills/scientific-agent-skills(用户级)或.agents/skills/scientific-agent-skills(项目级)
第 4 步:补齐科研 Skills 的 Python 依赖与凭据
耗时:10-30 分钟(取决于包的大小) 前置条件:技能已装好 难度:中(不能跳过)
要做什么:这一步最容易出问题,所以再强调一遍:装技能文件 ≠ 装依赖。由你本人打开每个技能的 SKILL.md,查看 compatibility 字段,再用 uv 安装依赖。注意,uv sync 只会装仓库自己的开发和校验工具,不会装全部科学计算包。
cat .claude/skills/scanpy/SKILL.md:查看 compatibility,scanpy 技能写的是“测试于 Python 3.13 + Scanpy 1.12.4 + AnnData 0.13.4”uv venv .venv-scrna --python 3.13:一个工作流单独建一个环境,避免单细胞和化学信息的包互相冲突source .venv-scrna/bin/activateuv pip install "scanpy[leiden]"
个别技能需要你自己的 Key。比如 generate-image 走的是 OpenRouter 的图片接口,需要设置 export OPENROUTER_API_KEY=你的Key,而且按次计费。列模型或者加 --dry-run 不收费,建议先用这两种方式试。literature-review 需要联网做 DOI 校验,导出 PDF 还要另装 Pandoc 和 XeLaTeX。
已经在用 API易 的话,生图这块不用另开 OpenRouter 账号:API易 文档里收录了社区贡献的两个 Skills,apiyi-gpt-image-2-gen(官转 gpt-image-2,按 token 计费、支持 4K 和自定义尺寸)和 apiyi-gpt-image-2-all-gen(官逆,按次 $0.025,对话式改图)。装进 Cursor、Codex CLI、Gemini CLI、OpenCode、GitHub Copilot 或 Amp 之后,直接说一句“用 apiyi-gpt-image-2-gen 生成一张 3840×2160 的图”就行,Key 统一走环境变量 APIYI_API_KEY。
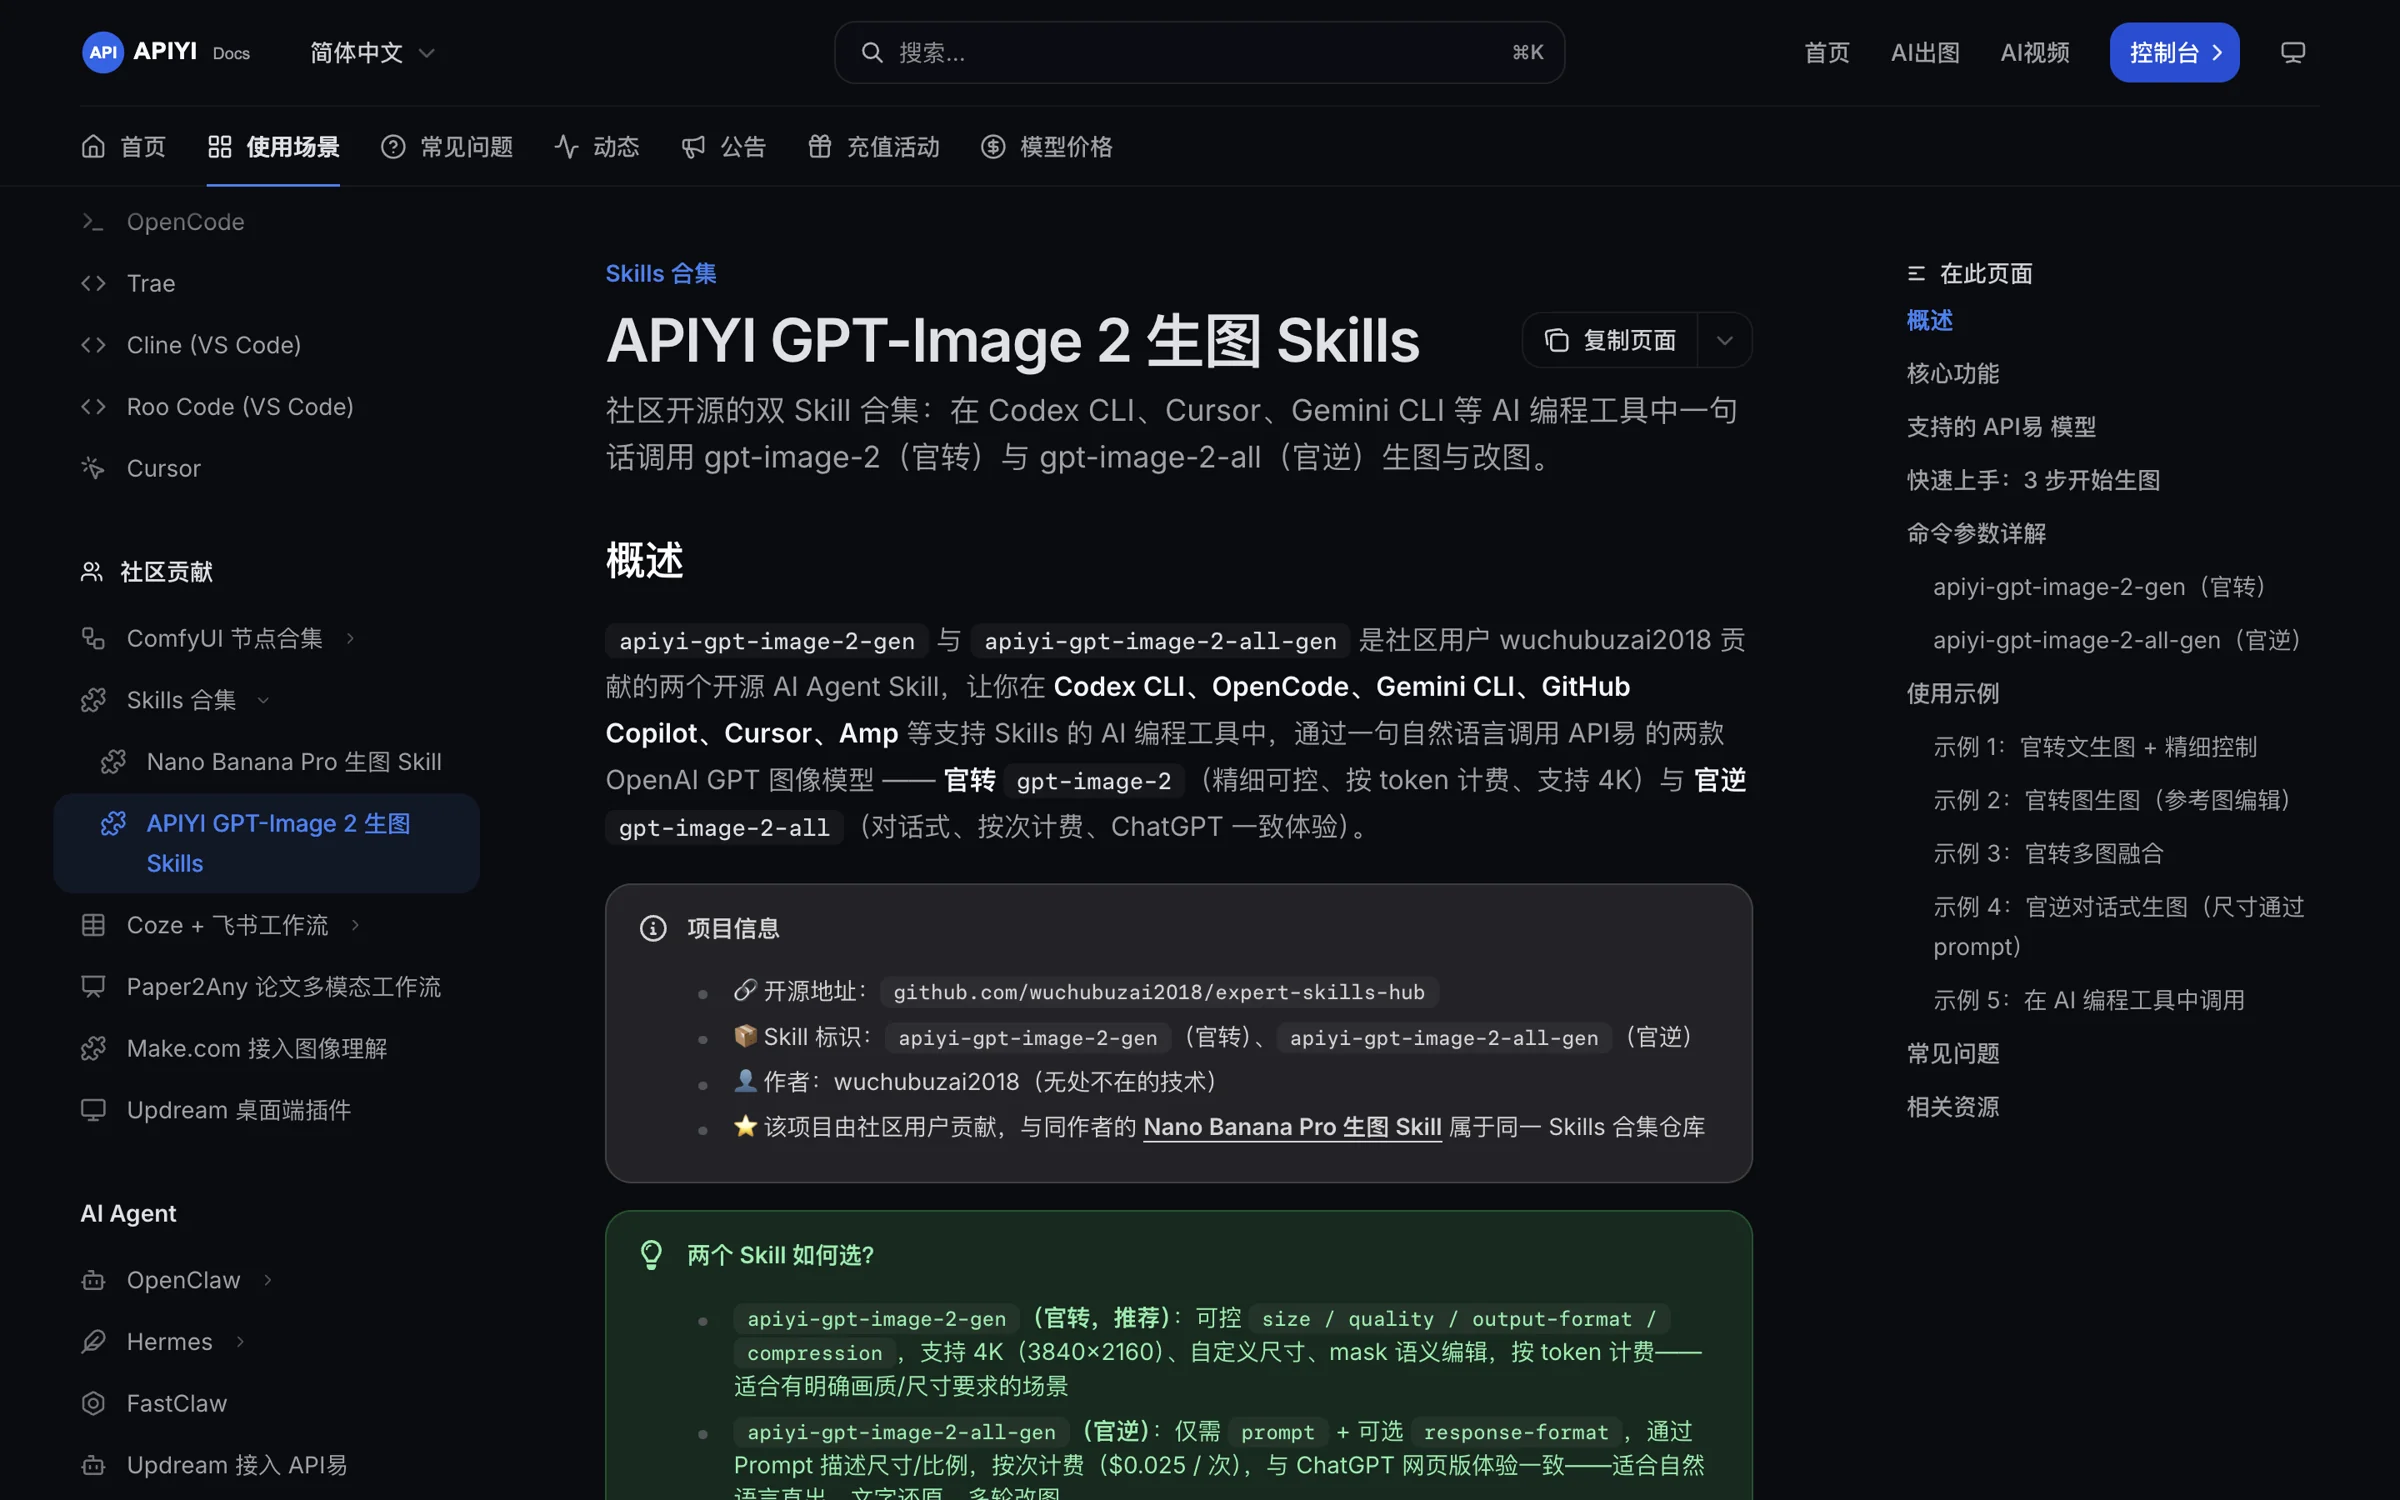
图 3:API易 文档里的 Skills 合集页面,两个生图技能都写明了模型标识、计费方式和安装报错怎么查
会看到什么:uv 打印出解析和安装的包列表。
验收标准:由你本人运行 python -c "import scanpy, anndata; print(scanpy.__version__, anndata.__version__)",输出的版本号能和 compatibility 字段对上。需要 Key 的技能,用 echo $OPENROUTER_API_KEY | head -c 6 确认环境变量已经生效。
第 5 步:触发科研 Skills 并验收结果
耗时:约 10 分钟 前置条件:依赖已装好 难度:低
要做什么:重启宿主,让它重新扫描技能目录。然后由你本人在对话框里输入提示词,后面的工作由 Agent 完成:读取 SKILL.md、执行脚本、生成产物。推荐的提示词写法是“通用开头句 + 点名技能”:
- 开头加一句
Use available skills you have access to whenever possible. - 再点名技能,例如“用 literature-review 技能做一次系统综述”
会看到什么:Agent 的回复里会说明它读取了哪个技能,并给出要执行的命令。
验收标准(三条都要能核对):
- Agent 是否明确说明用了哪个技能。如果没说,就追问一句“你用了哪个 skill”
- 产物落在哪个目录,文件是否真实存在,用
ls自己看一下 - 结果里的数字能否对上来源:DOI 能不能打开,数据库条目的 ID 能不能查到
日常维护命令(由你本人运行):npx skills check 检查更新,npx skills update 执行更新,npx skills remove 卸载。安装器默认会收集匿名使用数据,加上 DISABLE_TELEMETRY=1 或 DO_NOT_TRACK=1 可以关闭。
🎯 跑通之后再算账:技能本身是免费开源的,真正花钱的是执行技能时的模型调用。一次单细胞全流程往往要多轮读文档、写代码、改错,token 消耗不小。如果你的宿主支持自定义 OpenAI 兼容端点,可以把 base_url 设为
https://api.apiyi.com/v1,通过 API易 apiyi.com 用一个 Key 切换 Claude、GPT、Gemini 等模型,对比不同模型跑同一个技能的效果和成本。以 Claude Code 为例,接入就是两行环境变量:ANTHROPIC_BASE_URL指向https://api.apiyi.com,ANTHROPIC_AUTH_TOKEN填你的 Key,配完这些技能照样在 Claude Code 里用。
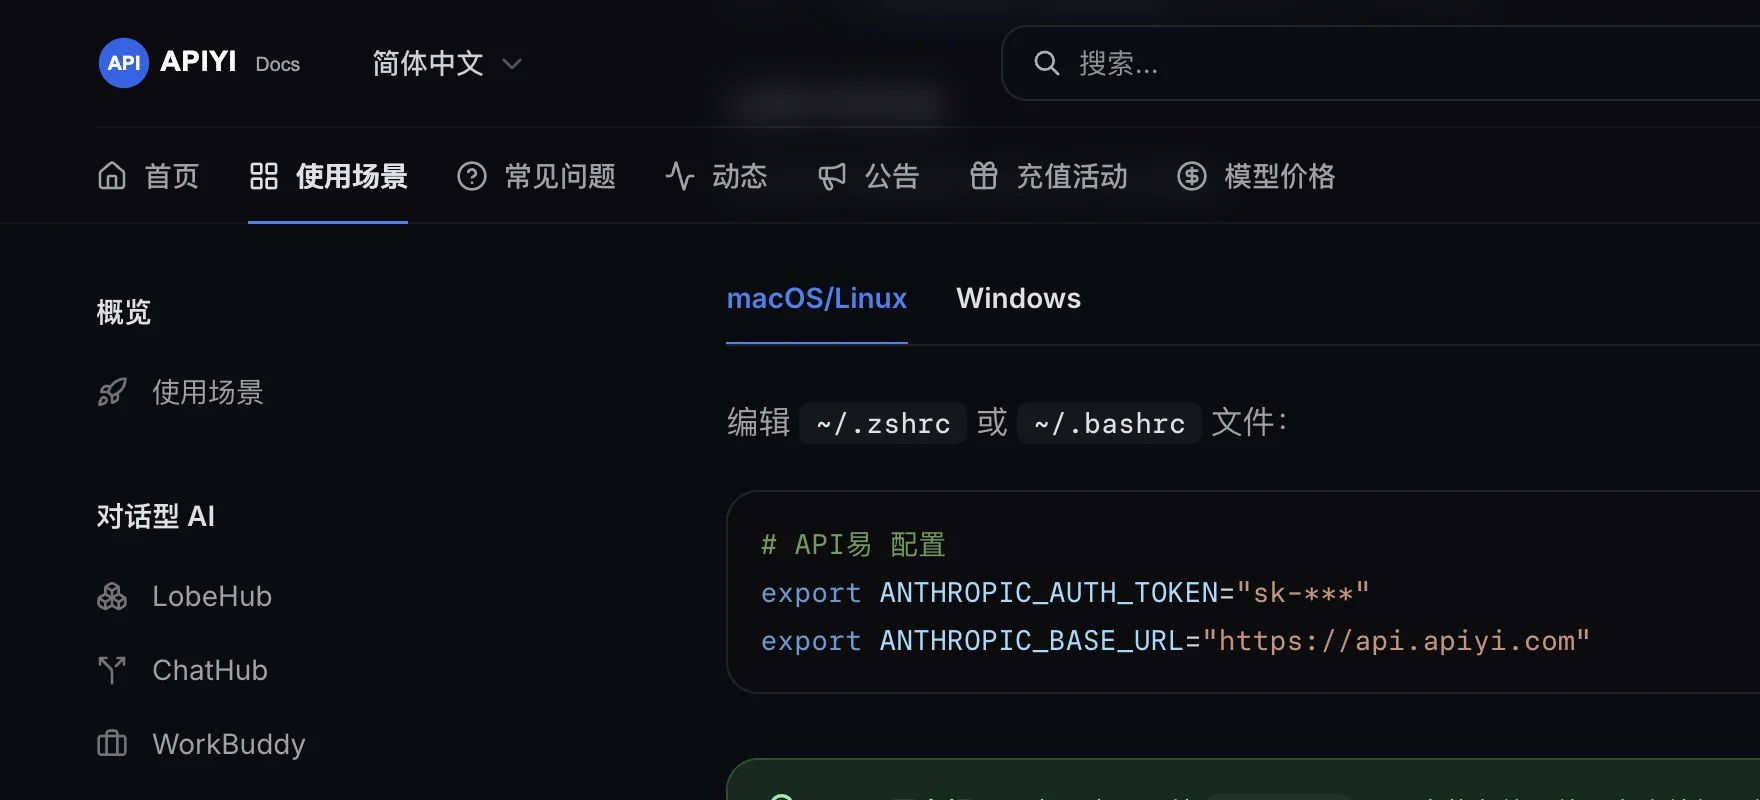
图 4:API易 文档里 Claude Code 的配置,只需要两行环境变量(截图中的 Key 已打码)
| 型号 | 输入 | 输出 | 缓存读 | 可用平台 |
|---|---|---|---|---|
| claude-opus-5-5 | $4 / 百万 tokens | $20 / 百万 tokens | $0.2 / 百万 tokens | API易 apiyi.com |
型号与价格以平台型号列表为准。科研技能的提示词里会反复带上同一份 SKILL.md,缓存读的单价只有输入的二十分之一,长会话里能省下不少费用。
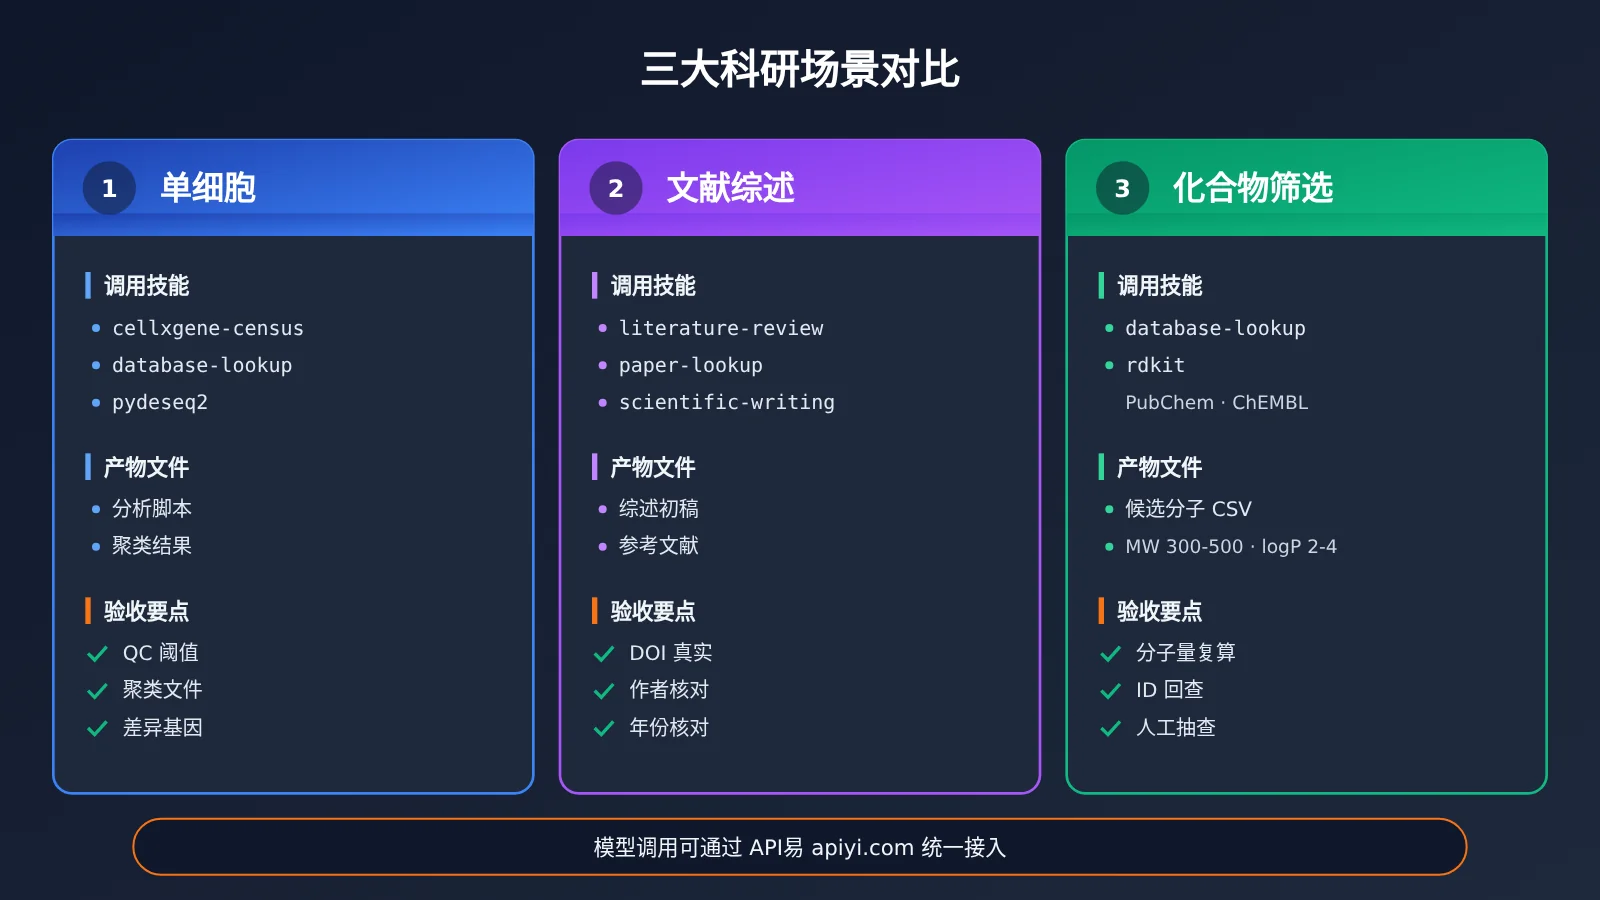
三个科研 Skills 第一次跑通的真实场景
场景一:单细胞分析
提示词:Use available skills you have access to whenever possible. 然后接着写“用 scanpy 做 QC、标准化、降维和聚类,用 cellxgene-census 做细胞类型参考,用 database-lookup 查标记基因,用 pydeseq2 做差异表达”。Agent 会依次读取这几个技能,生成并执行分析脚本。
验收时重点看三处:QC 阈值是否写明,聚类结果文件是否存在,差异基因能否在 database-lookup 返回的数据源里查到。
场景二:文献综述
提示词:“用 literature-review 技能,针对某一具体主题做系统综述,用 paper-lookup 补全文献,最后用 scientific-writing 整理成初稿。”这个技能会联网校验 DOI,所以要逐条打开 DOI,确认文献真实存在、作者和年份没写错。
场景三:化合物筛选
提示词:“用 database-lookup 从 PubChem 和 ChEMBL 拉一批候选分子,用 rdkit 按分子量 300-500、logP 2-4 过滤,并输出 CSV。”验收时由你本人抽查几条:用 RDKit 重新计算分子量,看是否和 CSV 里的一致;再拿化合物 ID 回 PubChem 查一下,确认能对上。
科研 Skills 排错表
| 现象 | 常见原因 | 处理办法 |
|---|---|---|
| 技能不加载 | 目录放错,或技能目录里缺 SKILL.md |
对照第 3 步的目录表检查;改完后重启 IDE;Cursor 在 Settings → Rules 里查看是否被识别 |
| 缺 Python 依赖 | 只装了技能文件,没装依赖 | 按 SKILL.md 的 compatibility 用 uv pip install 安装,并确认当前激活的是对应环境 |
| 数据库限流 | 批量请求过快,或超出免费额度 | 查看该数据库的文档,加缓存、分批请求,降低并发 |
| 认证报错 | Key 未设置、过期或权限不足 | 用 echo 检查环境变量,到对应服务后台核对权限 |
旧路径 scientific-skills/ 返回 404 |
v2.43.0 起技能路径改为 skills/ |
更新本地脚本和书签里的路径,或者重新安装 |
| 想卸载重装 | 版本混乱,或软链失效 | npx skills remove 后重新 npx skills add,需要固定版本时用 gh skill install --pin |
卡在 Cloning repository… 后报 Clone timed out |
仓库体积四百多 MB,300 秒不够 | 用 SKILLS_CLONE_TIMEOUT_MS=600000 再跑,或先 git clone 到本地再用本地路径安装 |
科研 Skills 风险与免责
这一节请认真读完。Scientific Agent Skills 是社区开源项目,不是任何平台的官方 API。我们只做推荐,不为它背书。
技能具备执行能力。技能可以指挥 Agent 执行任意代码、安装包、发起网络请求、修改本机文件。恶意或写得不好的技能,都可能把 Agent 带偏。建议的做法如下:
- 装之前先读
SKILL.md,看清它用了哪些包、连了哪些外部服务 - 查看贡献历史:K-Dense-AI 署名的技能经过了内部评审,社区贡献的只能做到“尽力评审”
- 自己再扫描一遍:先运行
uv pip install cisco-ai-skill-scanner,再运行skill-scanner scan <path> --use-behavioral,其中<path>换成技能目录。官方每周做增量扫描,至少每 30 天全量重扫一次,结果公开在docs/security-report.md
第三方服务约束。部分技能需要注册第三方数据库,或使用你自己的 Key,这时要遵守这些服务的条款和额度限制。批量抓取可能被限流,甚至被封号,建议先用小号或在隔离环境里测试。
临床与法规边界。临床、医疗、法规类技能只能用于研究和起草,不能替代诊断、放行或认证决定。
责任归属。使用这些技能产生的一切后果,由使用者自行判断并承担,与本平台和本文作者无关。
常见问题 FAQ
Q1:Scientific Agent Skills 到底是什么?
它是 K-Dense-AI 维护的科研技能库,共 177 个遵循 Agent Skills 标准的技能文件夹,用来告诉 Agent 某个科研流程该怎么做、要调哪些包、连哪些数据库。它不是模型,也不是 API 服务。
Q2:为什么不建议一条命令把 177 个科研 Skills 全装上?
一是官方 README 明确写了不要一次全装;二是技能装得越多,Agent 越难选准该用哪个;三是每个技能都能执行代码,装得越多,需要审查的内容也越多。按方向挑 5-10 个就够用了。
Q3:为什么现在是 177 个,而不是 181 个?
从 2.72.0 开始,docx、pdf、pptx、xlsx 四个文档技能不再随仓库分发。需要的话,去 Anthropic 的 skills 仓库另装。
Q4:技能是免费的,那费用主要花在哪里?
主要花在执行技能时的模型调用上,有些技能还会产生第三方服务的费用,比如 `generate-image` 走 OpenRouter 按次计费。模型这部分可以通过 API易 apiyi.com 按量计费调用,没有固定月费,适合先拿一个小流程测一下 token 消耗,再决定长期用哪个型号。
Q5:我在 Cursor 里装好了,但 Agent 不调用技能怎么办?
先在 Settings → Rules 里确认技能已被识别,再在提示词开头加上 `Use available skills you have access to whenever possible.`,并直接点名技能。如果还是不调用,可以换一个模型对比试试。通过 API易 apiyi.com 一个 Key 就能切换多种模型,排查起来比较省事。
Q6:怎么保证科研结果可复现?
用 `gh skill install –pin` 把技能固定到某个版本或 commit;Python 依赖写死在独立的 uv 环境里;同时记下 `SKILL.md` 里的 metadata.version 和 last-reviewed 日期。
Q7:这些技能的许可都是 MIT 吗?
不一定。仓库整体是 MIT,但每个技能有自己的 license 字段,例如 `scanpy` 是 BSD-3-Clause。商用前请逐个核对。
科研 Skills 核心要点 Key Takeaways
- 是什么:177 个开源科研技能,覆盖 README 列出的 22 个大类
- 怎么装:先用
--list查看清单,再用-s和-a只装需要的 - 前置条件:Node.js 22.20+、Python 3.13+、uv,以及支持 Agent Skills 标准的宿主
- 最常踩的坑:装技能文件不等于装依赖,每个工作流单独建一个 uv 环境
- 怎么验收:确认用了哪个技能、产物在哪个目录、数字能否对上来源
- 安全:装前读
SKILL.md,并用 Cisco 扫描器扫一遍 - 成本:技能免费,模型调用可通过 API易 apiyi.com 统一接入并对比
总结
这 177 个科研 Skills 很好用,但要按顺序来,不要贪多:
- 先自检再安装:先确认环境版本和宿主支持,再用
--list挑出 5-10 个技能 - 装技能和装依赖分开做:技能文件用
npx skills add安装,Python 依赖用 uv 安装,两步都要做 - 结果要能核对:每次运行都检查用了哪个技能、产物在哪里、数字从哪里来
建议先拿一个最熟悉的小流程(比如对一份小数据集做 scanpy 聚类)完整走一遍,再逐步加技能。模型侧推荐通过 API易 apiyi.com 按量计费先跑通,再根据 token 消耗决定长期用哪个型号。
📚 参考资料
- Scientific Agent Skills 仓库:技能源码、README 与安全报告
- 链接:
github.com/K-Dense-AI/scientific-agent-skills -
说明:包含 177 个技能、安装方式、排错说明和
docs/security-report.md -
skills 安装器:npx skills 的命令与参数说明
- 链接:
github.com/vercel-labs/skills -
说明:查看 add / list / check / update / remove 等命令,以及 70+ 宿主的目录对照
-
Anthropic Skills 仓库:docx、pdf、pptx、xlsx 文档技能
- 链接:
github.com/anthropics/skills -
说明:2.72.0 之后需要单独到这里安装这四个文档技能
-
配套论文:Scientific Agent Skills: A Library of Procedural Knowledge for Research Agents
- 链接:
arxiv.org/abs/2609.00065 -
说明:了解技能库的设计思路
-
API易 文档 · Claude Code 接入:环境变量、分组与故障排除
- 链接:
docs.apiyi.com/scenarios/programming/claude-code -
说明:用两个环境变量把 Claude Code 接到 API易,技能装好之后就在这里把模型跑起来
-
API易 文档 · GPT-Image 2 生图 Skills:社区贡献的两个生图技能
- 链接:
docs.apiyi.com/scenarios/ecosystem/apiyi-gpt-image-skills -
说明:
apiyi-gpt-image-2-gen与apiyi-gpt-image-2-all-gen的参数、计费与常见报错 -
API易 模型价格总表:型号、类型、计费方式与单价
- 链接:
docs.apiyi.com/models - 说明:本文引用的 claude-opus-5-5 单价以这张表为准,价格会变,用前请再核对
作者:API易 技术团队
技术交流:欢迎在 API易 网站首页联系我们,更多模型接入资料可访问 docs.apiyi.com 文档中心