作者注:名字里都带 Flash,但输入模态、端点和分组倍率各不相同。本文按“先看型号页、再对价格、按任务选”的顺序,讲清 Flash 模型怎么选。
很多人选 Flash 级模型的方式是:名字里有 Flash,就当成“又快又便宜”,然后编码、看图、算公式都交给同一款。这样做的问题是,名字里带 Flash 的模型,输入模态和可用端点并不一样。有的只吃文本,有的能读图像和视频,有的连 /v1/messages 都走不通。
这不是一份“谁最强”的排行榜。 本文不宣布哪一款全面更强或更便宜,只给出一套可执行的 Flash 模型选型步骤:先看型号页写的输入种类和用途,再对输入价、输出价和缓存读,最后按任务落到具体型号。
核心价值:读完本文,你能根据自己的输入类型(纯文本、图表截图、长视频)选出模态对得上的 Flash 模型。你也会知道哪些重推导任务不该默认交给 Flash。
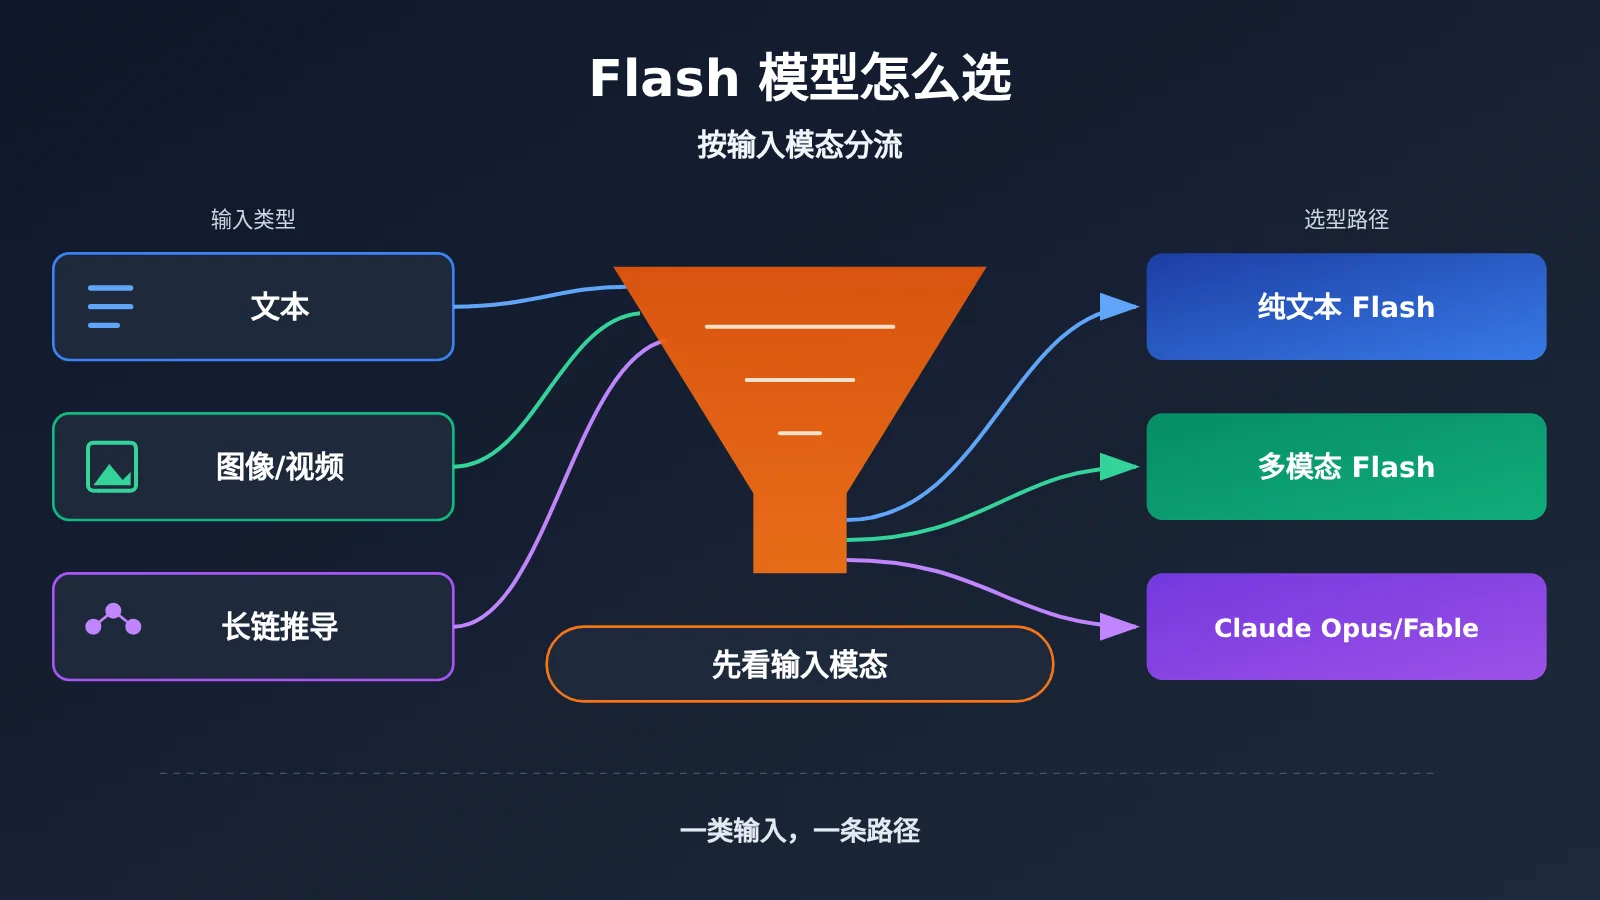
Flash 模型怎么选的核心要点
| 要点 | 说明 | 价值 |
|---|---|---|
| 先看输入模态 | 型号页写的输入种类(文本/图像/视频/音频)决定能不能接你的数据 | 避免把截图发给只吃文本的模型 |
| 再看端点 | chat、messages、gemini 端点各型号支持情况不同 | 避免换模型后接口直接报错 |
| 对三项价格 | 输入价、输出价、缓存读要一起看,再乘分组倍率 | 账单预估更接近实际 |
| 按任务分流 | 读图表、改短代码用模态对得上的 Flash | 跑量任务成本可控 |
| 重推导另选 | 公式、证明、长链技术活不默认 Flash | 难题交给定位更高的模型 |
为什么 Flash 模型不能按名字一刀切
“Flash”只是厂商给一档模型起的名字,各家对它的定义并不统一。从 API易 模型页(docs.apiyi.com/models.md)可以看到,同样叫 Flash 的几款模型,输入模态从“仅文本”到“文本、图像、视频、音频”都有。端点也从“chat 加 messages”到“只有 chat”不等。
所以选 Flash 模型时,名字只能帮你圈定“这是一档偏跑量、偏低延迟的模型”。真正决定能不能用的是型号页上的三栏信息:输入种类、支持端点、分组倍率。下文的所有数据都来自型号页和模型总表。核对日期为 2026-11-17,总表数据更新于 2026-11-16 09:39(UTC+8),价格单位是每百万 token 的默认标价。
Flash 模型输入模态与端点对照
下面这张表把几款 Flash 模型的输入模态和端点放在一起。选型的第一步就是在这里排除“模态对不上”和“端点对不上”的型号。
| 模型 ID | 输入模态 | 输出 | 端点 | 型号页其他说明 |
|---|---|---|---|---|
deepseek-v4-flash |
仅文本 | 文本 | chat、messages | 结构化输出不支持;支持工具调用、可选深度思考、提示词缓存 |
deepseek-v4.1-flash |
无单独型号页 | — | chat、messages | 仅总表一行,能力以官方后续说明为准 |
gemini-3.8-flash |
文本、图像、视频、音频 | 文本 | chat、gemini(无 messages) | 深度思考默认开启,思考档位 low/medium/high;官方规格尚未公布 |
qwen3.8-flash |
文本、图像、视频 | 文本 | 仅 chat | 上下文 1,000,000,最大输出 131,072 |
glm-5.3-flash |
文本、图像、视频 | 文本 | 仅 chat | 上下文 1,000,000,最大输出 128,000;深度思考默认开启 |
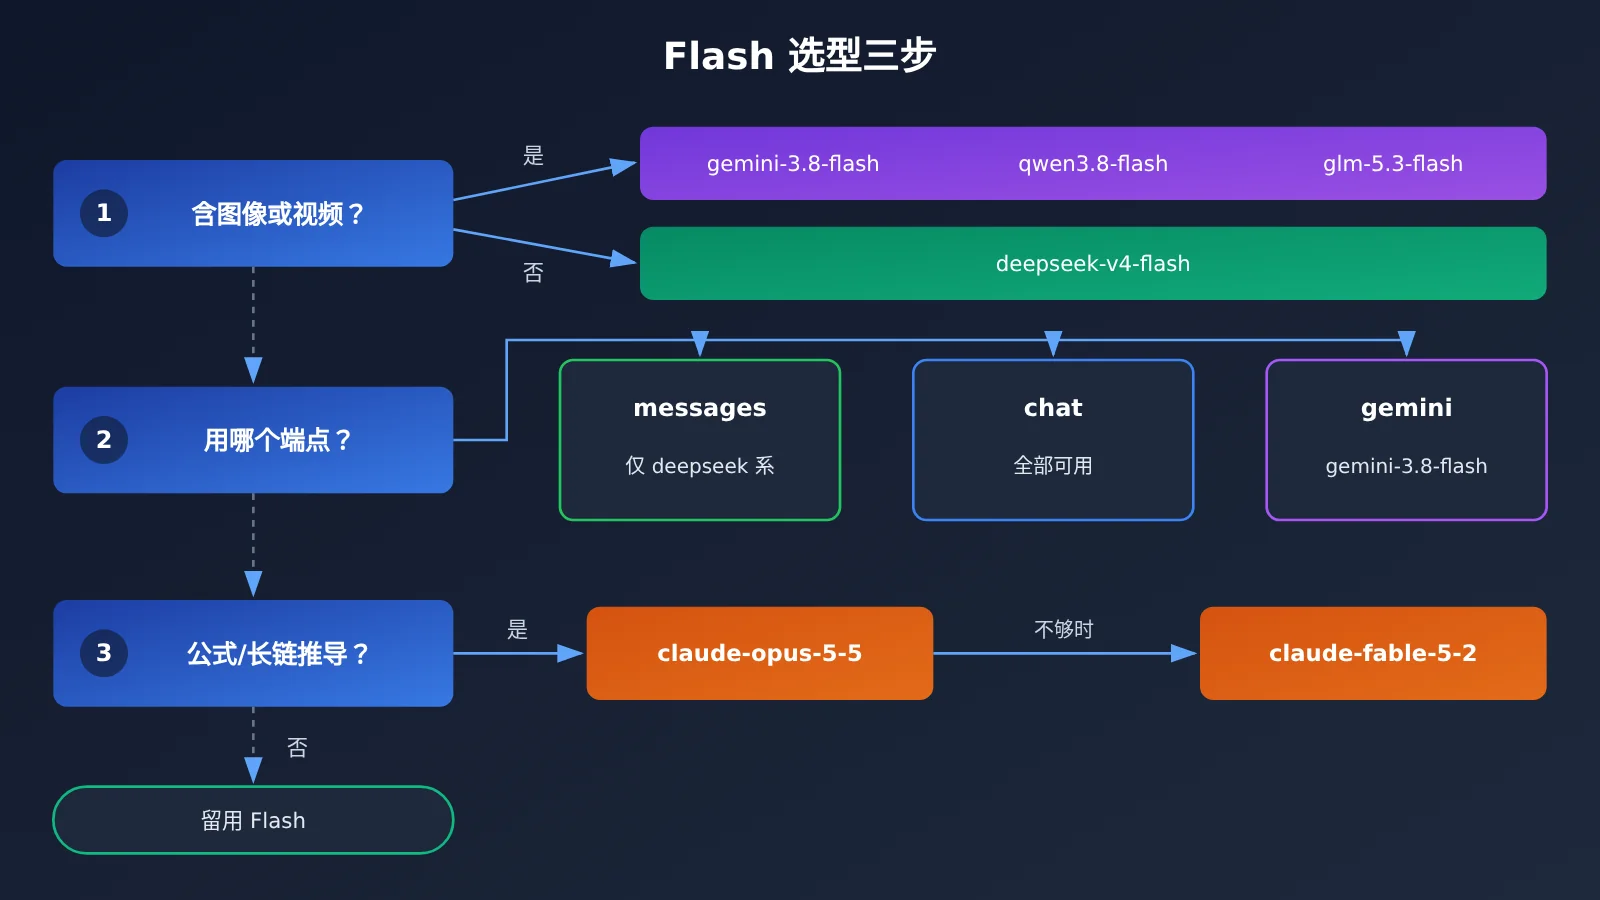
有两点需要特别注意。第一,deepseek-v4-flash 的“仅文本”、上下文 1,048,576 和最大输出 393,216 都是 v4 型号页的数据,不能挪到 deepseek-v4.1-flash 上。v4.1 目前只有总表一行,能力写不清就不要假设。第二,如果你的项目用的是 Anthropic 风格的 /v1/messages 接口,几款多模态 Flash 都走不通,需要改用 chat 端点。
Flash 模型价格与分组怎么对
模态和端点过关后,再对价格。换模型会直接改账单,而且标价不等于实际扣费,因为 API易 apiyi.com 的令牌分组带有倍率。下表列出默认标价和型号页标注的分组。
| 模型 ID | 输入价 | 输出价 | 缓存读 | 分组与倍率 |
|---|---|---|---|---|
deepseek-v4-flash |
$0.44 | $1.32 | $0.01408 | ClaudeCode 0.95×;CodexResponses、Default、SVIP 1× |
deepseek-v4.1-flash |
$0.3 | $1.2 | $0.006 | ClaudeCode、CodexResponses、Default、SVIP |
gemini-3.8-flash |
$0.75 | $3.75 | $0.075 | Gemini_Reverse 0.5×;Default、SVIP 1× |
qwen3.8-flash |
$0.114 | $0.3876 | $0.01425 | Default、SVIP 1× |
glm-5.3-flash |
$0.15 | $0.5 | $0.03 | CodexResponses、Default、SVIP |
claude-opus-5-5 |
$4 | $20 | $0.2 | 见模型总表 |
claude-fable-5-2 |
$8 | $40 | $0.2 | 无 Claude_Reverse 分组 |
Flash 模型账单的三个对账点
本文不替你下“谁更便宜”的结论,因为实际成本取决于你的输入输出比例和缓存命中率。建议按下面三步自己对账:
- 看输入输出比例:看图、读文档类任务输入大、输出小,输入价权重更高;生成长代码、长报告类任务输出价权重更高。
- 看缓存读:系统提示词固定、反复调用的场景,缓存读价格会显著影响总账单。
- 乘分组倍率:同一个
gemini-3.8-flash,走 Gemini_Reverse 分组按 0.5× 结算,走 Default 按 1× 结算,账单不是同一个数。
💰 成本建议:令牌绑定哪个分组会直接改变扣费结果。切换模型前,先到 API易 apiyi.com 控制台确认当前令牌的分组,再用上表标价乘以倍率估算,避免上线后才发现账单变化。
按任务选 Flash 模型
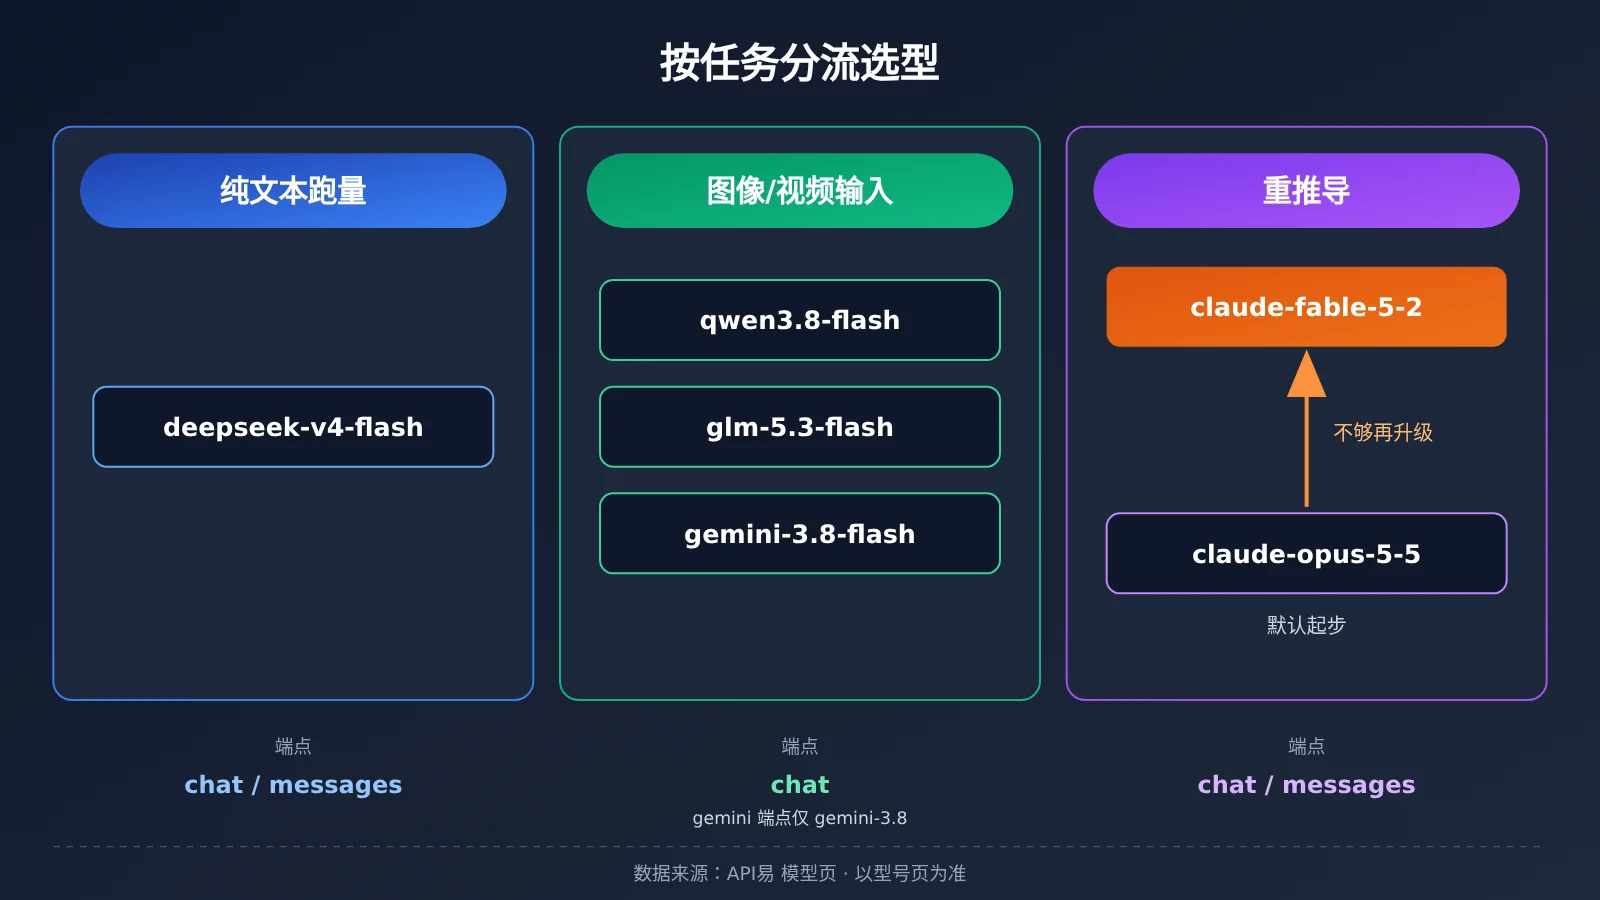
对完模态、端点和价格,就可以按任务落地。下表是一份按任务给出的选型思路。其中的分工是基于型号页信息的判断,具体能力以型号页为准。
| 任务类型 | 输入特征 | 候选模型 | 选择依据 |
|---|---|---|---|
| 改短代码、高并发文本处理 | 纯文本 | deepseek-v4-flash |
型号页原文写主打高并发低延迟;支持 messages 端点 |
| 看截图改代码、读图表 | 文本 + 图像 | qwen3.8-flash、glm-5.3-flash、gemini-3.8-flash |
输入模态包含图像,支持视觉理解 |
| 文档与长视频分析 | 文本 + 视频 | qwen3.8-flash、glm-5.3-flash、gemini-3.8-flash |
输入模态包含视频;qwen 型号页原文点名此类跑量场景 |
| 含音频的输入 | 文本 + 音频 | gemini-3.8-flash |
几款中只有它的型号页写了音频输入 |
| 公式、证明、长链技术活 | 重推导 | claude-opus-5-5 → claude-fable-5-2 |
四份 Flash 型号页都没把科学计算写成专项 |
编码任务的 Flash 模型选择
如果输入只有代码和文字说明,模态对得上的是 deepseek-v4-flash。它的型号页原文写的是“284B 总参、13B 激活的 MoE,主打高并发低延迟”,这是型号页原文,不是本文测得的数据。它同时支持 chat 和 messages 端点,接入 Anthropic 风格客户端时改动最小。需要注意,它的结构化输出一栏标的是不支持,如果你依赖 JSON Schema 约束输出,要另作处理。
如果编码任务带截图,比如“照着这张设计稿改前端”,就要换到多模态 Flash。qwen3.8-flash 型号页原文写“适合视觉编码、文档与长视频分析这类跑量场景”。glm-5.3-flash 型号页原文写 320B 总参数、18B 激活,并写 Terminal-Bench 2.1 得分 84.3。这两组数字都是型号页原文,不是本文实测,也不意味着它全面强过其他几款。
看图与长视频的 Flash 模型选择
读图表、解析 PDF 截图、分析长视频,三款多模态 Flash 的模态都对得上。区别主要在端点和功能栏:gemini-3.8-flash 额外支持音频输入和代码执行,并可走 gemini 端点;qwen3.8-flash 和 glm-5.3-flash 只有 chat 端点。gemini-3.8-flash 和 glm-5.3-flash 的深度思考默认开启,对延迟敏感的跑量任务要留意这一点。
重推导任务不默认 Flash 模型
这里需要说清楚边界:Flash 并非完全不能做计算,只是四份型号页都没有把科学计算、证明或物理写成专项,所以不该默认把这类任务交给它。Anthropic 在 2026-11-09 的公告中把 Claude Fable 5.2 定位在最难的技术工作上,并建议多数编码和知识任务从 Opus 5.5 起步,不够再上 Fable。
两款在 API易 都已上架,模型 ID 分别是 claude-opus-5-5 和 claude-fable-5-2。它们的标价明显高于 Flash 档,所以更合理的做法是分流:跑量任务走 Flash,只有公式推导、证明、长链技术分析才升级。
Flash 模型快速上手
确定型号后,接入步骤很简单。API易 提供 OpenAI 兼容接口,一个 API Key 即可调用上面所有模型。下面按 help 文档的方式列出配置要点。
第一步:配置 Flash 模型的 base_url 与端点
- 在客户端把 base_url 设为
https://api.apiyi.com/v1,API Key 填你在控制台创建的令牌。 - 根据型号选择路径:所有型号都可以走
/v1/chat/completions;只有deepseek-v4-flash(以及总表标注的deepseek-v4.1-flash)可以走/v1/messages;gemini-3.8-flash还可以走 gemini 端点。 - 在请求体的
model字段填入模型 ID,例如qwen3.8-flash。
第二步:按输入模态组织 Flash 模型请求
- 纯文本:
messages里放role和文本content即可,适用于deepseek-v4-flash。 - 带图像:在 chat 格式里把
content写成数组,文本项用type为text,图片项用type为image_url。只发给支持图像输入的型号。 - 开启流式:设置
stream为true,适合高并发、需要首字快速返回的场景。
第三步:切换 Flash 模型前的检查清单
- 新型号是否支持你当前用的端点?messages 用户换到多模态 Flash 时,必须改走 chat。
- 新型号是否支持你依赖的功能?例如结构化输出在
deepseek-v4-flash上标为不支持。 - 当前令牌分组下,新型号的倍率是多少?
🚀 快速开始:建议先在 API易 apiyi.com 用新用户免费测试额度,把同一批真实输入分别发给两三款候选 Flash 模型,对比输出质量和 token 用量,再决定正式切换。只需修改
model字段即可在不同型号间切换。
常见问题 FAQ
Q1: Flash 模型是什么意思?
Flash 是厂商给偏跑量、偏低延迟一档模型起的名字,并不是统一标准。不同厂商的 Flash 在输入模态、端点、功能支持上差异很大,选型要看型号页,不能只看名字。
Q2: deepseek-v4-flash 和 deepseek-v4.1-flash 能互相替换吗?
不能直接假设。v4.1 目前只有总表一行:输入 $0.3、输出 $1.2、缓存读 $0.006,端点 chat 与 messages。v4 的参数量、上下文和“仅文本”都不能套到 v4.1 上,替换前请以总表和后续型号说明为准。
Q3: 为什么我的 Claude 风格客户端调不通 gemini-3.8-flash?
因为 `gemini-3.8-flash` 的端点是 chat 和 gemini,没有 messages。`qwen3.8-flash` 和 `glm-5.3-flash` 也只有 chat。需要 messages 端点的话,候选只剩 deepseek 系 Flash。
Q4: 同一个模型为什么不同令牌扣费不一样?
因为分组倍率不同。例如 `gemini-3.8-flash` 在 Gemini_Reverse 分组是 0.5×,在 Default 是 1×。令牌与分组的关系可参考 API易 文档 docs.apiyi.com/faq/token-and-groups.md。
Q5: 如何通过 API 快速调用这些 Flash 模型?
在 API易 apiyi.com 注册并创建令牌,把 base_url 设为 `https://api.apiyi.com/v1`,按型号选择 chat 或 messages 路径,`model` 填对应 ID 即可。新用户有免费测试额度,可先小批量验证。
Q6: Flash 模型能不能做数学推导或科学计算?
能处理一般计算,但几份型号页都没有把科学计算、证明或物理写成专项。公式、证明、长链技术活建议从 `claude-opus-5-5` 起步,不够再升级到 `claude-fable-5-2`。
Q7: 型号页上的 Terminal-Bench 分数可以直接当选型依据吗?
`glm-5.3-flash` 型号页原文写 Terminal-Bench 2.1 得分 84.3,这是型号页原文,不是本文实测。它可以作为参考信号,但不代表该模型在所有任务上更强,最终仍建议用自己的真实数据验证。
Flash 模型选型 Key Takeaways
- 名字不等于能力:带 Flash 的模型,输入模态和端点各不相同。
- 第一步看模态:纯文本选
deepseek-v4-flash,带图像视频选多模态 Flash。 - 第二步看端点:messages 只有 deepseek 系支持,多模态 Flash 多数只走 chat。
- 第三步对账单:输入价、输出价、缓存读一起看,再乘分组倍率。
- 型号页数字要标来源:参数量、Terminal-Bench、“适合视觉编码”都是型号页原文。
- 重推导不默认 Flash:公式证明从
claude-opus-5-5起,不够再上claude-fable-5-2。 - 切换前小批量验证:在 API易 用免费额度跑真实输入,再决定正式切换。
总结
Flash 模型怎么选,核心就是一句话:按输入模态对,不按名字一刀切。
- 先看型号页:确认输入种类、端点和功能支持,排除对不上的型号。
- 再对价格:输入价、输出价、缓存读结合你的调用比例看,并乘上令牌分组倍率。
- 按任务分流:跑量的读图表、改短代码交给模态对得上的 Flash,重推导任务交给 Claude Opus 5.5 或 Fable 5.2。
价格和能力都会更新,选型时以当天的型号页为准。建议在 API易 apiyi.com 用同一个 API Key 对几款候选模型做小批量对比,再根据自己的账单和输出质量做决定。
📚 参考资料
-
Anthropic 公告 – Claude Fable 与 Mythos 5.2:Fable 5.2 的定位与 Opus 5.5 起步的使用建议
- 链接:
anthropic.com/claude-fable-and-mythos-5-2 - 说明: 了解重推导任务的模型分工依据
- 链接:
-
Claude 模型总览:Anthropic 官方模型列表与用法说明
- 链接:
platform.claude.com/docs/en/about-claude/models/overview - 说明: 与公告一致的 Opus 与 Fable 使用建议
- 链接:
-
API易 模型总表与型号页:价格、分组、端点与输入模态
- 链接: 文档中心 models.md 及各型号页(deepseek-v4-flash、gemini-3-8-flash、qwen3-8-flash、glm-5-3-flash)
- 说明: 本文所有价格与能力数据的来源,选型前请以最新版本为准
作者: APIYI 技术团队
技术交流: 欢迎在 API易 网站首页联系我们,更多模型与分组说明可访问 docs.apiyi.com 文档中心