
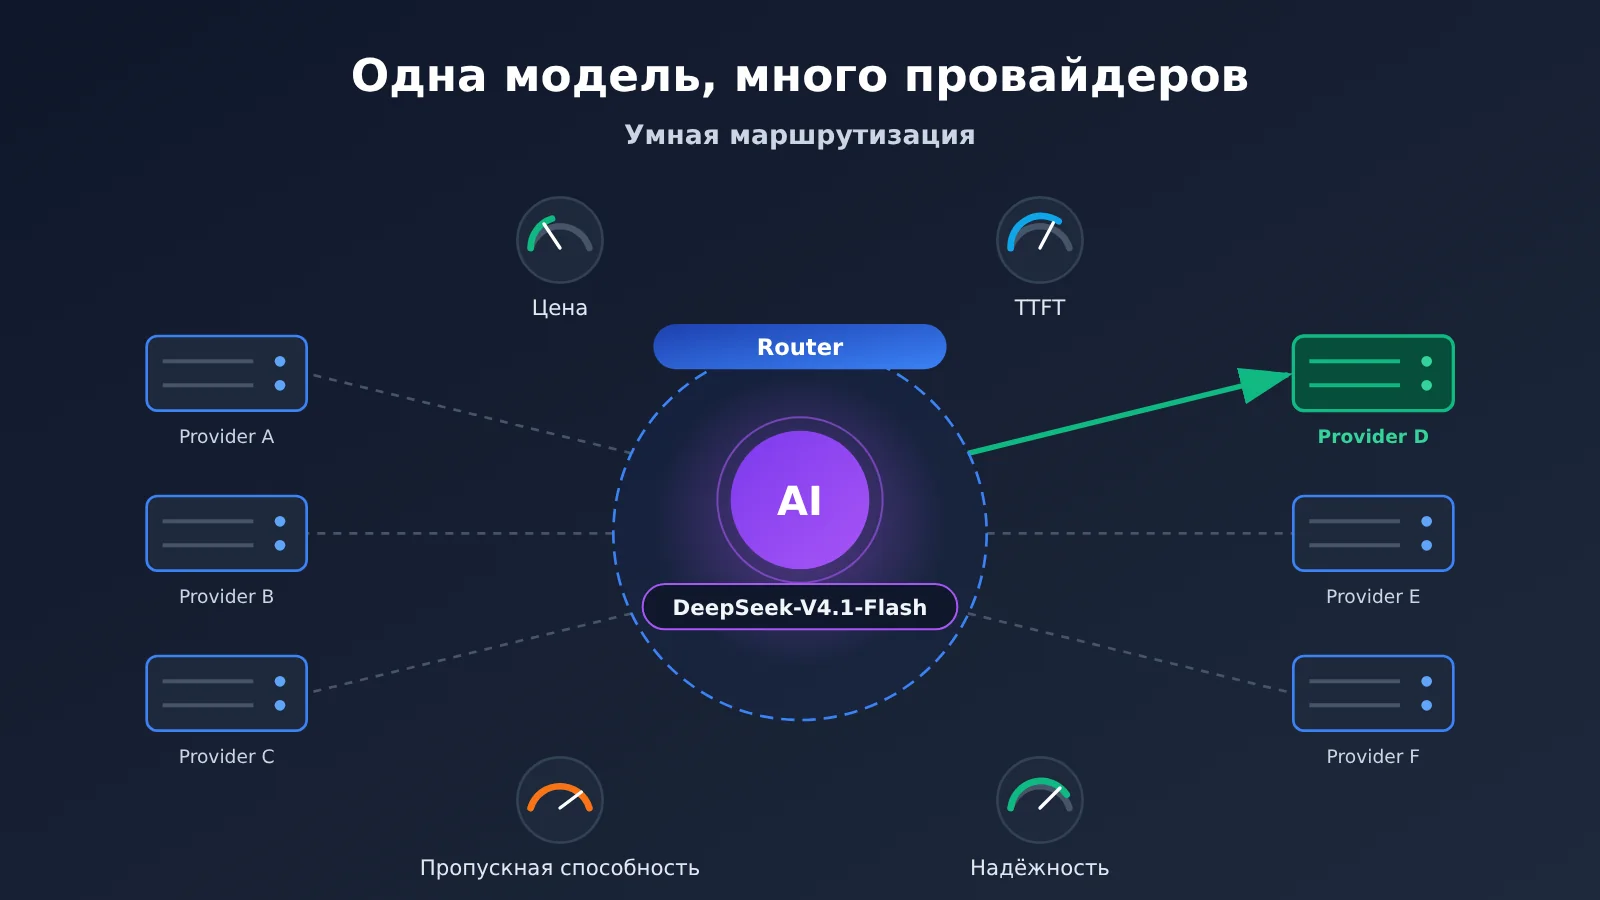
Прямой ответ: одну и ту же модель с открытыми весами могут развернуть у себя многие провайдеры инференса — отсюда и десятки API-провайдеров. OpenRouter смотрит не только на самую низкую цену в прайсе, а на совокупную стоимость одного успешного ответа. Он одновременно оценивает 6 показателей — фактическую эффективную цену, задержку до первого токена, пропускную способность, ограничения частоты запросов, надёжность и качество ответа, — а затем отправляет запрос самому подходящему на тот момент провайдеру, а при сбое пробует другого.
Это значит, что конкуренция среди агрегаторов AI API уже вышла за пределы «предоставить единый интерфейс» и сместилась к «динамическому распределению запросов между провайдерами». 16 ноября 2026 года Hugging Face объявила, что маршрутизацию языковых моделей в Inference Providers теперь выполняет OpenRouter. Это сотрудничество даёт конкретный пример: по нему видно, как такие показатели превращаются в механизм автоматического выбора провайдера.
Что вы узнаете из этой статьи?
- Почему у одной и той же AI-модели появляется несколько API-провайдеров и чем разработчик модели отличается от провайдера инференса
- На какие метрики опирается маршрутизация между провайдерами и какую задачу решает каждая из них
- Что умеет fallback при сбоях и какие у него ограничения
- Как самостоятельно сравнивать провайдеров по метаданным API каталога моделей Hugging Face
Структура статьи: часть с фактами идёт в таком порядке: сначала объясним, откуда берутся несколько API-провайдеров, затем разберём, что именно решает умная маршрутизация и какие 6 показателей она учитывает, потом расскажем, как работает переключение при сбоях и какие у него ограничения, и в конце покажем, как разработчику самому сравнивать провайдеров через интерфейс каталога. По ходу добавим опубликованные OpenRouter данные экспериментов с маршрутизацией и изменения в тарификации. В аналитической части обсудим, куда дальше будет смещаться конкуренция среди агрегаторов API и как разработчику выбирать и проверять решения в реальном приложении.
Что важно знать о нескольких API-провайдерах и маршрутизации Provider
| Понятие | Краткое объяснение |
|---|---|
| Provider | Поставщик, который разворачивает модель и фактически предоставляет сервис инференса, например Together AI, Novita |
| Router | Слой маршрутизации, который решает, куда направить запрос, исходя из условий запроса и состояния доступных поставщиков |
| Модель с открытыми весами | Модель, веса которой после обучения публично доступны и которую можно развернуть самостоятельно в соответствии с её лицензией |
| TTFT | Time to First Token — время ожидания от отправки запроса до возврата первого токена |
| Пропускная способность | Количество токенов, генерируемых в единицу времени, обычно измеряется в tok/s |
| Failover | Автоматический переход на другого поставщика и повторная попытка, если текущий поставщик даёт сбой |
| Prompt Caching | Поставщик кэширует повторяющийся ввод, чтобы снизить вычислительные затраты и время ответа |
| BYOK | Bring Your Own Key — использование собственного ключа поставщика и квоты соответствующего аккаунта |
| P50 / P95 | Статистические перцентили: P50 — медиана, P95 отражает более медленные 5% запросов |
Что меняется при маршрутизации между несколькими API-провайдерами — коротко
- Разработчикам: Код и токены на стороне Hugging Face в принципе менять не нужно, но фактический поставщик будет определяться маршрутизацией: один и тот же ID модели в разных запросах может попадать к разным Provider. Приложениям, которые зависят от вызова инструментов и структурированного вывода, придётся заново пройти регрессионное тестирование. Для тех, кто раньше настраивал в Hugging Face собственный ключ Provider для своей языковой модели, эта возможность закрыта: ключи и принадлежность биллинга нужно перепроверить заново.
- Корпоративным закупщикам и командам платформ: Придётся заново оценить допуск поставщиков, стратегию аварийного восстановления и условия обработки данных. Организация может отключить конкретного Provider, но это не означает, что она получает полные гарантии резидентности данных или соответствия требованиям — политику каждого поставщика в области данных всё равно нужно проверять отдельно.
Одна и та же AI-модель у нескольких API-провайдеров: объективные факты
Почему у одной и той же модели бывает несколько API-провайдеров
Разработчик модели и провайдер инференса — это две разные роли. Разработчик отвечает за обучение модели и публикацию весов. Для моделей с открытыми весами любая организация, у которой есть вычислительные ресурсы и которая соблюдает условия лицензии, может развернуть веса на своём кластере GPU и предоставлять API. Поэтому модели вроде DeepSeek, Qwen и GLM часто одновременно работают на инфраструктуре нескольких провайдеров инференса.
Возьмём deepseek-ai/DeepSeek-V4.1-Flash: разработчик запрашивает одно и то же имя модели, а фактически инференс может выполняться в Together AI, Novita или у другого провайдера, который поддерживает эту модель. У каждого свои железо, масштаб кластера, схема планирования и ценовая политика — поэтому у одной и той же модели различаются цена, скорость и доступная пропускная способность. У кого-то цена ниже, но в часы пик легко получить ограничение по скорости; кто-то быстрее отдаёт первый токен; кто-то поддерживает более длинное контекстное окно; а некоторые полнее поддерживают формат вызова инструментов.
Цифры о масштабе показывают, насколько этот рынок фрагментирован. В объявлении о сотрудничестве OpenRouter сообщил, что вся его платформа поддерживает более 600 моделей, подключена к более чем 80 провайдерам, ежемесячно обрабатывает более 800 триллионов токенов и обслуживает более 10 миллионов пользователей. Это данные по всей платформе OpenRouter, а не масштаб, который принесло только это сотрудничество. Страница провайдеров Hugging Face тоже содержит список из более чем десятка провайдеров — Baseten, Cerebras, DeepInfra, Fireworks, Nebius, Novita, Together AI и другие, — но для разных моделей доступны разные провайдеры.
У одной модели несколько провайдеров, а условия у каждого меняются в реальном времени — вопрос «кому отдать этот запрос» превращается в задачу, которую приходится решать постоянно. Так и появляется маршрутизация между несколькими провайдерами.
Что на самом деле решает интеллектуальная маршрутизация
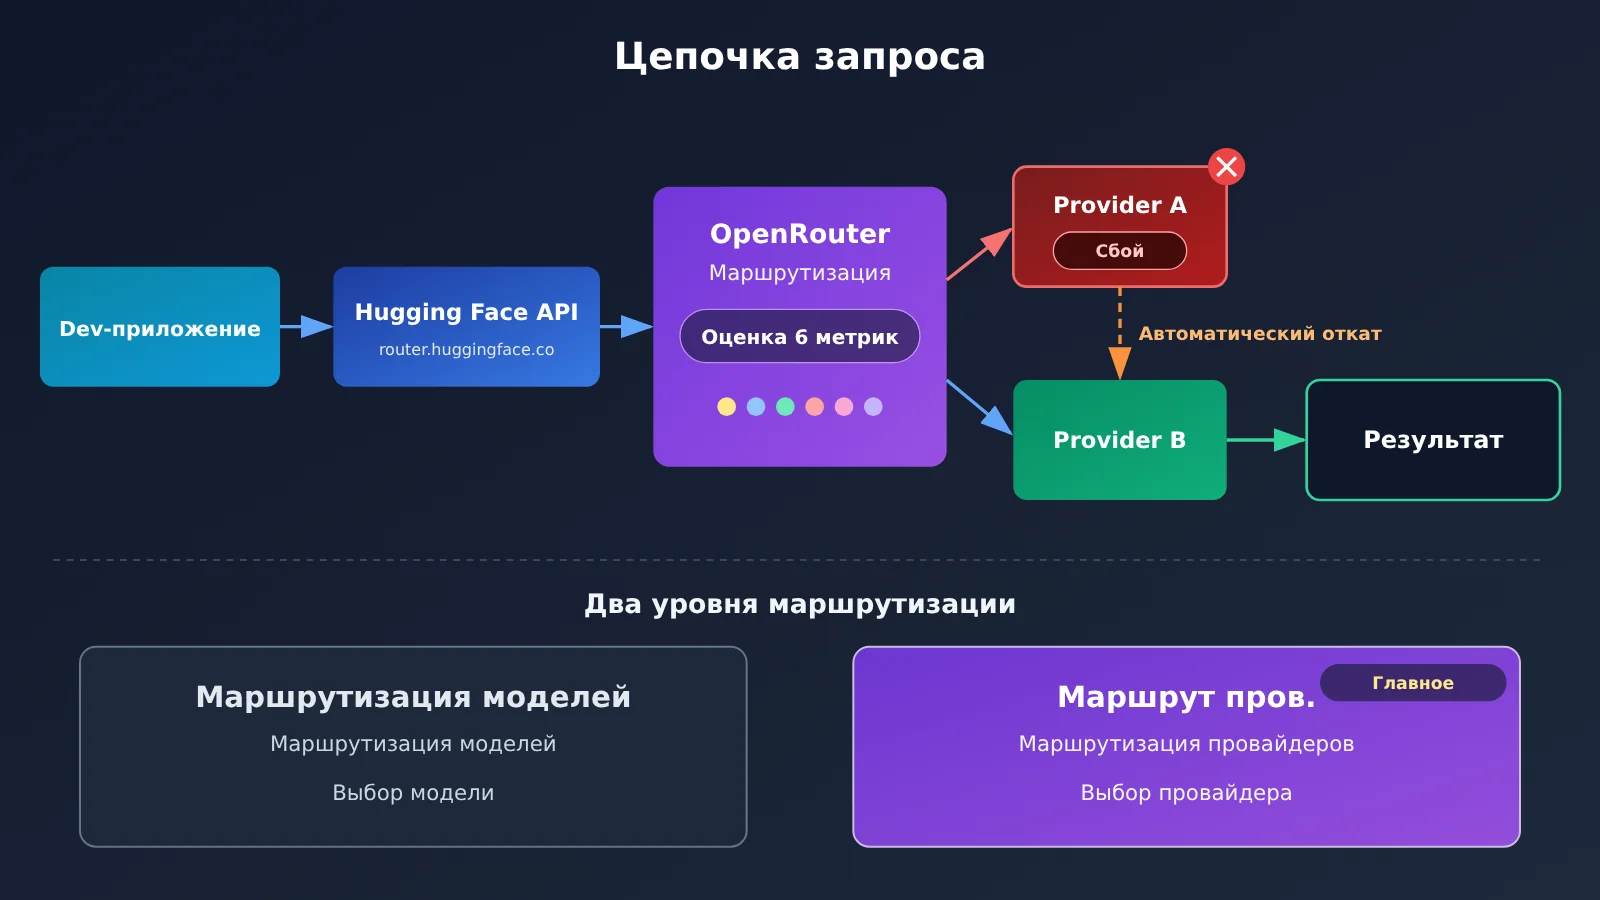
Сначала стоит развести два легко путающихся понятия. Model Routing (маршрутизация модели) решает, какая модель будет отвечать: например, простые вопросы можно отдать небольшой модели, а сложные — большой языковой модели. Provider Routing (маршрутизация провайдера) работает уже после того, как модель выбрана, и определяет, какой провайдер выполнит инференс. Сотрудничество OpenRouter и Hugging Face, о котором речь в этой статье, относится именно ко второму случаю: модель задаёт разработчик, а слой маршрутизации только выбирает провайдера и не подменяет модель за вас.
После начала сотрудничества цепочка одного запроса к языковой модели выглядит так: приложение разработчика или Coding Agent → Hugging Face API (router.huggingface.co) → система маршрутизации OpenRouter → инференс у определённого провайдера → возврат результата. OpenRouter здесь отвечает за маршрутизацию запросов и выбор провайдера, но не выполняет инференс всех моделей. Пользователь по-прежнему использует токен Hugging Face, а расчёты идут через аккаунт Hugging Face или аккаунт организации. Hugging Face говорит, что не добавляет наценку к цене инференса у провайдера.
С точки зрения управления Hugging Face предлагает три уровня:
- Автоматическая маршрутизация по умолчанию: официальный клиент использует
provider="auto", а система выбирает провайдера с учётом цены, скорости и надёжности. - Явное указание провайдера: например,
provider="together"или суффикс:novitaпосле ID модели — запрос гарантированно уходит к этому провайдеру. - Маршрутизация по стратегии: OpenAI-совместимый интерфейс поддерживает суффиксы
:cheapest(приоритет цены) и:fastest(приоритет пропускной способности).
Важно: :fastest оптимизирует пропускную способность, а не «скорость» во всех смыслах. TTFT, скорость генерации и полное время запроса — это три разных показателя. Для коротких ответов в одну-две фразы задержка до первого токена часто влияет на восприятие сильнее, чем пропускная способность.
| Параметр | Исходная маршрутизация Hugging Face | Новая маршрутизация OpenRouter |
|---|---|---|
| Система маршрутизации | Собственный роутер Hugging Face | OpenRouter |
| Выбор провайдера | Прежний механизм выбора | Оценка в реальном времени по совокупности факторов |
| Основа цены | Прежняя ценовая политика | Фактическая действующая цена |
| Фактор скорости | Прежний механизм производительности | Учитываются TTFT и пропускная способность |
| Единичный сбой | Может сразу вернуть ошибку | Можно повторить запрос у другого провайдера в рамках того же запроса |
| Кеш сессии | Прежняя стратегия | Поддержка закрепления провайдера за сессией |
| Учётные данные пользователя | Токен Hugging Face | По-прежнему используется токен Hugging Face |
На какие показатели смотреть в качественной системе маршрутизации между несколькими провайдерами
28 октября 2026 года OpenRouter представил алгоритм Provider Routing нового поколения. Старая маршрутизация по умолчанию во многом опиралась на цену за входные токены, поэтому провайдеры с низкими ценами чаще получали больше трафика. Новый алгоритм сводит шесть типов сигналов в одну стоимость маршрутизации в реальном времени (Routing Cost). Цель — оптимизировать совокупную стоимость «успешного и пригодного к использованию ответа с первого раза», а не просто гнаться за минимальной ценой за единицу.
① Effective Price (фактическая эффективная цена) решает проблему «дешёвая цена в прайсе не равна дешёвому счёту». Она учитывает три вида цены за единицу — для некэшированных входных, кэшированных входных и выходных токенов, — а затем рассчитывает итог с учётом реального соотношения входа и выхода в запросе и доли попаданий в кэш у этого провайдера. Пример от OpenRouter: 40 000 некэшированных входных токенов ($2/M) дают $0.080, 60 000 кэшированных входных токенов ($0.50/M) — $0.030, 4 000 выходных токенов ($8/M) — $0.032, итого $0.142. В сценариях с агентами доля кэшированного входа часто велика, поэтому сравнение только по цене входных токенов может привести к выбору неправильного провайдера.
② TTFT (время до первого токена) решает проблему «как долго пользователю ждать, пока появится ответ». Для чат-интерфейсов и агентов с многократными вызовами инструментов это особенно чувствительно, потому что на каждом раунде сначала приходится ждать первый токен.
③ Throughput (пропускная способность) измеряет скорость уже после начала генерации. Новый алгоритм смотрит на пропускную способность генерации на протяжении всего ответа, а не только на мгновенный пик. На задачи с большим объёмом вывода — длинную генерацию текста, автодополнение кода — это влияет в первую очередь.
④ Rate Limits (лимиты частоты запросов) в основном касаются ошибок HTTP 429 и решают проблему «нехватки мощностей у провайдера». Если какой-то провайдер часто возвращает 429, значит, у него не хватает вычислительных ресурсов, и маршрутизация снижает долю трафика, которую ему выделяет.
⑤ Reliability (надёжность) измеряет частоту неудачных запросов. Если доля ошибок у провайдера заметно выше, чем у других провайдеров той же модели, система уменьшает его долю трафика, а при необходимости приостанавливает поток до восстановления.
⑥ Quality (качество ответа) решает проблему «одна и та же модель в разных развёртываниях работает по-разному». Судя по текущему публичному описанию, сигнал качества в основном связан с тем, правильно ли возвращаются вызовы инструментов и соответствует ли структура требованиям. У провайдеров с неправильным форматом вызовов инструментов или заметно отстающей точностью на бенчмарках конкурентоспособность понижается.
Помимо этих шести показателей, в собственной документации OpenRouter по маршрутизации политика данных также включена в ограничения. Например, data_collection: "deny" позволяет исключить провайдеров, не соответствующих требованиям к сбору данных, а zdr: true требует использовать эндпоинт с нулевым хранением данных. В документации Hugging Face по безопасности указано, что компания не использует данные пользовательских запросов для обучения модели, при маршрутизации не сохраняет тело запроса и ответ, а отладочные логи хранит не дольше 30 дней, причём без пользовательских данных и токенов. Но там же предупреждают разработчиков: всё равно нужно смотреть на фактическую политику безопасности данных конкретного провайдера. Обещания платформы не заменяют соглашение об обработке данных каждого провайдера.
Данные и компромиссы эксперимента с маршрутизацией OpenRouter
Перед запуском нового алгоритма OpenRouter в октябре 2026 года провёл недельный Switchback-эксперимент с чередованием. Каждый день разбивали на 3-часовые блоки; парные блоки использовали старый и новый алгоритмы соответственно. После каждого переключения оставляли 1 час прогрева, который не учитывался в измерениях. Всего — более 24 млн запросов и 103 млрд входных токенов. Чередование выбрали вместо случайного распределения пользователей по группам потому, что когда новый алгоритм уводит трафик от перегруженного провайдера, группа со старым алгоритмом тоже выигрывает — это мешает сравнению.
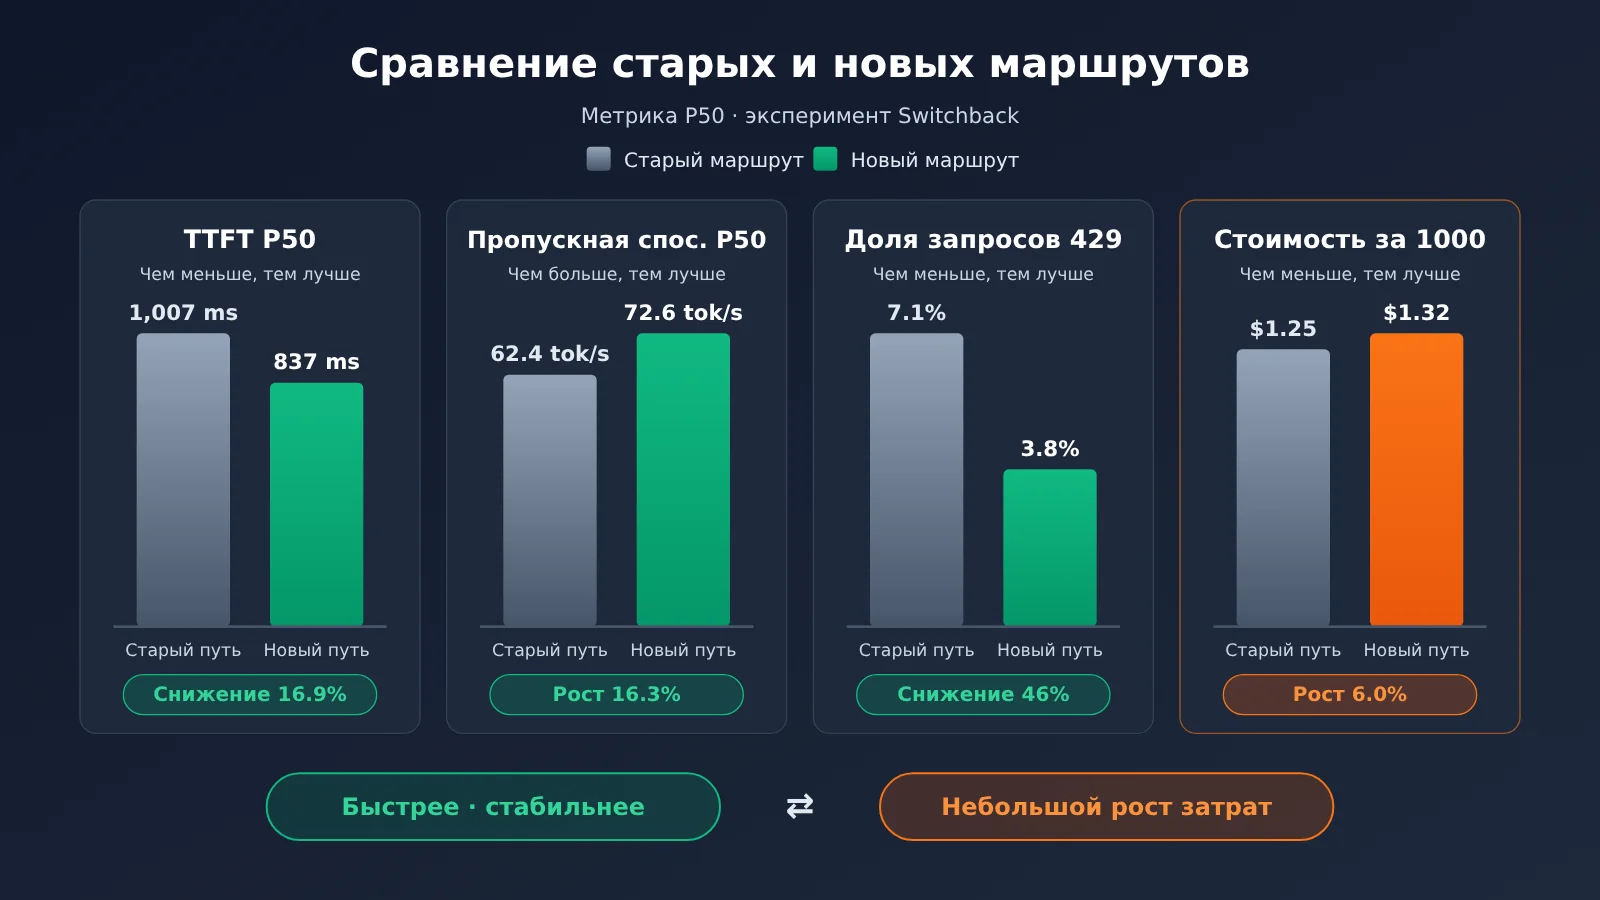
| Показатель | Старая маршрутизация | Новая маршрутизация | Изменение |
|---|---|---|---|
| TTFT P50 | 1 007 мс | 837 мс | снижение на 16,9% |
| TTFT P95 | 4 601 мс | 3 733 мс | снижение на 18,9% |
| Пропускная способность P50 | 62,4 tok/s | 72,6 tok/s | рост на 16,3% |
| Время полного запроса P50 | 4,00 с | 3,24 с | снижение на 19,0% |
| Доля запросов хотя бы с одним 429 | 7,1% | 3,8% | меньше на 46% |
| Доля запросов, требующих повторной попытки | 10,4% | 6,9% | меньше на 34% |
| Стоимость на 1 000 запросов | $1,25 | $1,32 | рост на 6,0% |
| Стоимость на 1 млн токенов | $0,301 | $0,324 | рост на 7,3% |
Эти данные показывают главный компромисс новой маршрутизации: рост стоимости на 1 000 запросов примерно на 6% в обмен на более низкую задержку и меньше ошибок из-за перегрузки. Есть несколько ограничений: эксперимент OpenRouter разработал и обнародовал сам, без аудита третьей стороной; выборка — набор репрезентативных открытых моделей, а не все модели и провайдеры; результаты — общая статистика, и они не означают, что каждый запрос станет быстрее на 16,9%. Эти данные взяты из эксперимента OpenRouter до сотрудничества, а не из независимого замера после запуска в Hugging Face.
💡 Совет по тестированию: эксперимент с маршрутизацией даёт общую статистику, а производительность собственного продукта всё равно придётся измерять самостоятельно. Если нужно в одном и том же коде сравнить качество вывода и стоимость нескольких популярных моделей, можно вызывать их через APIYI apiyi.com одним ключом: сначала определитесь с выбором на уровне модели, а уже потом думайте об оптимизации на уровне провайдера.
Как система переключается при сбое Provider
Типичный процесс автоматического Failover выглядит так: маршрутизация выбирает Provider A; если A работает нормально, ответ возвращается сразу; если A выдаёт ошибку или сталкивается с проблемой ёмкости, система в рамках того же запроса пробует Provider B; после успеха B возвращается результат. В эксперименте доля «запросов, требующих повторной попытки» снизилась с 10.4% до 6.9%, а время, затрачиваемое на неудачные попытки в расчёте на запрос, — с 349 ms до 242 ms. Это показывает, что хорошая маршрутизация должна не только уметь повторять попытки, но и по возможности изначально избегать провайдеров в плохом состоянии.
Автоматический fallback и указание конкретного Provider — это пара взаимно ограничивающих вариантов. Маршрутизация по умолчанию допускает переключение, что даёт более высокую доступность. Указание конкретного Provider фиксирует запрос на одном провайдере, удовлетворяя требованиям допуска поставщиков, но лишает возможности отказоустойчивости. Собственный API OpenRouter предоставляет комбинацию only (разрешает только указанного Provider) вместе с allow_fallbacks: false (без автоматического fallback), что позволяет запросу напрямую завершиться неудачей, если нет провайдера, соответствующего требованиям, вместо передачи другому поставщику. Важно различать: это параметры полного API OpenRouter, и их нельзя понимать так, будто интерфейс Hugging Face уже полностью открыл всё это. Соответствующие возможности на стороне Hugging Face — это указание Provider и отключение Provider в настройках.
Повторные попытки тоже имеют цену и не бесконечны:
- Затраты времени: каждая неудачная попытка удлиняет общее время выполнения, что заметно влияет на интерактивные сценарии.
- Потоковый вывод: потоковый ответ, который уже начал выводиться, нельзя бесшовно продолжить у другого провайдера.
- Повторные побочные эффекты: если вызов инструмента уже вызвал внешнее действие при первой попытке, повторная попытка может привести к дублированию выполнения; приложение должно само обеспечить идемпотентность.
- Потеря кэша: Prompt Caching обычно привязан к конкретному провайдеру, и переключение провайдера может лишить выгоды от кэша. Для этого Hugging Face предоставляет заголовок запроса
X-HF-Session-Id— стабильный UUID, чтобы одна и та же сессия по возможности оставалась у Provider, который держит кэш. - Нет доступных провайдеров: если у модели только один Provider или другие Provider не поддерживают текущие параметры, переключаться некуда. Проблемы вроде нехватки квоты, недостаточных прав у Token, недействительного запроса или превышения контекста маршрутизация тоже не решает.
Изменения в биллинге Hugging Face и работе с собственными ключами
Это сотрудничество принесло одно ломающее изменение: при вызове языковых моделей через Hugging Face больше нельзя использовать собственный API-ключ провайдера. Все такие запросы теперь идут через OpenRouter, а расходы записываются на аккаунт Hugging Face или на аккаунт организации. Для задач генерации изображений и видео собственные ключи по-прежнему работают — точные детали смотрите в официальной документации.
Если разработчик хочет и дальше тратить квоту, купленную у своего провайдера, есть два пути: обращаться к API этого провайдера напрямую или перейти на собственный аккаунт OpenRouter. По текущей документации OpenRouter про BYOK расклад такой: бесплатная квота BYOK считается по эквивалентной стоимости каталога инференса; для аккаунтов Pay-as-you-go это 25 000 долларов в месяц, для Enterprise — индивидуальный лимит. Всё, что сверх этого, тарифицируется как 5% от эквивалентной стоимости инференса и списывается с Credits платформы. Важно: 25 000 — это стоимость инференса в долларах, а не количество запросов. Кроме того, при откате на общие мощности могут расходоваться Credits платформы. Прямое подключение к OpenRouter — это отдельные аккаунты и отдельные биллинговые отношения, старые ключи туда автоматически не переносятся.
В актуальной документации по тарифам Hugging Face у Free-пользователей нет фиксированной ежемесячной квоты, у PRO — 2 $ в месяц, у Team и Enterprise — 2 $ за место в месяц. Это универсальные Compute Credits, которыми можно покрывать Inference Providers, Inference Endpoints, Spaces и другие сервисы. И ещё один момент, который стоит держать в голове: механизм ценообразования у провайдеров не меняется, но это не значит, что стоимость каждого запроса останется прежней — маршрутизация может выбрать провайдера чуть дороже, зато быстрее и стабильнее.
Как разработчику самостоятельно сравнивать нескольких поставщиков с помощью API каталога
Hugging Face предоставляет интерфейс каталога моделей, доступный для запросов, — это открытое окно, через которое система маршрутизации получает основу для принятия решений:
- Все модели:
GET https://router.huggingface.co/v1/models - Отдельная модель:
GET https://router.huggingface.co/v1/models/deepseek-ai/DeepSeek-V4-Pro
| Поле | Значение | Роль при выборе |
|---|---|---|
| provider | Фактический поставщик инференса | Определение списка кандидатов |
| status | Текущий статус, например live, error | Исключение недоступных поставщиков |
| context_length | Длина контекста, поддерживаемая данным поставщиком | Фильтрация по требованиям к длинному контексту |
| pricing.input / pricing.output | Цена в долларах за миллион входных и выходных токенов | Сортировка по стоимости |
| supports_tools | Поддерживается ли вызов инструментов | Жёсткое условие для сценариев с агентами |
| supports_structured_output | Поддерживается ли структурированный вывод | Жёсткое условие для вывода JSON |
| first_token_latency_ms | Задержка первого токена при последней проверочной пробе | Сортировка для интерактивных сценариев |
| throughput | Скорость генерации при последней проверочной пробе | Сортировка для сценариев с длинным выводом |
| is_free / is_model_author | Временная бесплатная акция / является ли издателем модели | Вспомогательная справка |
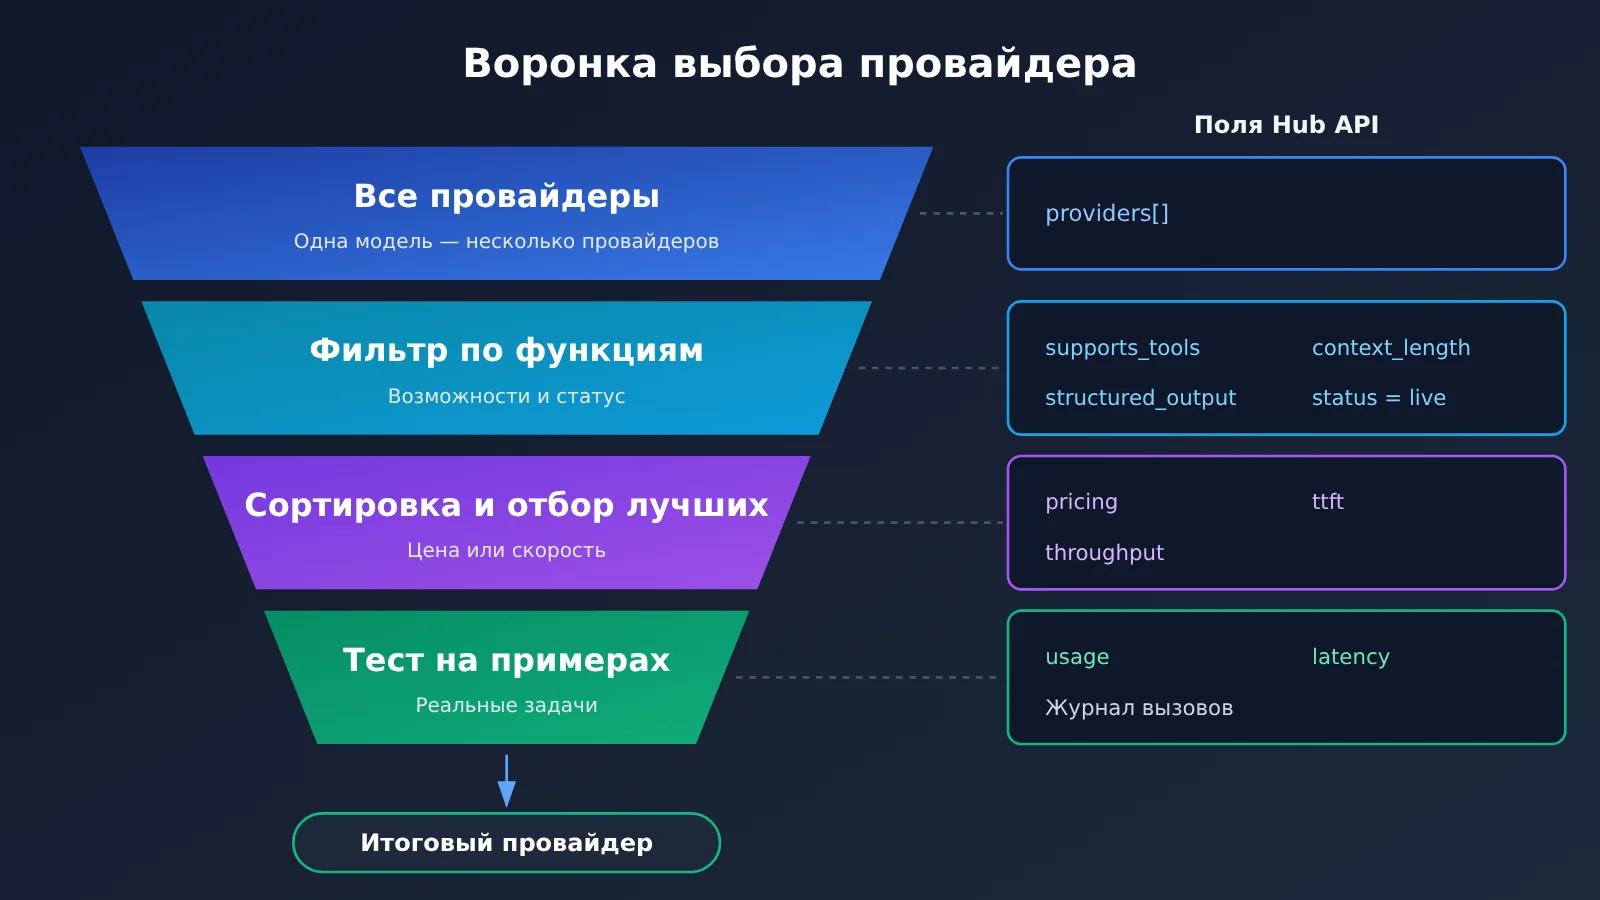
Эти поля предоставляются не каждым провайдером в полном объёме, а данные о производительности берутся из последней проверочной пробы и не равны вашим собственным сквозным показателям в реальном времени. Разумный подход — «сначала фильтрация, потом сортировка»: сначала отсеиваем несовместимых поставщиков по функциональным полям, затем сортируем по стоимости или скорости. Пример ниже демонстрирует этот подход; за структурой ответа обращайтесь к официальной документации Hub API:
import os
import requests

HF_TOKEN = os.environ["HF_TOKEN"]
MODEL = "deepseek-ai/DeepSeek-V4.1-Flash"

resp = requests.get(
    f"https://router.huggingface.co/v1/models/{MODEL}",
    headers={"Authorization": f"Bearer {HF_TOKEN}"},
    timeout=30,
)
data = resp.json()
providers = data.get("providers", [])  # конкретная структура — см. официальную документацию

# Шаг 1: фильтрация по функциям (агенту нужны вызов инструментов + структурированный вывод + контекст 64K)
candidates = [
    p for p in providers
    if p.get("status") == "live"
    and p.get("supports_tools")
    and p.get("supports_structured_output")
    and (p.get("context_length") or 0) >= 64_000
]

# Шаг 2: сортировка по цене за выходные токены, отсутствующие поля — в конец
candidates.sort(key=lambda p: (p.get("pricing") or {}).get("output", float("inf")))

for p in candidates:
    print(p["provider"], p.get("pricing"), p.get("first_token_latency_ms"), p.get("throughput"))
После отбора кандидатов обязательно нужно ещё раз проверить их реальными бизнес-запросами. Метаданные каталога говорят о том, что поставщик «заявляет о поддержке», и не заменяют точность на ваших собственных задачах, долю успешных вызовов инструментов и итоговую долю завершённых задач.
Прежде чем тонко настраивать на уровне поставщиков, обычно нужно сначала определить, какую модель использовать. Приведённый ниже код демонстрирует пакетное сравнение ответов нескольких моделей через один и тот же OpenAI-совместимый интерфейс; идентификаторы моделей замените на фактические названия из списка моделей платформы:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI — единый интерфейс: один ключ для вызова моделей от разных провайдеров
)

prompt = "用 JSON 返回:{\"city\": 城市名, \"reason\": 一句话理由},推荐一个适合冬季旅行的城市"

for model in ["model-id-a", "model-id-b", "model-id-c"]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, resp.usage.total_tokens, resp.choices[0].message.content)
🚀 Быстрый старт: новые пользователи могут получить бесплатный тестовый лимит в APIYI apiyi.com и прогнать на приведённом выше коде свой набор примеров из реальных бизнес-задач. В логах вызовов в панели фиксируются модель, расход токенов и стоимость каждого запроса — так можно посчитать реальную стоимость одной задачи, а не ориентироваться только на прайс-лист.
Стоит пояснить: единый доступ плюс логи вызовов, с одной стороны, и данные о производительности на уровне провайдеров в реальном времени, которые показывает Hugging Face, с другой — это разные уровни функциональности. Первое решает задачу «подключиться и посчитать», второе дополнительно показывает динамическое состояние нижележащих провайдеров. Одно прекрасно дополняет другое.
Несколько API-провайдеров и интеллектуальная маршрутизация: анализ и выводы
Где дальше будут конкурировать платформы-агрегаторы API
Если разложить возможности OpenRouter на слои, получится три уровня: агрегация моделей отвечает на вопрос «как получить доступ к разным моделям», агрегация провайдеров — «кто выполняет инференс для одной и той же модели», динамическая маршрутизация — «кому передать конкретно этот запрос». Единый интерфейс уже в основном решил проблему подключения; это сотрудничество показывает, что второй и третий уровни становятся новой точкой конкуренции. Основание для такого вывода: Hugging Face решил отказаться от собственного маршрутизатора и перейти на внешние возможности маршрутизации; OpenRouter также отдельно опубликовал алгоритм маршрутизации и подтвердил его ценность экспериментами в продакшене.
Можно предвидеть, что оптимизация затрат, стабильность и управление данными станут новыми измерениями сравнения для API-платформ. Ниже — прогнозы, которые ещё предстоит проверить: прозрачность маршрутизации будет становиться всё важнее, разработчики захотят знать, к какому провайдеру ушёл запрос, почему выбран именно он и сколько за это уплачено; ограничения по политике работы с данными могут превратиться из дополнительной опции в обязательное условие при корпоративных закупках.
Однако маршрутизация — не панацея. Данные экспериментов показывают: за более высокую скорость и стабильность приходится платить более высокой удельной стоимостью. Последующие планы из анонса сотрудничества (например, связать аккаунты на обеих платформах и подключить больше задач к маршрутизации OpenRouter) пока остаются только планами. Маршрутизация также не решает проблемы качества самой модели, лицензирования и соответствия бизнес-задачам.
Спрос на модели с открытыми весами и давление на расходы предприятий
Данные со стороны спроса подтверждают вывод о том, что маршрутизация между провайдерами становится важной. По статистике OpenRouter, если считать недельный объём токенов по топ-50 моделям, доля моделей с открытыми весами 28 сентября 2026 года достигла 71,7%. Это методика подсчёта в рамках платформы OpenRouter, и её нельзя переносить на глобальную рыночную долю. Чем больше используется моделей с открытыми весами, тем чаще одна и та же модель доступна у нескольких провайдеров — и тем заметнее становится ценность маршрутизации.
Что касается затрат, Capgemini в сентябре 2026 года опросила 500 руководителей высшего звена (CXO) крупных компаний: 59% отметили, что расходы на ИИ заметно превысили ожидания; у компаний, столкнувшихся с проблемой, средний перерасход составил 24%. Эти цифры отражают только данную выборку, но вместе с выводом из эксперимента с маршрутизацией — «рост скорости сопровождается ростом затрат» — они напоминают предприятиям: автоматическая маршрутизация по умолчанию ориентируется на общий опыт, а не обязательно на минимальный счёт. Для бизнеса, чувствительного к затратам, стоит осознанно выбирать стратегию приоритета цены или устанавливать верхний предел цены и постоянно сверять расходы по журналам вызовов.
Как выбрать стратегию под свою роль
- Частные разработчики и небольшие команды: автоматическая маршрутизация по умолчанию уже избавляет от необходимости строить собственную систему отказоустойчивости. Главное — проверить на реальных примерах, насколько стабильно работают вызов инструментов и вывод JSON. Сначала определить модель через такой единый интерфейс, как APIYI apiyi.com, а потом при необходимости оптимизировать на уровне провайдера — это путь с небольшими вложениями.
- Продукты с интерактивным взаимодействием: смотрите в первую очередь на TTFT P95, а не на пропускную способность.
:fastestне обязательно улучшит ощущение от коротких ответов. - Длинные ответы и пакетные задачи: пропускная способность и эффективная цена важнее, так что можно взять стратегию с приоритетом цены и использовать привязку сессии, чтобы сохранить выгоду от кэша.
- Корпоративные команды и команды платформ: сначала составьте список — какие приложения зависят от собственных Provider Key, а какие бизнес-процессы требуют фиксированного провайдера. Потом решите, разрешать ли откат, ограничивать ли круг провайдеров или подключаться к провайдеру напрямую. Соглашения об обработке данных нужно сверять с каждым провайдером отдельно.
Какую бы стратегию вы ни выбрали, всё в итоге сводится к одному действию: прогнать один цикл на своих запросах и своих метриках. Небольшое сравнение на бесплатной квоте в APIYI apiyi.com или предварительный отбор провайдеров через каталог Hugging Face API — очень дешёвая отправная точка. 16.9% из официального эксперимента — это среднее по всем, а сколько получите именно вы, станет ясно только после теста.
The proof of the pudding is in the eating.(Проверить пудинг можно, только съев его; реальный эффект проверяется на практике.)


