Note de l’auteur : à partir d’un test réel d’Apple Intelligence en version chinoise sous iOS 27.3, cet article décortique la logique de répartition entre modèles embarqués et grands modèles de langage dans le cloud. Il propose un cadre de décision en 5 dimensions directement réutilisable, ainsi que les étapes de mise en œuvre dans une application.
Avec le déploiement de la bêta développeur d’iOS 27.3, la version chinoise d’Apple Intelligence ouvre enfin sa phase de test. Sous le capot, l’ensemble s’appuie à la fois sur les modèles développés par Apple et sur Qwen d’Alibaba : la suppression d’objets dans les photos, la reformulation de base et la traduction en temps réel tournent sur l’appareil, tandis que les tâches longues de Siri et la fonction « Demander » d’Intelligence visuelle sont confiées à Qwen dans le cloud. Ce déploiement en Chine tombe à pic : il constitue un exemple très concret de répartition appareil-cloud.
Ce n’est pas un énième récapitulatif de fonctionnalités : nous nous servons de cet exemple pour décortiquer la logique de conception de la répartition appareil-cloud. Quelles tâches d’IA ont intérêt à rester sur l’appareil ? Lesquelles doivent nécessairement être confiées à un grand modèle de langage dans le cloud ? Et comment un développeur doit-il tracer cette frontière dans son propre produit ?
À retenir : à la fin de cet article, vous maîtriserez un cadre de décision en 5 dimensions pour la répartition appareil-cloud, et vous saurez mettre en œuvre en 4 étapes une architecture hybride « repli sur l’appareil + renforcement dans le cloud » dans votre application.
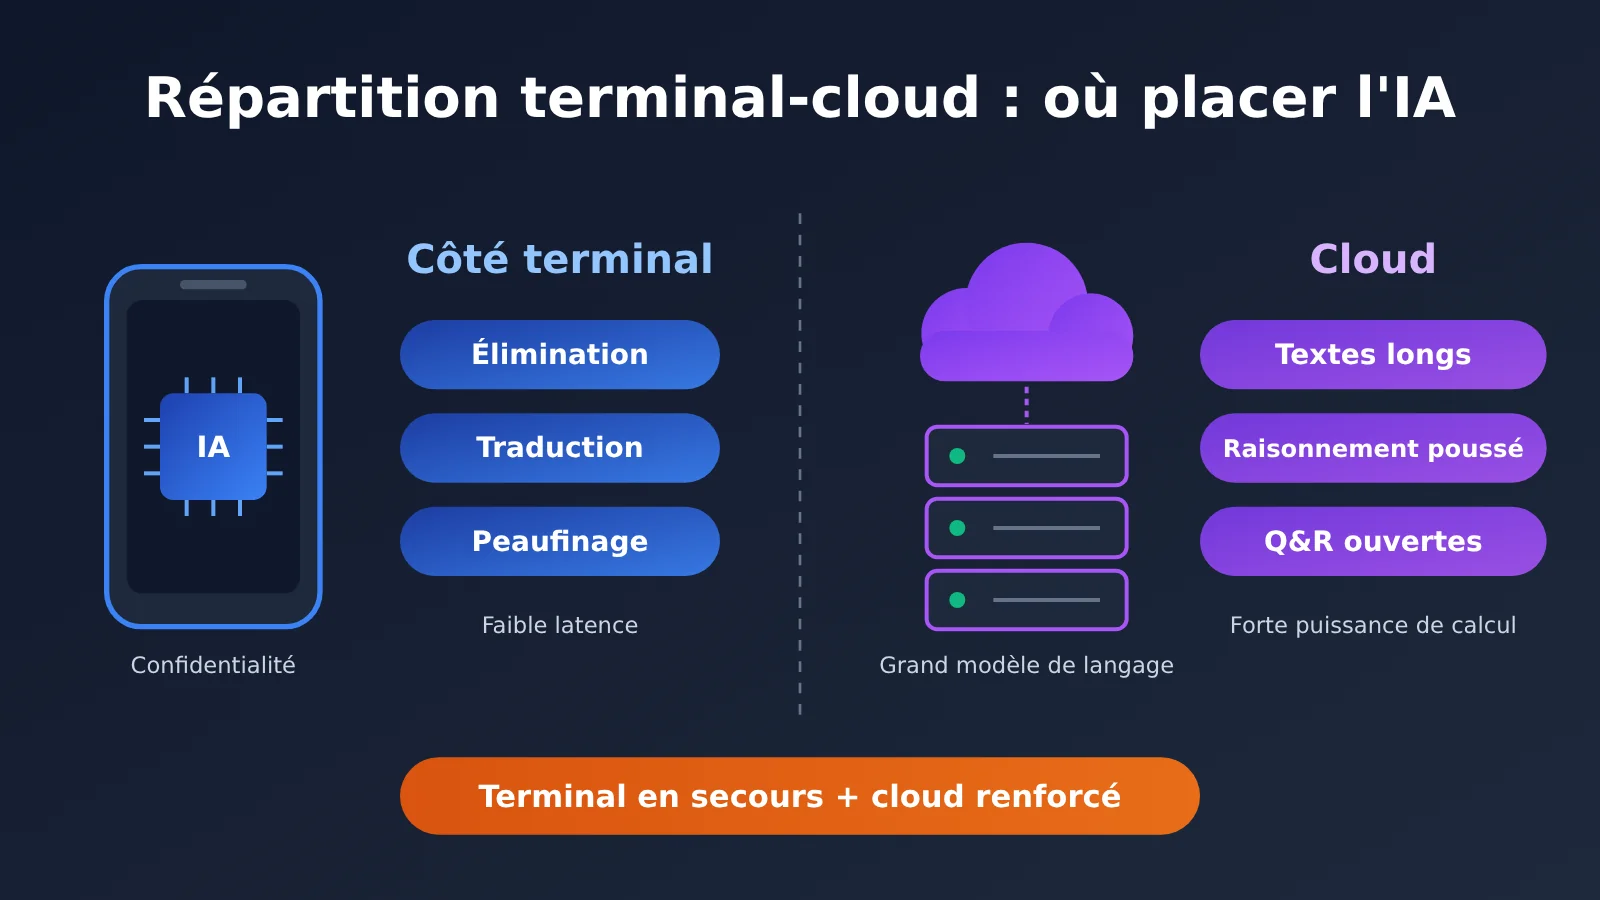
Apple Intelligence en Chine : l’essentiel de la répartition entre appareil et cloud
Commençons par un tableau récapitulant la répartition que les tests réels permettent de confirmer. Les colonnes « Emplacement d’exécution » et « Comportement observé » proviennent d’essais publics ; on constate que la répartition choisie par Apple n’a rien d’aléatoire et suit une logique claire.
| Fonction | Emplacement d’exécution | Source du modèle | Comportement observé |
|---|---|---|---|
| Nettoyage de photos | Sur l’appareil | Modèle embarqué développé par Apple | Sur un arrière-plan simple, le rendu est propre ; sur des textures complexes, des zones de basse résolution ont tendance à subsister |
| Traduction en temps réel | Sur l’appareil | Modèle embarqué Apple, avec téléchargement de packs de langue (environ 2 Go chacun) | Pour la conversation courante, la latence est inférieure à 1 seconde et la précision est bonne |
| Outils d’écriture (reformulation de base) | Principalement sur l’appareil | Modèle développé par Apple | L’appel au niveau système est pratique, mais la reformulation en chinois reste un peu rigide |
| Résumé des notifications / recherche en langage naturel dans la photothèque | Sur l’appareil | Modèle développé par Apple, avec création d’un index local | Juste après la mise à jour, il faut attendre un à deux jours pour que l’indexation se termine |
| Tâches complexes de Siri | Cloud | Qwen d’Alibaba ; nécessite l’autorisation de l’utilisateur et la connexion à un compte Qwen | Résultats en environ 7 à 8 secondes, avec un contenu plutôt succinct |
| Intelligence visuelle « Demander » / « Rechercher » | Cloud | « Demander » passe par Qwen ; « Rechercher » utilise par défaut le modèle visuel de Baidu, avec possibilité de connecter des apps tierces | Après adaptation, les applications tierces peuvent apparaître dans la liste des services de recherche |
Répartition appareil-cloud : les points clés — pourquoi l’effacement d’objets et la traduction restent côté appareil
L’effacement d’objets sur les photos et la traduction en temps réel ont trois points communs : les entrées sont des données personnelles de l’utilisateur (photos, voix des appels), la latence est critique et le périmètre de la tâche est bien délimité. Les visages et les informations de localisation présents sur les photos ne quittent pas l’appareil, ce qui réduit au minimum le risque pour la vie privée. Pour la traduction, il faut pouvoir traduire tout en discutant : le moindre aller-retour réseau casserait le rythme de la conversation. Une latence inférieure à une seconde en local, c’est précisément ce qui fait la différence.
Le revers de la médaille est évident. La taille des modèles embarqués est limitée par la puissance de calcul et le stockage du téléphone. Résultat : l’effacement échoue dès qu’il tombe sur des textures complexes comme une grande étendue d’herbe ou des galets, et chaque pack de langues pour la traduction occupe environ 2 Go. La mise à jour système pèse cette fois jusqu’à 12 Go : en substance, on paie le « loyer » des modèles embarqués.
Répartition appareil-cloud : les points clés — pourquoi Siri confie les tâches longues au cloud
Une demande comme « Organise-moi un itinéraire de quatre jours à Jiuzhaigou » exige une grande quantité de connaissances du monde, de la génération de textes longs et une planification en plusieurs étapes. Un petit modèle embarqué ne peut tout simplement pas suivre. L’approche d’Apple est la suivante : lorsque Siri détecte une question qui dépasse ses capacités, une fenêtre contextuelle demande à l’utilisateur s’il accepte de faire appel à Qwen. En cas de refus, la réponse est simplement abandonnée.
Cette fenêtre mérite vraiment d’inspirer les développeurs. Elle indique explicitement à l’utilisateur que « les données vont quitter l’appareil » et lui rend le pouvoir de décider en matière de vie privée. En même temps, les tests réels nous rappellent que la qualité d’un résultat dans le cloud dépend du contexte et de la conception de l’invite fournis au modèle par le système. L’itinéraire proposé par Siri est nettement moins bon que lorsque l’on pose directement la question dans l’application Qwen : brancher un grand modèle de langage ne signifie donc pas savoir bien l’exploiter.
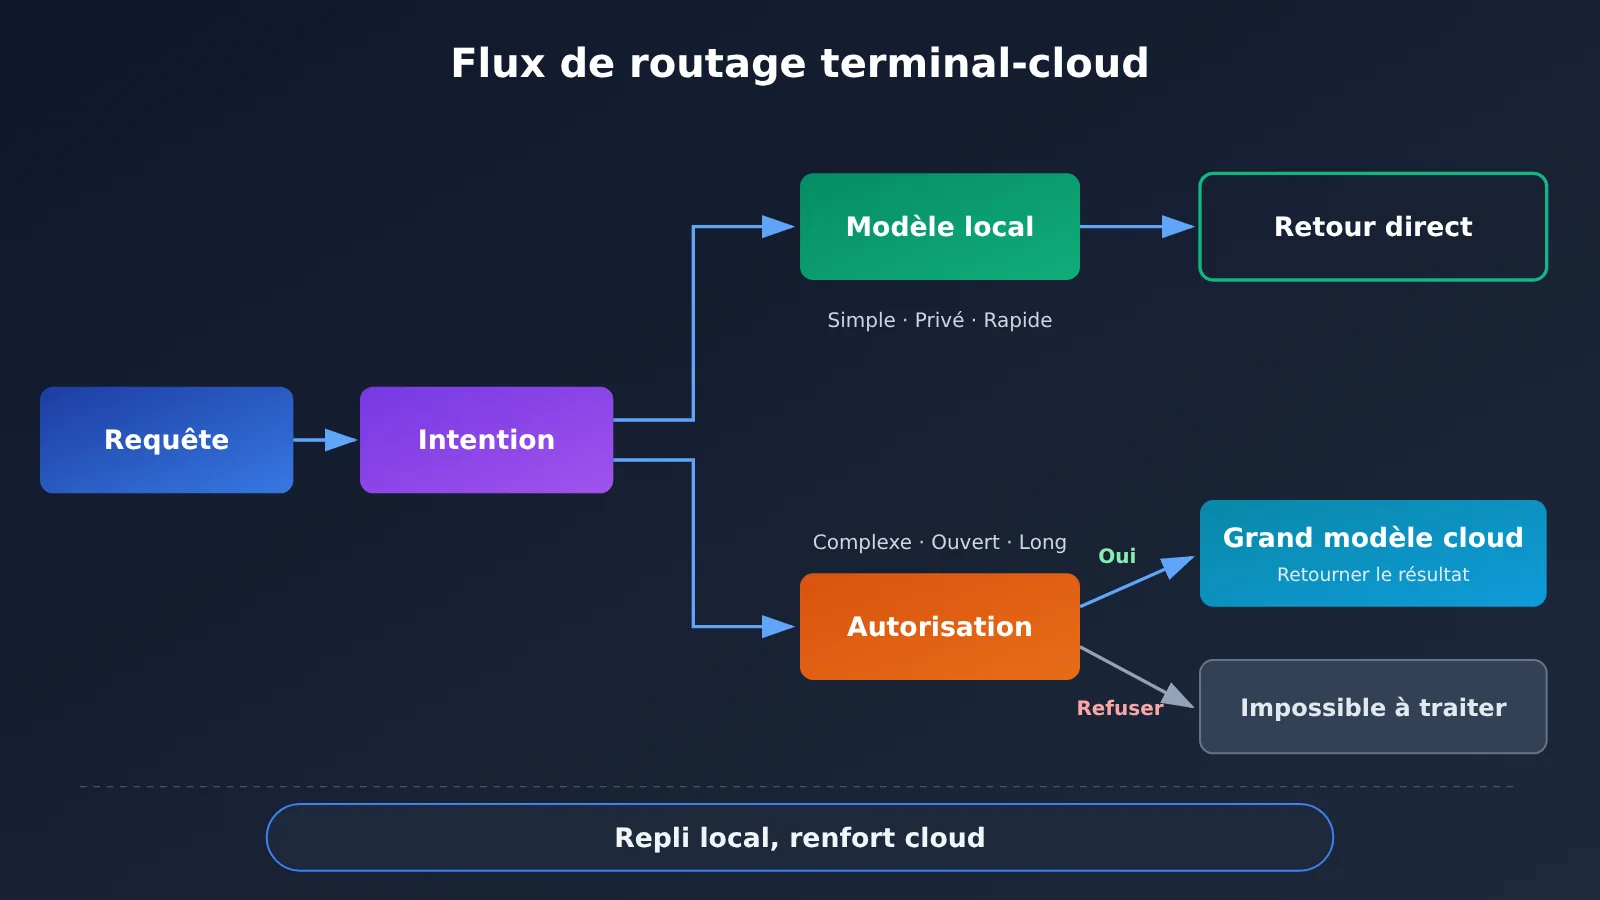
Cadre de décision pour la répartition appareil/cloud : 5 dimensions pour savoir où placer chaque tâche
À partir de la répartition des tâches dans Apple Intelligence en Chine, on peut dégager 5 dimensions de décision. En pratique, pour chaque tâche, on peut l’évaluer selon ces 5 dimensions : la majorité penche d’un côté, et on place la tâche de ce côté.
| Dimension d’évaluation | Caractéristiques qui favorisent l’appareil | Caractéristiques qui favorisent le cloud | Exemple dans Apple Intelligence |
|---|---|---|---|
| Sensibilité des données | Données personnelles : photos, contacts, historique de conversations, etc. | Connaissances publiques, questions soumises volontairement par l’utilisateur | L’effacement reste sur l’appareil ; les questions de type guide passent par le cloud |
| Exigence de latence | Réponse attendue en moins d’une seconde, une interruption fait échouer la tâche | Un délai de plusieurs secondes est acceptable | La traduction reste sur l’appareil ; les tâches longues de Siri prennent environ 7 à 8 secondes |
| Complexité de la tâche | Périmètre bien délimité, sortie courte | Questions ouvertes, planification en plusieurs étapes, génération de textes longs | La reformulation de base reste sur l’appareil ; les questions complexes sont confiées à Qwen |
| Fraîcheur des connaissances | Ne dépend pas d’informations externes récentes | Nécessite des connaissances générales ou une recherche en temps réel | La fonction « Recherche » d’Intelligence visuelle s’appuie sur Baidu et des services tiers |
| Disponibilité hors ligne | Doit fonctionner avec un réseau faible ou sans réseau | Scénario en ligne par défaut | La traduction en temps réel peut tourner localement après téléchargement d’un pack de langues |
Les erreurs courantes dans la répartition appareil/cloud
Quand les équipes répartissent les tâches entre l’appareil et le cloud, elles tombent facilement dans les pièges suivants. Mieux vaut les anticiper :
- Erreur 1 : tout mettre sur l’appareil dès que possible. Les modèles embarqués ont des limites. Forcer des tâches complexes sur l’appareil ne produit que des résultats médiocres, comme le raté de la fonction d’effacement, et dégrade l’expérience.
- Erreur 2 : croire qu’il suffit de brancher le cloud. L’exemple des questions de guide avec Siri montre que l’invite système, l’organisation du contexte et le contrôle de la longueur de sortie déterminent aussi la qualité.
- Erreur 3 : ignorer l’autorisation et la dégradation. Un appel au cloud doit prévoir un chemin de repli quand l’utilisateur refuse l’autorisation ou quand le réseau échoue. La fonctionnalité ne doit pas simplement « disparaître ».
- Erreur 4 : ne calculer le coût qu’une fois. Côté appareil, il s’agit de coûts ponctuels de stockage et de taille de paquet ; côté cloud, de coûts récurrents à l’usage. Les deux doivent être calculés séparément.
Prise en main rapide de la répartition terminal-cloud : 4 étapes pour la concrétiser dans votre propre application
Transformons maintenant le cadre de décision en étapes concrètes et exécutables. Même si vous ne développez pas un système mobile, mais une application classique, un mini-programme ou un outil de bureau, cette approche s’applique tout autant.
Étape 1 : inventorier les tâches et les étiqueter selon la répartition terminal-cloud
Listez toutes les fonctionnalités du produit que vous prévoyez d’équiper d’IA et évaluez-les une par une selon les 5 dimensions de la section précédente. Je vous conseille de produire une liste de tâches comprenant au minimum les colonnes « nom de la tâche, sensibilité des données, exigences de latence, complexité, emplacement cible » : lors de la revue, tout sera limpide.
Étape 2 : choisir une solution légère pour les tâches côté terminal
Pour les tâches côté terminal, privilégiez les capacités natives du système ou des modèles légers : par exemple les interfaces de traduction, d’OCR ou de reconnaissance vocale fournies par le système, ou de petits modèles quantifiés. L’essentiel est de maîtriser la taille du modèle et l’expérience du premier téléchargement. Inspirez-vous d’Apple : les ressources volumineuses sont téléchargées à la demande, avec un message explicite lors de la première utilisation.
Étape 3 : connecter une API de grand modèle de langage pour les tâches cloud
Les tâches cloud nécessitent un grand modèle de langage suffisamment puissant. Si vous souhaitez utiliser la série Qwen comme le fait Apple Intelligence dans sa version chinoise, ou comparer en même temps GPT, Claude et d’autres modèles, vous pouvez passer par APIYI pour des appels unifiés. APIYI fournit l’accès aux API des principaux grands modèles de langage évoqués dans cet article, et est compatible avec les deux formats d’interface OpenAI et Anthropic : le code existant ne demande généralement qu’un changement d’URL d’interface et de clé pour migrer. Les modèles réellement disponibles sont ceux de la liste de la page des tarifs.
Les éléments de configuration à surveiller lors de l’intégration sont récapitulés dans le tableau ci-dessous ; pour les URL d’interface, référez-vous à ce qu’indique la documentation APIYI docs.apiyi.com :
| Élément de configuration | Rôle | Recommandation dans un scénario terminal-cloud |
|---|---|---|
| URL de l’interface (base_url) | Indique le serveur auquel la requête est envoyée | À renseigner selon la documentation APIYI docs.apiyi.com ; les formats OpenAI et Anthropic ont chacun leur propre adresse |
| API Key | Authentification et facturation | À conserver uniquement côté serveur, ne jamais l’embarquer dans le paquet d’installation du client |
| model | Spécifie le modèle appelé | Choisissez un modèle à fort raisonnement pour les tâches de planification complexe, un modèle léger pour de simples reformulations |
| max_tokens | Contrôle la longueur de sortie | À assouplir pour les guides et les rapports, afin d’éviter une concision excessive à la Siri |
| stream | Sortie en flux ou non | À activer pour les tâches cloud longues, afin de compenser la latence ressentie de plusieurs secondes d’attente |
| Timeout et nouvelle tentative | Gestion des anomalies réseau | Définissez un timeout raisonnable ; en cas d’échec, basculez sur un résultat simplifié côté terminal ou affichez un message clair |
Étape 4 : concevoir la fenêtre d’autorisation et les chemins de repli
Prenez exemple sur la fenêtre de confirmation de Siri avant d’appeler Qwen : toute fonctionnalité qui envoie des données utilisateur vers le cloud doit expliquer, au premier appel, « quels contenus sont envoyés et à qui ». Si l’utilisateur refuse, ne renoncez pas comme le fait Siri : vous pouvez revenir aux capacités côté terminal pour fournir un résultat simplifié, ou inviter l’utilisateur à compléter les informations manuellement.
🚀 Démarrage rapide : je vous conseille de commencer par prototyper la tâche cloud la plus complexe. Après inscription sur APIYI apiyi.com, vous obtenez des crédits de test ; avec le même format compatible OpenAI, changez de modèle et comparez lequel offre la meilleure qualité de sortie dans votre contexte, avant d’arrêter la solution définitive.
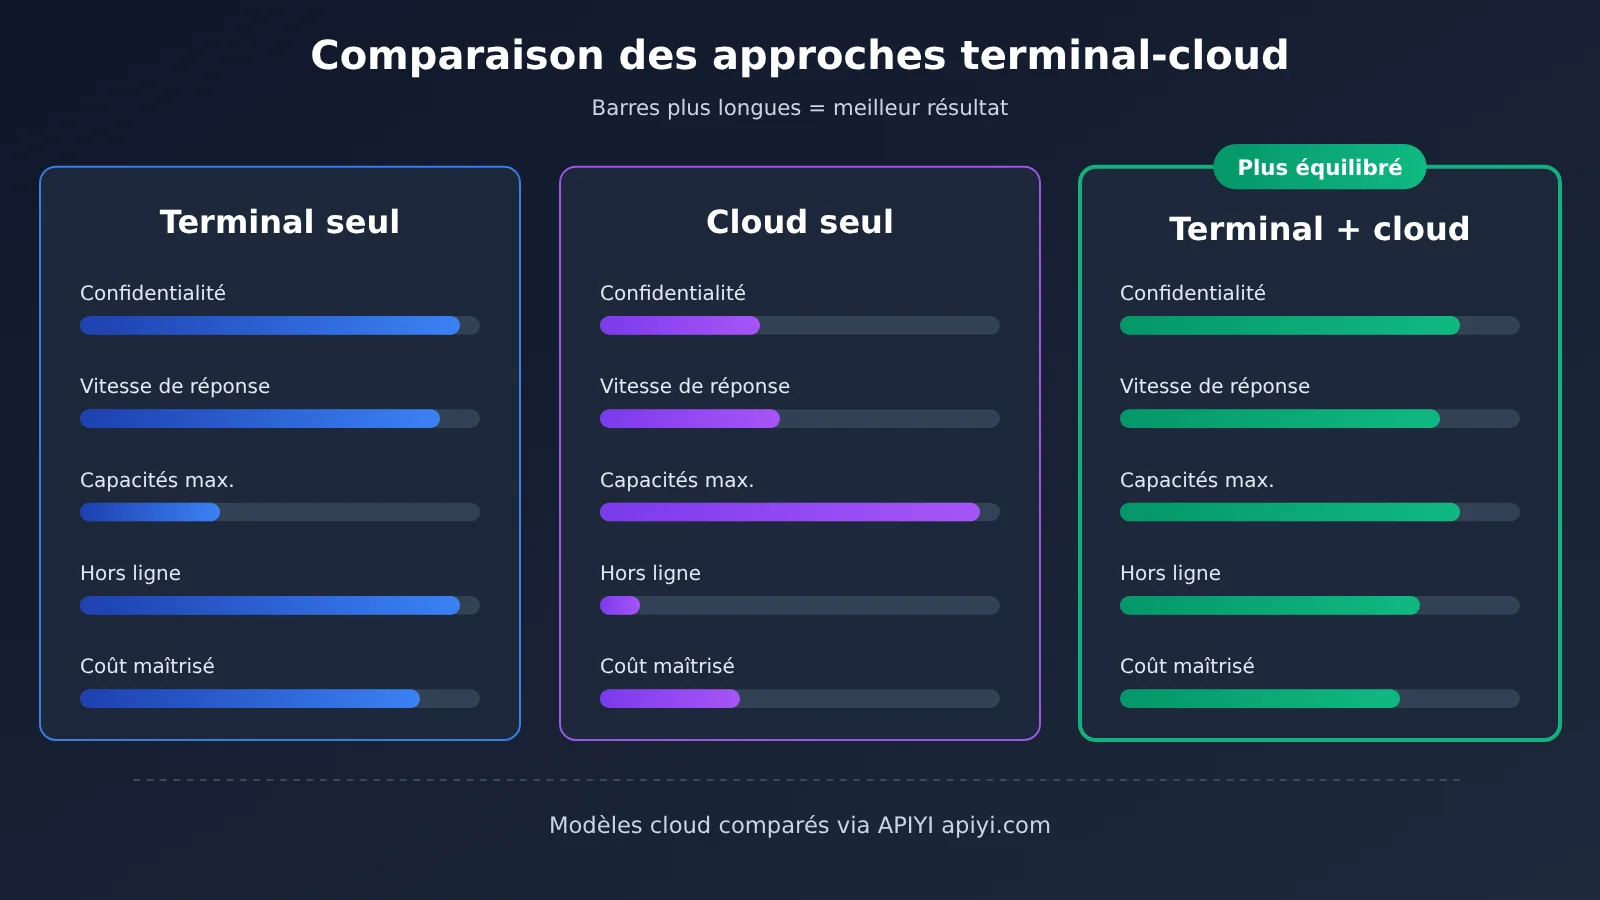
Comparaison des approches de répartition terminal-cloud : tout en local, tout dans le cloud et collaboration terminal-cloud
| Approche | Caractéristiques clés | Cas d’usage | Principale limite | Plateformes de modèles cloud disponibles |
|---|---|---|---|---|
| Tout en local | Les données ne quittent pas l’appareil, utilisable hors ligne | Traduction, suppression d’objets, reconnaissance vocale et autres tâches au périmètre bien défini | Plafond de capacités bas, taille de l’application et stockage sous pression | Sans objet |
| Tout dans le cloud | Plafond de capacités élevé, itérations rapides | Questions-réponses ouvertes, textes longs, planification en plusieurs étapes | Dépend du réseau, préoccupations de confidentialité et coût d’appel récurrent | APIYI apiyi.com, API officielles des différents modèles |
| Collaboration terminal-cloud | Le local assure la base, le cloud renforce, routage selon la tâche | La grande majorité des produits IA grand public | Architecture complexe : il faut concevoir le routage, l’autorisation et la dégradation | APIYI apiyi.com, API officielles des différents modèles |
Lecture comparative des approches de répartition terminal-cloud
Analyse comparative du tout-local : le tout-local garde l’avantage sur la confidentialité et la vitesse de réponse — la traduction en temps réel en moins d’une seconde en est la meilleure preuve. Mais les modèles embarqués sont bridés par la puissance de calcul et le stockage : dès qu’il s’agit de supprimer des textures complexes ou de réécrire un texte chinois délicat, la qualité chute nettement. À l’inverse, la collaboration terminal-cloud permet de confier ces cas difficiles au cloud, en préservant le socle de confidentialité tout en relevant le plafond de capacités.
Analyse comparative du tout-cloud : le tout-cloud brille par l’étendue de ses connaissances et sa capacité de génération — depuis que Siri s’est connecté à Qwen, il peut enfin répondre aux questions du type « quel itinéraire choisir ». Mais chaque appel dépend du réseau et de l’autorisation de l’utilisateur ; en cas de refus ou de réseau faible, la fonctionnalité tombe purement et simplement. Pour les fonctions essentielles qui doivent rester « disponibles à tout moment », la collaboration terminal-cloud demeure le choix le plus sûr.
💡 Conseil de choix : la décision dépend de la composition de vos tâches. Si la partie cloud doit arbitrer entre Qwen, GPT, Claude et d’autres modèles, vous pouvez passer par APIYI apiyi.com pour mener des tests comparatifs sur les mêmes questions avec une interface unifiée, et trancher sur la qualité réelle des sorties plutôt que sur les arguments marketing.
La répartition des coûts entre l’appareil et le cloud : un investissement unique côté appareil, une facturation à l’usage côté cloud
Le coût est l’aspect le plus souvent sous-estimé dans la répartition des tâches entre l’appareil et le cloud. Côté appareil, le coût se traduit principalement par la taille du paquet, l’espace de stockage occupé chez l’utilisateur et l’expérience du premier téléchargement. La mise à jour de 12 Go d’Apple et ses packs de langue d’environ 2 Go chacun en sont l’illustration concrète. Côté cloud, il s’agit en revanche de frais d’appel à l’usage qui s’accumulent en continu : plus l’utilisateur est actif, plus la facture grimpe.
Apple fait d’ailleurs ce calcul elle-même. Lors de sa conférence téléphonique de résultats, sa direction a indiqué que les futures fonctionnalités dépendant de grands modèles de langage dans le cloud, comme Siri AI ou la retouche photo intelligente avancée, disposeraient d’un quota d’utilisation de base, les utilisateurs intensifs devant acheter des quotas supplémentaires. Autrement dit, le modèle « quota de base gratuit + paiement à l’usage intensif » pourrait bien devenir le modèle économique dominant des fonctionnalités d’IA dans le cloud. Les développeurs peuvent s’en inspirer pour concevoir leurs propres produits.
Concernant plus précisément le coût d’appel des modèles dans le cloud, les prix d’entrée, les prix de sortie et les modalités de facturation du cache varient fortement d’un modèle à l’autre, et changent régulièrement. Cet article ne donne aucun chiffre précis : pour tous les prix de modèles, modalités de facturation, tarifs d’entrée et de sortie ainsi que prix du cache, référez-vous aux données réelles de la page de tarifs APIYI : https://docs.apiyi.com/models.
💰 Optimisation des coûts : pour estimer les coûts cloud, partez du principe « nombre moyen de tokens d’entrée par tâche × prix d’entrée + nombre moyen de tokens de sortie × prix de sortie », en prenant toujours les tarifs unitaires sur la page de tarifs APIYI docs.apiyi.com/models. Pour les invites système répétées à haute fréquence, vérifiez si la page de tarifs mentionne une facturation du cache, afin de réduire encore les coûts récurrents.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce que la répartition edge-cloud ?
La répartition edge-cloud consiste à découper les tâches IA selon leurs caractéristiques : une partie est confiée au modèle embarqué sur l’appareil, l’autre est envoyée au grand modèle de langage dans le cloud. Apple Intelligence pour la Chine continentale en est un cas typique : la gomme et la traduction restent en local, tandis que les tâches complexes de Siri et les questions « Demander » de l’intelligence visuelle passent par Qwen dans le cloud.
Q2 : Quelle est la différence fondamentale entre un modèle embarqué et un grand modèle de langage cloud ?
Le modèle embarqué garde l’avantage sur la confidentialité, la latence et la disponibilité hors ligne, mais son plafond de capacité est bridé par la puissance de calcul et le stockage. Le grand modèle de langage cloud couvre un savoir bien plus large et génère mieux, mais il dépend du réseau, exige l’autorisation de l’utilisateur et entraîne un coût d’invocation continu. Les deux ne se substituent pas l’un à l’autre : ils sont complémentaires.
Q3 : Quand Apple Intelligence (version Chine continentale) sera-t-elle officiellement disponible ?
Apple Intelligence pour la Chine continentale est entrée en phase de test avec la bêta développeur d’iOS 27.3 ; on peut y accéder via l’app Apple Developer, puis dans Mise à jour logicielle. Le premier firmware de test contient des bugs ; selon les rapports publics, la version finale est attendue en décembre. Si c’est votre téléphone principal, mieux vaut attendre la version stable avant de mettre à jour.
Q4 : Quelles tâches IA sont les plus adaptées à une exécution en local ?
Les scénarios suivants sont les plus adaptés :
– **Traitement de données sensibles** : gomme photo, recherche en langage naturel dans la photothèque, résumé des notifications
– **Interactions à très faible latence** : traduction vocale en temps réel, suggestions du clavier
– **Fonctions indispensables hors ligne** : traduction, reconnaissance vocale et correction de texte de base en réseau faible
Q5 : Comment appeler rapidement Qwen ou un autre grand modèle cloud via une API ?
Le plus simple est de passer par une plateforme d’agrégation multi-modèles :
1. Rendez-vous sur APIYI apiyi.com, créez un compte et récupérez une clé API
2. Consultez le centre de documentation docs.apiyi.com pour les instructions d’intégration au format compatible OpenAI ou Anthropic
3. Vérifiez sur la page des tarifs docs.apiyi.com/models les modèles disponibles et la base de facturation, puis il suffit de remplacer l’adresse de l’endpoint et la clé pour appeler
Vous pouvez ainsi comparer Qwen et les autres modèles majeurs avec un seul et même jeu d’interfaces.
Q6 : Que faire si l’utilisateur refuse l’autorisation lors d’un appel cloud ?
La méthode de Siri : abandonner purement et simplement la réponse, ce qui donne une expérience un peu sèche. Une meilleure approche consiste à prévoir un chemin de repli : revenir au modèle embarqué pour fournir un résultat simplifié, ou inviter l’utilisateur à compléter ses informations avant de réessayer, tout en respectant son choix et sans multiplier les fenêtres de rappel.
Q7 : Quelles sont les limites connues d’une architecture edge-cloud ?
Objectivement, il y en a trois principales :
– **Complexité d’architecture** : il faut maintenir en plus le routage des intentions, le flux d’autorisation et la logique de repli
– **Cohérence de l’expérience** : le style de sortie diffère entre le local et le cloud, l’utilisateur peut ressentir une rupture
– **Frontières de l’écosystème** : comme les tests le montrent, l’IA système n’entre pas dans les applications tierces comme WeChat ou Meituan ; le contexte personnel reste fragmenté, et la répartition edge-cloud ne résout pas le problème des silos de données
Points clés de la répartition entre l’appareil et le cloud
- Le principe : les tâches privées, à faible latence et au périmètre bien délimité restent sur l’appareil ; les tâches complexes, ouvertes et à longs textes partent vers le cloud
- L’exemple de la version chinoise : le modèle maison d’Apple gère la suppression d’objets et la traduction, Qwen d’Alibaba prend en charge les tâches longues de Siri et les questions visuelles
- La grille d’évaluation : sensibilité des données, latence, complexité, fraîcheur de l’information et disponibilité hors ligne, notées une à une sur cinq axes
- Le consentement, indispensable : obtenir explicitement l’accord de l’utilisateur avant que les données ne quittent l’appareil, et prévoir une solution de repli en cas de refus
- La qualité avant tout : brancher un grand modèle de langage n’est qu’un point de départ ; l’invite, le contexte et la longueur de sortie font l’expérience finale
- Pour démarrer : les modèles cloud s’intègrent de façon unifiée via APIYI apiyi.com, compatible avec les formats OpenAI et Anthropic
En résumé
Le déploiement d’Apple Intelligence sur le marché chinois nous offre une référence claire pour répartir les tâches entre l’appareil et le cloud :
- L’appareil protège la confidentialité et la vitesse : suppression d’objets, traduction, résumés de notifications restent sur l’appareil — au prix du poids de l’application et du stockage
- Le cloud repousse les limites de capacité : les questions-réponses complexes et les questions visuelles passent par Qwen — au prix de la latence, du consentement et d’un coût récurrent
- La coopération est la norme : repli sur l’appareil, enrichissement par le cloud, le tout accompagné d’une fenêtre de consentement et d’un chemin de repli, voilà une forme de produit réellement exploitable
Pour les développeurs, la voie la plus pragmatique consiste à étiqueter d’abord les tâches à l’aide de la grille d’évaluation, puis à choisir une tâche cloud pour valider un prototype. Je recommande de passer par APIYI apiyi.com pour comparer les résultats réels de différents grands modèles de langage via une interface unifiée ; pour les tarifs et la base de facturation, référez-vous à la page des prix docs.apiyi.com/models.
📚 Références
- ifanr : test réel de l’iPhone AI version chinoise : test réel de la première version développeur d’Apple Intelligence pour la Chine
- Lien :
ifanr.com/1687733 -
Description : source des faits concernant la répartition des fonctions entre l’appareil et le cloud, ainsi que les performances mesurées dans cet article
-
Centre de documentation APIYI : guide d’intégration aux formats compatibles OpenAI et Anthropic
- Lien :
docs.apiyi.com -
Description : les adresses d’interface, les méthodes d’authentification et les paramètres d’appel font référence
-
Page tarifaire des modèles APIYI : liste des modèles disponibles et base de facturation
- Lien :
docs.apiyi.com/models - Description : les prix unitaires d’entrée et de sortie, les tarifs de cache et les autres informations de facturation se basent sur les données réelles de cette page
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil d’APIYI apiyi.com ; pour plus de ressources d’intégration, consultez le centre de documentation docs.apiyi.com