Nota del autor: deepseek-flash ya puede buscar en Internet de forma integrada, pero el interruptor de pensamiento cambia la manera de buscar; la facturación se cuenta por query y, en la siguiente ronda, solo se conserva el cuerpo de la respuesta. Este artículo explica tres puntos que lo diferencian de una llamada normal a herramientas, y también cuándo no conviene dejar que el modelo busque por su cuenta.
2026-11-13, DeepSeek anunció oficialmente que abre a la API la capacidad de conversación que está en la aplicación. Esta vez, solo deepseek-flash trae este conjunto de capacidades, en la versión DeepSeek-V4.1-Flash-1017. Con solo declarar un deepseek_web_search, deepseek-flash puede navegar por Internet por su cuenta, y tanto la invocación de herramientas como el ensamblaje del contexto se realizan en el servidor.
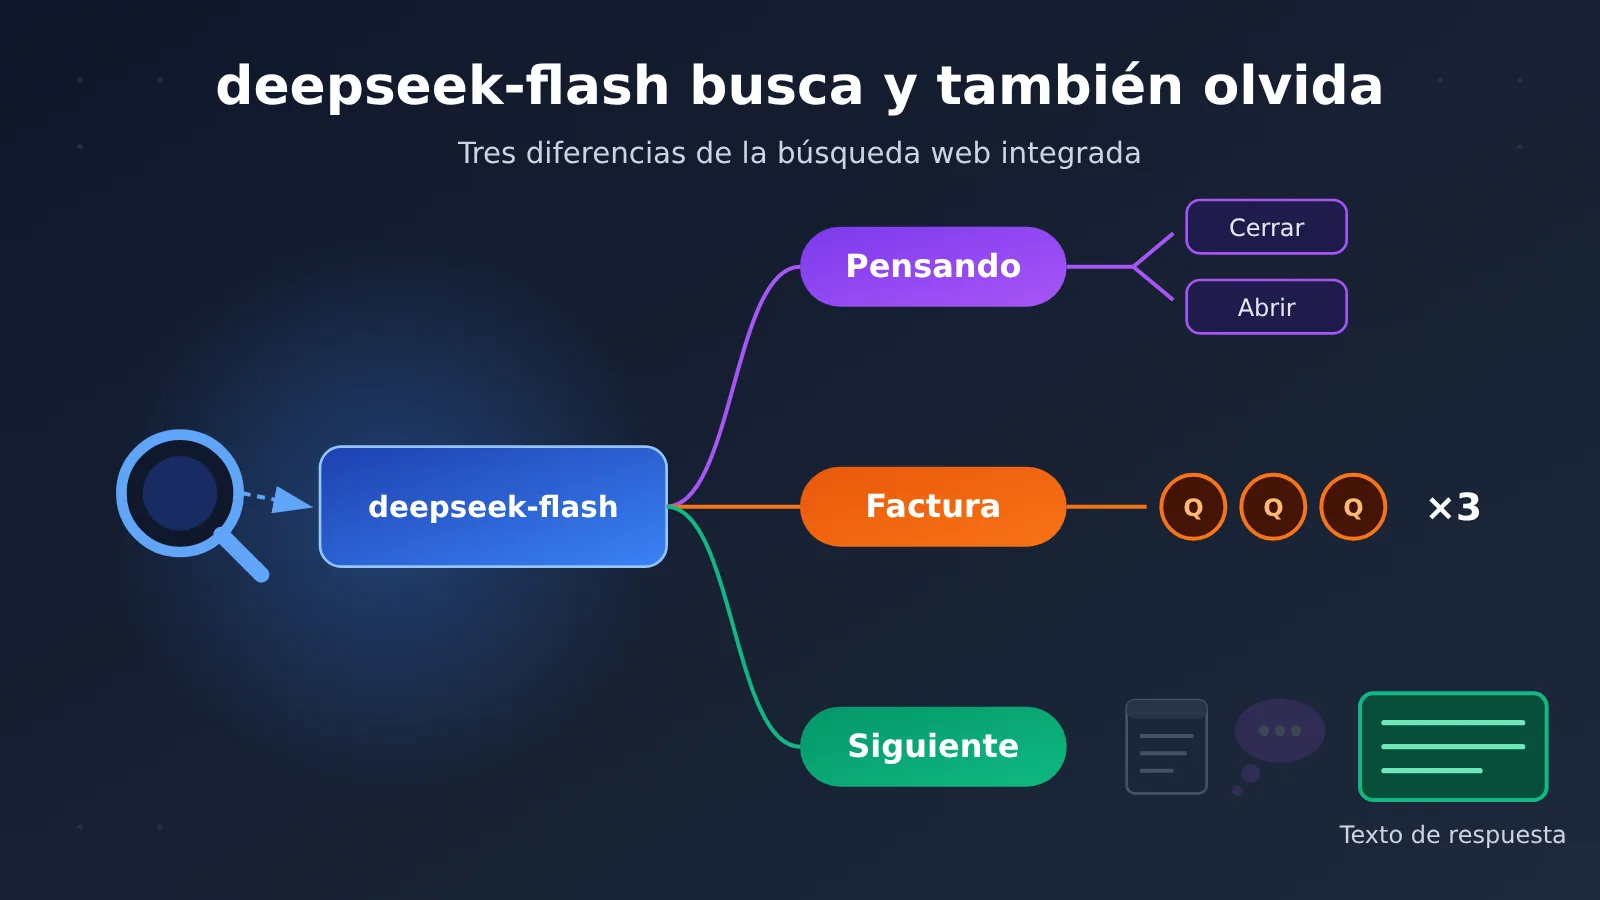
Mucha gente lo interpretará como «activo un interruptor y el resto funciona igual que una llamada a función normal». Esto no es un simple interruptor. Si el pensamiento está activado o no, la forma de buscar cambia; el número de veces que aparece en la respuesta no es el número de veces que se cobra; y, al llegar a la siguiente ronda, lo que el modelo buscó, leyó y pensó ya no está en el contexto.
Valor clave: al terminar de leer este artículo, sabrás en qué se diferencian deepseek-flash y una llamada normal a herramientas en estos tres puntos —pensamiento, facturación y siguiente ronda— y también podrás decidir cuándo conviene que el modelo busque por su cuenta y cuándo debe hacerlo el programa.
deepseek-flash busca y también olvida: tres puntos clave
Primero, la conclusión. La tabla siguiente resume las tres diferencias entre la búsqueda integrada de deepseek-flash y el flujo que ya conoces de «el modelo inicia la llamada, el programa la ejecuta y el resultado vuelve».
| Punto clave | Comportamiento real de deepseek-flash | Diferencia con la llamada a función normal |
|---|---|---|
| Razonamiento | Con el razonamiento desactivado, es una búsqueda web o de imágenes con citas; con el razonamiento activado, se convierte en búsqueda con razonamiento profundo | Una misma declaración de herramienta se transforma en dos flujos distintos según el interruptor de razonamiento |
| Facturación | La búsqueda integrada se cuenta por número de queries; si una búsqueda contiene tres queries, cuenta como tres | No es «una llamada, un cargo»; el número en usage tampoco equivale al número de cargos |
| Siguiente ronda | Los resultados de búsqueda, las páginas abiertas y el razonamiento no pasan a la siguiente ronda; solo se conserva el cuerpo de la respuesta | Los resultados de una llamada a función normal normalmente los escribes tú al historial, así que se pueden conservar |
De dónde vienen las tres diferencias de deepseek-flash
Las tres diferencias nacen del mismo diseño: la invocación de herramientas ocurre en el servidor. No ves los mensajes intermedios de tool call, ni tienes oportunidad de decidir qué contenido se escribe al historial. El servidor busca, lee y ensambla el contexto por ti, y al terminar la respuesta también descarta el proceso intermedio.
Así la integración es muy cómoda, pero el precio es que pierdes control. Qué queries se envían, qué páginas se abren y si la siguiente ronda puede citar el texto original de la ronda anterior, todo lo decide el servidor. Una vez entiendes esto, las tres secciones siguientes encajan solas.
Cómo el interruptor de pensamiento de deepseek-flash cambia la búsqueda
La comparación que ofrece la documentación oficial Build a Chatbot es muy clara: con la misma declaración de deepseek_web_search, si el interruptor de pensamiento está activado o no, el comportamiento cambia.
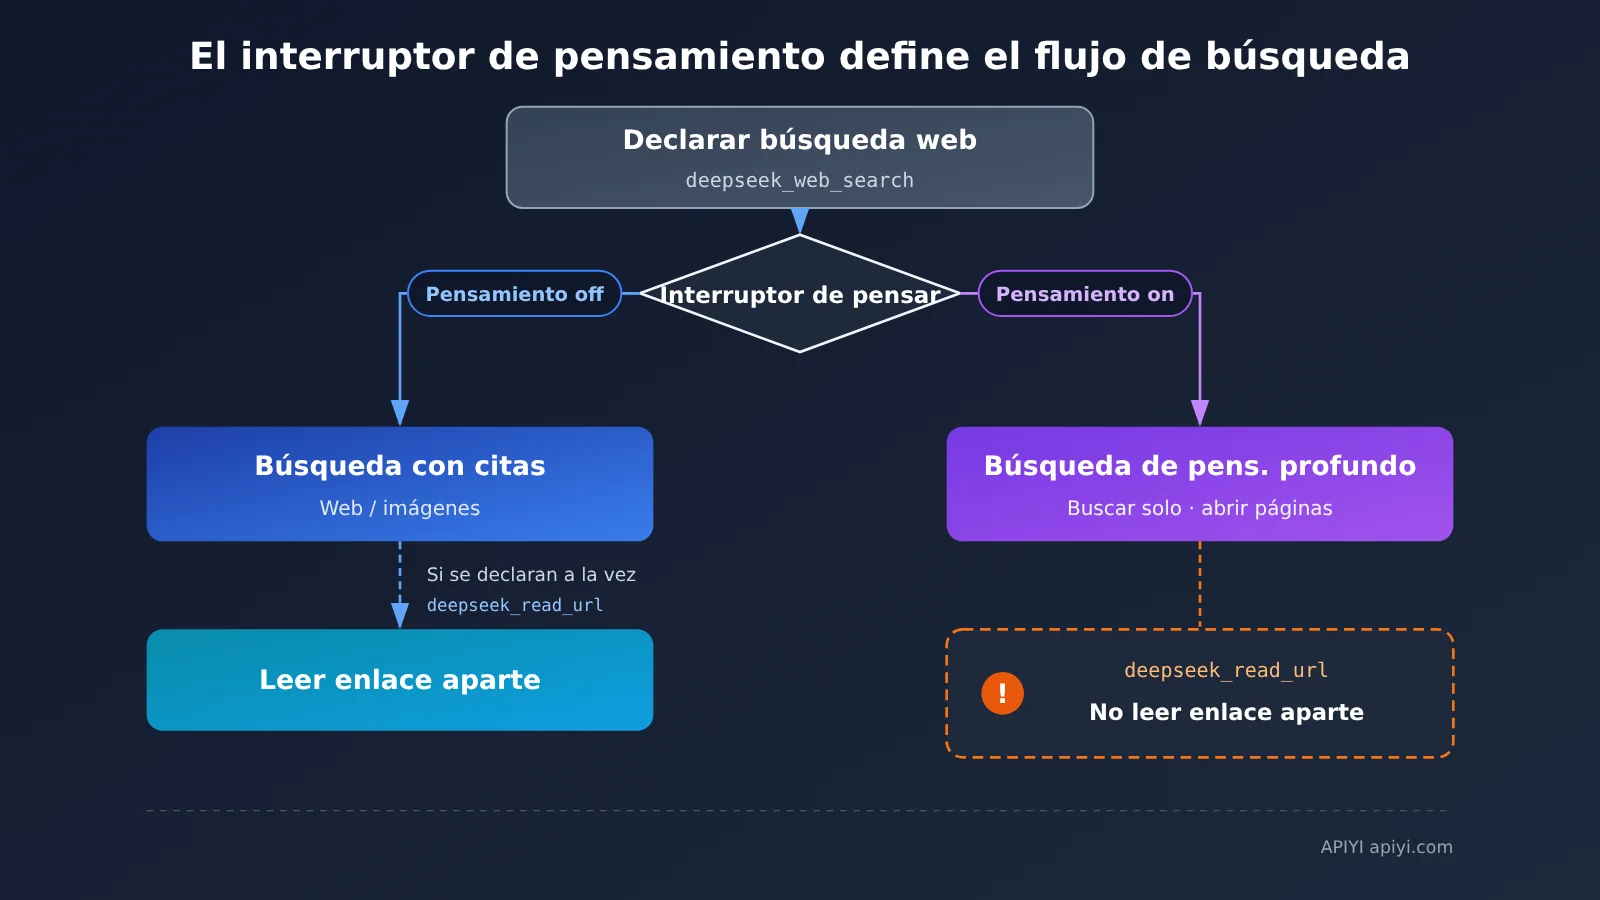
| Interruptor de pensamiento | Herramientas declaradas | Comportamiento real | ¿Se lee el enlace aparte? |
|---|---|---|---|
| Desactivado | deepseek_web_search |
Busca web o imágenes según la pregunta, respuesta con citas | No aplica |
| Desactivado | deepseek_web_search + deepseek_read_url |
Búsqueda con citas; los enlaces del mensaje del usuario se capturan aparte | Sí |
| Activado | deepseek_web_search |
Búsqueda con pensamiento profundo; durante el razonamiento de múltiples pasos busca y abre páginas por sí mismo | El propio modelo decide qué páginas abrir |
| Activado | deepseek_web_search + deepseek_read_url |
Sigue siendo búsqueda con pensamiento profundo | No lee el enlace por separado |
| Cualquiera | Solo deepseek_read_url |
Identifica y captura los enlaces del mensaje del usuario | Sí |
Los dos escollos de la búsqueda con pensamiento profundo de deepseek-flash
El primer escollo es la lectura de enlaces. El usuario pega un enlace y tú das por hecho que, solo con declarar deepseek_read_url, seguro que se lee esa página. Pero basta que el pensamiento esté activado y que también se declare deepseek_web_search para que esta ronda vaya a la búsqueda con pensamiento profundo: el enlace ya no se lee por separado, y si abrir esa página o no lo decide el modelo durante el razonamiento. Si tu producto promete «pega el enlace y leo el texto original», o desactivas el pensamiento, o esta ronda solo declaras deepseek_read_url.
El segundo escollo son los parámetros. Cuando activas deepseek_web_search o deepseek_read_url, pones safety_check en high o habilitas title, el servidor ignora un conjunto de parámetros de muestreo, como temperature y top_p; las listas de lo que se ignora no son exactamente iguales en los tres protocolos. max_tokens (en el protocolo Responses es max_output_tokens) sigue teniendo efecto, pero limita la salida de cada paso de razonamiento dentro de una ronda, no el total de la ronda. Por eso, en la búsqueda con pensamiento profundo, usar max_tokens para estimar el límite de coste de una ronda no es preciso.
Cómo se calcula la factura de deepseek-flash con conexión a internet
La facturación es el punto donde más fácilmente se cometen errores, porque aquí hay dos sistemas de unidades de conteo distintos. Vamos a explicarlos por separado.
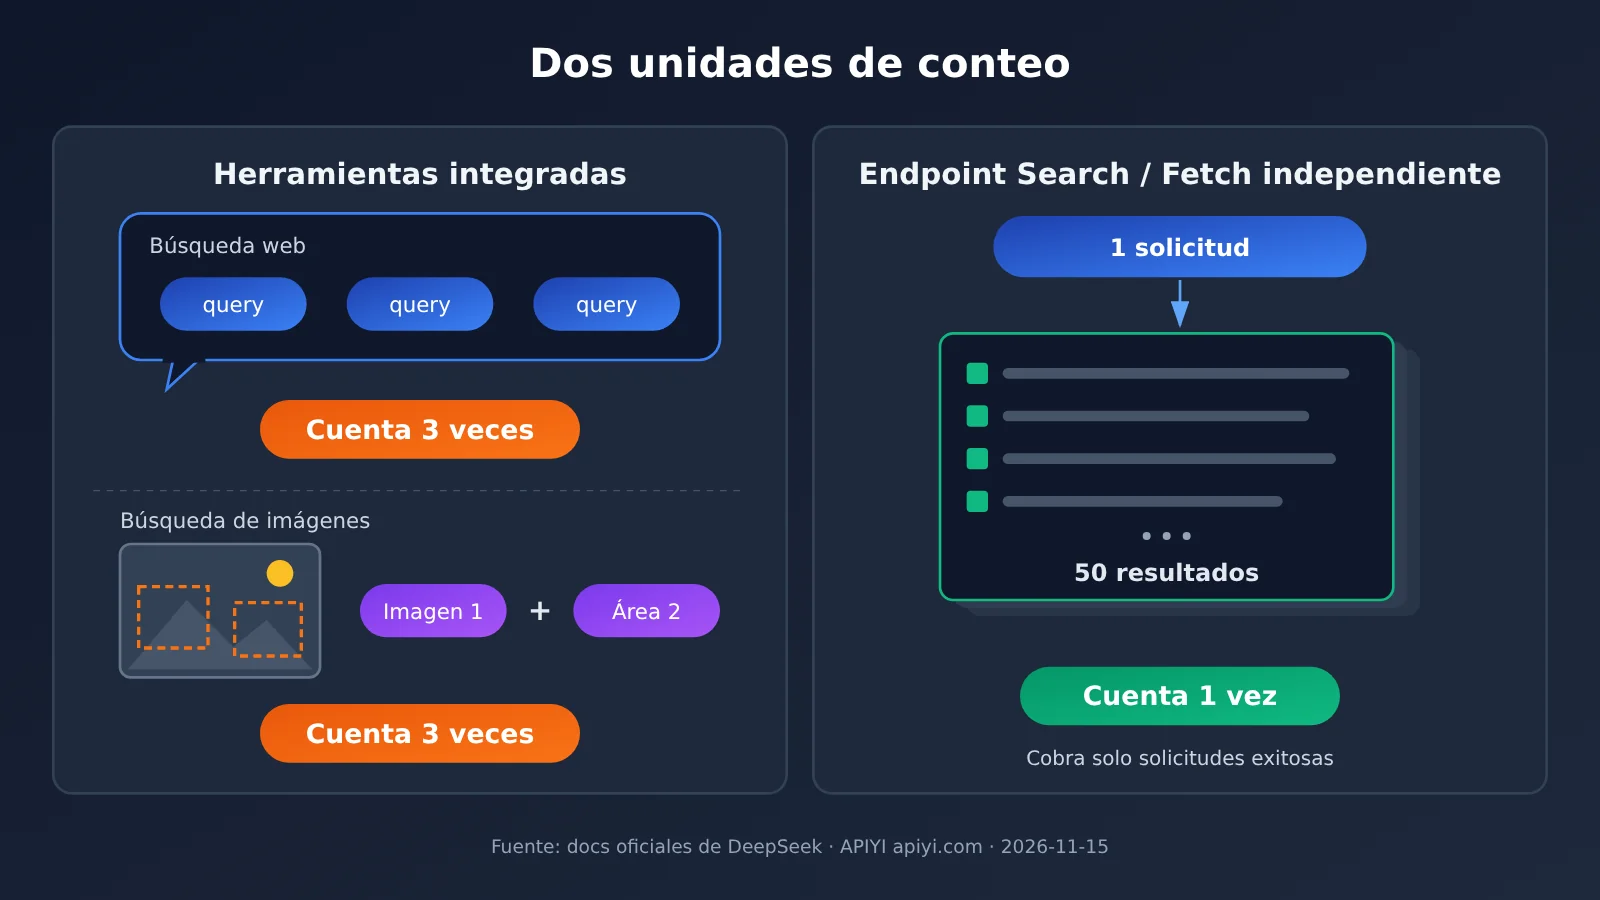
| Escenario | Unidad de conteo | Qué cuenta como una vez | Casos sin cargo |
|---|---|---|---|
| Búsqueda web integrada | query | Si una búsqueda que devuelve resultados contiene varios query, se cuentan todos | Fallo, sin resultados |
| Búsqueda de imágenes integrada | imagen + área | Cada imagen cuenta como 1 vez, y cada área que el modelo marca en la imagen suma 1 más | Fallo, sin resultados |
| Lectura de enlaces integrada | Página capturada con éxito | Se factura si se captura, incluidas las páginas que luego, por revisión de seguridad, se sustituyen por url_not_allowed o unavailable |
Enlaces que no se pueden capturar |
| Accesos repetidos dentro de la búsqueda de razonamiento profundo | Captura real | Solo se factura la vez que realmente se captura de internet | Reabrir la misma página, moverse dentro de la página, contenido ya devuelto junto con los resultados de búsqueda |
| Interfaz independiente Search / Fetch | Solicitud exitosa | Solo cuenta como una vez si hay HTTP 200 y resultados; count no cambia el precio de esa solicitud |
Fallo, resultado vacío, tiempo de espera agotado |
En la página oficial de precios (2026-11-15), tanto Search (texto e imágenes) como Web fetch cuestan 0.75 USD por cada 1000 veces. El precio unitario es el mismo, pero en las herramientas integradas «una vez» significa un query, mientras que en la interfaz independiente «una vez» significa una solicitud exitosa; las cantidades de ambas no se pueden comparar directamente.
No confundas los campos de usage de deepseek-flash
En el usage devuelto hay dos grupos de campos que se parecen mucho, pero cuyo significado no es el mismo:
| Campo | Significado | ¿Sirve para conciliar cuentas? |
|---|---|---|
web_search_requests |
Número de bloques de resultados de búsqueda para visualización, incluidos los erróneos | No |
web_fetch_requests |
Número de bloques de resultados de captura para visualización, incluidos los erróneos | No |
tool_search |
Número de búsquedas facturadas | Sí |
tool_fetch |
Número de capturas facturadas | Sí |
tool_image_search |
Número de búsquedas de imágenes facturadas | Sí |
Si calculas el consumo con web_search_requests, la cifra puede salir más alta de lo real, porque incluye bloques de resultados fallidos; al mismo tiempo, tampoco permite ver cuántos query había en una búsqueda. Para conciliar cuentas hay que usar los tres campos tool_*.
La tarifa de herramientas se cobra aparte de la tarifa de tokens. En el sitio oficial, el precio de tokens de deepseek-flash se divide en hora pico y hora valle: la hora pico es de lunes a viernes de 01:00–04:00 y 06:00–10:00 UTC (sin contar los días festivos oficiales de China), el resto del tiempo es hora valle, y el precio de hora valle es la mitad del de hora pico.
Por qué deepseek-flash «olvida» en la siguiente ronda
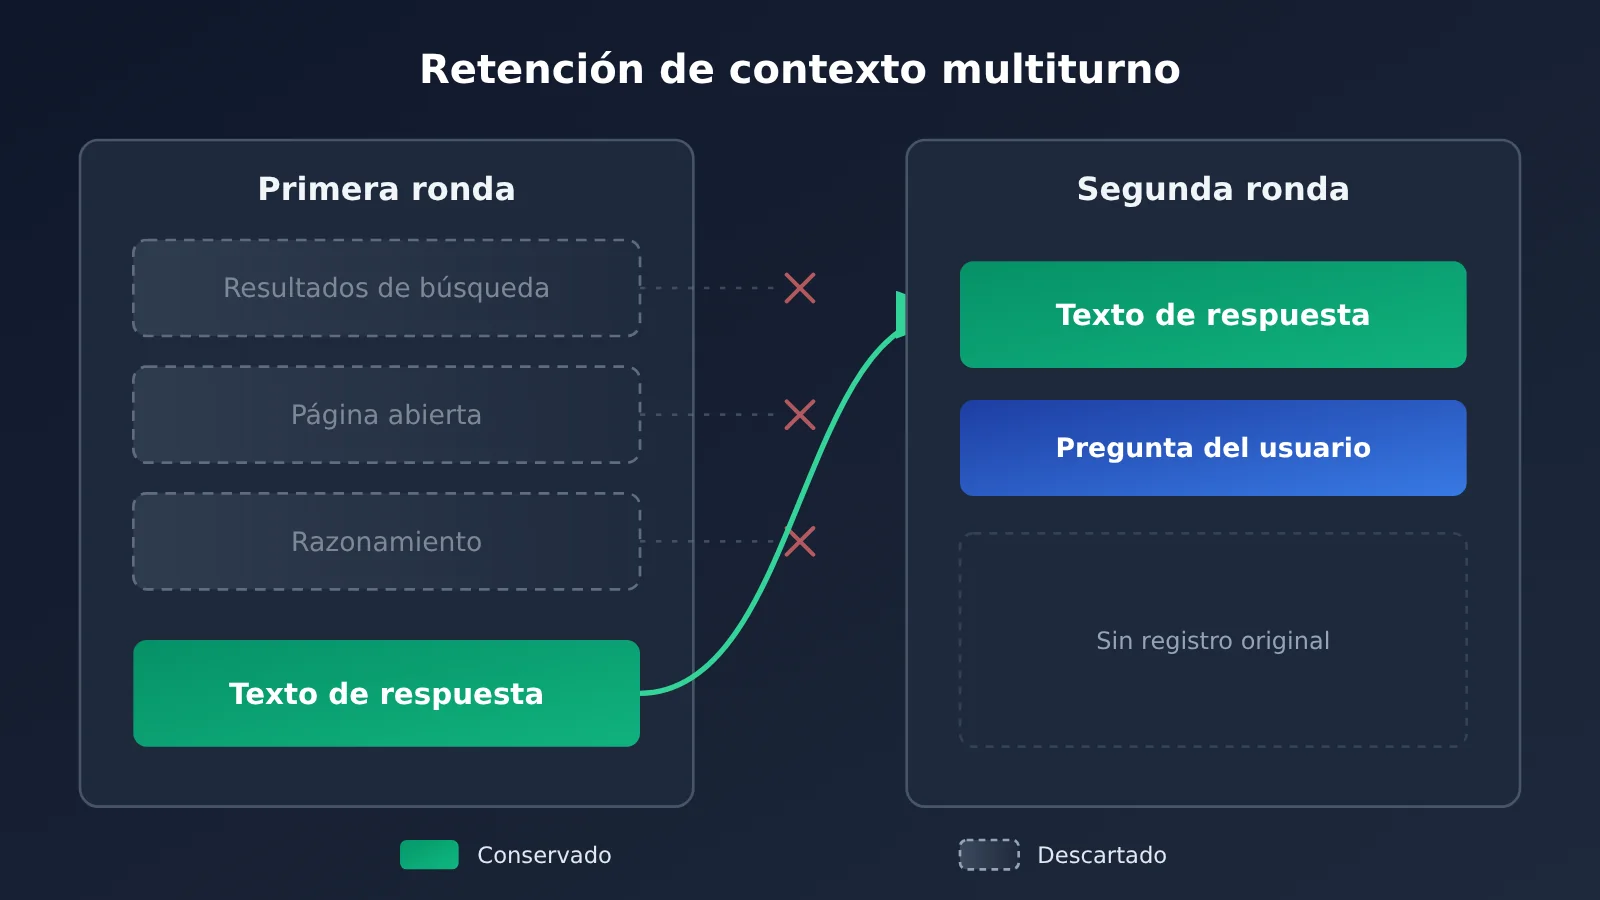
La documentación oficial lo aclara: en una conversación de varias rondas, los resultados de búsqueda, las páginas abiertas y el razonamiento de la ronda anterior no pasan al contexto de la siguiente; solo se conserva el cuerpo de la respuesta.
Así que eso de «olvida» en el título se refiere a que el contexto se limpia, no a que el modelo no haya encontrado nada. En la ronda anterior puede haber leído cinco páginas y citado tres fragmentos textuales, pero en la siguiente solo tiene en la mano la respuesta que él mismo escribió. Cuando el usuario pregunta «¿qué decía exactamente la segunda fuente?», el modelo o vuelve a buscar (y genera otro cargo por uso de herramienta) o se limita a especular a partir de su propia respuesta.
Cuándo conviene no dejar que deepseek-flash busque por su cuenta
En estos casos es mejor que sea el programa quien decida qué buscar, en lugar de dejarlo al modelo:
- Hace falta citar el texto original entre rondas: por ejemplo, cláusulas normativas, contratos o preguntas sobre documentos largos, donde la siguiente ronda todavía debe responder con base en el texto original.
- Hace falta una facturación predecible: la búsqueda con razonamiento profundo lanza varias query y abre varias páginas, y no hay forma de controlarlo de antemano.
- Hace falta limitar las fuentes de información: permitir solo determinados sitios, o excluir obligatoriamente otros.
- Al pegar un enlace hay que leer el texto original: con el razonamiento activado, puede que el enlace no se lea por separado.
- La clave API no está en el sitio oficial de DeepSeek: la plataforma que usas no necesariamente tiene ya conectadas las herramientas integradas; la siguiente sección lo explica en detalle.
deepseek-flash: inicio rápido para conservar páginas web en el contexto
La idea para conservar una página web en el contexto es separar la «búsqueda» de la «respuesta»: el programa llama a las interfaces de búsqueda y extracción, arma el contenido principal dentro de messages y luego lo entrega a deepseek-flash para que responda. Así, el texto original de la página queda en el historial que tú guardas y no se pierde en la siguiente ronda.
En APIYI apiyi.com ya hay dos interfaces independientes disponibles: deepseek-search y deepseek-fetch, lanzadas el 2026-10-21. No son modelos de conversación, no consumen tokens y se facturan por número de solicitudes exitosas; las reglas de facturación son las mismas que las de las interfaces independientes del sitio oficial. Los pasos son:
- En la consola de APIYI, crea un token nuevo y elige el grupo
defaultosvip. Si usas el grupo ClaudeCode, devolverá 503; el texto original del error esno available channels for model deepseek-search. - Búsqueda: haz
POSTa/v1/tools/search, con la URL basehttps://api.apiyi.com; el cuerpo de la solicitud no necesita el campomodel. queryes obligatorio, de 1 a 128 caracteres, y admitesite:,-site:, comillas,lang:,after:,before:countacepta valores entre 1 y 50, por defecto 10, y no afecta el precioneed_contentpor defecto esfalse; si lo configuras como true, también devuelve el contenido principallocalizationse rellena con la IP del usuario; si pones un código de idioma comozh-CN, devolverá 400- Extracción: elige el enlace que quieres leer y haz
POSTa/v1/tools/fetch;urldebe ser una dirección http o https con dominio, de hasta 8192 caracteres, y no puede incluir nombre de usuario ni contraseña. - Respuesta: coloca el contenido principal extraído como un mensaje dentro de messages, llama a
deepseek-flashy configura elbase_urlcompatible con OpenAI enhttps://api.apiyi.com/v1. - Conservación: escribe ese contenido de la página en tu propio historial de conversación y llévalo contigo en la siguiente ronda, o guarda solo un resumen para controlar los tokens.
Los límites de solicitudes del upstream, según la documentación, son: Search 100 QPS, Fetch 25 QPS, y además existen límites por dominio. La documentación, tras volver a probar, menciona otros dos puntos: las palabras clave con caracteres corruptos también pueden devolver algunos resultados y se cobran igualmente; algunos sitios devuelven la página de inicio para páginas inexistentes (un soft 404), y Fetch lo cobra como solicitud exitosa. Antes de hacer fetch, conviene filtrar los enlaces por tu cuenta.
🎯 Recomendación técnica: en escenarios en los que necesitas citar el texto original entre rondas, te sugerimos probar primero de principio a fin la cadena «search → fetch → deepseek-flash» en APIYI apiyi.com con el crédito de prueba gratuito para usuarios nuevos, y confirmar que la longitud del contenido extraído y el número de cobros coinciden con lo esperado antes de pasar a producción.
Qué tener en cuenta con la clave de deepseek-flash cuando no está en el sitio oficial
Hay algo que conviene aclarar desde el principio: a fecha 2026-11-15, ni la tabla general de modelos de APIYI ni el feed de novedades en tiempo real indican que deepseek-flash ya soporte deepseek_web_search. La entrada más reciente sobre DeepSeek en ese feed es el lanzamiento de la versión económica del 2026-11-11, y el 13 de noviembre esta API de App todavía no aparecía. Por lo tanto, al invocar deepseek-flash en APIYI no puedes dar por hecho que basta declarar deepseek_web_search para que busque por su cuenta: hoy su papel es el de modelo de respuesta.
La siguiente tabla recoge los precios a fecha 2026-11-15; los precios por token están en USD por 1 millón de tokens y los modelos por llamada, en USD por llamada:
| Modelo | Precio en APIYI apiyi.com | Comparación con el sitio oficial | Notas |
|---|---|---|---|
deepseek-flash |
Entrada 0.3, salida 1.2, lectura de caché 0.006 | En hora punta igual: 0.3 / 1.2 / 0.006; en hora valle a la mitad | La tabla general no incluye el precio reducido de hora valle |
deepseek-search |
0.0009 / llamada (es decir, 0.90 / 1000 llamadas) | 0.75 / 1000 llamadas | Grupos solo default, svip |
deepseek-fetch |
0.0009 / llamada (es decir, 0.90 / 1000 llamadas) | 0.75 / 1000 llamadas | Grupos solo default, svip |
Los 0.90 USD / 1000 llamadas de la página de capacidades y los 0.0009 USD / llamada de la tabla general son el mismo precio. Según la documentación de APIYI, contando el bono de recarga, un cliente de recarga grande acaba pagando unos 0.75 USD / 1000 llamadas, igual que en el sitio oficial; un usuario normal paga alrededor de 0.82 USD / 1000 llamadas. Estas dos cifras reflejan el descuento por bono, no el precio de la tabla general. Los precios incluyen impuestos y se puede emitir factura.
Además, OCR, ASR y TTS todavía no están disponibles en APIYI; incorporaremos este modelo lo antes posible, y tanto el modelo como el precio se rigen por la lista de modelos de la plataforma.
💡 Sugerencia de elección: Si tu negocio necesita esa «búsqueda multipaso que hace el propio modelo» integrada en el sitio oficial, por ahora tendrás que usar la clave del sitio oficial; si te importan más que el texto original se pueda conservar y que la factura sea predecible, usa la interfaz independiente de APIYI apiyi.com junto con deepseek-flash para las respuestas, y todo el flujo queda en tus manos.
Preguntas frecuentes (FAQ)
Q1: ¿Qué es la búsqueda integrada de deepseek-flash?
Es una herramienta del lado del servidor, `deepseek_web_search`, disponible en deepseek-flash (V4.1-Flash-1017), y se puede usar en los tres protocolos: Messages, Responses y Chat Completions. La invocación de la herramienta y el ensamblado del contexto los realiza el servidor; la tarifa de la herramienta se cobra aparte de la tarifa de tokens.
Q2: ¿Qué diferencia hay entre que deepseek-flash busque por su cuenta y que un programa llame a Search / Fetch?
La búsqueda integrada cobra por cada query y los resultados intermedios no se conservan para la siguiente ronda; la interfaz independiente cobra por cada solicitud exitosa, `count` no afecta el precio y tú decides si conservas el cuerpo devuelto. La primera opción es más fácil de integrar; la segunda ofrece más control.
Q3: ¿Cuándo se lanzó esta capacidad de conexión a internet de deepseek-flash?
DeepSeek lo anunció oficialmente el 2026-11-13 (22:24, hora de Pekín); la página de noticias y el registro de cambios corresponden al mismo día. `deepseek-search` y `deepseek-fetch` se lanzaron en APIYI el 2026-10-21, lo cual no es lo mismo que este lanzamiento.
Q4: ¿Puede buscar por su cuenta la versión económica o V4 Pro?
La documentación oficial indica que esta capacidad de conversación solo se ofrece en deepseek-flash; no hay que aplicarla a deepseek-v4-pro ni a los ID de la versión económica. La versión económica de APIYI, `deepseek-v4-1-flash-economy-261017`, carga los mismos pesos que V4.1-Flash-1017, solo que es más lenta. La estimación que menciona la documentación es de unos 2 segundos hasta el primer token y unos 15 milisegundos por token. No es una interfaz de búsqueda.
Q5: ¿Cómo hacer que deepseek-flash responda basándose en páginas web en APIYI?
Usa un token `default` o `svip` para llamar a `/v1/tools/search` y `/v1/tools/fetch`, inserta el cuerpo en messages y después llama a `deepseek-flash`. Para los parámetros concretos, consulta la página DeepSeek Search / Fetch del centro de documentación de APIYI apiyi.com.
Q6: Al ofrecer servicios al público, ¿qué hay que tener en cuenta en la configuración de seguridad?
La documentación oficial exige activar `safety_check` (en el ejemplo de la documentación, level es high) cuando se ofrecen servicios al público, y completar por cuenta propia la revisión de seguridad del contenido, el registro del Modelo de Lenguaje Grande y el etiquetado de IA. Una vez activado, los parámetros de muestreo como `temperature` se ignoran; cuando el modelo rechaza responder, `stop_reason` es `refusal`. La seguridad del modelo se factura por tokens de salida y no se desglosa como un precio unitario aparte.
Q7: ¿Me cobran si ninguna query encuentra resultados?
La búsqueda integrada no cobra cuando falla o no encuentra resultados. La interfaz independiente solo cobra cuando el HTTP es 200 y hay resultados; los 400 y los 404 por fallo de captura no se cobran. Pero una prueba posterior mencionada en la documentación señala que las palabras clave con caracteres corruptos y los soft 404 todavía podrían generar cargos.
deepseek-flash: busca, pero también olvida — Puntos clave
- El pensamiento cambia la forma de buscar: con el pensamiento desactivado es una búsqueda con citas; con el pensamiento activado es una búsqueda de razonamiento profundo en varios pasos.
- No siempre se leen los enlaces: cuando el pensamiento está activado y se ha declarado
deepseek_web_search, los enlaces no se leen por separado. - La facturación cuenta por query: si una búsqueda contiene tres queries, se cuentan como tres; los fallos o los resultados vacíos no se cobran.
- Para conciliar, fíjate en el campo tool:
web_search_requestssolo sirve para mostrar; el número de cobros se consulta en campos comotool_search. - En la siguiente ronda solo queda la respuesta: las páginas web, las páginas cargadas y el pensamiento se descartan; «olvida» se refiere al contexto.
- Si quieres conservar las páginas web, búscalas tú mismo: en APIYI apiyi.com usa
deepseek-searchjunto condeepseek-fetchy luego pásalo a deepseek-flash.
Resumen
deepseek-flash busca, pero también olvida; hay tres cosas que tener en cuenta:
- Pensamiento: la misma declaración de
deepseek_web_searchsigue dos flujos distintos según el interruptor de pensamiento, y el comportamiento de lectura de enlaces cambia con ello. - Facturación: las herramientas integradas cuentan por query, imagen y área seleccionada; la interfaz independiente cuenta por solicitud exitosa. No mezcles las dos unidades de conteo.
- Siguiente ronda: solo se conserva el cuerpo de la respuesta; si necesitas citar el texto original entre rondas, el programa debe buscar y guardar el contenido por su cuenta.
Si tu clave API está en APIYI, por ahora la documentación no indica que deepseek-flash ya tenga integrada la búsqueda interna. Puedes probar primero la combinación de la interfaz independiente con deepseek-flash usando la cuota gratuita de APIYI apiyi.com, y luego decidir si necesitas la búsqueda integrada del sitio oficial.
📚 Referencias
- Página de noticias de DeepSeek (2026-11-13): Anuncio sobre la apertura de las capacidades de la App a la API
- Enlace:
api-docs.deepseek.com/zh-cn/news/news261113 -
Nota: Confirma que solo deepseek-flash incorpora este conjunto de capacidades
-
Guía Build a Chatbot de DeepSeek: Comparación de comportamiento entre el interruptor de razonamiento y la combinación de herramientas
- Enlace:
api-docs.deepseek.com/guides/build_a_chatbot -
Nota: Reglas de búsqueda con razonamiento profundo, lectura de enlaces y contexto multiturno
-
Guía Web Tools de DeepSeek: Uso y facturación de las herramientas integradas
- Enlace:
api-docs.deepseek.com/guides/web_tools -
Nota: Cobro por query y significado del campo usage
-
Página de precios de DeepSeek: Precio por token, horas pico y horas valle, precio unitario de las herramientas
- Enlace:
api-docs.deepseek.com/quick_start/pricing -
Nota: Datos del 2026-11-15
-
Documentación de DeepSeek Search / Fetch de APIYI: Parámetros y facturación de la interfaz independiente
- Enlace:
docs.apiyi.com/api-capabilities/deepseek-search-fetch/overview -
Nota: Requisitos de grupo, límites de parámetros y notas sobre la revisión repetida de la documentación
-
Tabla general de modelos de APIYI: Modelos y precios en tiempo real
- Enlace:
docs.apiyi.com/models - Nota: Los modelos y precios se rigen por esta tabla
Autor: Equipo técnico de APIYI
Contacto técnico: Escríbenos desde la página principal de APIYI apiyi.com; encontrarás más materiales en el centro de documentación docs.apiyi.com