Nota del autor: cuando llamas a la interfaz de generación de imágenes, que la respuesta no traiga ninguna imagen no significa que la solicitud haya fallado, y mucho menos que no te hayan cobrado. Este artículo te da un método de 4 pasos para revisar primero la respuesta y decidir después si reintentar, además de código en Python que puedes usar tal cual.
Si trabajas con interfaces de imágenes, quizá te haya pasado esto: la solicitud salió, la interfaz respondió, pero en el resultado no hay ni rastro de la imagen. Muchos piensan primero en un fallo momentáneo de red y vuelven a llamar enseguida, o incluso escriben un bucle que lo intenta varias veces seguidas. Aquí verás un orden de trabajo distinto: primero revisar la respuesta y después decidir si reintentar. Así sabrás cómo investigar correctamente cuando la generación de imágenes no devuelve ninguna.
Esto no es una guía genérica sobre reintentos. En los modelos de generación de imágenes con cobro por solicitud, cada petición puede generar un cargo. Tomemos como ejemplo gpt-image-2.6-all, que salió en APIYI el 2026-11-12 y cuesta $0.025 por solicitud: si una respuesta vacía se reintenta sin analizarla, pagas otra vez.
Valor central: al terminar este artículo sabrás qué revisar primero cuando no llega ninguna imagen, en qué casos se puede reintentar y en cuáles nunca, y cómo llevar ese criterio al código para que no te cobren dos veces la misma imagen.
Puntos clave cuando la generación de imágenes no devuelve ninguna imagen
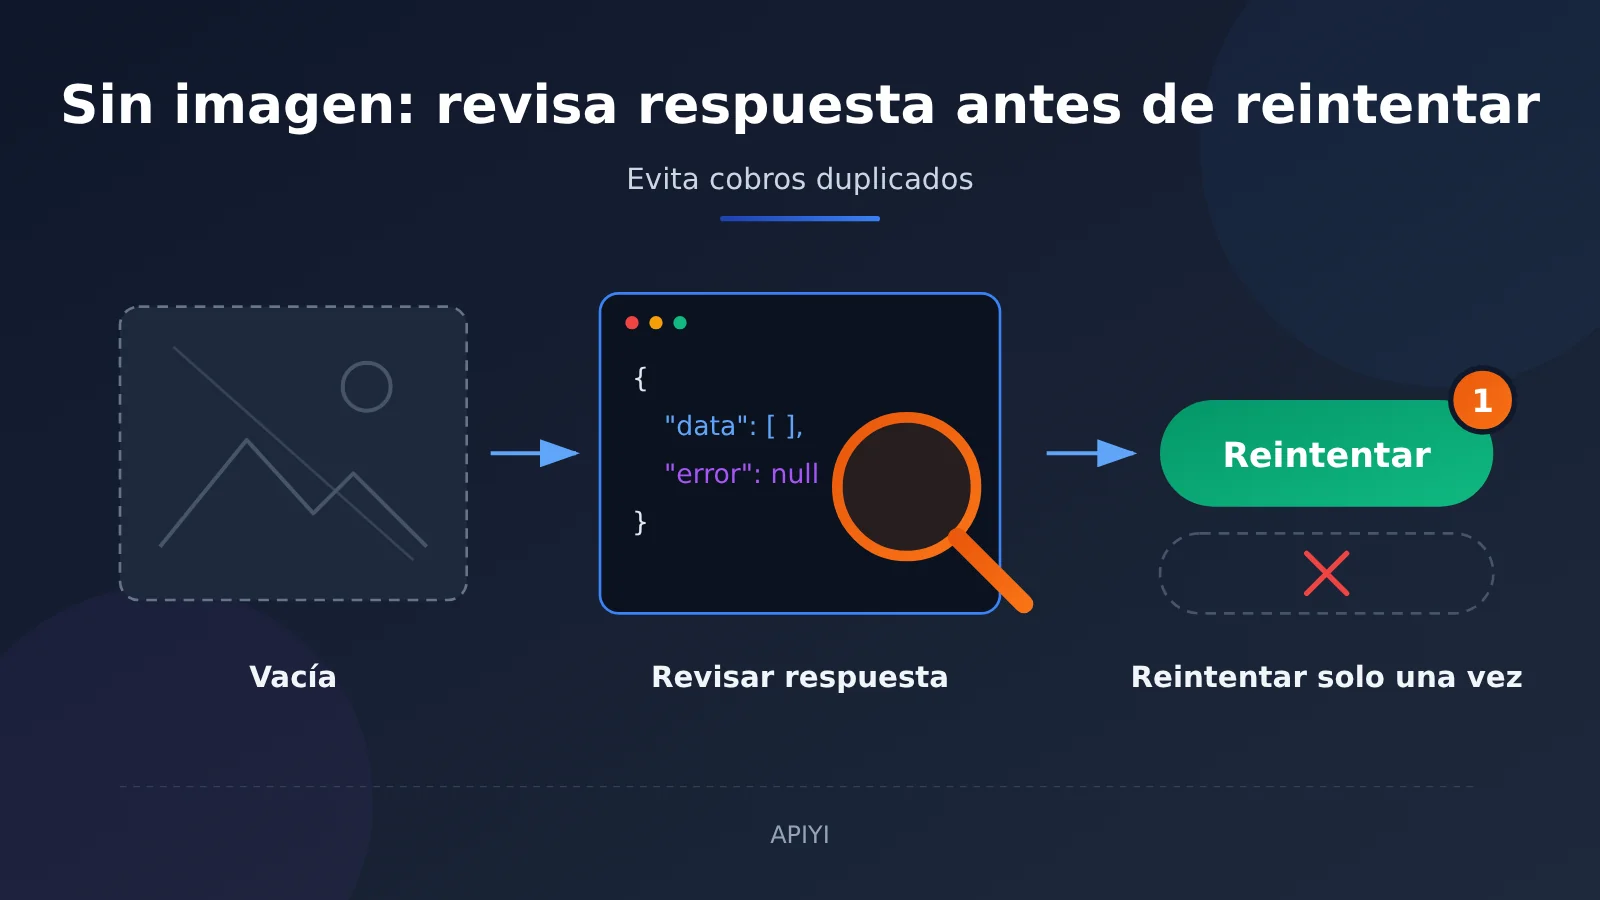
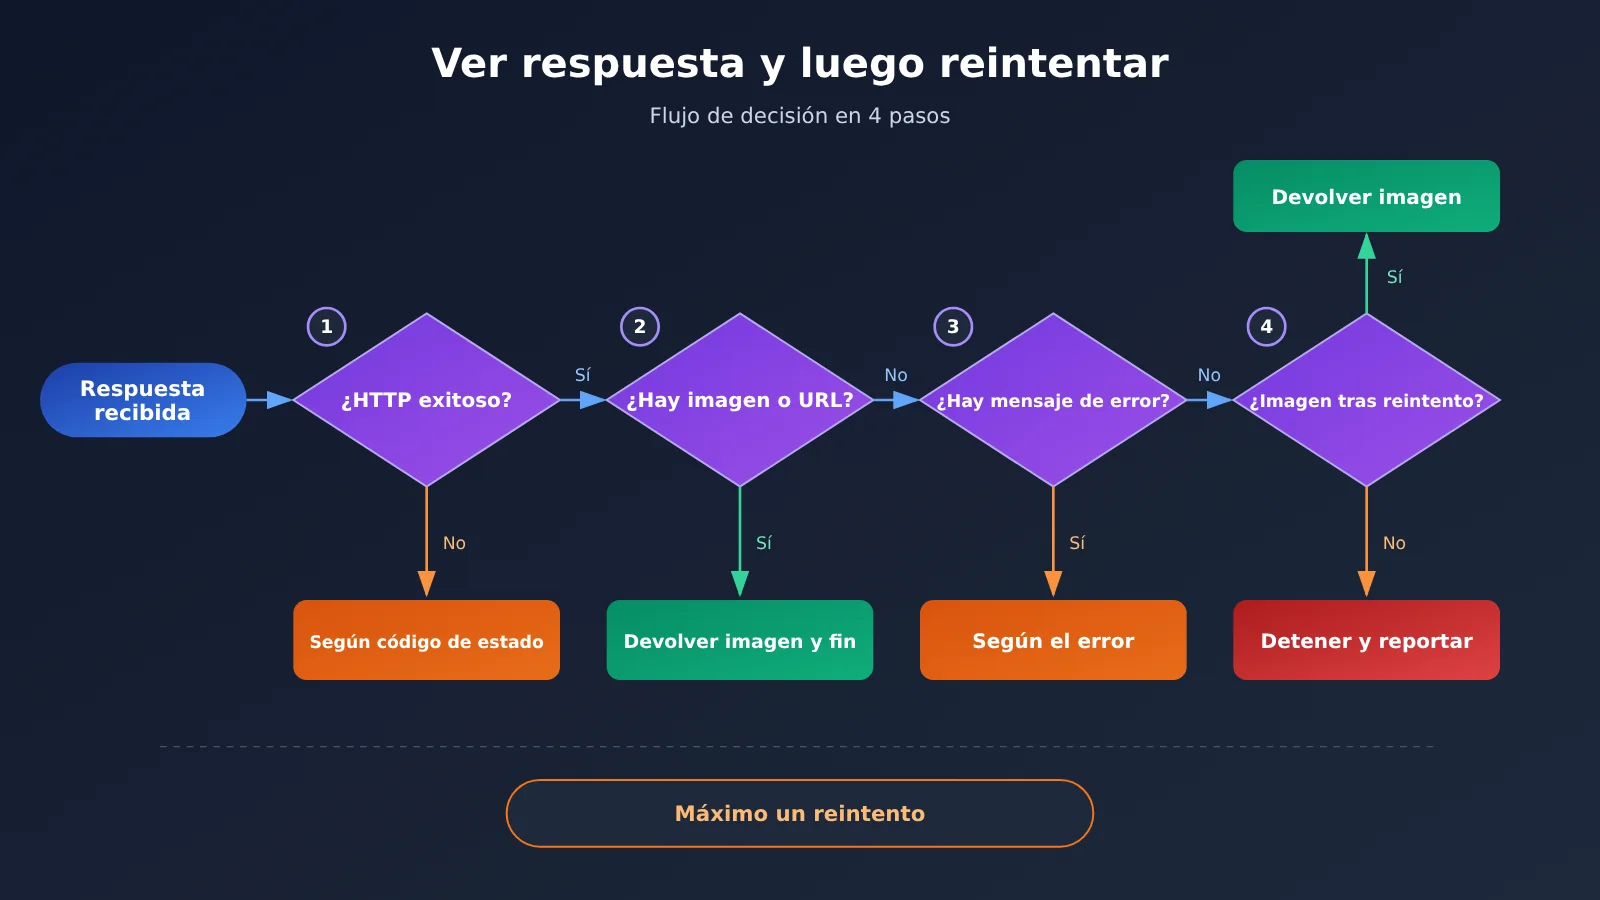
Vamos primero a la conclusión. Cuando una solicitud de generación de imágenes no devuelve ninguna imagen, no conviene despacharla sin más como un problema de red: hay que revisar el contenido de la respuesta siguiendo un orden fijo. La siguiente tabla resume los 4 pasos de este método de diagnóstico.
| Paso | Qué se comprueba | Qué hacer si la respuesta es «no» | Valor |
|---|---|---|---|
| Paso 1 | Si la solicitud HTTP tuvo éxito | Se gestiona según el código de estado y no se pasa a los siguientes pasos | Distingue los fallos de la capa de solicitud de los problemas de contenido |
| Paso 2 | Si la respuesta contiene datos de imagen o una URL de imagen | Pasar al paso 3 | Si hay imagen, se termina ahí y se evitan reintentos innecesarios |
| Paso 3 | Si la respuesta contiene información de error | Si hay error, se gestiona según ese error | Evita pagar una y otra vez por solicitudes que van a fallar sí o sí |
| Paso 4 | Se confirma que no hay imagen ni error | Reintentar una sola vez | Mantiene el coste extra dentro de un rango predecible |
Por qué no conviene reintentar de inmediato cuando no llega la imagen
Una solicitud de generación de imágenes no es como una conversación de texto normal: cada llamada cuesta más y el resultado muchas veces no es de «todo o nada». Puede que el servidor ya haya terminado de generar la imagen y que tu código simplemente no la haya leído del campo correcto; o puede que la solicitud haya sido rechazada y la respuesta te diga el motivo con toda claridad. Si reintentas de inmediato, en el primer caso pagarás dos veces por la misma imagen, y en el segundo pagarás repetidamente por una solicitud condenada al fracaso.
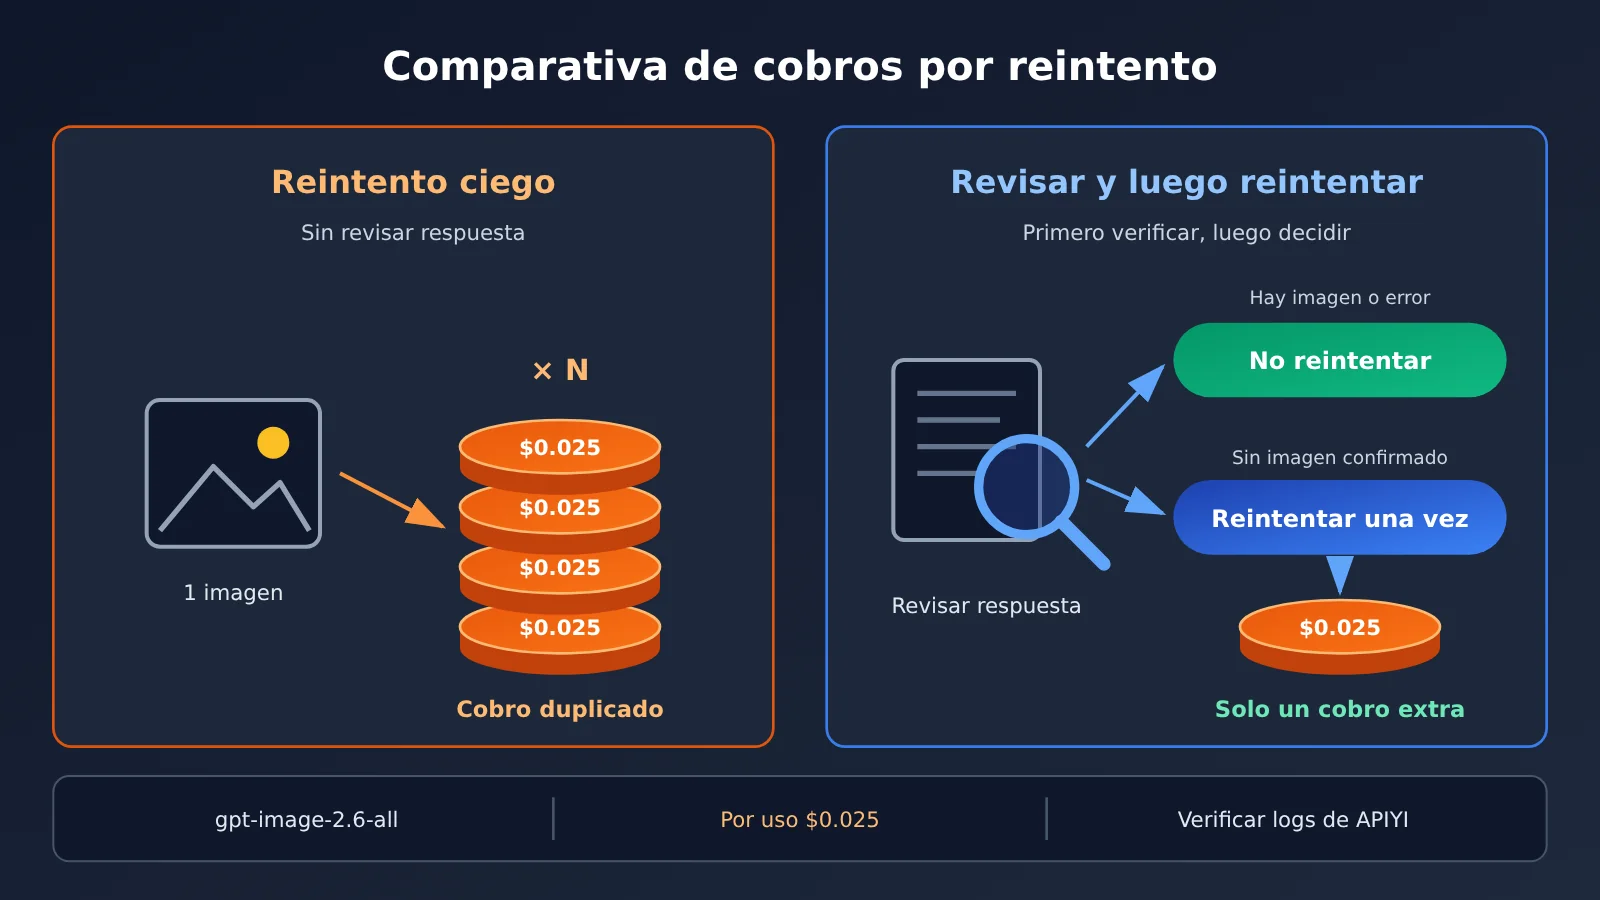
Tomando como ejemplo el precio por llamada de gpt-image-2.6-all, que es de $0.025, cada reintento a ciegas supone otros $0.025. Si tratas una respuesta vacía como una fluctuación de red y la metes en un bucle de reintentos, 3 reintentos suponen $0.075 de más, y es posible que ni un solo centavo de eso te dé una imagen válida. Por eso, cuando no llega la imagen, mirar primero la respuesta y reintentar después es, en el fondo, hacer una comprobación de coste casi nulo antes de gastar dinero.
La lógica de «primero la respuesta, luego el reintento»
El orden de las comprobaciones sigue un principio de «de fuera hacia dentro». El código de estado HTTP es la señal más externa y te dice si la solicitud se procesó con normalidad. Los datos de imagen son lo que realmente buscas, así que se revisan a continuación. La información de error es el motivo del fallo que el servidor te da de forma explícita, y tiene prioridad sobre el reintento. Solo cuando las tres capas anteriores se han revisado y se confirma que de verdad no hay imagen ni ninguna explicación de error, tiene sentido reintentar.
Hay un detalle que se suele pasar por alto: en el paso 2 se comprueban «los datos de imagen o la URL de imagen». Según el tipo de interfaz, la imagen llega en sitios distintos: a veces va en los campos b64_json o url dentro del array data, y otras veces el enlace de la imagen viene escrito en el texto de content de un mensaje de conversación. Si tu código de análisis solo reconoce una de esas formas, tomará por vacía una respuesta que sí tiene imagen, y esa es una de las causas más habituales de reintentos innecesarios.
Desglose de los tipos de respuesta cuando la generación de imágenes no devuelve ninguna imagen
Para revisar la respuesta antes de reintentar, primero hay que saber qué pinta puede tener. La siguiente tabla recoge los tipos de respuesta más habituales y cómo tratar cada uno.
| Tipo de respuesta | Rasgo típico | ¿Ya se generó la imagen? | Tratamiento recomendado |
|---|---|---|---|
| Fallo en la capa de la solicitud | Código de estado HTTP que no es 2xx | No | Actuar según el código de estado; si es un problema de autenticación o de parámetros, corregirlo antes de volver a enviar |
| Imagen generada correctamente (estructurada) | data contiene b64_json o url |
Sí | Obtener la imagen directamente, sin reintentar |
| Imagen generada correctamente (incrustada en texto) | El content del mensaje incluye un enlace a la imagen |
Sí | Extraer el enlace con una expresión regular, sin reintentar |
| Respuesta exitosa con información de error | HTTP correcto, pero el cuerpo contiene error o una explicación de rechazo |
No | Leer la causa del error y modificar la indicación o los parámetros |
| Respuesta realmente vacía | HTTP correcto, sin imagen y sin error | No | Guardar la respuesta original y reintentar una sola vez |
| Tiempo de espera agotado | El cliente no recibió respuesta | No se puede confirmar | No reenviar automáticamente; primero revisar los registros y la facturación |
Por qué también hay que mirar antes de reintentar en un timeout
El timeout es el caso que más fácilmente se confunde con una «fluctuación de red», y justamente por eso requiere más cautela. Que el cliente agote el tiempo solo significa que no esperaste lo suficiente la respuesta; no demuestra que el servidor no haya terminado la generación. Generar imágenes tarda bastante, y si el tiempo de espera del cliente es corto, es muy posible que el servidor ya haya generado la imagen y cobrado la solicitud, mientras tu programa abandonó la espera antes de tiempo.
Lo razonable en estos casos es, primero, ampliar un poco el tiempo de espera; después, cuando ocurra un timeout, registrar la hora y los parámetros de la solicitud y comprobar en los registros de invocación de la consola cuál fue el estado real de esa petición. Si confirmas que no hay un registro exitoso, reenviarla manualmente es mucho más seguro que dejar que el programa dispare reintentos en cadena.
Las respuestas con información de error se tratan como errores
Algunas respuestas tienen un estado HTTP exitoso, pero el cuerpo incluye un objeto de error, o el modelo explica en el texto por qué no pudo generar la imagen; por ejemplo, porque la indicación activó la moderación de contenido. Aunque estas respuestas no traen imagen, la causa ya está bien explicada, y reintentar tal cual casi seguro dará el mismo resultado.
Lo correcto es leer el mensaje de error y determinar si se trata de un problema de parámetros, de contenido o de una falla temporal del servidor. Los problemas de parámetros y de contenido exigen modificar la solicitud antes de volver a enviarla; solo cuando el mensaje apunta claramente a una falla temporal conviene plantearse reintentar tras esperar un rato.
Cuando la generación de imágenes no devuelve ninguna imagen, revisa la respuesta antes de reintentar: guía rápida
A continuación te muestro en Python cómo llevar esta lógica de decisión al código. El ejemplo usa la interfaz compatible con OpenAI y, como modelo, gpt-image-2.6-all. El endpoint concreto y el formato de respuesta dependen de lo que indique la documentación de APIYI para ese modelo, así que consúltala.
Ejemplo mínimo: comprueba si hay imagen en cuanto recibas la respuesta
Lo más sencillo es mirar el campo de la imagen nada más recibir la respuesta: si hay imagen, terminas ahí; si no, pasas a investigar el motivo:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Interfaz compatible con OpenAI de APIYI
)

resp = client.images.generate(
    model="gpt-image-2.6-all",
    prompt="一只坐在窗台上的橘猫,水彩风格",
)

item = resp.data[0] if resp.data else None
if item and (item.b64_json or item.url):
    print("已拿到图片,不要重试")
else:
    print("响应里没有图片,先打印原始响应再决定")
    print(resp.model_dump())
Son apenas una docena de líneas, pero ya evitan el error más habitual: volver a lanzar la petición sin mirar el contenido de la respuesta. Los fallos a nivel HTTP los notifica el SDK mediante excepciones, así que puedes capturarlas con un try externo y tratarlas según el código de estado, en lugar de meterte directamente en un bucle de reintentos.
Ejemplo completo: 4 pasos de verificación y un máximo de un reintento
En producción te recomiendo usar esta versión más completa. Cubre la comprobación del estado HTTP, el análisis de las dos ubicaciones posibles de la imagen en la respuesta, la detección de mensajes de error, no reintentar automáticamente tras un timeout, y el límite de «máximo un reintento una vez confirmado que no hay imagen»:
import re
import requests

API_KEY = "YOUR_API_KEY"
BASE_URL = "https://api.apiyi.com/v1"  # Dirección unificada de la interfaz de APIYI
MODEL = "gpt-image-2.6-all"
IMG_URL_RE = re.compile(r"https?://\S+?\.(?:png|jpe?g|webp)", re.I)


def find_images(body):
    """Revisa a la vez el campo estructurado data y los enlaces de imagen en el content de la conversación"""
    images = []
    for item in body.get("data") or []:
        if item.get("url"):
            images.append(item["url"])
        elif item.get("b64_json"):
            images.append("base64-image")
    for choice in body.get("choices") or []:
        content = (choice.get("message") or {}).get("content") or ""
        images += IMG_URL_RE.findall(content)
    return images


def generate_with_check(prompt, max_retry=1):
    for attempt in range(max_retry + 1):
        try:
            resp = requests.post(
                f"{BASE_URL}/images/generations",
                headers={"Authorization": f"Bearer {API_KEY}"},
                json={"model": MODEL, "prompt": prompt},
                timeout=300,
            )
        except requests.Timeout:
            # Tras un timeout no se puede confirmar si el servidor ya generó la imagen y la cobró, así que no se reintenta automáticamente
            return {"status": "timeout", "action": "check_logs_first"}

        # Paso 1: ¿la petición HTTP fue exitosa?
        if resp.status_code != 200:
            return {"status": "http_error", "code": resp.status_code,
                    "detail": resp.text[:500]}

        try:
            body = resp.json()
        except ValueError:
            return {"status": "bad_json", "detail": resp.text[:500]}

        # Paso 2: ¿la respuesta contiene datos de imagen o una URL de imagen?
        images = find_images(body)
        if images:
            return {"status": "ok", "images": images}

        # Paso 3: si hay un mensaje de error, se trata como error y no se reintenta
        if body.get("error"):
            return {"status": "api_error", "error": body["error"]}

        # Paso 4: solo se permite reintentar tras confirmar que no hay imagen ni error y registrar la respuesta original
        print(f"第 {attempt + 1} 次请求无图片,原始响应:{str(body)[:300]}")

    return {"status": "empty_after_retry", "action": "stop_and_report"}


result = generate_with_check("一只坐在窗台上的橘猫,水彩风格")
print(result)
Hay varias decisiones de diseño en este código que conviene tener presentes. max_retry vale 1 por defecto, así que una imagen genera como máximo dos cobros por petición, y el techo de coste es predecible. La rama del timeout devuelve el resultado directamente en lugar de seguir con el bucle, porque tras un timeout no hay forma de saber si ya se cobró. Y cada vez que una respuesta se considera vacía se imprime la respuesta original, para que después puedas averiguar si el problema estaba en el análisis o si el servidor realmente no generó la imagen.
🚀 Empieza rápido: si quieres validar primero esta lógica de verificación en un entorno de pruebas, puedes conseguir créditos de prueba gratuitos en APIYI (apiyi.com). Con la misma clave API puedes invocar gpt-image-2.6-all y otros modelos populares, así que puedes dejar funcionando el flujo de verificación antes de pasarlo a producción.
Comparación de costos al reintentar a ciegas cuando la generación de imágenes no devuelve ninguna imagen
Antes de escribir la lógica de decisión en el código, mucha gente no tiene una idea clara de lo que cuesta «reintentar unas cuantas veces más». A continuación, con el precio de gpt-image-2.6-all, que es de $0.025 por llamada, comparamos el gasto extra por imagen entre dos estrategias: lanzar peticiones a ciegas y revisar primero la respuesta antes de reintentar.
| Estrategia | Máx. de peticiones por imagen | Gasto extra en el peor caso | Riesgo |
|---|---|---|---|
| Sin revisar, reintentar 1 vez si falla | 2 | $0.025 | Puede cobrarte de nuevo una petición que sí generó imagen |
| Sin revisar, bucle de 3 reintentos | 4 | $0.075 | Pagas una y otra vez por peticiones que van a fallar sí o sí |
| Sin revisar, bucle hasta que salga imagen | Indeterminado | Sin límite | Sigues pagando cuando hay rechazos por moderación de contenido |
| Revisar la respuesta y reintentar 1 vez solo si no hay imagen | 2 | $0.025 | Solo pagas el extra cuando la respuesta está realmente vacía |
A simple vista, el peor caso de «revisar la respuesta y luego reintentar» y el de «reintentar 1 vez si falla» cuesta lo mismo, pero lo que dispara cada uno es totalmente distinto. En el primero, los $0.025 solo se gastan cuando confirmas que no hay imagen ni mensaje de error. En el segundo, ese dinero también se va cuando la imagen sí se generó pero falló el parseo, o cuando el contenido fue rechazado, y encima no obtienes nada a cambio.
Cuando el volumen de llamadas crece y pasas a generar imágenes por lotes, esta diferencia se multiplica. Esos $0.025 extra por imagen, multiplicados por las peticiones diarias, son un gasto totalmente evitable.
Referencia de interfaces y modelos cuando la generación de imágenes no devuelve ninguna imagen
Según el modelo y el tipo de interfaz, la imagen puede venir en lugares distintos, y eso afecta directamente a que el diagnóstico del paso 2 sea correcto. La tabla siguiente recoge los formatos de respuesta más comunes y los puntos clave a revisar, para que compruebes que tu código de parseo no se está dejando ninguna imagen.
| Formato de respuesta | Dónde está la imagen | Claves para el parseo | Plataformas disponibles |
|---|---|---|---|
| Interfaz de generación de imágenes (URL) | data[].url |
Ten en cuenta que el enlace puede caducar, así que descarga y guarda la imagen cuanto antes | APIYI apiyi.com (consulta la documentación del modelo) |
| Interfaz de generación de imágenes (Base64) | data[].b64_json |
Decodifícala y escríbela en un archivo; no la confundas con una cadena vacía | Igual que arriba |
| Imagen incrustada en la interfaz de chat | choices[].message.content |
Usa una expresión regular para extraer la imagen en Markdown o el enlace | Igual que arriba |
| Respuesta en streaming | El contenido completo tras unir los fragmentos | Espera a que termine el flujo y a tener el contenido completo antes de decidir si hay imagen | Igual que arriba |
La respuesta en streaming es otro punto donde es fácil llegar a un diagnóstico erróneo. Si buscas la imagen en cuanto llega el primer fragmento, lógicamente no vas a encontrar nada. Cuando la generación de imágenes no devuelva ninguna imagen, asegúrate de estar revisando la respuesta completa y no un estado intermedio.
Preguntas frecuentes (FAQ)
P1: Si la generación de imágenes no devolvió ninguna imagen, ¿significa que no se cobró?
No necesariamente. Que la solicitud se cobre depende de si el servidor llegó a procesarla, no de si tu código logró extraer la imagen. Si te equivocas con el campo que parseas, si no ensamblas por completo la respuesta en streaming o si el cliente da timeout antes de tiempo, puede pasar que «ya se cobró pero tú no recibiste la imagen». Por eso conviene revisar primero la respuesta y reintentar después, en lugar de asumir que no hubo cobro y volver a lanzar la solicitud sin pensar.
P2: ¿En qué se diferencia «revisar la respuesta antes de reintentar» del reintento con backoff exponencial de siempre?
El backoff exponencial resuelve el «cuándo reintentar» y encaja bien con límites de tasa y fallos temporales del servidor. Revisar la respuesta antes de reintentar resuelve el «si se debe reintentar o no». En las solicitudes de generación de imágenes que se cobran por llamada, primero hay que confirmar con los 4 pasos de verificación que de verdad hace falta reintentar, y luego usar una estrategia de backoff para decidir el momento. Es una relación secuencial, no de sustitución.
P3: ¿Cuándo salió gpt-image-2.6-all y cuánto cuesta?
gpt-image-2.6-all se lanzó el 2026-11-12 en APIYI, con cobro por llamada de $0.025. Cobro por llamada significa que cada solicitud se factura de forma independiente: si reintentas directamente tras una respuesta vacía, pagas otra vez. Esa es la razón directa por la que este artículo insiste en revisar la respuesta antes de reintentar.
P4: ¿En qué casos nunca se debe reintentar cuando la generación de imágenes no devuelve imagen?
Hay tres tipos principales:
– **La respuesta incluye un mensaje de error**: por ejemplo, la indicación activó la moderación de contenido o los parámetros no son válidos. Si reintentas igual, el resultado será el mismo.
– **Timeout de la solicitud**: no se puede confirmar si el servidor llegó a generar la imagen y a cobrarla, así que primero hay que revisar los registros.
– **Errores HTTP de autenticación o de saldo**: reintentar no cambia el resultado; antes hay que corregir la clave o el problema de saldo.
P5: ¿Cómo puedo comprobar rápido que mi lógica de decisión es correcta?
Te recomiendo ejecutar primero el flujo completo en un entorno de pruebas:
1. Regístrate en APIYI (apiyi.com) para obtener una clave API y crédito gratuito de prueba.
2. Configura el `BASE_URL` del ejemplo completo de este artículo como `https://api.apiyi.com/v1` y llama a gpt-image-2.6-all.
3. Prueba con una indicación normal y con otra que pueda ser rechazada, y observa qué devuelve cada rama.
Cuando confirmes que cada tipo de respuesta cae en la rama correcta, ya puedes integrarlo en el entorno de producción.
P6: Si después de un reintento sigue sin haber imagen, ¿qué hago?
Detén los reintentos automáticos y guarda las respuestas originales de ambas solicitudes, junto con los parámetros y la hora. Primero revisa si tu código de parseo se está saltando el campo de la imagen y luego contrasta en la consola los registros de esas dos llamadas. Si confirmas que el servidor devuelve resultados vacíos de forma consecutiva, puedes contactar con el soporte técnico de APIYI (apiyi.com) con la hora de las solicitudes y las respuestas originales para que lo investiguen. Es más efectivo que seguir pagando por reintentos.
P7: En generación por lotes, ¿cómo controlo el coste de los reintentos?
Asigna a cada tarea de generación su propio contador de reintentos y fija el máximo por tarea en 1. También conviene medir la «tasa de respuestas vacías» a nivel de tarea: si en un lote hay claramente más respuestas vacías de lo normal, revisa primero las indicaciones y la lógica de parseo en lugar de aumentar el número de reintentos en general.
Qué hacer cuando la generación de imágenes no devuelve nada: revisa la respuesta antes de reintentar. Puntos clave (Key Takeaways)
- Sin imagen no significa sin cobro: en las solicitudes de generación de imágenes facturadas por llamada, si el servidor llegó a procesarlas, es posible que ya se hayan cobrado.
- Orden de comprobación fijo: estado HTTP → datos de imagen o URL → mensaje de error → reintentar solo cuando se confirma que no hay imagen.
- Un solo reintento: si confirmas que no hay imagen ni error, reintenta una única vez; así el coste máximo es predecible.
- Los timeouts no se reenvían automáticamente: un timeout no te permite saber si la imagen se generó o no, así que revisa primero los logs y luego decide si reenviar.
- El análisis debe cubrir varias ubicaciones: revisa tanto el campo
datacomo elcontentde la conversación para no confundir una respuesta con imagen con una vacía. - Los reintentos a ciegas tienen un coste claro: con gpt-image-2.6-all, cada reintento a ciegas supone pagar otros $0.025.
- Valida primero con crédito de prueba: puedes probar todo el flujo de comprobación con el crédito de prueba gratuito de APIYI (apiyi.com) antes de pasar a producción.
Resumen
Esto es lo esencial cuando la generación de imágenes no devuelve ninguna imagen: mira la respuesta antes de reintentar.
- Primero investiga, luego gasta: revisar la respuesta cuesta casi nada; cada reintento a ciegas se paga.
- Sigue los 4 pasos en orden: si el HTTP fue exitoso, si hay imagen, si hay error y, solo cuando confirmes que no hay imagen, reintentar una vez.
- Lleva las reglas al código: limita el número de reintentos, no reenvíes automáticamente tras un timeout y guarda la respuesta original. Así el coste se mantiene bajo control y los problemas se pueden rastrear.
Para quienes usan modelos de imágenes facturados por llamada, este método no es complicado, pero evita de forma concreta que te cobren dos veces por la misma imagen. Te recomiendo recorrer todas las ramas en un entorno de pruebas y, después, convertirlo en tu envoltorio estándar para las llamadas de generación de imágenes.
Te sugiero validar esta lógica rápidamente a través de APIYI (apiyi.com). La plataforma ofrece una interfaz compatible con OpenAI y crédito de prueba gratuito, y con una sola clave puedes invocar gpt-image-2.6-all y otros modelos populares.
📚 Referencias
- Centro de documentación de APIYI: forma de invocación de los modelos y descripción del formato de respuesta
- Enlace:
docs.apiyi.com -
Descripción: consulta los endpoints de invocación y los campos de respuesta de gpt-image-2.6-all; en caso de duda, manda la documentación
-
Referencia de la API Images de OpenAI: estructura de respuesta estándar de la interfaz de generación de imágenes
- Enlace:
platform.openai.com/docs/api-reference/images - Descripción: te ayuda a entender qué significan los campos
urlyb64_jsondentro del arraydata
Autor: Equipo técnico de APIYI
Intercambio técnico: puedes contactarnos desde la página principal de APIYI; para más material de integración, visita el centro de documentación en docs.apiyi.com