Nota del autor: MiniMax H3 y H3-Image han abierto los pesos de sus modelos, pero son los componentes del sistema, los servicios en la nube y las licencias comunitarias los que fijan los límites del desarrollo y del uso comercial. En este artículo lo desglosamos módulo por módulo y licencia por licencia.
El 10 de noviembre de 2026, MiniMax abrió los pesos del modelo H3-Image. Antes, el 3 de agosto de 2026, ya había liberado el modelo omnimodal de generación de video MiniMax H3, ahora de código abierto. Entre un lanzamiento y otro pasaron más de tres meses, y a menudo se mezclan en las conversaciones, pero son dos modelos distintos con dos licencias distintas.
Esto no es un artículo para criticar el «falso código abierto». El anuncio oficial, la model card de Hugging Face y el texto de la licencia lo dejan bastante claro: lo que MiniMax ha abierto son los pesos y los materiales de inferencia centrados en el modelo generativo principal, no todo el sistema en la nube. Lo que haremos aquí es ordenar, punto por punto, qué se ha abierto, qué no y cómo se puede usar.
Lo que te llevas: al terminar sabrás en qué estado de apertura está cada uno de los tres módulos de MiniMax H3, qué componentes de H3-Image se pueden ejecutar en local, y cuáles son las diferencias concretas entre las dos Community License en cuanto a umbral de ingresos y servicios alojados.
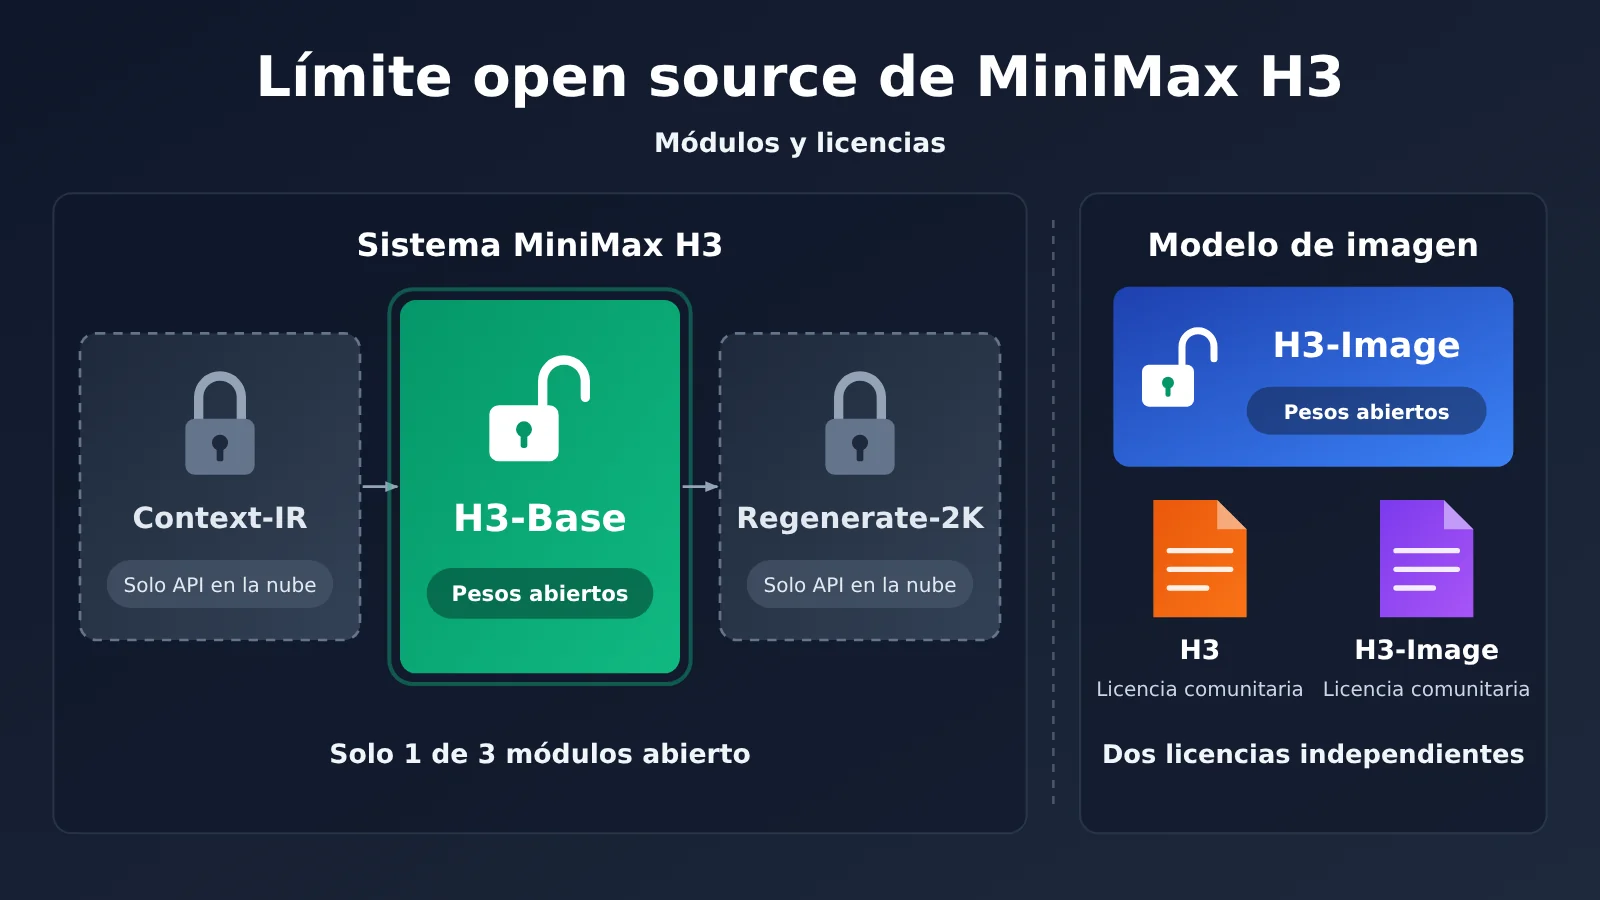
MiniMax H3: resumen de la información clave sobre su apertura
Primero, la línea temporal y los datos básicos en una sola tabla. Todas las afirmaciones de este artículo se basan en los anuncios oficiales, las fichas del modelo y el texto original de la licencia, con verificación hasta el 11 de noviembre de 2026.
| Dato | MiniMax H3 (vídeo) | MiniMax H3-Image (imagen) |
|---|---|---|
| Fecha de apertura | 3 de agosto de 2026 | 10 de noviembre de 2026 |
| Posicionamiento | Generación de vídeo omnimodal, con salida de vídeo y audio estéreo nativo | Generación y edición de imágenes en alta resolución derivada de H3 |
| Tamaño principal | 33B parámetros | DiT de 33.1B parámetros |
| Contenido abierto | Pesos de H3-Base y materiales de inferencia (dos checkpoints: FL2VA y Ref2VA) | DiT, Image VAE, Tokenizer/Processor, modelo PE, etc. |
| Sigue dependiendo de la nube | Context-IR, Regenerate-2K | H3-Image-Context-IR |
| Licencia | H3 Community License | H3-Image Community License |
Antes de leer: 6 términos clave sobre MiniMax H3
- Pesos abiertos: se permite obtener los parámetros del modelo ya entrenado, pero el alcance de uso lo determina la licencia. No significa que los datos de entrenamiento ni el proceso completo sean públicos.
- Community License: acuerdo de licencia de uso que define el propio proveedor del modelo. No es una licencia genérica como MIT o Apache 2.0.
- Checkpoint: archivo de parámetros que sirve para cargar el modelo. Un mismo modelo puede ofrecer varios checkpoints para distintas tareas.
- Context-IR: servicio oficial que se encarga de entender entradas multimodales, interpretar instrucciones y organizar el contexto. Por ahora se ofrece en forma de API.
- Servicio alojado (hosting): ofrecer las capacidades del modelo a terceros a través de la red, por ejemplo abriendo una API al público. Es el escenario en el que más se centran las restricciones de la licencia.
- Atención dispersa (sparse attention): técnica que calcula solo una parte de las relaciones de atención para reducir el coste de cómputo en secuencias largas.
Modelo de video MiniMax H3: solo 1 de 3 módulos está abierto
El anuncio oficial divide el sistema completo de MiniMax H3 en tres módulos. Entender esta división es clave para entender por qué es «open source, pero no del todo».
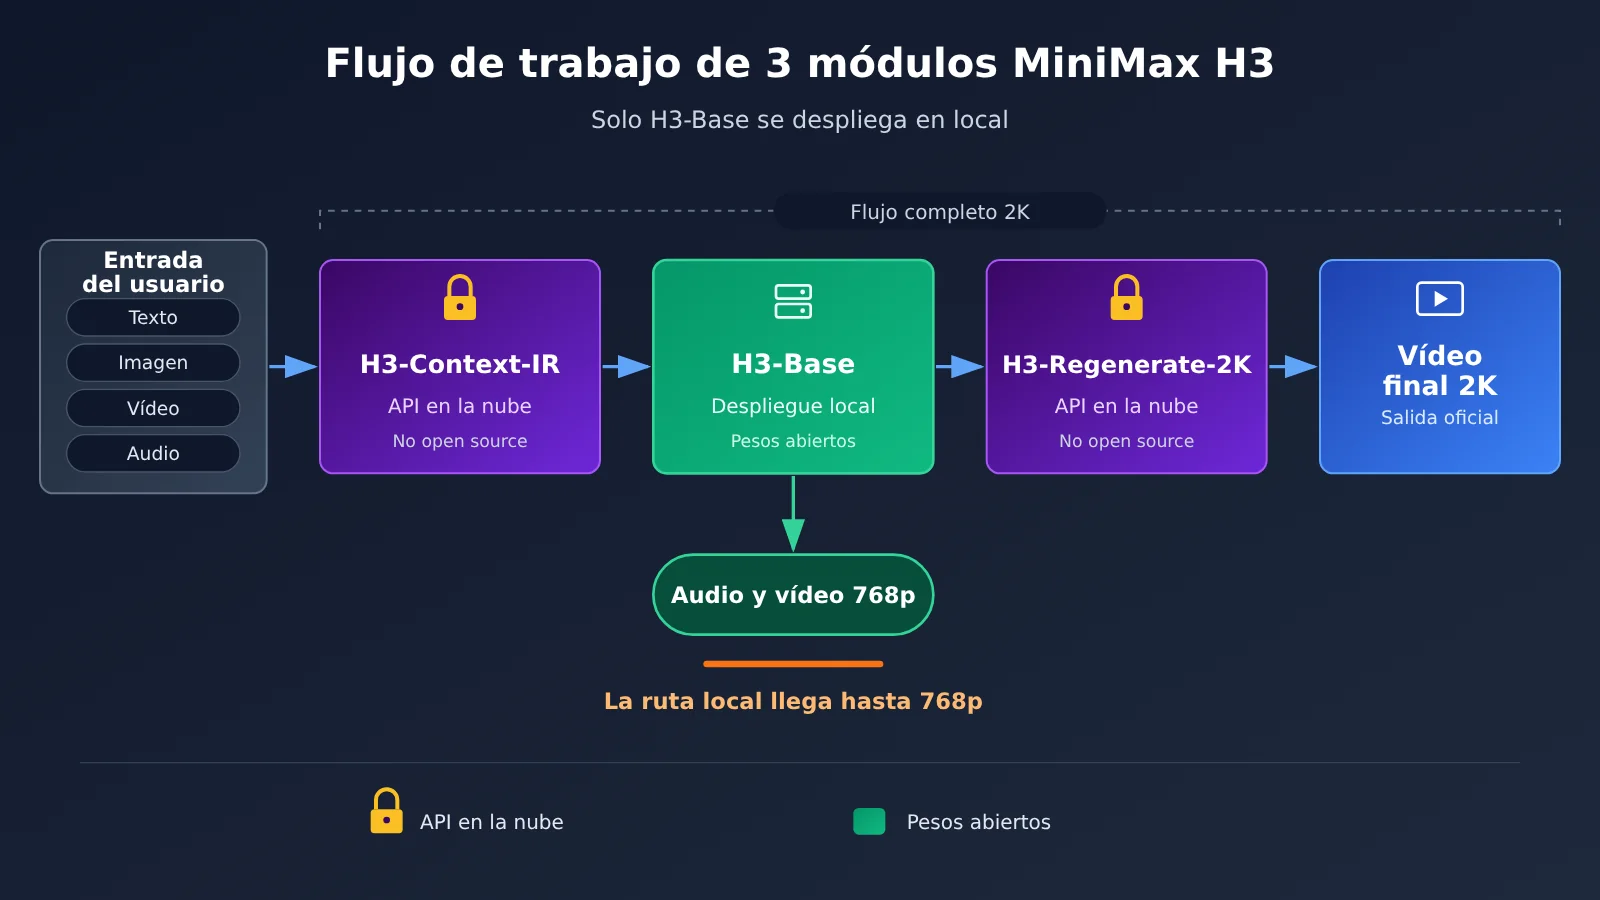
| Módulo | Función | Estado de apertura | Uso local |
|---|---|---|---|
| H3-Context-IR | Comprensión de entradas multimodales, interpretación de instrucciones y estructuración del contexto | No es open source; se ofrece mediante API oficial | No |
| H3-Base | Modelo central de generación de video y audio | Pesos abiertos y materiales de inferencia | Sí |
| H3-Regenerate-2K | Regenera a 2K los resultados de baja resolución a partir del contexto original | No es open source; se ofrece mediante API oficial | No |
Los dos checkpoints de MiniMax H3-Base
H3-Base no es un único archivo de pesos: incluye dos checkpoints especializados por tarea. FL2VA cubre texto a video, primer fotograma a video, último fotograma a video y primer y último fotograma a video. Ref2VA permite usar a la vez imágenes, videos y audio como referencia para tareas de generación y edición más complejas; por ejemplo, conservar la apariencia de los personajes y la escena del video original y cambiar solo los movimientos, la sincronización labial y los diálogos.
Ambos checkpoints incluyen componentes como processor, tokenizer, text encoder, transformer, visual VAE y audio VAE. Es decir, lo que se ha abierto es un repositorio del modelo con el que realmente se puede ejecutar la inferencia, y no unos pesos «en crudo» a los que tú tengas que añadir las piezas que faltan. En este sentido, es una publicación más completa que muchas que solo liberan los pesos.
Diferencias entre el flujo local en 768p y el flujo completo en 2K
Según las especificaciones oficiales, H3 genera por defecto con un lado corto de 768 px, videos de entre 4 y 15 segundos, a 24 FPS, y audio estéreo a 32 kHz. Si solo despliegas el H3-Base de código abierto, puedes generar audio y video en 768p en local; para reproducir la salida oficial en 2K, tendrás que llamar además a las API de Context-IR y Regenerate-2K.
Por eso lo más preciso es decir que H3-Base puede funcionar de forma independiente, pero el sistema H3 completo no puede prescindir del todo de los servicios de MiniMax. En una solución local, el paso de comprensión de entradas y organización de instrucciones lo tienes que diseñar tú: no puedes dar por hecho que exista una versión local de Context-IR.
Un detalle que se pasa por alto: Sparse Attention
En la primera publicación open source, la compañía aclaró que el propio modelo H3 admite de forma nativa el entrenamiento y la inferencia con atención dispersa, con el fin de reducir el costo computacional de las secuencias multimodales largas. Sin embargo, el código de inferencia publicado inicialmente solo incluye Full Attention; la implementación de Sparse Attention se publicará por separado en una actualización posterior.
Esto significa que abrir los pesos no equivale a abrir también todas las optimizaciones internas de inferencia. Si haces inferencia de videos largos con el código público actual, el costo computacional puede ser mayor que el rendimiento real de la nube oficial, y es una variable que conviene tener en cuenta al evaluar el rendimiento.
¿Qué componentes ha abierto MiniMax H3-Image?
H3-Image se abre de forma parecida a H3: el modelo principal se puede descargar, pero el procesamiento de contexto sigue dependiendo de la nube. La siguiente tabla está basada en el repositorio del modelo en Hugging Face.
| Componente | ¿Abierto? | Descripción |
|---|---|---|
| Modelo de generación de imágenes DiT de 33.1B | Sí | Diffusion Transformer de flujo único, unos 68.65 GB |
| Image VAE | Sí | Codificación y decodificación de la representación latente de la imagen |
| Tokenizer / Processor | Sí | Preprocesamiento de la entrada |
| Cabezal de salida PDD y configuración de muestreo | Sí | Permite el muestreo en 6 pasos sin necesidad de CFG |
| Codificador de texto Qwen3-VL | Sí, reutiliza los pesos del repositorio de H3 | Usa el estado oculto de la capa 50, unos 66.7 GB |
| Modelo de mejora de indicaciones H3-Image-PE | Sí, descarga independiente | Unos 17.9 GB, se puede ejecutar en local |
| H3-Image-Context-IR | No | Se ofrece mediante la API oficial |
Por qué el codificador de texto se descarga del repositorio de H3
H3-Image reutiliza el codificador de texto Qwen3-VL de H3. Sus pesos están en el repositorio de H3 y no se duplican en el de H3-Image. Por eso, para desplegar H3-Image hay que descargar el contenido de ambos repositorios: entre el modelo principal y el codificador de texto suman unos 135.35 GB de almacenamiento, y eso es solo el tamaño de los archivos, no equivale a los requisitos de memoria de vídeo.
Los frameworks de despliegue recomendados oficialmente son SGLang, vLLM-Omni, Diffusers y ComfyUI. Entre el hardware compatible figuran NVIDIA H200, RTX PRO 6000 Blackwell y AMD Instinct MI350X, y también hay soluciones de paralelismo multi-GPU. Para la mayoría de desarrolladores individuales, este listón de hardware no es precisamente bajo.
Context-IR y PE no son lo mismo
H3-Image-Context-IR es el servicio oficial en la nube: convierte instrucciones breves en descripciones de generación completas y determina el tamaño de imagen adecuado. H3-Image-PE, en cambio, es un modelo de mejora de indicaciones que se puede descargar por separado y ejecutar en local; es la alternativa local que ofrece el equipo oficial.
Que PE esté abierto no significa que también lo esté el flujo de trabajo alojado y de varias etapas de Context-IR. Si solo descargas el modelo de imágenes y PE, obtendrás un flujo local utilizable, pero no una reproducción completa del resultado de la nube oficial.
Las afirmaciones del fabricante y las pruebas de los frameworks hay que verlas por separado
«Generar imágenes 4K en menos de 10 segundos» y «hasta 16 imágenes de referencia» provienen de la ficha del modelo y del anuncio oficial, así que son afirmaciones del fabricante. En cambio, en la receta de despliegue de vLLM el límite de imágenes de referencia es de 9 como máximo; los criterios de ambas fuentes son distintos. Cuántas imágenes de referencia puedes usar realmente depende del framework de inferencia y de la configuración que adoptes, así que a la hora de evaluar conviene fiarse de tus propias pruebas.
¿Qué restringen realmente las dos licencias de MiniMax H3?
Esta es la parte que más se presta a malentendidos en los dos lanzamientos. H3 y H3-Image usan dos Community License distintas, con condiciones de autorización comercial claramente diferentes, así que no se puede aplicar la misma conclusión a ambas.
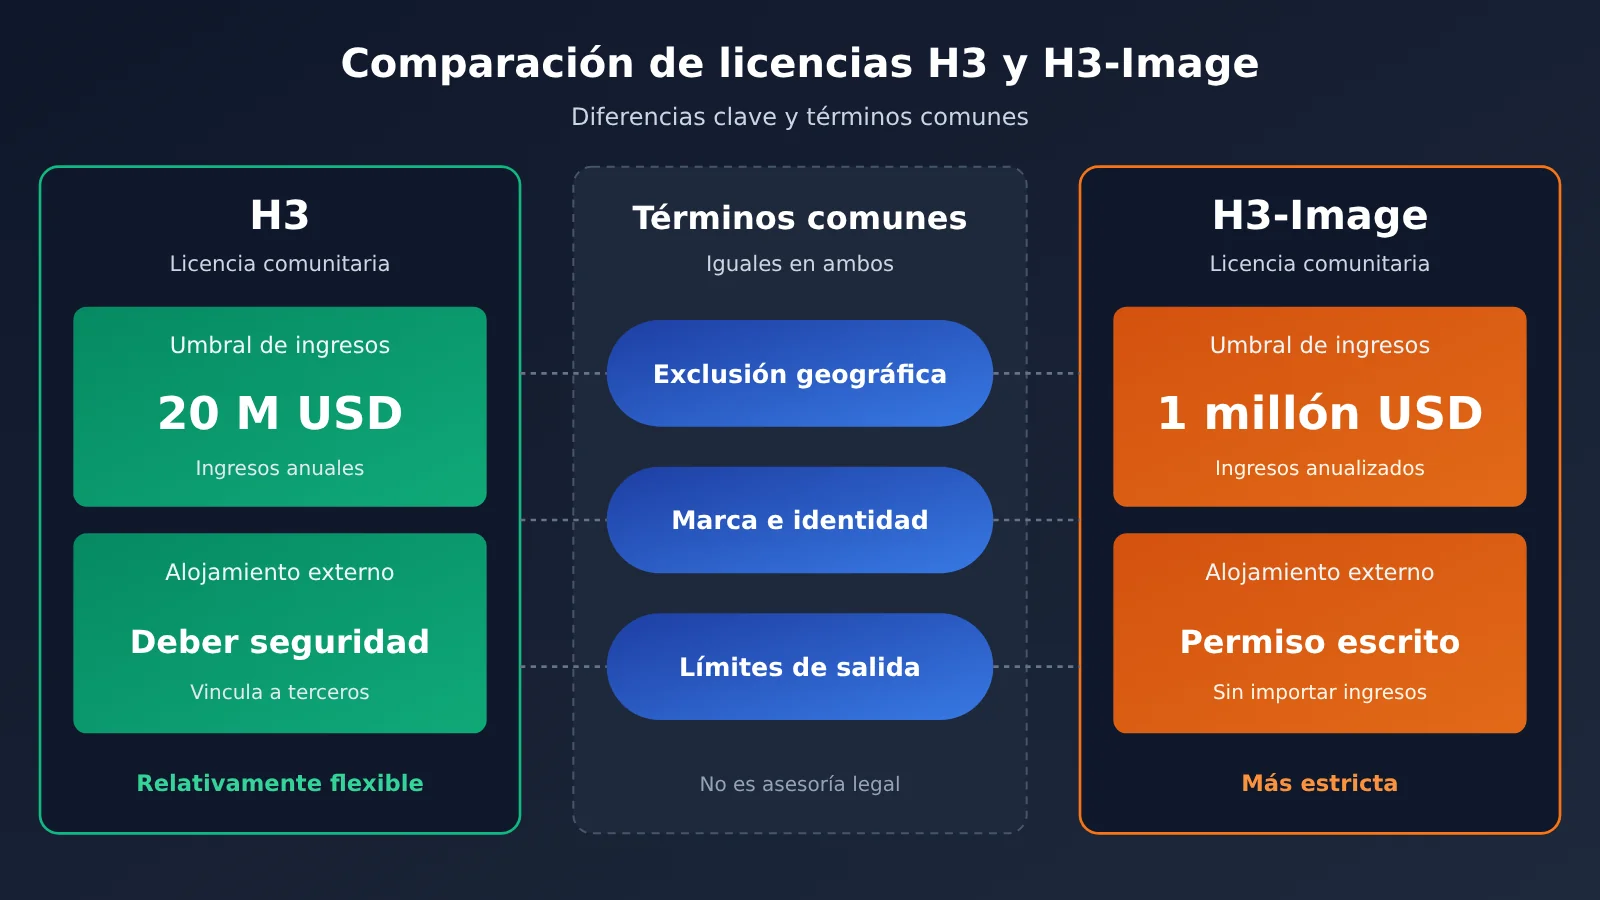
| Condición | H3 Community License | H3-Image Community License |
|---|---|---|
| Ámbito geográfico | Excluye Estados Unidos, la Unión Europea, el Reino Unido y Corea del Sur | Igual |
| Umbral de ingresos para la autorización | Si los ingresos anuales de productos y servicios comerciales superan los 20 millones de USD, se requiere autorización previa por escrito | Si tus ingresos anualizados y/o los de tus afiliadas superan 1 millón de USD, se requiere autorización previa por escrito |
| Servicios alojados por terceros | Hay que establecer medidas de seguridad razonables y obligar a los usuarios finales a cumplir las restricciones de uso | Para ofrecer servicios alojados a cualquier tercero, se requiere autorización previa por escrito |
| Identificación en productos comerciales | Mostrar MiniMax H3 de forma destacada en la interfaz | Mostrar MiniMax-H3-Image de forma destacada en la interfaz |
| Uso de las salidas para mejorar otros modelos de IA | No permitido | No permitido |
📌 Nota: lo anterior es un resumen de las cláusulas de las licencias y no constituye asesoría legal. Para los detalles de las restricciones geográficas y otras obligaciones, consulta el texto original de ambos archivos LICENSE. Si solo quieres evaluar primero el rendimiento de modelos generativos y conversacionales, puedes usar la interfaz unificada de APIYI (apiyi.com) para invocar los modelos más populares y comparar opciones, y después decidir si vale la pena invertir en un despliegue local y en solicitar la autorización.
Los límites de H3: se permite el uso comercial, pero con obligaciones
H3 ofrece una licencia limitada y libre de regalías dentro de las regiones permitidas, y admite el uso comercial. Los verdaderos umbrales son dos: si los ingresos anuales superan los 20 millones de USD, hace falta autorización por escrito; y si ofreces el modelo como servicio a terceros, debes establecer salvaguardas de seguridad y trasladar las restricciones de uso a los usuarios finales.
Los límites de H3-Image: el servicio alojado es la barrera dura
Las condiciones de H3-Image son bastante más estrictas. El umbral de ingresos anualizados baja a 1 millón de USD y, en cuanto ofreces un servicio alojado a cualquier tercero, sin importar tus ingresos, necesitas obtener antes una autorización por escrito. La licencia también incluye un canal para contactar con MiniMax y solicitar una licencia aparte.
Para plataformas de API, plataformas de alojamiento de modelos y desarrolladores de SaaS, esto significa que «se pueden descargar los pesos» no implica «se puede desplegar el modelo y abrir una API al público». Esta frontera es mucho más flexible en H3 que en H3-Image.
Impacto de la apertura de MiniMax H3 para los desarrolladores
Si miramos juntos el grado de apertura de los módulos y la licencia, la libertad real que tiene un desarrollador cambia mucho según el escenario.
| Escenario de uso | Qué se puede hacer | Límites principales |
|---|---|---|
| Investigación personal y experimentos locales | Descargar los pesos, hacer inferencia en local, estudiar la arquitectura y desarrollar sobre ella | Cláusula de exclusión geográfica; las salidas no pueden usarse para mejorar otros modelos; requisitos de hardware elevados |
| Uso comercial interno en empresas | Desplegar en local y usar el contenido generado en el negocio propio | H3 tiene un umbral de 20 millones de dólares; H3-Image, de 1 millón de dólares |
| Productos comerciales de cara al usuario | Integrarlo en aplicaciones propias | Hay que mostrar de forma destacada el nombre del modelo correspondiente en la interfaz |
| Ofrecer alojamiento de API a terceros | H3 puede ofrecerse tras cumplir las obligaciones de seguridad | H3-Image requiere autorización previa por escrito |
| Reproducir el resultado oficial completo | Vídeo local a 768p, generación de imágenes local con PE | El vídeo en 2K y Context-IR siguen necesitando la API oficial |
La libertad real que aporta la apertura
La libertad que dan los pesos abiertos es auténtica. Los desarrolladores pueden desplegar sin conexión, mantener los datos dentro de la red interna, estudiar la estructura de un modelo omnimodal de 33B y también sustituir o adaptar las etapas de preprocesamiento y posprocesamiento en sus flujos locales. Ambos modelos incluyen los componentes de inferencia completos, lo que reduce la barrera para que la comunidad los reproduzca.
Las tres capas de límites que siguen ahí
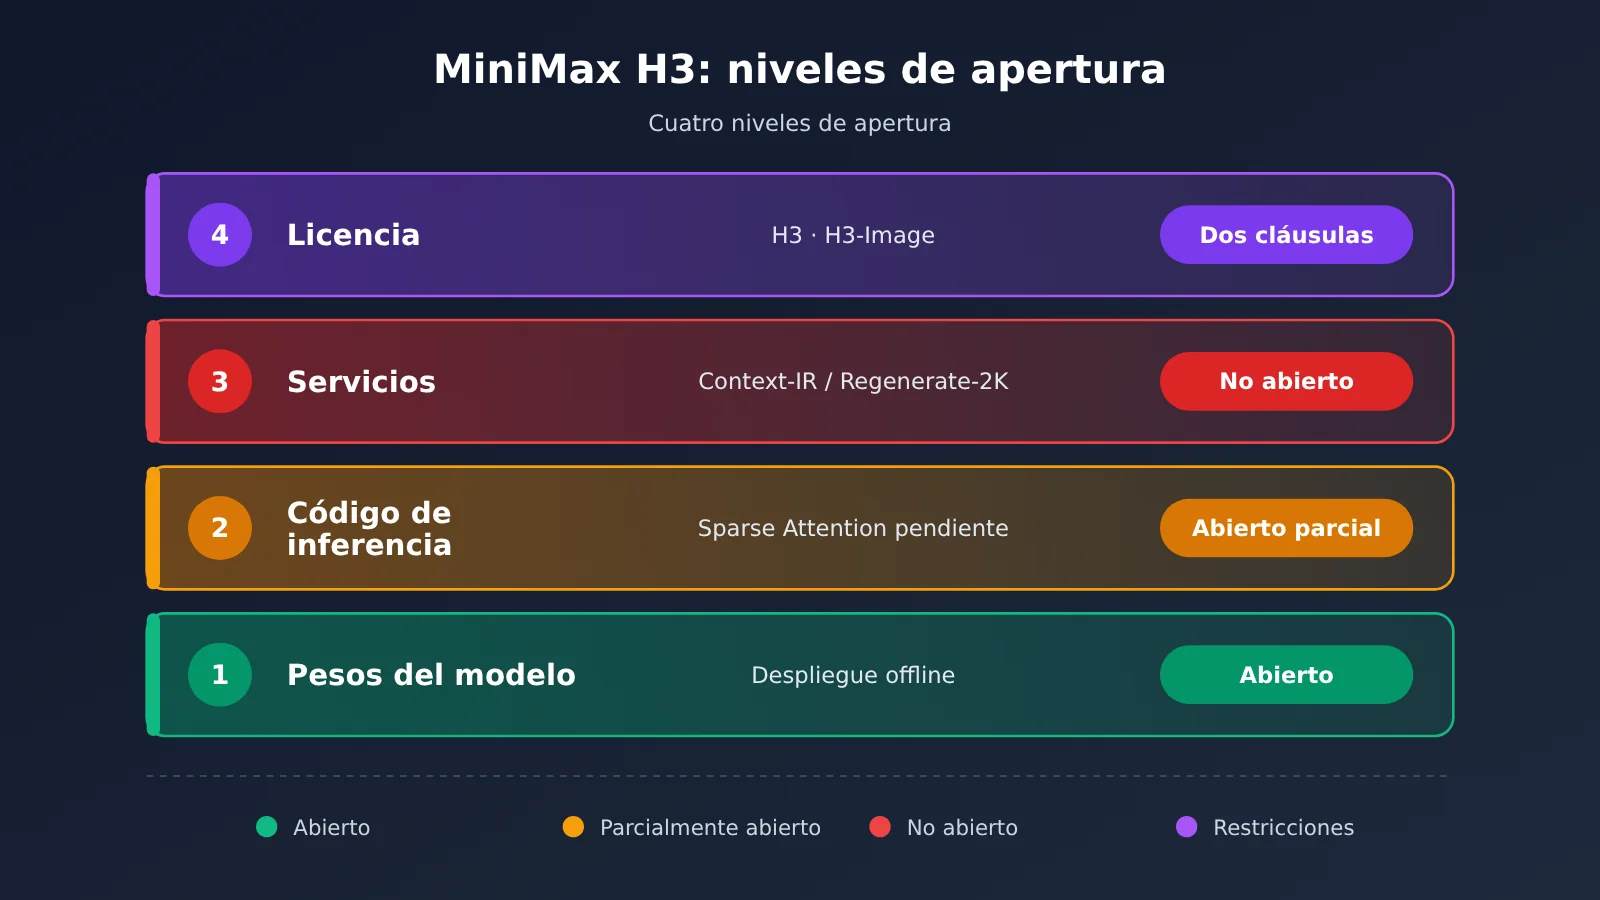
La primera capa es la del sistema: Context-IR y Regenerate-2K quedan fuera de lo que se ha abierto. La segunda es la de implementación: el código de Sparse Attention de H3 no estaba incluido en la primera publicación. La tercera es la de licencia: las cláusulas sobre región, ingresos, servicios de alojamiento y marca determinan en conjunto si se puede usar comercialmente.
Por eso los pesos abiertos y la API en la nube conviven. La compra de GPU, la optimización de la inferencia, la planificación con alta concurrencia, la mejora de indicaciones y la revisión de cumplimiento son costes que no desaparecen porque los pesos sean abiertos. Para muchos equipos, lo más prudente es validar primero la necesidad de negocio con una plataforma agregadora como APIYI (apiyi.com) y, después, evaluar si compensa montar su propia infraestructura.
Ejemplo del paso previo en el flujo local de MiniMax H3
Como Context-IR no está disponible públicamente, si ejecutas H3-Base en local tendrás que resolver tú mismo el paso de preparación de la entrada. Una práctica habitual es usar un Modelo de Lenguaje Grande de propósito general para expandir una idea breve en una descripción estructurada y pasársela después al modelo local. Ojo: esto es solo una alternativa a nivel de ingeniería, y el resultado no equivale al Context-IR oficial.
Ejemplo mínimo
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[
        {"role": "system", "content": "把简短视频创意扩写为详细镜头描述,包含主体、动作、镜头、光线和声音。"},
        {"role": "user", "content": "雨夜街头,一只猫跳上霓虹灯招牌"}
    ]
)
print(resp.choices[0].message.content)
Ver el código de la implementación completa
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM_PROMPT = """你是视频生成提示词工程师。
请把用户的简短创意扩写为 JSON,字段包括:
- prompt: 详细的画面与动作描述
- camera: 镜头运动
- audio: 环境声与音乐描述
- duration: 视频时长(秒,取值 4 到 15)
只输出 JSON。"""

def build_context(idea: str, model: str = "gpt-4o-mini") -> dict:
    """Usa un Modelo de Lenguaje Grande de propósito general para preparar la entrada, como paso previo al H3-Base local"""
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": idea},
        ],
        response_format={"type": "json_object"},
    )
    ctx = json.loads(resp.choices[0].message.content)
    # Limita la duración a 4-15 segundos según la especificación oficial de H3
    ctx["duration"] = max(4, min(15, int(ctx.get("duration", 5))))
    return ctx

if __name__ == "__main__":
    ctx = build_context("雨夜街头,一只猫跳上霓虹灯招牌")
    print(json.dumps(ctx, ensure_ascii=False, indent=2))
    # Siguiente paso: pasa ctx a tu flujo de inferencia local de H3-Base
    # (consulta el ejemplo de inferencia FL2VA en el repositorio oficial de GitHub)
🚀 Empieza rápido: si tu GPU local no tiene suficiente VRAM, puedes conseguir crédito de prueba gratuito en APIYI (apiyi.com) y completar primero este paso de preparación de la indicación. La plataforma ofrece una interfaz compatible con OpenAI, así que con una sola clave API puedes cambiar entre distintos modelos y comparar cuál funciona mejor para la expansión previa.
Preguntas frecuentes (FAQ) sobre MiniMax H3 de código abierto
P1: ¿MiniMax H3 es realmente de código abierto?
Lo más preciso es decir que es un modelo de pesos abiertos. Los pesos y los materiales de inferencia de H3-Base están disponibles, pero Context-IR y Regenerate-2K no se han abierto, y la licencia es una Community License restrictiva, no MIT ni Apache 2.0.
P2: ¿MiniMax H3 y H3-Image tienen la misma licencia?
No. Ambas comparten las mismas exclusiones geográficas, pero el umbral de ingresos de H3 es de más de 20 millones de dólares anuales, mientras que el de H3-Image es de más de 1 millón de dólares de ingresos anualizados. Además, H3-Image exige autorización previa por escrito para ofrecer servicios alojados a cualquier tercero, mientras que H3 exige cumplir con obligaciones de salvaguardas de seguridad y restricciones para los usuarios posteriores.
P3: ¿Puedo obtener vídeo en 2K desplegando solo H3-Base?
No. H3-Base en local produce por defecto un lado corto de 768 px, y la salida en 2K depende de las API oficiales Context-IR y Regenerate-2K.
P4: ¿H3-Image-PE puede reemplazar a Context-IR?
PE es la solución oficial local para mejorar indicaciones. Se puede descargar y ejecutar de forma independiente, pero no equivale al flujo de trabajo alojado multietapa completo de Context-IR. Si quieres acercarte al resultado oficial, tendrás que hacer tus propias pruebas y ajustes.
P5: El despliegue local exige demasiado. ¿Hay alguna alternativa?
Solo el modelo principal de H3-Image más el codificador de texto ocupan unos 135,35 GB de almacenamiento, y el hardware que cuenta con adaptación oficial son sobre todo GPU de clase centro de datos como H200 o MI350X. Si por ahora solo estás validando una propuesta, puedes empezar invocando los modelos principales ya disponibles en APIYI (apiyi.com), con una interfaz unificada para comparar resultados rápidamente, y luego decidir si compensa montar tu propia infraestructura.
P6: ¿Puedo usar las salidas de H3 para entrenar mi propio modelo?
Ninguna de las dos licencias permite usar el modelo ni sus salidas para mejorar otros modelos de IA. Antes de hacer síntesis de datos o destilación, revisa siempre el texto original de la licencia.
Puntos clave de la apertura de MiniMax H3 (Key Takeaways)
- De tres módulos, solo se abre uno: H3-Base es abierto, mientras que Context-IR y Regenerate-2K siguen siendo API oficiales.
- Checkpoint completo: FL2VA y Ref2VA incluyen tokenizer, VAE y otros componentes de inferencia.
- En local, el límite es 768p: el flujo de trabajo completo de vídeo en 2K depende del servicio oficial en la nube.
- La atención dispersa aún no se ha publicado: el código de inferencia liberado por primera vez solo incluye Full Attention.
- Las dos licencias son distintas: el umbral de H3 es de 20 millones de dólares y el de H3-Image es de 1 millón.
- Los servicios alojados son la línea roja: H3-Image exige autorización previa por escrito para ofrecer alojamiento a terceros.
- Primero valida, luego despliega por tu cuenta: puedes usar la interfaz unificada de APIYI (apiyi.com) para validar tus necesidades de negocio a bajo coste.
Resumen
Lo esencial de la apertura de MiniMax H3:
- Lo que se abre es el modelo de generación central: H3-Base y el modelo principal de H3-Image se pueden descargar y desplegar, con todos los componentes de inferencia incluidos.
- El servicio en la nube sigue siendo parte del sistema: Context-IR y Regenerate-2K determinan el techo del resultado completo.
- La licencia marca el límite comercial: las dos Community License tienen condiciones distintas, y H3-Image es claramente más estricta con los servicios alojados.
Para saber hasta qué punto un modelo es realmente abierto, no basta con mirar si se pueden descargar los pesos: hay que revisar cuatro dimensiones, que son los componentes, el código de inferencia, los servicios complementarios y la licencia. MiniMax ha hecho una apertura sincera esta vez, pero antes de desplegar o comercializar, conviene revisar estos cuatro límites uno por uno.
Si estás evaluando soluciones de generación, te recomiendo empezar por APIYI (apiyi.com) y usar el crédito gratuito para validar rápidamente tu flujo de negocio. Después podrás decidir si merece la pena invertir en un despliegue local y solicitar las autorizaciones necesarias.
📚 Referencias
- Anuncio oficial de código abierto de MiniMax H3: división en tres módulos y explicación de Sparse Attention
- Enlace:
minimax.io/news/minimax-h3-open-source -
Descripción: fuente de primera mano para conocer la estructura del sistema H3 y el alcance de lo que se abre
-
Hugging Face – Repositorio del modelo MiniMax-H3: checkpoints de FL2VA y Ref2VA, y componentes
- Enlace:
huggingface.co/MiniMaxAI/MiniMax-H3 -
Descripción: incluye los pesos compartidos del codificador de texto Qwen3-VL
-
Texto original de la MiniMax H3 Community License
- Enlace:
huggingface.co/MiniMaxAI/MiniMax-H3/blob/main/LICENSE -
Descripción: el umbral de ingresos, el alcance geográfico y las obligaciones posteriores se rigen por este documento
-
Hugging Face – Repositorio del modelo MiniMax-H3-Image: lista de componentes e instrucciones de despliegue
- Enlace:
huggingface.co/MiniMaxAI/MiniMax-H3-Image -
Descripción: ficha oficial del modelo, con declaraciones del fabricante como el límite de imágenes de referencia
-
Texto original de la MiniMax H3-Image Community License
- Enlace:
huggingface.co/MiniMaxAI/MiniMax-H3-Image/blob/main/LICENSE -
Descripción: licencia para servicios alojados y cláusula del umbral de 1 millón de dólares
-
Receta de despliegue con vLLM – MiniMax-H3-Image
- Enlace:
recipes.vllm.ai/MiniMaxAI/MiniMax-H3-Image -
Descripción: configuración de pruebas del lado del framework; el criterio del límite de imágenes de referencia difiere del de la ficha del modelo
-
GitHub – Código fuente y materiales de despliegue de MiniMax-H3
- Enlace:
github.com/MiniMax-AI/MiniMax-H3 - Descripción: ejemplos de inferencia local y scripts de despliegue
Autor: Equipo técnico de APIYI
Intercambio técnico: te invitamos a contactarnos desde la página principal de APIYI. Para más información de integración, visita el centro de documentación docs.apiyi.com