Nota del autor: comparamos Qwen4-Max y Kimi K3.1 Pro en cinco dimensiones: apertura de pesos, tareas de terminal, entrega de tareas largas, visión y video, y coste por millón de tokens; además explicamos por qué no coinciden las puntuaciones oficiales de Terminal-Bench de ambas compañías.
Conclusión primero: si necesitas obtener los pesos para fine-tuning, cuantización o despliegue privado, elige Kimi K3.1 Pro; si necesitas una API alojada y además valoras visión, video y entrega de tareas largas, y quieres reducir al mínimo el coste por millón de tokens, elige Qwen4-Max. Si tu carga principal son agentes de línea de comandos en la terminal, Kimi K3.1 Pro tiene hoy una ventaja clara.
Este no es un análisis de compromiso del tipo «cada uno tiene lo suyo». Todas las cifras que aparecen a continuación indican su fuente: las de Qwen provienen del blog oficial de Alibaba y de la comparación en la misma imagen autodeclarada oficialmente; las de Kimi, de la documentación oficial de Moonshot; los datos de terceros, de una instantánea pública de la tabla de arena (2026-11-14). Por qué no cuadran las mismas métricas de referencia autodeclaradas por ambas compañías es algo que desglosamos por separado en este artículo.
Valor central: al terminar de leer, tendrás una línea divisoria clara para elegir, y sabrás cómo trasladar las dos ventajas, «más barato» y «poder obtener los pesos», a tus propias tareas.
Diferencias clave entre Qwen4-Max y Kimi K3.1 Pro
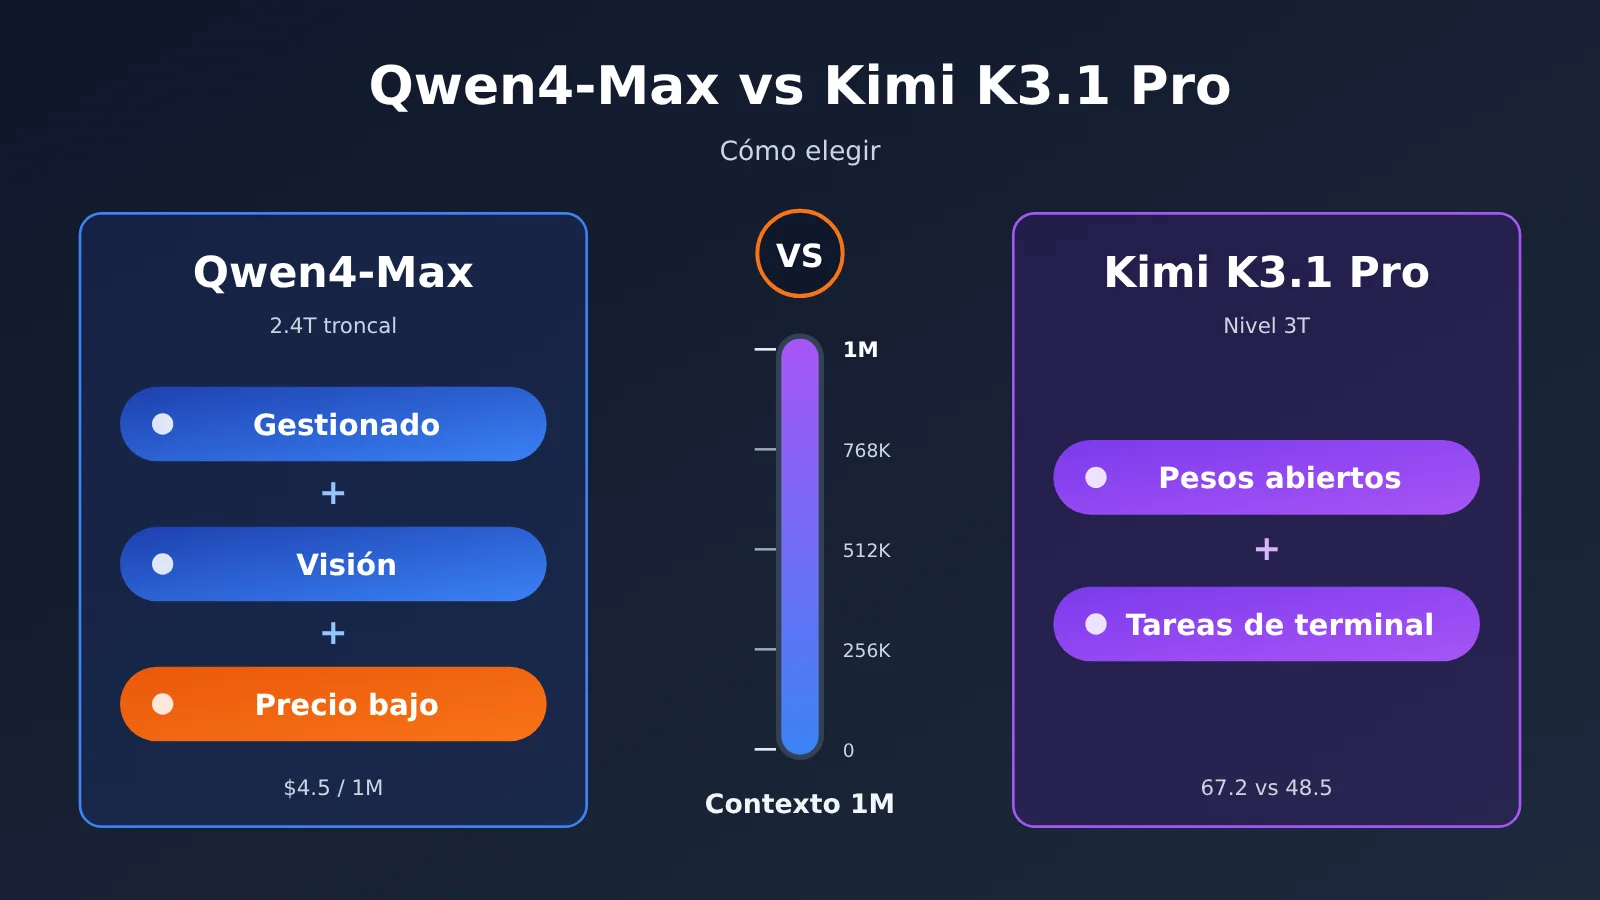
Ambos modelos son buques insignia chinos de la segunda mitad de 2026, con contextos de nivel 1M y parámetros sobre el papel parecidos, pero con posicionamientos muy distintos. Qwen4-Max utiliza un backbone de 2.4T, 71B de parámetros activos y 328B adicionales de N-gram Embedding, con soporte nativo de visión, salida máxima de 393K y cadena de pensamiento máxima de 262K; el valor predeterminado de reasoning_effort es high. Kimi K3.1 Pro es el primer modelo de la serie K3.1, pertenece al nivel 3T y la compañía lo presenta como el modelo de pesos abiertos de nivel 3T más capaz, con un contexto de 1,048,576 token.
| Dimensión | Qwen4-Max | Kimi K3.1 Pro | Ventaja |
|---|---|---|---|
| Escala | Backbone de 2.4T / 71B activos + 328B N-gram Embedding | Nivel 3T | — |
| Pesos | La documentación pública solo menciona la API alojada de QwenCloud | Pesos abiertos | Kimi |
| Contexto | 1M, salida máxima de 393K | 1,048,576 token | Empate |
| Tareas de terminal (gráfica de Alibaba) | 48.5 | 67.2 | Kimi |
| Tareas largas y entrega sectorial | Lidera en varios aspectos | AutomationBench algo superior | Qwen4 |
| Visión y video | Visión nativa; lidera en métricas de gráficos y video | Métricas por detrás | Qwen4 |
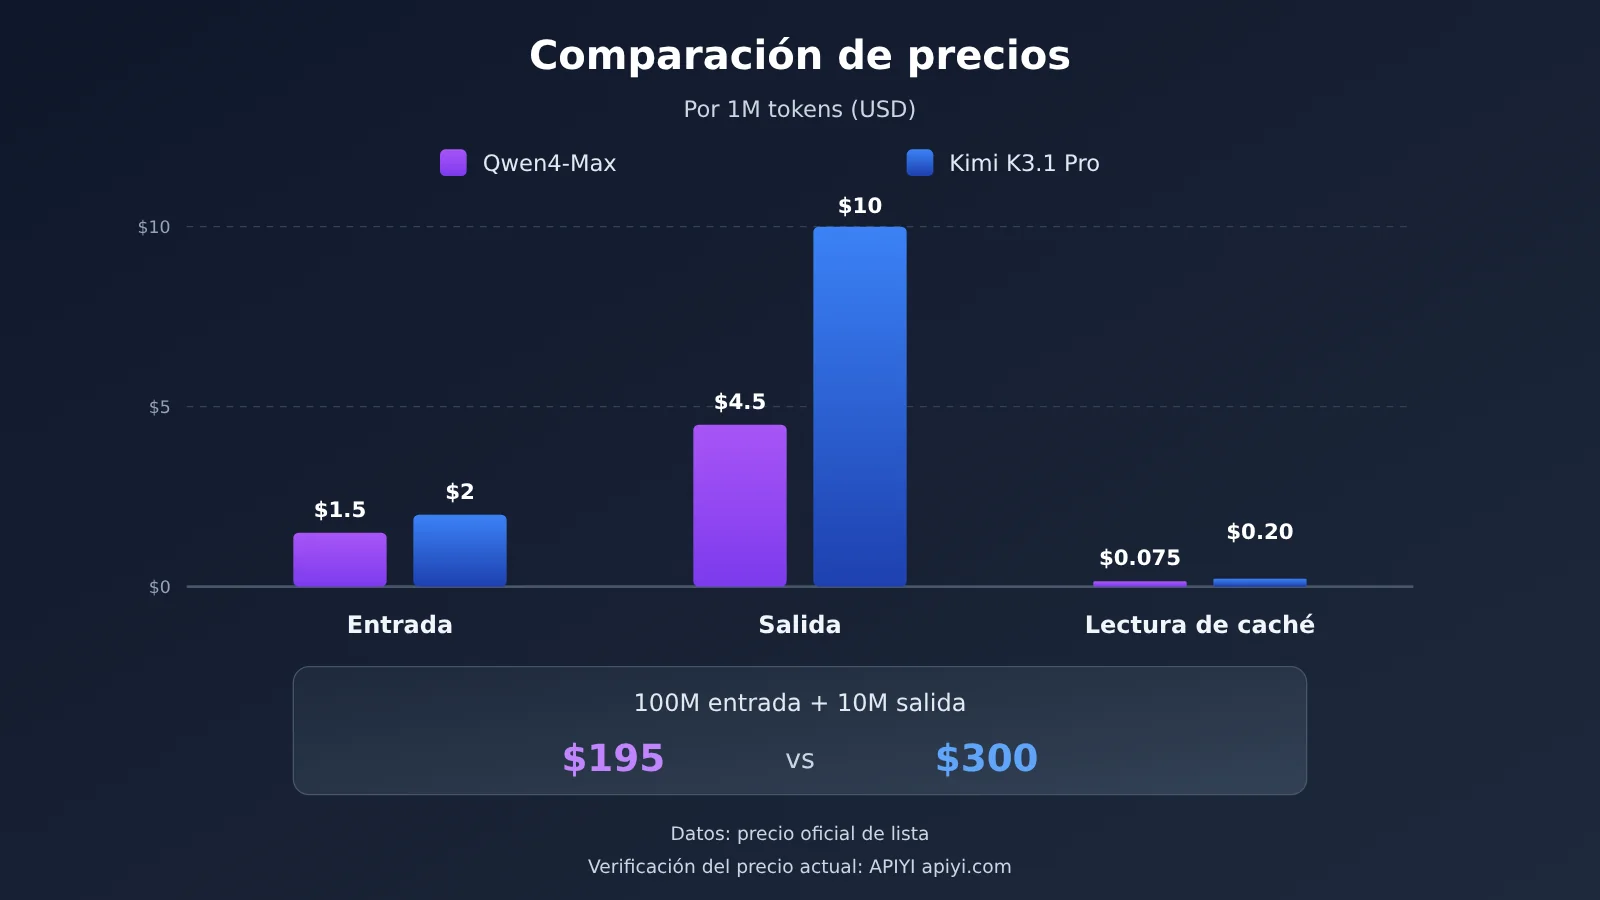
| Precio por 1M de salida | $4.5 | $10 | Qwen4 |
En resumen: la ventaja de Kimi está en “poder modificarse” y “poder ejecutar terminales”; la de Qwen4 está en “una amplia cobertura de entrega” y “ser económico”. A continuación lo desglosamos en cinco dimensiones.
¿Se pueden modificar los pesos de Kimi K3.1 Pro y Qwen4-Max?
Esta es la línea divisoria más dura entre ambos. Kimi K3.1 Pro es un modelo de pesos abiertos: un equipo puede llevarlo a su propio clúster y hacer ajuste fino de dominio, compresión por cuantización, destilación, o desplegarlo offline en entornos con requisitos de cumplimiento estrictos. Para quien necesita «cambiar el modelo en sí», no hay alternativa: por muchos benchmarks que saque otro modelo, no compensa esa carencia.
La documentación pública de Qwen4-Max solo menciona que se ofrece como API gestionada a través de QwenCloud; en las referencias consultadas no se habla de pesos abiertos. Lo bueno del alojamiento gestionado es que te olvidas de GPU, frameworks de inferencia y escalado; lo malo es que solo puedes adaptar el modelo al negocio mediante indicaciones, contexto y llamadas a herramientas. Cabe aclarar que tener pesos abiertos no equivale automáticamente a más seguridad: la seguridad sigue dependiendo de tu despliegue, tus controles de acceso y tus procesos de auditoría.
Cómo ponderarlo: si lo único que haces es «invocar el modelo», el valor de los pesos abiertos para ti es prácticamente cero; si necesitas ajuste fino o despliegue privado, Kimi es la única opción de esta comparación, y las siguientes dimensiones solo sirven para evaluar si te «alcanza».
Qwen4-Max frente a Kimi K3.1 Pro: ¿quién es más fuerte en tareas de terminal?
Las tareas de terminal se refieren a cuando un modelo lee y escribe archivos en un entorno de línea de comandos, ejecuta comandos y corrige iterativamente a partir de los errores; es el escenario de los agentes de código más cercano al trabajo real. En este apartado, Kimi K3.1 Pro es claramente más fuerte: en la comparación dentro de la misma gráfica reportada por Alibaba, Qwen4-Max obtiene 48.5 en Terminal-Bench 4.0, mientras que Kimi K3.1 alcanza 67.2, una diferencia de 18.7 puntos. Es el apartado donde Qwen4 queda más atrás en toda la gráfica.
Por qué Terminal-Bench no coincide entre ambas partes
Hay un detalle fácil de pasar por alto: el mismo Kimi K3.1 Pro no tiene la misma puntuación en Terminal-Bench 4.0 según el material oficial de cada parte.
| Fuente | Kimi K3.1 Pro | Otras referencias |
|---|---|---|
| Documentación oficial de Moonshot | 65.7% | Claude Opus 5.5 con 66.4%, GPT-6 Astra con 58.2% |
| Comparación en la misma gráfica reportada por Qwen | 67.2 | Qwen4-Max con 48.5 |
Moonshot indica 65.7% en su propia documentación, mientras que la gráfica de Alibaba asigna a Kimi 67.2; hay 1.5 puntos de diferencia. Esta diferencia proviene del harness de evaluación (framework de agentes, definición de herramientas, políticas de timeout y reintentos), de la configuración de reasoning effort y de la versión del conjunto de tareas. No debe interpretarse como manipulación por parte de ninguna de las partes, ni se deben citar ambos números como si fueran una única «puntuación de Kimi en tareas de terminal». Del mismo modo, Claude Opus 5.5 aparece con 66.4% en la documentación de Moonshot; bajo el marco de evaluación de Alibaba también daría otra cifra, y construir un ranking mezclando documentos de diferentes fuentes no es válido.
La forma correcta de leerlo es: comparar posiciones relativas solo dentro de la misma gráfica y del mismo harness. Según los criterios de Moonshot, Kimi queda ligeramente por debajo de Opus 5.5 y claramente por encima de GPT-6 Astra; según los criterios de Alibaba, Kimi está muy por delante de Qwen4-Max. Ambas conclusiones son válidas y apuntan en la misma dirección: la capacidad de Kimi K3.1 Pro en terminal está en el primer nivel.
🎯 Consejo técnico: las puntuaciones de benchmark varían según el harness y el esfuerzo; la forma más fiable es ejecutar una ronda con tu propio framework de agentes y tus tareas reales. Con APIYI apiyi.com puedes invocar modelos como
kimi-k3.1-prousando la misma clave API, manteniendo el framework sin cambios y cambiando solo el parámetromodel; así la comparación sí tiene sentido.
Otro dato relacionado son las demás métricas de tareas de código. En la misma gráfica de Alibaba, DeepSWE v1.1 está prácticamente empatado (75.7 frente a 75.5); en ProgramBench, Qwen4-Max supera por 6.5 puntos (31.5 frente a 25.0). La documentación oficial de Moonshot también reporta un 61.2% en Kimi Code Bench 3.0 Long-horizon, una mejora notable frente al 55.95% de la generación anterior K3. Por tanto, la forma precisa de decirlo es: Kimi destaca en la interacción por terminal, mientras que Qwen4 no se queda atrás en algunas tareas de código que no son de terminal.
Qwen4-Max y Kimi K3.1 Pro: tareas de larga duración y entrega en entornos profesionales
Si tu agente se encarga de «entregar un trabajo completo» —organizar informes, recorrer un proceso de negocio de principio a fin, resolver problemas de un dominio especializado— Qwen4-Max rinde mejor en la misma comparativa de Alibaba. La siguiente tabla recoge, del benchmark comparativo autodeclarado por Qwen, los indicadores relacionados con tareas de larga duración y escenarios de industria.
| Benchmark (misma comparativa oficial de Qwen) | Qwen4-Max | Kimi K3.1 | Diferencia |
|---|---|---|---|
| JobBench | 68.5 | 61.2 | Qwen4 +7.3 |
| APEX-Agents v1.1 | 72.1 | 65.5 | Qwen4 +6.6 |
| HLAB-Vals-1.1 | 21.3 | 11.7 | Qwen4 +9.6 |
| AA-Briefcase v1.1 Elo | 1686 | 1674 | Qwen4 +12 |
| AgentArena Net Improvement | 7.5 | 3.9 | Qwen4 +3.6 |
| AutomationBench-AA | 72.5 | 73.3 | Kimi +0.8 |
| BioMysteryBench | 85.0 | 80.6 | Qwen4 +4.4 |
| HealthBench Professional | 60.0 | 57.2 | Qwen4 +2.8 |
| Humanity’s Last Exam | 51.7 | 51.1 | Prácticamente empatados |
El patrón en estos datos está bastante claro: Qwen4-Max lidera en la mayoría de las tareas profesionales, en la entrega por parte de agentes y en dominios especializados como la biomedicina, con márgenes de entre 3 y 10 puntos; Kimi solo aventaja ligeramente en AutomationBench-AA, por 0.8 puntos, mientras que en HLE ambos modelos están prácticamente empatados. Conviene tener en cuenta que este es el marco de evaluación de Alibaba, así que las cifras de Kimi bajo su propio harness podrían ser distintas.
La salida máxima de 393K y la cadena de pensamiento máxima de 262K de Qwen4-Max también resultan muy prácticas para tareas largas. Significa que en una sola llamada se puede generar un informe extenso o un archivo de código completo, sin tener que dividir y volver a ensamblar constantemente, lo que reduce los puntos de error en la orquestación del agente.
Capacidades visuales y de video de Qwen4-Max vs. Kimi K3.1 Pro
Qwen4-Max admite entrada visual de forma nativa, algo que también se refleja en las comparativas de Alibaba: en el benchmark de comprensión de gráficos Chartography, Qwen4 obtiene 54,2 frente a 50,0 de Kimi, y en el benchmark de comprensión de video Video-Index, Qwen4 alcanza 68,1 frente a 63,2 de Kimi, con ventajas de 4,2 y 4,9 puntos respectivamente.
Para negocios que necesitan leer capturas de pantalla, analizar gráficos de informes, entender grabaciones de pantalla de productos o hacer análisis de contenido audiovisual, Qwen4-Max es la opción más cómoda. Aunque Kimi también tiene buenos resultados en estas dos áreas, si lo visual es la carga principal, la diferencia se amplificará al escalar.
En cuanto a la generación de frontend, podemos fijarnos en datos de terceros. En el snapshot público de la arena (2026-11-14), dentro del Code Arena WebDev, Qwen4-Max (xHigh) ocupa el puesto 6 con 1750 puntos, pero aún aparece marcado como Preliminary, con 1.814 votos; Kimi K3.1 Pro (Max) se sitúa en el puesto 13 con 1686 puntos y 5.215 votos, ya sin la marca preliminary. Qwen4 tiene una puntuación más alta, pero con menos muestras, por lo que su posición todavía podría fluctuar.
Cómo calcular el costo de Qwen4-Max frente a Kimi K3.1 Pro
Precio de lista oficial (por 1M tokens, fecha de consulta 2026-11-16)
| Concepto de facturación | Qwen4-Max (QwenCloud) | Kimi K3.1 Pro (Moonshot) | Kimi K3.1 Pro Highspeed |
|---|---|---|---|
| Entrada | $1.5 | $2 | $4 |
| Salida | $4.5 | $10 | $20 |
| Lectura de caché / acierto de caché | $0.075 | $0.20 | $0.20 |
| Escritura de caché de 5 minutos | $1.875 | $2 | — |
| Escritura de caché de 1 hora | $3 | $4 | — |
Convertido a precio de lista, el precio de entrada de Qwen4-Max es el 75% del de Kimi, el de salida el 45%, y la lectura de caché apenas el 37.5%. Estimando con una carga típica de agente de «100 millones de tokens de entrada + 10 millones de salida», Qwen4-Max sale por unos $195 y Kimi K3.1 Pro por unos $300. Kimi además ofrece el modo Batch, con precio al 60% del estándar, ideal para tareas por lotes offline; la versión Highspeed duplica el precio a cambio de aproximadamente 2 a 3 veces más velocidad.
Un token más barato no significa una tarea más barata
Este es el punto más contraintuitivo de la dimensión de costos. La instantánea de arena muestra que el costo por tarea de Qwen4-Max (xHigh) es de $4.18, mientras que el de Kimi K3.1 Pro (Max) es solo $0.89. Qwen4 es más barato por token, pero por tarea resulta varias veces más caro: la razón es que en niveles de effort alto el modelo genera una enorme cantidad de tokens de cadena de pensamiento, con un volumen de salida muy superior al de Kimi.
Por eso, al calcular el costo real hay que mirar «precio × consumo real de tokens». El reasoning_effort de Qwen4-Max es high por defecto; si la tarea no requiere razonamiento profundo, bajar el effort de forma proactiva es lo que convierte la ventaja de precio unitario en ventaja de costo total.
Precios actuales de APIYI (2026-11-16)
| ID del modelo | Entrada | Salida | Lectura de caché | Estado |
|---|---|---|---|---|
kimi-k3.1-pro |
$2 | $10 | $0.2 | Disponible |
kimi-k3.1-pro-highspeed |
$4 | $20 | $0.2 | Disponible |
qwen3.8-max |
$1.65 | $4.95 | $0.20625 | Disponible |
qwen4-max |
— | — | — | Aún no disponible, lo publicaremos lo antes posible |
Los precios anteriores son por 1M tokens. qwen4-max todavía no aparece en la lista de modelos de APIYI, pero publicaremos este modelo lo antes posible; mientras tanto, puedes montar toda la cadena de invocación con qwen3.8-max. Todos los nombres de modelo y precios están sujetos a la lista de modelos de la plataforma APIYI apiyi.com; antes de cambiar de modelo, conviene consultar el modelo, verificar el precio y luego confirmar el protocolo de invocación.
Cómo invocar Kimi K3.1 Pro y la serie Qwen a través de APIYI
APIYI ofrece una interfaz compatible con OpenAI. Para integrarla solo necesitas hacer tres cambios y no hace falta cambiar el SDK:
- Configura el
base_urldel cliente comohttps://api.apiyi.com/v1; la ruta de la solicitud es/chat/completions. - Introduce la clave API que obtuviste en la consola de APIYI.
- Establece el parámetro
modelcomokimi-k3.1-pro,kimi-k3.1-pro-highspeedoqwen3.8-max. Cuandoqwen4-maxesté disponible, basta con sustituir el modelo.
Al hacer comparaciones A/B, se recomienda fijar la indicación, la definición de herramientas y el nivel de effort, cambiar solo el campo model y registrar la entrada, la salida y el número de tokens en caché de cada invocación. Así podrás reproducir el fenómeno mencionado antes de que “el harness cambia la puntuación” y también calcular el costo real por tarea de ambos modelos en tu negocio.
🚀 Inicio rápido: los nuevos usuarios que se registren en APIYI apiyi.com obtienen una cuota de prueba gratuita. Pueden usar la misma clave para alternar entre Kimi y la serie Qwen, validar primero el rendimiento con un volumen pequeño de tráfico y luego decidir el modelo principal para el entorno de producción.
Escenarios recomendados para Qwen4-Max y Kimi K3.1 Pro
Escenarios en los que elegir Kimi K3.1 Pro
- Despliegue privado y ajuste fino: cuando necesitas pesos abiertos para ajuste fino de dominio, cuantización o despliegue offline.
- Agentes de codificación en terminal: cuando la carga principal es el ciclo de lectura y escritura, ejecución y corrección en la línea de comandos.
- Procesamiento por lotes offline: cuando puedes aceptar resultados asíncronos y aprovechar el 40% de descuento de Batch para reducir costos.
- Interacción de baja latencia: cuando la velocidad es crítica, puedes elegir la versión Highspeed y pagar más a cambio de 2 a 3 veces más velocidad.
Escenarios en los que elegir Qwen4-Max
- Prioridad al servicio gestionado: cuando no quieres mantener un clúster de inferencia y solo necesitas una API estable.
- Visión y video: cuando la comprensión de capturas de pantalla, el análisis de gráficos y el análisis de video son las entradas principales.
- Entrega de tareas largas: generación de informes, agentes de procesos de negocio, preguntas y respuestas especializadas en medicina y biología, etc.
- Sensibilidad al costo por token: con un effort bien controlado, el costo por millón de tokens es el más bajo.
Qwen4-Max frente a Kimi K3.1 Pro: recomendaciones para decidir
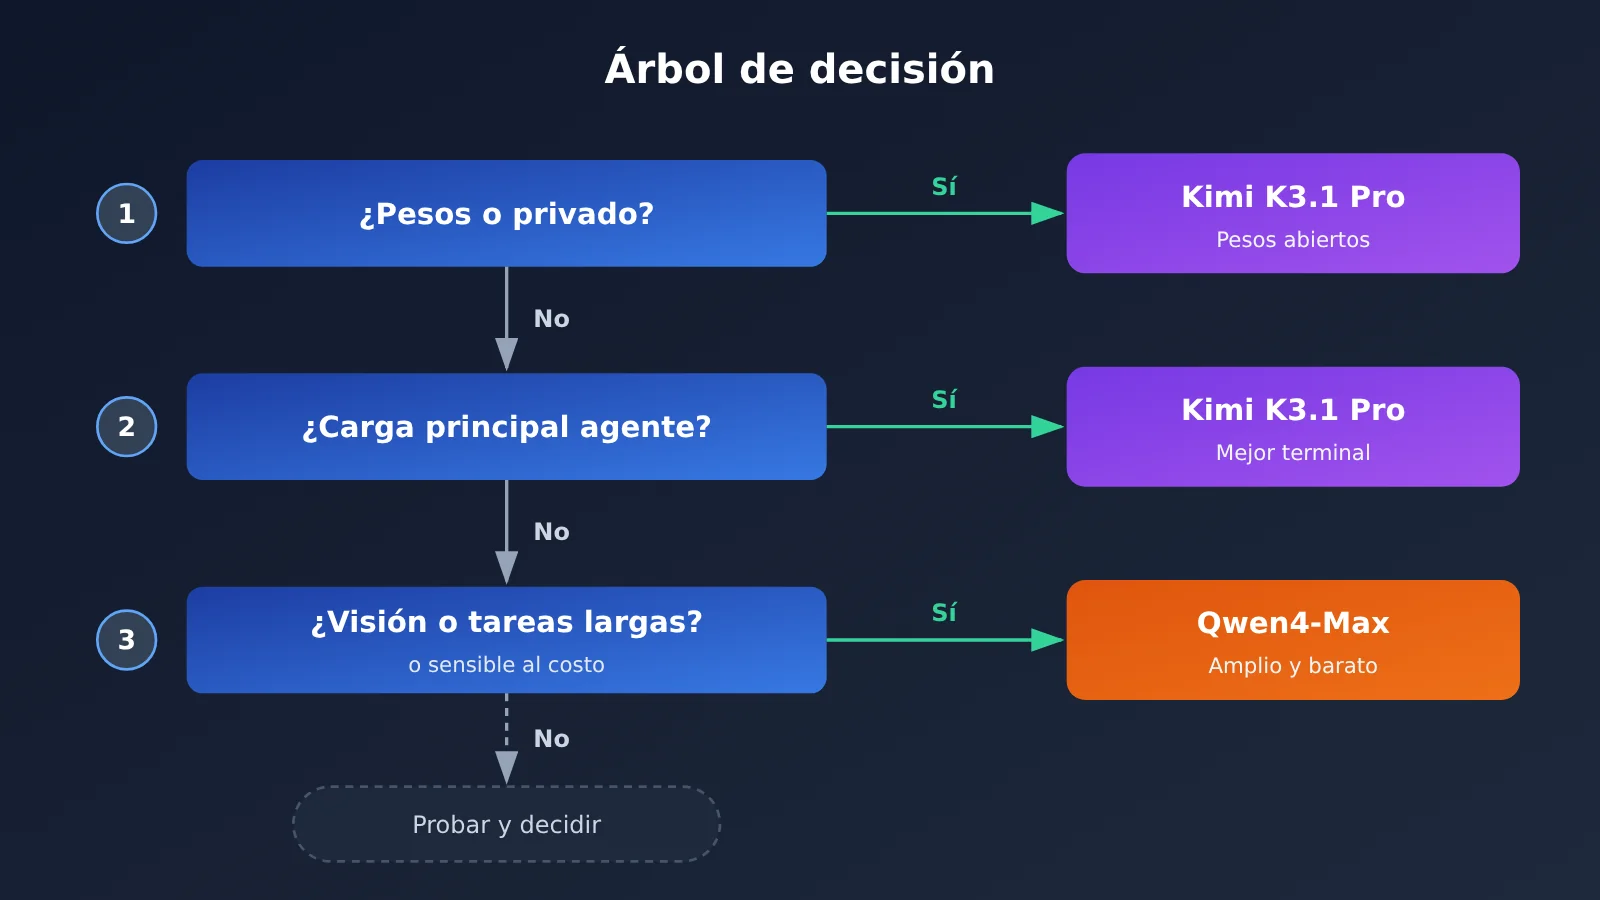
Cinco dimensiones resumidas en tres preguntas. Primera: ¿necesitas sí o sí los pesos? Si la respuesta es sí, elige directamente Kimi K3.1 Pro. Segunda: ¿tu carga principal son agentes de línea de comandos en terminal? Entonces Kimi es más estable. Tercera: si no aplica ninguno de los casos anteriores, Qwen4-Max aventaja en visión, entrega de tareas largas y precio unitario.
También es habitual combinarlos: Kimi K3.1 Pro se encarga de la ejecución en terminal y la familia Qwen asume la comprensión visual y la entrega de informes. Esa orquestación exige que los dos modelos usen la misma interfaz, y una pasarela unificada ahorra bastante trabajo de adaptación.
💡 Recomendación de selección: al final, la elección depende de cómo se distribuyen tus tareas. Te sugerimos hacer una comparación con tareas reales en APIYI apiyi.com, usando el mismo base_url para registrar la tasa de éxito y el consumo de tokens de cada lado, y solo después decidir cuál será tu modelo principal.
Preguntas frecuentes (FAQ)
P1: ¿Cuál es la diferencia más importante entre Qwen4-Max y Kimi K3.1 Pro?
Kimi K3.1 Pro es un modelo de pesos abiertos de nivel 3T, que puedes desplegar y ajustar por tu cuenta; Qwen4-Max se ofrece como API gestionada, con visión nativa y un precio de lista más bajo. El primero destaca en tareas de terminal; el segundo, en visión y entrega de tareas largas.
P2: ¿El Terminal-Bench de Kimi K3.1 Pro es 65.7 o 67.2?
Los dos son correctos, pero bajo criterios distintos. El 65.7 % viene de la documentación oficial de Moonshot; el 67.2 sale de la comparación en la misma gráfica que Qwen reportó oficialmente. La diferencia proviene del harness, del effort y de la versión del conjunto de problemas. Al citarlos hay que indicar la fuente, no mezclarlos ni empalmar rankings de documentos distintos.
P3: ¿La longitud de contexto es igual en ambos?
Prácticamente sí. Kimi K3.1 Pro tiene 1.048.576 tokens y Qwen4-Max, 1M. Qwen4-Max publica además una salida máxima de 393K y una cadena de pensamiento máxima de 262K, lo que resulta más cómodo para salidas largas en una sola interacción.
P4: ¿Por qué Qwen4-Max tiene un precio unitario más bajo pero un coste por tarea más alto en arena?
En la instantánea de arena, Qwen4-Max usa el nivel xHigh, gasta muchos tokens de cadena de pensamiento y cuesta $4.18 por tarea, frente a $0.89 de Kimi K3.1 Pro (Max). El coste real es el precio unitario multiplicado por el consumo de tokens, así que solo bajando `reasoning_effort` podrás aprovechar de verdad la ventaja de precio.
P5: ¿Ya se puede invocar Qwen4-Max a través de APIYI?
`qwen4-max` todavía no está disponible; lo publicaremos lo antes posible. Por ahora puedes invocar `kimi-k3.1-pro`, `kimi-k3.1-pro-highspeed` y `qwen3.8-max` en APIYI apiyi.com, con base_url `https://api.apiyi.com/v1`. Los modelos y precios vigentes son los que aparecen en la lista de modelos de la plataforma.
P6: ¿Qué limitaciones conocidas tiene cada modelo?
Qwen4-Max va claramente por detrás en tareas de terminal (48.5 frente a 67.2 en la gráfica de Alibaba), su ranking en arena sigue en Preliminary y el effort alto por defecto puede encarecer el coste por tarea. Kimi K3.1 Pro tiene un precio de salida de más del doble que Qwen4 y se queda atrás en visión, vídeo y en la mayoría de las métricas de entrega del sector.
Puntos clave de Qwen4-Max frente a Kimi K3.1 Pro
- Los pesos marcan una frontera clara: si quieres hacer ajuste fino o despliegue privado, solo Kimi K3.1 Pro está disponible.
- Kimi es más fuerte en tareas de terminal: en la misma gráfica de Alibaba, Kimi supera a Qwen4-Max por 18,7 puntos.
- Los benchmarks dependen de la metodología: 65,7 y 67,2 provienen de harness distintos y no se pueden mezclar.
- Qwen4 destaca en entrega y visión: lidera en JobBench, APEX-Agents, Video-Index y otras métricas.
- Precio unitario más bajo en Qwen4: el precio de salida es solo el 45% del de Kimi, pero hay que controlar el esfuerzo (effort).
- Cómo empezar: en APIYI, usa la misma clave API para alternar entre
kimi-k3.1-proy la serie Qwen y comparar.
Resumen
Conclusiones clave de la comparación entre Qwen4-Max y Kimi K3.1 Pro:
- ¿Se puede modificar el modelo?: los pesos abiertos son una ventaja exclusiva de Kimi K3.1 Pro.
- Terminal y entrega: Kimi destaca en agentes de línea de comandos; Qwen4-Max, en entrega de tareas largas, visión y video.
- Coste: Qwen4-Max es el más barato por millón de tokens, pero la factura real depende del consumo de tokens que genere el esfuerzo (effort).
Las puntuaciones de benchmark solo indican una dirección; la respuesta final la obtendrás en tus propias tareas. Te recomendamos hacer una ronda de comparación con poco tráfico a través de APIYI apiyi.com usando la interfaz unificada. Cuando qwen4-max esté disponible, también podrás cambiar de modelo sin fricción para seguir validando.
📚 Referencias
- Blog oficial de Qwen4-Max: especificaciones del modelo, contexto y precios de QwenCloud
- Enlace:
qwen.ai/blog?id=qwen4-max -
Descripción: incluye datos comparativos de la misma imagen autoinformados por Qwen.
-
Guía de inicio rápido de Kimi K3.1 Pro: documentación oficial de Moonshot
- Enlace:
platform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart.md -
Descripción: incluye las puntuaciones oficiales autoinformadas de Terminal-Bench 4.0 y Kimi Code Bench 3.0.
-
Precios de los modelos de chat de Kimi: página oficial de precios de Moonshot
- Enlace:
platform.kimi.ai/docs/pricing/chat.md -
Descripción: reglas de facturación de la versión estándar, la versión Highspeed y Batch.
-
Arena Code Arena WebDev: instantánea de la clasificación pública, 2026-11-14
- Enlace:
arena.ai - Descripción: ranking de votación de terceros y costo por tarea.
Autor: equipo técnico de APIYI
Contacto técnico: escríbenos desde la página principal del sitio de APIYI; encontrarás más recursos en el centro de documentación docs.apiyi.com