Anmerkung des Autors: Auf Basis eines Praxistests von Apple Intelligence in der China-Version unter iOS 27.3 zerlegen wir die Arbeitsteilung zwischen On-Device-Modellen und Cloud-Großmodellen und liefern einen direkt anwendbaren 5-dimensionalen Bewertungsrahmen sowie Schritte für die Umsetzung in der Praxis.
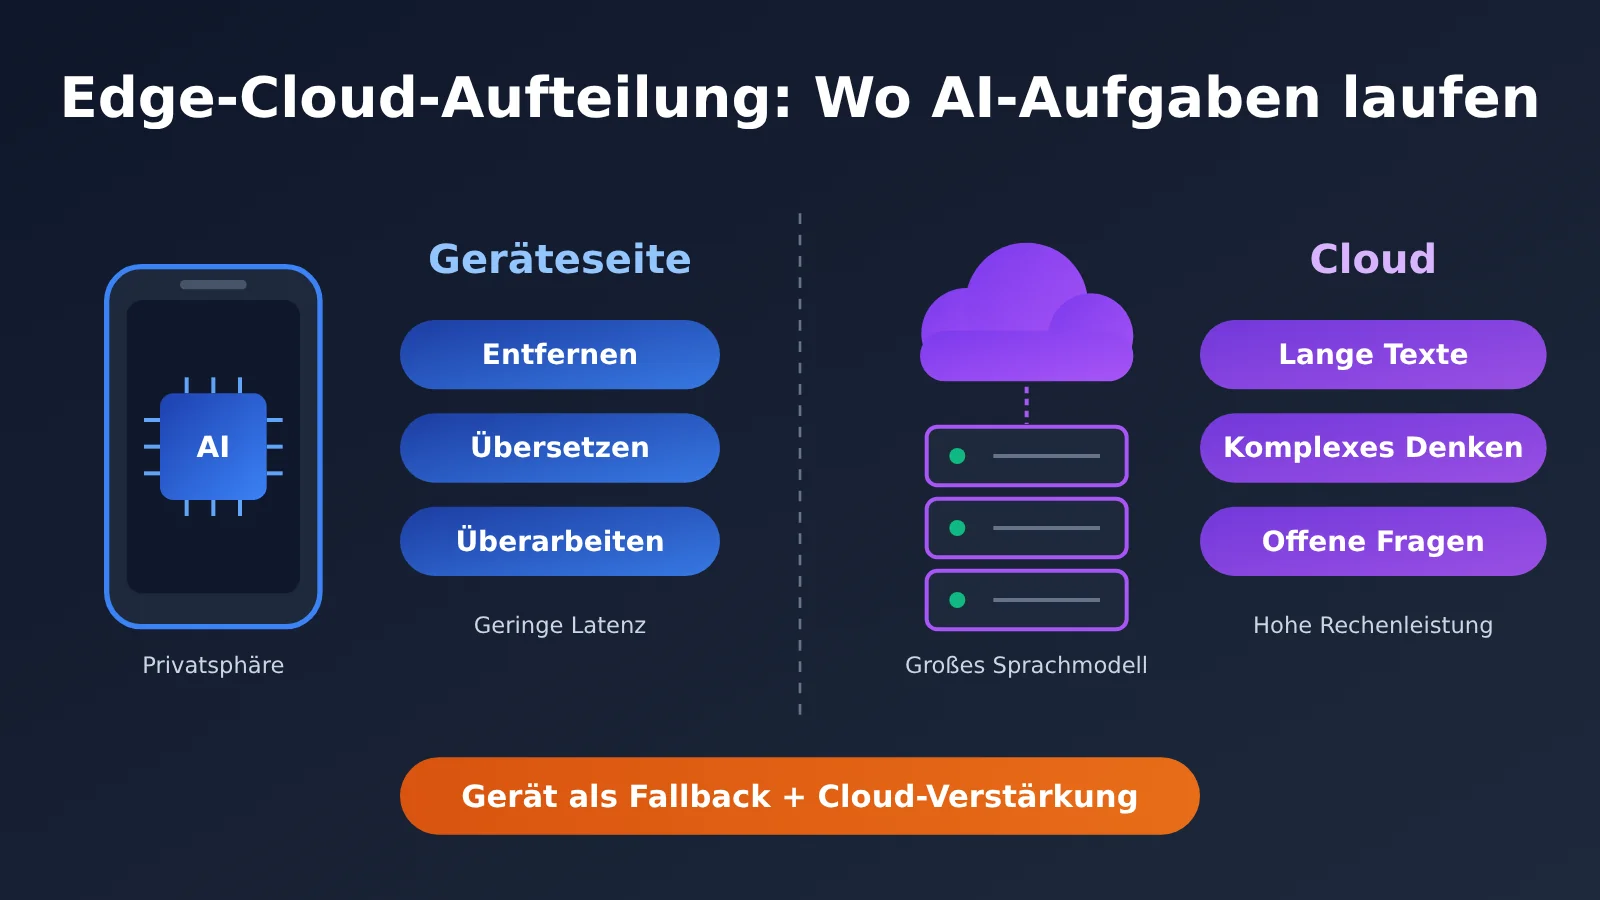
Mit der Auslieferung der iOS-27.3-Developer-Beta wurde Apple Intelligence für den chinesischen Markt endlich zum Test freigegeben. Im Hintergrund stehen Apples eigene Modelle und Alibabas Qwen: Fotobereinigung, einfache Textüberarbeitung und Echtzeitübersetzung laufen auf dem Gerät; lang laufende Siri-Aufgaben und das „Fragen“ der visuellen Intelligenz übernimmt Qwen in der Cloud. Dieser Marktstart in China ist damit ein sehr konkretes Beispiel für die Arbeitsteilung zwischen Gerät und Cloud.
Dies ist kein weiterer Überblick über Funktionen und Erfahrungen, sondern eine Analyse der Designlogik dieser Arbeitsteilung anhand des Beispiels: Welche KI-Aufgaben gehören aufs Gerät, welche müssen an ein Cloud-Großmodell gehen – und wo sollten Entwickler in ihren eigenen Produkten diese Grenze ziehen?
Kernnutzen: Nach der Lektüre dieses Artikels verfügen Sie über einen 5-dimensionalen Bewertungsrahmen für die Aufteilung zwischen Gerät und Cloud und können in vier Schritten eine hybride Architektur aus „On-Device-Fallback + Cloud-Erweiterung“ in Ihrer eigenen App umsetzen.
Kernpunkte der Aufteilung zwischen On-Device und Cloud bei Apple Intelligence für den chinesischen Markt
Zuerst fasse ich die Aufteilung, die sich in Tests bestätigen lässt, in einer Tabelle zusammen. Die Spalten „Ausführungsort“ und „Testergebnis“ stammen aus öffentlich verfügbaren Tests. Daran zeigt sich, dass Apples Aufteilung nicht willkürlich ist, sondern klaren Regeln folgt.
| Funktion | Ausführungsort | Modellquelle | Testergebnis |
|---|---|---|---|
| Foto-Bereinigung | Auf dem Gerät | Apple-eigenes On-Device-Modell | Bei einfachen Hintergründen saubere Ergebnisse; bei komplexen Texturen bleiben leicht niedrig aufgelöste Farbflecken zurück |
| Echtzeitübersetzung | Auf dem Gerät | Apple-On-Device-Modell, Sprachpaket erforderlich (je ca. 2 GB) | Alltagssprache mit weniger als 1 Sekunde Verzögerung, gute Genauigkeit |
| Schreibwerkzeuge (grundlegende Überarbeitung) | Überwiegend auf dem Gerät | Apple-eigenes Modell | Bequem systemweit aufrufbar; chinesische Umformulierungen wirken etwas steif |
| Mitteilungszusammenfassungen / natürliche Suche in der Fotos-App | Auf dem Gerät | Apple-eigenes Modell, lokaler Index erforderlich | Direkt nach dem Update dauert es ein bis zwei Tage, bis der Index fertig ist |
| Komplexe Siri-Aufgaben | Cloud | Alibaba Qwen; Nutzerautorisierung und Anmeldung mit Qwen-Konto erforderlich | Ergebnisse nach etwa 7 bis 8 Sekunden; Inhalte eher knapp |
| Visuelle Intelligenz „Fragen“ / „Suchen“ | Cloud | „Fragen“ nutzt Qwen, „Suchen“ standardmäßig das Baidu-Vision-Modell; Drittanbieter-Apps können angebunden werden | Nach Anpassung durch Dritte kann die App in der Liste der Suchdienste erscheinen |
Schwerpunkt im Detail: Aufteilung zwischen Endgerät und Cloud – warum Objektentfernung und Übersetzung auf dem Gerät bleiben
Foto-Objektentfernung und Echtzeitübersetzung haben drei Gemeinsamkeiten: Die Eingaben sind private Nutzerdaten (Fotos, Gesprächsaudio), sie reagieren extrem empfindlich auf Latenz, und die Aufgaben sind klar abgegrenzt. Gesichter und Standortinformationen auf Fotos verlassen das Gerät nicht – das minimiert das Datenschutzrisiko. Bei der Übersetzung muss während des Gesprächs übersetzt werden; jede einzelne Netzwerkrunde würde den Gesprächsrhythmus stören. Die Latenz von unter einer Sekunde auf dem Gerät ist genau der entscheidende Faktor für das Nutzererlebnis.
Der Preis dafür ist ebenfalls offensichtlich. Der Parameterumfang von On-Device-Modellen ist durch Rechenleistung und Speicher des Smartphones begrenzt. Deshalb scheitert die Objektentfernung bei komplexen Texturen wie großen Grasflächen oder Kieselsteinen. Jedes Sprachpaket für die Übersetzung belegt rund 2 GB. Das diesmalige Systemupdate ist satte 12 GB groß – im Kern zahlt man damit „Miete“ für die On-Device-Modelle.
Schwerpunkt im Detail: Aufteilung zwischen Endgerät und Cloud – warum Siri langwierige Aufgaben an die Cloud gibt
Anfragen wie „Stell mir einen viertägigen Reiseplan für Jiuzhaigou zusammen“ benötigen viel Weltwissen, lange Textgenerierung und mehrstufige Planung. Ein kleines On-Device-Modell ist damit schlicht überfordert. Apples Ansatz: Erkennt Siri, dass eine Frage die eigenen Fähigkeiten übersteigt, zeigt es einen Dialog und fragt den Nutzer, ob Qwen aufgerufen werden darf. Lehnt er ab, wird die Antwort direkt verworfen.
Dieser Dialog ist für Entwickler sehr lehrreich. Er sagt dem Nutzer ausdrücklich, dass Daten das Gerät verlassen, und gibt ihm die Entscheidung über den Datenschutz zurück. Zugleich erinnert uns der Praxistest daran, dass die Qualität der Cloud-Ergebnisse davon abhängt, welchen Kontext und welche Eingabeaufforderungen das System dem Modell vorgibt. Der Siri-Reiseplan ist deutlich schlechter als eine direkt in der Qwen-App gestellte Frage. Das zeigt: „Ein großes Sprachmodell angebunden“ bedeutet nicht, es auch gut zu nutzen.
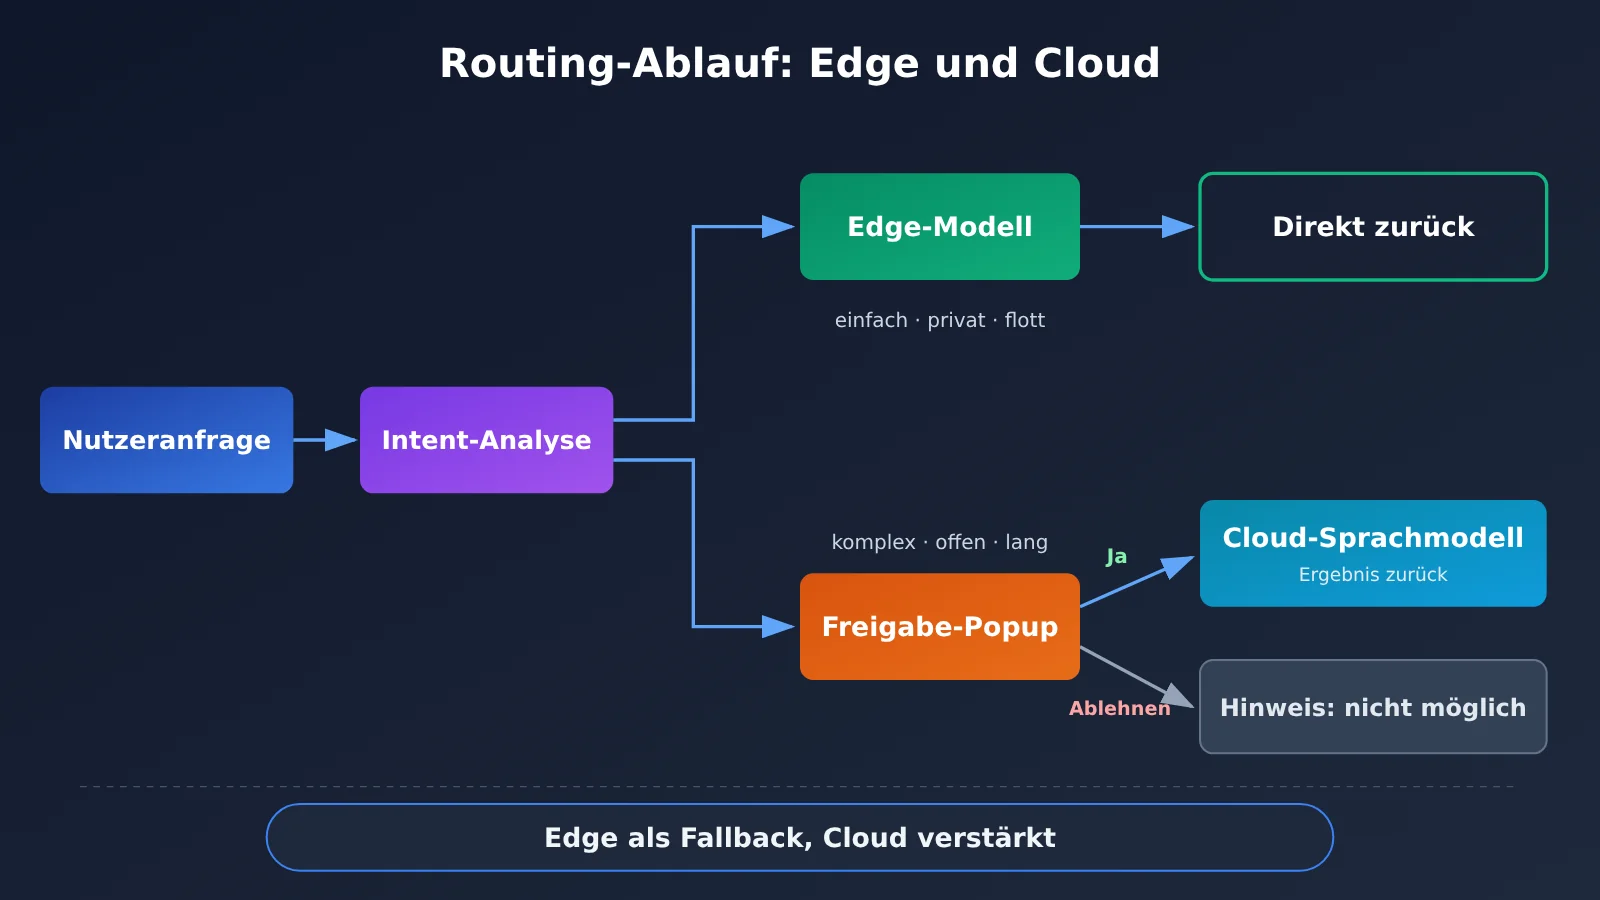
Entscheidungsrahmen für die Arbeitsteilung zwischen Gerät und Cloud: 5 Dimensionen entscheiden, wo eine Aufgabe hingehört
Aus der Arbeitsteilung von Apple Intelligence für den chinesischen Markt lassen sich fünf Bewertungsdimensionen ableiten. Bei der konkreten Planung kann man jede Aufgabe anhand dieser fünf Dimensionen einzeln bewerten. Tendiert die Mehrheit der Dimensionen zu einer Seite, wird die Aufgabe dort verortet.
| Bewertungsdimension | Merkmale, die für das Gerät sprechen | Merkmale, die für die Cloud sprechen | Beispiel aus Apple Intelligence |
|---|---|---|---|
| Datenempfindlichkeit | Private Daten wie Fotos, Kontakte und Chatverläufe | Öffentliches Wissen, von Nutzern aktiv gestellte Fragen | Objektentfernung auf dem Gerät, Ratgeber-Fragen über die Cloud |
| Latenzanforderung | Reaktion in unter 1 Sekunde nötig, eine Unterbrechung macht den Vorgang unbrauchbar | Wartezeit von einigen Sekunden akzeptabel | Übersetzung auf dem Gerät, längere Siri-Aufgaben dauern etwa 7 bis 8 Sekunden |
| Aufgabenkomplexität | Klar abgegrenzt, kurze Ausgabe | Offene Fragen, mehrstufige Planung, Erzeugung langer Texte | Einfache Textkorrektur auf dem Gerät, komplexe Fragen gehen an Qwen |
| Aktualität des Wissens | Keine Abhängigkeit von externen aktuellen Informationen | Weltwissen oder Echtzeitsuche erforderlich | Die „Suche“ der visuellen Intelligenz nutzt Baidu und Drittanbieter |
| Offline-Verfügbarkeit | Muss bei schwachem oder fehlendem Netz verfügbar sein | Standardmäßig Online-Szenario | Echtzeitübersetzung läuft nach dem Herunterladen eines Sprachpakets lokal |
Häufige Missverständnisse bei der Arbeitsteilung zwischen Gerät und Cloud
Viele Teams tappen bei der Aufteilung zwischen Gerät und Cloud in die folgenden Fallen. Es lohnt sich, sie von vornherein zu vermeiden:
- Irrtum 1: Was auf das Gerät passt, gehört komplett auf das Gerät. Die Fähigkeiten von On-Device-Modellen sind begrenzt. Komplexe Aufgaben gewaltsam dorthin zu verlagern, führt nur zu minderwertigen Ergebnissen wie bei den misslungenen Ergebnissen der Objektentfernung – und schadet am Ende dem Nutzererlebnis.
- Irrtum 2: Ist erst einmal die Cloud angebunden, ist alles erledigt. Das Beispiel der Siri-Ratgeber zeigt: Auch System-Eingabeaufforderungen, die Organisation des Kontexts und die Steuerung der Ausgabelänge entscheiden über die Qualität.
- Irrtum 3: Berechtigungen und Fallbacks außer Acht lassen. Bei Cloud-Aufrufen muss man berücksichtigen, wie es weitergeht, wenn Nutzer die Berechtigung verweigern oder das Netz ausfällt; Funktionen dürfen nicht einfach „verschwinden“.
- Irrtum 4: Kosten nur einmal berechnen. Auf dem Gerät fallen einmalige Speicher- und App-Paketkosten an, in der Cloud laufende nutzungsabhängige Aufrufkosten; beides muss getrennt kalkuliert werden.
Schnelleinstieg in die Aufteilung zwischen On-Device und Cloud: 4 Schritte zur Umsetzung in deiner eigenen App
Hier übersetzen wir den Bewertungsrahmen in konkrete, umsetzbare Schritte. Das gilt auch dann, wenn du kein Mobilbetriebssystem entwickelst, sondern eine normale App, eine Mini-App oder ein Desktop-Tool.
Schritt 1: Aufgaben erfassen und nach On-Device und Cloud kennzeichnen
Liste alle Funktionen im Produkt auf, die AI nutzen sollen, und bewerte sie entlang der fünf Dimensionen aus dem vorigen Abschnitt. Erstelle am besten eine Aufgabenliste mit mindestens den Spalten „Aufgabenname, Datensensitivität, Latenzanforderungen, Komplexität, Zielumgebung“, damit du bei der Bewertung alles auf einen Blick siehst.
Schritt 2: Leichtgewichtige Lösungen für On-Device-Aufgaben wählen
Für On-Device-Aufgaben nutzt du vorzugsweise native Systemfunktionen oder leichtgewichtige Modelle, etwa von der Plattform bereitgestellte Schnittstellen für Übersetzung, OCR und Spracherkennung oder quantisierte Modelle mit wenigen Parametern. Achte besonders auf Modellgröße und die Erfahrung beim ersten Download. Orientiere dich an Apple: große Ressourcen bei Bedarf herunterladen und beim ersten Einsatz einen klaren Hinweis anzeigen.
Schritt 3: Für Cloud-Aufgaben APIs für große Sprachmodelle anbinden
Cloud-Aufgaben erfordern die Anbindung an ein ausreichend leistungsfähiges großes Sprachmodell. Wenn du wie bei Apple Intelligence in der chinesischen Version die Qwen-Serie nutzen möchtest oder gleichzeitig Modelle wie GPT und Claude vergleichen willst, kannst du sie über APIYI einheitlich aufrufen. APIYI bietet Zugriff auf die in diesem Artikel erwähnten wichtigen APIs für große Sprachmodelle und ist sowohl mit dem OpenAI- als auch dem Anthropic-Schnittstellenformat kompatibel. Bestehender Code lässt sich in der Regel migrieren, indem du nur API-Endpunkt und Schlüssel austauschst. Welche Modelle konkret verfügbar sind, steht in der Liste auf der Preisseite.
Die wichtigsten Konfigurationspunkte bei der Anbindung zeigt die folgende Tabelle. Für den API-Endpunkt gilt die APIYI-Dokumentation unter docs.apiyi.com:
| Konfigurationspunkt | Zweck | Empfehlung für die Aufteilung zwischen On-Device und Cloud |
|---|---|---|
| API-Endpunkt (base_url) | Legt den Server fest, an den Anfragen gesendet werden | Gemäß APIYI-Dokumentation docs.apiyi.com eintragen; für das OpenAI-Format und das Anthropic-Format gelten jeweils die eigenen Adressangaben |
| API Key | Identitätsprüfung und Abrechnung | Nur serverseitig speichern, nicht in das Client-Installationspaket packen |
| model | Gibt das aufzurufende Modell an | Für komplexe Planungsaufgaben ein starkes Reasoning-Modell wählen, für einfaches Umschreiben ein leichtgewichtiges Modell |
| max_tokens | Steuert die Ausgabelänge | Bei Aufgaben wie Ratgebern und Berichten großzügiger bemessen, um Siri-artige Überknappheit zu vermeiden |
| stream | Ob die Ausgabe gestreamt wird | Bei langen Cloud-Aufgaben aktivieren, um die gefühlte Verzögerung durch mehrere Sekunden Wartezeit auszugleichen |
| Timeout und Wiederholungsversuche | Behandlung von Netzwerkfehlern | Sinnvolle Timeouts setzen und bei Fehlern auf ein vereinfachtes On-Device-Ergebnis zurückfallen oder einen klaren Hinweis geben |
Schritt 4: Berechtigungsdialog und Fallback-Pfad entwerfen
Orientiere dich am Bestätigungsdialog, der bei Siri vor dem Aufruf von Qwen erscheint. Bei allen Funktionen, die Nutzerdaten in die Cloud senden, muss beim ersten Aufruf erklärt werden, welche Inhalte gesendet werden und an wen. Wenn Nutzer ablehnen, brich nicht wie Siri einfach ab, sondern falle auf On-Device-Funktionen zurück und liefere ein vereinfachtes Ergebnis oder bitte die Nutzer, Informationen manuell zu ergänzen.
🚀 Schnellstart: Wähle zunächst eine Cloud-Aufgabe mit der höchsten Komplexität für einen Prototyp aus. Nach der Registrierung über APIYI apiyi.com erhältst du Testguthaben. Wechsle mit demselben OpenAI-kompatiblen Format zwischen verschiedenen Modellen und vergleiche, welches Modell in deinem Szenario die beste Ausgabequalität liefert, bevor du dich für die endgültige Lösung entscheidest.
Vergleich der Arbeitsteilung zwischen Gerät und Cloud: rein geräteseitig, rein cloudbasiert und Edge-Cloud-Kombination
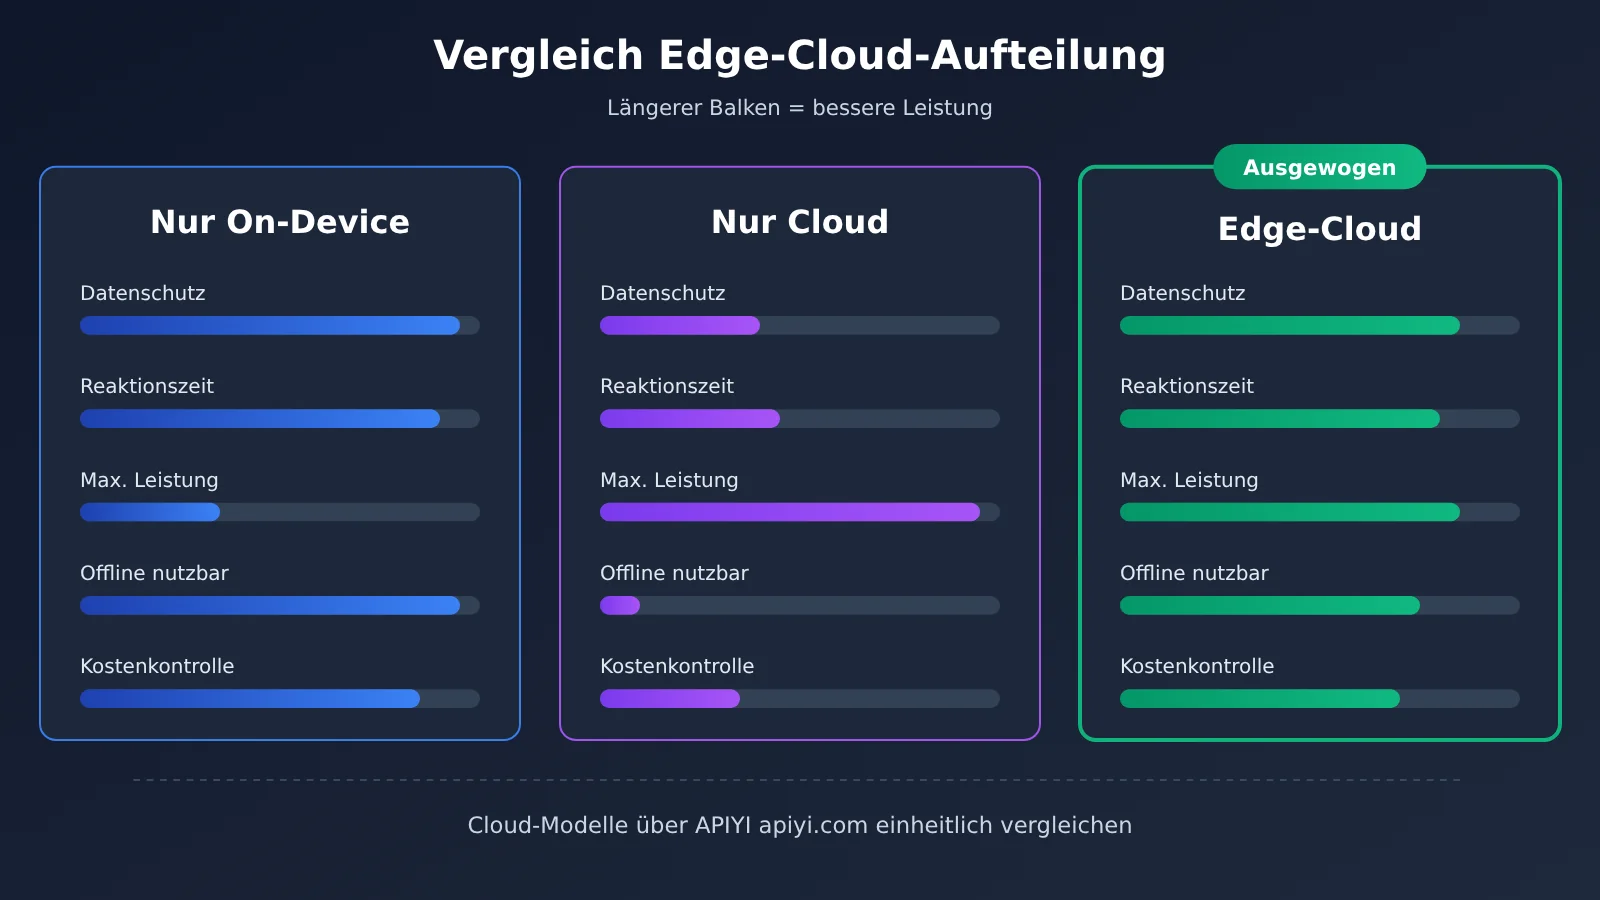
| Ansatz | Kernmerkmale | Geeignete Szenarien | Hauptschwächen | Plattformen für Cloud-Modelle |
|---|---|---|---|---|
| Rein geräteseitig | Daten verlassen das Gerät nicht, offline nutzbar | Klar abgegrenzte Aufgaben wie Übersetzung, Objektentfernung, Spracherkennung | Geringe Leistungsobergrenze, hoher Druck auf App-Größe und Speicher | Nicht relevant |
| Rein cloudbasiert | Hohe Leistungsobergrenze, schnelle Iteration | Offene Fragen und Antworten, lange Texte, mehrstufige Planung | Netzabhängig, Datenschutzbedenken und laufende Aufrufkosten | APIYI apiyi.com, offizielle APIs der jeweiligen Modelle |
| Edge-Cloud-Kombination | Gerät als Grundlage, Cloud als Verstärkung, Routing je nach Aufgabe | Nahezu alle verbraucherorientierten KI-Produkte | Komplexe Architektur, Routing, Autorisierung und Fallback müssen entworfen werden | APIYI apiyi.com, offizielle APIs der jeweiligen Modelle |
Vergleichsanalyse der Arbeitsteilungsansätze
Benchmark-Analyse: rein geräteseitig: Rein geräteseitige Ansätze liegen bei Datenschutz und Reaktionsgeschwindigkeit vorn – die Latenz von unter einer Sekunde bei Echtzeitübersetzung ist der beste Beleg dafür. Allerdings sind On-Device-Modelle durch Rechenleistung und Speicher begrenzt; bei komplexer Texturentfernung oder anspruchsvoller chinesischer Umformulierung sinkt die Qualität deutlich. Die Edge-Cloud-Kombination kann solche schwierigen Fälle dagegen an die Cloud abgeben und so die Leistungsobergrenze anheben, ohne die Datenschutz-Untergrenze zu verletzen.
Benchmark-Analyse: rein cloudbasiert: Rein cloudbasierte Ansätze glänzen bei Wissensbreite und Generierungsfähigkeit – seit Siri Qwen angebunden hat, kann es endlich auch Fragen zu Reiseführern und Ähnlichem beantworten. Doch jeder Aufruf hängt vom Netz und von der Zustimmung der Nutzer ab; verweigern sie diese oder ist das Netz schwach, fällt die Funktion komplett aus. Für Kernfunktionen, die „jederzeit verfügbar“ sein müssen, bleibt die Edge-Cloud-Kombination die sicherere Wahl.
💡 Auswahlempfehlung: Die Wahl des Ansatzes hängt davon ab, wie sich deine Aufgaben zusammensetzen. Wenn für den Cloud-Teil eine Entscheidung zwischen Qwen, GPT, Claude und anderen Modellen ansteht, kannst du über APIYI apiyi.com mit einer einheitlichen Schnittstelle dieselben Testaufgaben vergleichend durchlaufen lassen und dich an der tatsächlichen Ausgabequalität statt an Marketing-Parametern orientieren.
Die Kostenrechnung der Endgerät-Cloud-Aufteilung: einmalig auf dem Gerät, verbrauchsabhängig in der Cloud
Kosten sind der am häufigsten unterschätzte Faktor bei der Aufteilung zwischen Endgerät und Cloud. Die geräteseitigen Kosten zeigen sich vor allem in der App-Paketgröße, im Speicherverbrauch der Nutzer und im Erlebnis beim ersten Download. Apples diesmaliges 12-GB-Updatepaket und die Sprachpakete von jeweils rund 2 GB sind ein anschauliches Beispiel dafür. Cloud-Kosten sind dagegen laufende, nutzungsabhängige Aufrufkosten: Je aktiver die Nutzer, desto höher die Rechnung.
Auch Apple selbst kalkuliert diese Kosten durch. In der Telefonkonferenz zu den Quartalszahlen erwähnte das Apple-Management, dass für Funktionen wie Siri AI und anspruchsvolle intelligente Bildbearbeitung, die auf cloudbasierte große Sprachmodelle angewiesen sind, künftig ein Basisnutzungskontingent eingeführt wird. Intensive Nutzer müssen zusätzliche Kontingente kostenpflichtig erwerben. Mit anderen Worten: „Kostenloses Basiskontingent + kostenpflichtige Zusatznutzung für intensive Nutzer“ dürfte zum vorherrschenden Geschäftsmodell für Cloud-KI-Funktionen werden. Entwickler können diesen Ansatz bei der Gestaltung eigener Produkte als Orientierung nehmen.
Konkret auf die Aufrufkosten von Cloudmodellen bezogen: Die Eingabepreise, Ausgabepreise und die Grundlagen der Cache-Abrechnung unterscheiden sich je nach Modell stark und werden laufend angepasst. Dieser Artikel nennt keine konkreten Preisangaben. Für alle Modellpreise, Abrechnungsgrundlagen, Ein- und Ausgabepreise sowie Cache-Preise gelten die tatsächlichen Daten auf der APIYI-Preisseite https://docs.apiyi.com/models.
💰 Kostenoptimierung: Bei der Berechnung der Cloud-Kosten empfiehlt sich eine Schätzung nach dem Schema „durchschnittliche Eingabe-Token pro Aufgabe × Preis pro Eingabe-Token + durchschnittliche Ausgabe-Token × Preis pro Ausgabe-Token“. Die Preise stammen stets von der APIYI-Preisseite docs.apiyi.com/models. Bei häufig wiederholten System-Eingabeaufforderungen lohnt sich ein Blick darauf, ob die Preisseite eine Cache-Abrechnung ausweist – so lassen sich die laufenden Kosten weiter senken.
Häufig gestellte Fragen (FAQ)
F1: Was bedeutet Arbeitsteilung zwischen Gerät und Cloud?
Bei der Arbeitsteilung zwischen Gerät und Cloud werden KI-Aufgaben nach ihren Eigenschaften aufgeteilt: Ein Teil wird von einem lokalen Modell auf dem Gerät verarbeitet, der andere Teil an ein großes Sprachmodell in der Cloud geschickt. Ein typisches Beispiel ist Apple Intelligence für den chinesischen Markt: Entfernen und Übersetzen laufen auf dem Gerät, komplexe Siri-Aufgaben und die Funktion „Fragen“ der visuellen Intelligenz gehen an Qwen in der Cloud.
F2: Worin unterscheiden sich lokale Modelle und große Cloud-Modelle im Kern?
Lokale Modelle sind bei Datenschutz, Latenz und Offline-Verfügbarkeit im Vorteil, stoßen aber bei der Leistungsfähigkeit an Grenzen, die von Rechenleistung und Speicher gesetzt werden. Große Cloud-Modelle haben ein breites Wissen und starke Generierungsfähigkeiten, sind jedoch auf eine Netzverbindung angewiesen, benötigen die Zustimmung der Nutzer und verursachen laufende Kosten pro Aufruf. Die beiden ersetzen einander nicht, sondern ergänzen sich.
F3: Wann kann Apple Intelligence für den chinesischen Markt offiziell genutzt werden?
Die China-Version von Apple Intelligence ist mit der Entwickler-Beta von iOS 27.3 in die Testphase gegangen. Nach der Anmeldung über die Apple-Developer-App lässt sie sich über die Softwareaktualisierung beziehen. Die erste Test-Firmware enthält Bugs, und laut öffentlichen Berichten soll die finale Version im Dezember erscheinen. Wer sein Hauptgerät nutzt, sollte besser auf die finale Version warten.
F4: Welche KI-Aufgaben eignen sich am besten für das Gerät selbst?
Vor allem diese Szenarien:
– **Verarbeitung privater Daten**: Objekte aus Fotos entfernen, Fotosuche in natürlicher Sprache, Zusammenfassung von Mitteilungen
– **Interaktion mit extrem niedriger Latenz**: Echtzeit-Sprachübersetzung, Vorschläge der Eingabemethode
– **Funktionen, die offline verfügbar sein müssen**: Übersetzung, Spracherkennung und einfache Textkorrektur bei schwacher Netzverbindung
F5: Wie ruft man Qwen und andere Cloud-Modelle schnell per API auf?
Zum Testen empfiehlt sich eine Multi-Modell-Plattform:
1. Auf APIYI apiyi.com ein Konto registrieren und einen API-Schlüssel erhalten
2. Im Dokumentationszentrum docs.apiyi.com die Hinweise zur Einbindung im OpenAI-kompatiblen oder Anthropic-kompatiblen Format nachlesen
3. Auf der Preisseite docs.apiyi.com/models die verfügbaren Modelle und die Abrechnungsgrundlage prüfen und dann nur Endpunkt-Adresse und Schlüssel austauschen, um loszulegen
So lassen sich Qwen und andere gängige Modelle über dieselbe Schnittstelle vergleichen.
F6: Was passiert, wenn Nutzer beim Cloud-Aufruf die Zustimmung verweigern?
Siri verzichtet in diesem Fall einfach auf eine Antwort, was etwas abrupt wirkt. Besser ist ein gestalteter Ausweichpfad: auf das Gerät zurückfallen und ein vereinfachtes Ergebnis liefern oder die Nutzer bitten, Informationen zu ergänzen und es erneut zu versuchen. Gleichzeitig sollte die Entscheidung der Nutzer respektiert werden, ohne sie mit wiederholten Dialogen zu belästigen.
F7: Welche bekannten Einschränkungen hat das Modell der Arbeitsteilung zwischen Gerät und Cloud?
Nüchtern betrachtet sind es vor allem drei Punkte:
– **Architekturkomplexität**: Intent-Routing, Zustimmungsabläufe und Ausweichlogik müssen zusätzlich gepflegt werden
– **Einheitlichkeit des Erlebnisses**: Lokale und Cloud-Ausgaben unterscheiden sich im Stil, was für Nutzer brüchig wirken kann
– **Grenzen des Ökosystems**: Wie Praxistests zeigen, kommt die System-KI nicht in Drittanwendungen wie WeChat oder Meituan hinein. Der persönliche Kontext bleibt also lückenhaft, und die Arbeitsteilung zwischen Gerät und Cloud löst das Problem der Datensilos nicht
Kernpunkte der Aufgabenverteilung zwischen Gerät und Cloud
- Das Wesen der Arbeitsteilung: Private Aufgaben mit klarer Abgrenzung und niedriger Latenz bleiben auf dem Gerät, komplexe, offene Aufgaben mit langen Texten gehen in die Cloud.
- Beispiel aus der China-Variante: Apples eigenes Modell übernimmt Objektentfernung und Übersetzung, Alibabas Qwen kümmert sich um lange Siri-Aufgaben und visuelle Anfragen.
- Beurteilungsrahmen: Datenempfindlichkeit, Latenz, Komplexität, Aktualität und Offline-Verfügbarkeit – fünf Dimensionen, die einzeln bewertet werden.
- Zustimmung ist Pflicht: Bevor Daten das Gerät verlassen, muss die ausdrückliche Zustimmung der Nutzer eingeholt werden; für den Fall einer Ablehnung braucht es einen vorbereiteten Ausweichpfad.
- Qualität entscheidet: Ein angebundenes großes Sprachmodell ist nur der Anfang – Eingabeaufforderung, Kontext und Ausgabelänge bestimmen das Enderlebnis.
- So legt man los: Cloud-Modelle lassen sich über APIYI apiyi.com einheitlich anbinden, kompatibel mit den Formaten von OpenAI und Anthropic.
Fazit
Die Einführung von Apple Intelligence in der China-Variante liefert uns eine klare Referenzantwort zur Aufgabenverteilung zwischen Gerät und Cloud:
- Auf dem Gerät bleiben Privatsphäre und Tempo gewahrt: Objektentfernung, Übersetzung und Zusammenfassungen von Mitteilungen bleiben auf dem Gerät – der Preis dafür sind App-Größe und Speicherbedarf.
- Die Cloud hebt die Leistungsobergrenze: Komplexe Fragen und visuelle Anfragen gehen an Qwen – der Preis dafür sind Latenz, Zustimmung und laufende Kosten.
- Zusammenspiel ist der Normalfall: Gerät als Grundlage, Cloud als Verstärkung, dazu ein Zustimmungsdialog und ein Ausweichpfad – erst das ergibt eine produktreife Form.
Für Entwickler ist der pragmatischste Weg: Zuerst die Aufgaben mit dem Beurteilungsrahmen etikettieren, dann eine Cloud-Aufgabe als Prototyp validieren. Empfehlenswert ist es, über APIYI apiyi.com mit einer einheitlichen Schnittstelle die tatsächlichen Ergebnisse verschiedener großer Sprachmodelle zu vergleichen. Modellpreise und Abrechnungsmodalitäten entnehmen Sie bitte der Preisseite docs.apiyi.com/models.
📚 Referenzen
- 爱范儿: Praxistest der China-Version von iPhone AI: Praxistest der ersten Entwicklerversion von Apple Intelligence in der China-Version
- Link:
ifanr.com/1687733 -
Beschreibung: Quelle für die in diesem Artikel beschriebene Aufgabenteilung zwischen On-Device- und Cloud-Funktionen sowie für die Testergebnisse
-
APIYI Dokumentationszentrum: Anleitung zur Anbindung im OpenAI- und Anthropic-kompatiblen Format
- Link:
docs.apiyi.com -
Beschreibung: Schnittstellenadressen, Authentifizierungsmethoden und Aufrufparameter richten sich nach dieser Quelle
-
APIYI Modellpreisseite: Liste der verfügbaren Modelle und Abrechnungsgrundlage
- Link:
docs.apiyi.com/models - Beschreibung: Informationen zur Abrechnung wie Eingabe- und Ausgabepreise sowie Cache-Preise richten sich nach den tatsächlichen Daten auf dieser Seite
Autor: APIYI-Team
Technischer Austausch: Sie können uns gerne über die Startseite von APIYI apiyi.com kontaktieren; weitere Integrationsmaterialien finden Sie im Dokumentationszentrum unter docs.apiyi.com