
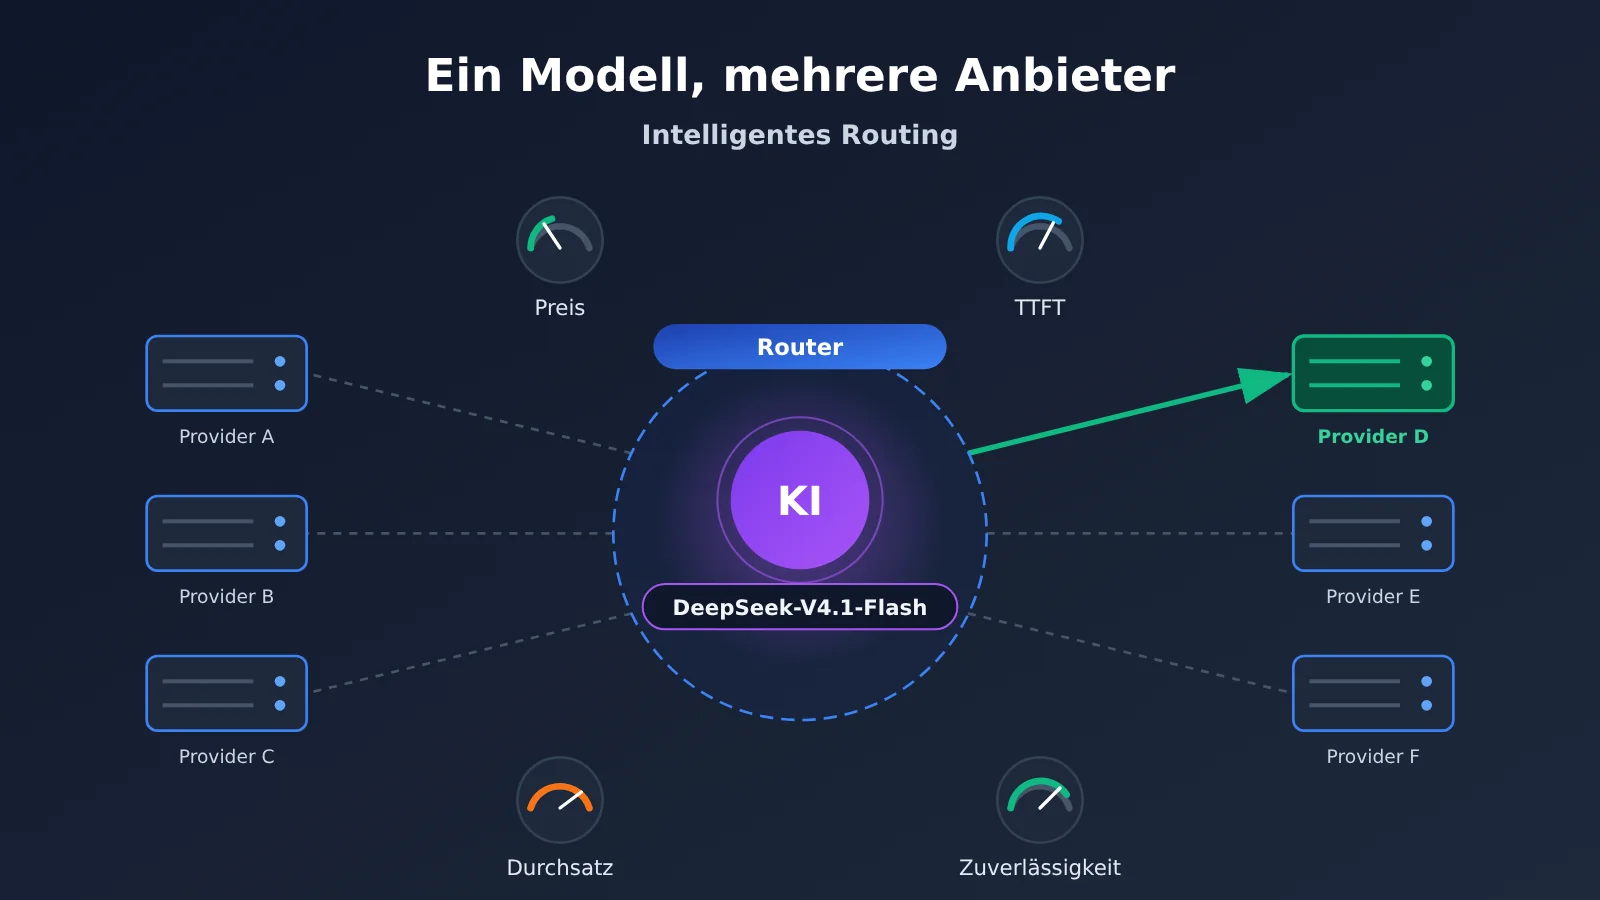
Direkte Antwort: Dasselbe Open-Weight-Modell kann von vielen Inferenzanbietern jeweils separat betrieben werden – daher gibt es Dutzende API-Anbieter. OpenRouter schaut nicht einfach darauf, wer den niedrigsten Listenpreis hat, sondern wählt den Anbieter anhand der Gesamtkosten einer erfolgreichen Antwort. Dabei bewertet OpenRouter sechs Kennzahlen gleichzeitig: den tatsächlich effektiven Preis, die Latenz bis zum ersten Token (Time to First Token, TTFT), den Durchsatz, die Rate Limits, die Zuverlässigkeit und die Antwortqualität. Anschließend geht die Anfrage an den aktuell am besten geeigneten Provider; schlägt sie fehl, wird sie bei einem anderen Anbieter erneut versucht.
Das zeigt: Der Wettbewerb bei der KI-API-Aggregation reicht inzwischen über die „einheitliche Schnittstelle“ hinaus bis zur „dynamischen Steuerung der Anbieter“. Am 16. November 2026 gab Hugging Face bekannt, das Routing der Sprachmodelle von Inference Providers an OpenRouter zu übergeben. Diese Kooperation liefert ein konkretes Beispiel dafür, wie aus diesen Kennzahlen ein Mechanismus zur automatischen Auswahl des Anbieters wird.
Was Sie aus diesem Artikel mitnehmen:
- Warum dasselbe KI-Modell mehrere API-Anbieter hat und worin sich Modellentwickler und Inferenzanbieter unterscheiden
- Auf welchen Entscheidungskennzahlen das Provider-Routing basiert und welches Problem jede Kennzahl löst
- Was Failover leisten kann und wo seine Grenzen liegen
- Wie Sie mit den Metadaten der Hugging-Face-Modellkatalog-API selbst verschiedene Anbieter vergleichen
Gliederung: Der Fakten-Teil ist folgendermaßen aufgebaut: Zuerst erklären wir, wie es zu den vielen API-Anbietern kommt, dann schlüsseln wir die Entscheidungsobjekte des intelligenten Routings und die sechs Kennzahlen auf. Danach beschreiben wir Ablauf und Grenzen des Failovers. Schließlich zeigen wir, wie Entwickler mit der Katalog-API selbst Provider vergleichen – unterbrochen von den von OpenRouter veröffentlichten Routing-Experimentdaten und Änderungen bei der Abrechnung. Der Analyse-Teil diskutiert, wohin der Wettbewerb der API-Aggregationsplattformen als Nächstes geht und wie Entwickler in ihren Anwendungen abwägen und verifizieren sollten.
Must-know-Konzepte für das Verständnis mehrerer API-Anbieter und des Provider-Routings
| Begriff | Kurze Erklärung |
|---|---|
| Provider | Anbieter, der Modelle bereitstellt und die Inferenz tatsächlich ausführt, z. B. Together AI, Novita |
| Router | Routing-Schicht, die anhand der Anfragebedingungen und des Status verfügbarer Anbieter entscheidet, wohin die Anfrage geht |
| Open-Weight-Modelle | Modelle, deren trainierte Gewichte öffentlich verfügbar sind und die gemäß ihrer Lizenz selbst bereitgestellt werden können |
| TTFT | Time to First Token; Wartezeit vom Absenden der Anfrage bis zur Rückgabe des ersten Tokens |
| Durchsatz | Anzahl der pro Zeiteinheit generierten Tokens, üblicherweise in tok/s |
| Failover | Automatischer Wechsel zu einem anderen Anbieter und erneuter Versuch, wenn der aktuelle Anbieter ausfällt |
| Prompt Caching | Anbieter cachen wiederholte Eingaben, um Rechenaufwand und Antwortzeit zu reduzieren |
| BYOK | Bring Your Own Key: eigenen Anbieter-Key mitbringen und das Guthaben des entsprechenden Kontos nutzen |
| P50 / P95 | Statistische Perzentile; P50 ist der Median, P95 bildet die langsameren 5 % der Anfragen ab |
Kurzüberblick über die Auswirkungen von Routing-Änderungen bei mehreren API-Anbietern
- Entwickler:innen: Der Code und die Token von Hugging Face müssen grundsätzlich nicht geändert werden, aber der tatsächliche Anbieter wird durch das Routing bestimmt. Dieselbe Modell-ID kann bei unterschiedlichen Anfragen bei unterschiedlichen Providern landen. Anwendungen, die auf Tool-Aufrufe und strukturierte Ausgaben angewiesen sind, müssen erneut Regressionstests durchlaufen. Entwickler, die zuvor in Hugging Face einen eigenen Provider-Key für ein Sprachmodell konfiguriert hatten, können diesen Weg nicht mehr nutzen und müssen Key und Abrechnungszuordnung erneut prüfen.
- Einkauf und Plattformteams in Unternehmen: Anbieterzulassung, Disaster-Recovery-Strategien und Bedingungen der Datenverarbeitung müssen neu bewertet werden. Organisationen können bestimmte Provider deaktivieren, aber das bedeutet nicht, dass sie vollständige Datenresidenz- oder Compliance-Garantien erhalten. Die Datenrichtlinien der Anbieter müssen weiterhin einzeln geprüft werden.
Ein KI-Modell, mehrere API-Anbieter: die objektiven Fakten
Warum es für dasselbe Modell mehrere API-Anbieter gibt
Modellentwickler und Inferenzdienstleister sind zwei unterschiedliche Rollen. Der Entwickler ist für das Training des Modells und die Veröffentlichung der Gewichte verantwortlich. Bei Modellen mit offenen Gewichten kann jede Organisation, die über die nötige Rechenleistung verfügt und die Lizenzbedingungen erfüllt, die Gewichte auf ihrem eigenen GPU-Cluster deployen und eine API bereitstellen. Deshalb laufen Modelle wie DeepSeek, Qwen oder GLM oft gleichzeitig auf mehreren Inferenz-Infrastrukturen.
Am Beispiel von deepseek-ai/DeepSeek-V4.1-Flash: Entwickler fordern denselben Modellnamen an, die Inferenz tatsächlich ausführen kann aber Together AI, Novita oder ein anderer Anbieter, der dieses Modell unterstützt. Die verwendete Hardware, die Clustergröße, die Skalierungsverfahren und die Preisstrategien unterscheiden sich von Anbieter zu Anbieter – deshalb gibt es auch Unterschiede bei Preis, Geschwindigkeit und tragbarer Kapazität desselben Modells. Manche sind günstiger, drosseln aber in Spitzenzeiten; manche liefern das erste Token schneller; manche unterstützen einen längeren Kontext; manche unterstützen Tool-Call-Formate vollständiger.
Skalierungsdaten zeigen, wie fragmentiert dieser Markt ist. OpenRouter gab in seiner Partnerschaftsankündigung bekannt, dass seine Plattform insgesamt über 600 Modelle unterstützt, mehr als 80 Provider anbindet, monatlich über 800 Billionen Token verarbeitet und mehr als 10 Millionen Nutzer bedient. Dies sind Daten der gesamten OpenRouter-Plattform, nicht die Skalierung, die diese Partnerschaft allein mit sich bringt. Die Provider-Seite von Hugging Face listet ebenfalls über ein Dutzend Dienstleister auf, darunter Baseten, Cerebras, DeepInfra, Fireworks, Nebius, Novita und Together AI – aber welche Provider für ein bestimmtes Modell verfügbar sind, unterscheidet sich von Modell zu Modell.
Ein Modell entspricht mehreren Anbietern, und die Bedingungen der einzelnen Anbieter ändern sich in Echtzeit. „An wen geht diese Anfrage?“ wird damit zu einer Frage, die fortlaufend entschieden werden muss – und genau daraus entsteht das Multi-Provider-Routing.
Was intelligentes Routing wirklich entscheidet
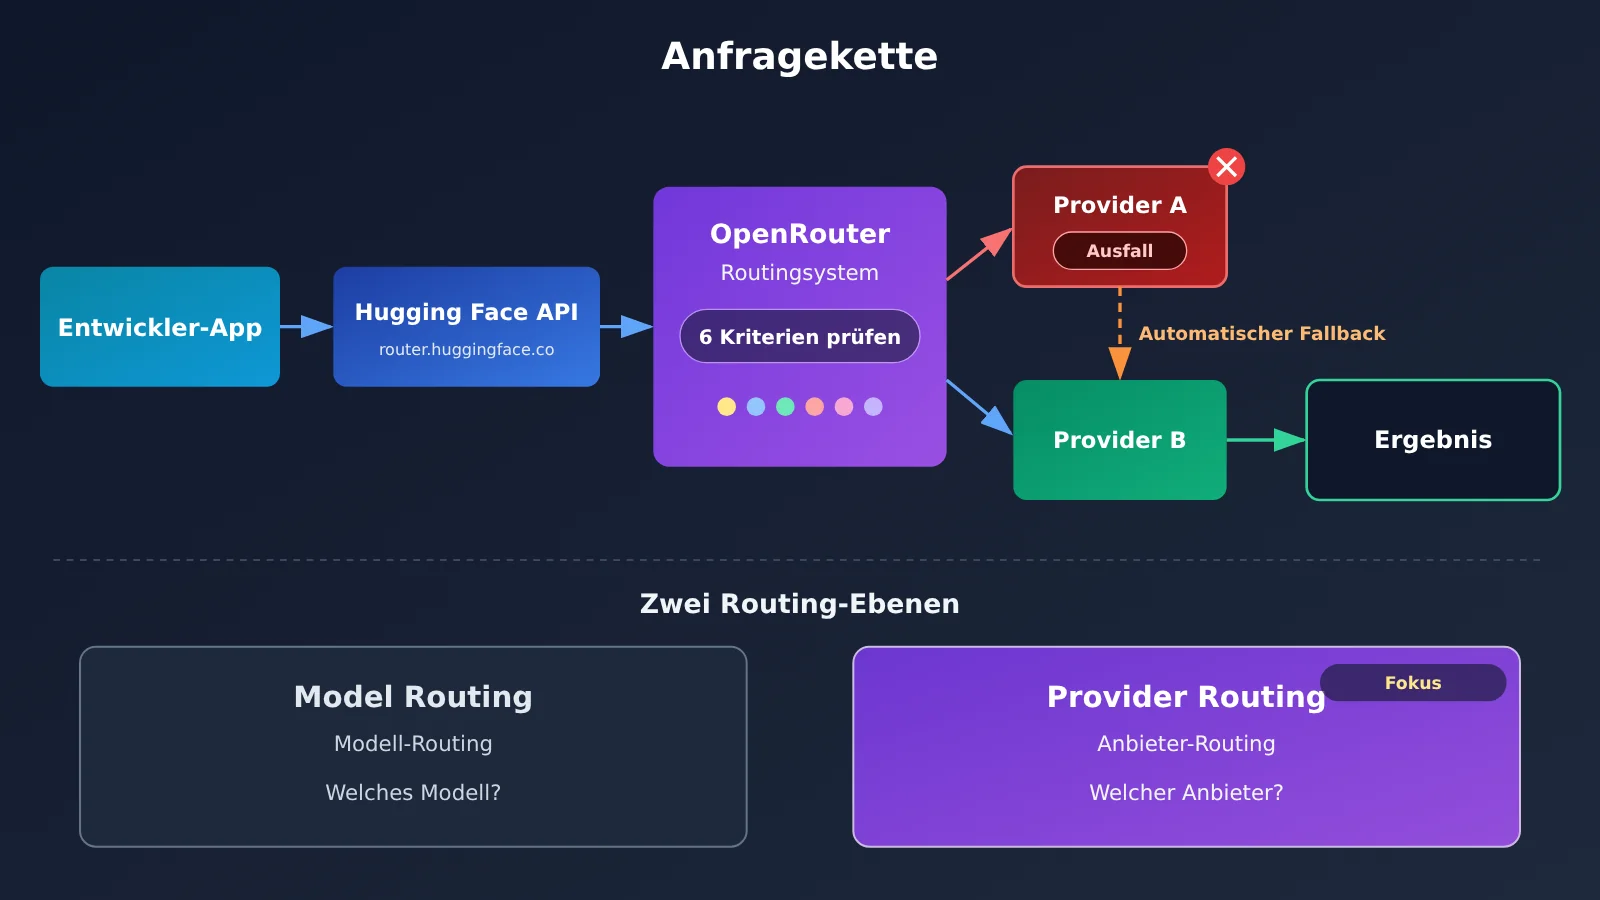
Zuerst müssen wir zwei Begriffe auseinanderhalten, die leicht verwechselt werden. Model Routing (Modell-Routing) entscheidet, welches Modell eine Antwort erzeugt – einfache Fragen gehen etwa an ein kleines Modell, komplexe an ein großes. Provider Routing (Anbieter-Routing) setzt voraus, dass das Modell bereits feststeht, und entscheidet, welcher Anbieter die Inferenz ausführt. Die in diesem Artikel besprochene Kooperation zwischen OpenRouter und Hugging Face gehört zum zweiten Fall: Das Modell gibt der Entwickler vor, die Routing-Schicht wählt nur den Anbieter aus und tauscht das Modell nicht gegen ein anderes.
Nach der Kooperation sieht die Kette einer Sprachmodell-Anfrage so aus: Entwickler-Anwendung oder Coding-Agent → Hugging-Face-API (router.huggingface.co) → OpenRouter-Routingsystem → Inferenz bei einem Anbieter → Ergebnis zurück. OpenRouter übernimmt hier das Anfrage-Routing und die Anbieterauswahl, führt aber nicht die Inferenz für alle Modelle aus. Nutzer verwenden weiterhin ihr Hugging-Face-Token und rechnen über ihr Hugging-Face-Konto oder das ihrer Organisation ab. Hugging Face erklärt, keinen Aufschlag auf die Inferenzpreise der Anbieter zu erheben.
Bei der Steuerung bietet Hugging Face drei Ebenen:
- Standardmäßiges automatisches Routing: Der offizielle Client verwendet
provider="auto", das System wählt den Anbieter anhand von Preis, Geschwindigkeit und Zuverlässigkeit. - Anbieter festlegen: Zum Beispiel
provider="together"oder das Suffix:novitaan der Modell-ID – die Anfrage geht dann fest an diesen Anbieter. - Strategie-Routing: Die OpenAI-kompatible Schnittstelle unterstützt die Suffixe
:cheapest(Preis priorisiert) und:fastest(Durchsatz priorisiert).
Zu beachten ist, dass :fastest den Durchsatz optimiert und nicht „schnell“ in jeder Bedeutung des Wortes. TTFT, Generierungsgeschwindigkeit und Gesamtzeit einer Anfrage sind drei verschiedene Kennzahlen. Bei kurzen Antworten von nur ein oder zwei Sätzen wirkt sich die Latenz bis zum ersten Token meist stärker auf das gefühlte Tempo aus als der Durchsatz.
| Vergleichspunkt | Bisheriges Hugging-Face-Routing | Neues OpenRouter-Routing |
|---|---|---|
| Routingsystem | Selbst betriebener Router von Hugging Face | OpenRouter |
| Anbieterauswahl | Bisheriger Auswahlmechanismus | Bewertung in Echtzeit |
| Preisgrundlage | Bisherige Preisstrategie | Tatsächlich geltender Preis |
| Geschwindigkeitsfaktoren | Bisheriger Performance-Mechanismus | TTFT und Durchsatz fließen ein |
| Einzelfehler | Möglicherweise direkte Fehlerrückgabe | Erneuter Versuch bei einem anderen Anbieter innerhalb derselben Anfrage möglich |
| Sitzungs-Cache | Bisherige Strategie | Anbieter kann pro Sitzung beibehalten werden |
| Nutzer-Anmeldedaten | Hugging Face Token | Weiterhin Hugging Face Token |
Welche Kennzahlen ein taugliches Routing-System für mehrere Anbieter berücksichtigen sollte
OpenRouter hat am 28. Oktober 2026 eine neue Generation des Provider-Routing-Algorithmus vorgestellt. Das alte Standard-Routing orientierte sich stark am Listenpreis für Input-Token, sodass günstige Anbieter leichter mehr Traffic erhielten. Der neue Algorithmus kombiniert die folgenden sechs Signalkategorien zu laufenden Routing-Kosten (Routing Cost). Ziel ist es, die Gesamtkosten einer erfolgreichen, nutzbaren Antwort beim ersten Versuch zu optimieren – statt nur den niedrigsten Stückpreis anzustreben.
① Effective Price (effektiver Preis) – Damit wird das Problem gelöst, dass ein niedriger Listenpreis nicht automatisch eine niedrigere Rechnung bedeutet. Die Kennzahl kombiniert die drei Preisarten für ungecachte Eingaben, gecachte Eingaben und Ausgaben und berücksichtigt dabei das tatsächliche Verhältnis von Eingabe zu Ausgabe in der Anfrage sowie die Cache-Trefferquote des Anbieters. OpenRouter nennt als Beispiel: 40,000 ungecachte Input-Token ($2/M) ergeben $0.080, 60,000 gecachte Input-Token ($0.50/M) ergeben $0.030, 4,000 Output-Token ($8/M) ergeben $0.032, zusammen also $0.142. In Agenten-Szenarien ist der Anteil gecachter Eingaben oft hoch. Vergleicht man nur die Input-Listenpreise, kann man leicht den falschen Anbieter wählen.
② TTFT (Latenz bis zum ersten Token) – Damit wird die Frage beantwortet, wie lange Nutzer auf eine erste Reaktion warten müssen. Chat-Oberflächen und mehrstufige Tool-Aufrufe von Agenten sind davon am stärksten betroffen, weil bei jeder Runde zuerst auf das erste Token gewartet werden muss.
③ Throughput (Durchsatz) – Diese Kennzahl misst die Geschwindigkeit nach Beginn der Generierung. Der neue Algorithmus betrachtet den Generierungsdurchsatz über die gesamte Antwort hinweg und nicht nur kurzzeitige Spitzenwerte. Aufgaben mit hohem Ausgabevolumen wie Langtextgenerierung und Codevervollständigung werden vor allem davon beeinflusst.
④ Rate Limits (Ratenlimits) – Hier liegt der Fokus vor allem auf HTTP-429-Fehlern; damit wird das Problem unzureichender Anbieterkapazität adressiert. Antwortet ein Anbieter häufig mit 429, deutet das auf knappe Rechenkapazität hin, und das Routing weist ihm weniger Traffic zu.
⑤ Reliability (Zuverlässigkeit) – Diese Kennzahl misst die Häufigkeit fehlgeschlagener Anfragen. Liegt die Fehlerrate eines Anbieters deutlich über der anderer Anbieter desselben Modells, reduziert das System die ihm zugewiesene Last und pausiert den Traffic bei Bedarf, bis sich die Lage wieder erholt hat.
⑥ Quality (Antwortqualität) – Damit wird das Problem adressiert, dass dasselbe Modell bei unterschiedlichen Deployments unterschiedlich abschneiden kann. Nach der aktuellen öffentlichen Beschreibung betreffen die Qualitätssignale vor allem die Frage, ob Tool-Aufrufe korrekt zurückgegeben werden und ob die Struktur den Anforderungen entspricht. Anbieter mit fehlerhaftem Tool-Aufruf-Format oder deutlich zurückbleibender Benchmark-Genauigkeit verlieren an Wettbewerbsfähigkeit.
Neben diesen sechs Kennzahlen berücksichtigt die Routing-Dokumentation von OpenRouter selbst auch Datenrichtlinien als einschränkende Bedingung. Zum Beispiel kann data_collection: "deny" Anbieter ausschließen, die die Anforderungen an die Datenerhebung nicht erfüllen; zdr: true verlangt Endpunkte mit Zero Data Retention. Die Sicherheitsdokumentation von Hugging Face gibt an, dass keine Nutzeranfragedaten zum Trainieren von Modellen verwendet werden, beim Routing weder Anfrageinhalte noch Antworten gespeichert werden und Debug-Logs höchstens 30 Tage aufbewahrt werden und keine Nutzerdaten oder Token enthalten. Zugleich weist sie Entwickler darauf hin, dass sie die tatsächlichen Datensicherheitsrichtlinien des jeweiligen Anbieters weiterhin prüfen müssen. Eine Plattformzusage ersetzt nicht die Datenverarbeitungsvereinbarung jedes einzelnen Anbieters.
OpenRouter-Routing: Experimentdaten und Kompromisse
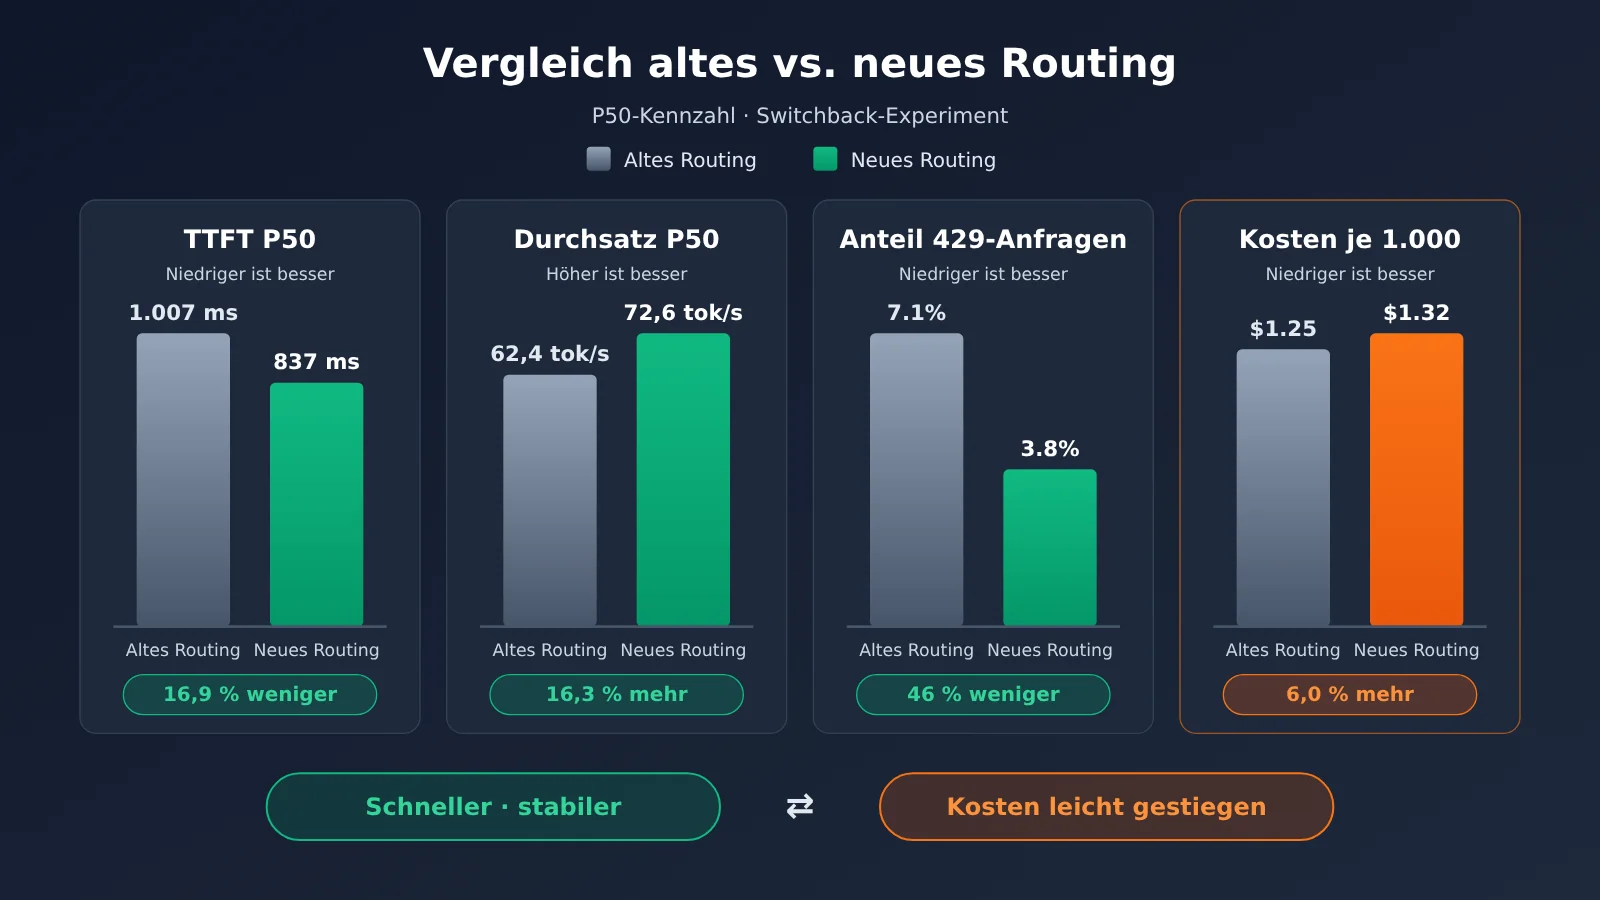
Bevor der neue Algorithmus live ging, führte OpenRouter im Oktober 2026 ein einwöchiges Switchback-Wechselexperiment durch. Jeder Tag wurde in 3-Stunden-Blöcke aufgeteilt; passende Blöcke nutzten jeweils den alten bzw. den neuen Algorithmus. Nach jedem Wechsel blieb eine einstündige Aufwärmphase, die nicht in die Messung einging. Insgesamt umfasste das Experiment über 24 Millionen Anfragen und 103 Milliarden Eingabe-Token. Man entschied sich für ein Wechselexperiment statt für eine zufällige Nutzergruppierung, weil der neue Algorithmus den Traffic von überlasteten Anbietern wegleitet – davon würde auch die Gruppe mit dem alten Algorithmus profitieren, was den Vergleich verfälschen würde.
| Metrik | Altes Routing | Neues Routing | Veränderung |
|---|---|---|---|
| TTFT P50 | 1.007 ms | 837 ms | 16,9 % niedriger |
| TTFT P95 | 4.601 ms | 3.733 ms | 18,9 % niedriger |
| Durchsatz P50 | 62,4 tok/s | 72,6 tok/s | 16,3 % höher |
| Dauer einer vollständigen Anfrage P50 | 4,00 s | 3,24 s | 19,0 % niedriger |
| Anfragen mit mindestens einem 429 | 7,1 % | 3,8 % | 46 % weniger |
| Anfragen mit erforderlichem Retry | 10,4 % | 6,9 % | 34 % weniger |
| Kosten pro tausend Anfragen | 1,25 $ | 1,32 $ | 6,0 % höher |
| Kosten pro Million Token | 0,301 $ | 0,324 $ | 7,3 % höher |
Diese Daten zeigen den zentralen Kompromiss des neuen Routings: Rund 6 % höhere Kosten pro tausend Anfragen werden gegen niedrigere Latenz und weniger Kapazitätsfehler eingetauscht. Einige Einschränkungen sollten erwähnt werden: Das Experiment wurde von OpenRouter selbst entworfen und veröffentlicht, ohne Prüfung durch Dritte; die Stichprobe besteht aus einer Gruppe repräsentativer offener Modelle und steht nicht für alle Modelle und Anbieter; die Ergebnisse sind Gesamtstatistiken und bedeuten nicht, dass jede einzelne Anfrage eine Verbesserung von 16,9 % erzielt. Diese Daten stammen zudem aus einem OpenRouter-Experiment vor der Zusammenarbeit und sind keine unabhängige Messung nach dem Start bei Hugging Face.
💡 Testempfehlung: Die Routing-Experimente liefern nur Gesamtstatistiken – die eigene Leistung im konkreten Geschäftsfall muss man selbst messen. Wenn Sie in derselben Codebasis mehrere gängige Modelle hinsichtlich Ausgabequalität und Kosten vergleichen möchten, können Sie über APIYI apiyi.com mit einem einzigen Key einheitlich aufrufen. Klären Sie zuerst die Auswahl auf Modellebene und kümmern Sie sich dann um die Optimierung auf Anbieterebene.
Wie das System bei einem Provider-Ausfall umschaltet
Der typische Ablauf eines automatischen Failovers sieht so aus: Das Routing wählt Provider A aus. Ist A in Ordnung, wird das Ergebnis direkt zurückgegeben. Meldet A einen Fehler oder gibt es Kapazitätsprobleme, versucht das System innerhalb derselben Anfrage Provider B. Ist B erfolgreich, wird das Ergebnis zurückgegeben. In den Experimenten sank der Anteil der Anfragen, die eine Wiederholung benötigten, von 10.4 % auf 6.9 %; die Zeit, die pro Anfrage für fehlgeschlagene Versuche anfiel, sank von 349 ms auf 242 ms. Das zeigt: Gutes Routing muss nicht nur wiederholen können, sondern möglichst schon von Anfang an Provider mit schlechtem Zustand meiden.
Automatisches Fallback und die Festlegung auf einen bestimmten Provider sind zwei Optionen, die sich gegenseitig einschränken. Das Standard-Routing erlaubt Wechsel und bietet höhere Verfügbarkeit. Die Festlegung auf einen Provider bindet die Anfrage an einen Anbieter, erfüllt Anforderungen an die Anbieterzulassung, nimmt aber die Ausweichmöglichkeit für Ausfälle. Die eigene API von OpenRouter bietet die Kombination aus only (nur der angegebene Provider ist erlaubt) und allow_fallbacks: false (kein automatisches Fallback). Damit kann eine Anfrage direkt fehlschlagen, wenn kein konformer Provider verfügbar ist, statt an einen anderen Anbieter weitergeleitet zu werden. Wichtig zur Abgrenzung: Das sind Parameter der vollständigen OpenRouter-API und nicht so zu verstehen, dass die Hugging-Face-Schnittstelle sie bereits vollständig anbietet. Die entsprechende Funktion auf Hugging-Face-Seite besteht darin, einen Provider festzulegen und Provider in den Einstellungen zu deaktivieren.
Auch Wiederholungen haben Kosten und sind nicht unbegrenzt möglich:
- Zeitkosten: Jeder fehlgeschlagene Versuch verlängert die Gesamtdauer und wirkt sich spürbar auf Echtzeit-Interaktionen aus.
- Streaming-Ausgabe: Eine Streaming-Antwort, die bereits mit der Ausgabe begonnen hat, lässt sich nicht nahtlos bei einem anderen Anbieter fortsetzen.
- Doppelte Seiteneffekte: Wenn ein Tool-Aufruf beim ersten Versuch bereits eine externe Aktion ausgelöst hat, kann eine Wiederholung zu doppelter Ausführung führen; die Anwendung muss selbst für Idempotenz sorgen.
- Cache-Verlust: Prompt-Caching ist meist an einen konkreten Anbieter gebunden; ein Anbieterwechsel kann den Nutzen des Caches zunichtemachen. Hugging Face stellt dafür den Request-Header
X-HF-Session-Idbereit, mit dem eine stabile UUID dafür sorgt, dass dieselbe Sitzung möglichst beim Provider mit dem Cache bleibt. - Kein verfügbarer Anbieter: Wenn ein Modell nur einen Provider hat oder andere Provider die aktuellen Parameter nicht unterstützen, gibt es nichts, wohin gewechselt werden könnte. Probleme wie unzureichendes Kontingent, fehlende Token-Berechtigungen, ungültige Anfragen oder ein überschrittenes Kontextlimit kann das Routing ebenfalls nicht lösen.
Änderungen bei der Abrechnung von Hugging Face und eigenen Keys
Diese Kooperation bringt eine Breaking Change mit sich: Beim Aufruf von Sprachmodellen über Hugging Face lässt sich der selbst konfigurierte Provider-API-Schlüssel nicht mehr verwenden. Alle entsprechenden Anfragen werden über OpenRouter geroutet, die Kosten werden dem Hugging-Face-Konto bzw. dem Organisationskonto belastet. Für Aufgaben zur Bild- und Videogenerierung bleiben eigene Keys weiterhin nutzbar; im Detail gilt die offizielle Erklärung.
Wenn Entwickler weiterhin das selbst erworbene Kontingent des Anbieters nutzen möchten, können sie direkt die API dieses Anbieters aufrufen oder auf ein eigenes OpenRouter-Konto umsteigen. Nach der aktuellen BYOK-Dokumentation von OpenRouter gilt: Das kostenlose BYOK-Kontingent wird an den äquivalenten Kosten des Inferenzkatalogs gemessen; Pay-as-you-go-Konten erhalten 25.000 US-Dollar pro Monat, Enterprise ein individuelles Kontingent. Darüber hinausgehende Beträge werden mit 5 % der äquivalenten Inferenzkosten berechnet und von den Plattform-Credits abgezogen. Die 25.000 sind hier in US-Dollar gemessene Inferenzkosten, nicht die Anzahl der Anfragen. Außerdem können beim Zurückfallen auf geteilte Kapazität Plattform-Credits verbraucht werden. Der direkte Anschluss an OpenRouter ist ein separates Konto- und Abrechnungsverhältnis; bestehende Keys werden nicht automatisch dorthin migriert.
In der aktuellen Preisgestaltungsdokumentation von Hugging Face haben Free-Nutzer kein festes monatliches Guthaben, PRO-Nutzer erhalten 2 $ pro Monat, Team und Enterprise 2 $ pro Sitz und Monat. Diese Guthaben sind allgemeine Compute Credits, die für Inference Providers, Inference Endpoints, Spaces und weitere Dienste angerechnet werden können. Noch ein erwähnenswerter Punkt: Die unveränderte Preisgestaltung der Provider bedeutet nicht, dass die Kosten pro Anfrage gleich bleiben, denn das Routing kann einen etwas teureren, aber schnelleren und stabileren Anbieter wählen.
Wie Entwickler mithilfe der Verzeichnis-API selbst mehrere Anbieter vergleichen
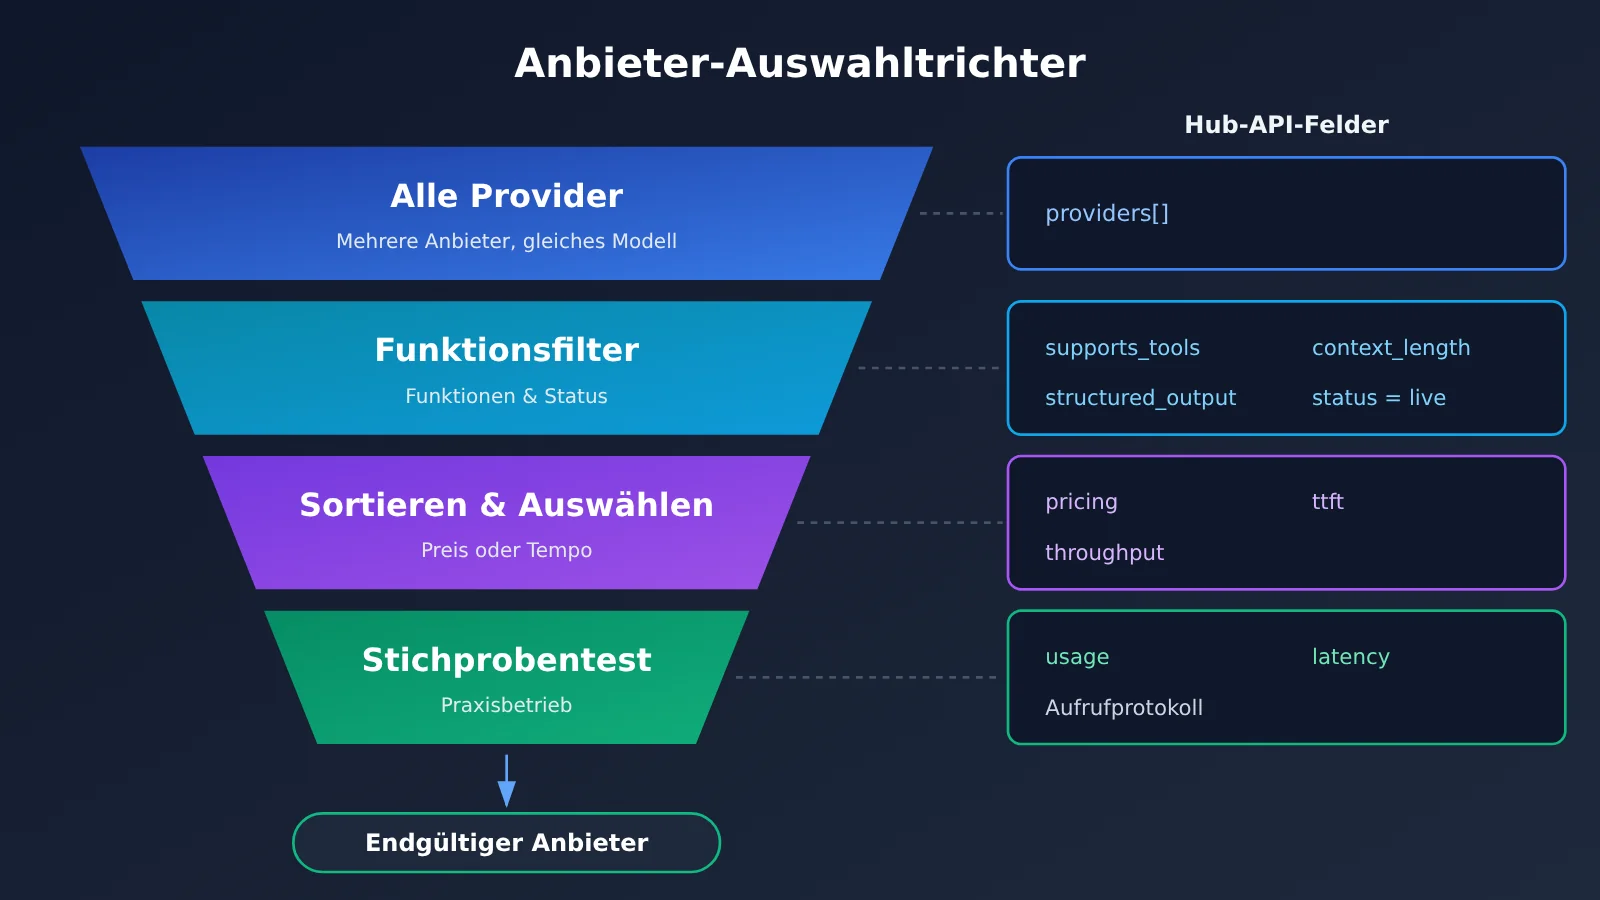
Hugging Face bietet eine abfragbare Schnittstelle für den Modellkatalog. Das ist ein öffentliches Fenster, über das das Routing-System seine Entscheidungsgrundlage erhält:
- Alle Modelle:
GET https://router.huggingface.co/v1/models - Einzelnes Modell:
GET https://router.huggingface.co/v1/models/deepseek-ai/DeepSeek-V4-Pro
| Feld | Bedeutung | Rolle bei der Auswahl |
|---|---|---|
| provider | Der Anbieter, der die Inferenz tatsächlich bereitstellt | Kandidatenliste festlegen |
| status | Aktueller Status, z. B. live, error | Nicht verfügbare Anbieter ausschließen |
| context_length | Die vom Anbieter unterstützte Kontextlänge | Anforderungen an lange Kontexte filtern |
| pricing.input / pricing.output | USD-Preis pro Million Input- bzw. Output-Token | Kostensortierung |
| supports_tools | Ob Tool-Aufrufe unterstützt werden | Harte Bedingung für Agent-Szenarien |
| supports_structured_output | Ob strukturierte Ausgaben unterstützt werden | Harte Bedingung für JSON-Ausgaben |
| first_token_latency_ms | Latenz bis zum ersten Token bei der letzten Verifizierungsprüfung | Sortierung für interaktive Anwendungen |
| throughput | Generierungsgeschwindigkeit bei der letzten Verifizierungsprüfung | Sortierung für lange Ausgaben |
| is_free / is_model_author | Vorübergehende Gratisaktion / ob es sich um den Modellherausgeber handelt | Ergänzende Referenz |
Diese Felder werden nicht von jedem Provider vollständig bereitgestellt, und die Leistungsdaten stammen aus der letzten Verifizierungsprüfung – sie entsprechen nicht deiner eigenen End-to-End-Leistung in Echtzeit. Sinnvoll ist das Vorgehen „erst filtern, dann sortieren“: Zuerst filterst du mit den Funktionsfeldern inkompatible Anbieter heraus, dann sortierst du nach Kosten oder Geschwindigkeit. Das folgende Beispiel zeigt diese Vorgehensweise; die zurückgegebene Struktur richtest du bitte nach der offiziellen Hub-API-Dokumentation.
import os
import requests

HF_TOKEN = os.environ["HF_TOKEN"]
MODEL = "deepseek-ai/DeepSeek-V4.1-Flash"

resp = requests.get(
    f"https://router.huggingface.co/v1/models/{MODEL}",
    headers={"Authorization": f"Bearer {HF_TOKEN}"},
    timeout=30,
)
data = resp.json()
providers = data.get("providers", [])  # Konkrete Struktur siehe offizielle Dokumentation

# Schritt 1: Funktionsfilter (Agent benötigt Tool-Aufrufe + strukturierte Ausgaben + 64K-Kontext)
candidates = [
    p for p in providers
    if p.get("status") == "live"
    and p.get("supports_tools")
    and p.get("supports_structured_output")
    and (p.get("context_length") or 0) >= 64_000
]

# Schritt 2: Nach Stückpreis der Ausgabe sortieren, fehlende Felder ans Ende
candidates.sort(key=lambda p: (p.get("pricing") or {}).get("output", float("inf")))

for p in candidates:
    print(p["provider"], p.get("pricing"), p.get("first_token_latency_ms"), p.get("throughput"))
Nachdem du die Kandidaten herausgefiltert hast, musst du sie noch mit echten Geschäftsanfragen testen. Die Katalog-Metadaten sagen aus, was der Anbieter „zu unterstützen angibt“, und können nicht die Genauigkeit, die Erfolgsrate der Tool-Aufrufe und die Endabschlussrate deiner eigenen Aufgabe ersetzen.
Bevor du auf Anbieterebene feinjustierst, musst du normalerweise erst festlegen, welches Modell du verwendest. Der folgende Code zeigt, wie du über dieselbe OpenAI-kompatible Schnittstelle die Antworten mehrerer Modelle im Stapel vergleichst. Ersetze die Modell-IDs durch die tatsächlichen Namen aus der Modellliste der Plattform:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI einheitliche Schnittstelle, mit einem Key mehrere Modelle aufrufen
)

prompt = "用 JSON 返回:{\"city\": 城市名, \"reason\": 一句话理由},推荐一个适合冬季旅行的城市"

for model in ["model-id-a", "model-id-b", "model-id-c"]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, resp.usage.total_tokens, resp.choices[0].message.content)
🚀 Schnellstart: Neue Nutzer können bei APIYI apiyi.com ein kostenloses Testkontingent abrufen und mit dem obigen Code eine eigene Stichprobe aus ihrem Geschäftsbereich durchlaufen lassen. Das Backend-Protokoll zeichnet bei jeder Anfrage das verwendete Modell, den Token-Verbrauch und die Kosten auf – so lässt sich der tatsächliche Aufwand pro Aufgabe ermitteln, statt nur auf den Listenpreis zu schauen.
Wichtig zu erwähnen: Der einheitliche Zugang plus das Aufrufprotokoll und die von Hugging Face angezeigten Echtzeit-Leistungsdaten auf Provider-Ebene sind Funktionen auf unterschiedlichen Ebenen. Ersteres löst das Problem „anschließen und sauber abrechnen“, Letzteres zeigt zusätzlich den dynamischen Status der zugrunde liegenden Anbieter. Beides lässt sich gut kombinieren.
Mehrere API-Anbieter und intelligentes Routing: Analyse und Einschätzung
Wo der nächste Wettbewerb der API-Aggregationsplattformen liegt
Schlüsselt man die Fähigkeiten von OpenRouter auf, lassen sich drei Ebenen unterscheiden: Modell-Aggregation beantwortet die Frage, „wie man auf verschiedene Modelle zugreift“, Provider-Aggregation beantwortet, „wer dasselbe Modell inferenziert“, und dynamisches Routing beantwortet, „wem diese eine Anfrage übergeben werden soll“. Die einheitliche Schnittstelle hat das Anbindungsproblem weitgehend gelöst; diese Kooperation zeigt, dass die zweite und dritte Ebene gerade zu neuen Wettbewerbspunkten werden. Grundlage dieser Einschätzung ist: Hugging Face entscheidet sich, einen eigenen Router aufzugeben und stattdessen externe Routing-Fähigkeiten zu nutzen; OpenRouter veröffentlicht zudem den Routing-Algorithmus separat und belegt dessen Wert mit Produktionsexperimenten.
Es ist absehbar, dass Kostenoptimierung, Stabilität und Daten-Governance zu neuen Vergleichsdimensionen für API-Plattformen werden. Das Folgende sind Vorhersagen, die noch der späteren Überprüfung harren: Routing-Transparenz wird zunehmend wichtiger, Entwickler werden wissen wollen, bei welchem Anbieter die Anfrage gelandet ist, warum dieser gewählt wurde und wie viel dafür bezahlt wurde; Datenrichtlinien-Beschränkungen könnten sich von einer Zusatzoption zu einer Eintrittshürde beim Unternehmenseinkauf entwickeln.
Allerdings ist Routing kein Allheilmittel. Die Experimentdaten zeigen: Schneller und stabiler geht mit höheren Stückkosten einher. Die in der Kooperationsankündigung genannten Folgepläne (etwa die Verknüpfung der Konten beider Seiten und die Einbeziehung weiterer Aufgaben in das OpenRouter-Routing) sind ebenfalls noch bloße Pläne. Routing kann auch die Qualitäts-, Lizenz- und Geschäftstauglichkeitsprobleme des Modells selbst nicht lösen.
Bedarf an Open-Weight-Modellen und Kostendruck bei Unternehmen
Die Nachfragedaten stützen die Einschätzung, dass das Routing zwischen Anbietern immer wichtiger wird. Laut OpenRouter-Statistiken lag der Anteil der Modelle mit offenen Gewichten am 28. September 2026 bei 71.7 %, wenn man das wöchentliche Token-Volumen der Top-50-Modelle zugrunde legt. Das ist eine plattforminterne statistische Abgrenzung von OpenRouter und lässt sich nicht als globaler Marktanteil verallgemeinern. Je stärker Open-Weight-Modelle genutzt werden, desto häufiger gibt es mehrere Anbieter für dasselbe Modell – und desto deutlicher wird der Wert des Routings.
Auf der Kostenseite hat Capgemini im September 2026 500 CXOs großer Unternehmen befragt; 59 % gaben an, dass die KI-Ausgaben deutlich über den Erwartungen liegen. Bei den betroffenen Unternehmen lag die durchschnittliche Überschreitung bei 24 %. Diese Zahlen repräsentieren nur die Stichprobe der Umfrage. Zusammen mit dem Ergebnis des Routing-Experiments, dass mehr Geschwindigkeit mit höheren Kosten einhergeht, sind sie aber ein Hinweis für Unternehmen: Automatisches Routing strebt standardmäßig ein gutes Gesamterlebnis an, nicht unbedingt die niedrigste Rechnung. Kostenempfindliche Geschäftsbereiche sollten bewusst eine preisorientierte Strategie wählen oder eine Preisobergrenze festlegen und die Ergebnisse laufend anhand der Aufrufprotokolle überprüfen.
Wie unterschiedliche Rollen abwägen sollten
- Einzelentwickler und kleine Teams: Standardmäßiges automatisches Routing spart bereits die Arbeit für eine selbst aufgebaute Ausfallsicherheit. Der Schwerpunkt sollte darauf liegen, mit echten Stichproben zu prüfen, ob Tool-Aufrufe und JSON-Ausgaben stabil sind. Ein kostengünstiger Weg ist, zunächst über eine einheitliche Schnittstelle wie APIYI apiyi.com das Modell festzulegen und erst bei Bedarf auf Anbieterebene zu optimieren.
- Interaktive Produkte: Der Fokus sollte auf TTFT P95 liegen, nicht auf dem Durchsatz.
:fastestverbessert nicht unbedingt die Wahrnehmung kurzer Antworten. - Lange Ausgaben und Batch-Verarbeitung: Durchsatz und effektiver Preis sind wichtiger. Eine preisorientierte Strategie kann sinnvoll sein; nutzen Sie Sitzungsaffinität, um Cache-Vorteile zu sichern.
- Unternehmen und Plattformteams: Erfassen Sie zuerst, welche Anwendungen von eigenen Provider-Keys abhängen und welche Geschäftsbereiche zwingend an einen festen Anbieter gebunden sein müssen. Danach entscheiden Sie, ob Fallback erlaubt, Anbieter eingeschränkt oder direkt an Anbieter angebunden werden soll. Datenverarbeitungsvereinbarungen müssen mit jedem Anbieter einzeln geprüft werden.
Welche Strategie auch immer gewählt wird, am Ende läuft es auf dieselbe Aktion hinaus: mit den eigenen Anfragen und den eigenen Metriken einen Testlauf durchführen. Bei APIYI apiyi.com mit dem kostenlosen Kontingent einen kleinen Vergleich durchzuführen oder mit der Hugging-Face-Katalog-API zunächst Kandidatenanbieter herauszufiltern, sind beides sehr günstige Ausgangspunkte. Die 16.9 % aus dem offiziellen Experiment sind ein Gesamtdurchschnitt; wie viel in Ihrem konkreten Fall möglich ist, wissen Sie erst, wenn Sie es getestet haben.
The proof of the pudding is in the eating. (Ob der Pudding gut ist, zeigt sich erst beim Essen; die tatsächliche Wirkung muss in der Praxis überprüft werden.)


