作者注:按终端与代码仓、办公长任务、多模态长文档、成本四类任务,对比 Qwen4-Max 与 Claude Opus 5.5 的跑分、规格、缓存价与迁移成本,并给出可执行的选型建议。
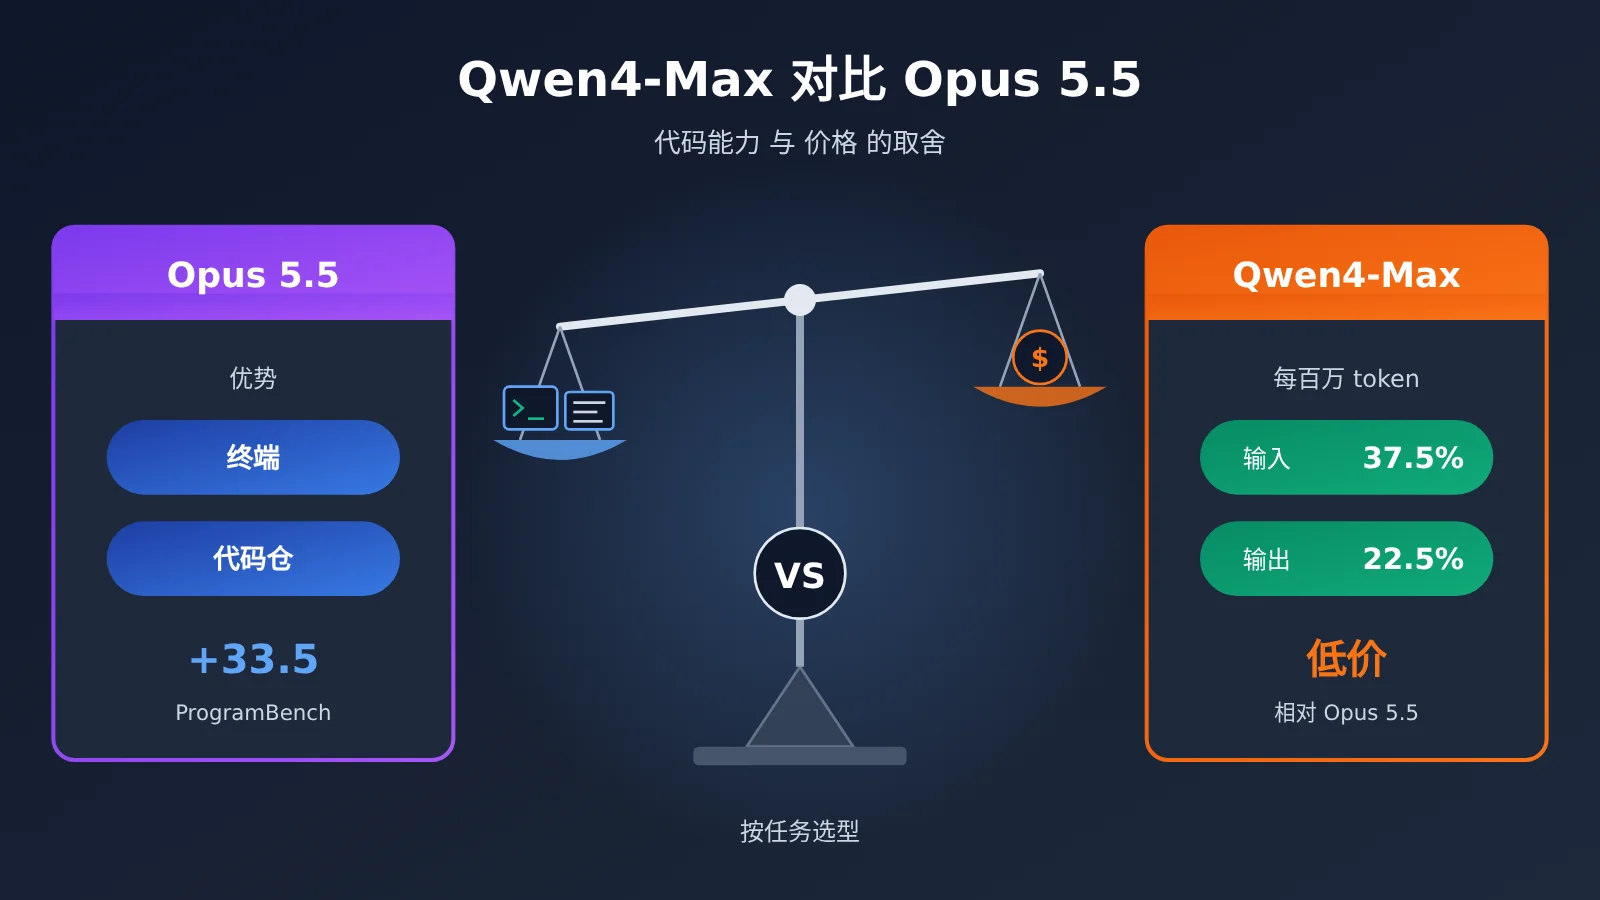
如果你的团队已经把 Claude Opus 5.5 当主力,在 Claude Code 或自建 agent 里跑生产,那么 2026-11-16 发布的 Qwen4-Max 会让你重新算一遍账:它的输入价只有 Opus 5.5 的 37.5%,输出价只有 22.5%。
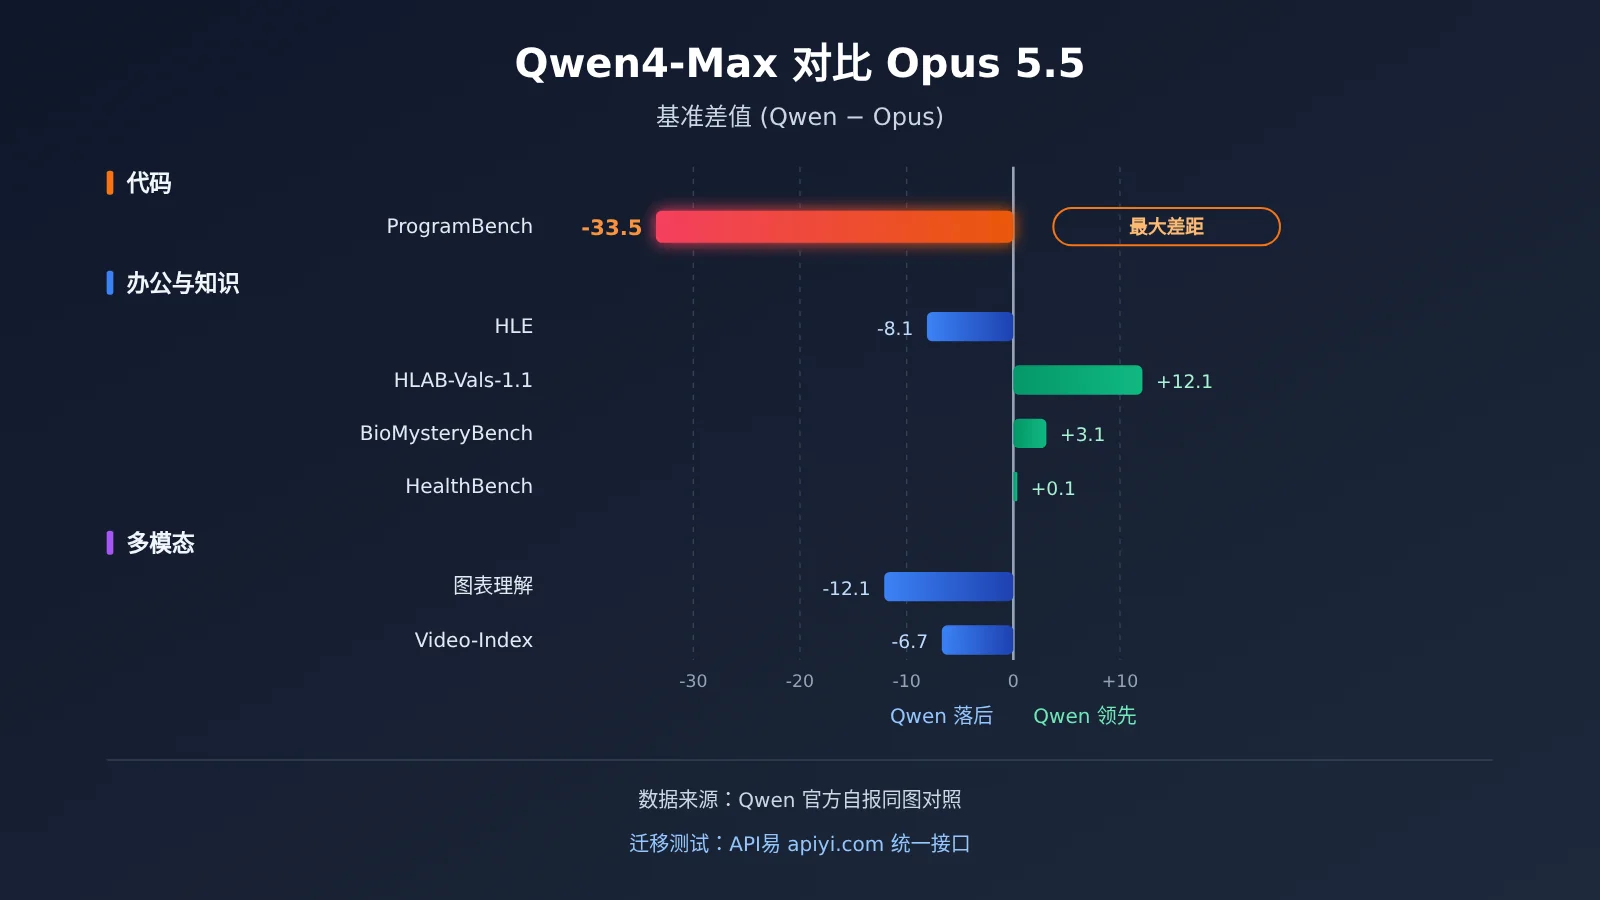
先给结论,不做折中:终端操作与仓库级重构继续留在 Opus 5.5,Qwen4-Max 在 ProgramBench 上落后 33.5 分,这是本次对比里最大的短板;工作流自动化、成本敏感的高并发 agent、超长输出的文档任务,可以优先试 Qwen4-Max;办公交付物和图表、视频理解类任务,Opus 5.5 仍有明显优势。
核心价值:读完本文,你会拿到一张按任务划分的取舍表,并清楚两边缓存价、默认推理档位和实际迁移步骤的差别。
Qwen4-Max 对比 Opus 5.5 核心差异速览
先说清楚数据口径。本文的数字来自三套互不相同的来源,不能混着读:
- Qwen 官方自报的同图对照:阿里在发布博客里用同一张图列出 Qwen4-Max 与 Opus 5.5 的分数,属于厂商自跑,并非第三方复现。
- 公开榜快照,2026-11-14:arena.ai 的 Code Arena WebDev 榜,基于公开投票。
- Anthropic 文档原文:Opus 5.5 的规格与价格取自 Anthropic 官方模型页和价目页。
下面这张表是全文的结论浓缩,后续章节逐项展开依据。
| 任务类型 | 推荐 | 关键依据 | 一句话理由 |
|---|---|---|---|
| 终端操作与仓库级重构 | Opus 5.5 | Terminal-Bench 低 11.1,ProgramBench 低 33.5 | 多步命令链和整仓改动是 Qwen4-Max 最弱的一环 |
| 单个 issue 修复类编码 | Qwen4-Max 可试 | DeepSWE 高 1.5 | 局部修复能力已持平,价格优势明显 |
| 办公交付物与长任务 | Opus 5.5 | AA-Briefcase 低 115 Elo,JobBench 低 6.9 | 文档、报告类产出质量差距可感知 |
| 工作流自动化 | Qwen4-Max | AutomationBench 高 3.0 | 规则清晰的流程任务不输,成本更低 |
| 图表与视频理解 | Opus 5.5 | Chartography 低 12.1,Video-Index 低 6.7 | 多模态读图仍有差距 |
| 成本敏感高并发 agent | Qwen4-Max | 输入 37.5%、输出 22.5% | 量大时账单差距会成倍放大 |
Qwen4-Max 与 Opus 5.5 规格差异
规格层面,两者上下文都是 1M,但输出与推理默认值差别很大:
- Qwen4-Max:2.4T 主干、71B 激活,外加 328B N-gram Embedding;原生视觉;最大输出 393K,最大思维链 262K;默认
reasoning_effort为 high。 - Opus 5.5(Anthropic 文档原文):定位长跑 agentic 编码与知识工作;最大输出 128K;默认 effort 为 medium;知识截止 2026 年 6 月。
默认档位这一条很容易被忽略。Qwen4-Max 默认就开到 high,思考过程会按输出计费,所以真实账单的差距通常小于标价上的 22.5%,后文价格部分会给出一个公开榜上的旁证。
Qwen4-Max 对比 Opus 5.5:终端与代码仓任务
这是现有 Opus 用户最关心的部分,也是 Qwen4-Max 最需要谨慎对待的部分。
| 基准(Qwen 官方自报的同图对照) | Qwen4-Max | Opus 5.5 | 差值 |
|---|---|---|---|
| DeepSWE v1.1 | 75.7 | 74.2 | Qwen 高 1.5 |
| CodeArena WebDev Elo | 1750 | 1816 | Qwen 低 66 |
| Terminal-Bench 4.0 | 48.5 | 59.6 | Qwen 低 11.1 |
| ProgramBench | 31.5 | 65.0 | Qwen 低 33.5 |
逐项看它们对实际工作意味着什么:
- DeepSWE 高 1.5:在给定 issue 做定点修复这类任务上,Qwen4-Max 已经和 Opus 5.5 站在同一水平,1.5 分基本可视为持平,适合拿来跑低风险的 bug 修复队列。
- WebDev 低 66 Elo:前端页面生成的整体观感,用户投票更偏向 Opus,做落地页、组件原型时差距能被肉眼看到。
- Terminal-Bench 低 11.1:在终端里连续执行命令、读输出、再决定下一步的能力明显落后,这正是 Claude Code 类工作流的日常,换过去意味着更多中途卡住或需要人工接管。
- ProgramBench 低 33.5:这是本次对比中最大的短板,分数接近腰斩。从零构建或大范围改写程序的任务,Qwen4-Max 目前不适合作为 Opus 5.5 的替身。
公开榜也给出了相近的位置信息。按公开榜快照,2026-11-14,arena.ai Code Arena WebDev 共 1,007,405 票、159 个模型:Opus 5.5(Max)1816 分排第 2,Qwen4-Max(xHigh)1750 分排第 6,但后者只有 1,814 票,仍标记为 Preliminary,排名还会波动。
代码仓场景的 Qwen4-Max 使用建议
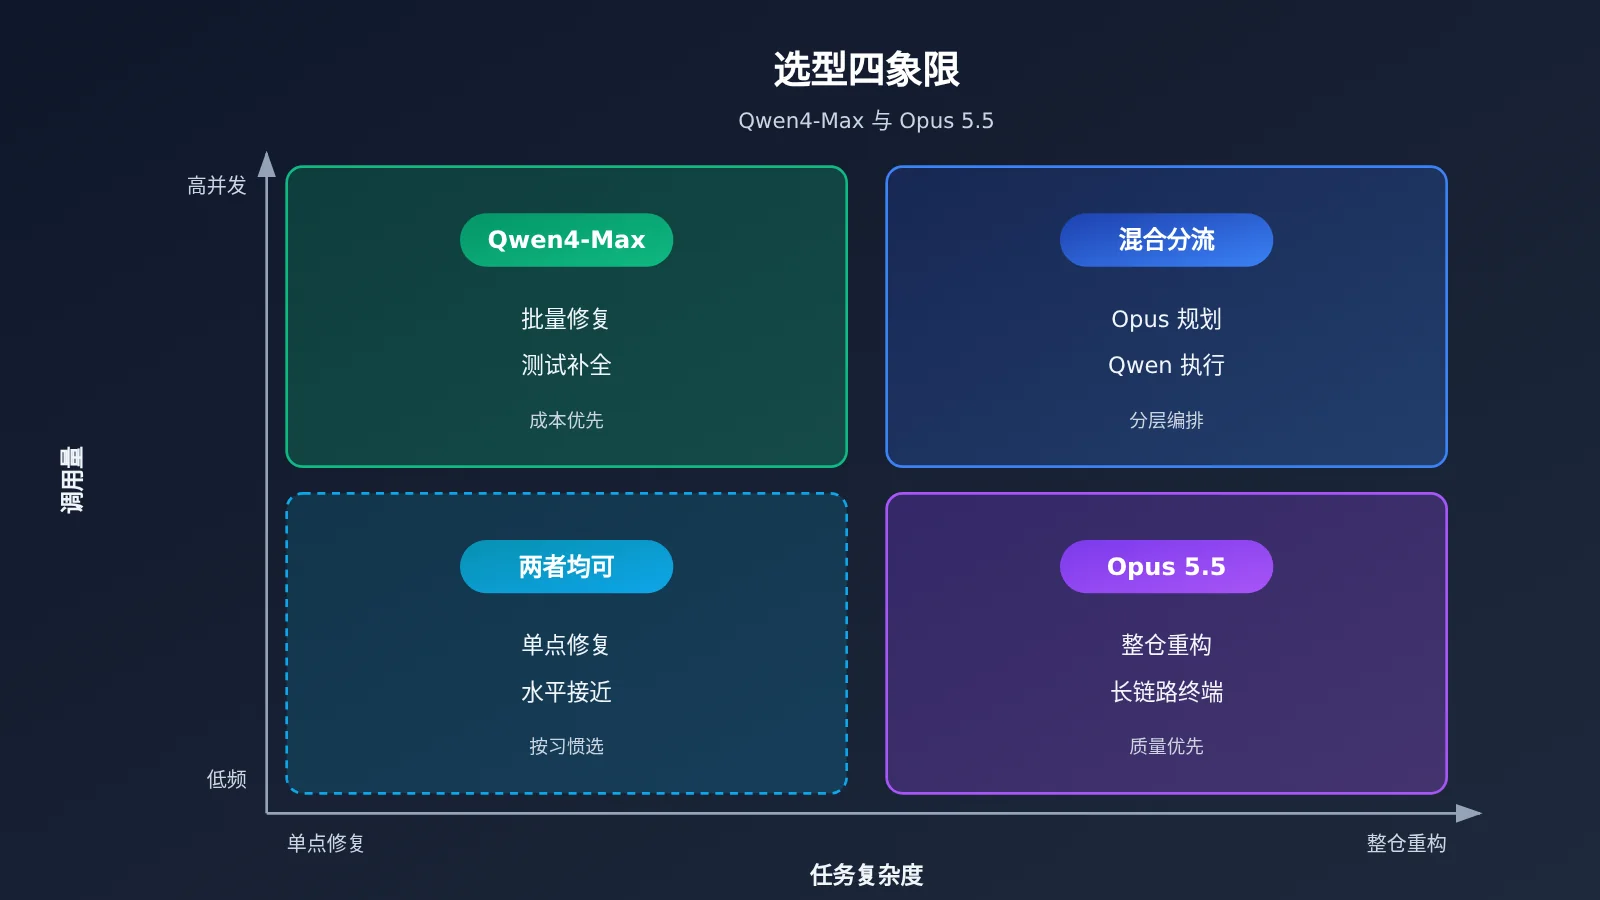
如果你的 agent 主要做整仓重构、跨模块迁移或长链路终端操作,建议保持 Opus 5.5 不动。如果你把任务拆成了“规划 + 执行”两层,可以考虑让 Opus 5.5 负责规划与关键改动,把单文件修复、测试补全这类局部任务分流给 Qwen4-Max。
Qwen4-Max 对比 Opus 5.5:办公与长任务
办公类和长时 agent 任务的结果比编码更分化,有输有赢。
| 基准(Qwen 官方自报的同图对照) | Qwen4-Max | Opus 5.5 | 差值 |
|---|---|---|---|
| AA-Briefcase v1.1 Elo | 1686 | 1801 | Qwen 低 115 |
| JobBench | 68.5 | 75.4 | Qwen 低 6.9 |
| APEX-Agents v1.1 | 72.1 | 73.5 | Qwen 低 1.4 |
| AutomationBench-AA | 72.5 | 69.5 | Qwen 高 3.0 |
| AgentArena Net Improvement | 7.5 | 18.2 | Qwen 低 10.7 |
对应到实际工作:
- AA-Briefcase 低 115 Elo:报告、方案、表格这类办公交付物,Opus 5.5 的成品更容易被直接采用,这是办公场景里差距最大的一项。
- JobBench 低 6.9:贴近真实岗位任务的综合完成度仍是 Opus 领先,意味着端到端交付时返工率可能更高。
- APEX-Agents 低 1.4:通用 agent 任务基本打平,换模型不会带来明显体验落差。
- AutomationBench 高 3.0:规则明确的流程自动化反而是 Qwen4-Max 的强项,表单处理、数据搬运、定时任务编排适合优先迁移。
- AgentArena Net Improvement 低 10.7:在多轮迭代中持续改进的能力较弱,长任务越往后越依赖模型自我修正时,Opus 更稳。
另外,Qwen4-Max 的 393K 最大输出和 262K 思维链上限,对需要一次性产出超长内容的长任务是实打实的优势,Opus 5.5 的最大输出是 128K。
Qwen4-Max 对比 Opus 5.5:中文与多模态长文档
需要先说明:参考资料中的对照图没有中文专项基准,所以本文无法用数字回答“中文谁更好”。如果中文质量是你的核心指标,请用自己的样本集做 A/B,不要依赖任何二手结论。
能用数字说话的是多模态和知识类任务:
| 基准(Qwen 官方自报的同图对照) | Qwen4-Max | Opus 5.5 | 差值 |
|---|---|---|---|
| Chartography | 54.2 | 66.3 | Qwen 低 12.1 |
| Video-Index | 68.1 | 74.8 | Qwen 低 6.7 |
| Humanity’s Last Exam | 51.7 | 59.8 | Qwen 低 8.1 |
| HLAB-Vals-1.1 | 21.3 | 9.2 | Qwen 高 12.1 |
| BioMysteryBench | 85.0 | 81.9 | Qwen 高 3.1 |
| HealthBench Professional | 60.0 | 59.9 | 基本打平 |
这些数字的实际含义是:读图表、抽取财报和研报中的图形数据,Qwen4-Max 落后 12.1 分,容易漏读或误读坐标;视频理解也有 6.7 分差距;高难度综合知识题(HLE)落后 8.1 分。反过来,生物推理和医疗专业问答上 Qwen4-Max 持平甚至略占优,HLAB-Vals 领先 12.1 分。
所以长文档任务要再细分:以文字为主、需要超长输出的文档,Qwen4-Max 可以作为首选候选;图表密集的 PDF 或含视频素材的资料,仍建议走 Opus 5.5。
Qwen4-Max 与 Opus 5.5 每百万 token 价格与缓存账
价格是 Qwen4-Max 最有力的论据。下表单位均为每 1M tokens,官方价分别取自 QwenCloud 与 Anthropic 文档原文,API易 现价取自 docs.apiyi.com/models,取数日期 2026-11-16。
| 计费项($/1M tokens) | Qwen4-Max 官方 | Opus 5.5 官方 | Qwen/Opus | API易 qwen3.8-max |
API易 claude-opus-5-5 |
|---|---|---|---|---|---|
| 输入 | 1.5 | 4 | 37.5% | 1.65 | 4 |
| 输出 | 4.5 | 20 | 22.5% | 4.95 | 20 |
| 缓存读 | 0.075 | 0.20 | 37.5% | 0.20625 | 0.2 |
| 5 分钟缓存写 | 1.875 | 5 | 37.5% | 以平台列表为准 | 以平台列表为准 |
| 1 小时缓存写 | 3 | 8 | 37.5% | 以平台列表为准 | 以平台列表为准 |
两家的缓存结构其实完全同构:缓存读都是输入价的 5%,5 分钟缓存写都是输入价的 1.25 倍,1 小时缓存写都是 2 倍。这意味着你在 Opus 上设计的缓存策略可以原样搬到 Qwen4-Max,账单按 37.5% 等比缩小。需要留意的是,API易 上 qwen3.8-max 的缓存读是输入价的 12.5%,比例与 Qwen4-Max 官方不同,迁移时请按实际型号单独核算。
一笔具体的账
以 1 亿输入 + 1000 万输出为例:Qwen4-Max 约 $195(150 + 45),Opus 5.5 约 $600(400 + 200)。差额约 $405,相当于 Opus 账单的三分之二。
但标价不等于实付。公开榜快照,2026-11-14 给出了单任务成本 P50:Opus 5.5(Max)$8.99,Qwen4-Max(xHigh)$4.18,比值约 46%,而不是标价的 22.5%。原因在于两者推理档位不同,Qwen4-Max 默认就是 high,思维链按输出计费,token 消耗更多。实际省多少,取决于你的任务长度和推理档位,建议用自己的流量回放测一遍。
💰 成本建议:对比账单时,请同时记录输入、输出、缓存读写四项 token 量,而不只看单价。通过 API易 apiyi.com 在同一账户下并行调用两个模型,用量明细在一处就能对齐。
Qwen4-Max 对比 Opus 5.5 决策建议与迁移三步
把一条 agent 从 Opus 换到 Qwen,绕不开查型号、对价格、对协议三步。
第一步:查型号。 截至 2026-11-16,Qwen4-Max 在 API易 暂未上架,我们会尽快上架这个模型;当前 Qwen 侧最强的是 qwen3.8-max。Opus 侧可用 claude-opus-5-5,另有 claude-opus-5-5-thinking,价格相同。型号与价格以 apiyi.com 文档中心的型号列表为准,上架前可以先用 qwen3.8-max 搭好灰度链路。
第二步:对价格。 按上一节的方法,用一周真实流量估算两边成本,并把推理档位对齐后再比。API易 apiyi.com 的型号列表把输入、输出、缓存读都列在同一张总表里,适合直接拿来做核算表的数据源。
第三步:对协议。 API易 提供 OpenAI 兼容接口,端点为 https://api.apiyi.com/v1,切换模型时只需改 model 字段,例如从 claude-opus-5-5 改为 qwen3.8-max,api_key 与 base_url 保持不变。需要额外检查两处:推理强度参数在 Qwen 侧叫 reasoning_effort,默认 high,若想与 Opus 的 medium 对齐要显式设置;缓存的写入时长与命中规则也要按目标模型重新验证。
🎯 灰度建议:不要整条 agent 一次切换。推荐把同一个
base_url(https://api.apiyi.com/v1)下的流量按任务类型分流,先迁移自动化和局部修复任务,终端与整仓任务保留在 Opus 5.5,观察两周返工率再决定下一步。
常见问题 FAQ
Q1:Qwen4-Max 和 Opus 5.5 谁更适合做 coding agent?
看任务粒度。单 issue 修复(DeepSWE)两者持平,可用 Qwen4-Max 省钱;终端多步操作和整仓构建(Terminal-Bench、ProgramBench)Opus 5.5 明显领先,尤其 ProgramBench 差 33.5 分,这类任务继续用 Opus。
Q2:阿里图上的分数和 arena 榜能放在一起比吗?
不能当同一口径。前者是 Qwen 官方自报的同图对照,后者是公开榜快照(2026-11-14),而且 Qwen4-Max 在榜上仅 1,814 票、仍为 Preliminary。两者可以互相参照趋势,但不应合并成一个“领先多少分”的结论。
Q3:换到 Qwen4-Max 实际能省多少钱?
标价上输入省 62.5%、输出省 77.5%。但公开榜上的单任务成本 P50 比值约为 46%,因为 Qwen4-Max 默认推理档位更高、思考 token 更多。实际节省需要用你的流量回放测算。
Q4:现在能在 API易 上调用 Qwen4-Max 吗?
暂时不能,Qwen4-Max 尚未上架,我们会尽快上架。当前可用 `qwen3.8-max` 搭建迁移链路,上架后只需改 `model` 字段。型号状态请以 API易 apiyi.com 的型号列表为准。
Q5:从 Opus 切到 Qwen 需要改多少代码?
若已使用 OpenAI 兼容接口,`base_url` 指向 `https://api.apiyi.com/v1` 后只需改模型名,并按需设置 `reasoning_effort`。注册 API易 apiyi.com 后可用新用户免费测试额度先跑一轮对比。
Q6:Qwen4-Max 有哪些已知限制?
终端与整仓编码是最大短板,图表理解落后 12.1 分,办公交付物 Elo 低 115,多轮自我改进能力也偏弱。此外,所有对照分数均为厂商自报,尚无第三方复现,中文能力也缺少专项基准数据。
Qwen4-Max 对比 Opus 5.5 核心要点 Key Takeaways
- 最大短板:ProgramBench 低 33.5 分,整仓构建与重构继续用 Opus 5.5。
- 持平区域:DeepSWE、APEX-Agents、HealthBench 基本打平,可优先分流。
- Qwen 优势:工作流自动化、生物医疗推理、393K 超长输出。
- 价格结构:输入 37.5%、输出 22.5%,缓存四项比例与 Opus 完全同构。
- 实付差距:默认推理档位为 high,公开榜单任务成本比约 46%。
- 迁移路径:在 API易 apiyi.com 用同一端点先跑
qwen3.8-max,Qwen4-Max 上架后直接替换。
总结
Qwen4-Max 对比 Opus 5.5 的选择可以归纳为三点:
- 终端与代码仓留给 Opus 5.5:Terminal-Bench 与 ProgramBench 的差距,价格差覆盖不了返工成本。
- 自动化与高并发交给 Qwen4-Max:能力持平或领先的任务上,三到五成的账单就是纯收益。
- 按任务分流,而不是整体替换:同一套接口、按任务类型路由,是风险最低的迁移方式。
建议先在 API易 apiyi.com 用 qwen3.8-max 与 claude-opus-5-5 跑一轮自己的任务回放,Qwen4-Max 上架后再做最终切换决策。
📚 参考资料
- Qwen4-Max 发布博客:模型规格与官方自报基准对照
- 链接:
qwen.ai/blog?id=qwen4-max -
说明:包含架构参数、上下文与输出上限及同图对照分数
-
Anthropic 模型概览:Opus 5.5 规格说明
- 链接:
platform.claude.com/docs/en/about-claude/models/overview.md -
说明:上下文、最大输出、默认 effort 与知识截止
-
Anthropic 价格页:Opus 5.5 输入输出与缓存价
- 链接:
platform.claude.com/docs/en/about-claude/pricing.md -
说明:含 5 分钟与 1 小时缓存写价格
-
API易 型号列表:平台现价与可用型号
- 链接:
docs.apiyi.com/models - 说明:迁移前核对型号上架状态与价格
作者:APIYI 技术团队
技术交流:欢迎在 API易 apiyi.com 网站首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心