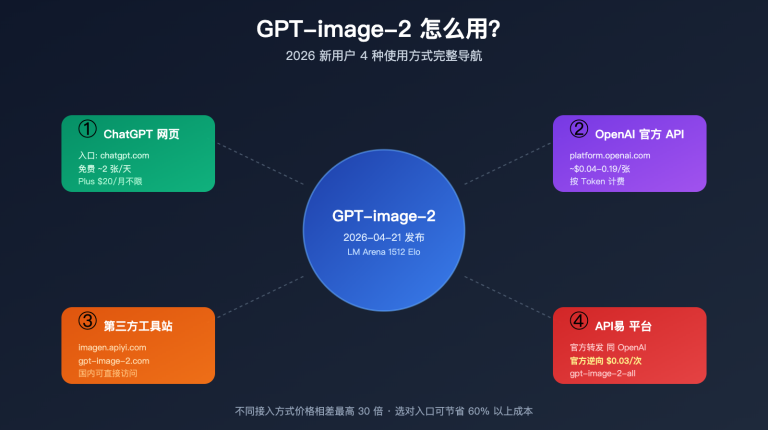
先说结论。在 API易 上批量出图,常规任务默认用 gpt-image-2.5-all,走 Default 分组,按次令牌或按量令牌都能调用,标价 0.025 美元/张。需要锁定固定尺寸或 4K 时,把模型名换成 gpt-image-2.5-vip 这类 -vip 型号,标价 0.03 美元/张。不过 -all 专页自己写明,-vip 的 4K 有稳定性波动,不作为 4K 首选。需要官方 quality 档位、蒙版局部重绘或任意合法尺寸时走官转,新项目优先看 gpt-image-2.6-flare(速度优先)和 gpt-image-2.6-sunburst(编辑与精度优先)。
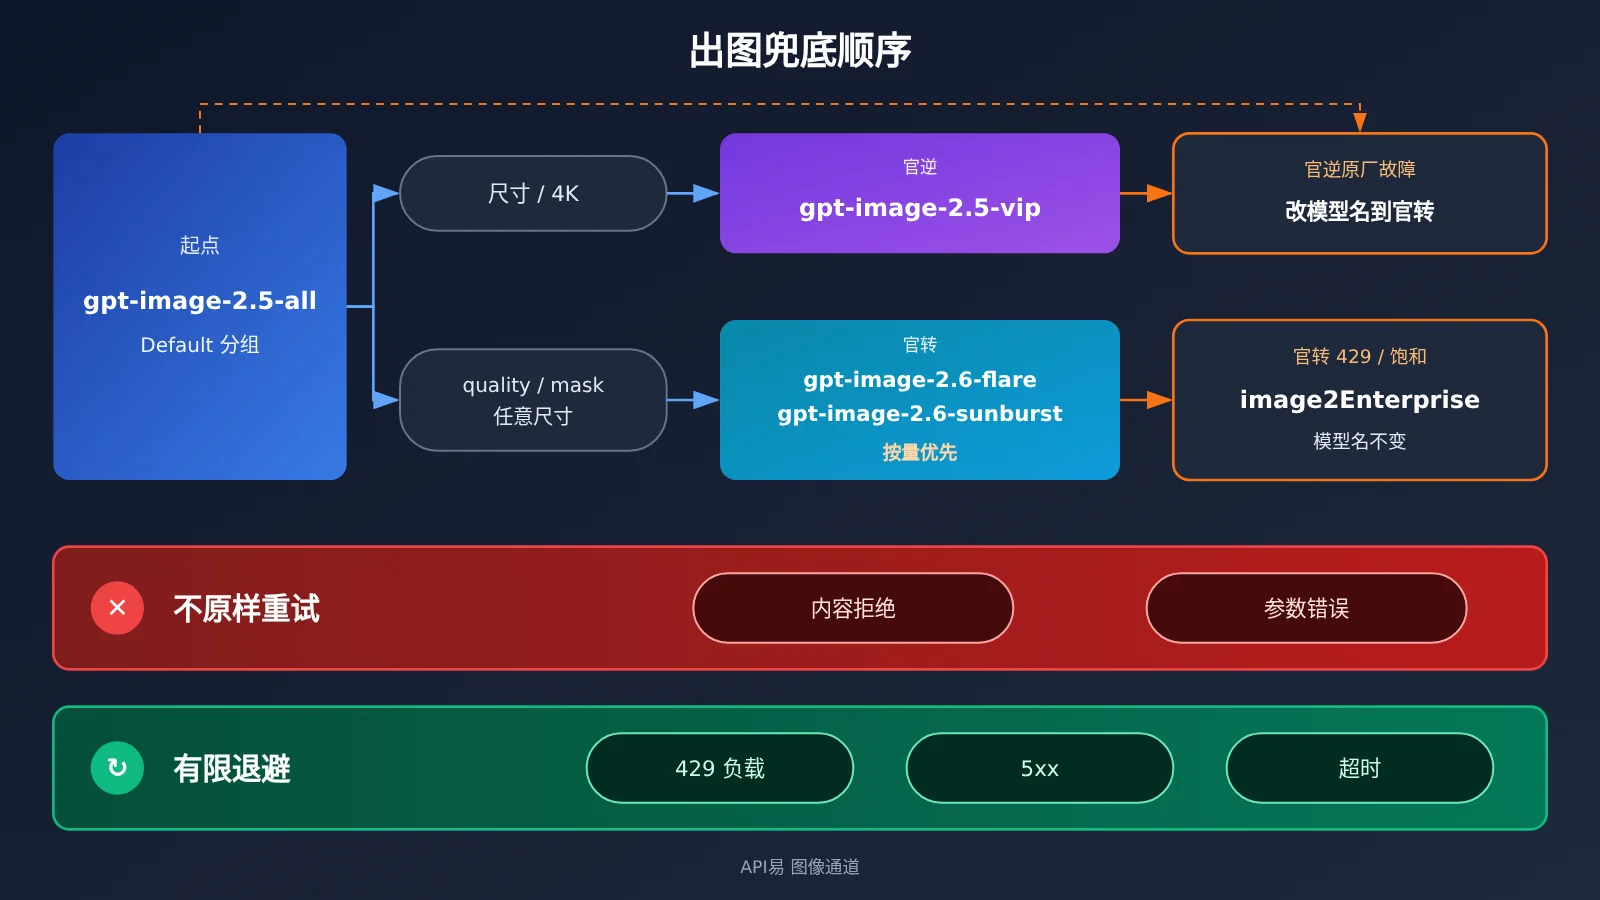
兜底分两种情况。官转在 Default 分组持续报 429 或饱和时,把令牌分组切到 image2Enterprise,模型名不用改。官逆遇到 ChatGPT 网页版或 Adobe 原厂故障时,不要对同一条逆向线路反复退避,应把模型名改成官转型号,并确认令牌是「按量优先」。另外有两类错误不能原样重试:内容安全拒绝和参数错误。还要注意 n 参数,它在 -all 上会按 n 倍扣费,但仍只返回 1 张图。
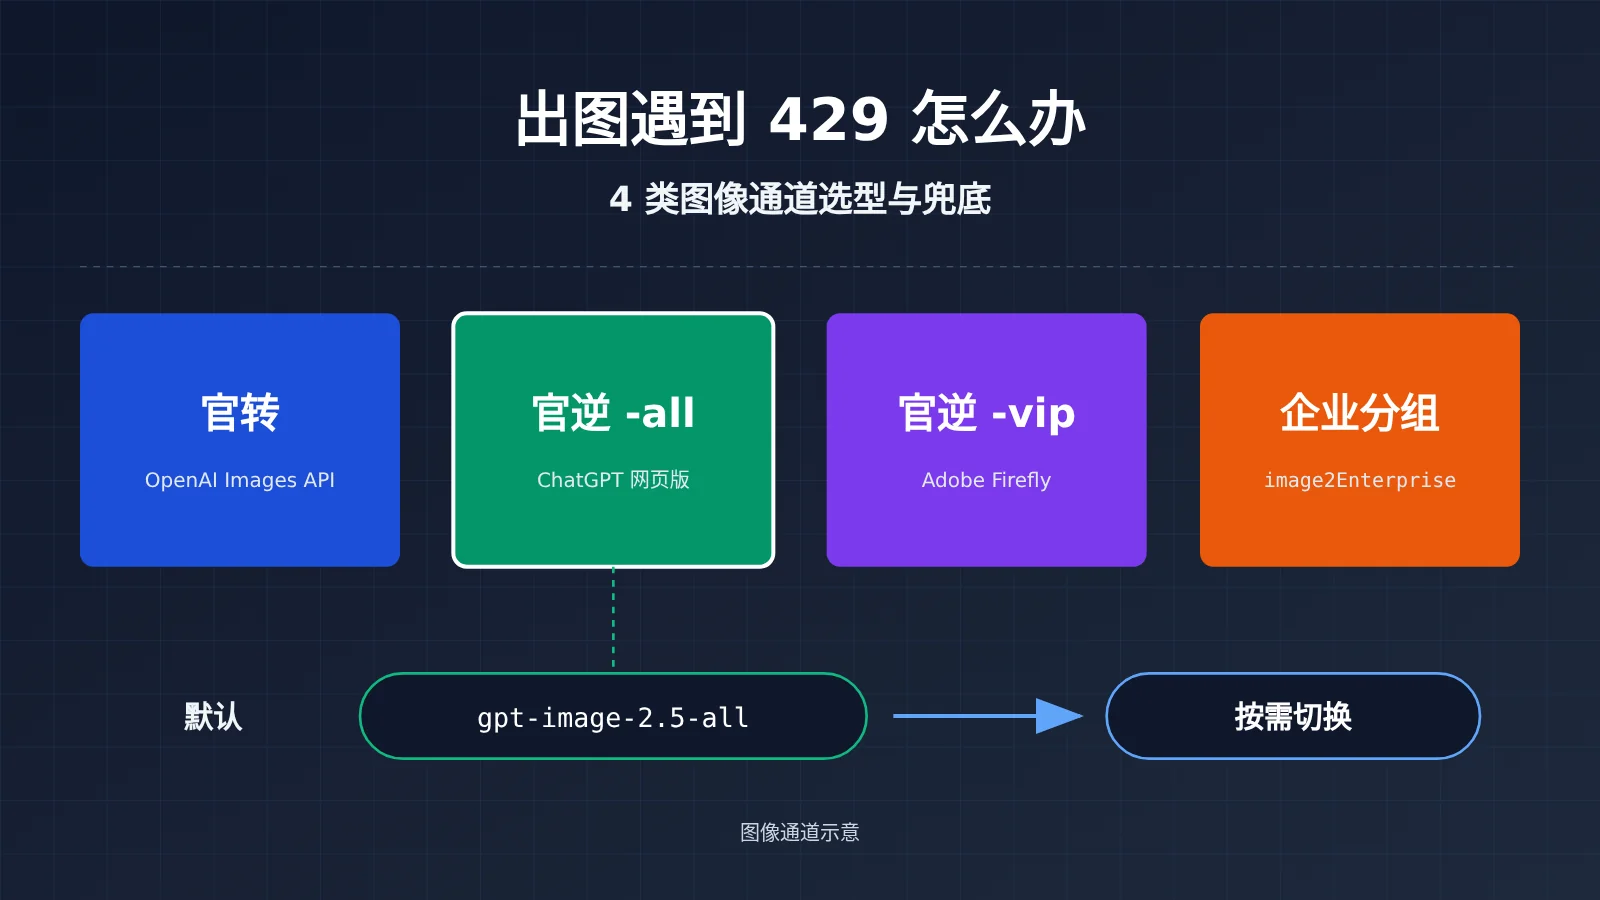
GPT 图像通道的四个名字分别是什么
同一个 GPT 图像模型在列表里会出现几种后缀,它们分别代表上游来源和计费方式。其中「企业分组」不是模型,而是令牌上的一个路由选项。下面按文档用词逐一说明:
- 官转:官方直连 OpenAI Images API,文档写明请求和响应与 OpenAI 官方一致。价格总表里的官转图像型号有
gpt-image-2.6-flare、gpt-image-2.6-sunburst、gpt-image-2.5-flare、gpt-image-2.5-sunburst、两者的日期快照gpt-image-2.5-flare-2026-09-08与gpt-image-2.5-sunburst-2026-09-08,以及上一代gpt-image-2。文档建议文生图优先用 flare,编辑和多图融合优先用 sunburst。生产环境可以锁定日期快照,避免别名指向发生变化。 - 官逆 -all:逆向 ChatGPT 网页版。
gpt-image-2-all和gpt-image-2.5-all同价、行为一致、可以互换。原因是 ChatGPT 网页版已整体升级到 Images 2.5,所以gpt-image-2-all出的也是 2.5 的图。文档建议新项目直接用gpt-image-2.5-all。 - 官逆 -vip:Adobe 官逆线路(Firefly),型号有
gpt-image-2-vip、gpt-image-2.5-flare-vip、gpt-image-2.5-sunburst-vip。别名gpt-image-2.5-vip指向gpt-image-2.5-sunburst-vip。 - 企业分组
image2Enterprise:官转在 OpenAI 上游的企业兜底分组。FAQ 明确说明它不是 Google Vertex,也不是用来缩短出图时间的加速线。它的作用是在默认分组拥塞时提供另一条资源池,但不能保证上游永远可用。
还有一个分组容易被误认为兜底,就是 image2_OSS。它是 1 倍、不加价的分组,用途只有一个:保证返回 URL,不被降级成 base64。它不提升稳定性,适用于 -all 和 -vip。
2.6 目前只有官转版本。2026-11-10 的价格总表和定价接口里,都没有 gpt-image-2.6-all、gpt-image-2.6-vip 或类似名字。型号与价格以平台型号列表为准。
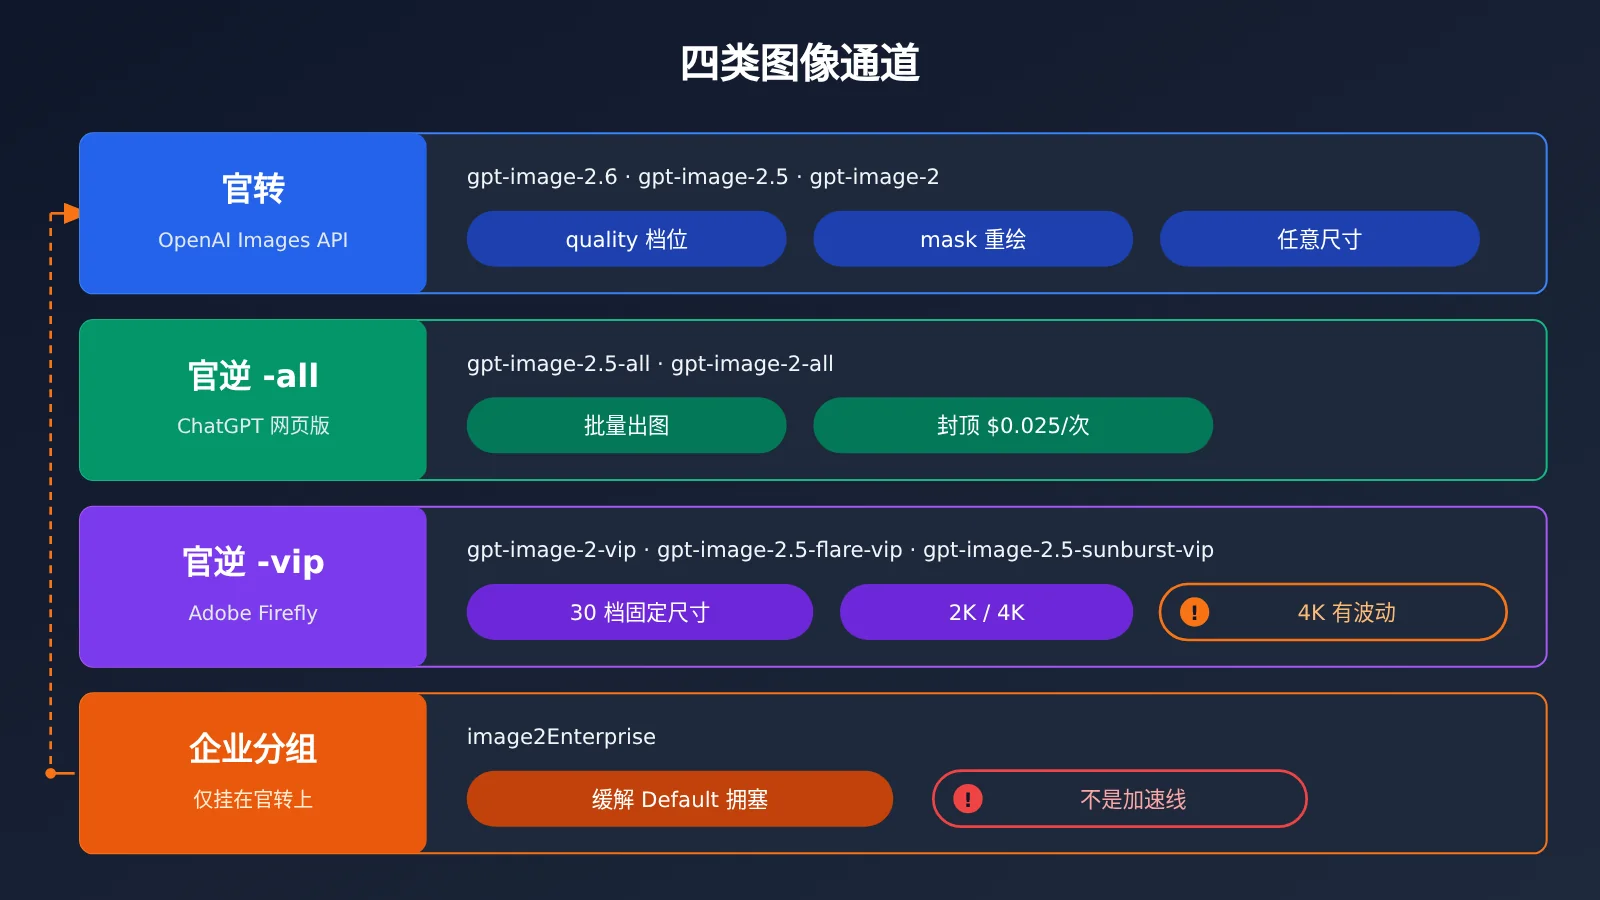
按场景选默认图像通道:价格与能力对照表
选通道时先看三个问题:需不需要官方画质档位、对尺寸要求有多严、成本要不要按张封顶。可以按下面的顺序判断:
- 批量出图、成本按张封顶、尺寸长边在 512 到 1536 之间:用
gpt-image-2.5-all。验收标准:返回图片的实际宽高符合预期,控制台每次扣费等于单价乘以调用次数。 - 需要 30 档里的固定尺寸,或者需要 2K、4K:改用 -vip 型号,并显式传
size。验收标准:以返回图片的实际宽高为准,不能只看请求参数。 - 需要官方
quality、mask局部重绘、透明背景、任意合法尺寸,或要和 OpenAI 字段对齐:走官转。新项目用 2.6,需要锁定行为时用带日期的 2.5 快照。验收标准:请求字段与目标模型的官方参数表一致,不出现 400。
图像通道价格对照表
下表的计费和标价来自价格总表(2026-11-09 更新),全部是折扣前标价。充值加赠 10% 到 20% 后实际扣费会更低,最终以控制台为准。完整型号和价格请查看 docs.apiyi.com/models。
| 型号 | 通道性质 | 计费 | 标价(折扣前) | 可用分组 |
|---|---|---|---|---|
gpt-image-2.6-flare / gpt-image-2.6-sunburst |
官转(2026-11-05 上线) | 按量 | 每百万 tokens:文本输入 5、图片输入 8、输出 30 美元 | Default、image2Enterprise、image2_OSS、SVIP |
gpt-image-2.5-flare / gpt-image-2.5-sunburst 及 2026-09-08 快照 |
官转 | 按量 | 同上,缓存读文本 1.25、图片 2 美元 | Default、image2Enterprise、image2_OSS、SVIP |
gpt-image-2 |
官转(上一代) | 按量 | 同上 | Default、image2Enterprise、image2_OSS、SVIP |
gpt-image-2.5-all / gpt-image-2-all |
官逆 ChatGPT 网页版 | 按次 | 0.025 美元/次 | Default、image2_OSS、SVIP |
gpt-image-2.5-vip 等 4 个 -vip 名字 |
官逆 Adobe Firefly | 按次 | 0.03 美元/次 | Default、image2_OSS、SVIP |
定价接口与价格总表有一处不一致,需要分开看。 定价接口里,gpt-image-2、gpt-image-2.5-flare、gpt-image-2.5-sunburst 的 quota_type 为 1、model_price 为 0.2。而 gpt-image-2.6-flare、gpt-image-2.6-sunburst 和两个 2026-09-08 快照的 quota_type 为 0、model_price 为 0。价格总表则把这些官转型号全部标为按量。本文的标价以价格总表的按量口径为准,不把 0.2 当作按次价。下单前,请在控制台核对该分组的实际折后价。-all 的 0.025 和 -vip 的 0.03 在两处来源一致,可以当作按次标价使用。
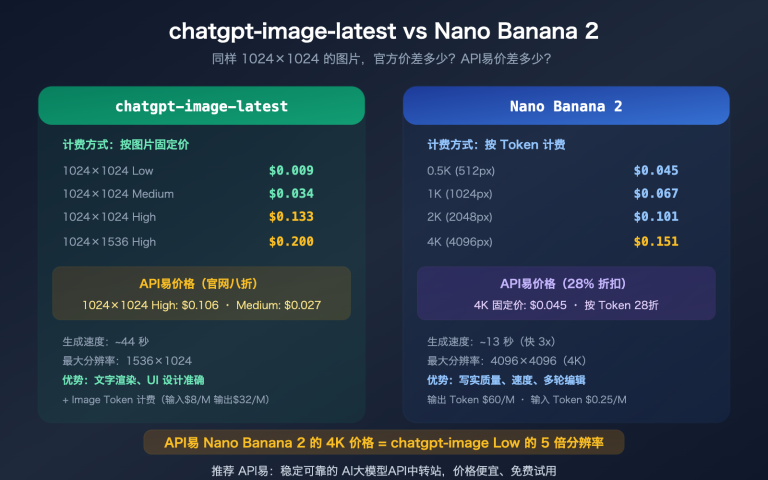
官转每张图的成本取决于输出 tokens。对比页(文档自述)给出的典型区间约为每张 0.03 到 0.2 美元,提示词越长、size 和 quality 越高,成本越高。文档里有一组 2026-09-09 的粗算:1024 方图用 2.5 的 xhigh 约 0.094 美元(3122 output tokens),用 max 约 0.211 美元(7024 output tokens),不含通常不到 0.001 美元的输入。文档的结论是:1K low 草图走官转不一定更贵,中高画质才是官逆 0.025 到 0.03 美元更划算的区间。
还有一个旧价格要提醒。帮助中心 2026-04-25 的一篇旧文把 gpt-image-2-all 写成 0.03 美元/次,那是降价前的数据。-all 在 2026-10-10 降到 0.025 美元,两个 -all 名字同步调整。文档给出的降价原因是:-all 比 -vip 更稳,-vip 受原厂风控影响波动较大,但仍在维护、照常可用。
图像通道能力对照表
| 能力 | 官逆 -all | 官逆 -vip | 官转 |
|---|---|---|---|
size |
专页:长边 512 到 1536 的常见宽高,含非 16 倍数;2K 不列为精确支持 | 30 档(10 种比例 × 1K/2K/4K),仅 images 端点生效 | 任意合法尺寸,边长为 16 的倍数、比例不超过 3:1,预设含 3840×2160 |
quality |
不接受 | 渠道行为、不承诺;2.5 两款 2026-09-10 复测到 max,gpt-image-2-vip 只到 high |
官方承诺档位;xhigh/max 仅限 2.5 两款(对比页) |
n |
不接受,传了照样按 n 倍扣费 | 不支持,单次 1 张 | 支持 |
| 蒙版 | 只做整图重绘 | 只做整图重绘 | 支持 mask 局部重绘 |
| 透明背景 | 无 background,只能写进提示词 |
能出 alpha PNG,文档不承诺 | 2.5 支持;gpt-image-2 已关停 |
| 速度(文档自述) | 专页约 30 到 60 秒;对比页约 90 秒 | gpt-image-2-vip 90 到 150 秒;flare-vip 22 到 138 秒,sunburst-vip 37 到 120 秒 |
2026-09-09 时 2.5-flare 1K low 约 10 秒,sunburst 约 14 秒;gpt-image-2 100 到 120 秒 |
关于 -all 的速度,两处文档的说法不同:专页写约 30 到 60 秒,对比页写约 90 秒。本文两个数字都列出,不取平均。-all 的 size 也存在文档不同步:专页写「现已支持 size」,对比页还写着不接受。本文以专页为准。专页还提到,1536 方图可能经过插值,不代表原生细节。2.6 的「生成提速 50%,Flare 低画质最快 6 秒」来自 2026-11-05 实时动态里转述的官方公布,不是平台复测的数据。2.6 的新参数(complexity、SVG、GIF 等)以 OpenAI 官方文档为准,不能直接套用 2.5 的参数表。
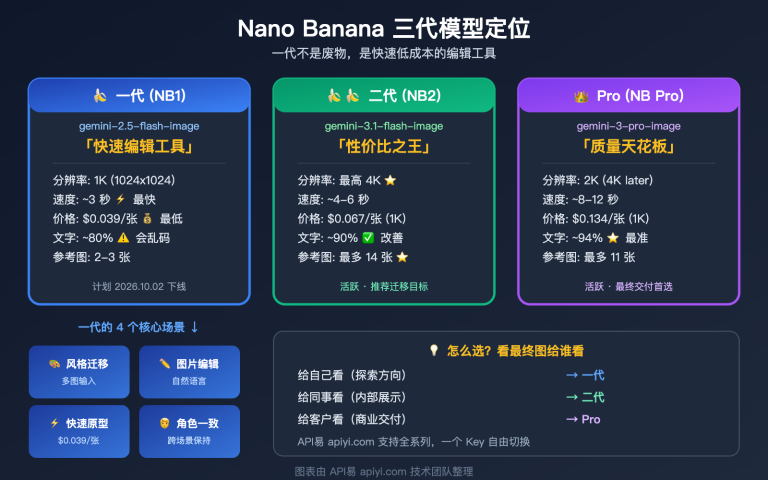
如果 4K 需求很多,-all 专页还提到另一条路线:API易 上的 Nano Banana。价格总表中,nano-banana-pro 与 gemini-3-pro-image 系列为 0.09 美元/次,nano-banana-2 与 gemini-3.1-flash-image 为 0.055 美元/次。这条路线的企业分组是 NanoBananaEnterprise 和 NanoBananaReverse,不能和 image2Enterprise 混用。
图像通道的令牌类型和分组优先级怎么配
很多报错其实不是通道本身有问题,而是令牌类型或分组配错了。所有通道都走同一个 Base URL:https://api.apiyi.com/v1。端点推荐使用 /v1/images/generations 和 /v1/images/edits。令牌类型的规则只有一条需要特别记住:官转必须用「按量优先」。用按次令牌调官转,会因为计费方式不匹配被拒绝。-all 和 -vip 用「按次计费」或「按量优先」都可以。
| 分组 | 倍率(定价接口 2026-11-10) | 适用通道 | 用途 | 注意 |
|---|---|---|---|---|
Default |
1 | 官转、-all、-vip | 默认首选 | 官转高峰期可能并发紧张,出现 429 |
image2Enterprise |
1.2 | 仅官转 | OpenAI 上游企业兜底 | 不是加速线,不是 Vertex;-all 和 -vip 不在此分组 |
image2_OSS |
1 | 官转、-all、-vip | 保证 URL 输出 | 不提升稳定性;URL 约 24 小时失效 |
SVIP |
接口读到 1,以控制台令牌页为准 | 官转、-all、-vip | 按控制台说明 | 2026-10-29 起限时倍率活动结束 |
企业分组的 1.2 倍,文档的解释是:按「3000 美金单次充值大客户加赠 20% 后约等官网原价」设定,平台不计税务成本。关于哪些型号在这个分组里可见,FAQ 正文表列的是 gpt-image-2.5-flare、gpt-image-2.5-sunburst、gpt-image-2。价格总表和定价接口的 enable_groups 则显示 2.6 两款也在其中,FAQ 表格还没有同步更新。文档没有说明这个分组需要单独申请,如果选不到,以控制台显示为准。
推荐的配置方法是「一把令牌覆盖两类模型」。一个令牌可以设 1 个默认分组和最多 2 个兜底分组。按文档的配法,把第一优先级设为 image2Enterprise,默认分组设为 Default。这样官转请求优先走企业分组,-all 和 -vip 因为不在企业分组里,会留在 Default 正常出图。具体操作:打开 api.apiyi.com/token,编辑令牌,选择分组并保存,代码不用改。验收标准:用同一个请求分别调用一次官转型号和一次 -all 型号,两次都能出图,并且控制台里官转那次按 1.2 倍计费。
强依赖 URL 的业务需要单独处理。在默认分组下,文档记录 2026-07 时不传 response_format 会返回 b64_json;显式传 response_format 为 url 可以拿到链接,但默认分组不承诺输出格式。这类业务应把令牌切到 image2_OSS,同时显式传 url,拿到链接后立即下载转存。验收标准:响应里是 url 字段,而且转存后的文件可以打开。
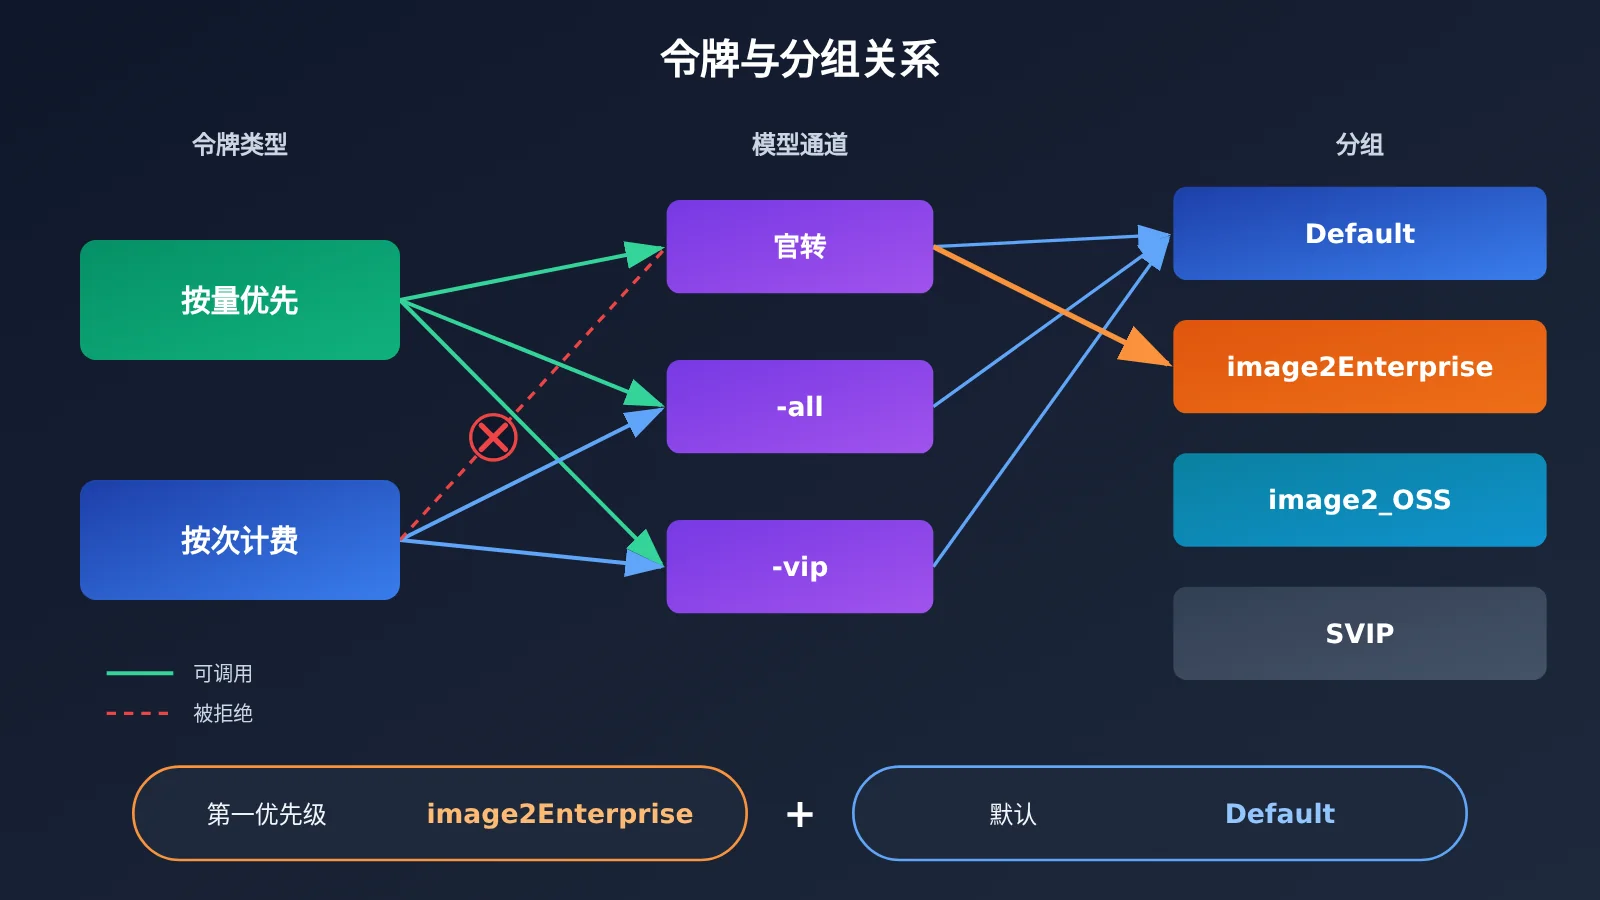
出图遇到 429、饱和、原厂故障分别怎么兜底
同样是报错,背后的原因可能完全不同,所以第一步是读错误体里的 error.message,再决定怎么处理。-vip 专页把 429 拆成了两种:参数被拒和分组饱和。-all 专页对 429 的笼统解释是「限流或额度不足」。实时动态里还记录过两类原厂故障,分别来自 ChatGPT 网页版和 OpenAI 上游。下表把这些情况整理成「看到什么错误,先做什么」:
| 看到什么 | 判断 | 先做什么 | 验收标准 |
|---|---|---|---|
| 官转在 Default 上持续 429 或提示饱和 | 默认分组拥塞 | 到 api.apiyi.com/token 把分组切到 image2Enterprise,或调高它的优先级,模型名不变 |
同一请求能出图,计费变为 1.2 倍 |
-vip 返回 429,message 是 quality must be one of… 这类 |
参数被拒 | 改参数,不要原样重试 | 改完后第一次请求就成功 |
| -vip 返回 429,message 是「当前分组上游负载已饱和」 | 偶发饱和 | 指数退避重试,同时查看实时动态 | 有限次数内恢复,否则切官转 |
| -all/-vip 当天集中报错,实时动态有原厂故障播报 | ChatGPT 网页或 Adobe 原厂故障 | 停止退避,改模型名切到官转 | 官转请求成功,令牌为按量优先 |
官转企业分组返回 The server had an error while processing your request. |
OpenAI 上游故障 | 重试 1 到 2 次,仍不行就切到官逆 | 换到 -all 后可以出图 |
| 401 | 令牌问题 | 检查令牌,不要重试 | 换成正确令牌后恢复 |
gpt-image-2 带 background 为 transparent 返回 400 |
官方已关停该能力 | 透明底改用 2.5 官转配合 png 或 webp | 返回图片带 alpha 通道 |
如果怀疑是原厂故障,先去 docs.apiyi.com/live 看当天有没有对应播报,再决定是退避还是换通道。从官逆切到官转的操作很简单:在 API易 上用同一把令牌、只改模型名就能完成,对比页原话是「只需更换 model 名即可切到官转」。但有两个前提需要逐项核对:
- 令牌类型:确认令牌是「按量优先」。如果是按次令牌,请求会被拒绝。
- 按目标模型删减字段:切到
gpt-image-2时,去掉 xhigh、max 档位和透明背景;从 -all 带过来的非 16 倍数尺寸,要改成 16 的倍数,且比例不超过 3:1。反方向从官转切回 -all 时,要删掉quality、n、aspect_ratio和mask。 - 超时:官转低画质和中画质按 240 秒设置,high 和 xhigh 设 300 秒,max 以及
gpt-image-2的 high 用 600 秒兜底。-all 和 -vip 保守设 300 秒。输入图片先压缩到 1.5MB 以内。
2026 年 4 月到 11 月的历史播报判断表
下面这些事件只用来说明「曾经出现过哪类故障、当时是怎么处理的」,不代表 2026-11-10 的现状。当前是否饱和,以当次的错误体和实时动态为准。
| 日期 | 事件(历史播报) | 当时的处理 | 今天怎么用 |
|---|---|---|---|
| 2026-04-29 | 官转默认分组仍报 429,只有 image2Enterprise 稳定,-all 与 -vip 都稳定 | 官转走企业分组 | 作为「官转默认分组拥塞」的典型案例 |
| 2026-05-07 | 官转企业分组也返回 server error,根因是 OpenAI 上游 | 等上游恢复或换通道 | 企业分组也不能保证上游永远可用 |
| 2026-05-13 | 默认分组饱和,image2Enterprise 仍能出图 | 切企业分组 | 支持优先级配法 |
| 2026-05-23 | 默认分组补充资源,文档写无需特意切企业分组 | 回到 Default | 拥塞是阶段性的 |
| 2026-09-21 | 2.5 官转默认分组并发紧张,企业分组稳定 | 切企业分组 | 同上 |
| 2026-10-15 | gpt-image-2-vip 负载过高;-all 因 ChatGPT 网页原厂故障报错;gpt-image-2 透明背景关停(对比页记为 2026-09-30) |
官逆先用官转兜底;透明底改用 2.5 官转 | 原厂故障时应换通道,不要死磕 |
| 2026-11-05 | 2.6 官转上线,Default 分组可用 | 新项目可以使用 | 这是一条上线播报,不是故障播报 |
出图报错哪些该重试,哪些不该
判断是否重试,标准只有一个:错误原因会不会随着时间自己消失。负载类 429、5xx 和超时可能自行恢复,可以做有限次退避;参数错误、令牌错误和内容拒绝不会自己消失,原样重试只会浪费时间,有时还会多扣费。选题归档 2026-08-25 的运维口径是「429 可重试、内容安全无需重试」,和这个标准一致。
- 可以退避重试:负载类 429 用指数退避;5xx 重试 1 到 2 次;超时先把客户端超时调到建议值。记录响应头里的
request-id,方便排查。-vip 文档写 RPM 500 以内不必先考虑并发问题。 - 改了再发:参数被拒先改参数;401 先检查令牌;400 先对照目标模型的字段表。鉴权失败和参数校验失败不计费。
- 不要自动重试:内容拒绝分两种。一种返回明确错误,例如「没有按照预期生成图片,请重新调整提示词后重试」,这种不计费,应该修改提示词。另一种返回 200,但正文是「我不能做到这个需求」之类的软拒绝。协议上它算正常返回,会计费,官逆也无法在协议层提前识别。同一条提示词不要自动重新提交。
问:-all 传了 n=4,为什么只拿到 1 张却扣了 4 次?
-all 不接受 n,但传了仍会按 n 倍扣费。专页举的例子是 n=3 扣 0.075 美元,仍只返回 1 张图。需要 N 张时,应并行调用 N 次。验收标准:控制台扣费次数等于实际拿到的图片张数。
问:对比页说 -all 不接受 size,到底能不能传?
以 -all 专页为准,可以传。显式传入的 size 优先于提示词里的尺寸描述;不传或传 auto 时保持原生行为。对比页是还没同步更新。
问:企业分组能让出图变快吗?
不能。FAQ 明确写了它不是加速线,作用只是在默认分组拥塞时提供另一条资源池。官逆模型放在 Default 分组即可。
问:定价接口里官转的 0.2 是按次价吗?
不应该这样理解。价格总表标的是按量,本文也以按量为准。接口对部分没有日期的别名返回 model_price 0.2,两处口径不一致,下单前请在控制台核对实际折后价。
问:2.6 有 -all 或 -vip 版本吗?
2026-11-10 的价格总表和定价接口里都没有,本文也不对上线时间做任何推测。
照做的默认配置
- 模型名:
gpt-image-2.5-all;需要尺寸或 4K 时改为gpt-image-2.5-vip;需要官方参数时改为gpt-image-2.6-flare或gpt-image-2.6-sunburst - 分组:第一优先级
image2Enterprise,默认分组Default;强依赖 URL 的业务另建一把令牌,使用image2_OSS - 令牌类型:按量优先(官转和官逆都能调用)
- 超时秒数:-all/-vip 设 300;官转低、中画质 240,high/xhigh 300,max 600
- Base URL:
https://api.apiyi.com/v1
按这套配置跑起来后,平时只需要关注两件事:错误体里的 error.message 写的是什么,以及当天的实时动态有没有相关播报。参考上面两张表,就能判断该退避重试、修改请求还是切换通道。
作者:APIYI 技术团队
技术交流:遇到文中没有覆盖的报错,欢迎通过 API易 官网首页联系我们,并附上request-id和完整的错误体。