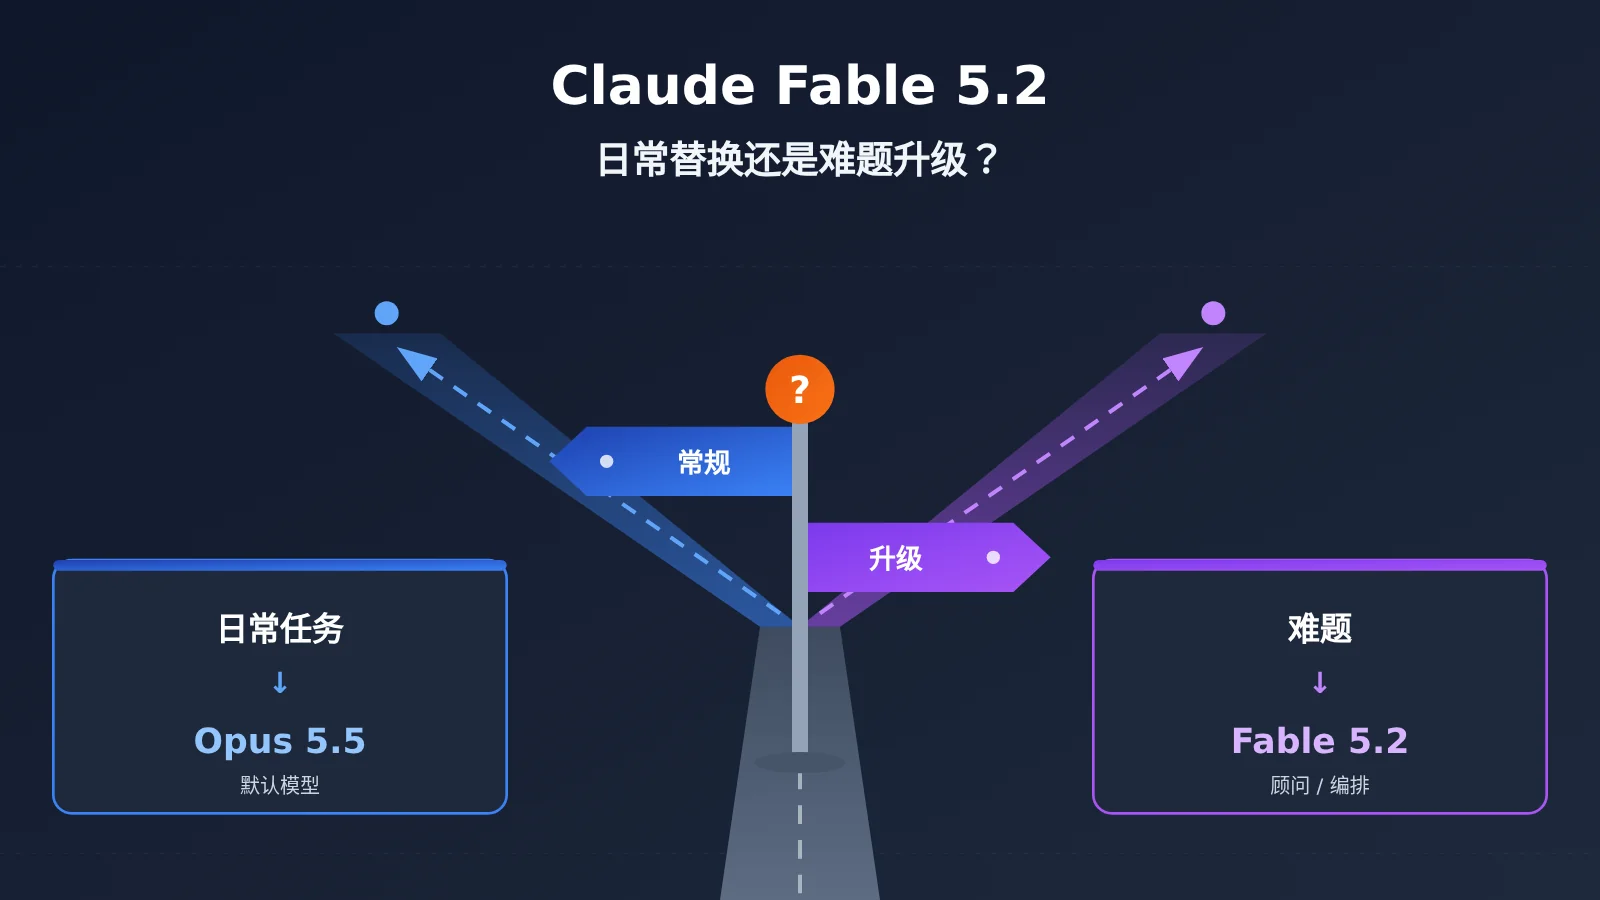
直接回答:Claude Fable 5.2 是“难题升级”,不是日常替换。 Anthropic 在 2026-11-09 的发布说明中明确建议,多数日常编程与知识工作先使用 Opus 5.5。Fable 5.2 更适合作为难题的上层支援:它可以在其他模型求助时担任 Advisor(顾问),也可以作为 Orchestrator(编排者)把简单任务委派出去。对大多数团队来说,合理的做法是把它接进工作流的关键节点,而不是把默认模型全部换成它。
您读完此文能了解到什么?
- Claude Fable 5.2 与 Mythos 5.2 的关系,以及两者在访问方式上的区别。
- Fable 5.2 普通模式与快速模式的官方定价,以及“快 2.5 倍”这个数字的真实含义。
- 官方给出的定位:日常任务先用 Opus 5.5,Fable 5.2 担任 Advisor 或 Orchestrator。
- 判断是否值得接入 Fable 5.2 的三个维度:访问资格、等待时间成本、调用范围。
- 一段可直接改用的成本估算代码,以及按人群划分的应对建议。
索引: 先看 To Know 概念表和影响速览,快速建立背景。“客观事实”部分只整理官方已公布的信息,并单独标出本文未核实的内容。“分析判断”部分讨论 Fable 5.2 为什么不适合当作日常替换,拆开计算快速模式的成本与提速,最后给出不同人群的接入思路和后续观察点。
Claude Fable 5.2 To Know:概念解释
| 概念 | 简要解释 |
|---|---|
| Claude Fable 5.2 | Anthropic 于 2026-11-09 发布的模型,带有网络安全与生物领域的防滥用限制 |
| Mythos 5.2 | 与 Fable 5.2 使用同一底层模型,面向通过验证计划的机构,需要申请访问 |
| Opus 5.5 | 官方建议多数日常编程与知识工作优先使用的模型 |
| 防滥用限制 | 模型在特定高风险领域(这里是网络安全与生物)收紧响应范围的安全措施 |
| 快速模式 | Fable 5.2 的高速档位,单价是普通模式的 2 倍,厂商称 token 生成最高快 2.5 倍 |
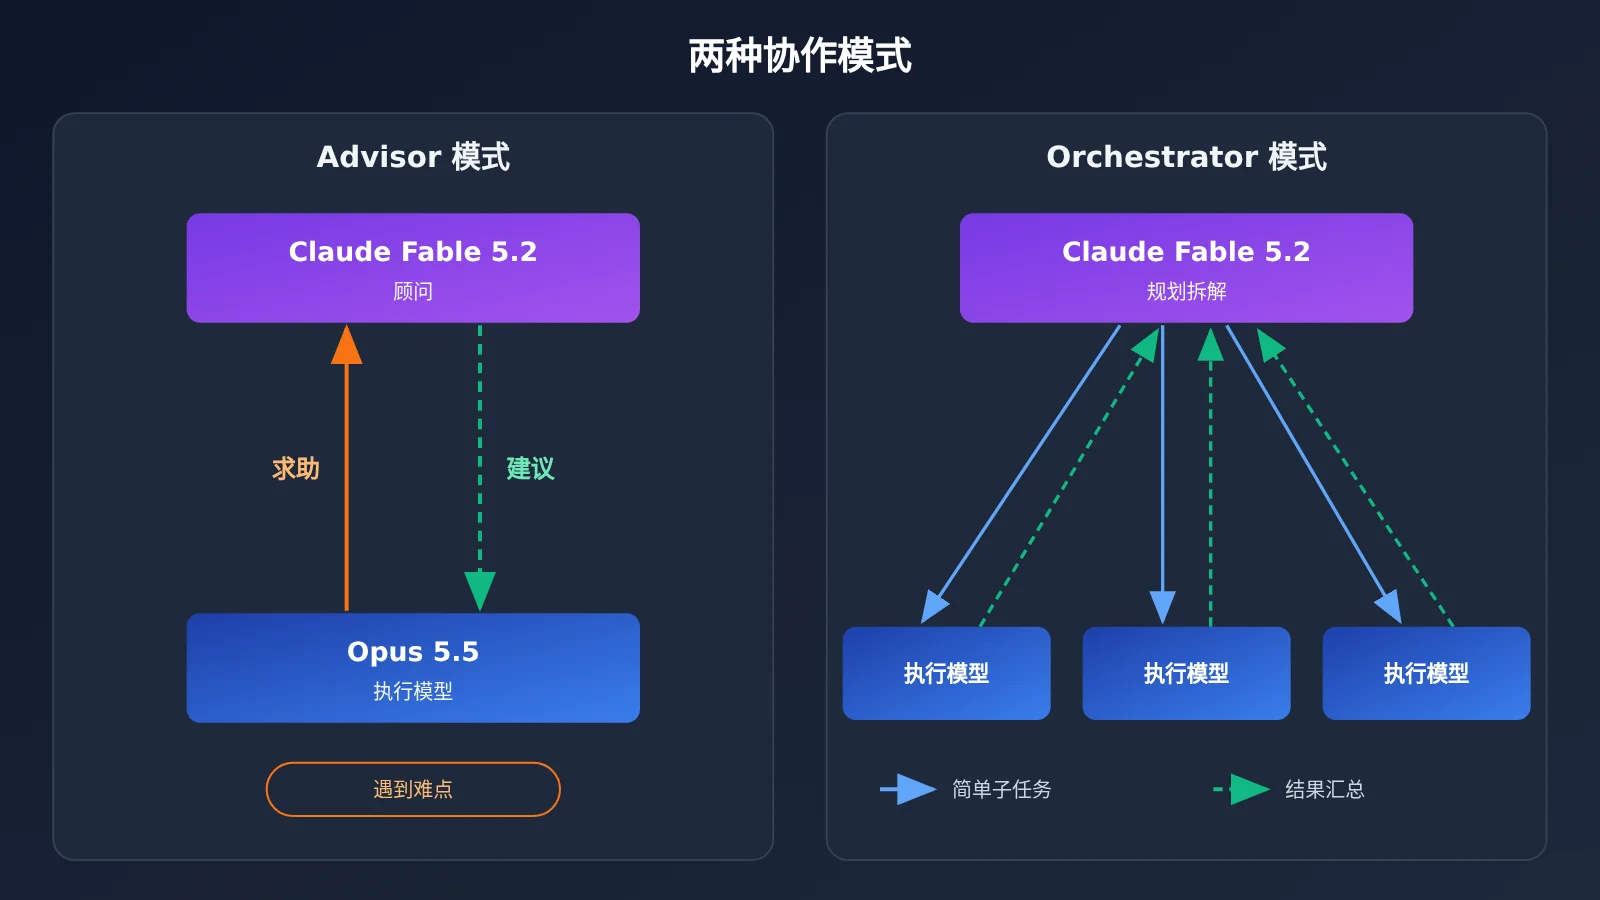
| Advisor(顾问) | 其他模型遇到难点时向 Fable 求助,由它给出思路或判断 |
| Orchestrator(编排者) | 由 Fable 拆解任务,把简单子任务委派给其他模型执行 |
| 端到端耗时 | 一个任务从发起到完成的总时间,包含模型生成以外的工具调用、网络、排队等环节 |
Claude Fable 5.2 影响速览
| 人群 | 主要影响 | 建议动作 |
|---|---|---|
| 日常开发者 | 官方并不建议用 Fable 5.2 替换日常模型 | 默认模型继续使用 Opus 5.5,遇到卡点再升级 |
| Agent / 工作流搭建者 | Advisor 与 Orchestrator 两种角色可以直接映射到多模型架构 | 设计“主模型 + 求助通道”或“编排 + 执行”的分层 |
| 安全与生物领域团队 | Fable 存在防滥用限制,部分请求可能受限 | 评估是否需要并有资格申请 Mythos 5.2 |
| 预算负责人 | 普通模式 8/40 美元、快速模式 16/80 美元(每百万 token) | 按任务估算成本,不按“提速倍数”估算收益 |
Claude Fable 5.2 客观事实
本部分只整理 Anthropic 官方发布页公开的信息。官方发布页: www.anthropic.com/claude-fable-and-mythos-5-2,发布日期为 2026-11-09,本文核查日期为 2026-11-17。
Claude Fable 5.2 与 Mythos 5.2 的关系
官方说明,Fable 5.2 与 Mythos 5.2 使用同一个底层模型,区别在于开放方式和限制范围。Fable 5.2 在网络安全与生物两个领域设有防滥用限制。Mythos 5.2 则面向通过验证计划的机构,需要申请才能使用。
换句话说,这次发布的是同一模型的两种开放形态,而不是两个能力层级不同的模型。
Claude Fable 5.2 定价与快速模式
| 模式 | 输入价格(每百万 token) | 输出价格(每百万 token) | 官方描述的速度 |
|---|---|---|---|
| 普通模式 | 8 美元 | 40 美元 | 基准 |
| 快速模式 | 16 美元 | 80 美元 | token 生成最高快 2.5 倍(厂商说法) |
上表为官方公布的价格。快速模式的输入和输出单价都是普通模式的 2 倍。“最高快 2.5 倍”是厂商对 token 生成速度的描述,指的是上限,不代表每次调用都能达到。
Claude Fable 5.2 的官方定位
官方给出的使用建议很明确:多数日常编程与知识工作,先使用 Opus 5.5。Fable 5.2 的推荐用法是两种协作角色:
- Advisor:其他模型在执行中遇到难点时向 Fable 求助,由 Fable 给出判断或方案。
- Orchestrator:由 Fable 负责拆解和规划,把其中的简单任务委派给其他模型完成。
本文未核实的部分
以下内容本文没有独立验证,读者在引用时应注意区分:
- 官方材料中涉及的科学研究成果和榜单表现,本文未独立复现。
- 快速模式“最高快 2.5 倍”为厂商说法,本文未做实测。
- Mythos 5.2 验证计划的具体审核条件与周期,以及 Fable 5.2 在不同账号下的可用情况,本文未逐一核实。
- Opus 5.5 的具体价格不在本文参考范围内,两者的成本对比请以官方价目为准。
Claude Fable 5.2 分析判断
以下为作者基于上述事实的解读。涉及未来走势的内容属于预测,会单独标明。
为什么 Claude Fable 5.2 不是日常替换
最直接的依据来自官方自己的建议:日常编程与知识工作先用 Opus 5.5。厂商在发布新模型时主动把用户引向另一个模型,说明 Fable 5.2 的设计目标并不是覆盖所有任务。
协作角色的设定也支持这个判断。Advisor 和 Orchestrator 两种角色都意味着 Fable 5.2 不承担全部执行工作:前者只在别的模型卡住时介入,后者把简单任务交出去。这种分工的出发点,是把高单价的算力集中用在规划和疑难判断上。
所以“日常替换还是难题升级”的答案很清楚:Fable 5.2 是难题升级通道。把它设为全局默认模型,相当于用高价资源去处理大量本来不需要它的简单请求。
判断是否接入 Claude Fable 5.2 的三个门槛
决定是否接入 Fable 5.2,建议拆成三个独立的问题来看,而不是只看“它强不强”。
| 判断维度 | 核心问题 | 关注点 |
|---|---|---|
| 访问资格 | 你的业务需要的是 Fable 还是 Mythos? | 网络安全、生物领域的请求可能触发 Fable 的防滥用限制;Mythos 需要机构通过验证计划 |
| 等待时间成本 | 慢一点的代价有多大? | 交互式场景对延迟敏感,批处理场景通常不敏感 |
| 调用范围 | 哪些环节真的需要 Fable? | 按 Advisor 或 Orchestrator 角色限定调用点,避免全量使用 |
访问资格是硬门槛。如果团队的核心工作恰好落在网络安全或生物领域,Fable 5.2 的限制可能直接影响可用性。由于两者底层模型相同,此时更值得关注的是能否通过验证计划获得 Mythos 5.2,而不是寻找另一个更强的模型。
等待时间成本决定是否开快速模式。如果开发者在 IDE 里实时等待回复,或者终端用户在等页面响应,减少等待有直接价值。如果是夜间批量跑的分析任务,多等几分钟通常没有影响,开快速模式就是多付钱。
调用范围决定总账单。同样的单价,只在疑难节点调用和每个请求都调用,月度成本可能相差一个数量级。这一点比在普通模式和快速模式之间选择更重要。
Claude Fable 5.2 快速模式:单价翻倍不等于任务快 2.5 倍
快速模式的单价是普通模式的 2 倍,厂商描述的 token 生成速度最高快 2.5 倍。看到这两个数字,很容易得出“多花一倍钱,速度快一倍多,很划算”的结论。这里需要拆开看两件事。
第一,“最高 2.5 倍”说的是 token 生成环节,而且是上限。一个真实任务的端到端耗时,还包括网络往返、排队、上下文处理、工具调用、代码执行和人工审阅。快速模式只能加速生成那一段,其他环节耗时不变。
第二,Agent 类任务中,模型生成往往只占总耗时的一部分。下面是一个假设性示例,用来说明计算方法,数据并非实测:假设某任务总耗时 100 秒,其中模型生成占 40 秒,其余 60 秒是工具调用和等待。即使生成环节达到 2.5 倍上限,生成时间降到 16 秒,总耗时也只从 100 秒降到 76 秒,端到端提速约 1.3 倍,而这一部分 token 的费用翻了一倍。
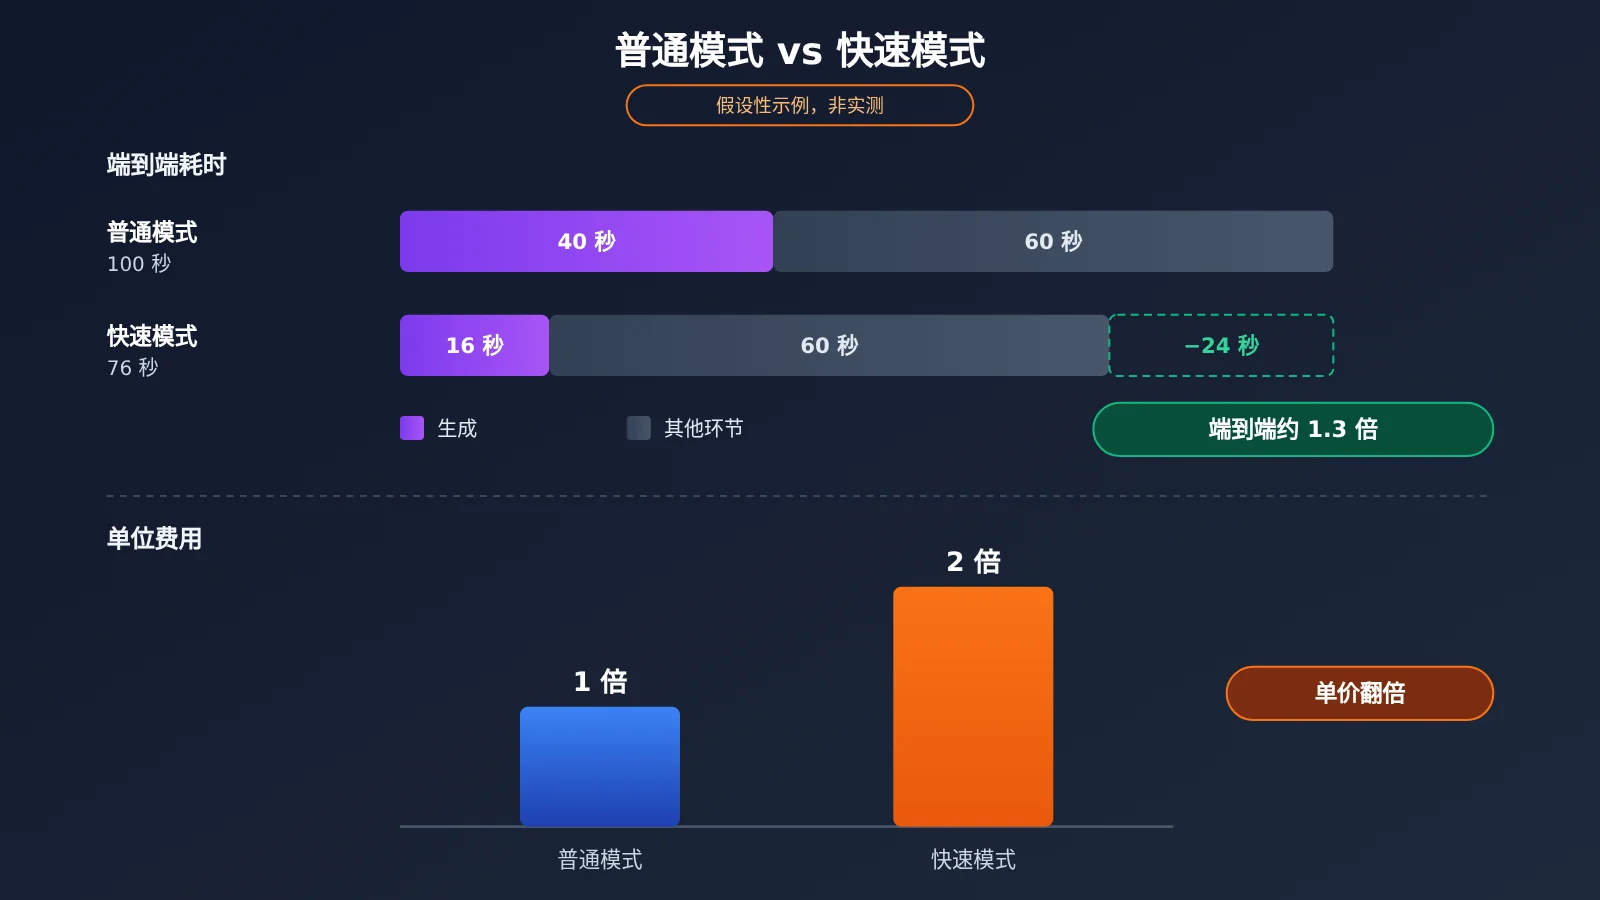
下面这段 Python 代码可以按官方单价估算单个任务的费用,并根据生成耗时占比估算端到端提速。各项参数请替换成你自己业务的实测数据:
# 官方公布单价(美元 / 百万 token)
PRICES = {
    "normal": {"input": 8, "output": 40},
    "fast":   {"input": 16, "output": 80},
}

def task_cost(input_tokens: int, output_tokens: int, mode: str) -> float:
    p = PRICES[mode]
    return input_tokens / 1e6 * p["input"] + output_tokens / 1e6 * p["output"]

def end_to_end_speedup(total_sec: float, gen_sec: float, gen_speedup: float = 2.5) -> float:
    """只有生成环节被加速,其余环节耗时不变;gen_speedup 为上限值"""
    new_total = (total_sec - gen_sec) + gen_sec / gen_speedup
    return total_sec / new_total

# 假设性示例:输入 20 万 token、输出 2 万 token
print(task_cost(200_000, 20_000, "normal"))   # 2.4 美元
print(task_cost(200_000, 20_000, "fast"))     # 4.8 美元
print(round(end_to_end_speedup(100, 40), 2))  # 约 1.32 倍
这段计算想说明的是:评估快速模式时,要用自己业务的“生成耗时占比”去折算,不能直接拿 2.5 倍当作收益。生成耗时占比越高(例如长文本一次性输出),快速模式越接近宣传效果;工具调用越密集,收益越小。
不同人群如何应对 Claude Fable 5.2
| 角色 | 推荐做法 | 不建议的做法 |
|---|---|---|
| 个人开发者 | 日常用 Opus 5.5,遇到反复卡住的问题再手动切到 Fable 5.2 | 把 Fable 5.2 设为编辑器默认模型 |
| Agent 架构师 | 设置 Advisor 求助通道,或让 Fable 只负责规划层 | 让 Fable 执行每一个子步骤 |
| 安全 / 生物研究机构 | 先确认业务是否会触发 Fable 的限制,再评估 Mythos 申请 | 在 Fable 上反复绕过限制 |
| 成本负责人 | 按调用点统计 Fable 用量,快速模式只开给交互式场景 | 按“提速 2.5 倍”预估全部收益 |
对 Agent 架构师来说,Advisor 模式可以用一个简单的升级规则落地:执行模型连续失败若干次,或者自评置信度低于阈值时,把当前上下文摘要后交给 Fable 5.2,拿回建议后继续由执行模型完成。这样 Fable 的调用次数与“难题数量”挂钩,而不是与“请求总量”挂钩,成本更可控。
Orchestrator 模式更适合任务结构复杂、可拆分的场景,例如大型代码重构或多文档研究。Fable 负责拆解和验收,执行交给更便宜的模型。需要注意的是,编排层本身会产生较长的输入上下文,按 8 美元每百万输入 token 计算,长上下文的规划调用也需要纳入预算。
Claude Fable 5.2 后续值得关注的问题
以下属于预测和观察方向,尚待验证:
- 独立评测结果:官方提到的科研成果和榜单表现,需要第三方复现后才能作为选型依据。
- 快速模式实测:不同任务类型下,端到端提速与官方“最高 2.5 倍”之间的实际差距。
- 限制边界:Fable 5.2 在网络安全与生物领域的限制到底收紧到什么程度,是否会误伤正常的防御性研究。
- Mythos 5.2 审核门槛:验证计划的开放范围和周期,将决定专业机构能否实际用上同一底层模型。
- 官方定位是否变化(预测):如果未来价格调整或 Opus 系列更新,“日常先用 Opus 5.5”这一建议可能随之改变,届时值得重新评估。
Fable 5.2 的价值不在于“更强所以全换掉”,而在于把最贵的能力放到最需要它的位置。屈原在《卜居》中写道:“夫尺有所短,寸有所长;物有所不足,智有所不明。”选模型也是一样,日常任务和疑难问题各有适合的工具。